Curso
Programación asistida por IA para desarrolladores
1 h 30 min
10.5K
Hacía tiempo que no veíamos una empresa nueva meterse en la carrera de los LLM. Pero el 3 de octubre, Aleph Alpha publicó su nuevo modelo Kolibri 1 en Hugging Face con licencia Apache 2.0 y pidió a Europa que se tomara en serio la IA soberana.
La propuesta: que gobiernos y empresas europeas puedan ejecutar un modelo potente en su propio hardware, incluso totalmente offline, en lugar de depender del API de un proveedor estadounidense.
Kolibri 1 es un modelo mixture-of-experts (MoE) con 78B parámetros totales y 3,46B activos por token, entrenado desde cero por Aleph Alpha Research con 768 GPUs NVIDIA B200 en centros de datos en Alemania y Finlandia.
Solo maneja alemán e inglés, admite una ventana de contexto de 1.048.576 tokens (Aleph Alpha recomienda quedarse en 262.144 tokens o menos por eficiencia de servicio) y llega como disponibilidad general, no como vista previa. El preentrenamiento cubrió 20 billones de tokens, seguido de 3,44T en mid-training y 201B para la extensión de contexto largo.
En este artículo, repasamos todo lo nuevo de Kolibri 1: sus funciones clave, los benchmarks y cuánto cuesta realmente ponerlo en marcha.
Kolibri 1 es el LLM bilingüe especializado de Aleph Alpha, lanzado el 3 de octubre de 2026 bajo Apache 2.0. Es un único modelo en disponibilidad general, sin versiones más pequeñas o más grandes.
Bajo el capó, es un transformer mixture-of-experts de 50 capas.
Cada capa contiene 384 subredes especialistas pequeñas llamadas expertos, y un enrutador envía cada token solo a 6 de ellas, más 1 experto compartido que siempre se ejecuta. Así, los 78,1B parámetros totales se reducen a 3,46B activos por token (alrededor del 4,4%), de modo que el modelo está pensado para servir a bajo coste, no para capacidad máxima.
Dos decisiones de diseño más lo mantienen rápido y con poca huella en memoria:
El mensaje principal de Aleph Alpha es la eficiencia, no la capacidad bruta.
Kolibri 1 promedia un 71% en su batería de benchmarks en alemán mientras decodifica unos 47.000 bytes/s de texto por GPU, frente al 68% y ~24.000 bytes/s de Nemotron Super A12B.
El modelo tiene un cutoff de conocimiento del 18 de junio de 2026 para ambos idiomas, y es solo texto: no admite entrada ni salida de imagen, audio o vídeo.
Si quieres ver de dónde sale realmente su desempeño en alemán, la mezcla de datos publicada es inusualmente transparente para un lanzamiento de pesos abiertos.
| Dominio | Preentrenamiento | Mid-training | Extensión de contexto largo |
|---|---|---|---|
| Web y documentos en inglés | 43,4% | 1,3% | 15,8% |
| Web y documentos en alemán | 23,4% | 2,1% | 2,6% |
| Código | 13,6% | 16,3% | 13,2% |
| Código agentic y uso de herramientas | ~0% | 15,4% | 5,6% |
| PDFs con OCR | 0% | 0% | 33,3% |
La tabla muestra solo las filas de web, código, agentic y PDF. La model card también incluye datos de instrucciones y razonamiento en inglés y alemán, documentos STEM, QA y datos jurídicos y del sector público especializados. Sumando todas las filas de inglés y alemán, la model card resume la mezcla de preentrenamiento en aproximadamente 62,5% inglés, 23,9% alemán y 13,6% código.
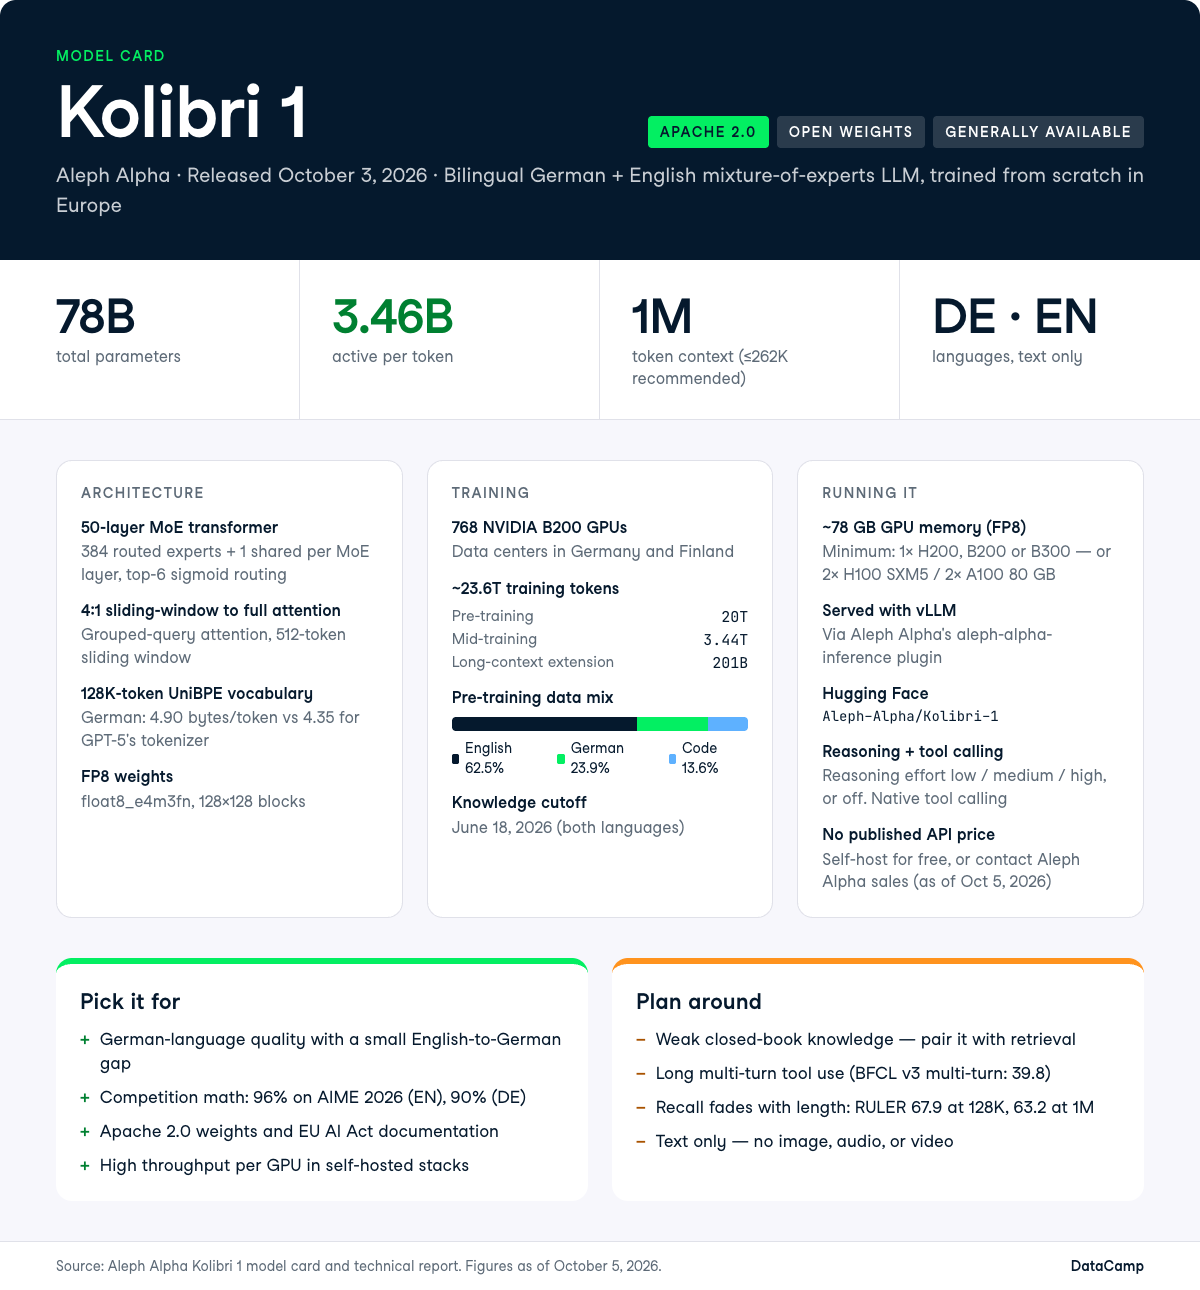
Lo que diferencia a Kolibri 1 se resume en dos decisiones: entrenar bien la parte alemana en lugar de traducirla, y mantener el recuento de parámetros activos lo bastante bajo como para servirlo en una sola H200.
Kolibri 1 acorta más de lo esperado la brecha entre alemán e inglés, algo poco habitual en un modelo de pesos abiertos de este tamaño.
Su media general de benchmarks es 75,5 en inglés y 70,8 en alemán.
Aleph Alpha entrenó un vocabulario de 128.000 tokens con un nuevo algoritmo de tokenización llamado UniBPE, que mantiene las fusiones codiciosas de abajo a arriba del byte-pair encoding, pero usa el objetivo Unigram para decidir qué fusión entra en el vocabulario.
El beneficio declarado es una compresión en alemán de 4,90 bytes/token, frente a 4,35 del tokenizador de GPT-5, con inglés en 4,58 bytes/token (el tokenizador de GPT-5 logra 4,67).
Eso importa tanto en coste como en calidad.
Mejor compresión implica menos tokens para el mismo documento en alemán, así que un Bescheid de 50 páginas (una notificación administrativa oficial en alemán) cuesta menos de procesar y deja más margen en contexto.
El alemán representó el 23,4% de la mezcla de preentrenamiento frente al 43,4% de web y documentos en inglés, así que la capacidad se paga con datos, no con un ajuste fino añadido después.
El modelo anuncia 1.048.576 tokens. Maneja 262.144 tokens de forma nativa tras una fase de entrenamiento de contexto largo de 201B tokens, y estira hasta 1M por extrapolación, es decir, no se entrenó nunca a esa longitud.
La propia Aleph Alpha recomienda quedarse en 262.144 tokens o por debajo por eficiencia. RULER, una prueba de si el modelo puede encontrar y usar detalles concretos enterrados en entradas muy largas, muestra la degradación del modelo base: 67,9 en 128K y 63,2 en 1M, frente a un Qwen3.5 35B-A3B Base citado con 89,9 en 128K.
Con todo, la puntuación de Kolibri en 1M supera a Nemotron 3 Nano (58,5) y Qwen3.5 (57,5) a esa longitud, así que se degrada menos que ellos partiendo de un punto más bajo.
Yo trataría la cifra de 1M como un techo que puedes alcanzar técnicamente, no como tu presupuesto de trabajo.
Si tu RAG mete 400K tokens de PDFs escaneados pasados a texto (OCR) en un prompt y esperas que el modelo encuentre con fiabilidad un detalle concreto, pruébalo antes de comprometerte. Ojo: el 33,3% de la mezcla de extensión de contexto largo fueron PDFs con OCR, así que los documentos escaneados son claramente un caso de uso objetivo.
El modo de razonamiento hace que el modelo resuelva un problema paso a paso antes de responder, lo que mejora la precisión pero consume más tokens.
En Kolibri 1 es un interruptor que controlas, no un nivel de modelo aparte, y las llamadas a herramientas (que el modelo decida invocar una función o API externa, como una consulta a base de datos) son nativas.
Aleph Alpha lo orienta a razonamiento multi‑paso, RAG, llamadas agentic a herramientas, programación y asistencia bilingüe, y en el mid-training destinó un 15,4% a código agentic y uso de herramientas, frente a prácticamente cero en el preentrenamiento.
Un usuario reportó de forma anecdótica, ejecutándolo en FP8 en una sola RTX Pro 6000, unos 170 tokens por segundo y cierta tendencia a gastar muchos tokens en deliberación.
Tenlo en cuenta si dejas el razonamiento activado por defecto en un flujo sensible a la latencia.
Kolibri 1 se entrenó desde cero, así que no es un fine‑tune ni una copia del modelo de otra compañía.
Eso importa para la licencia y para saber exactamente qué contiene.
Combinado con pesos Apache 2.0, significa que puedes ejecutar Kolibri 1 en un entorno air‑gapped (totalmente desconectado de internet), ajustarlo y distribuirlo dentro de un producto comercial sin pedir permiso a nadie.
El Reglamento de IA de la UE y su Código de Buenas Prácticas para GPAI marcan las reglas europeas para modelos de propósito general, incluida la documentación de los datos de entrenamiento.
Aleph Alpha es firmante del Código y publica una model card detallada con fuentes de entrenamiento, pasos de descontaminación (eliminación de preguntas de benchmark del entrenamiento) y un punto de contacto para titulares de derechos, es decir, la documentación que pedirá una revisión de cumplimiento del Reglamento de IA de la UE.
Para compradores del sector público en Alemania y la UE, ese papeleo suele pesar más que unas décimas en un benchmark.
Y es la parte que ningún laboratorio de EE. UU. puede replicar rápido.
La model card de Aleph Alpha enumera abiertamente las limitaciones, y conviene leerlas antes de comprar:
Para cualquier despliegue de alto riesgo, Aleph Alpha indica que se requieren salvaguardas adicionales y cumplimiento del Reglamento (UE) 2024/1689.
El perfil de benchmarks de Kolibri 1 está desequilibrado de forma útil: lidera su grupo comparado en matemáticas de competición y razonamiento en alemán, y pierde frente a Qwen3.6 35B-A3B en conocimiento closed-book, MMLU‑Pro y la mayoría de suites de uso de herramientas.
Aleph Alpha lo compara con Qwen3.6 35B-A3B, Mistral Small 4 119B-A6B y Nemotron 3 Super 120B-A12B.
La model card también lista Qwen3.8 27B, un modelo denso (usa todos sus parámetros en cada token, a diferencia de un MoE) que puntúa más alto en todo (79,9 en alemán frente a 70,8 de Kolibri) con aproximadamente ocho veces más parámetros activos.
Lo he dejado fuera de las tablas siguientes, pero tenlo presente al leer los argumentos de eficiencia.
En esos nombres, el número tras la "A" son los parámetros activos por token, así que 35B‑A3B significa 35B totales y 3B activos. Esto es lo que miden los benchmarks de las tablas:
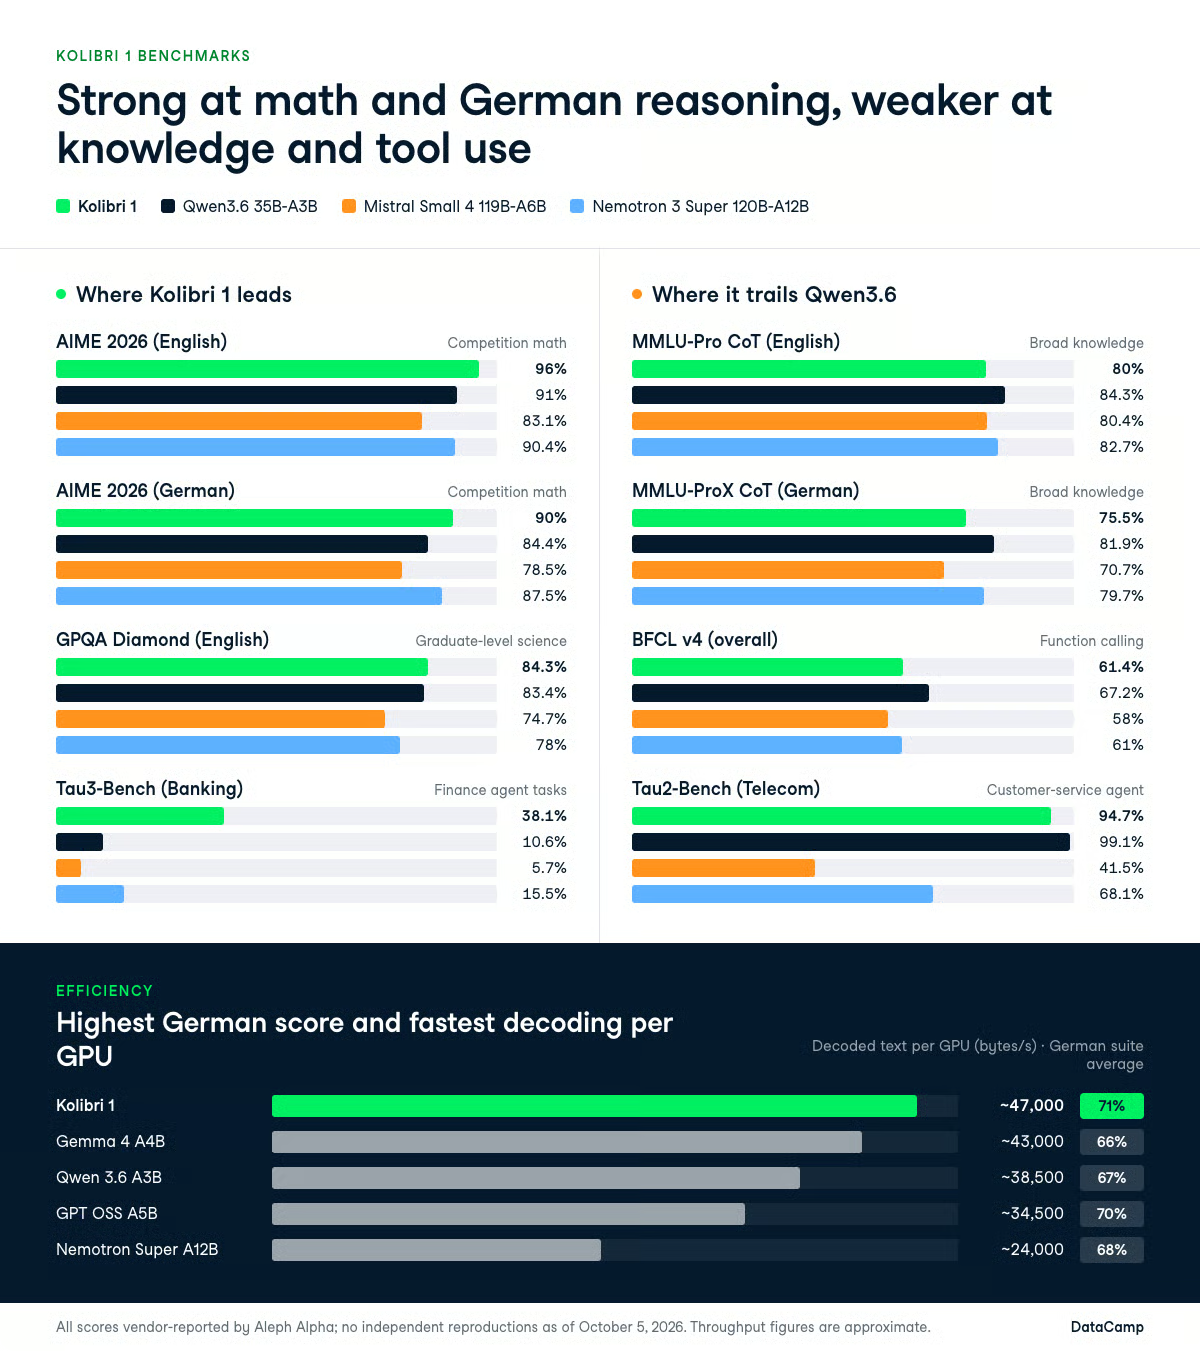
Las matemáticas son donde Kolibri 1 destaca con claridad.
Logra un 96% en AIME 2026 (EN) frente al 91% de Qwen3.6 35B‑A3B, 90,4% de Nemotron 3 Super y 83,1% de Mistral Small 4, y un 96,9% en AIME 2025 (EN) frente al 84,6% de Qwen3.6.
En GPQA Diamond (EN) marca 84,3% frente a 83,4%, y en Humanity's Last Exam (EN) 21,5% frente a 21,1%, lo bastante cerca para considerarlo un empate.
El punto flojo en la misma tabla es el conocimiento.
El AA‑Omniscience Index (conjunto público) se puntúa en una escala donde los negativos son comunes y cuanto más alto mejor. Kolibri 1 logra -32,8 frente a -12,5 de Qwen3.6 y -24,0 de Mistral Small 4, aunque supera el -36,5 de Nemotron 3 Super. Una cifra de precisión separada en AA‑Omniscience queda en 14,8%, la más baja de los cuatro modelos.
Su tasa de no alucinación en el mismo benchmark es más favorable: 44,0%, por delante de Nemotron (13,9%) y Mistral (34,7%) pero por detrás de Qwen3.6 (56,7%), en línea con el entrenamiento de abstención de Aleph Alpha.
Un modelo con 3,46B parámetros activos tiene poca capacidad para memorizar hechos: úsalo con retrieval en lugar de confiar en recuerdo closed‑book.
| Benchmark (EN) | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| AIME 2026 | 96% | 91% | 83,1% | 90,4% |
| AIME 2025 | 96,9% | 84,6% | 79,8% | 91,7% |
| GPQA Diamond | 84,3% | 83,4% | 74,7% | 78% |
| Humanity's Last Exam | 21,5% | 21,1% | 9,7% | 20,6% |
| MMLU-Pro CoT | 80% | 84,3% | 80,4% | 82,7% |
| AA-Omniscience Index (más alto es mejor) | -32,8 | -12,5 | -24,0 | -36,5 |
Kolibri 1 gana en los benchmarks de matemáticas y ciencias en alemán y pierde en los de conocimiento en alemán, igual que en inglés.
Logra 90% en AIME 2026 (DE) frente a 84,4% de Qwen3.6, y 81,3% en GPQA Diamond (DE) frente a 80,6%. En MMLU‑ProX CoT (DE) baja a 75,5% mientras Qwen3.6 llega a 81,9% y Nemotron 3 Super a 79,7%, y en Humanity's Last Exam (DE) se queda en 15,9% frente al 22,3% de Nemotron.
Lo interesante es la brecha pequeña de inglés a alemán.
Kolibri pierde 6 puntos al pasar AIME 2026 de inglés a alemán y 3 puntos en GPQA Diamond, una caída más estrecha de lo que verías en un modelo que trata el alemán como simple destino de traducción.
| Benchmark (DE) | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| AIME 2026 | 90% | 84,4% | 78,5% | 87,5% |
| AIME 2025 | 87,5% | 82,9% | 72,3% | 85,6% |
| GPQA Diamond | 81,3% | 80,6% | 72,9% | 76,6% |
| MMLU-ProX CoT | 75,5% | 81,9% | 70,7% | 79,7% |
| Humanity's Last Exam | 15,9% | 20,5% | 10,5% | 22,3% |
Es la parte más floja del lanzamiento.
En BFCL v4 global, Kolibri 1 marca 61,4% frente a 67,2% de Qwen3.6, y en Tau2‑Bench (Telecom) alcanza 94,7% frente a 99,1%. Supera a Qwen3.6 en Tau2‑Bench (Airline), 76,7% vs 70,7%.
Una cifra aparte de BFCL v3 multi‑turn de 39,8 puntos (53,5 para Qwen3.6) muestra la misma debilidad: las llamadas únicas a herramientas van bien, las conversaciones largas con idas y vueltas repetidas no tanto.
La excepción va al revés.
En Tau3‑Bench (Banking), Kolibri 1 logra 38,1% mientras Qwen3.6 obtiene 10,6%, Nemotron 3 Super 15,5% y Mistral Small 4 apenas 5,7%. Es un margen ~2,5x sobre el siguiente mejor de este conjunto (3,6x sobre Qwen3.6) en un benchmark agentic con sabor financiero, y es el resultado que más me gustaría ver reproducido de forma independiente.
| Benchmark | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| Tau2-Bench (Telecom) | 94,7% | 99,1% | 41,5% | 68,1% |
| Tau2-Bench (Retail) | 69,9% | 71,6% | 62,9% | 67,5% |
| Tau2-Bench (Airline) | 76,7% | 70,7% | 40% | 72,7% |
| Tau3-Bench (Banking) | 38,1% | 10,6% | 5,7% | 15,5% |
| BFCL v4 (global) | 61,4% | 67,2% | 58% | 61% |
Resultados reportados: 85,9 en LiveCodeBench v6, 66,4 en SWE‑bench Verified y 27,7 en Terminal‑Bench 2.1.
La generación de código en bruto parece sólida, la ingeniería agentic luce normalita, y el dato de Terminal‑Bench indica que el trabajo largo en terminal con múltiples pasos no es el fuerte de este modelo.
Hay una advertencia de contaminación que deberías leer antes de citar nada.
El informe técnico señala que el 48% de los datos de evaluación HumanEval en inglés y el 47% en alemán aparecieron en material relacionado con el entrenamiento, lo que infla las puntuaciones tipo HumanEval.
Varias de las suites de las tablas son propietarias o creadas por proveedores, lo que dificulta auditar el conjunto completo, y no había comparativas verificadas y homogéneas frente a los buques insignia actuales de Claude, GPT o Gemini en el momento de escribir esto.
La afirmación de eficiencia es la que mejor resiste el sesgo de reporte del proveedor, porque es una propiedad de la arquitectura más que una puntuación.
Aquí throughput significa cuánto texto puede generar el modelo por GPU y por segundo. Aleph Alpha lo mide en bytes en lugar de tokens, para comparar con justicia modelos con tokenizadores distintos.
Kolibri 1 se sitúa en 71% de media en la suite alemana de Aleph Alpha mientras decodifica unos 47.000 bytes/s por GPU. GPT OSS A5B llega al 70% con ~34.500 bytes/s, Qwen 3.6 A3B al 67% con ~38.500, Gemma 4 A4B al 66% con ~43.000 y Nemotron Super A12B al 68% con ~24.000.
Servir aproximadamente el doble de texto decodificado por GPU que el modelo Nemotron, y con una media alemana superior, es el argumento práctico para elegir Kolibri en un stack autoalojado.
Si pagas tus propias GPUs y no por token, el throughput por GPU es la cifra que aparece en la factura.
No hay precio por token publicado para Kolibri 1.
Aleph Alpha no ha publicado una lista de precios de API alojada, y a 5 de octubre de 2026 no había un ID de modelo de API de Kolibri confirmado en la documentación oficial.
El despliegue para empresas pasa por el equipo de ventas de Aleph Alpha, y el identificador del repositorio Aleph-Alpha/Kolibri-1 no debe tratarse como un ID de modelo de API.
Los pesos son gratuitos bajo Apache 2.0, así que tu coste es el tiempo de GPU.
La huella de memoria en FP8 ronda los 78 GB, con un mínimo declarado de 2x A100 80 GB, 2x H100 SXM5, 1x H200, 1x B200 o 1x B300, y configuración recomendada de 2x H100 SXM5, 2x H200, 1x B200 o 1x B300. El modelo está en disponibilidad general, no en preview, sin lista de espera ni bloqueo por región.
Para situarte, nuestra cobertura de GPT‑6.1 Sol sitúa ese modelo en 2 $ entrada / 10 $ salida por millón de tokens. Un resumen de terceros sitúa el anterior GPT‑5.6 Sol en 5 $ / 30 $ y GPT‑5.6 Luna en 0,20 $ / 1,20 $ tras la bajada de precios de OpenAI del 30 de julio.
El autoalojamiento gana en economía unitaria solo cuando tu volumen supera el coste fijo de una B200.
Kolibri 1 tiene pesos abiertos bajo Apache 2.0, que permite uso comercial, modificación y redistribución sin umbrales de usuarios o ingresos.
Los pesos están en Aleph-Alpha/Kolibri-1 en Hugging Face en float8_e4m3fn. La model card documenta el servicio solo a través de vLLM, usando el plugin aleph-alpha-inference de Aleph Alpha. La comunidad publicó builds en GGUF y MLX en pocos días, pero Aleph Alpha no los ha validado y no encontré una entrada oficial de Ollama.
Para un despliegue servido, 1x H200 o 1x B200 alberga los ~78 GB de pesos FP8 en una sola tarjeta. Usa --tensor-parallel-size 2 en H100.
Mantén --max-model-len en 262.144 o por debajo salvo que hayas probado específicamente contextos más largos. Superarlo requiere una flag extra --hf-overrides, documentada en la model card.
Instala el plugin e inicia el servidor:
pip install 'aleph-alpha-inference>=1'

# Añade --tensor-parallel-size 2 en 2x H100
vllm serve Aleph-Alpha/Kolibri-1 \
  --kv-cache-dtype fp8 \
  --max-model-len 262144 \
  --reasoning-parser kolibri1 \
  --tool-call-parser kolibri1 \
  --enable-auto-tool-choice
Luego consúltalo a través del API compatible con OpenAI, usando los parámetros de muestreo que recomienda Aleph Alpha (temperature 1.0, top_p 0,97, top_k 128):
from openai import OpenAI

client = OpenAI(base_url="http://localhost:8000/v1", api_key="EMPTY")

response = client.chat.completions.create(
    model="Aleph-Alpha/Kolibri-1",
    messages=[{
        "role": "user",
        "content": "Fasse die wichtigsten Fristen aus diesem Bescheid in drei Punkten zusammen.",
    }],
    temperature=1.0,
    top_p=0.97,
    max_tokens=512,
    extra_body={
        "top_k": 128,
        "chat_template_kwargs": {"reasoning_effort": "medium"},
    },
)
print(response.choices[0].message.content)
Reasoning effort acepta low, medium y high, y puedes desactivar el pensamiento por completo si la latencia importa más que la profundidad.
Las salidas variarán con los parámetros de muestreo, y la model card señala que pueden divergir levemente incluso con el muestreo desactivado.
Para profundizar en inferencia autoalojada y bucles agentic, nuestro tutorial de API sobre construir un agente de migración cubre los patrones de permisos y control que se transfieren directamente.
Kolibri 1 es, en teoría, una "IA soberana": un país u organización puede ejecutar, auditar y controlar su IA en su propia infraestructura y bajo su propia jurisdicción, sin depender del API, los precios o las condiciones de servicio de un proveedor extranjero. En Kolibri 1, ese argumento se apoya en pesos Apache 2.0 que puedes ejecutar en air‑gap, infraestructura de entrenamiento europea y documentación conforme al Reglamento de IA de la UE.
Sin embargo, hay dos piezas de contexto corporativo detrás del lanzamiento.
Aleph Alpha ha firmado un acuerdo vinculante de fusión con la canadiense Cohere para formar lo que describen como la primera solución transatlántica de IA soberana.
La empresa combinada operará bajo la marca Cohere, con sedes en Toronto y Berlín y Heidelberg como centro de investigación. El acuerdo aún necesita aprobación regulatoria.
Un argumento de soberanía depende de que el propietario del modelo siga dándole soporte, y la marca Aleph Alpha desaparecerá en Cohere cuando se cierre la fusión, así que conviene seguir estos puntos junto con los benchmarks.
Aleph Alpha apuesta a que la soberanía, la licencia Apache 2.0 y el cumplimiento documentado del Reglamento de IA de la UE pesan más para los compradores públicos europeos que unos puntos en MMLU‑Pro.
Parece una apuesta razonable, y la fusión con Cohere sugiere que saben que no pueden ganar solo por escala.
Diría que Kolibri 1 es el mejor modelo de pesos abiertos en alemán dentro de este tamaño de parámetros activos que hemos visto tan bien documentado, pero no es el que elegiría si necesitara agentes de muchos turnos o recuerdo factual closed‑book.
Entre los MoE pequeños en parámetros activos, Qwen3.6 35B‑A3B sigue ganando esa partida. Si puedes permitirte un denso de 27B, Qwen3.8 27B la gana de calle.
Si quieres ponerte al día en ejecución y evaluación de modelos como este, empieza por nuestro itinerario de aprendizaje AI Fundamentals.
Los cursos destacados de DataCamp
Curso
Curso
Curso
blog
Bhavishya Pandit
7 min
blog
Stanislav Karzhev
9 min
blog
Abid Ali Awan
9 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Josep Ferrer
11 min
Tutorial
Moez Ali
12 min