Kurs
Geliştiriciler için Yapay Zeka Destekli Kodlama
1 sa 30 dk
10.5K
LLM yarışına yeni bir şirketin girdiğini görmeyeli epey olmuştu. Ancak 3 Ekim'de Aleph Alpha, yeni modeli Kolibri 1'i Apache 2.0 lisansı altında Hugging Face'e koydu ve Avrupa'ya egemen yapay zekâyı ciddiye alması çağrısı yaptı.
Verilen mesaj şu: Avrupa hükümetleri ve şirketleri, bir ABD sağlayıcısının API'sına bağımlı kalmak yerine, yetkin bir modeli kendi donanımlarında, tamamen çevrimdışı bile çalıştırabilir.
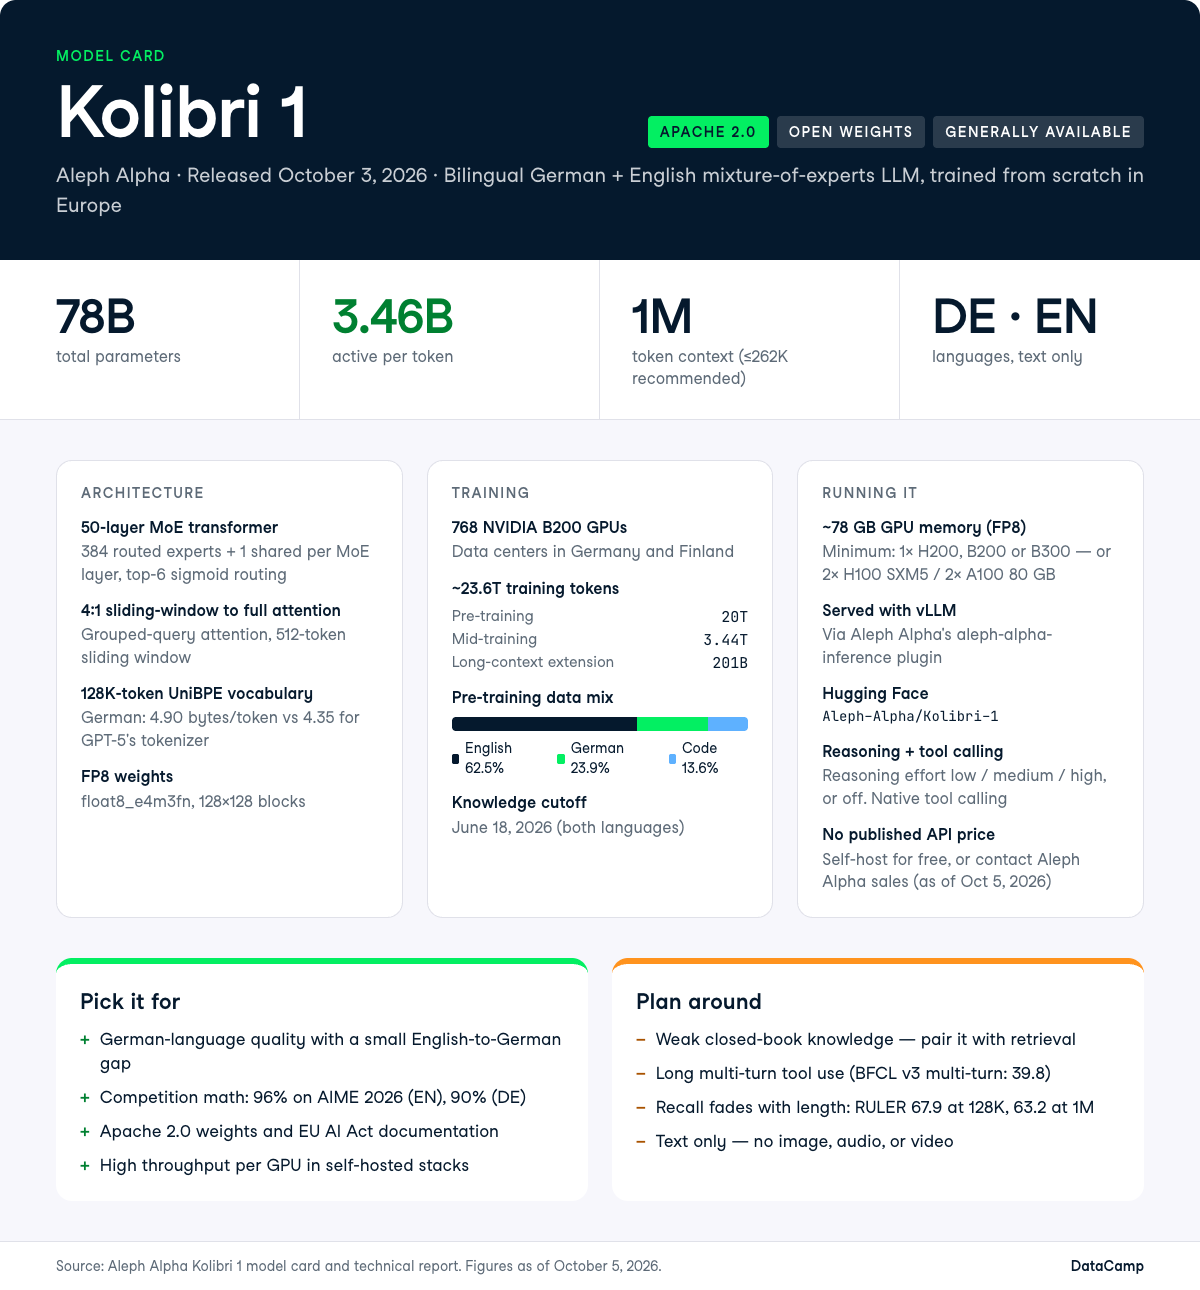
Kolibri 1, toplam 78B parametreli ve token başına 3,46B aktif parametreli bir uzman-karışımı (MoE) model; Aleph Alpha Research tarafından Almanya ve Finlandiya'daki veri merkezlerinde 768 NVIDIA B200 GPU ile sıfırdan eğitildi.
Yalnızca Almanca ve İngilizceyi destekler, 1.048.576 tokenlık bir bağlam penceresine sahiptir (Aleph Alpha, sunum verimliliği için 262.144 token ve altını öneriyor) ve önizleme değil, genel kullanıma sunulmuş şekilde gelir. Ön eğitim 20 trilyon token kapsadı, ardından orta eğitimde 3,44T ve uzun bağlam uzatması için 201B token geldi.
Bu yazıda Kolibri 1 ile gelen yeniliklerin tamamını ele alacak, temel özelliklere bakacak, kıyaslamalara dalacak ve gerçekten çalıştırmanın maliyetini anlatacağım.
Kolibri 1, 3 Ekim 2026'da Apache 2.0 kapsamında yayımlanan Aleph Alpha'nın uzmanlaşmış iki dilli büyük dil modelidir (LLM). Daha küçük ya da daha büyük kardeşi olmayan tek bir genel kullanıma açık modeldir.
Kaputun altında 50 katmanlı bir uzman-karışımı dönüştürücü bulunuyor.
Her katman, uzman adı verilen 384 küçük uzman alt ağa sahiptir ve bir yönlendirici her tokenı yalnızca bunlardan 6'sına ve her zaman çalışan 1 paylaşılan uzmana yollar. Böylece 78,1B toplam parametre token başına 3,46B aktife (yaklaşık %4,4) iner; model maksimum kapasiteden ziyade düşük maliyetli sunum için tasarlanmıştır.
İki tasarım tercihi daha hızı ve bellek verimliliğini korur:
Aleph Alpha'nın öne çıkardığı başlıca sonuç, ham yetenekten çok verimliliktir.
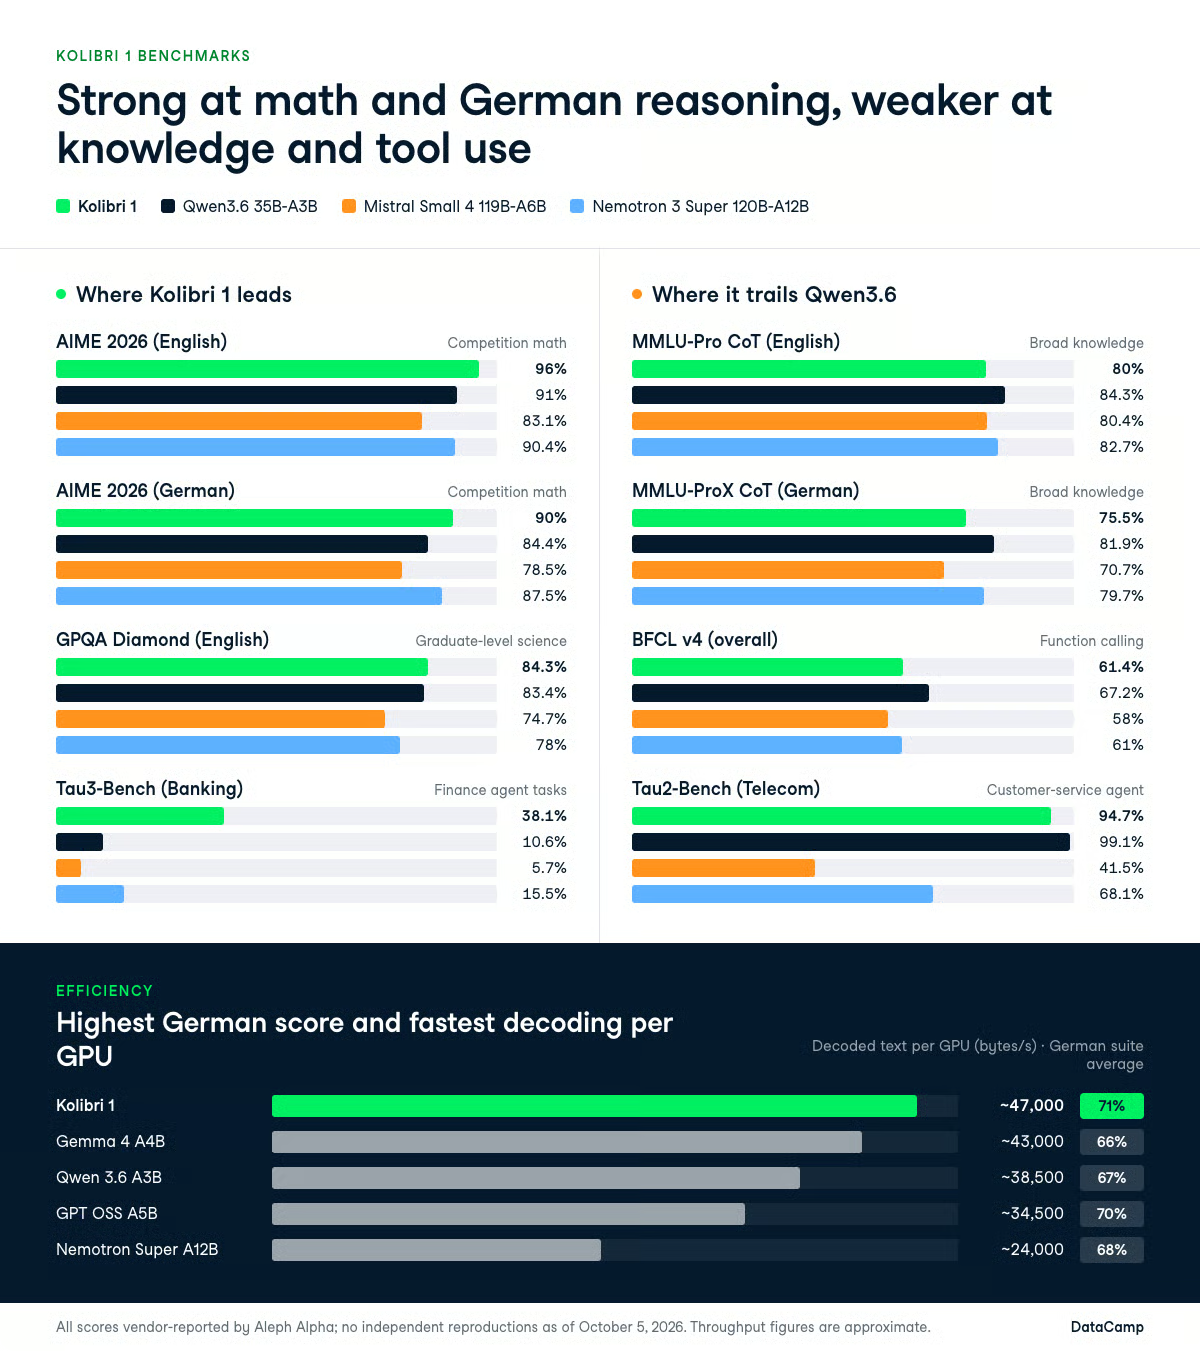
Kolibri 1, Alman kıyaslama setinde ortalama %71 alırken GPU başına saniyede yaklaşık 47.000 bayt metin çözümler; Nemotron Super A12B ise yaklaşık 24.000 bayt/s hızda %68 alır.
Modelin bilgi kesim tarihi her iki dil için de 18 Haziran 2026'dır ve yalnızca metin tabanlıdır; görüntü, ses veya video girdi/çıktısı yoktur.
Almanca yeteneğin nereden geldiğini görmek isterseniz, yayımlanan veri karması açık-ağırlıklı bir sürüm için alışılmadık derecede şeffaftır.
| Alan | Ön eğitim | Orta eğitim | Uzun bağlam uzatması |
|---|---|---|---|
| İngilizce web ve dokümanlar | 43,4% | 1,3% | 15,8% |
| Almanca web ve dokümanlar | 23,4% | 2,1% | 2,6% |
| Kod | 13,6% | 16,3% | 13,2% |
| Aracısal kod ve araç kullanımı | ~0% | 15,4% | 5,6% |
| OCR ile dönüştürülmüş PDF'ler | 0% | 0% | 33,3% |
Tablo yalnızca web, kod, aracısal ve PDF satırlarını gösteriyor. Model kartında ayrıca İngilizce ve Almanca yönerge ve akıl yürütme verileri, STEM dokümanları, Soru-Cevap ve uzmanlaşmış hukuk ile kamu sektörü verileri listeleniyor. İngilizce ve Almanca satırların tamamını saydığınızda, model kartı ön eğitim karmasını yaklaşık %62,5 İngilizce, %23,9 Almanca ve %13,6 kod olarak özetliyor.
Kolibri 1'i farklılaştıranların çoğu iki karara dayanıyor: Almancayı çeviriyle değil, düzgünce eğitmek ve aktif parametre sayısını tek bir H200'ün modeli sunabileceği kadar düşük tutmak.
Kolibri 1, beklenenden daha fazla ölçüde Almanca ile İngilizce arasındaki farkı daraltıyor; bu, bu boyutta açık-ağırlıklı bir model için alışılmadık.
Genel kıyaslama ortalaması İngilizce'de 75,5, Almanca'da 70,8.
Aleph Alpha, açgözlü aşağıdan yukarı birleştirmeleri koruyan ancak hangi birleştirmenin söz varlığına gireceğini seçmek için Unigram amacını kullanan UniBPE adlı yeni bir belirteçleyici algoritmayla 128.000 tokenlık bir söz varlığı eğitti.
Belirtilen kazanım, Almanca için 4,90 bayt/token sıkıştırma; GPT-5'in belirteçleyicisi 4,35 alıyor. İngilizce ise 4,58 bayt/token düzeyinde kalıyor (GPT-5'in belirteçleyicisi 4,67 elde ediyor).
Bu, kalite kadar maliyet açısından da önemlidir.
Daha iyi sıkıştırma, aynı Almanca doküman için daha az token demek; dolayısıyla 50 sayfalık bir Bescheid (resmî bir Alman idari tebligatı) işlemek için daha az maliyet ve bağlamda daha fazla alan anlamına gelir.
Ön eğitim karmasında Almanca %23,4 iken İngilizce web ve dokümanlar %43,4'tü; dolayısıyla bu yetenek, ana eğitim turundan sonra eklenen bir ince ayarla değil, doğrudan veriye yatırımla sağlandı.
Model 1.048.576 token ilan ediyor. 201B tokenlık bir uzun bağlam eğitim aşamasından sonra yerel olarak 262.144 tokenı kaldırıyor ve 1M'e ekstrapolasyonla uzanıyor; yani bu uzunlukta hiç eğitilmedi.
Aleph Alpha, sunum verimliliği için 262.144 token ve altını öneriyor. Çok uzun girdilere gömülü belirli ayrıntıları bulup kullanabilme testi olan RULER, temel model için bozulmayı gösteriyor: 128K'da 67,9 ve 1M'de 63,2; atıf yapılan Qwen3.5 35B-A3B Base sonucu 128K'da 89,9.
Adil olmak gerekirse, Kolibri'nin 1M skoru yine de o uzunlukta Nemotron 3 Nano'yu (58,5) ve Qwen3.5'i (57,5) geçiyor; yani daha düşük bir başlangıç noktasından daha az düşüş yaşıyor.
1M rakamını pratik bir bütçeden çok, teknik olarak erişilebilecek bir tavan olarak görürdüm.
Eğer alımlı üretim (RAG) hattınız, taranmış PDF'lerden metne (OCR) çevrilmiş 400K tokenı bir istemin içine doldurup modelin tek bir özel ayrıntıyı güvenilir şekilde bulmasını bekliyorsa, bağlanmadan önce test edin. Özellikle, uzun bağlam uzatması karmasının %33,3'ü OCR'lı PDF'lerden oluşuyordu; dolayısıyla taranmış doküman iş yükleri bariz hedef kullanım alanı.
Akıl yürütme modu, modelin cevaplamadan önce bir problemi adım adım işlemesi demektir; doğruluğu artırır ama daha çok token harcar.
Kolibri 1'de bu, ayrı bir model kademesi değil, sizin kontrol ettiğiniz bir anahtar; araç çağırma (modelin bir veritabanı sorgusu gibi harici bir işlevi veya API'ı çağırmaya karar vermesi) ise yerel olarak desteklenir.
Aleph Alpha, çok adımlı akıl yürütme, RAG, aracısal araç çağırma, kodlama ve iki dilli asistan işlerini hedef kullanımlar olarak listeliyor ve orta eğitim karmasında aracısal kod ile araç kullanımına, ön eğitimde neredeyse sıfırdan %15,4'e çıkarak yer verilmiş.
Tek bir RTX Pro 6000 iş istasyonu GPU'sunda modeli FP8'de çalıştıran bir kullanıcı anlatısı, saniyede yaklaşık 170 token ölçtü ve modelin epeyce token harcayarak muhakeme etme eğilimine dikkat çekti.
Gecikmeye duyarlı bir yolda akıl yürütmeyi varsayılan açık bırakırsanız bunun için bütçe ayırın.
Kolibri 1 sıfırdan eğitildi; dolayısıyla başka bir şirketin modelinin ince ayarı ya da kopyası değildir.
Bu, lisanslama ve içine tam olarak nelerin girdiğini bilmek açısından önemlidir.
Apache 2.0 ağırlıklarla birleştiğinde, Kolibri 1'i hava boşluklu (internetten tamamen ayrık) şekilde çalıştırabilir, ince ayar yapabilir ve kimseye sormadan ticari bir ürünün içine yerleştirebilirsiniz.
AB Yapay Zekâ Yasası ve Genel Amaçlı Yapay Zekâ (GPAI) Uygulama Kuralları, genel amaçlı modeller için — eğitim verisinin belgelenmesi dahil — AB'nin kurallarını belirler.
Aleph Alpha, Uygulama Kurallarının imzacısıdır ve eğitim verisi kaynaklarını, dekontaminasyon adımlarını (kıyaslama sorularını eğitim verisinden çıkarma) ve hak sahipleri için bir irtibat noktasını kapsayan ayrıntılı bir model kartı yayımlar; bunlar AB Yapay Zekâ Yasası uyumluluk incelemesinin talep edeceği belgelerdir.
Almanya ve daha geniş AB'deki kamu alıcıları için, çoğu zaman belirleyici olan bir kıyaslama farkı değil, bu evraktır.
Ayrıca, ABD'deki hiçbir laboratuvarın hızla kopyalayamayacağı kısım da budur.
Aleph Alpha'nın model kartı sınırlamaları açıkça listeliyor ve tedarik kararı öncesinde okumaya değerler:
Yüksek riskli her kurulum için, Aleph Alpha ek korkulukların ve (AB) 2024/1689 Yönetmeliğine uyumun gerektiğini belirtir.
Kolibri 1'in kıyaslama profili faydalı bir biçimde tek yanlı: yarışma matematiği ve Almanca akıl yürütmede belirtilen karşılaştırma setinin önünde; kapalı kitap bilgi, MMLU-Pro ve çoğu araç kullanımı paketinde Qwen3.6 35B-A3B'ye kaybediyor.
Aleph Alpha, Qwen3.6 35B-A3B, Mistral Small 4 119B-A6B ve Nemotron 3 Super 120B-A12B ile karşılaştırıyor.
Model kartı ayrıca, her token için tüm parametrelerini kullanan yoğun bir model olan Qwen3.8 27B'yi listeliyor; bu model, yaklaşık sekiz kat daha fazla aktif parametreyle (Kolibri'nin 70,8'ine karşı genel Almanca 79,9) her alanda daha yüksek puan alıyor.
Aşağıdaki tablolardan çıkardım, ama verimlilik iddialarını okurken akılda tutun.
Bu model adlarında, "A"den sonraki sayı token başına aktif parametreleri gösterir; dolayısıyla 35B-A3B, toplam 35B ve 3B aktif demektir. Aşağıdaki tablolarda yer alan kıyaslamalar şunları ölçer:
Matematik, Kolibri 1'in net biçimde önde olduğu alan.
AIME 2026 (EN)'de %96 alıyor; Qwen3.6 35B-A3B %91, Nemotron 3 Super %90,4 ve Mistral Small 4 %83,1 alıyor. AIME 2025 (EN)'de ise Kolibri 1 %96,9'a ulaşırken Qwen3.6 %84,6'da kalıyor.
GPQA Diamond (EN)'de %84,3'e karşı %83,4, Humanity's Last Exam (EN)'de %21,5'e karşı %21,1 alıyor; her ikisi de berabere denebilecek kadar yakın.
Aynı tablodaki zayıf nokta bilgi.
AA-Omniscience Endeksi (kamusal set) negatif sayıların yaygın olduğu ve yüksek skorun daha iyi olduğu bir ölçekte puanlanıyor. Kolibri 1, Qwen3.6 için -12,5 ve Mistral Small 4 için -24,0'a karşı -32,8'de kalıyor; yine de Nemotron 3 Super'ın -36,5'ini az farkla geçiyor. Ayrı bir AA-Omniscience doğruluk değeri %14,8 ile dört modelin en düşüğü.
Aynı kıyaslamadaki halüsinasyon yapmama oranı ise daha olumlu, %44,0; Nemotron (%13,9) ve Mistral'in (%34,7) önünde, ama Qwen3.6'nın (%56,7) gerisinde. Bu da Aleph Alpha'nın çekimserlik eğitimine uyuyor.
3,46B aktif parametreli bir modelin gerçekleri ezberlemek için sınırlı alanı vardır; bu yüzden kapalı kitap hatırlamaya güvenmek yerine geri getirimle (retrieval) eşleyin.
| Kıyaslama (EN) | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| AIME 2026 | %96 | %91 | %83,1 | %90,4 |
| AIME 2025 | %96,9 | %84,6 | %79,8 | %91,7 |
| GPQA Diamond | %84,3 | %83,4 | %74,7 | %78 |
| Humanity's Last Exam | %21,5 | %21,1 | %9,7 | %20,6 |
| MMLU-Pro CoT | %80 | %84,3 | %80,4 | %82,7 |
| AA-Omniscience Endeksi (yüksek daha iyi) | -32,8 | -12,5 | -24,0 | -36,5 |
Kolibri 1, Almanca matematik ve fen kıyaslamalarını alıyor ve Almanca bilgi kıyaslamalarını kaybediyor; bu da İngilizce profilinin aynısı.
AIME 2026 (DE)'de %90 alıyor; Qwen3.6 %84,4. GPQA Diamond (DE)'de %81,3'e karşı %80,6. MMLU-ProX CoT (DE)'de %75,5'e düşerken Qwen3.6 %81,9'a, Nemotron 3 Super %79,7'ye çıkıyor; Humanity's Last Exam (DE)'de ise Nemotron'un %22,3'üne karşı %15,9'da kalıyor.
Gerçekten ilginç bulduğum şey, İngilizce-Almanca farkının küçük olması.
Kolibri, AIME 2026'yı İngilizceden Almancaya taşıyınca 6 puan, GPQA Diamond'da 3 puan kaybediyor; bu da Almancayı yalnızca bir çeviri hedefi olarak gören bir modelden beklenenden daha dar bir düşüş.
| Kıyaslama (DE) | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| AIME 2026 | %90 | %84,4 | %78,5 | %87,5 |
| AIME 2025 | %87,5 | %82,9 | %72,3 | %85,6 |
| GPQA Diamond | %81,3 | %80,6 | %72,9 | %76,6 |
| MMLU-ProX CoT | %75,5 | %81,9 | %70,7 | %79,7 |
| Humanity's Last Exam | %15,9 | %20,5 | %10,5 | %22,3 |
Bu, sürümün en yumuşak kısmı.
BFCL v4 genelinde Kolibri 1 %61,4 alırken Qwen3.6 %67,2 alıyor; Tau2-Bench (Telekom)'da %94,7'ye karşı Qwen3.6 %99,1. Tau2-Bench (Havayolu)'nda ise Kolibri 1 %76,7 ile Qwen3.6'yı %70,7'ye karşı az farkla geçiyor.
Ayrı raporlanan BFCL v3 çok turlu değeri 39,8 puan (Qwen3.6 için 53,5) aynı zayıflığı gösteriyor: tekil araç çağrıları iyi, tekrarlanan araç gidiş-dönüşleriyle uzun konuşmalar iyi değil.
İstisna ise ters yönde.
Tau3-Bench (Bankacılık)'ta Kolibri 1 %38,1 alırken Qwen3.6 %10,6, Nemotron 3 Super %15,5 ve Mistral Small 4 yalnızca %5,7 alıyor. Bu, bu karşılaştırma setindeki bir sonraki en iyi modele kıyasla yaklaşık 2,5 kat (Qwen3.6'ya karşı 3,6 kat) fark demek; finans ağırlıklı bir ajan kıyaslamasında ve bu sonuç, bağımsız biçimde yeniden üretilmesini en çok isteyeceğim tek bulgu.
| Kıyaslama | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| Tau2-Bench (Telekom) | %94,7 | %99,1 | %41,5 | %68,1 |
| Tau2-Bench (Perakende) | %69,9 | %71,6 | %62,9 | %67,5 |
| Tau2-Bench (Havayolu) | %76,7 | %70,7 | %40 | %72,7 |
| Tau3-Bench (Bankacılık) | %38,1 | %10,6 | %5,7 | %15,5 |
| BFCL v4 (genel) | %61,4 | %67,2 | %58 | %61 |
Raporlanan kodlama sonuçları: LiveCodeBench v6'da 85,9; SWE-bench Verified'da 66,4; Terminal-Bench 2.1'de 27,7.
Ham kod üretimi güçlü görünüyor, ajan odaklı yazılım mühendisliği sıradan, Terminal-Bench skoru ise uzun, çok adımlı terminal işlerinin bu modelin hedefi olmadığını söylüyor.
Alıntılamadan önce okumanız gereken bir kontaminasyon uyarısı var.
Teknik rapor, İngilizce HumanEval değerlendirme verilerinin %48'inin ve Almanca HumanEval verilerinin %47'sinin eğitimle ilişkili materyallerde göründüğünü, bunun da HumanEval tarzı skorları şişirdiğini belirtiyor.
Karşılaştırma tablolarındaki paketlerin birkaçı tescilli veya sağlayıcı kaynaklı; bu da tam seti denetlemeyi zorlaştırıyor ve bu yazı yazıldığı sırada mevcut Claude, GPT veya Gemini amiral gemilerine karşı doğrulanmış birebir bir karşılaştırma bulunmuyordu.
Verimlilik iddiası, satıcı-raporu uyarısından en iyi şekilde kurtuluyor; çünkü bir skordan ziyade mimarinin bir niteliği.
Burada çıktı hacmi (throughput), modelin GPU başına saniyede ne kadar metin üretebildiği anlamına geliyor. Aleph Alpha bunu token yerine bayt cinsinden ölçüyor; böylece farklı tokenize edicilere sahip modeller adil biçimde karşılaştırılabiliyor.
Kolibri 1, Aleph Alpha'nın Almanca kıyas paketi üzerinde ortalama %71'de dururken GPU başına yaklaşık 47.000 bayt/sn hızla çözümlüyor. GPT OSS A5B yaklaşık 34.500 bayt/sn'de %70'e, Qwen 3.6 A3B yaklaşık 38.500'de %67'ye, Gemma 4 A4B yaklaşık 43.000'de %66'ya ve Nemotron Super A12B yaklaşık 24.000'de %68'e ulaşıyor.
Nemotron modeline göre GPU başına kabaca 2 kat daha fazla çözümlenmiş metni, daha yüksek bir Almanca ortalamayla sunmak, kendi altyapınızda Kolibri'yi seçmek için pratik bir argüman.
Token başına değil de kendi GPU'larınıza para ödüyorsanız, GPU başına çıktı hacmi faturada görünen sayıdır.
Kolibri 1 için yayımlanmış bir token fiyatı yok.
Aleph Alpha barındırılan bir API fiyat listesi yayımlamadı ve 5 Ekim 2026 itibarıyla resmi API belgelerinde doğrulanmış bir Kolibri API model kimliği görünmüyordu.
Kurumsal kurulum, Aleph Alpha satış ekibi üzerinden yürütülüyor ve Aleph-Alpha/Kolibri-1 depo tanımlayıcısı bir API model kimliği olarak değerlendirilmemeli.
Ağırlıklar Apache 2.0 altında ücretsiz, dolayısıyla maliyetiniz GPU süresi.
FP8 bellek ayak izi yaklaşık 78 GB; belirtilen minimumlar 2x A100 80 GB, 2x H100 SXM5, 1x H200, 1x B200 veya 1x B300; önerilen yapılandırma ise 2x H100 SXM5, 2x H200, 1x B200 veya 1x B300. Model önizleme değil, genel kullanıma açık; bekleme listesi veya bölge kilidi yok.
Kıyas olması açısından, GPT-6.1 Sol kapsamımız o modeli milyon token başına $2 giriş / $10 çıkışta konumlandırıyor. Üçüncü taraf bir fiyat özeti, daha eski GPT-5.6 Sol'u $5 / $30 ve GPT-5.6 Luna'yı 30 Temmuz'daki OpenAI fiyat indirimi sonrası $0,20 / $1,20 olarak listeliyor.
Kendi barındırmanız, birim ekonomisinde ancak hacminiz bir B200'ün sabit maliyetini aştığında kazanır.
Kolibri 1, Apache 2.0 altında açık ağırlıklıdır; bu da ticari kullanım, değiştirme ve yeniden dağıtıma kullanıcı veya gelir eşiği olmadan izin verir.
Ağırlıklar Hugging Face'te Aleph-Alpha/Kolibri-1 altında float8_e4m3fn biçiminde bulunuyor. Model kartı, yalnızca Aleph Alpha'nın aleph-alpha-inference eklentisini kullanarak vLLM üzerinden sunumu belgeliyor. Topluluk GGUF ve MLX yapıları birkaç gün içinde ortaya çıktı, ancak Aleph Alpha bunları doğrulamadı ve resmi bir Ollama girdisi bulamadım.
Sunulan bir dağıtım için, 1x H200 veya 1x B200, FP8 ağırlıkların ~78 GB'ını tek kartta tutar. H100'lerde --tensor-parallel-size 2 kullanın.
Özel olarak daha uzun bağlamları test etmediğiniz sürece --max-model-len değerini 262.144 veya altında tutun. Bunun ötesine geçmek, model kartında belgelenen ek bir --hf-overrides bayrağı gerektirir.
Eklentiyi kurun ve sunucuyu başlatın:
pip install 'aleph-alpha-inference>=1'

# Add --tensor-parallel-size 2 on 2x H100
vllm serve Aleph-Alpha/Kolibri-1 \
  --kv-cache-dtype fp8 \
  --max-model-len 262144 \
  --reasoning-parser kolibri1 \
  --tool-call-parser kolibri1 \
  --enable-auto-tool-choice
Ardından, Aleph Alpha'nın önerdiği örnekleme parametrelerini kullanarak (sıcaklık 1,0; top_p 0,97; top_k 128) OpenAI uyumlu API üzerinden sorgulayın:
from openai import OpenAI

client = OpenAI(base_url="http://localhost:8000/v1", api_key="EMPTY")

response = client.chat.completions.create(
    model="Aleph-Alpha/Kolibri-1",
    messages=[{
        "role": "user",
        "content": "Fasse die wichtigsten Fristen aus diesem Bescheid in drei Punkten zusammen.",
    }],
    temperature=1.0,
    top_p=0.97,
    max_tokens=512,
    extra_body={
        "top_k": 128,
        "chat_template_kwargs": {"reasoning_effort": "medium"},
    },
)
print(response.choices[0].message.content)
Akıl yürütme çabası low, medium ve high değerlerini kabul eder; gecikme derinlikten daha önemliyse düşünmeyi tamamen kapatabilirsiniz.
Çıktılar, örnekleme parametrelerine göre değişecektir; model kartı, örnekleme devre dışı bırakıldığında bile hafif sapmalar olabileceğini belirtiyor.
Kendi barındırdığınız çıkarım ve ajan döngülerinde daha derin kurulum için, doğrudan aktarılabilen araç izni ve yönlendirme kalıplarını ele alan göç ajanı oluşturmaya dair API eğitimimizi inceleyin.
Kolibri, sözde bir “egemen yapay zekâ”; yani bir ülke veya kuruluş, yapay zekâsını kendi altyapısında ve kendi yargı yetkisi altında, yabancı bir sağlayıcının API'sine, fiyatlandırmasına veya hizmet koşullarına bağlı kalmadan çalıştırabilir, denetleyebilir ve kontrol edebilir. Kolibri 1 için bu argüman, çevrimdışı (internete kapalı) çalıştırabileceğiniz Apache 2.0 ağırlıklara, Avrupa’daki eğitim altyapısına ve AB Yapay Zekâ Yasası dokümantasyonuna dayanıyor.
Bununla birlikte, bu lansmanın arkasında iki kurumsal bağlam unsuru var.
Aleph Alpha, Kanada şirketi Cohere ile bağlayıcı bir birleşme anlaşması imzaladı ve bunu ilk transatlantik egemen yapay zekâ çözümü olarak tanımlıyorlar.
Birleşik şirket Cohere adı altında faaliyet gösterecek; Toronto ve Berlin çift genel merkez olacak, Heidelberg araştırma merkezi olarak devam edecek. Anlaşmanın hâlâ düzenleyici onaya ihtiyacı var.
Bir egemenlik söylemi, modele sahip olanların onu desteklemeye devam etmesine bağlıdır ve birleşme tamamlandığında Aleph Alpha markası Cohere içinde kaybolmaya adaydır; bu nedenle her iki unsur da kıyaslamalarla birlikte takip edilmeye değer.
Aleph Alpha, egemenliğin, Apache 2.0 lisanslamasının ve belgelenmiş AB Yapay Zekâ Yasası uyumunun, Avrupa kamu sektörü alıcıları için MMLU-Pro’da birkaç puandan daha önemli olduğuna bahis oynuyor.
Bu bahis makul görünüyor ve şirketin Cohere ile birleşmesi, yalnızca ölçekle kazanamayacağını bildiğini gösteriyor.
Bence Kolibri 1’in, bu aktif parametre boyutunda şimdiye dek bu kadar iyi belgelendiğini gördüğümüz en iyi Almanca açık ağırlık model olduğu söylenebilir; ama uzun, çok turlu ajan çalışmaları veya kapalı kitap olgusal hatırlama gerektiğinde seçeceğim model bu olmaz.
Karşılaştırılabilir küçük-aktif MoE modeller arasında Qwen3.6 35B-A3B hâlâ bu yarışı kazanıyor. Yoğun 27B bir modeli karşılayabiliyorsanız, Qwen3.8 27B yarışı doğrudan kazanır.
Bu tür modelleri çalıştırma ve değerlendirme konusunda hız kazanmak istiyorsanız, AI Fundamentals beceri yolumuz ile başlayın.
En İyi DataCamp Kursları
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.