Курс
Разработка с помощью ИИ: курс для разработчиков
1 ч 30 мин
10.5K
Новых игроков в гонке LLM давно не было. Но 3 октября Aleph Alpha выложила свою новую модель Kolibri 1 на Hugging Face под лицензией Apache 2.0 и призвала Европу серьёзно относиться к суверенному ИИ.
Идея в том, что правительства и компании в Европе могут запускать сильную модель на собственном оборудовании, даже полностью офлайн, вместо зависимости от API американского провайдера.
Kolibri 1 — это модель класса mixture-of-experts (MoE) с 78B суммарных параметров и 3,46B активных на токен. Её с нуля обучила команда Aleph Alpha Research на 768 NVIDIA B200 в дата-центрах Германии и Финляндии.
Она работает только с немецким и английским, поддерживает контекстное окно на 1 048 576 токенов (Aleph Alpha рекомендует держаться на уровне 262 144 токенов или ниже для эффективности сервинга) и выходит сразу в статусе GA, а не превью. Предобучение охватило 20 трлн токенов, затем 3,44 трлн на среднем этапе обучения и 201 млрд для расширения длинного контекста.
В этой статье разберём всё новое в Kolibri 1: ключевые особенности, бенчмарки и реальные затраты на запуск.
Kolibri 1 — специализированная двуязычная большая языковая модель (LLM) от Aleph Alpha, выпущенная 3 октября 2026 года под Apache 2.0. Это одна модель в статусе GA, без меньших или больших «соседей».
Под капотом — 50‑слойный трансформер mixture-of-experts.
В каждом слое — 384 небольших специализированных подсети‑эксперта, а роутер отправляет каждый токен только к 6 из них, плюс 1 общий эксперт всегда активен. Так 78,1B общих параметров сводятся к 3,46B активным на токен (около 4,4%), и модель изначально спроектирована под дешёвый сервинг, а не под максимальную ёмкость.
Ещё два архитектурных решения держат скорость высокой, а потребление памяти — низким:
Главный акцент Aleph Alpha делает на эффективности, а не на «сырой» мощности.
Kolibri 1 в среднем набирает 71% на своём наборе немецких бенчмарков, декодируя примерно 47 000 байт/с текста на GPU, против 68% и около 24 000 байт/с у Nemotron Super A12B.
Край знания модели — 18 июня 2026 года для обоих языков. Модальность — только текст: без изображений, аудио или видео на вход/выход.
Если хотите понять, откуда у неё берётся сила в немецком, опубликованная смесь данных на редкость прозрачна для релиза с открытыми весами.
| Домен | Предобучение | Средний этап | Расширение длинного контекста |
|---|---|---|---|
| Англоязычный веб и документы | 43,4% | 1,3% | 15,8% |
| Немецкий веб и документы | 23,4% | 2,1% | 2,6% |
| Код | 13,6% | 16,3% | 13,2% |
| Агентный код и использование инструментов | ~0% | 15,4% | 5,6% |
| OCR‑копии PDF | 0% | 0% | 33,3% |
Таблица показывает только строки про веб, код, агентный компонент и PDF. В карточке модели также указаны обучающие и рассуждательные данные на английском и немецком, документы STEM, QA, а также специализированные юридические и госданные. Если сложить все англоязычные и немецкие строки, карточка суммирует предобучение как примерно 62,5% английского, 23,9% немецкого и 13,6% кода.
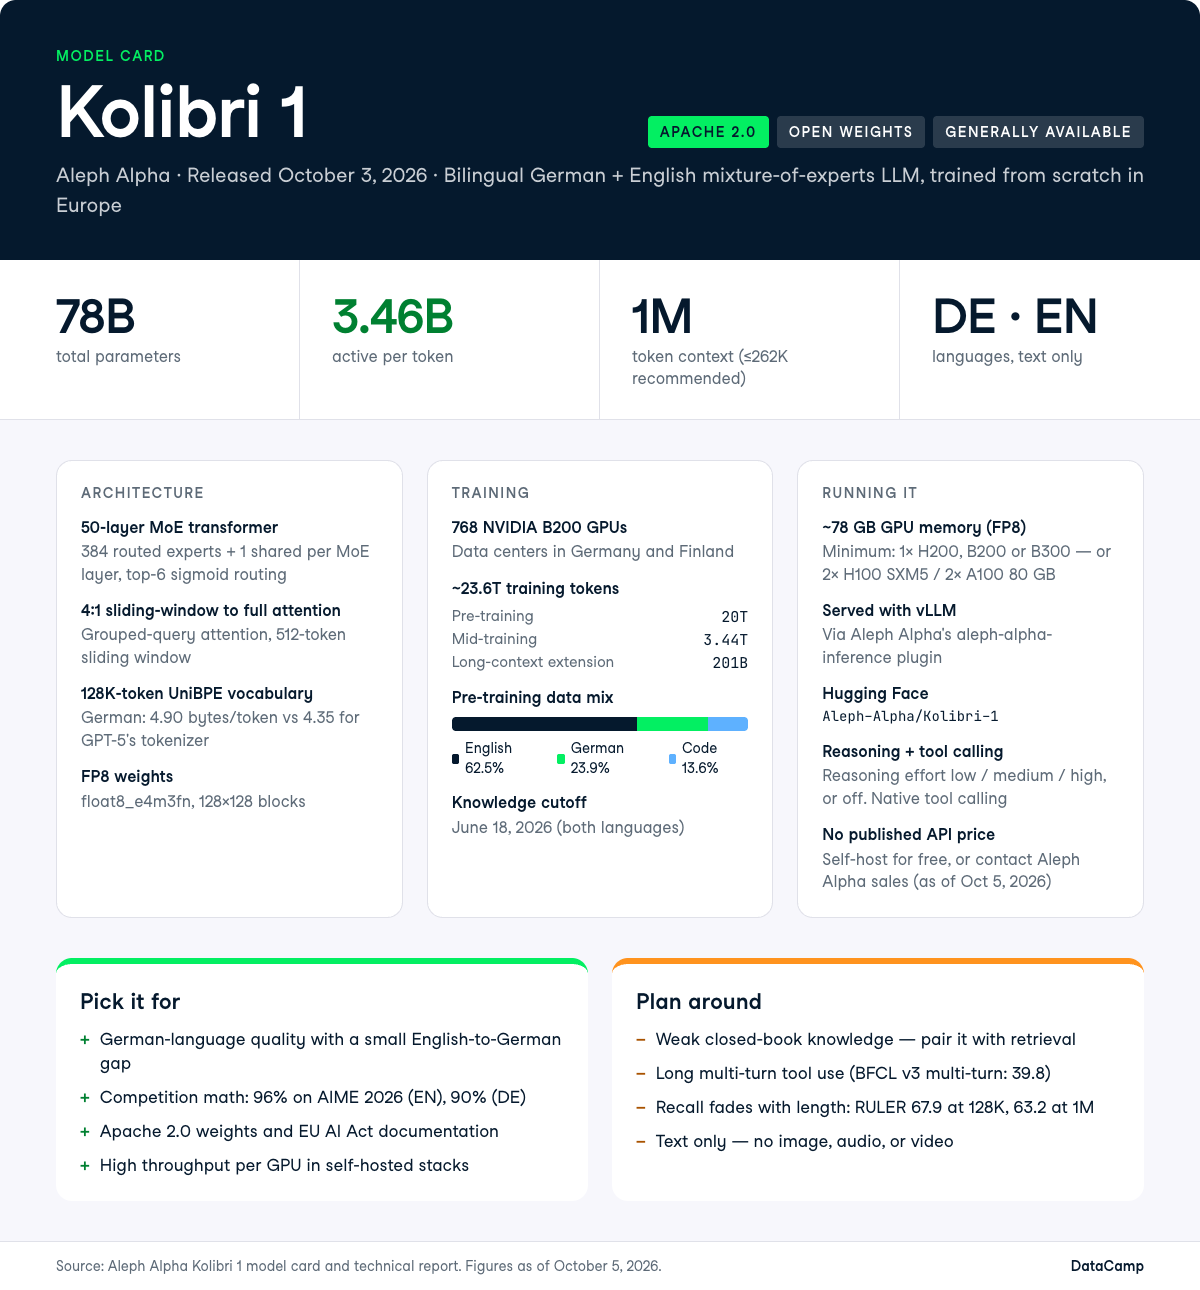
Главные отличия Kolibri 1 сводятся к двум решениям: нормально обучить немецкий, а не переводить его постфактум, и держать число активных параметров настолько низким, чтобы один H200 справлялся с обслуживанием.
Kolibri 1 сильнее, чем ожидаешь, сокращает разрыв между немецким и английским — что необычно для модели с открытыми весами такого размера.
Её средний результат по бенчмаркам — 75,5 для английского и 70,8 для немецкого.
Aleph Alpha обучила словарь на 128 000 токенов с новым алгоритмом токенизации UniBPE, который сохраняет жадные снизу‑вверх слияния из byte-pair encoding, но выбирает, какие слияния войдут в словарь, по целевой функции Unigram.
Заявленный выигрыш — компрессия немецкого 4,90 байта/токен против 4,35 у токенизатора GPT‑5, при этом английский — 4,58 байта/токен (токенизатор GPT‑5 даёт 4,67).
Это важно и для качества, и для стоимости.
Лучшая компрессия — меньше токенов для одного и того же немецкого документа, так что 50‑страничный Bescheid (официальное административное уведомление в Германии) дешевле в обработке и оставляет больше места в контексте.
Немецкий составил 23,4% смеси предобучения против 43,4% для англоязычного веба и документов, то есть способность оплачена данными, а не дообучением «сверху» после основного прогона.
Модель заявляет 1 048 576 токенов. Нативно она держит 262 144 токена после этапа обучения на 201 млрд токенов для длинного контекста и растягивается до 1M за счёт экстраполяции, то есть на такой длине её не обучали.
Сама Aleph Alpha рекомендует держаться на уровне 262 144 токенов или ниже для эффективного сервинга. Тест RULER, который проверяет, может ли модель находить и использовать конкретные детали в очень длинных входах, показывает деградацию для базовой модели: 67,9 на 128K и 63,2 на 1M против указанного результата Qwen3.5 35B-A3B Base 89,9 на 128K.
Справедливости ради, показатель Kolibri на 1M всё же обходит Nemotron 3 Nano (58,5) и Qwen3.5 (57,5) на этой длине, то есть модель проседает меньше, хотя и стартует ниже.
Относитесь к цифре 1M как к техническому потолку, а не к рабочему бюджету.
Если ваша RAG‑система набивает подсказку 400K токенами отсканированных PDF, конвертированных в текст (OCR), и ждёт, что модель надёжно найдёт одну конкретную деталь, протестируйте это до внедрения. Показательно, что 33,3% смеси для длинного контекста — это OCR‑копии PDF, так что задачи со сканами явно целевой сценарий.
Режим рассуждения означает, что модель проходит задачу шаг за шагом перед ответом — это повышает точность, но расходует больше токенов.
В Kolibri 1 это управляемый переключатель, а не отдельный тариф модели, и вызов инструментов (когда модель решает обратиться к внешней функции или API, например к БД) реализован нативно.
Aleph Alpha заявляет целевыми сценариями многошаговое рассуждение, RAG, агентные вызовы инструментов, программирование и двуязычную ассистентскую работу, а на среднем этапе обучения 15,4% смеси ушло на агентный код и инструменты — с почти нуля на предобучении.
Один пользователь в рабочей станции с одной RTX Pro 6000 и FP8 сообщил около 170 токенов в секунду и заметил склонность модели тратить много токенов на рассуждение.
Закладывайте это в бюджет, если держите рассуждение включённым по умолчанию в чувствительном к задержкам тракте.
Kolibri 1 обучена с нуля, это не дообучение и не копия чужой модели.
Это важно и для лицензирования, и для понимания, из чего она сделана.
В сочетании с весами Apache 2.0 это означает, что вы можете запускать Kolibri 1 в изолированной среде (полностью без интернета), дообучать её и встраивать в коммерческий продукт без чьих-либо разрешений.
Регламент об ИИ ЕС (EU AI Act) и Кодекс практики для ИИ общего назначения (GPAI) определяют правила ЕС для моделей общего назначения, включая документацию по обучающим данным.
Aleph Alpha подписала Кодекс практики и публикует подробную карточку модели с источниками обучающих данных, шагами деконтаминации (удаление бенчмарков из обучающей выборки) и контактами для правообладателей — это та документация, которую запросят при проверке на соответствие EU AI Act.
Для закупок в госсекторе Германии и ЕС именно «бумаги» часто важнее разницы в бенчмарках.
И это как раз то, что ни одна лаборатория из США быстро не повторит.
В карточке модели Aleph Alpha честно перечисляет ограничения — их важно прочитать до закупки:
Для развёртываний с высокой ставкой Aleph Alpha указывает на необходимость дополнительных ограничителей и соответствия Регламенту (ЕС) 2024/1689.
Профиль Kolibri 1 неравномерен, но полезен: она лидирует в своей группе по соревновательной математике и немецкому рассуждению и уступает Qwen3.6 35B-A3B в закрытых знаниях, MMLU-Pro и большинстве наборов по использованию инструментов.
Aleph Alpha сравнивает с Qwen3.6 35B-A3B, Mistral Small 4 119B-A6B и Nemotron 3 Super 120B-A12B.
В карточке модели также указан Qwen3.8 27B — плотная модель (которая использует все параметры на каждый токен, в отличие от MoE), дающая более высокие результаты по всем метрикам (общий немецкий 79,9 против 70,8 у Kolibri) примерно при восьмикратном росте активных параметров.
В таблицы ниже его не включаем, но держите это в уме, читая заявления об эффективности.
В этих названиях моделей число после «A» — это активные параметры на токен, так что 35B-A3B значит 35B всего и 3B активных. Ниже — что именно измеряют бенчмарки в таблицах:
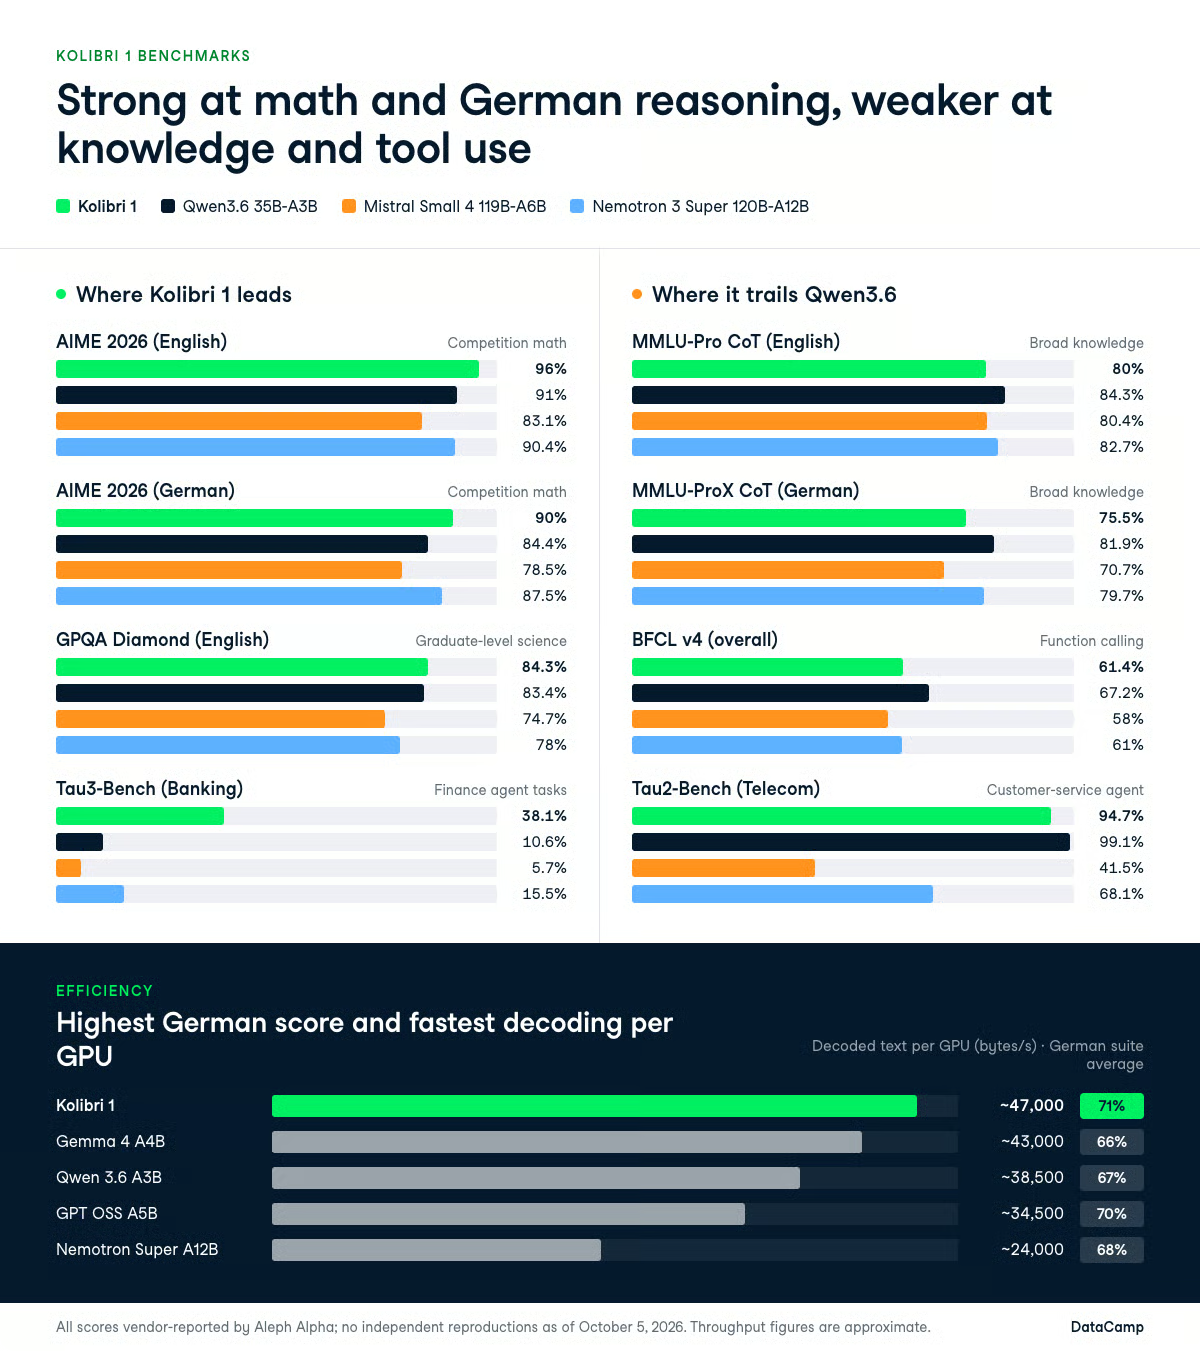
Математика — это то, где Kolibri 1 явно впереди.
Она набирает 96% на AIME 2026 (EN) против 91% у Qwen3.6 35B-A3B, 90,4% у Nemotron 3 Super и 83,1% у Mistral Small 4, а на AIME 2025 (EN) — 96,9% против 84,6% у Qwen3.6.
На GPQA Diamond (EN) результат 84,3% против 83,4%, а на Humanity's Last Exam (EN) 21,5% против 21,1% — оба достаточно близки, чтобы считать ничьей.
Слабое место в той же таблице — знание фактов.
AA-Omniscience Index (публичный набор) оценивается по шкале, где отрицательные числа встречаются часто, а выше — лучше. Kolibri 1 показывает -32,8 против -12,5 у Qwen3.6 и -24,0 у Mistral Small 4, хотя чуть опережает -36,5 у Nemotron 3 Super. Отдельная метрика точности AA-Omniscience составляет 14,8%, самый низкий показатель из четырёх моделей.
Доля «не-галлюцинаций» на том же бенчмарке выглядит приятнее — 44,0%, впереди Nemotron (13,9%) и Mistral (34,7%), но позади Qwen3.6 (56,7%), что согласуется с обучением Aleph Alpha на воздержание от ответов.
У модели с 3,46 млрд активных параметров мало места для запоминания фактов, поэтому лучше сочетать её с извлечением знаний, а не полагаться на «закрытую книгу».
| Бенчмарк (EN) | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| AIME 2026 | 96% | 91% | 83,1% | 90,4% |
| AIME 2025 | 96,9% | 84,6% | 79,8% | 91,7% |
| GPQA Diamond | 84,3% | 83,4% | 74,7% | 78% |
| Humanity's Last Exam | 21,5% | 21,1% | 9,7% | 20,6% |
| MMLU-Pro CoT | 80% | 84,3% | 80,4% | 82,7% |
| AA-Omniscience Index (выше — лучше) | -32,8 | -12,5 | -24,0 | -36,5 |
Kolibri 1 выигрывает немецкие бенчмарки по математике и естественным наукам и уступает по знаниям, что повторяет её профиль на английском.
Она набирает 90% на AIME 2026 (DE) против 84,4% у Qwen3.6 и 81,3% на GPQA Diamond (DE) против 80,6%. На MMLU-ProX CoT (DE) результат падает до 75,5%, тогда как Qwen3.6 достигает 81,9%, а Nemotron 3 Super — 79,7%, а на Humanity's Last Exam (DE) — 15,9% против 22,3% у Nemotron.
Что действительно интересно — небольшой разрыв между английским и немецким.
Kolibri теряет 6 пунктов при переходе AIME 2026 с английского на немецкий и 3 пункта на GPQA Diamond — падение меньше ожидаемого для модели, которая воспринимает немецкий как язык перевода.
| Бенчмарк (DE) | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| AIME 2026 | 90% | 84,4% | 78,5% | 87,5% |
| AIME 2025 | 87,5% | 82,9% | 72,3% | 85,6% |
| GPQA Diamond | 81,3% | 80,6% | 72,9% | 76,6% |
| MMLU-ProX CoT | 75,5% | 81,9% | 70,7% | 79,7% |
| Humanity's Last Exam | 15,9% | 20,5% | 10,5% | 22,3% |
Это самая мягкая часть релиза.
В BFCL v4 в целом Kolibri 1 набирает 61,4% против 67,2% у Qwen3.6, а на Tau2-Bench (Telecom) — 94,7% против 99,1% у Qwen3.6. На Tau2-Bench (Airline) она всё же опережает Qwen3.6 — 76,7% против 70,7%.
Отдельно сообщаемый показатель BFCL v3 для многоходовых диалогов — 39,8 пункта (53,5 у Qwen3.6) — показывает ту же слабость: одиночные вызовы инструментов даются хорошо, длинные разговоры с повторными циклами — нет.
Исключение — в другую сторону.
На Tau3-Bench (Banking) Kolibri 1 набирает 38,1%, тогда как Qwen3.6 — 10,6%, Nemotron 3 Super — 15,5%, а Mistral Small 4 — всего 5,7%. Это примерно 2,5-кратное преимущество над следующей лучшей моделью в этом наборе (3,6-кратное над Qwen3.6) на «финансовом» агентном бенчмарке, и это единственный результат релиза, воспроизведение которого независимо хотелось бы увидеть в первую очередь.
| Бенчмарк | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| Tau2-Bench (Telecom) | 94,7% | 99,1% | 41,5% | 68,1% |
| Tau2-Bench (Retail) | 69,9% | 71,6% | 62,9% | 67,5% |
| Tau2-Bench (Airline) | 76,7% | 70,7% | 40% | 72,7% |
| Tau3-Bench (Banking) | 38,1% | 10,6% | 5,7% | 15,5% |
| BFCL v4 (в целом) | 61,4% | 67,2% | 58% | 61% |
Заявленные результаты по коду: 85,9 на LiveCodeBench v6, 66,4 на SWE-bench Verified и 27,7 на Terminal-Bench 2.1.
Генерация «сырого» кода выглядит сильной, агентная разработка — обычной, а показатель Terminal-Bench указывает, что длительная многошаговая работа в терминале — не про эту модель.
Есть оговорка о возможной утечке тестов, с которой стоит ознакомиться, прежде чем цитировать эти результаты.
В техническом отчёте отмечено, что 48% английских и 47% немецких данных оценки HumanEval присутствовали в материалах, связанных с обучением, что завышает показатели стиля HumanEval.
Несколько наборов в сравнительных таблицах являются проприетарными или созданными вендорами, из‑за чего весь комплект сложно аудитировать, и на момент написания не существовало проверенного сопоставления «один к одному» с текущими флагманами Claude, GPT или Gemini.
Заявление об эффективности лучше других переживает оговорку о вендорской отчётности, потому что это свойство архитектуры, а не оценка.
Здесь под пропускной способностью понимается, сколько текста модель может генерировать на один GPU в секунду. Aleph Alpha измеряет её в байтах, а не в токенах, чтобы можно было корректно сравнивать модели с разными токенизаторами.
Kolibri 1 показывает в среднем 71% на немецком наборе бенчмарков Aleph Alpha при декодировании примерно 47 000 байт/с на GPU. GPT OSS A5B достигает 70% при около 34 500 байт/с, Qwen 3.6 A3B — 67% при около 38 500, Gemma 4 A4B — 66% при около 43 000, а Nemotron Super A12B — 68% при около 24 000.
Выдавать примерно в 2 раза больше декодированного текста на GPU, чем модель Nemotron, при более высоком среднем результате на немецком — это практический аргумент в пользу выбора Kolibri в саморазвёртываемом стеке.
Если вы платите за собственные GPU, а не за токены, пропускная способность на GPU — это число, которое превращается в сумму в счёте.
Опубликованной цены за токены для Kolibri 1 нет.
Aleph Alpha не выпустила прайс‑лист на размещённый API, и подтверждённого ID модели Kolibri для API в официальной документации на 5 октября 2026 года не было.
Корпоративные внедрения идут через отдел продаж Aleph Alpha, а идентификатор репозитория Aleph-Alpha/Kolibri-1 не следует считать ID модели для API.
Сами веса бесплатны по лицензии Apache 2.0, так что ваша стоимость — это время GPU.
Память для FP8 — около 78 ГБ; заявлен минимум: 2× A100 80 ГБ, 2× H100 SXM5, 1× H200, 1× B200 или 1× B300; рекомендуемая конфигурация: 2× H100 SXM5, 2× H200, 1× B200 или 1× B300. Модель общедоступна, не превью, без листа ожидания и региональных ограничений.
Для понимания альтернатив: наш обзор GPT-6.1 Sol оценивает ту модель в $2 за вход / $10 за выход за миллион токенов. Сводка цен стороннего источника указывает, что более старая GPT-5.6 Sol стоит $5 / $30, а GPT-5.6 Luna — $0,20 / $1,20 после снижения цен OpenAI 30 июля.
Самостоятельный хостинг выигрывает по юнит‑экономике только после того, как объём перекроет фиксированную стоимость B200.
Kolibri 1 — модель с открытыми весами под Apache 2.0, что допускает коммерческое использование, модификацию и распространение без порогов по пользователям или выручке.
Веса размещены на Hugging Face в Aleph-Alpha/Kolibri-1 в формате float8_e4m3fn. Карточка модели описывает развёртывание только через vLLM с использованием плагина Aleph Alpha aleph-alpha-inference. Сообществом были выпущены сборки GGUF и MLX в течение нескольких дней, но Aleph Alpha их не валидировала, и официальной записи для Ollama найти не удалось.
Для сервируемого развёртывания 1× H200 или 1× B200 помещает ~78 ГБ весов FP8 на одну карту. На H100 используйте --tensor-parallel-size 2.
Держите --max-model-len на уровне 262 144 или ниже, если только вы специально не тестировали более длинные контексты. Выход за пределы требует дополнительного флага --hf-overrides, который описан в карточке модели.
Установите плагин и запустите сервер:
pip install 'aleph-alpha-inference>=1'

# Add --tensor-parallel-size 2 on 2x H100
vllm serve Aleph-Alpha/Kolibri-1 \
  --kv-cache-dtype fp8 \
  --max-model-len 262144 \
  --reasoning-parser kolibri1 \
  --tool-call-parser kolibri1 \
  --enable-auto-tool-choice
Затем отправляйте запросы через совместимый с OpenAI API, используя рекомендуемые Aleph Alpha параметры сэмплирования (temperature 1.0, top_p 0.97, top_k 128):
from openai import OpenAI

client = OpenAI(base_url="http://localhost:8000/v1", api_key="EMPTY")

response = client.chat.completions.create(
    model="Aleph-Alpha/Kolibri-1",
    messages=[{
        "role": "user",
        "content": "Fasse die wichtigsten Fristen aus diesem Bescheid in drei Punkten zusammen.",
    }],
    temperature=1.0,
    top_p=0.97,
    max_tokens=512,
    extra_body={
        "top_k": 128,
        "chat_template_kwargs": {"reasoning_effort": "medium"},
    },
)
print(response.choices[0].message.content)
Параметр reasoning effort принимает значения low, medium и high, а рассуждение можно совсем отключить, если латентность важнее глубины.
Выводы будут варьироваться в зависимости от параметров сэмплирования, и в карточке модели отмечено, что расхождения возможны даже при отключённом сэмплинге.
Для более глубокой настройки само-хостингового инференса и агентных циклов наш API‑туториал по созданию миграционного агента покрывает паттерны разрешений на инструменты и управления, которые переносятся напрямую.
Kolibri 1 номинально является «суверенным ИИ», то есть страна или организация может запускать, аудировать и контролировать свой ИИ на собственной инфраструктуре и в своей юрисдикции, не полагаясь на API, цены или условия использования зарубежного провайдера. Для Kolibri 1 эта позиция опирается на веса Apache 2.0, которые можно запускать в «air‑gapped» (без доступа к интернету) среде, европейскую инфраструктуру обучения и документацию по соответствию EU AI Act.
Однако за запуском стоят два корпоративных контекста.
Aleph Alpha подписала обязывающее соглашение о слиянии с канадской компанией Cohere для формирования, как они описывают, первого трансатлантического решения суверенного ИИ.
Объединённая компания будет работать под брендом Cohere с двумя штаб‑квартирами — в Торонто и Берлине, а Гейдельберг останется исследовательским центром. Сделка ещё нуждается в одобрении регуляторов.
Заявка на суверенность зависит от того, что владелец модели продолжит её поддерживать, а бренд Aleph Alpha должен исчезнуть в Cohere после закрытия сделки, так что обе темы стоит отслеживать наряду с бенчмарками.
Aleph Alpha делает ставку на то, что суверенность, лицензирование Apache 2.0 и оформленное соответствие EU AI Act важнее для европейских заказчиков из госсектора, чем несколько пунктов на MMLU-Pro.
Ставка выглядит разумной, а слияние с Cohere показывает понимание, что победить за счёт одного масштаба не получится.
Справедливо сказать, что Kolibri 1 — лучшая немецкоязычная модель с открытыми весами при таком размере активных параметров, которую мы видели с настолько подробной документацией, но это не та модель, к которой стоило бы обращаться для длительных многоходовых агентных запусков или «закрытого» воспроизведения фактов.
Среди сопоставимых небольших активных MoE‑моделей Qwen3.6 35B-A3B всё ещё выигрывает. Если вы можете позволить себе плотную 27B‑модель, Qwen3.8 27B побеждает безоговорочно.
Чтобы быстро войти в тему запуска и оценки таких моделей, начните с нашего трека навыков AI Fundamentals.
Лучшие курсы DataCamp
Курс
Курс
Курс