คอร์ส
การเขียนโค้ดด้วยความช่วยเหลือของ AI สำหรับนักพัฒนา
1 ชม. 30 นาที
10.5K
นานพอสมควรแล้วที่ยังไม่ค่อยเห็นบริษัทใหม่กระโดดเข้าสู่สนาม LLM แต่เมื่อวันที่ 3 ตุลาคม Aleph Alpha ได้นำโมเดลใหม่ชื่อ Kolibri 1 ขึ้นบน Hugging Face ภายใต้สัญญาอนุญาต Apache 2.0 และเรียกร้องให้ยุโรปให้ความสำคัญกับ AI ที่ควบคุมได้เองในภูมิภาค
สาระสำคัญคือ รัฐบาลและบริษัทในยุโรปสามารถรันโมเดลที่มีความสามารถบนฮาร์ดแวร์ของตนเองได้ แม้กระทั่งออฟไลน์เต็มรูปแบบ โดยไม่ต้องพึ่งพา API จากผู้ให้บริการในสหรัฐฯ
Kolibri 1 เป็นโมเดลแบบ mixture-of-experts (MoE) ที่มีพารามิเตอร์รวม 78B และใช้งานต่อโทเคน 3.46B ฝึกจากศูนย์โดย Aleph Alpha Research บน NVIDIA B200 จำนวน 768 ตัว ในดาต้าเซ็นเตอร์ที่เยอรมนีและฟินแลนด์
รองรับเพียงภาษาเยอรมันและอังกฤษ มีหน้าต่างบริบท 1,048,576 โทเคน (Aleph Alpha แนะนำให้ใช้อยู่ที่หรือต่ำกว่า 262,144 โทเคนเพื่อประสิทธิภาพในการเสิร์ฟ) และออกมาเป็นรุ่น GA ไม่ใช่พรีวิว การพรีเทรนรวม 20 ล้านล้านโทเคน ตามด้วย mid-training 3.44T และ 201B สำหรับการขยายบริบทยาว
ในบทความนี้จะสรุปสิ่งใหม่ทั้งหมดของ Kolibri 1 ตั้งแต่คุณสมบัติเด่น เจาะบेंชมาร์ก ไปจนถึงต้นทุนจริงในการรัน
Kolibri 1 คือโมเดลภาษาขนาดใหญ่ (LLM) แบบสองภาษาที่เชี่ยวชาญของ Aleph Alpha เปิดตัวเมื่อ 3 ตุลาคม 2026 ภายใต้ Apache 2.0 เป็นโมเดลเดียวที่ออก GA โดยไม่มีรุ่นเล็กหรือใหญ่กว่านี้
ภายในเป็นทรานส์ฟอร์เมอร์แบบ mixture-of-experts จำนวน 50 เลเยอร์
แต่ละเลเยอร์มีซับเน็ตเวิร์กผู้เชี่ยวชาญขนาดเล็ก 384 ตัว และมีตัวนำทาง (router) ที่ส่งโทเคนแต่ละตัวไปยังผู้เชี่ยวชาญเพียง 6 ตัว บวกผู้เชี่ยวชาญส่วนกลางอีก 1 ตัวที่ทำงานเสมอ จึงทำให้พารามิเตอร์รวม 78.1B เหลือใช้งานต่อโทเคน 3.46B (ราว 4.4%) ออกแบบมาเพื่อประหยัดต้นทุนการเสิร์ฟมากกว่าความจุสูงสุด
ยังมีอีกสองทางเลือกเชิงออกแบบที่ช่วยให้เร็วและใช้หน่วยความจำน้อย:
ผลลัพธ์หลักที่ Aleph Alpha ผลักดันคือประสิทธิภาพ ไม่ใช่ความสามารถดิบ
Kolibri 1 ทำค่าเฉลี่ย 71% บนชุดบेंชมาร์กภาษาเยอรมัน พร้อมถอดรหัสข้อความราว 47,000 ไบต์/วินาที ต่อ GPU เทียบกับ 68% ที่ประมาณ 24,000 ไบต์/วินาที สำหรับ Nemotron Super A12B
โมเดลมีขอบเขตความรู้ถึงวันที่ 18 มิถุนายน 2026 สำหรับทั้งสองภาษา และเป็นแบบข้อความล้วน ไม่มีอินพุตหรือเอาต์พุตภาพ เสียง หรือวิดีโอ
หากอยากเห็นว่าความสามารถภาษาเยอรมันมาจากไหน ชุดข้อมูลที่เปิดเผยถือว่าโปร่งใสกว่าปกติสำหรับการปล่อยน้ำหนักเปิด
| โดเมน | พรีเทรน | มิดเทรน | ขยายบริบทยาว |
|---|---|---|---|
| เว็บและเอกสารภาษาอังกฤษ | 43.4% | 1.3% | 15.8% |
| เว็บและเอกสารภาษาเยอรมัน | 23.4% | 2.1% | 2.6% |
| โค้ด | 13.6% | 16.3% | 13.2% |
| โค้ดเชิงเอเจนต์และการใช้เครื่องมือ | ~0% | 15.4% | 5.6% |
| ไฟล์ PDF ที่ OCR แล้ว | 0% | 0% | 33.3% |
ตารางนี้แสดงเฉพาะแถวของเว็บ โค้ด เอเจนต์ และ PDF โมเดลการ์ดยังระบุข้อมูลคำสั่งและการให้เหตุผลภาษาอังกฤษและเยอรมัน เอกสารสายวิทยาศาสตร์และวิศวกรรม (STEM) คำถาม-คำตอบ และข้อมูลเฉพาะทางด้านกฎหมายและภาครัฐ เมื่อรวมทุกแถวภาษาอังกฤษและเยอรมัน โมเดลการ์ดสรุปสัดส่วนพรีเทรนโดยประมาณเป็น อังกฤษ 62.5% เยอรมัน 23.9% และโค้ด 13.6%
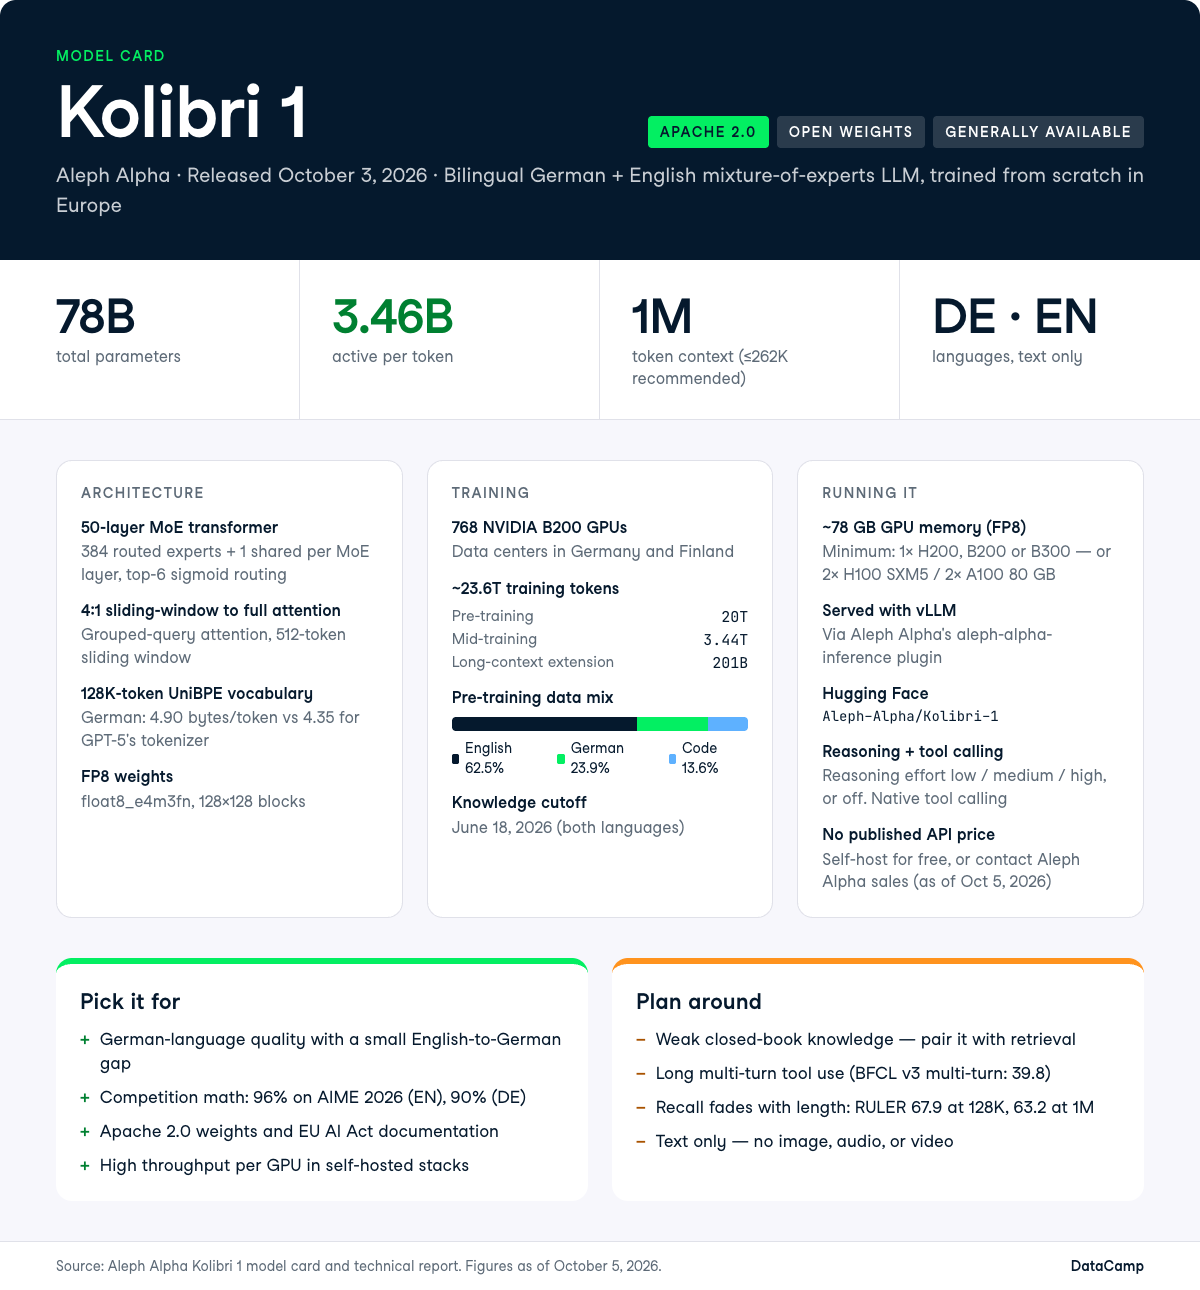
สิ่งที่ทำให้ Kolibri 1 แตกต่างส่วนใหญ่เกิดจากสองการตัดสินใจ: ฝึกฝั่งภาษาเยอรมันอย่างจริงจังแทนการแปล และคุมจำนวนพารามิเตอร์ใช้งานให้ต่ำพอที่ H200 ตัวเดียวจะเสิร์ฟได้
Kolibri 1 ลดช่องว่างระหว่างภาษาเยอรมันกับอังกฤษได้มากกว่าที่คาด ซึ่งไม่ค่อยเห็นบ่อยในโมเดลน้ำหนักเปิดขนาดนี้
ค่าเฉลี่ยบेंชมาร์กโดยรวมอยู่ที่ 75.5 ในภาษาอังกฤษ และ 70.8 ในภาษาเยอรมัน
Aleph Alpha ฝึกคำศัพท์ 128,000 โทเคนด้วยอัลกอริทึม tokenizer ใหม่ชื่อ UniBPE ที่คงขั้นตอนรวมหน่วยแบบ greedy จาก byte-pair encoding ไว้ แต่ใช้วัตถุประสงค์แบบ Unigram ในการเลือกว่าจะนำ merge ใดเข้าคลังคำศัพท์
ผลลัพธ์ที่ระบุคือการบีบอัดภาษาเยอรมันได้ 4.90 ไบต์/โทเคน เทียบกับ 4.35 ของ tokenizer ของ GPT-5 ขณะที่ภาษาอังกฤษอยู่ที่ 4.58 ไบต์/โทเคน (tokenizer ของ GPT-5 ได้ 4.67)
ประเด็นนี้สำคัญต่อทั้งต้นทุนและคุณภาพ
การบีบอัดที่ดีกว่าหมายถึงโทเคนน้อยลงสำหรับเอกสารเยอรมันชุดเดียวกัน ดังนั้น Bescheid 50 หน้า (หนังสือแจ้งทางปกครองอย่างเป็นทางการของเยอรมนี) จึงมีต้นทุนประมวลผลต่ำลงและเหลือพื้นที่บริบทมากขึ้น
ภาษาเยอรมันคิดเป็น 23.4% ของส่วนผสมพรีเทรน เทียบกับ 43.4% สำหรับเว็บและเอกสารภาษาอังกฤษ ดังนั้นความสามารถจึงมาจากข้อมูลฝึก ไม่ใช่การไฟน์จูนที่ยัดเพิ่มหลังจบการฝึกหลัก
โมเดลโฆษณาว่ารองรับ 1,048,576 โทเคน รองรับแบบ native ที่ 262,144 โทเคนหลังจากการฝึกบริบทยาว 201B โทเคน และยืดไปถึง 1M ด้วยการคาดขยาย (extrapolation) หมายความว่าไม่เคยถูกฝึกที่ความยาวนั้นจริง
Aleph Alpha เองแนะนำให้ใช้อยู่ที่หรือต่ำกว่า 262,144 โทเคนเพื่อประสิทธิภาพในการเสิร์ฟ RULER ซึ่งเป็นการทดสอบว่าโมเดลสามารถค้นหาและใช้รายละเอียดเฉพาะที่ซ่อนอยู่ในอินพุตยาวมากได้หรือไม่ แสดงการเสื่อมลงของรุ่นฐาน: 67.9 ที่ 128K และ 63.2 ที่ 1M เทียบกับผลอ้างอิง Qwen3.5 35B-A3B Base ที่ 89.9 ที่ 128K
อย่างไรก็ดี คะแนน 1M ของ Kolibri ยังชนะ Nemotron 3 Nano (58.5) และ Qwen3.5 (57.5) ที่ความยาวนั้น จึงเสื่อมน้อยกว่าคู่แข่งแม้ออกตัวจากฐานที่ต่ำกว่า
ควรมองตัวเลข 1M เป็นเพดานที่ทำได้ในทางเทคนิค มากกว่างบทำงานจริง
ถ้าสายงาน retrieval-augmented generation (RAG) อัด 400K โทเคนจาก PDF สแกนที่แปลงเป็นข้อความ (OCR) ลงในพรอมป์ตและคาดว่าโมเดลจะค้นหารายละเอียดเฉพาะได้อย่างเชื่อถือได้ ให้ทดสอบก่อนตัดสินใจ ทั้งนี้ 33.3% ของส่วนผสมขยายบริบทยาวคือ PDF ที่ OCR แล้ว ชัดเจนว่างานเอกสารสแกนคือเป้าหมายหลัก
โหมด reasoning หมายถึงโมเดลจะไล่คิดแก้ปัญหาเป็นขั้นตอนก่อนตอบ ซึ่งช่วยเพิ่มความแม่นยำแต่ใช้โทเคนมากขึ้น
ใน Kolibri 1 เป็นสวิตช์ที่ควบคุมได้ แทนที่จะเป็นรุ่นโมเดลแยก และการเรียกใช้เครื่องมือ (โมเดลตัดสินใจเรียกฟังก์ชันหรือ API ภายนอก เช่น คิวรีฐานข้อมูล) เป็นความสามารถเนทีฟ
Aleph Alpha ระบุการใช้งานเป้าหมายเป็นการให้เหตุผลหลายขั้น RAG การเรียกใช้เครื่องมือเชิงเอเจนต์ การเขียนโค้ด และผู้ช่วยสองภาษา โดยส่วนผสมระยะ mid-training ให้ 15.4% กับโค้ดเชิงเอเจนต์และการใช้เครื่องมือ เพิ่มจากแทบเป็นศูนย์ในระยะพรีเทรน
รายงานผู้ใช้เชิงประจักษ์หนึ่งราย รันโมเดลแบบ FP8 บน GPU เดสก์ท็อป RTX Pro 6000 ตัวเดียว วัดได้ราว 170 โทเคนต่อวินาที และสังเกตว่าโมเดลมีแนวโน้มใช้โทเคนไตร่ตรองค่อนข้างมาก
จึงควรเผื่องบโทเคนไว้หากเปิดโหมด reasoning เป็นค่าเริ่มต้นในเส้นทางที่ไวต่อเวลาแฝง
Kolibri 1 ถูกฝึกจากศูนย์ จึงไม่ใช่การไฟน์จูนหรือคัดลอกโมเดลของบริษัทอื่น
ประเด็นนี้สำคัญต่อเรื่องลิขสิทธิ์และความโปร่งใสว่าอะไรอยู่ในโมเดลบ้าง
เมื่อรวมกับน้ำหนักภายใต้ Apache 2.0 หมายความว่าสามารถรัน Kolibri 1 แบบ air-gapped (ตัดขาดจากอินเทอร์เน็ตเต็มรูปแบบ) ไฟน์จูน และบรรจุในผลิตภัณฑ์เชิงพาณิชย์ได้โดยไม่ต้องขออนุญาตใคร
EU AI Act และหลักปฏิบัติ (Code of Practice) สำหรับ General-Purpose AI (GPAI) เป็นกรอบกติกาของสหภาพยุโรปสำหรับโมเดลอเนกประสงค์ รวมถึงข้อกำหนดด้านเอกสารข้อมูลฝึก
Aleph Alpha เป็นผู้ลงนามใน Code of Practice และเผยแพร่โมเดลการ์ดรายละเอียดที่ครอบคลุมแหล่งข้อมูลฝึก ขั้นตอน decontamination (นำคำถามบेंชมาร์กออกจากข้อมูลฝึก) และช่องทางติดต่อสำหรับผู้ถือสิทธิ์ ซึ่งเป็นเอกสารที่การตรวจประเมินตาม EU AI Act จะร้องขอ
สำหรับผู้ซื้อภาครัฐในเยอรมนีและสหภาพยุโรปโดยรวม เอกสารเหล่านี้มักเป็นปัจจัยชี้ขาดมากกว่าความต่างของคะแนนบेंชมาร์ก
และนี่คือส่วนที่ห้องทดลองในสหรัฐฯ เลียนแบบได้ไม่เร็ว
Aleph Alpha ระบุข้อจำกัดในโมเดลการ์ดอย่างเปิดเผย และควรอ่านก่อนตัดสินใจจัดซื้อ:
สำหรับการดีพลอยที่มีความเสี่ยงสูง Aleph Alpha ระบุว่าจำเป็นต้องมีมาตรการคุ้มครองเพิ่มเติมและปฏิบัติตาม Regulation (EU) 2024/1689
โปรไฟล์บेंชมาร์กของ Kolibri 1 เอนเอียงในทางที่ใช้งานได้จริง: นำหน้าชุดเทียบที่ระบุในคณิตศาสตร์เชิงแข่งขันและเหตุผลภาษาเยอรมัน และแพ้ Qwen3.6 35B-A3B ในความรู้แบบปิดหนังสือ, MMLU-Pro และชุดการใช้เครื่องมือส่วนใหญ่
Aleph Alpha เปรียบเทียบกับ Qwen3.6 35B-A3B, Mistral Small 4 119B-A6B และ Nemotron 3 Super 120B-A12B
โมเดลการ์ดยังกล่าวถึง Qwen3.8 27B ซึ่งเป็นโมเดลหนาแน่น (dense โมเดลที่ใช้พารามิเตอร์ทั้งหมดกับทุกโทเคน ต่างจาก MoE) ที่ทำคะแนนสูงกว่าโดยรวม (เยอรมันรวม 79.9 เทียบกับ 70.8 ของ Kolibri) ด้วยพารามิเตอร์ใช้งานมากกว่าราวแปดเท่า
ตารางด้านล่างไม่ได้ใส่รุ่นนั้นไว้ แต่ควรนึกถึงเมื่ออ่านข้ออ้างด้านประสิทธิภาพ
ในชื่อโมเดลเหล่านั้น ตัวเลขหลัง "A" คือพารามิเตอร์ใช้งานต่อโทเคน ดังนั้น 35B-A3B หมายถึงรวม 35B และใช้งาน 3B ต่อโทเคน ต่อไปนี้คือสิ่งที่บेंชมาร์กในตารางด้านล่างวัด:
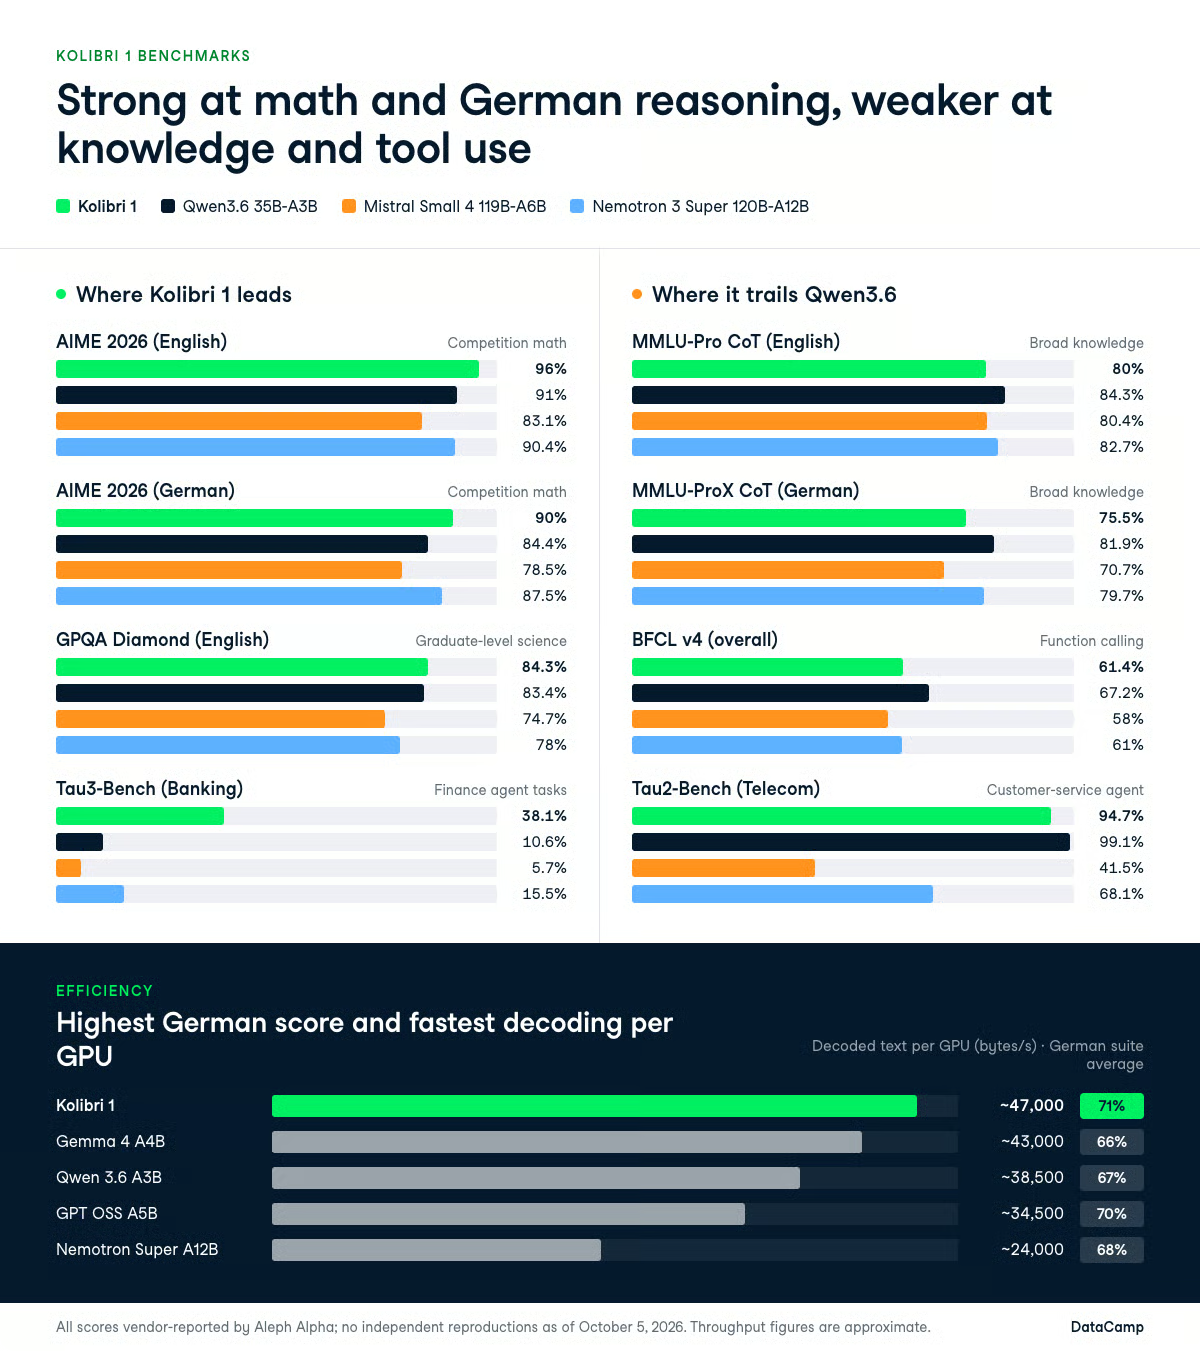
คณิตศาสตร์คือจุดที่ Kolibri 1 นำหน้าอย่างชัดเจน
ทำได้ 96% บน AIME 2026 (EN) เทียบกับ 91% ของ Qwen3.6 35B-A3B, 90.4% ของ Nemotron 3 Super และ 83.1% ของ Mistral Small 4 และได้ 96.9% บน AIME 2025 (EN) เทียบกับ 84.6% ของ Qwen3.6
บน GPQA Diamond (EN) ได้ 84.3% เทียบกับ 83.4% และบน Humanity's Last Exam (EN) 21.5% เทียบกับ 21.1% ซึ่งใกล้เคียงจนถือว่าเสมอกัน
จุดอ่อนในตารางเดียวกันคือด้านความรู้
AA-Omniscience Index (ชุดสาธารณะ) ให้คะแนนบนสเกลที่ค่าติดลบพบได้บ่อยและยิ่งสูงยิ่งดี Kolibri 1 ได้ -32.8 เทียบกับ -12.5 ของ Qwen3.6 และ -24.0 ของ Mistral Small 4 แม้จะเฉือนชนะ -36.5 ของ Nemotron 3 Super ตัวเลขความแม่นยำ AA-Omniscience แยกต่างหากอยู่ที่ 14.8% ต่ำที่สุดในสี่โมเดล
อัตราไม่เพี้ยนข้อเท็จจริงบนเบนช์มาร์กเดียวกันนี้ดูดีกว่าอยู่ที่ 44.0% แซงหน้า Nemotron (13.9%) และ Mistral (34.7%) แต่ตามหลัง Qwen3.6 (56.7%) ซึ่งสอดคล้องกับการฝึกให้เว้นว่างคำตอบของ Aleph Alpha
โมเดลที่มีพารามิเตอร์ทำงาน 3.46B มีพื้นที่จำข้อเท็จจริงจำกัด จึงควรจับคู่กับการค้นคืนข้อมูล แทนที่จะพึ่งพาการตอบแบบปิดหนังสือ
| Benchmark (EN) | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| AIME 2026 | 96% | 91% | 83.1% | 90.4% |
| AIME 2025 | 96.9% | 84.6% | 79.8% | 91.7% |
| GPQA Diamond | 84.3% | 83.4% | 74.7% | 78% |
| Humanity's Last Exam | 21.5% | 21.1% | 9.7% | 20.6% |
| MMLU-Pro CoT | 80% | 84.3% | 80.4% | 82.7% |
| AA-Omniscience Index (ยิ่งสูงยิ่งดี) | -32.8 | -12.5 | -24.0 | -36.5 |
Kolibri 1 ชนะเบนช์มาร์คคณิตศาสตร์และวิทยาศาสตร์ภาษาเยอรมัน แต่แพ้ด้านความรู้ภาษาเยอรมัน ซึ่งมีรูปทรงเดียวกับโปรไฟล์ภาษาอังกฤษ
ทำได้ 90% บน AIME 2026 (DE) เทียบกับ 84.4% ของ Qwen3.6 และ 81.3% บน GPQA Diamond (DE) เทียบกับ 80.6% บน MMLU-ProX CoT (DE) ลดลงเหลือ 75.5% ขณะที่ Qwen3.6 ไปถึง 81.9% และ Nemotron 3 Super 79.7% และบน Humanity's Last Exam (DE) ทำได้ 15.9% เทียบกับ 22.3% ของ Nemotron
สิ่งที่น่าสนใจจริง ๆ คือช่องว่างอังกฤษ-เยอรมันที่เล็ก
Kolibri เสียไป 6 คะแนนเมื่อย้าย AIME 2026 จากอังกฤษเป็นเยอรมัน และ 3 คะแนนบน GPQA Diamond ซึ่งลดลงแคบกว่าที่คาดจากโมเดลที่มองภาษาเยอรมันเป็นเป้าหมายการแปล
| Benchmark (DE) | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| AIME 2026 | 90% | 84.4% | 78.5% | 87.5% |
| AIME 2025 | 87.5% | 82.9% | 72.3% | 85.6% |
| GPQA Diamond | 81.3% | 80.6% | 72.9% | 76.6% |
| MMLU-ProX CoT | 75.5% | 81.9% | 70.7% | 79.7% |
| Humanity's Last Exam | 15.9% | 20.5% | 10.5% | 22.3% |
นี่คือส่วนที่นุ่มที่สุดของรุ่นนี้
บน BFCL v4 ภาพรวม Kolibri 1 ได้ 61.4% เทียบกับ 67.2% ของ Qwen3.6 และบน Tau2-Bench (Telecom) ทำได้ 94.7% เทียบกับ 99.1% ของ Qwen3.6 แต่เฉือนชนะ Qwen3.6 บน Tau2-Bench (Airline) ที่ 76.7% ต่อ 70.7%
ตัวเลขหลายรอบของ BFCL v3 ที่รายงานแยกคือ 39.8 คะแนน (Qwen3.6 ได้ 53.5) สะท้อนจุดอ่อนเดียวกัน: การเรียกเครื่องมือครั้งเดียวทำได้ดี แต่บทสนทนายาวที่ต้องไป-กลับกับเครื่องมือซ้ำ ๆ ไม่ถนัด
ค่าผิดสังเกตไปอีกทาง
บน Tau3-Bench (Banking) Kolibri 1 ทำได้ 38.1% ขณะที่ Qwen3.6 ได้ 10.6%, Nemotron 3 Super 15.5% และ Mistral Small 4 เพียง 5.7% นั่นมากกว่าราว 2.5 เท่าจากโมเดลอันดับถัดไปในชุดเปรียบเทียบนี้ (3.6 เท่าจาก Qwen3.6) บนเบนช์มาร์คเอเจนต์แนวการเงิน และเป็นผลลัพธ์เดียวในรุ่นนี้ที่อยากให้มีการทำซ้ำยืนยันอย่างอิสระมากที่สุด
| Benchmark | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| Tau2-Bench (Telecom) | 94.7% | 99.1% | 41.5% | 68.1% |
| Tau2-Bench (Retail) | 69.9% | 71.6% | 62.9% | 67.5% |
| Tau2-Bench (Airline) | 76.7% | 70.7% | 40% | 72.7% |
| Tau3-Bench (Banking) | 38.1% | 10.6% | 5.7% | 15.5% |
| BFCL v4 (overall) | 61.4% | 67.2% | 58% | 61% |
ผลการโค้ดที่รายงานคือ 85.9 บน LiveCodeBench v6, 66.4 บน SWE-bench Verified และ 27.7 บน Terminal-Bench 2.1
การสร้างโค้ดดิบดูแข็งแรง งานวิศวกรรมซอฟต์แวร์แบบเอเจนต์ดูทั่วไป และตัวเลข Terminal-Bench บอกว่างานเทอร์มินัลหลายขั้นตอนยาว ๆ ไม่ใช่จุดเด่นของโมเดลนี้
มีข้อพึงระวังเรื่องการปนเปื้อนที่ควรอ่านก่อนอ้างอิงตัวเลขใด ๆ
รายงานเทคนิคระบุว่า 48% ของข้อมูลประเมิน HumanEval ภาษาอังกฤษ และ 47% ของภาษาเยอรมัน ปรากฏในวัสดุที่เกี่ยวข้องกับการฝึก ซึ่งทำให้คะแนนสไตล์ HumanEval สูงเกินจริง
หลายชุดในตารางเปรียบเทียบเป็นข้อมูลปิดหรือสร้างโดยผู้ขาย ทำให้ยากต่อการตรวจสอบครบชุด และขณะเขียนยังไม่มีการเปรียบเทียบแบบยืนยันที่เทียบเคียงได้กับรุ่นเรือธงของ Claude, GPT หรือ Gemini
ข้ออ้างเรื่องประสิทธิภาพเป็นสิ่งที่รอดจากข้อควรระวังเรื่องการรายงานโดยผู้ขายได้ดีที่สุด เพราะเป็นคุณสมบัติของสถาปัตยกรรม ไม่ใช่คะแนน
ปริมาณงานที่นี่หมายถึงปริมาณข้อความที่โมเดลสร้างได้ต่อ GPU ต่อวินาที Aleph Alpha วัดเป็นไบต์แทนโทเคน เพื่อให้เทียบโมเดลที่มีตัวแยกโทเคนต่างกันได้อย่างยุติธรรม
Kolibri 1 อยู่ที่ค่าเฉลี่ย 71% บนชุดเบนช์มาร์คภาษาเยอรมันของ Aleph Alpha ขณะถอดรหัสได้ราว 47,000 ไบต์/วินาที ต่อ GPU GPT OSS A5B ไปถึง 70% ที่ประมาณ 34,500 ไบต์/วินาที, Qwen 3.6 A3B 67% ที่ราว 38,500, Gemma 4 A4B 66% ที่ราว 43,000 และ Nemotron Super A12B 68% ที่ราว 24,000
ให้ข้อความถอดรหัสต่อ GPU ราว 2 เท่าของโมเดล Nemotron พร้อมค่าเฉลี่ยภาษาเยอรมันที่สูงกว่า คือเหตุผลเชิงปฏิบัติในการเลือก Kolibri สำหรับสแตกที่โฮสต์เอง
หากจ่ายค่า GPU เองแทนจ่ายตามโทเคน ปริมาณงานต่อ GPU คือเลขที่โผล่ในใบแจ้งหนี้
ยังไม่มีการประกาศราคาโทเคนสำหรับ Kolibri 1
Aleph Alpha ยังไม่เผยรายการราคา API แบบโฮสต์ และไม่มีรหัสรุ่น API ของ Kolibri ที่ยืนยันแล้วในเอกสาร API อย่างเป็นทางการ ณ วันที่ 5 ตุลาคม 2026
การปรับใช้ระดับองค์กรทำผ่านทีมขายของ Aleph Alpha และตัวระบุรีโพสิทอรี Aleph-Alpha/Kolibri-1 ไม่ควรถูกมองว่าเป็นรหัสรุ่น API
น้ำหนักโมเดลเผยแพร่ฟรีภายใต้ Apache 2.0 ดังนั้นต้นทุนของคุณคือเวลา GPU
รอยเท้าหน่วยความจำ FP8 ประมาณ 78 GB โดยระบุขั้นต่ำเป็น 2x A100 80 GB, 2x H100 SXM5, 1x H200, 1x B200 หรือ 1x B300 และคอนฟิกที่แนะนำคือ 2x H100 SXM5, 2x H200, 1x B200 หรือ 1x B300 โมเดลเปิดให้ใช้งานทั่วไป ไม่ใช่พรีวิว ไม่มีลิสต์รอหรือจำกัดภูมิภาค
เพื่อเห็นภาพสิ่งที่ต้องแลก ความครอบคลุม GPT-6.1 Sol ของเรา ระบุรุ่นนั้นที่ $2 ขาเข้า / $10 ขาออก ต่อหนึ่งล้านโทเคน สรุปราคาจากบุคคลที่สามระบุ GPT-5.6 Sol รุ่นเก่าที่ $5 / $30 และ GPT-5.6 Luna ที่ $0.20 / $1.20 หลังการปรับลดราคาของ OpenAI เมื่อ 30 กรกฎาคม
การโฮสต์เองคุ้มเชิงต้นทุนต่อหน่วยก็ต่อเมื่อปริมาณงานเกินต้นทุนคงที่ของ B200
Kolibri 1 เป็น open-weight ภายใต้ Apache 2.0 ซึ่งอนุญาตให้ใช้เชิงพาณิชย์ ดัดแปลง และแจกจ่ายซ้ำได้โดยไม่มีเกณฑ์ผู้ใช้หรือรายได้
น้ำหนักโมเดลอยู่ที่ Aleph-Alpha/Kolibri-1 บน Hugging Face ในรูปแบบ float8_e4m3fn การ์ดโมเดลเอกสารการให้บริการผ่าน vLLM เท่านั้น โดยใช้ปลั๊กอิน aleph-alpha-inference ของ Aleph Alpha ชุมชนมีบิลด์ GGUF และ MLX ปรากฏในไม่กี่วัน แต่ Aleph Alpha ยังไม่รับรอง และไม่พบรายการ Ollama อย่างเป็นทางการ
สำหรับการให้บริการแบบเซิร์ฟ คนละ 1x H200 หรือ 1x B200 รองรับน้ำหนัก FP8 ~78 GB ได้บนการ์ดเดียว ใช้ --tensor-parallel-size 2 บน H100
ให้ตั้งค่า --max-model-len ที่ไม่เกิน 262,144 เว้นแต่ได้ทดสอบบริบทที่ยาวกว่านั้นโดยเฉพาะ การเกินค่านั้นต้องใช้แฟล็ก --hf-overrides เพิ่มเติม ซึ่งการ์ดโมเดลอธิบายไว้
ติดตั้งปลั๊กอินและเริ่มเซิร์ฟเวอร์:
pip install 'aleph-alpha-inference>=1'

# Add --tensor-parallel-size 2 on 2x H100
vllm serve Aleph-Alpha/Kolibri-1 \
  --kv-cache-dtype fp8 \
  --max-model-len 262144 \
  --reasoning-parser kolibri1 \
  --tool-call-parser kolibri1 \
  --enable-auto-tool-choice
จากนั้นเรียกใช้งานผ่าน API ที่เข้ากันได้กับ OpenAI โดยใช้พารามิเตอร์การสุ่มตัวอย่างตามที่ Aleph Alpha แนะนำ (temperature 1.0, top_p 0.97, top_k 128):
from openai import OpenAI

client = OpenAI(base_url="http://localhost:8000/v1", api_key="EMPTY")

response = client.chat.completions.create(
    model="Aleph-Alpha/Kolibri-1",
    messages=[{
        "role": "user",
        "content": "Fasse die wichtigsten Fristen aus diesem Bescheid in drei Punkten zusammen.",
    }],
    temperature=1.0,
    top_p=0.97,
    max_tokens=512,
    extra_body={
        "top_k": 128,
        "chat_template_kwargs": {"reasoning_effort": "medium"},
    },
)
print(response.choices[0].message.content)
reasoning effort รับค่า low, medium และ high และสามารถปิดการคิดทั้งหมดได้หากเวลาแฝงสำคัญกว่าความลึก
ผลลัพธ์จะเปลี่ยนไปตามพารามิเตอร์การสุ่มตัวอย่าง และการ์ดโมเดลระบุว่าสามารถต่างกันเล็กน้อยได้แม้ปิดการสุ่มตัวอย่าง
สำหรับการตั้งค่าลึกขึ้นในการอนุมานแบบโฮสต์เองและลูปเอเจนต์ บทเรียน API เกี่ยวกับการสร้างเอเจนต์ย้ายระบบ ของเราครอบคลุมรูปแบบการให้สิทธิ์เครื่องมือและการควบคุมที่ยกมาใช้ได้โดยตรง
โดยแนวคิด Kolibri 1 เป็น 'อธิปไตย AI' หมายความว่าประเทศหรือองค์กรสามารถรัน ตรวจสอบ และควบคุม AI บนโครงสร้างพื้นฐานของตนเองและภายใต้เขตอำนาจของตนเอง โดยไม่ต้องพึ่งพา API ราคา หรือข้อกำหนดการให้บริการของผู้ให้บริการต่างชาติ สำหรับ Kolibri 1 กรณีนั้นตั้งอยู่บนการมีน้ำหนักโมเดล Apache 2.0 ที่รันแบบ air-gapped ได้ (ตัดขาดอินเทอร์เน็ต) โครงสร้างพื้นฐานการฝึกในยุโรป และเอกสารตามกฎหมาย EU AI Act
อย่างไรก็ดี มีบริบทองค์กรสองประการอยู่เบื้องหลังการเปิดตัวนี้
Aleph Alpha ได้ลงนามข้อตกลงควบรวมกิจการกับบริษัทสัญชาติแคนาดา Cohere เพื่อก่อตั้งสิ่งที่พวกเขาเรียกว่าโซลูชัน AI อธิปไตยข้ามมหาสมุทรแอตแลนติกชุดแรก
บริษัทที่ควบรวมจะดำเนินงานภายใต้ชื่อ Cohere โดยมีสำนักงานใหญ่คู่ที่โตรอนโตและเบอร์ลิน และไฮเดลแบร์กยังคงเป็นศูนย์วิจัย ข้อตกลงยังต้องได้รับการอนุมัติตามกฎระเบียบ
ข้อเสนอเรื่องอธิปไตยขึ้นอยู่กับผู้เป็นเจ้าของโมเดลว่ายังคงสนับสนุนต่อไปหรือไม่ และแบรนด์ Aleph Alpha มีกำหนดจะกลายเป็นส่วนหนึ่งของ Cohere เมื่อการควบรวมเสร็จสิ้น ดังนั้นทั้งสองประเด็นจึงควรถูกติดตามควบคู่ไปกับเบนช์มาร์ก
Aleph Alpha กำลังเดิมพันว่าเรื่องอธิปไตย ใบอนุญาต Apache 2.0 และการปฏิบัติตาม EU AI Act ที่มีเอกสารครบ จะสำคัญต่อผู้ซื้อภาครัฐในยุโรปมากกว่าอีกไม่กี่คะแนนบน MMLU-Pro
เดิมพันนั้นดูสมเหตุสมผล และการควบรวมกับ Cohere บ่งชี้ว่าบริษัทตระหนักว่าชนะด้วยสเกลเพียงอย่างเดียวไม่ได้
กล่าวอย่างยุติธรรมได้ว่า Kolibri 1 เป็นโมเดล open-weight ภาษาเยอรมันที่ดีที่สุดในขนาดพารามิเตอร์ทำงานระดับนี้ที่มีเอกสารดีมาก แต่ไม่ใช่โมเดลที่จะเลือกใช้หากต้องการรันเอเจนต์หลายรอบยาว ๆ หรือการตอบข้อเท็จจริงแบบปิดหนังสือ
ท่ามกลางโมเดล MoE พารามิเตอร์ทำงานขนาดเล็กที่ใกล้เคียงกัน Qwen3.6 35B-A3B ยังชนะ และหากรองรับโมเดลแน่น 27B ได้ Qwen3.8 27B ชนะขาด
หากต้องการอัปสปีดการรันและประเมินโมเดลแบบนี้ เริ่มจาก เส้นทางทักษะ AI Fundamentals ของเรา
คอร์สยอดนิยมจาก DataCamp
คอร์ส
คอร์ส
คอร์ส