Curso
Codificação com IA para Desenvolvedores
1 h 30 min
10.5K
Fazia tempo que não víamos uma empresa nova entrar na corrida dos LLMs. Mas em 3 de outubro, a Aleph Alpha colocou seu novo modelo Kolibri 1 no Hugging Face sob licença Apache 2.0 e pediu que a Europa levasse a IA soberana a sério.
A proposta é que governos e empresas europeias possam rodar um modelo competente no próprio hardware, até totalmente offline, em vez de depender da API de um provedor dos EUA.
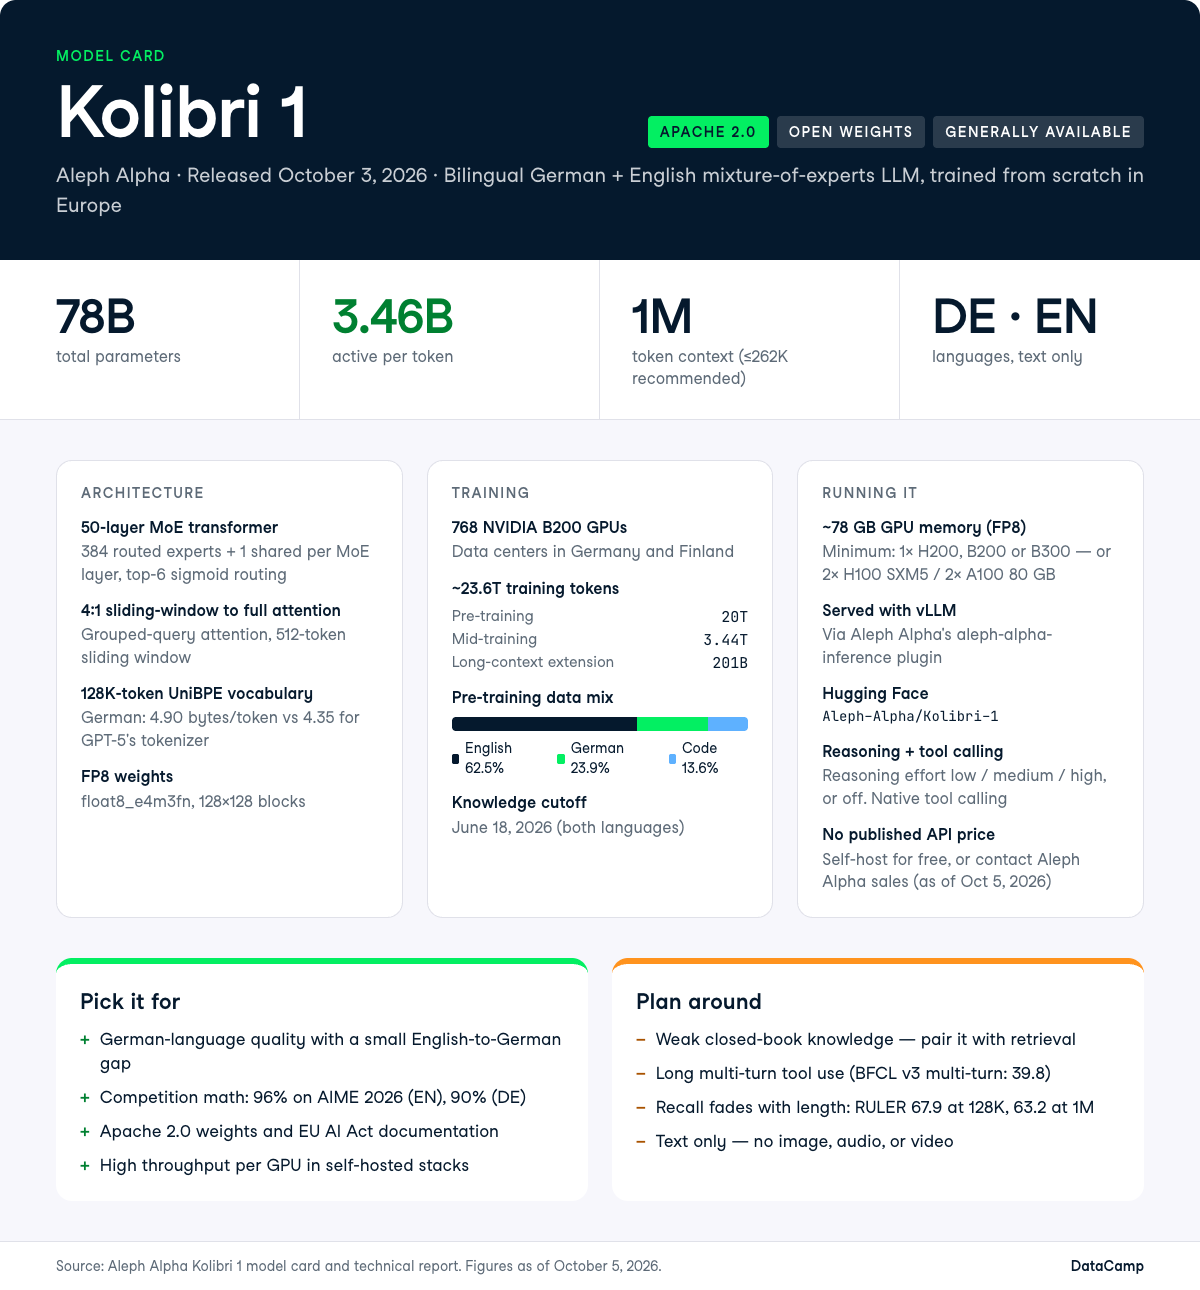
O Kolibri 1 é um modelo mixture-of-experts (MoE) com 78B de parâmetros totais e 3,46B ativos por token, treinado do zero pela Aleph Alpha Research em 768 GPUs NVIDIA B200, em data centers na Alemanha e na Finlândia.
Ele trabalha apenas com alemão e inglês, oferece uma janela de contexto de 1.048.576 tokens (a Aleph Alpha recomenda ficar em 262.144 tokens ou menos para eficiência em produção) e chega como disponibilidade geral, não como preview. O pré-treinamento cobriu 20 trilhões de tokens, seguido de 3,44T no mid-training e 201B para extensão de longo contexto.
Neste artigo, eu trago o que há de novo no Kolibri 1: principais recursos, benchmarks e quanto custa realmente rodar.
Kolibri 1 é o LLM bilíngue especializado da Aleph Alpha, lançado em 3 de outubro de 2026 sob a Apache 2.0. É um único modelo em disponibilidade geral, sem versões menores ou maiores.
Por baixo do capô, é um transformer mixture-of-experts de 50 camadas.
Cada camada contém 384 sub-redes especialistas menores, e um roteador envia cada token para apenas 6 delas, mais 1 especialista compartilhado que sempre roda. É assim que 78,1B de parâmetros totais viram 3,46B ativos por token (cerca de 4,4%), então o modelo prioriza servir barato em vez de capacidade máxima.
Mais duas escolhas de design mantêm o modelo rápido e leve em memória:
O destaque que a Aleph Alpha enfatiza é eficiência, não capacidade bruta.
O Kolibri 1 faz média de 71% no seu conjunto de benchmarks em alemão enquanto decodifica cerca de 47.000 bytes/s de texto por GPU, contra 68% a ~24.000 bytes/s do Nemotron Super A12B.
O modelo tem cutoff de conhecimento em 18 de junho de 2026, para ambos os idiomas, e é apenas texto, sem entrada ou saída de imagem, áudio ou vídeo.
Se você quer ver de onde vem a competência em alemão, a mistura de dados publicada é incomumente transparente para um release de pesos abertos.
| Domínio | Pré-treinamento | Mid-training | Extensão de longo contexto |
|---|---|---|---|
| Web e documentos em inglês | 43,4% | 1,3% | 15,8% |
| Web e documentos em alemão | 23,4% | 2,1% | 2,6% |
| Código | 13,6% | 16,3% | 13,2% |
| Código agentic e uso de ferramentas | ~0% | 15,4% | 5,6% |
| PDFs com OCR | 0% | 0% | 33,3% |
A tabela mostra apenas as linhas de web, código, agentic e PDF. A model card também lista dados de instrução e raciocínio em inglês e alemão, documentos STEM, QA e dados especializados jurídicos e do setor público. Contando todas as linhas de inglês e alemão, a model card resume a mistura de pré-treinamento em aproximadamente 62,5% inglês, 23,9% alemão e 13,6% código.
O que diferencia o Kolibri 1 se resume a duas decisões: treinar o lado em alemão de verdade, e manter o número de parâmetros ativos baixo o bastante para um H200 único servir o modelo.
O Kolibri 1 reduz mais do que o esperado a diferença entre alemão e inglês, algo incomum para um modelo de pesos abertos desse porte.
Sua média geral de benchmarks é 75,5 em inglês e 70,8 em alemão.
A Aleph Alpha treinou um vocabulário de 128.000 tokens com um novo algoritmo de tokenização chamado UniBPE, que mantém as fusões gulosa-de-baixo-para-cima do byte-pair encoding, mas usa o objetivo Unigram para decidir qual fusão entra no vocabulário.
O ganho declarado é compressão em alemão de 4,90 bytes/token, contra 4,35 do tokenizador do GPT-5, com o inglês ficando em 4,58 bytes/token (o tokenizador do GPT-5 fica em 4,67).
Isso pesa no custo tanto quanto na qualidade.
Melhor compressão significa menos tokens para o mesmo documento em alemão, então um Bescheid de 50 páginas (um ato administrativo oficial alemão) custa menos para processar e deixa mais espaço no contexto.
O alemão representou 23,4% da mistura de pré-treinamento contra 43,4% de web e documentos em inglês, então a capacidade foi paga em dados, não em um fine-tuning colado depois da corrida principal.
O modelo anuncia 1.048.576 tokens. Ele lida nativamente com 262.144 tokens após uma etapa de treinamento de longo contexto de 201B tokens e se estica até 1M por extrapolação, isto é, não foi treinado nesse comprimento.
A própria Aleph Alpha recomenda ficar em 262.144 tokens ou menos para eficiência. O RULER, um teste de achar e usar detalhes específicos enterrados em entradas muito longas, mostra a degradação do modelo base: 67,9 em 128K e 63,2 em 1M, contra um resultado citado do Qwen3.5 35B-A3B Base de 89,9 em 128K.
Para ser justo, a pontuação do Kolibri em 1M ainda supera o Nemotron 3 Nano (58,5) e o Qwen3.5 (57,5) nesse comprimento, então ele perde menos desempenho que eles, partindo de um ponto mais baixo.
Trate o número de 1M como um teto técnico, não como orçamento de trabalho.
Se sua RAG entope 400K tokens de PDFs escaneados convertidos em texto (OCR) no prompt e espera que o modelo encontre um detalhe específico com confiabilidade, teste antes de apostar. Vale notar: 33,3% da mistura de extensão de longo contexto eram PDFs com OCR, então workloads de documentos escaneados são claramente o alvo.
Modo de raciocínio quer dizer que o modelo resolve o problema passo a passo antes de responder, o que aumenta a precisão mas consome mais tokens.
No Kolibri 1, isso é um interruptor que você controla, não um nível de modelo separado, e o tool calling (o modelo decidir chamar uma função externa ou API, como uma consulta a banco) é nativo.
A Aleph Alpha lista raciocínio em múltiplas etapas, RAG, tool calling agentic, coding e assistente bilíngue como usos pretendidos, e o mid-training colocou 15,4% em código agentic e uso de ferramentas, partindo de praticamente zero no pré-treinamento.
Um relato anedótico de usuário, rodando o modelo em FP8 em uma única GPU de workstation RTX Pro 6000, mediu cerca de 170 tokens por segundo e notou uma tendência a gastar muitos tokens deliberando.
Preveja esse custo se você deixar o raciocínio ligado por padrão em caminhos sensíveis a latência.
O Kolibri 1 foi treinado do zero, então não é um fine-tune ou cópia do modelo de outra empresa.
Isso importa para licenciamento e para saber exatamente o que entrou no modelo.
Combinado com pesos sob Apache 2.0, isso significa que você pode rodar o Kolibri 1 em ambiente air-gapped (totalmente desconectado), fazer fine-tuning e embuti-lo em um produto comercial sem pedir permissão a ninguém.
O EU AI Act e seu Código de Prática para IA de Propósito Geral (GPAI) definem as regras da UE para modelos de propósito geral, incluindo documentação de dados de treinamento.
A Aleph Alpha é signatária do Código de Prática e publica uma model card detalhada cobrindo fontes de dados de treinamento, etapas de descontaminação (remoção de questões de benchmark dos dados de treino) e um ponto de contato para titulares de direitos — exatamente a documentação que uma análise de conformidade do EU AI Act vai pedir.
Para compradores do setor público na Alemanha e na UE em geral, essa papelada costuma pesar mais do que uma diferença de pontos no benchmark.
E é a parte que nenhum laboratório dos EUA consegue copiar rapidamente.
A model card da Aleph Alpha lista as limitações de forma aberta — vale ler antes de uma decisão de compra:
Para qualquer implantação de alto risco, a Aleph Alpha afirma que são necessários controles adicionais e conformidade com o Regulamento (UE) 2024/1689.
O perfil do Kolibri 1 é assimétrico de um jeito útil: ele lidera seu conjunto de comparação em matemática de competição e raciocínio em alemão, e perde para o Qwen3.6 35B-A3B em conhecimento closed-book, MMLU-Pro e na maioria das suítes de uso de ferramentas.
A Aleph Alpha compara com o Qwen3.6 35B-A3B, Mistral Small 4 119B-A6B e Nemotron 3 Super 120B-A12B.
A model card também cita o Qwen3.8 27B, um modelo denso (que usa todos os seus parâmetros a cada token, ao contrário de um MoE) que pontua mais alto em tudo (alemão geral 79,9 contra 70,8 do Kolibri) com cerca de oito vezes os parâmetros ativos.
Eu o deixei fora das tabelas abaixo, mas mantenha isso em mente ao ler as alegações de eficiência.
Nesses nomes de modelo, o número após o "A" são os parâmetros ativos por token, então 35B-A3B significa 35B totais e 3B ativos. Eis o que medem os benchmarks nas tabelas abaixo:
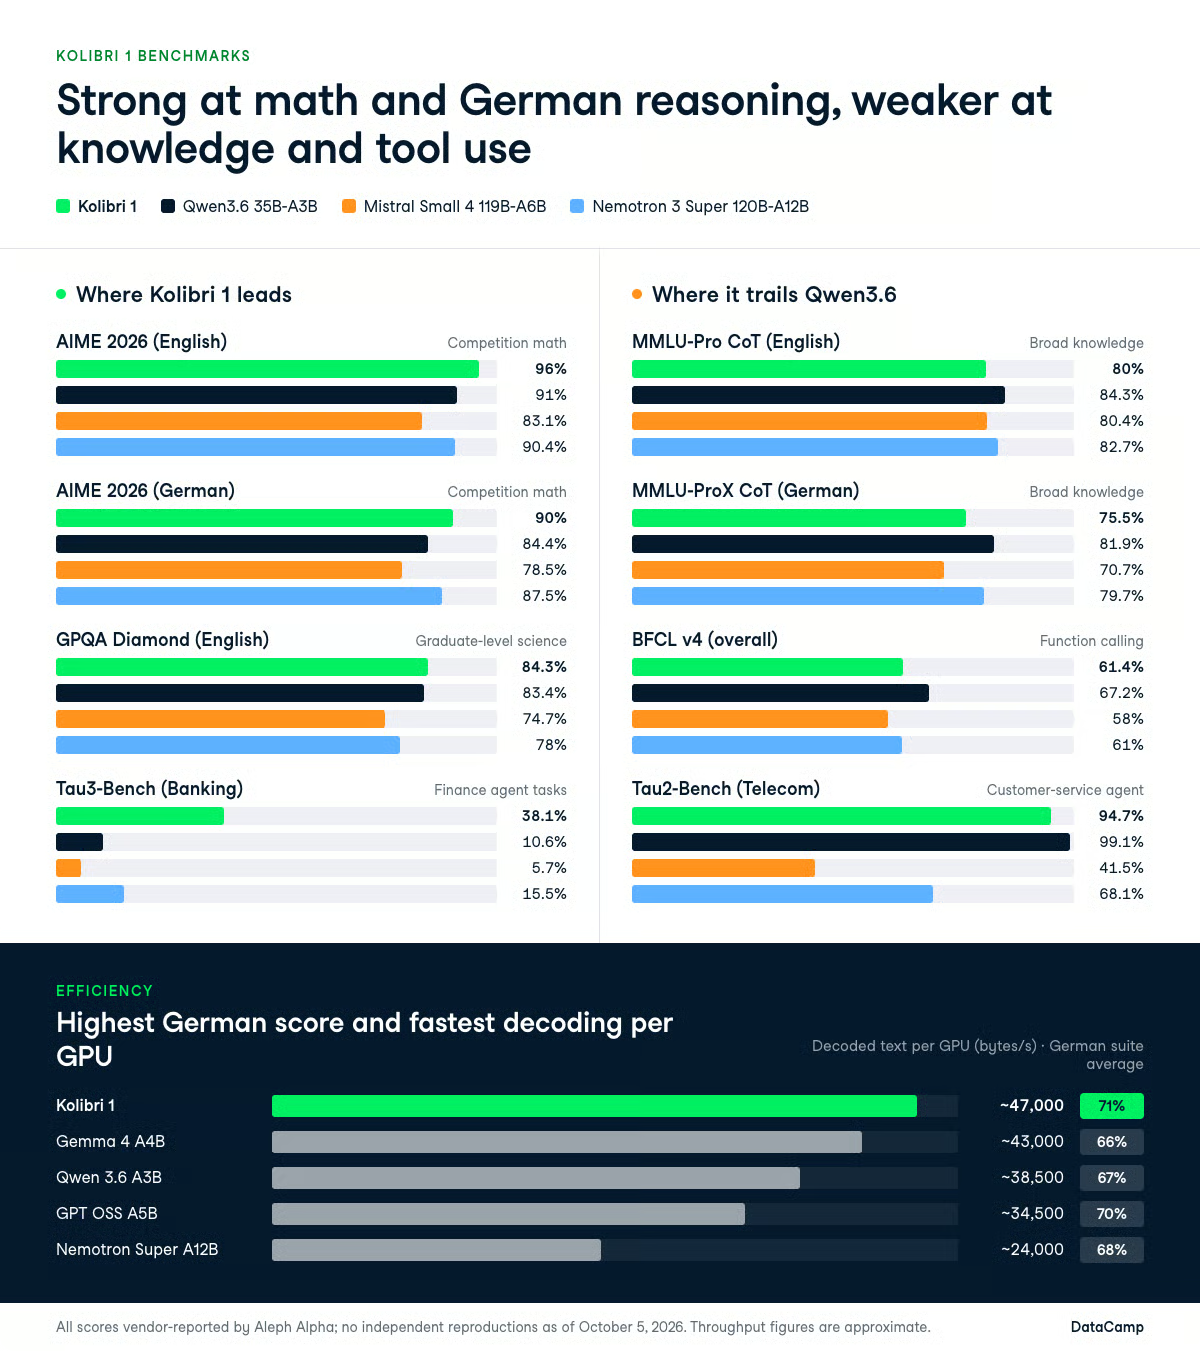
Matemática é onde o Kolibri 1 está claramente à frente.
Ele marca 96% no AIME 2026 (EN) contra 91% do Qwen3.6 35B-A3B, 90,4% do Nemotron 3 Super e 83,1% do Mistral Small 4; e 96,9% no AIME 2025 (EN) contra 84,6% do Qwen3.6.
No GPQA Diamond (EN) ele faz 84,3% versus 83,4%, e no Humanity's Last Exam (EN) 21,5% versus 21,1% — praticamente empate.
O ponto fraco na mesma tabela é conhecimento.
O AA-Omniscience Index (conjunto público) é pontuado numa escala em que números negativos são comuns e maior é melhor. O Kolibri 1 faz -32,8 contra -12,5 do Qwen3.6 e -24,0 do Mistral Small 4, embora supere os -36,5 do Nemotron 3 Super. Uma métrica separada de acurácia no AA-Omniscience fica em 14,8%, a mais baixa dos quatro modelos.
Sua taxa de não-alucinação no mesmo benchmark é mais favorável: 44,0%, à frente do Nemotron (13,9%) e do Mistral (34,7%), mas atrás do Qwen3.6 (56,7%) — o que combina com o treinamento de abstenção da Aleph Alpha.
Um modelo com 3,46B de parâmetros ativos tem pouco espaço para memorizar fatos — use recuperação em vez de confiar em recall closed-book.
| Benchmark (EN) | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| AIME 2026 | 96% | 91% | 83,1% | 90,4% |
| AIME 2025 | 96,9% | 84,6% | 79,8% | 91,7% |
| GPQA Diamond | 84,3% | 83,4% | 74,7% | 78% |
| Humanity's Last Exam | 21,5% | 21,1% | 9,7% | 20,6% |
| MMLU-Pro CoT | 80% | 84,3% | 80,4% | 82,7% |
| AA-Omniscience Index (quanto maior, melhor) | -32,8 | -12,5 | -24,0 | -36,5 |
O Kolibri 1 vence em benchmarks de matemática e ciências em alemão e perde nos de conhecimento em alemão — o mesmo desenho do seu perfil em inglês.
Ele marca 90% no AIME 2026 (DE) contra 84,4% do Qwen3.6, e 81,3% no GPQA Diamond (DE) contra 80,6%. No MMLU-ProX CoT (DE) cai para 75,5% enquanto o Qwen3.6 chega a 81,9% e o Nemotron 3 Super a 79,7%; e no Humanity's Last Exam (DE) faz 15,9% contra 22,3% do Nemotron.
O que acho realmente interessante é o pequeno gap de inglês para alemão.
O Kolibri perde 6 pontos ao mover o AIME 2026 do inglês para o alemão e 3 pontos no GPQA Diamond — uma queda mais estreita do que se esperaria de um modelo que trata o alemão como mera tradução.
| Benchmark (DE) | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| AIME 2026 | 90% | 84,4% | 78,5% | 87,5% |
| AIME 2025 | 87,5% | 82,9% | 72,3% | 85,6% |
| GPQA Diamond | 81,3% | 80,6% | 72,9% | 76,6% |
| MMLU-ProX CoT | 75,5% | 81,9% | 70,7% | 79,7% |
| Humanity's Last Exam | 15,9% | 20,5% | 10,5% | 22,3% |
Este é o ponto mais fraco do lançamento.
No BFCL v4 geral, o Kolibri 1 marca 61,4% contra 67,2% do Qwen3.6, e no Tau2-Bench (Telecom) faz 94,7% contra 99,1% do Qwen3.6. Ele supera o Qwen3.6 no Tau2-Bench (Airline), 76,7% a 70,7%.
Um número separado do BFCL v3 para múltiplas voltas de 39,8 pontos (53,5 do Qwen3.6) mostra a mesma fraqueza: chamadas únicas de ferramenta vão bem; conversas longas com várias idas e voltas de ferramenta, não.
O outlier puxa para o outro lado.
No Tau3-Bench (Banking), o Kolibri 1 marca 38,1%, enquanto o Qwen3.6 faz 10,6%, o Nemotron 3 Super 15,5% e o Mistral Small 4 apenas 5,7%. Isso é ~2,5x a margem sobre o próximo melhor deste conjunto (3,6x sobre o Qwen3.6) em um benchmark de finanças para agentes — é o único resultado que eu mais gostaria de ver reproduzido independentemente.
| Benchmark | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| Tau2-Bench (Telecom) | 94,7% | 99,1% | 41,5% | 68,1% |
| Tau2-Bench (Retail) | 69,9% | 71,6% | 62,9% | 67,5% |
| Tau2-Bench (Airline) | 76,7% | 70,7% | 40% | 72,7% |
| Tau3-Bench (Banking) | 38,1% | 10,6% | 5,7% | 15,5% |
| BFCL v4 (geral) | 61,4% | 67,2% | 58% | 61% |
Resultados relatados: 85,9 no LiveCodeBench v6, 66,4 no SWE-bench Verified e 27,7 no Terminal-Bench 2.1.
Geração de código bruta parece forte, engenharia agentic parece mediana, e o número do Terminal-Bench indica que longas sessões multi-etapas em terminal não são o foco deste modelo.
Há um alerta de contaminação que você deve ler antes de citar.
O relatório técnico observa que 48% dos dados de avaliação HumanEval em inglês e 47% em alemão apareceram em material relacionado a treinamento, inflando pontuações no estilo HumanEval.
Várias suítes nas tabelas de comparação são proprietárias ou criadas por fornecedores, o que dificulta a auditoria completa, e não havia comparação verificada, lado a lado, contra os flagships atuais do Claude, GPT ou Gemini no momento da escrita.
A alegação de eficiência é a que melhor resiste ao viés de relatório do fornecedor, porque é uma propriedade da arquitetura, não uma pontuação.
Throughput aqui significa quanto texto o modelo consegue gerar por GPU por segundo. A Aleph Alpha mede em bytes, não em tokens, para comparar modelos com tokenizadores diferentes de forma justa.
O Kolibri 1 fica em 71% de média no conjunto de benchmarks em alemão da Aleph Alpha enquanto decodifica ~47.000 bytes/s por GPU. GPT OSS A5B chega a 70% em ~34.500 bytes/s, Qwen 3.6 A3B 67% em ~38.500, Gemma 4 A4B 66% em ~43.000, e Nemotron Super A12B 68% em ~24.000.
Servir cerca do dobro de texto decodificado por GPU em relação ao Nemotron, com média alemã mais alta, é o argumento prático para escolher o Kolibri em um stack self-hosted.
Se você paga suas próprias GPUs, não por token, o throughput por GPU é o número que aparece na fatura.
Não há preço por token publicado para o Kolibri 1.
A Aleph Alpha não divulgou tabela de preços de API hospedada e nenhum ID de modelo Kolibri apareceu confirmado na documentação oficial da API até 5 de outubro de 2026.
Implantações enterprise passam pelo time de vendas da Aleph Alpha, e o identificador de repositório Aleph-Alpha/Kolibri-1 não deve ser tratado como ID de modelo de API.
Os pesos em si são gratuitos sob Apache 2.0 — seu custo é tempo de GPU.
O footprint de memória em FP8 é de ~78 GB, com mínimo declarado de 2x A100 80 GB, 2x H100 SXM5, 1x H200, 1x B200 ou 1x B300; e configuração recomendada de 2x H100 SXM5, 2x H200, 1x B200 ou 1x B300. O modelo está em disponibilidade geral, não é preview, sem lista de espera ou bloqueio por região.
Para referência, nossa cobertura do GPT-6.1 Sol coloca esse modelo em US$ 2 de entrada / US$ 10 de saída por milhão de tokens. Um resumo de terceiros lista o antigo GPT-5.6 Sol em US$ 5 / US$ 30 e o GPT-5.6 Luna em US$ 0,20 / US$ 1,20 após a redução de preços de 30 de julho da OpenAI.
Self-hosting vence em unit economics só depois que seu volume cobre o custo fixo de um B200.
O Kolibri 1 tem pesos abertos sob Apache 2.0, que permite uso comercial, modificação e redistribuição sem tetos de usuário ou receita.
Os pesos estão em Aleph-Alpha/Kolibri-1 no Hugging Face em float8_e4m3fn. A model card documenta servir apenas via vLLM, usando o plugin aleph-alpha-inference da Aleph Alpha. Builds comunitárias em GGUF e MLX surgiram em poucos dias, mas a Aleph Alpha não as validou, e não encontrei uma entrada oficial no Ollama.
Para servir em produção, 1x H200 ou 1x B200 comporta os ~78 GB de pesos em FP8 em uma única placa. Use --tensor-parallel-size 2 em H100s.
Mantenha --max-model-len em 262.144 ou menos, a não ser que você tenha testado contextos maiores. Ir além exige uma flag extra --hf-overrides, documentada na model card.
Instale o plugin e inicie o servidor:
pip install 'aleph-alpha-inference>=1'

# Adicione --tensor-parallel-size 2 em 2x H100
vllm serve Aleph-Alpha/Kolibri-1 \
  --kv-cache-dtype fp8 \
  --max-model-len 262144 \
  --reasoning-parser kolibri1 \
  --tool-call-parser kolibri1 \
  --enable-auto-tool-choice
Depois consulte pela API compatível com OpenAI, usando os parâmetros de amostragem recomendados pela Aleph Alpha (temperature 1.0, top_p 0,97, top_k 128):
from openai import OpenAI

client = OpenAI(base_url="http://localhost:8000/v1", api_key="EMPTY")

response = client.chat.completions.create(
    model="Aleph-Alpha/Kolibri-1",
    messages=[{
        "role": "user",
        "content": "Fasse die wichtigsten Fristen aus diesem Bescheid in drei Punkten zusammen.",
    }],
    temperature=1.0,
    top_p=0.97,
    max_tokens=512,
    extra_body={
        "top_k": 128,
        "chat_template_kwargs": {"reasoning_effort": "medium"},
    },
)
print(response.choices[0].message.content)
O nível de raciocínio aceita low, medium e high, e você pode desligar o pensamento totalmente se latência importar mais do que profundidade.
As saídas variam com os parâmetros de amostragem, e a model card observa que elas podem divergir levemente mesmo com a amostragem desativada.
Para aprofundar a configuração de inferência self-hosted e loops de agentes, nosso tutorial de API sobre construção de um agente de migração cobre padrões de permissão de ferramentas e de condução que se aplicam diretamente.
Kolibri 1 é, em tese, uma "IA soberana": um país ou organização pode rodar, auditar e controlar sua IA na própria infraestrutura e sob sua própria jurisdição, sem depender da API, do preço ou dos termos de serviço de um provedor estrangeiro. No Kolibri 1, esse argumento se apoia em pesos Apache 2.0 que você pode rodar em air-gap, infraestrutura de treinamento europeia e documentação do EU AI Act.
No entanto, dois pontos de contexto corporativo estão por trás deste lançamento.
A Aleph Alpha assinou um acordo vinculante de fusão com a empresa canadense Cohere para formar o que descrevem como a primeira solução transatlântica de IA soberana.
A empresa combinada operará sob o nome Cohere, com sedes em Toronto e Berlim, e Heidelberg continuará como centro de pesquisa. O negócio ainda precisa de aprovação regulatória.
Uma proposta de soberania depende de quem é dono do modelo continuar dando suporte; e a marca Aleph Alpha deve desaparecer na Cohere quando a fusão fechar. Vale acompanhar ambos os itens junto com os benchmarks.
A Aleph Alpha está apostando que soberania, licença Apache 2.0 e conformidade documentada com o EU AI Act pesam mais para compradores do setor público europeu do que alguns pontos a mais no MMLU-Pro.
Faz sentido, e a fusão com a Cohere sugere que a empresa sabe que não dá para vencer só em escala.
É justo dizer que o Kolibri 1 é o melhor modelo em alemão com pesos abertos neste tamanho de parâmetros ativos que vimos documentado tão bem — mas não é o modelo que eu escolheria para longas execuções de agentes multi-turn ou para recall factual closed-book.
Entre modelos MoE de ativos pequenos comparáveis, o Qwen3.6 35B-A3B ainda leva vantagem. Se você pode bancar um modelo denso de 27B, o Qwen3.8 27B vence com folga.
Para acelerar sua curva de aprendizado em rodar e avaliar modelos como este, comece pela nossa trilha de aprendizado AI Fundamentals.
Principais cursos da DataCamp
Curso
Curso
Curso
blog
Bhavishya Pandit
7 min
blog
Abid Ali Awan
13 min
blog
Abid Ali Awan
8 min
Tutorial
Josep Ferrer
11 min
Tutorial
Abid Ali Awan
13 min
Tutorial
Zoumana Keita
8 min