Corso
Programmazione assistita dall'AI per sviluppatori
1 ore 30 min
10.5K
Era un po' che non si vedeva una nuova azienda entrare nella corsa agli LLM. Ma il 3 ottobre Aleph Alpha ha pubblicato il suo nuovo modello Kolibri 1 su Hugging Face sotto licenza Apache 2.0 e ha chiesto all'Europa di prendere sul serio l'IA sovrana.
L'idea è che governi e aziende europee possano eseguire un modello capace sull'hardware di loro proprietà, anche completamente offline, invece di dipendere dall'API di un provider statunitense.
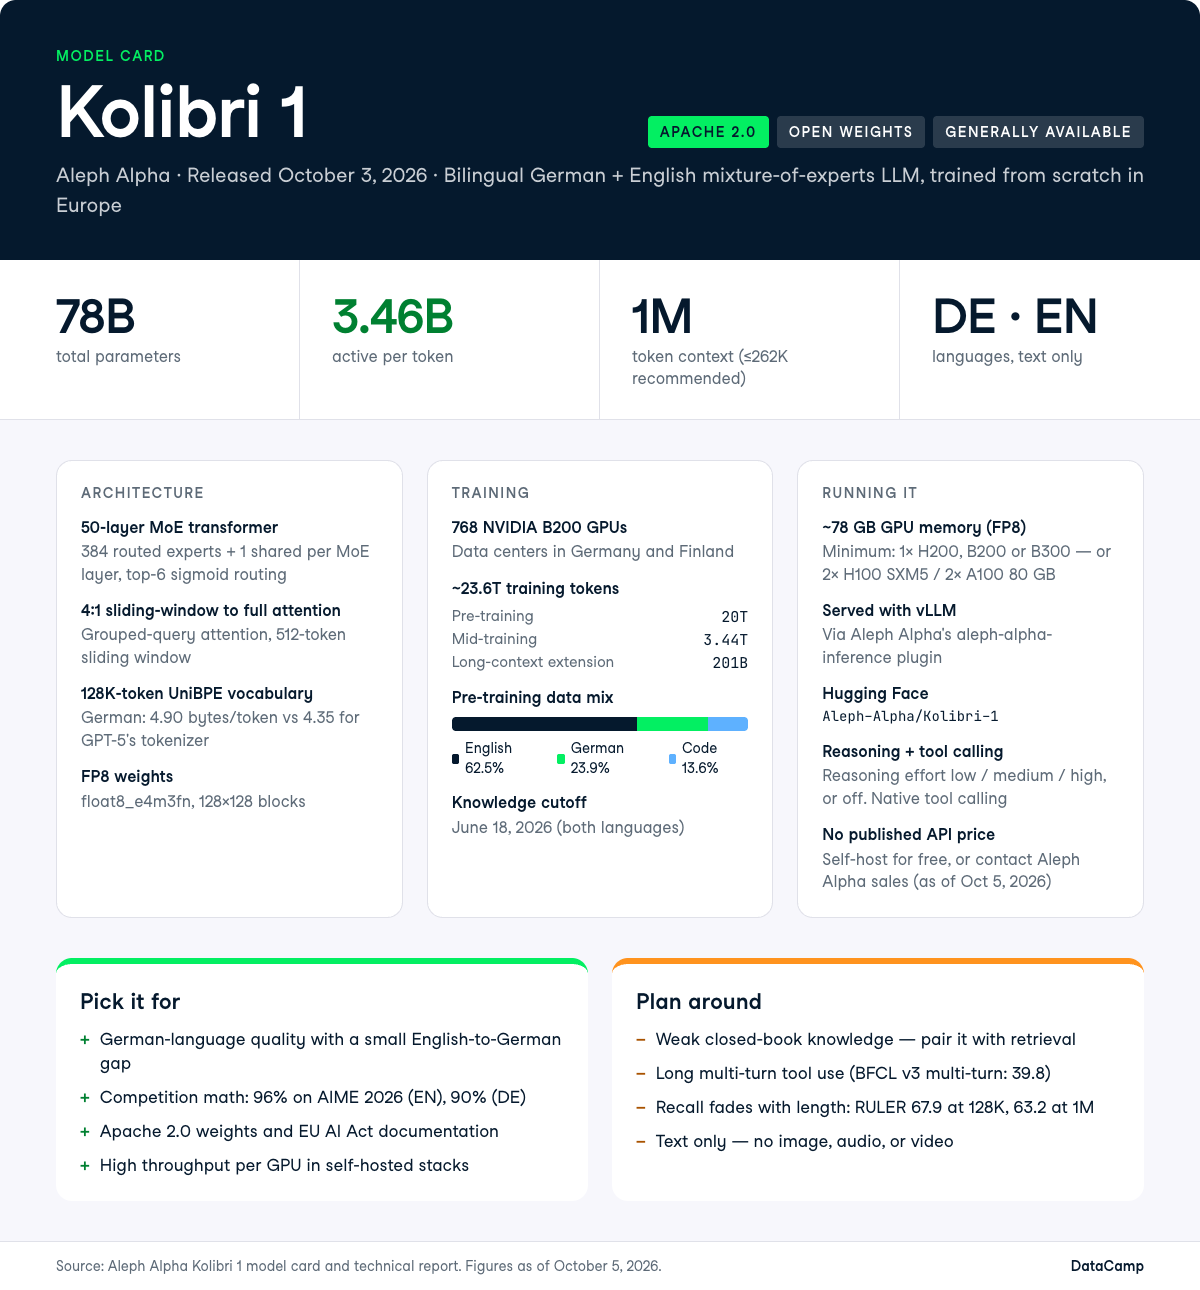
Kolibri 1 è un modello mixture-of-experts (MoE) con 78B parametri totali e 3,46B attivi per token, addestrato da zero da Aleph Alpha Research su 768 GPU NVIDIA B200 in data center in Germania e Finlandia.
Gestisce solo tedesco e inglese, supporta una finestra di contesto da 1.048.576 token (Aleph Alpha consiglia di restare a 262.144 token o meno per efficienza in serving) ed è distribuito come generally available, non come anteprima. Il pre-training ha coperto 20 trilioni di token, seguito da 3,44T nel mid-training e 201B per l'estensione del contesto lungo.
In questo articolo vedremo tutto ciò che c'è di nuovo in Kolibri 1: le caratteristiche principali, i benchmark e quanto costa davvero eseguirlo.
Kolibri 1 è il large language model (LLM) bilingue specializzato di Aleph Alpha, rilasciato il 3 ottobre 2026 sotto licenza Apache 2.0. È un unico modello generally available, senza versioni più piccole o più grandi.
Sotto il cofano è un transformer mixture-of-experts a 50 layer.
Ogni layer contiene 384 piccole sotto-reti specializzate chiamate expert, e un router invia ogni token a solo 6 di esse, più 1 expert condiviso che gira sempre. È così che 78,1B parametri totali si riducono a 3,46B attivi per token (circa il 4,4%), quindi il modello è pensato per un serving economico più che per la massima capacità.
Altre due scelte progettuali lo mantengono veloce e parco di memoria:
Il risultato su cui Aleph Alpha punta i riflettori è l'efficienza, più che la capacità grezza.
Kolibri 1 fa in media il 71% sulla sua suite di benchmark in tedesco decodificando circa 47.000 byte/s di testo per GPU, contro il 68% a circa 24.000 byte/s per Nemotron Super A12B.
Il modello ha un knowledge cutoff al 18 giugno 2026 per entrambe le lingue, ed è solo testo, senza input o output di immagini, audio o video.
Se vuoi capire da dove arriva la competenza in tedesco, il mix di dati pubblicato è insolitamente trasparente per un rilascio open-weight.
| Dominio | Pre-training | Mid-training | Estensione del contesto lungo |
|---|---|---|---|
| Web e documenti in inglese | 43,4% | 1,3% | 15,8% |
| Web e documenti in tedesco | 23,4% | 2,1% | 2,6% |
| Codice | 13,6% | 16,3% | 13,2% |
| Codice agentico e uso di tool | ~0% | 15,4% | 5,6% |
| PDF da OCR | 0% | 0% | 33,3% |
La tabella mostra solo le righe web, codice, agentico e PDF. La model card elenca anche dati di istruzioni e ragionamento in inglese e tedesco, documenti STEM, QA e dati specialistici legali e del settore pubblico. Contando tutte le righe in inglese e tedesco, la model card riassume il mix di pre-training in circa 62,5% inglese, 23,9% tedesco e 13,6% codice.
Gran parte di ciò che distingue Kolibri 1 si riduce a due decisioni: addestrare come si deve la parte tedesca invece di tradurla, e mantenere il numero di parametri attivi abbastanza basso da permettere il serving su una singola H200.
Kolibri 1 riduce più del previsto il divario tra tedesco e inglese, cosa insolita per un modello open-weight di queste dimensioni.
La sua media complessiva sui benchmark è 75,5 in inglese e 70,8 in tedesco.
Aleph Alpha ha addestrato un vocabolario da 128.000 token con un nuovo algoritmo di tokenizzazione chiamato UniBPE, che mantiene le merge greedy bottom-up del byte-pair encoding ma usa l'obiettivo Unigram per scegliere quale merge entra nel vocabolario.
Il vantaggio dichiarato è una compressione del tedesco di 4,90 byte/token, contro 4,35 per il tokenizer di GPT-5, mentre l'inglese resta a 4,58 byte/token (il tokenizer di GPT-5 ottiene 4,67).
Questo conta tanto per i costi quanto per la qualità.
Una compressione migliore significa meno token per lo stesso documento in tedesco, quindi un Bescheid di 50 pagine (un avviso amministrativo ufficiale tedesco) costa meno da processare e lascia più spazio nel contesto.
Il tedesco rappresentava il 23,4% del mix di pre-training contro il 43,4% per web e documenti in inglese, quindi la capacità è pagata in dati, non con un fine-tuning appiccicato dopo la corsa di addestramento principale.
Il modello dichiara 1.048.576 token. Gestisce nativamente 262.144 token dopo una fase di addestramento long-context da 201B token, ed estende a 1M per estrapolazione, cioè non è mai stato addestrato a quella lunghezza.
La stessa Aleph Alpha consiglia di restare a 262.144 token o meno per efficienza in serving. RULER, un test che verifica se un modello sa trovare e usare dettagli specifici sepolti in input molto lunghi, mostra il degrado per il base model: 67,9 a 128K e 63,2 a 1M, contro un risultato citato di Qwen3.5 35B-A3B Base di 89,9 a 128K.
A onor del vero, lo score a 1M di Kolibri batte comunque Nemotron 3 Nano (58,5) e Qwen3.5 (57,5) a quella lunghezza, quindi cala meno di loro partendo però da un livello più basso.
Tratterei quindi la cifra di 1M come un tetto che puoi tecnicamente raggiungere più che un budget operativo.
Se la tua pipeline di retrieval-augmented generation (RAG) imbottisce 400K token di PDF scansionati convertiti in testo (OCR) in un prompt e si aspetta che il modello trovi in modo affidabile un dettaglio specifico, testala prima di impegnarti. Da notare che il 33,3% del mix per l'estensione di contesto lungo erano PDF da OCR, quindi i carichi di lavoro su documenti scansionati sono chiaramente l'uso previsto.
La modalità ragionamento significa che il modello affronta un problema passo dopo passo prima di rispondere, il che migliora l'accuratezza ma usa più token.
In Kolibri 1 è un interruttore che controlli tu, non un livello di modello separato, e il tool calling (il modello che decide di chiamare una funzione o un'API esterna, come una query a un database) è nativo.
Aleph Alpha indica come usi previsti ragionamento multi-step, RAG, tool calling agentico, coding e assistenza bilingue, e nel mid-training ha investito il 15,4% in codice agentico e uso di tool, partendo da praticamente zero nel pre-training.
Una segnalazione aneddotica di un utente, eseguendo il modello in FP8 su una singola GPU workstation RTX Pro 6000, ha misurato circa 170 token al secondo e ha notato una tendenza a spendere molti token a deliberare.
Metti a budget questo aspetto se lasci il ragionamento attivo di default in un percorso sensibile alla latenza.
Kolibri 1 è stato addestrato da zero, quindi non è un fine-tune o una copia del modello di un'altra azienda.
Questo conta per la licenza e per sapere esattamente cosa ci è finito dentro.
Combinato con pesi Apache 2.0, significa che puoi eseguire Kolibri 1 in air gap (completamente disconnesso da internet), fare fine-tuning e distribuirlo dentro un prodotto commerciale senza chiedere il permesso a nessuno.
L'AI Act dell'UE e il suo Codice di condotta per l'IA di uso generale (GPAI) stabiliscono le regole dell'UE per i modelli general-purpose, inclusa la documentazione dei dati di addestramento.
Aleph Alpha è firmataria del Codice di condotta e pubblica una model card dettagliata che copre le fonti dei dati di addestramento, i passaggi di decontaminazione (rimozione delle domande di benchmark dai dati di addestramento) e un punto di contatto per i titolari dei diritti, ovvero la documentazione richiesta in una verifica di conformità all'AI Act dell'UE.
Per gli acquirenti del settore pubblico in Germania e nell'UE in generale, quella documentazione è spesso il fattore decisivo più di un delta nei benchmark.
È anche la parte che nessun laboratorio statunitense può copiare rapidamente.
La model card di Aleph Alpha elenca apertamente le limitazioni, e vale la pena leggerle prima di un acquisto:
Per qualsiasi deployment ad alto impatto, Aleph Alpha dichiara che sono richieste ulteriori protezioni e la conformità al Regolamento (UE) 2024/1689.
Il profilo di benchmark di Kolibri 1 è sbilanciato in modo utile: guida il suo set di confronto dichiarato in matematica da competizione e ragionamento in tedesco, e perde contro Qwen3.6 35B-A3B su conoscenza closed-book, MMLU-Pro e sulla maggior parte delle suite di tool-use.
Aleph Alpha si confronta con Qwen3.6 35B-A3B, Mistral Small 4 119B-A6B e Nemotron 3 Super 120B-A12B.
La model card elenca anche Qwen3.8 27B, un modello denso (che usa tutti i suoi parametri per ogni token, a differenza di un MoE) che segna più in alto su tutta la linea (tedesco complessivo 79,9 contro il 70,8 di Kolibri) con circa otto volte i parametri attivi.
L'ho lasciato fuori dalle tabelle qui sotto, ma tienilo a mente quando leggi le affermazioni sull'efficienza.
In quei nomi di modello, il numero dopo la "A" indica i parametri attivi per token, quindi 35B-A3B significa 35B totali e 3B attivi. Ecco cosa misurano i benchmark nelle tabelle qui sotto:
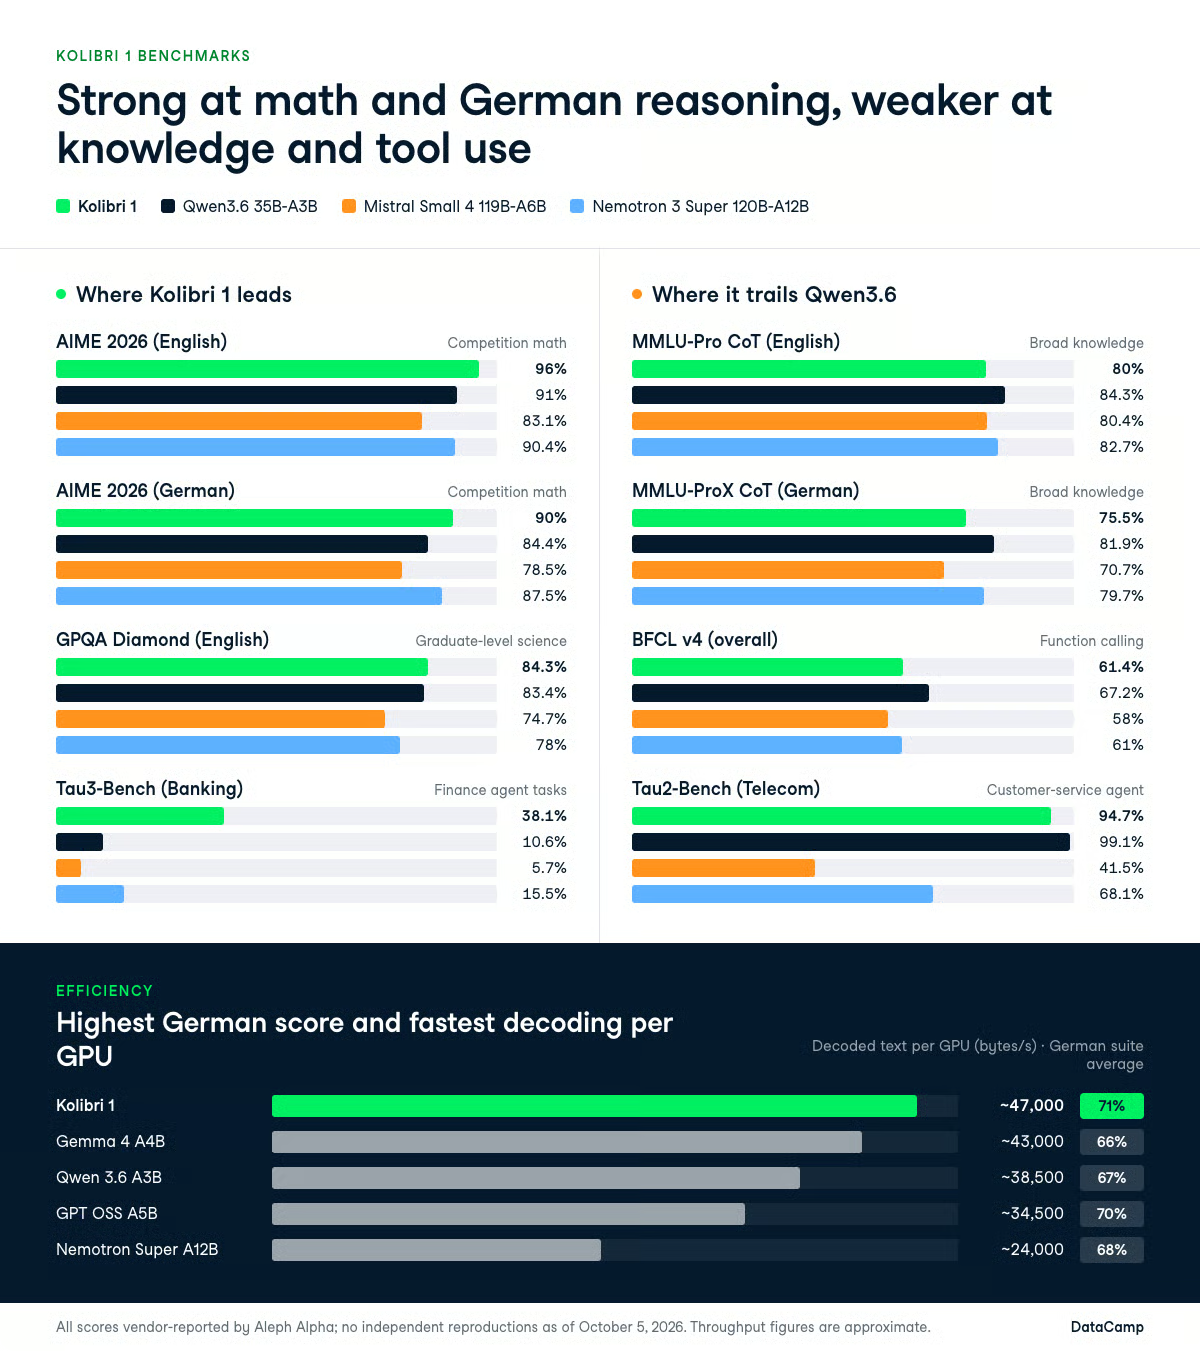
La matematica è l'ambito in cui Kolibri 1 è chiaramente avanti.
Ottiene il 96% su AIME 2026 (EN) contro il 91% di Qwen3.6 35B-A3B, il 90,4% di Nemotron 3 Super e l'83,1% di Mistral Small 4, e il 96,9% su AIME 2025 (EN) contro l'84,6% di Qwen3.6.
Su GPQA Diamond (EN) totalizza l'84,3% contro l'83,4%, e su Humanity's Last Exam (EN) il 21,5% contro il 21,1%, entrambi abbastanza vicini da poterli considerare un pareggio.
Il punto debole nella stessa tabella è la conoscenza.
L'AA-Omniscience Index (set pubblico) è valutato su una scala in cui i numeri negativi sono comuni e più alto è meglio. Kolibri 1 arriva a -32,8 contro il -12,5 di Qwen3.6 e il -24,0 di Mistral Small 4, anche se supera di poco il -36,5 di Nemotron 3 Super. Una separata metrica di accuratezza AA-Omniscience si ferma al 14,8%, la più bassa tra i quattro modelli.
Il suo tasso di non allucinazione sullo stesso benchmark è un più lusinghiero 44,0%, davanti a Nemotron (13,9%) e Mistral (34,7%) ma dietro Qwen3.6 (56,7%), in linea con l'addestramento all'astensione di Aleph Alpha.
Un modello con 3,46B parametri attivi ha poco margine per memorizzare fatti, quindi affiancalo al retrieval invece di contare sul richiamo a libro chiuso.
| Benchmark (EN) | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| AIME 2026 | 96% | 91% | 83,1% | 90,4% |
| AIME 2025 | 96,9% | 84,6% | 79,8% | 91,7% |
| GPQA Diamond | 84,3% | 83,4% | 74,7% | 78% |
| Humanity's Last Exam | 21,5% | 21,1% | 9,7% | 20,6% |
| MMLU-Pro CoT | 80% | 84,3% | 80,4% | 82,7% |
| AA-Omniscience Index (più alto è meglio) | -32,8 | -12,5 | -24,0 | -36,5 |
Kolibri 1 vince i benchmark di matematica e scienze in tedesco e perde quelli di conoscenza in tedesco, lo stesso profilo che mostra in inglese.
Ottiene il 90% su AIME 2026 (DE) contro l'84,4% di Qwen3.6, e l'81,3% su GPQA Diamond (DE) contro l'80,6%. Su MMLU-ProX CoT (DE) scende al 75,5% mentre Qwen3.6 arriva all'81,9% e Nemotron 3 Super al 79,7%, e su Humanity's Last Exam (DE) fa il 15,9% contro il 22,3% di Nemotron.
Quello che trovo davvero interessante è il piccolo divario tra inglese e tedesco.
Kolibri perde 6 punti passando AIME 2026 dall'inglese al tedesco e 3 punti su GPQA Diamond, un calo più ristretto di quanto ti aspetteresti da un modello che tratta il tedesco come semplice target di traduzione.
| Benchmark (DE) | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| AIME 2026 | 90% | 84,4% | 78,5% | 87,5% |
| AIME 2025 | 87,5% | 82,9% | 72,3% | 85,6% |
| GPQA Diamond | 81,3% | 80,6% | 72,9% | 76,6% |
| MMLU-ProX CoT | 75,5% | 81,9% | 70,7% | 79,7% |
| Humanity's Last Exam | 15,9% | 20,5% | 10,5% | 22,3% |
Questa è la parte più debole del rilascio.
Su BFCL v4 complessivo, Kolibri 1 ottiene il 61,4% contro il 67,2% di Qwen3.6, e su Tau2-Bench (Telecom) arriva al 94,7% contro il 99,1% di Qwen3.6. Supera però Qwen3.6 su Tau2-Bench (Airline), 76,7% contro 70,7%.
Una metrica separata riportata per BFCL v3 multi-turn di 39,8 punti (53,5 per Qwen3.6) mostra la stessa debolezza: singole chiamate di strumenti ok, conversazioni lunghe con ripetuti round-trip di strumenti no.
L'eccezione va nella direzione opposta.
Su Tau3-Bench (Banking), Kolibri 1 ottiene il 38,1% mentre Qwen3.6 prende il 10,6%, Nemotron 3 Super il 15,5% e Mistral Small 4 appena il 5,7%. È circa un margine di 2,5x sul secondo miglior modello in questo set di confronto (3,6x su Qwen3.6) su un benchmark agent centrato sulla finanza, ed è il singolo risultato in questo rilascio che vorrei vedere riprodotto in modo indipendente.
| Benchmark | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| Tau2-Bench (Telecom) | 94,7% | 99,1% | 41,5% | 68,1% |
| Tau2-Bench (Retail) | 69,9% | 71,6% | 62,9% | 67,5% |
| Tau2-Bench (Airline) | 76,7% | 70,7% | 40% | 72,7% |
| Tau3-Bench (Banking) | 38,1% | 10,6% | 5,7% | 15,5% |
| BFCL v4 (complessivo) | 61,4% | 67,2% | 58% | 61% |
I risultati riportati sul coding sono 85,9 su LiveCodeBench v6, 66,4 su SWE-bench Verified e 27,7 su Terminal-Bench 2.1.
La generazione di codice grezzo sembra solida, l'ingegneria del software agentica appare nella media, e il punteggio su Terminal-Bench indica che il lavoro da terminale lungo e multistep non è l'uso ideale per questo modello.
C'è un caveat sulla contaminazione da leggere prima di citare qualsiasi dato.
Il report tecnico segnala che il 48% dei dati di valutazione HumanEval in inglese e il 47% in tedesco sono comparsi in materiale legato all'addestramento, gonfiando i punteggi in stile HumanEval.
Diverse suite nelle tabelle di confronto sono proprietarie o create da vendor, il che rende difficile l'audit completo, e al momento della stesura non esisteva alcun confronto verificato, alla pari, con gli attuali flagship di Claude, GPT o Gemini.
L'affermazione sull'efficienza è quella che regge meglio al caveat sui dati forniti dai vendor, perché è una proprietà dell'architettura più che un punteggio.
Qui throughput significa quanto testo il modello può generare per GPU al secondo. Aleph Alpha lo misura in byte anziché in token, così modelli con tokenizer diversi possono essere confrontati in modo equo.
Kolibri 1 si attesta al 71% di media sulla suite di benchmark in tedesco di Aleph Alpha decodificando circa 47.000 byte/s per GPU. GPT OSS A5B arriva al 70% a circa 34.500 byte/s, Qwen 3.6 A3B al 67% a circa 38.500, Gemma 4 A4B al 66% a circa 43.000 e Nemotron Super A12B al 68% a circa 24.000.
Servire circa 2x il testo decodificato per GPU rispetto al modello Nemotron a una media tedesca più alta è l'argomento pratico per scegliere Kolibri in uno stack self-hosted.
Se paghi le GPU di tasca tua invece che per token, il throughput per GPU è il numero che trovi in fattura.
Non c'è un prezzo per token pubblicato per Kolibri 1.
Aleph Alpha non ha rilasciato un listino per l'API hosted e nessun ID modello API Kolibri confermato risultava nella documentazione ufficiale al 5 ottobre 2026.
Le implementazioni enterprise passano attraverso il team commerciale di Aleph Alpha, e l'identificatore del repository Aleph-Alpha/Kolibri-1 non va considerato un ID modello per l'API.
I pesi sono gratuiti sotto Apache 2.0, quindi il tuo costo è il tempo GPU.
L'ingombro in memoria in FP8 è di circa 78 GB, con un minimo dichiarato di 2x A100 80 GB, 2x H100 SXM5, 1x H200, 1x B200 o 1x B300, e una configurazione consigliata di 2x H100 SXM5, 2x H200, 1x B200 o 1x B300. Il modello è generalmente disponibile, non in anteprima, senza lista d'attesa o vincoli di regione.
Per un'idea del confronto, la nostra copertura di GPT-6.1 Sol colloca quel modello a $2 input / $10 output per milione di token. Un riepilogo prezzi di terze parti indica il più vecchio GPT-5.6 Sol a $5 / $30 e GPT-5.6 Luna a $0,20 / $1,20 dopo il taglio prezzi del 30 luglio di OpenAI.
Il self-hosting conviene nei costi unitari solo quando il tuo volume supera il costo fisso di una B200.
Kolibri 1 è open-weight sotto Apache 2.0, che consente uso commerciale, modifica e redistribuzione senza soglie di utenti o ricavi.
I pesi si trovano su Aleph-Alpha/Kolibri-1 su Hugging Face in float8_e4m3fn. La scheda modello documenta il serving solo tramite vLLM, usando il plugin aleph-alpha-inference di Aleph Alpha. Build community in GGUF e MLX sono apparse in pochi giorni, ma Aleph Alpha non le ha convalidate, e non ho trovato una voce Ollama ufficiale.
Per un deployment servito, 1x H200 o 1x B200 contiene i ~78 GB di pesi FP8 su una singola scheda. Usa --tensor-parallel-size 2 su H100.
Mantieni --max-model-len a 262.144 o meno, a meno che tu non abbia testato specificamente contesti più lunghi. Andare oltre richiede un flag aggiuntivo --hf-overrides, documentato nella scheda modello.
Installa il plugin e avvia il server:
pip install 'aleph-alpha-inference>=1'

# Add --tensor-parallel-size 2 on 2x H100
vllm serve Aleph-Alpha/Kolibri-1 \
  --kv-cache-dtype fp8 \
  --max-model-len 262144 \
  --reasoning-parser kolibri1 \
  --tool-call-parser kolibri1 \
  --enable-auto-tool-choice
Quindi interroga il modello tramite l'API compatibile con OpenAI, usando i parametri di sampling raccomandati da Aleph Alpha (temperature 1,0, top_p 0,97, top_k 128):
from openai import OpenAI

client = OpenAI(base_url="http://localhost:8000/v1", api_key="EMPTY")

response = client.chat.completions.create(
    model="Aleph-Alpha/Kolibri-1",
    messages=[{
        "role": "user",
        "content": "Fasse die wichtigsten Fristen aus diesem Bescheid in drei Punkten zusammen.",
    }],
    temperature=1.0,
    top_p=0.97,
    max_tokens=512,
    extra_body={
        "top_k": 128,
        "chat_template_kwargs": {"reasoning_effort": "medium"},
    },
)
print(response.choices[0].message.content)
Reasoning effort accetta low, medium e high, e puoi disattivare del tutto il thinking se la latenza conta più della profondità.
Gli output variano con i parametri di sampling, e la scheda modello segnala che possono divergere leggermente anche con il sampling disattivato.
Per configurazioni più approfondite su inferenza self-hosted e loop agentici, il nostro tutorial API sulla costruzione di un migration agent copre i pattern di autorizzazione degli strumenti e di steering che si trasferiscono direttamente.
Kolibri uno è teoricamente una "IA sovrana", nel senso che un paese o un'organizzazione può eseguire, auditare e controllare la propria IA sulla propria infrastruttura e sotto la propria giurisdizione, senza dipendere dall'API, dai prezzi o dai termini di servizio di un fornitore straniero. Per Kolibri 1, questo si basa su pesi Apache 2.0 che puoi eseguire in air-gap (disconnessi da internet), infrastruttura di training europea e documentazione conforme all'EU AI Act.
Tuttavia, dietro questo lancio ci sono due elementi di contesto aziendale.
Aleph Alpha ha firmato un accordo vincolante di fusione con l'azienda canadese Cohere per formare quella che descrivono come la prima soluzione di IA sovrana transatlantica.
La società combinata opererà con il nome Cohere, con doppia sede a Toronto e Berlino, e Heidelberg che continuerà come centro di ricerca. L'accordo necessita ancora dell'approvazione regolatoria.
Un pitch sulla sovranità dipende dal fatto che il proprietario del modello continui a supportarlo, e il marchio Aleph Alpha è destinato a confluire in Cohere una volta chiusa la fusione, quindi entrambi gli aspetti meritano di essere seguiti insieme ai benchmark.
Aleph Alpha scommette che sovranità, licenza Apache 2.0 e conformità documentata all'EU AI Act contino più, per gli acquirenti del settore pubblico europeo, di qualche punto su MMLU-Pro.
Sembra una scommessa ragionevole, e la fusione con Cohere suggerisce che l'azienda sappia di non poter vincere solo sulla scala.
Direi che è corretto affermare che Kolibri 1 è il miglior modello open-weight in tedesco a questa dimensione di parametri attivi che abbiamo visto documentato così bene, ma non è il modello a cui ricorrerei se mi servissero run agent multi-turn lunghe o richiamo fattuale a libro chiuso.
Tra i modelli MoE a parametri attivi piccoli comparabili, Qwen3.6 35B-A3B vince ancora quel confronto. Se puoi permetterti un modello denso da 27B, Qwen3.8 27B vince nettamente.
Se vuoi metterti al passo sull'esecuzione e la valutazione di modelli di questo tipo, inizia dal nostro percorso di competenze AI Fundamentals.
I migliori corsi DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min