
Kurs
KI-gestütztes Programmieren für Entwickler
1 Std. 30 Min.
10.5K
Es ist eine Weile her, dass ein neues Unternehmen ins LLM-Rennen eingestiegen ist. Am 3. Oktober hat Aleph Alpha sein neues Modell Kolibri 1 unter Apache 2.0 auf Hugging Face veröffentlicht – und Europa aufgefordert, souveräne KI ernst zu nehmen.
Die Idee: Europäische Regierungen und Unternehmen können ein leistungsfähiges Modell auf eigener Hardware betreiben – auch komplett offline – statt von der API eines US-Anbieters abhängig zu sein.
Kolibri 1 ist ein Mixture-of-Experts- (MoE) Modell mit insgesamt 78B Parametern und 3,46B aktiven pro Token. Es wurde von Aleph Alpha Research von Grund auf auf 768 NVIDIA B200 GPUs in Rechenzentren in Deutschland und Finnland trainiert.
Es beherrscht ausschließlich Deutsch und Englisch, unterstützt ein Kontextfenster von 1.048.576 Tokens (Aleph Alpha empfiehlt für den Betrieb Effizienz halber 262.144 Tokens oder weniger) und erscheint als allgemein verfügbares Release statt als Vorschau. Das Pretraining umfasste 20 Billionen Tokens, gefolgt von 3,44T im Mid-Training und 201B für die Long-Context-Erweiterung.
In diesem Artikel zeige ich alles Neue an Kolibri 1: die wichtigsten Features, die Benchmarks und was es tatsächlich kostet, das Modell zu betreiben.
Kolibri 1 ist Aleph Alphas spezialisiertes, zweisprachiges Large Language Model (LLM), veröffentlicht am 3. Oktober 2026 unter Apache 2.0. Es ist ein einzelnes, allgemein verfügbares Modell ohne kleinere oder größere Geschwister.
Unter der Haube steckt ein 50-lagiger Mixture-of-Experts-Transformer.
Jede Lage enthält 384 kleine, spezialisierte Subnetzwerke („Experts“). Ein Router schickt jeden Token zu genau 6 davon, plus 1 geteiltem Expert, der immer läuft. So schrumpfen 78,1B Gesamtparameter auf 3,46B aktive pro Token (ca. 4,4%). Das Modell ist also auf günstiges Serving statt maximale Kapazität ausgelegt.
Zwei weitere Designentscheidungen halten es schnell und speicherschonend:
Das Schlagwort, das Aleph Alpha setzt, ist Effizienz statt roher Spitzenfähigkeit.
Kolibri 1 erreicht im deutschen Benchmark-Suite-Schnitt 71% und dekodiert dabei rund 47.000 Bytes/s Text pro GPU – gegenüber 68% bei etwa 24.000 Bytes/s für Nemotron Super A12B.
Das Modell hat für beide Sprachen einen Wissensstichtag vom 18. Juni 2026 und ist textbasiert – ohne Bild-, Audio- oder Videoein- bzw. -ausgabe.
Wer verstehen will, wo die deutsche Stärke herkommt: Der veröffentlichte Datenmix ist für ein Open-Weight-Release ungewöhnlich transparent.
| Domain | Pretraining | Mid-Training | Long-Context-Erweiterung |
|---|---|---|---|
| Englisches Web und Dokumente | 43,4% | 1,3% | 15,8% |
| Deutsches Web und Dokumente | 23,4% | 2,1% | 2,6% |
| Code | 13,6% | 16,3% | 13,2% |
| Agentic Code und Tool-Nutzung | ~0% | 15,4% | 5,6% |
| OCR-gescannte PDFs | 0% | 0% | 33,3% |
Die Tabelle zeigt nur die Zeilen für Web, Code, Agentik und PDF. Die Model Card listet außerdem englische und deutsche Instruktions- und Reasoning-Daten, MINT-Dokumente, QA sowie spezialisierte Rechts- und Public-Sector-Daten. Über alle englischen und deutschen Zeilen fasst die Model Card den Pretraining-Mix mit ca. 62,5% Englisch, 23,9% Deutsch und 13,6% Code zusammen.
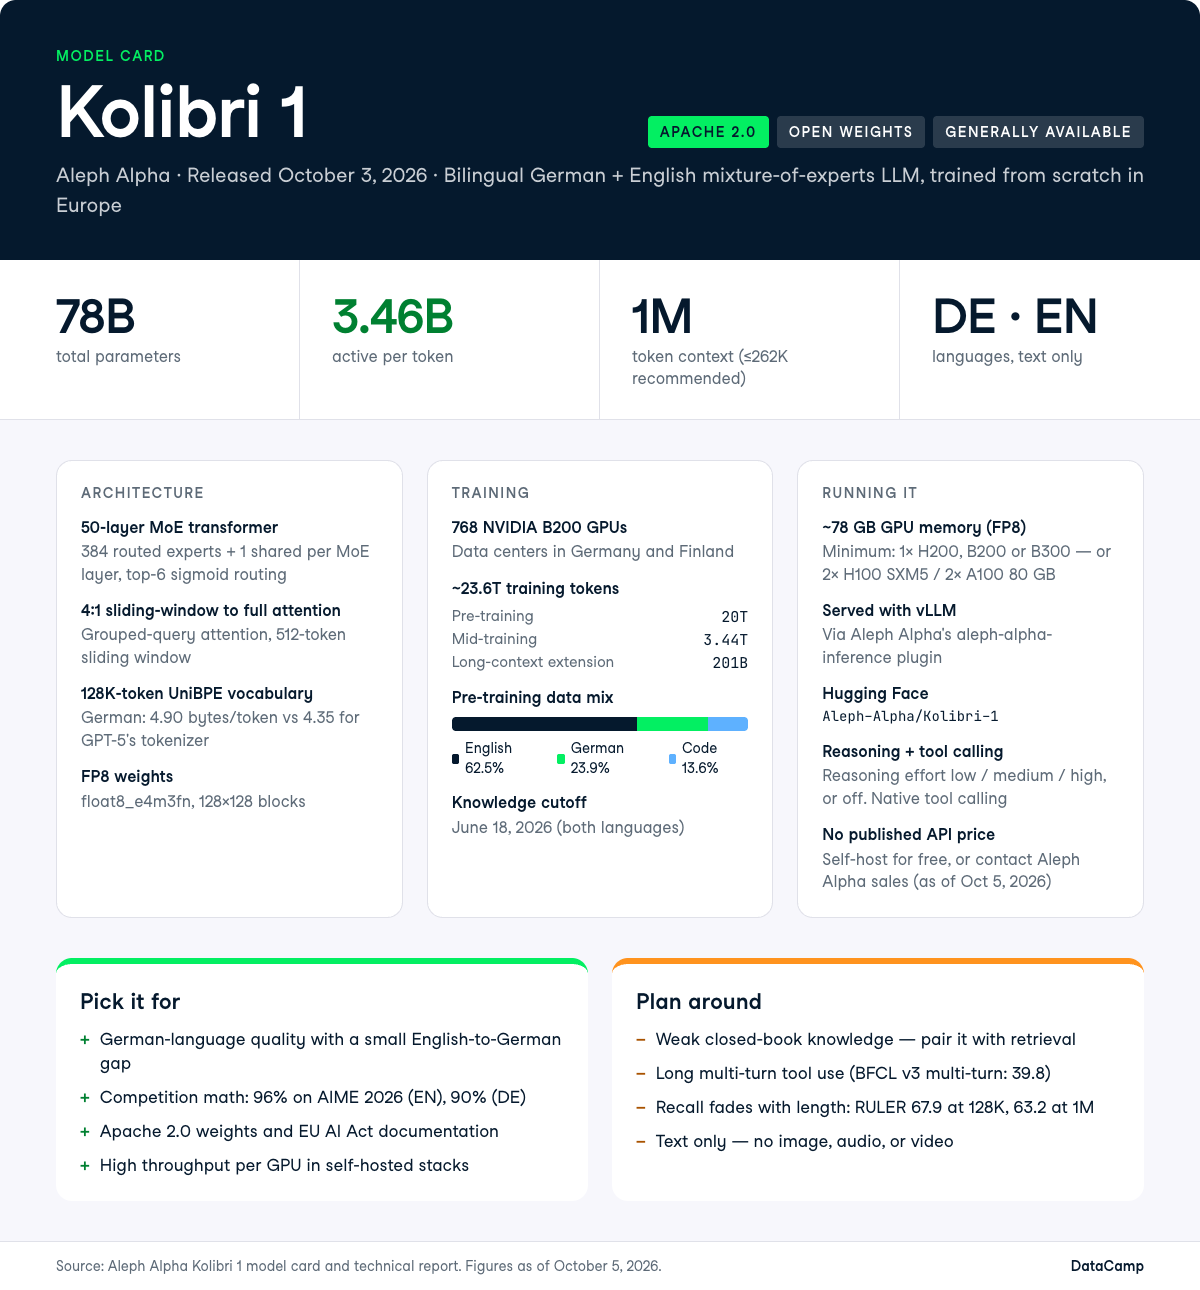
Was Kolibri 1 auszeichnet, hängt im Kern an zwei Entscheidungen: Deutsch sauber zu trainieren statt es nachträglich draufzusetzen – und die aktiven Parameter so niedrig zu halten, dass eine einzelne H200 das Modell serven kann.
Kolibri 1 verringert die Lücke zwischen Deutsch und Englisch stärker als erwartet – ungewöhnlich für ein Open-Weight-Modell dieser Größe.
Der Gesamtdurchschnitt liegt bei 75,5 in Englisch und 70,8 in Deutsch.
Aleph Alpha hat ein Vokabular mit 128.000 Tokens mit einem neuen Tokenizer-Algorithmus namens UniBPE trainiert. Er behält die gierigen Bottom-up-Merges von Byte-Pair-Encoding bei, wählt die Merges aber mit dem Unigram-Objective für das Vokabular aus.
Der angegebene Effekt: Deutsche Kompression mit 4,90 Bytes/Token gegenüber 4,35 beim Tokenizer von GPT-5, während Englisch bei 4,58 Bytes/Token liegt (GPT-5-Tokenizer: 4,67).
Das ist preislich genauso relevant wie qualitativ.
Bessere Kompression bedeutet weniger Tokens für dasselbe deutsche Dokument. Ein 50-seitiger Bescheid kostet dadurch weniger in der Verarbeitung und lässt mehr Kontextluft.
Deutsch machte 23,4% des Pretraining-Mixes aus, gegenüber 43,4% für englisches Web und Dokumente. Die Fähigkeit wird also über Daten bezahlt – nicht via nachträglichem Fine-Tuning.
Das Modell wirbt mit 1.048.576 Tokens. Nativ beherrscht es 262.144 Tokens nach einer Long-Context-Trainingsphase mit 201B Tokens und dehnt sich per Extrapolation auf 1M – es wurde also nie auf dieser Länge trainiert.
Aleph Alpha selbst empfiehlt aus Effizienzgründen, bei 262.144 Tokens oder darunter zu bleiben. RULER – ein Test, ob ein Modell spezifische Details in sehr langen Eingaben findet und nutzt – zeigt die Degradation des Basismodells: 67,9 bei 128K und 63,2 bei 1M, gegenüber 89,9 bei 128K für das zitierte Qwen3.5 35B-A3B Base.
Fairerweise schlägt Kolibri bei 1M Nemotron 3 Nano (58,5) und Qwen3.5 (57,5) immer noch – es fällt also weniger stark ab, startet aber niedriger.
Ich würde die 1M eher als technisch erreichbare Decke sehen, nicht als Arbeitsbudget.
Wenn deine Retrieval-Augmented Generation-Pipeline 400K Tokens OCR-textkonvertierter gescannter PDFs in einen Prompt stopft und erwartet, dass das Modell zuverlässig ein Detail findet, teste es, bevor du commitest. Bemerkenswert: 33,3% des Long-Context-Mixes waren OCR-PDFs – genau diese Scan-Workloads sind also das Ziel.
Reasoning-Modus heißt: Das Modell arbeitet sich Schritt für Schritt durch ein Problem, bevor es antwortet – das erhöht die Genauigkeit, kostet aber Tokens.
In Kolibri 1 ist es ein Schalter, den du steuerst – kein separates Modelltier – und Tool Calling (z. B. Datenbankabfragen per Funktion/API) ist nativ.
Aleph Alpha nennt als Hauptanwendungsfälle mehrstufiges Reasoning, RAG, agentische Tool-Nutzung, Coding und zweisprachige Assistenz. Im Mid-Training gingen 15,4% in agentischen Code und Tool Use – von nahezu null im Pretraining.
Ein anekdotischer Nutzerbericht, FP8 auf einer einzelnen RTX Pro 6000 Workstation-GPU, misst etwa 170 Tokens pro Sekunde und bemerkt eine Tendenz, viele Tokens fürs Abwägen zu verwenden.
Kalkuliere das ein, wenn du Reasoning standardmäßig in einer latenzkritischen Strecke aktiv lässt.
Kolibri 1 wurde von Grund auf trainiert – es ist kein Fine-Tune oder Abkömmling eines anderen Modells.
Das ist wichtig für die Lizenzierung und die Transparenz, was hineingeflossen ist.
In Kombination mit Apache-2.0-Gewichten heißt das: Du kannst Kolibri 1 air-gapped (komplett ohne Internet) betreiben, feinabstimmen und in ein kommerzielles Produkt integrieren – ohne jemanden um Erlaubnis zu fragen.
Der EU AI Act und sein GPAI Code of Practice setzen die EU-Regeln für General-Purpose-Modelle – inklusive Dokumentation der Trainingsdaten.
Aleph Alpha hat den Code of Practice unterzeichnet und veröffentlicht eine ausführliche Model Card zu Trainingsdatenquellen, Dekontamination (Entfernung von Benchmark-Fragen aus den Trainingsdaten) und einer Kontaktstelle für Rechteinhaber – genau die Dokumentation, die eine EU-AI-Act-Prüfung verlangt.
Für öffentliche Auftraggeber in Deutschland und der EU ist dieses Papier oft entscheidender als ein paar Benchmark-Punkte.
Und: Diesen Teil kann kein US-Lab schnell kopieren.
Die Model Card von Aleph Alpha listet die Einschränkungen offen – und die solltest du vor einer Beschaffung lesen:
Für alle sicherheitskritischen Einsätze sind zusätzliche Leitplanken und die Einhaltung der Verordnung (EU) 2024/1689 erforderlich.
Kolibri 1s Benchmark-Profil ist nutzbringend unausgewogen: Es führt im Vergleichsfeld bei Wettbewerbs-Mathe und deutschem Reasoning, verliert aber gegen Qwen3.6 35B-A3B bei Closed-Book-Wissen, MMLU-Pro und den meisten Tool-Use-Suites.
Aleph Alpha vergleicht gegen Qwen3.6 35B-A3B, Mistral Small 4 119B-A6B und Nemotron 3 Super 120B-A12B.
Die Model Card nennt außerdem Qwen3.8 27B – ein dichtes Modell (nutzt alle Parameter pro Token, im Gegensatz zu MoE) – das insgesamt höher punktet (DE gesamt 79,9 gegenüber 70,8 bei Kolibri) bei etwa achtfachen aktiven Parametern.
Ich habe es in den Tabellen unten weggelassen – behalte es bei Effizienzvergleichen im Hinterkopf.
In diesen Modellnamen steht die Zahl nach dem „A“ für aktive Parameter pro Token. 35B-A3B bedeutet also 35B gesamt und 3B aktiv. Das messen die Benchmarks unten:
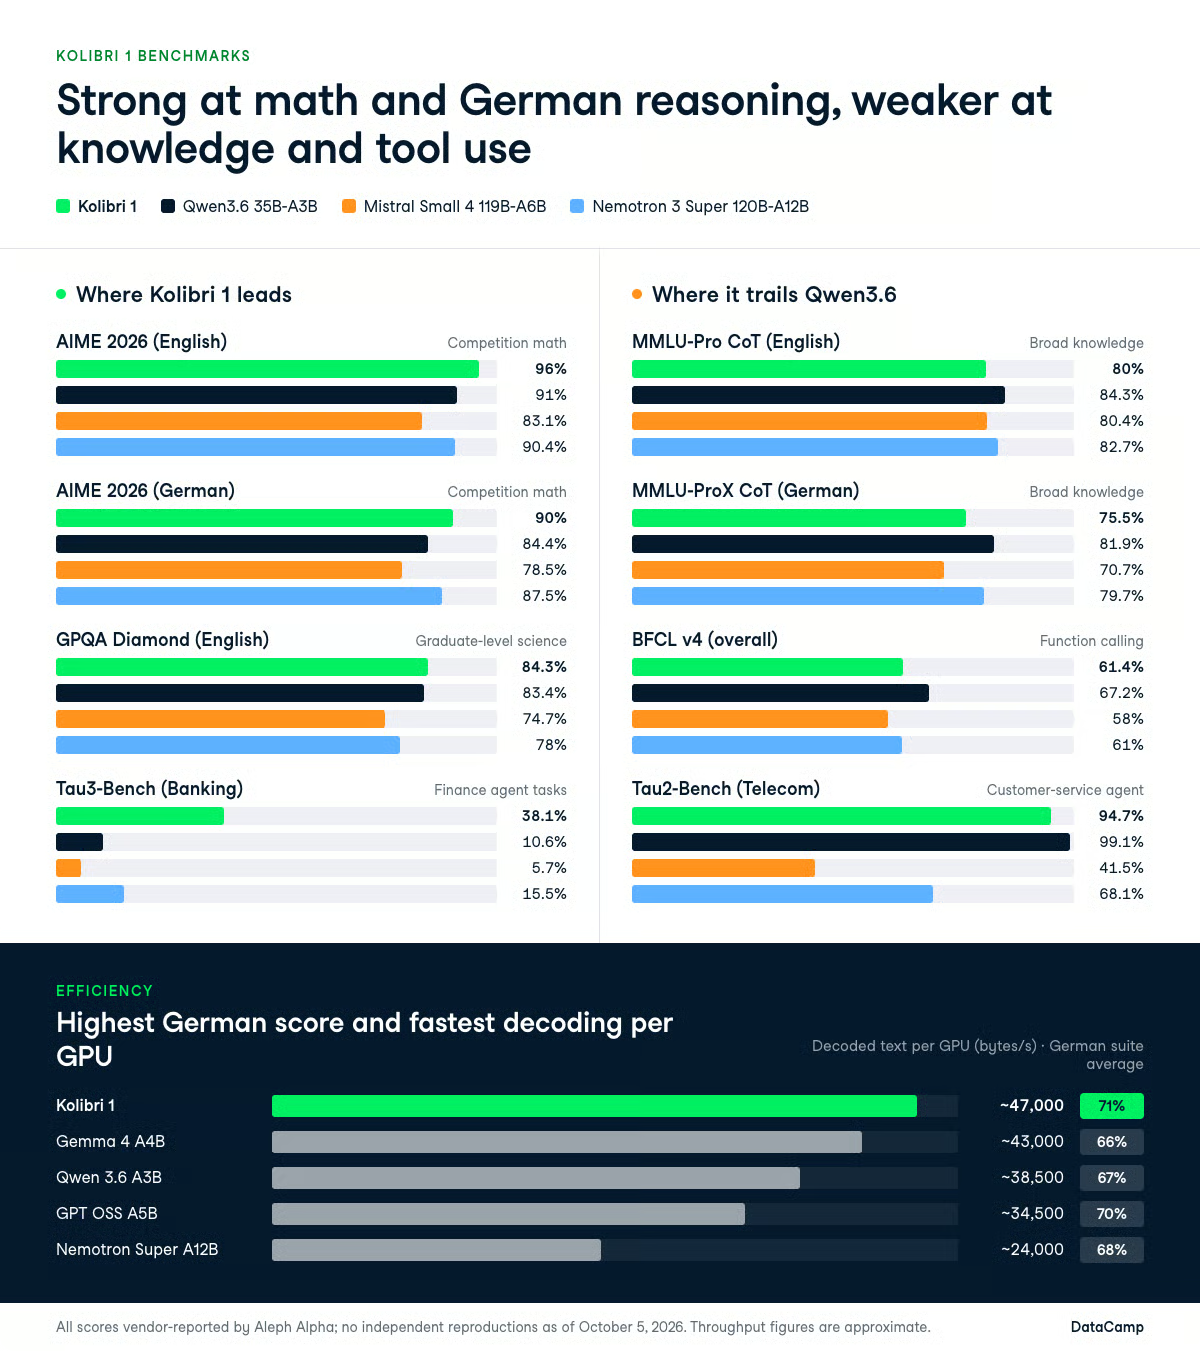
In Mathe liegt Kolibri 1 klar vorn.
Es erreicht 96% auf AIME 2026 (EN) gegenüber 91% bei Qwen3.6 35B-A3B, 90,4% bei Nemotron 3 Super und 83,1% bei Mistral Small 4 sowie 96,9% auf AIME 2025 (EN) gegenüber 84,6% bei Qwen3.6.
Auf GPQA Diamond (EN) erzielt es 84,3% vs. 83,4%, und bei Humanity's Last Exam (EN) 21,5% vs. 21,1% – praktisch Gleichstand.
Die Schwäche in derselben Tabelle ist Wissen.
Der AA-Omniscience Index (Public Set) ist so skaliert, dass negative Werte üblich sind – höher ist besser. Kolibri 1 kommt auf -32,8 gegenüber -12,5 bei Qwen3.6 und -24,0 bei Mistral Small 4; knapp vor Nemotron 3 Super (-36,5). Eine separate AA-Omniscience-Accuracy liegt bei 14,8% – der niedrigste Wert der vier.
Die Nicht-Halluzinationsrate desselben Benchmarks ist schmeichelhafter: 44,0% – vor Nemotron (13,9%) und Mistral (34,7%), aber hinter Qwen3.6 (56,7%) – passend zu Aleph Alphas Abstentions-Training.
Ein Modell mit 3,46B aktiven Parametern hat begrenzten Speicher für Fakten. Koppel es mit Retrieval statt auf Closed-Book-Recall zu vertrauen.
| Benchmark (EN) | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| AIME 2026 | 96% | 91% | 83,1% | 90,4% |
| AIME 2025 | 96,9% | 84,6% | 79,8% | 91,7% |
| GPQA Diamond | 84,3% | 83,4% | 74,7% | 78% |
| Humanity's Last Exam | 21,5% | 21,1% | 9,7% | 20,6% |
| MMLU-Pro CoT | 80% | 84,3% | 80,4% | 82,7% |
| AA-Omniscience Index (je höher, desto besser) | -32,8 | -12,5 | -24,0 | -36,5 |
Kolibri 1 gewinnt die deutschen Mathe- und Wissenschaftsbenchmarks und verliert bei den Wissensbenchmarks – also ähnlich wie auf Englisch.
Es erreicht 90% auf AIME 2026 (DE) gegenüber 84,4% bei Qwen3.6, und 81,3% auf GPQA Diamond (DE) gegenüber 80,6%. Auf MMLU-ProX CoT (DE) fällt es auf 75,5%, während Qwen3.6 81,9% und Nemotron 3 Super 79,7% erreichen; bei Humanity's Last Exam (DE) kommt es auf 15,9% gegenüber 22,3% bei Nemotron.
Spannend ist der kleine Abstand zwischen Englisch und Deutsch.
Kolibri verliert 6 Punkte beim Wechsel von AIME 2026 EN→DE und 3 Punkte bei GPQA Diamond – weniger, als man von einem Modell erwartet, das Deutsch nur als Übersetzungsziel behandelt.
| Benchmark (DE) | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| AIME 2026 | 90% | 84,4% | 78,5% | 87,5% |
| AIME 2025 | 87,5% | 82,9% | 72,3% | 85,6% |
| GPQA Diamond | 81,3% | 80,6% | 72,9% | 76,6% |
| MMLU-ProX CoT | 75,5% | 81,9% | 70,7% | 79,7% |
| Humanity's Last Exam | 15,9% | 20,5% | 10,5% | 22,3% |
Das ist der weichste Teil des Releases.
Auf BFCL v4 gesamt erzielt Kolibri 1 61,4% gegenüber 67,2% bei Qwen3.6. Auf Tau2-Bench (Telecom) kommt es auf 94,7% vs. 99,1% bei Qwen3.6. Auf Tau2-Bench (Airline) liegt Kolibri 1 mit 76,7% vor Qwen3.6 (70,7%).
Ein separat gemeldeter BFCL v3 Multi-Turn-Wert von 39,8 Punkten (Qwen3.6: 53,5) zeigt dieselbe Schwäche: Einfache Tool Calls sind okay, lange Dialoge mit wiederholten Tool-Roundtrips eher nicht.
Es gibt aber einen Ausreißer in die andere Richtung.
Auf Tau3-Bench (Banking) erzielt Kolibri 1 38,1%, während Qwen3.6 10,6%, Nemotron 3 Super 15,5% und Mistral Small 4 nur 5,7% erreichen. Das ist etwa der 2,5-fache Abstand zum nächsten Modell (3,6x zu Qwen3.6) auf einem Finance-nahen Agent-Benchmark – das eine Ergebnis, das ich am ehesten unabhängig reproduziert sehen möchte.
| Benchmark | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| Tau2-Bench (Telecom) | 94,7% | 99,1% | 41,5% | 68,1% |
| Tau2-Bench (Retail) | 69,9% | 71,6% | 62,9% | 67,5% |
| Tau2-Bench (Airline) | 76,7% | 70,7% | 40% | 72,7% |
| Tau3-Bench (Banking) | 38,1% | 10,6% | 5,7% | 15,5% |
| BFCL v4 (gesamt) | 61,4% | 67,2% | 58% | 61% |
Gemeldete Coding-Ergebnisse: 85,9 auf LiveCodeBench v6, 66,4 auf SWE-bench Verified und 27,7 auf Terminal-Bench 2.1.
Rohes Code-Generieren wirkt stark; agentisches Software-Engineering durchschnittlich; der Terminal-Bench-Wert signalisiert, dass langes mehrstufiges Terminal-Arbeiten nicht das Zielprofil ist.
Es gibt einen Kontaminationsvorbehalt, den du lesen solltest, bevor du zitierst.
Der Technical Report vermerkt, dass 48% der englischen und 47% der deutschen HumanEval-Evaluationsdaten in trainingsnahen Materialien vorkamen – HumanEval-ähnliche Scores werden dadurch aufgebläht.
Mehrere Suites in den Vergleichstabellen sind proprietär oder anbietererstellt, was die vollständige Auditierbarkeit erschwert. Verifizierte 1:1-Vergleiche gegen die aktuellen Flaggschiffe von Claude, GPT oder Gemini lagen zum Schreibzeitpunkt nicht vor.
Der Effizienz-Claim übersteht den Vendor-Reporting-Vorbehalt am besten – er ist eine Architektureigenschaft, kein Score.
Durchsatz meint hier: Wie viel Text ein Modell pro GPU und Sekunde generiert. Aleph Alpha misst in Bytes statt Tokens, damit Modelle mit unterschiedlichen Tokenizern fair vergleichbar sind.
Kolibri 1 liegt bei 71% Durchschnitt auf Aleph Alphas deutscher Benchmark-Suite und dekodiert rund 47.000 Bytes/s pro GPU. GPT OSS A5B erreicht 70% bei ca. 34.500 Bytes/s, Qwen 3.6 A3B 67% bei ca. 38.500, Gemma 4 A4B 66% bei ca. 43.000 und Nemotron Super A12B 68% bei ca. 24.000.
Etwa doppelt so viel dekodierten Text pro GPU wie Nemotron bei höherem deutschen Durchschnitt zu serven, ist das praktische Argument für Kolibri im Self-Hosted-Stack.
Wenn du für eigene GPUs bezahlst statt pro Token, zeigt sich Durchsatz pro GPU auf der Rechnung.
Es gibt keinen veröffentlichten Tokenpreis für Kolibri 1.
Aleph Alpha hat keine Hosted-API-Preisliste veröffentlicht, und zum 5. Oktober 2026 tauchte keine bestätigte Kolibri-API-Model-ID in der offiziellen API-Dokumentation auf.
Enterprise-Deployments laufen über das Vertriebsteam von Aleph Alpha, und der Repository-Identifier Aleph-Alpha/Kolibri-1 ist keine API-Model-ID.
Die Gewichte selbst sind unter Apache 2.0 frei – deine Kosten sind GPU-Zeit.
Der FP8-Speicherbedarf liegt bei rund 78 GB, mit einem angegebenen Minimum von 2× A100 80 GB, 2× H100 SXM5, 1× H200, 1× B200 oder 1× B300 und einer Empfehlung von 2× H100 SXM5, 2× H200, 1× B200 oder 1× B300. Das Modell ist allgemein verfügbar, kein Preview, ohne Warteliste oder Regionssperre.
Zum Vergleich: Unsere GPT-6.1-Sol-Berichterstattung nennt $2 Input / $10 Output pro Million Tokens. Eine Drittübersicht führt das ältere GPT-5.6 Sol mit $5 / $30 und GPT-5.6 Luna mit $0,20 / $1,20 nach OpenAIs Preissenkung vom 30. Juli.
Self-Hosting rechnet sich pro Einheit erst, wenn dein Volumen die Fixkosten einer B200 übersteigt.
Kolibri 1 ist Open-Weight unter Apache 2.0 – erlaubt kommerzielle Nutzung, Modifikation und Weiterverteilung ohne Umsatz- oder Nutzergrenzen.
Die Gewichte liegen als Aleph-Alpha/Kolibri-1 auf Hugging Face in float8_e4m3fn. Die Model Card dokumentiert Serving ausschließlich über vLLM mit Aleph Alphas aleph-alpha-inference-Plugin. Community-Builds in GGUF und MLX erschienen binnen Tagen, wurden von Aleph Alpha aber nicht validiert; einen offiziellen Ollama-Eintrag konnte ich nicht finden.
Für ein Served-Deployment passen ~78 GB FP8-Gewichte auf 1× H200 oder 1× B200. Auf H100s nutze --tensor-parallel-size 2.
Setze --max-model-len auf 262.144 oder darunter, außer du hast längere Kontexte explizit getestet. Darüber hinaus braucht es einen zusätzlichen --hf-overrides-Schalter, den die Model Card dokumentiert.
Installiere das Plugin und starte den Server:
pip install 'aleph-alpha-inference>=1'

# Add --tensor-parallel-size 2 on 2x H100
vllm serve Aleph-Alpha/Kolibri-1 \
  --kv-cache-dtype fp8 \
  --max-model-len 262144 \
  --reasoning-parser kolibri1 \
  --tool-call-parser kolibri1 \
  --enable-auto-tool-choice
Dann fragst du es über die OpenAI-kompatible API ab – mit den von Aleph Alpha empfohlenen Sampling-Parametern (temperature 1.0, top_p 0,97, top_k 128):
from openai import OpenAI

client = OpenAI(base_url="http://localhost:8000/v1", api_key="EMPTY")

response = client.chat.completions.create(
    model="Aleph-Alpha/Kolibri-1",
    messages=[{
        "role": "user",
        "content": "Fasse die wichtigsten Fristen aus diesem Bescheid in drei Punkten zusammen.",
    }],
    temperature=1.0,
    top_p=0.97,
    max_tokens=512,
    extra_body={
        "top_k": 128,
        "chat_template_kwargs": {"reasoning_effort": "medium"},
    },
)
print(response.choices[0].message.content)
Reasoning-Effort akzeptiert low, medium und high. Du kannst das „Denken“ komplett abschalten, wenn Latenz wichtiger ist als Tiefe.
Outputs variieren mit Sampling-Parametern; die Model Card vermerkt leichte Abweichungen selbst bei deaktiviertem Sampling.
Für tiefere Setups zu Self-Hosted Inference und Agent-Loops deckt unser API-Tutorial zum Bau eines Migrationsagenten die Tool-Permissions und Steuerungsmuster ab, die direkt übertragbar sind.
Kolibri one ist nominell „souveräne KI“: Ein Land oder eine Organisation kann seine KI auf eigener Infrastruktur und unter eigener Jurisdiktion betreiben, prüfen und steuern – ohne von einer fremden API, Preisgestaltung oder AGB abhängig zu sein. Bei Kolibri 1 stützt sich das auf Apache-2.0-Gewichte für Air-Gap-Betrieb, europäische Trainingsinfrastruktur und EU-AI-Act-Dokumentation.
Hinter dem Launch stehen jedoch zwei unternehmensseitige Kontexte.
Aleph Alpha hat eine verbindliche Fusionsvereinbarung mit dem kanadischen Unternehmen Cohere unterzeichnet, um die – so die Darstellung – erste transatlantische Lösung für souveräne KI zu bilden.
Das kombinierte Unternehmen tritt unter dem Namen Cohere auf, mit Doppel-HQ in Toronto und Berlin; Heidelberg bleibt Forschungsstandort. Der Deal steht noch unter regulatorischem Vorbehalt.
Ein Souveränitätsversprechen hängt daran, dass der Model-Eigner das Modell weiter unterstützt. Die Marke Aleph Alpha wird nach Abschluss der Fusion in Cohere aufgehen – beides sollte man neben den Benchmarks im Blick behalten.
Aleph Alpha setzt darauf, dass Souveränität, Apache-2.0-Lizenz und dokumentierte EU-AI-Act-Konformität für europäische öffentliche Auftraggeber mehr zählen als ein paar Punkte auf MMLU-Pro.
Diese Wette wirkt plausibel – und die Fusion mit Cohere zeigt, dass das Unternehmen weiß, dass es allein über Skalierung nicht gewinnen kann.
Man kann fair sagen: Kolibri 1 ist das beste deutschsprachige Open-Weight-Modell mit dieser aktiven Parametergröße, das so gründlich dokumentiert wurde. Für lange Multi-Turn-Agent-Runs oder Closed-Book-Faktenabruf würde ich es jedoch nicht zuerst wählen.
Unter vergleichbaren Small-Active-MoE-Modellen gewinnt Qwen3.6 35B-A3B weiterhin. Wenn du dir ein dichtes 27B-Modell leisten kannst, gewinnt Qwen3.8 27B klar.
Wenn du lernen willst, wie man Modelle wie dieses betreibt und bewertet, starte mit unserem AI Fundamentals Skill Track.
Top-DataCamp-Kurse
Kurs
Kurs
Kurs
Blog
Blog
Hesam Sheikh Hassani
15 Min.
Blog
Nathaniel Taylor-Leach
8 Min.
Tutorial
Josef Waples
8 Min.
Tutorial
Derrick Mwiti
10 Min.
Tutorial
Matt Crabtree
5 Min.


