강의
개발자를 위한 AI 보조 코딩
1시간 30분
10.5K
새로운 회사가 LLM 경쟁에 뛰어든 지 한동안 뜸했습니다. 그런데 10월 3일, Aleph Alpha가 새 모델 Kolibri 1을 Apache 2.0 라이선스로 Hugging Face에 공개하며 유럽이 주권형 AI를 진지하게 받아들이라고 메시지를 던졌습니다.
핵심 제안은 유럽의 정부와 기업이 미국 공급자의 API에 의존하지 않고, 자체 하드웨어에서 심지어 완전 오프라인으로도 충분히 유능한 모델을 운영할 수 있다는 점입니다.
Kolibri 1은 총 780억 파라미터를 갖춘 mixture-of-experts(MoE) 모델로, 토큰당 활성 파라미터는 34.6억입니다. Aleph Alpha Research가 독일과 핀란드의 데이터센터에서 NVIDIA B200 GPU 768대로 제로부터 학습시켰습니다.
이 모델은 독일어와 영어만 처리하며, 1,048,576토큰의 컨텍스트 윈도를 지원합니다(Aleph Alpha는 서비스 효율을 위해 262,144토큰 이하 사용을 권장). 사전 공개가 아닌 일반 배포로 제공됩니다. 사전학습은 20조 토큰으로 수행되었고, 이어서 3.44조 토큰의 중간 학습, 201억 토큰의 장문 컨텍스트 확장 학습이 진행되었습니다.
이 글에서는 Kolibri 1의 새로운 점을 모두 살펴보며 핵심 기능, 벤치마크, 그리고 실제 운영 비용까지 짚어보겠습니다.
Kolibri 1은 Aleph Alpha가 2026년 10월 3일 Apache 2.0으로 공개한 특화 이중언어 대형 언어 모델(LLM)입니다. 크기 변형 없이 단일 일반 배포 버전만 제공합니다.
내부적으로는 50층짜리 mixture-of-experts 트랜스포머입니다.
각 층에는 전문가(expert)라 불리는 소형 특화 서브네트워크 384개가 있으며, 라우터가 매 토큰을 그중 6개로만 보냅니다. 여기에 항상 실행되는 공유 전문가 1개가 추가됩니다. 이렇게 해서 총 781억 파라미터가 토큰당 활성 34.6억(약 4.4%)으로 줄어들며, 최대 용량보다 저비용 서비스에 초점을 맞춘 설계가 됩니다.
속도와 메모리 사용을 낮추기 위한 추가 설계도 두 가지가 있습니다:
Aleph Alpha가 강조하는 핵심 성과는 절대 성능보다는 효율성입니다.
Kolibri 1은 GPU당 초당 약 47,000바이트의 텍스트를 디코딩하면서 독일어 벤치마크 모음에서 평균 71%를 기록합니다. 이는 Nemotron Super A12B의 약 24,000바이트/초에서 68%와 대비됩니다.
지식 컷오프는 두 언어 모두 2026년 6월 18일이며, 이미지·오디오·비디오 입출력 없이 텍스트 전용입니다.
독일어 성능의 근거가 무엇인지 보고 싶다면, 공개된 데이터 믹스가 오픈-웨이트 공개치고는 이례적으로 투명합니다.
| 도메인 | 사전학습 | 중간 학습 | 장문 컨텍스트 확장 |
|---|---|---|---|
| 영어 웹과 문서 | 43.4% | 1.3% | 15.8% |
| 독일어 웹과 문서 | 23.4% | 2.1% | 2.6% |
| 코드 | 13.6% | 16.3% | 13.2% |
| 에이전틱 코드와 도구 사용 | ~0% | 15.4% | 5.6% |
| OCR 처리된 PDF | 0% | 0% | 33.3% |
표에는 웹, 코드, 에이전틱, PDF 행만 보였습니다. 모델 카드에는 영어와 독일어의 지시·추론 데이터, STEM 문서, QA, 특화된 법률 및 공공 부문 데이터도 나열되어 있습니다. 영어와 독일어 전체 항목을 합산하면, 모델 카드는 사전학습 믹스를 영어 약 62.5%, 독일어 23.9%, 코드 13.6%로 요약합니다.
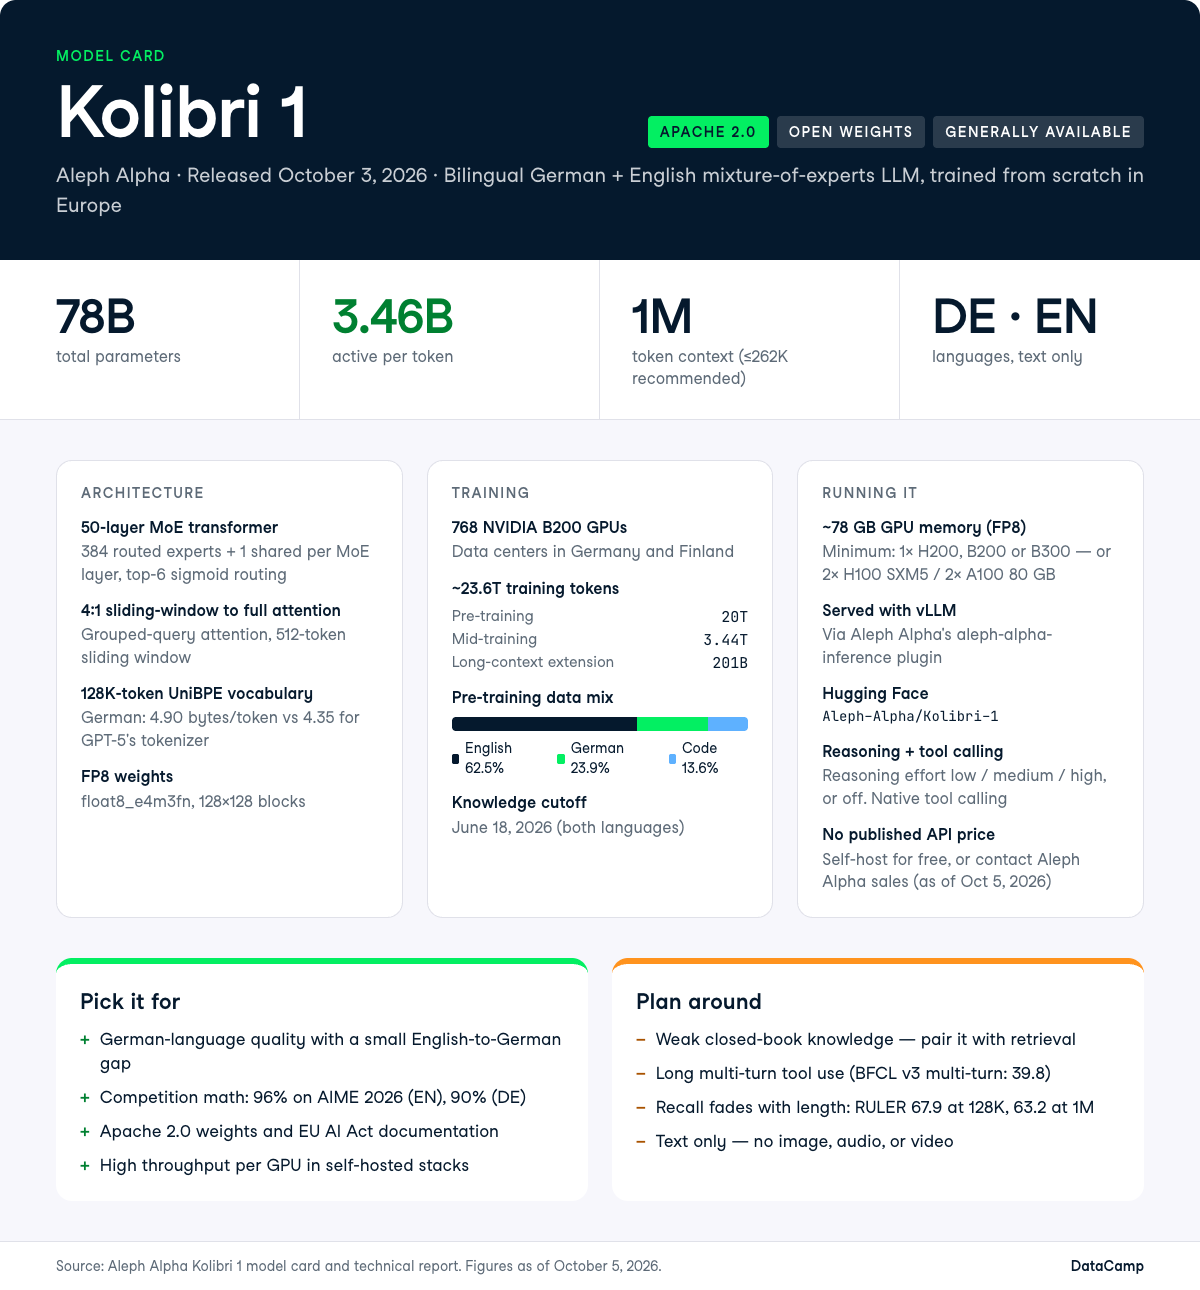
Kolibri 1을 차별화하는 지점은 두 가지 결정으로 요약됩니다. 독일어를 번역으로 땜질하지 않고 제대로 학습했다는 점, 그리고 단일 H200에서도 서비스를 돌릴 수 있을 만큼 활성 파라미터 수를 낮게 유지했다는 점입니다.
Kolibri 1은 예상보다 독일어와 영어 간 격차를 크게 좁혔습니다. 이 규모의 오픈-웨이트 모델로는 이례적입니다.
전체 벤치마크 평균은 영어 75.5, 독일어 70.8입니다.
Aleph Alpha는 UniBPE라는 새 토크나이저 알고리즘으로 128,000 토큰의 어휘를 학습했습니다. 바이트 페어 인코딩의 탐욕적(bottom-up) 병합은 유지하면서, 어떤 병합을 어휘에 넣을지는 Unigram 목적함수로 선택합니다.
공개된 수치에 따르면 독일어 압축률은 토큰당 4.90바이트로, GPT-5 토크나이저의 4.35보다 좋고, 영어는 토큰당 4.58바이트를 유지합니다(GPT-5 토크나이저는 4.67).
이는 품질만큼이나 비용에도 중요합니다.
압축이 잘 되면 같은 독일어 문서에서 토큰 수가 줄어듭니다. 따라서 50쪽짜리 Bescheid (독일 행정기관의 공식 통지서)를 처리하는 비용이 낮아지고, 컨텍스트에 더 많은 공간이 남습니다.
사전학습 믹스에서 독일어 비중은 23.4%로, 영어 웹·문서 43.4%에 비해 적지 않은 비중입니다. 즉, 주요 학습 이후 파인튜닝으로 덧씌운 것이 아니라 데이터로 성능을 확보했습니다.
이 모델은 1,048,576토큰을 광고합니다. 201억 토큰의 장문 컨텍스트 학습 이후 262,144토큰은 네이티브로 처리하고, 100만 토큰은 외삽으로 확장합니다. 즉, 그 길이로는 학습된 적이 없습니다.
Aleph Alpha 역시 서비스 효율을 위해 262,144토큰 이하를 권장합니다. 매우 긴 입력에서 특정 세부 정보를 찾아 활용할 수 있는지 측정하는 RULER에서는 베이스 모델 기준 성능 저하가 보입니다: 128K에서 67.9, 1M에서 63.2. 비교로 제시된 Qwen3.5 35B-A3B Base는 128K에서 89.9입니다.
공정하게 말하면, Kolibri의 1M 점수는 같은 길이에서 Nemotron 3 Nano(58.5)와 Qwen3.5(57.5)보다 높아, 더 낮은 출발점에서 시작했음에도 하락 폭은 더 적습니다.
100만 토큰은 실사용 예산이 아니라 기술적으로 도달 가능한 상한으로 보는 편이 좋겠습니다.
만약 검색 증강 생성(RAG) 파이프라인이 스캔된 PDF를 텍스트로 변환한 자료(OCR) 40만 토큰을 프롬프트에 넣고, 모델이 특정 세부 정보를 안정적으로 찾기를 기대한다면, 도입 전에 반드시 테스트하세요. 특히 장문 컨텍스트 확장 믹스의 33.3%가 OCR 처리된 PDF였던 만큼, 스캔 문서 업무가 분명 주요 사용 사례입니다.
추론 모드는 답변 전에 문제를 단계별로 풀어가며 사고하도록 하여 정확도를 높이지만, 토큰 사용량이 늘어납니다.
Kolibri 1에서는 별도 모델 티어가 아닌 스위치로 제어할 수 있고, 도구 호출(데이터베이스 조회 같은 외부 함수나 API를 호출할지 모델이 스스로 결정)도 네이티브로 지원합니다.
Aleph Alpha는 의도된 사용 사례로 다단계 추론, RAG, 에이전틱 도구 호출, 코딩, 이중언어 비서 업무를 제시합니다. 중간 학습 믹스에서 에이전틱 코드와 도구 사용이 15.4%를 차지했는데, 이는 사전학습 단계의 사실상 0%에서 크게 늘어난 수치입니다.
일화적 사용자 보고에 따르면, 워크스테이션용 RTX Pro 6000 단일 GPU에서 FP8로 실행 시 초당 약 170토큰이 측정되었고, 숙고에 토큰을 많이 쓰는 경향이 관찰되었습니다.
지연에 민감한 경로에서 기본으로 추론 모드를 켜둔다면, 그만큼의 예산을 잡아두세요.
Kolibri 1은 제로부터 학습했기 때문에 다른 회사 모델의 파인튜닝이나 복제본이 아닙니다.
이는 라이선스 측면과, 무엇이 들어갔는지를 정확히 아는 측면에서 중요합니다.
Apache 2.0 가중치와 결합되어, Kolibri 1을 에어갭(인터넷과 완전 분리) 환경에서 실행하고, 파인튜닝하며, 상용 제품에 포함해 출하할 수 있습니다. 누구의 허락도 필요 없습니다.
EU AI Act와 그 일반목적 AI(GPAI) 실천 강령은 범용 모델에 대한 EU의 규칙을 정하며, 학습 데이터 문서화도 포함합니다.
Aleph Alpha는 실천 강령 서명사로, 학습 데이터 출처, 비오염화 단계(벤치마크 문항의 학습 데이터 제거), 권리자 연락처를 포함한 상세 모델 카드를 공개합니다. 이는 EU AI Act 준수 심사에서 요구되는 문서입니다.
독일 및 EU 공공 부문 구매자에게는, 종종 벤치마크 격차보다 이런 서류가 결정적 요인입니다.
그리고 이는 어떤 미국 연구소도 단기간에 복제하기 어려운 부분입니다.
Aleph Alpha의 모델 카드는 한계를 공개적으로 명시하고 있으며, 조달 결정을 내리기 전에 읽어볼 가치가 있습니다:
중요도가 높은 모든 배포에서는, 추가적인 안전장치와 EU 규정(Regulation (EU) 2024/1689) 준수가 필요하다고 Aleph Alpha는 밝힙니다.
Kolibri 1의 벤치마크 프로필은 유용하게도 비대칭적입니다. 대회 수학과 독일어 추론에서는 비교군을 선도하지만, 폐쇄형 지식, MMLU-Pro, 대부분의 도구 사용에서는 Qwen3.6 35B-A3B에 밀립니다.
Aleph Alpha는 비교 대상으로 Qwen3.6 35B-A3B, Mistral Small 4 119B-A6B, Nemotron 3 Super 120B-A12B를 제시합니다.
모델 카드에는 Qwen3.8 27B도 기재되어 있는데, 이는 MoE와 달리 매 토큰에 모든 파라미터를 사용하는 밀집(dense) 모델로 전반적으로 더 높은 점수를 냅니다(전체 독일어 79.9, Kolibri 70.8 대비). 활성 파라미터는 대략 8배입니다.
아래 표에서는 제외했지만, 효율성 주장들을 읽을 때 염두에 두세요.
이들 모델명에서 "A" 뒤 숫자는 토큰당 활성 파라미터를 뜻합니다. 예를 들어 35B-A3B는 총 350억, 활성 30억입니다. 아래 표의 벤치마크는 다음을 측정합니다:
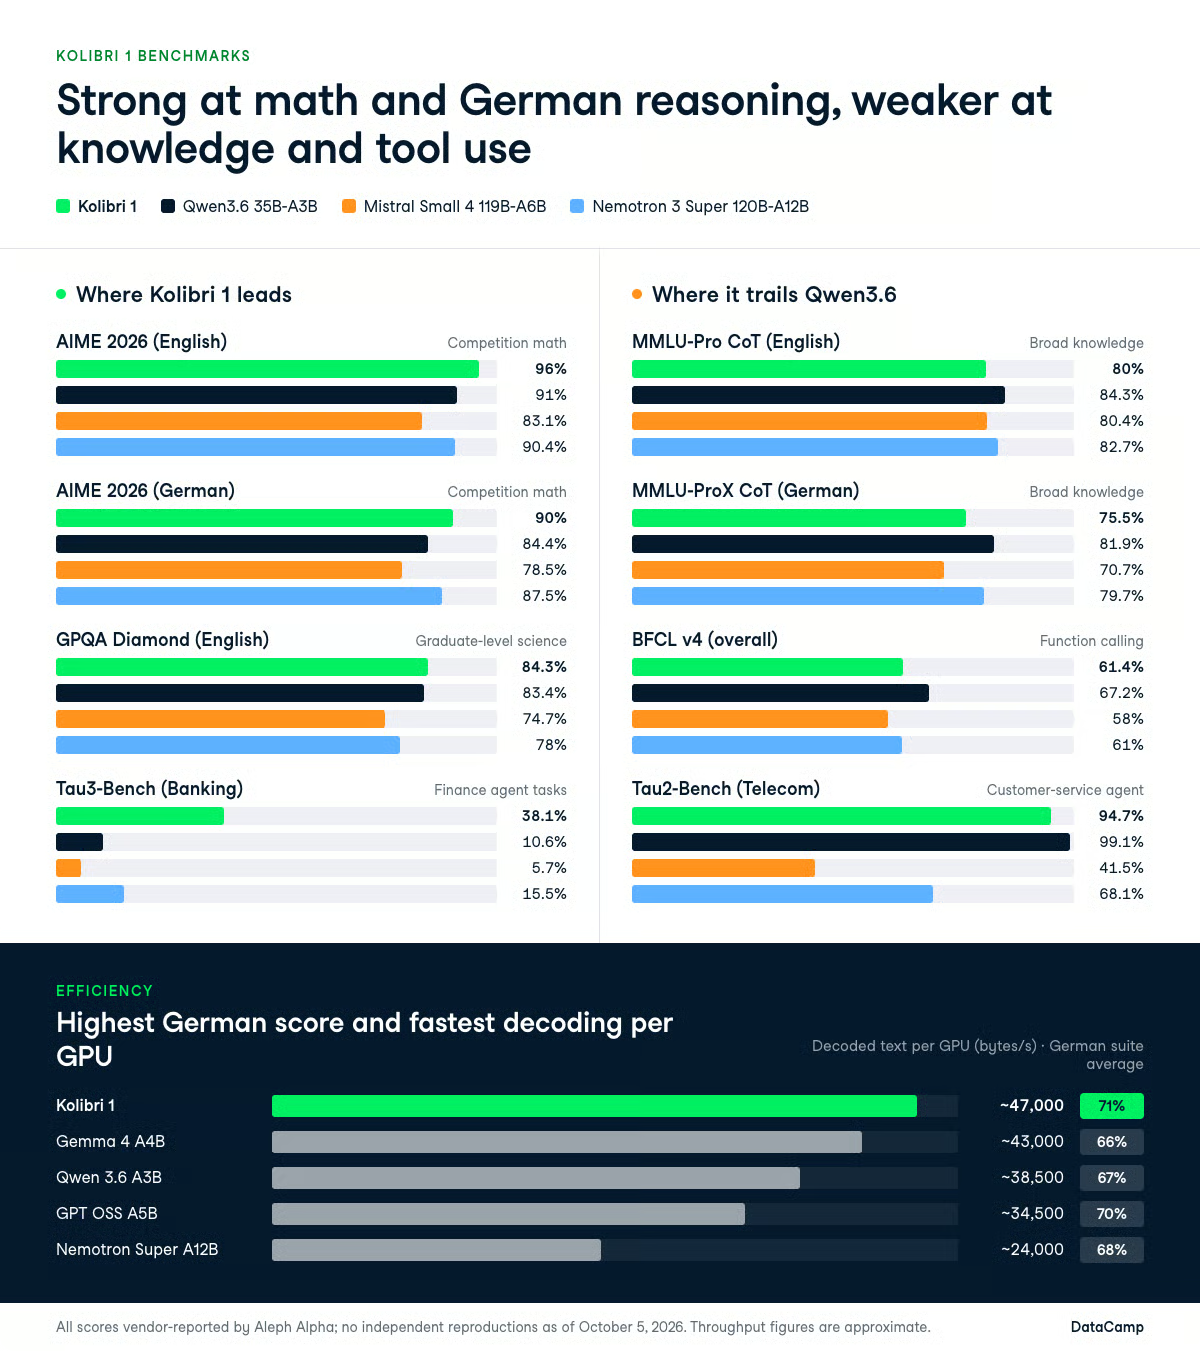
수학에서는 Kolibri 1의 우위가 뚜렷합니다.
AIME 2026 (EN)에서 96%를 기록해 Qwen3.6 35B-A3B의 91%, Nemotron 3 Super의 90.4%, Mistral Small 4의 83.1%를 앞섰고, AIME 2025 (EN)에서도 Qwen3.6의 84.6% 대비 96.9%입니다.
GPQA Diamond (EN)에서는 84.3% 대 83.4%, Humanity's Last Exam (EN)에서는 21.5% 대 21.1%로 모두 사실상 무승부에 가깝습니다.
같은 표에서 약점은 지식 영역입니다.
AA-Omniscience Index(공개 세트)는 음수가 흔하고 값이 높을수록 좋은 척도입니다. Kolibri 1은 Qwen3.6의 -12.5, Mistral Small 4의 -24.0 대비 -32.8을 기록했고, Nemotron 3 Super의 -36.5보다는 근소하게 높습니다. 별도로 보고된 AA-Omniscience 정확도는 14.8%로 네 모델 중 최저입니다.
같은 벤치마크에서의 비환각률은 44.0%로 더 체면이 서는 수치입니다. Nemotron(13.9%)과 Mistral(34.7%)보다 높지만 Qwen3.6(56.7%)에는 뒤지며, 이는 Aleph Alpha의 기권(abstention) 학습과 맞아떨어집니다.
활성 파라미터 34.6억 모델은 사실을 암기할 여지가 제한적이므로, 폐쇄형 책상 테스트에 의존하기보다 검색 결합형으로 운용하는 편이 낫습니다.
| Benchmark (EN) | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| AIME 2026 | 96% | 91% | 83.1% | 90.4% |
| AIME 2025 | 96.9% | 84.6% | 79.8% | 91.7% |
| GPQA Diamond | 84.3% | 83.4% | 74.7% | 78% |
| Humanity's Last Exam | 21.5% | 21.1% | 9.7% | 20.6% |
| MMLU-Pro CoT | 80% | 84.3% | 80.4% | 82.7% |
| AA-Omniscience Index (higher is better) | -32.8 | -12.5 | -24.0 | -36.5 |
Kolibri 1은 독일어 수학과 과학 벤치마크에서 앞서고, 독일어 지식 벤치마크에서는 밀리는 양상으로 영어 프로필과 동일한 형태를 보입니다.
AIME 2026 (DE)에서 90%로 Qwen3.6의 84.4%를 앞섰고, GPQA Diamond (DE)에서는 81.3%로 80.6% 대비 근소 우위입니다. MMLU-ProX CoT (DE)에서는 75.5%로 하락하는 반면 Qwen3.6은 81.9%, Nemotron 3 Super는 79.7%이며, Humanity's Last Exam (DE)에서는 15.9%로 Nemotron의 22.3%에 미치지 못합니다.
진짜 흥미로운 대목은 영어 대비 독일어 격차가 작다는 점입니다.
Kolibri는 AIME 2026을 영어에서 독일어로 옮길 때 6점, GPQA Diamond에서는 3점이 떨어지는데, 이는 독일어를 단순 번역 대상으로 취급하는 모델에서 기대하는 하락폭보다 좁습니다.
| Benchmark (DE) | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| AIME 2026 | 90% | 84.4% | 78.5% | 87.5% |
| AIME 2025 | 87.5% | 82.9% | 72.3% | 85.6% |
| GPQA Diamond | 81.3% | 80.6% | 72.9% | 76.6% |
| MMLU-ProX CoT | 75.5% | 81.9% | 70.7% | 79.7% |
| Humanity's Last Exam | 15.9% | 20.5% | 10.5% | 22.3% |
이 부분이 이번 공개에서 가장 약한 대목입니다.
BFCL v4 전체에서는 Kolibri 1이 61.4%로 Qwen3.6의 67.2%에 뒤지며, Tau2-Bench (Telecom)에서도 94.7%로 Qwen3.6의 99.1%에 못 미칩니다. 다만 Tau2-Bench (Airline)에서는 76.7% 대 70.7%로 Qwen3.6을 근소하게 앞섭니다.
별도로 보고된 BFCL v3 멀티턴 수치 39.8점(Qwen3.6은 53.5)은 같은 약점을 보여줍니다. 단발 도구 호출은 괜찮지만, 도구 왕복이 반복되는 장기 대화에는 약합니다.
특이점은 반대 방향에서 나옵니다.
Tau3-Bench (Banking)에서 Kolibri 1은 38.1%를 기록한 반면 Qwen3.6은 10.6%, Nemotron 3 Super는 15.5%, Mistral Small 4는 5.7%에 그칩니다. 이는 이 비교 세트에서 차점 모델 대비 대략 2.5배(Qwen3.6 대비 3.6배)에 해당하는 격차로, 금융 성격의 에이전트 벤치마크에서 나온 결과이며, 이번 공개 중 가장 독립 재현을 보고 싶은 단일 결과입니다.
| Benchmark | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| Tau2-Bench (Telecom) | 94.7% | 99.1% | 41.5% | 68.1% |
| Tau2-Bench (Retail) | 69.9% | 71.6% | 62.9% | 67.5% |
| Tau2-Bench (Airline) | 76.7% | 70.7% | 40% | 72.7% |
| Tau3-Bench (Banking) | 38.1% | 10.6% | 5.7% | 15.5% |
| BFCL v4 (overall) | 61.4% | 67.2% | 58% | 61% |
보고된 코딩 성능은 LiveCodeBench v6에서 85.9, SWE-bench Verified에서 66.4, Terminal-Bench 2.1에서 27.7입니다.
순수 코드 생성은 강해 보이지만, 에이전트형 소프트웨어 엔지니어링은 평범하고, Terminal-Bench 수치는 이 모델이 다단계 장기 터미널 작업에는 맞지 않음을 시사합니다.
인용 전 읽어야 할 오염(contamination) 주의사항이 있습니다.
기술 보고서에 따르면 HumanEval 평가 데이터의 48%(영어)와 47%(독일어)가 학습 관련 자료에 포함되어 HumanEval 스타일 점수를 부풀릴 수 있습니다.
비교 표에 포함된 여러 스위트는 독점 또는 벤더 제작으로 전체 세트의 감사를 어렵게 하며, 작성 시점 기준으로 최신 Claude, GPT, Gemini 플래그십과의 검증된 동등 비교는 존재하지 않았습니다.
효율성 주장은 벤더 보고 한계를 가장 잘 견디는 부분입니다. 점수가 아니라 아키텍처의 속성이기 때문입니다.
여기서 처리량은 GPU당 초당 모델이 생성할 수 있는 텍스트 양을 뜻합니다. Aleph Alpha는 토큰이 아닌 바이트로 측정해 토크나이저가 다른 모델도 공정하게 비교합니다.
Kolibri 1은 Aleph Alpha의 독일어 벤치마크 모음에서 평균 71%를 기록하면서 GPU당 초당 약 47,000바이트를 디코딩합니다. GPT OSS A5B는 약 34,500바이트/s에서 70%, Qwen 3.6 A3B는 약 38,500바이트/s에서 67%, Gemma 4 A4B는 약 43,000바이트/s에서 66%, Nemotron Super A12B는 약 24,000바이트/s에서 68%입니다.
독일어 평균이 더 높은 상태에서 Nemotron 모델 대비 GPU당 약 2배의 텍스트를 제공한다는 점은, 자체 호스팅 스택에서 Kolibri를 선택할 실용적 근거가 됩니다.
토큰당 과금이 아니라 GPU를 직접 결제한다면, GPU당 처리량이 바로 청구서에 찍히는 숫자입니다.
Kolibri 1에는 공개된 토큰 단가가 없습니다.
Aleph Alpha는 호스팅 API 가격표를 공개하지 않았고, 2026년 10월 5일 기준 공식 API 문서에 확인된 Kolibri API 모델 ID도 나타나지 않았습니다.
엔터프라이즈 배포는 Aleph Alpha 영업팀을 통해 진행되며, 저장소 식별자 Aleph-Alpha/Kolibri-1은 API 모델 ID로 취급하면 안 됩니다.
가중치 자체는 Apache 2.0으로 무료이므로 비용은 GPU 시간입니다.
FP8 메모리 풋프린트는 약 78 GB이며, 최소 사양으로 2x A100 80 GB, 2x H100 SXM5, 1x H200, 1x B200, 1x B300이 제시되어 있고, 권장 구성은 2x H100 SXM5, 2x H200, 1x B200, 1x B300입니다. 미리보기나 웨이팅 리스트, 지역 제한 없이 일반 제공됩니다.
비교 기준을 위해, 우리의 GPT-6.1 Sol 커버리지는 해당 모델의 단가를 입력 100만 토큰당 $2, 출력 100만 토큰당 $10로 제시합니다. 제3자 가격 요약은 이전 GPT-5.6 Sol을 $5 / $30, GPT-5.6 Luna를 OpenAI의 7월 30일 가격 인하 이후 $0.20 / $1.20로 기재합니다.
자체 호스팅은 B200의 고정비를 넘는 규모가 되어야 단위 경제성에서 유리해집니다.
Kolibri 1은 Apache 2.0 규정의 오픈 웨이트로, 사용자 수나 매출 기준 없이 상업적 사용, 수정, 재배포가 가능합니다.
가중치는 Hugging Face의 Aleph-Alpha/Kolibri-1에 float8_e4m3fn 형식으로 제공됩니다. 모델 카드는 Aleph Alpha의 aleph-alpha-inference 플러그인을 사용하는 vLLM 서빙만 문서화합니다. 커뮤니티 GGUF와 MLX 빌드는 며칠 내 등장했지만 Aleph Alpha가 검증하지 않았고, 공식 Ollama 항목은 찾지 못했습니다.
서빙 배포의 경우, 1x H200 또는 1x B200으로 약 78 GB의 FP8 가중치를 단일 카드에 올릴 수 있습니다. H100에서는 --tensor-parallel-size 2를 사용하세요.
특별히 더 긴 컨텍스트를 테스트하지 않았다면 --max-model-len을 262,144 이하로 유지하세요. 그보다 길게 가려면 추가 --hf-overrides 플래그가 필요하며, 모델 카드에 문서화되어 있습니다.
플러그인을 설치하고 서버를 시작하세요:
pip install 'aleph-alpha-inference>=1'

# Add --tensor-parallel-size 2 on 2x H100
vllm serve Aleph-Alpha/Kolibri-1 \
  --kv-cache-dtype fp8 \
  --max-model-len 262144 \
  --reasoning-parser kolibri1 \
  --tool-call-parser kolibri1 \
  --enable-auto-tool-choice
그런 다음 OpenAI 호환 API를 통해 질의하고, Aleph Alpha가 권장하는 샘플링 파라미터(temperature 1.0, top_p 0.97, top_k 128)를 사용하세요:
from openai import OpenAI

client = OpenAI(base_url="http://localhost:8000/v1", api_key="EMPTY")

response = client.chat.completions.create(
    model="Aleph-Alpha/Kolibri-1",
    messages=[{
        "role": "user",
        "content": "Fasse die wichtigsten Fristen aus diesem Bescheid in drei Punkten zusammen.",
    }],
    temperature=1.0,
    top_p=0.97,
    max_tokens=512,
    extra_body={
        "top_k": 128,
        "chat_template_kwargs": {"reasoning_effort": "medium"},
    },
)
print(response.choices[0].message.content)
reasoning_effort는 low, medium, high를 허용하며, 지연 시간을 깊이보다 우선시한다면 사고 과정을 완전히 끌 수도 있습니다.
출력은 샘플링 파라미터에 따라 달라지며, 샘플링을 꺼도 약간의 차이가 발생할 수 있다고 모델 카드에 명시되어 있습니다.
자가 호스팅 추론과 에이전트 루프에 대한 더 깊은 설정 작업은, 마이그레이션 에이전트 구축을 다룬 우리의 API 튜토리얼에서 도구 권한과 스티어링 패턴을 그대로 적용할 수 있습니다.
Kolibri one은 이론상 '주권형 AI'로, 외국 공급자의 API, 가격, 약관에 의존하지 않고 자체 인프라와 관할권 아래에서 모델을 운영·감사·통제할 수 있다는 뜻입니다. Kolibri 1의 근거는 오프라인(인터넷 미연결) 운용이 가능한 Apache 2.0 가중치, 유럽 내 학습 인프라, EU AI Act 문서화에 있습니다.
다만 이번 출시의 배경에는 두 가지 기업적 맥락이 있습니다.
Aleph Alpha는 캐나다 기업 Cohere와의 구속력 있는 합병 계약을 체결했으며, 이를 통해 최초의 대서양 횡단 주권형 AI 솔루션을 표방한다고 밝혔습니다.
통합 법인은 Cohere 이름으로 운영되며, 본사는 토론토와 베를린의 이중 체제로, 하이델베르크는 연구 거점으로 지속됩니다. 거래는 아직 규제 승인이 필요합니다.
주권성 제안은 모델 소유자가 지속적으로 지원하는지에 달려 있으며, 합병이 마무리되면 Aleph Alpha 브랜드는 Cohere로 흡수될 예정이므로, 이 두 가지 사안은 벤치마크와 함께 주시할 가치가 있습니다.
Aleph Alpha는 주권성, Apache 2.0 라이선스, EU AI Act 준수 문서화가 MMLU-Pro 몇 점보다 유럽 공공 부문 구매자에게 더 중요하다고 보고 있습니다.
그 판단은 합리적으로 보이며, Cohere와의 합병은 규모 경쟁만으로는 승산이 없음을 스스로 인지한다는 신호로 읽힙니다.
Kolibri 1은 이 활성 파라미터 크기대에서 독일어 오픈 웨이트 모델 중 가장 잘 문서화된 최고 수준이라 말할 수 있겠지만, 장기 멀티턴 에이전트 실행이나 폐쇄형 책상 사실 회상이 필요할 때 제가 먼저 고를 모델은 아닙니다.
비슷한 소활성 MoE 모델끼리의 싸움에서는 여전히 Qwen3.6 35B-A3B의 손을 들어주겠고, 밀집 27B를 감당할 수 있다면 Qwen3.8 27B가 확실히 앞섭니다.
이런 모델의 운용과 평가에 빠르게 익숙해지고 싶다면, AI Fundamentals 스킬 트랙부터 시작하세요.
DataCamp 추천 강의
강의
강의
강의