Cours
Coder avec l’aide de l’IA pour les développeurs
1 h 30 min
10.5K
Cela faisait un moment qu’aucun nouvel acteur n’était entré dans la course aux LLM. Le 3 octobre, Aleph Alpha a publié son nouveau modèle Kolibri 1 sur Hugging Face sous licence Apache 2.0 et a appelé l’Europe à prendre au sérieux l’IA souveraine.
La promesse : permettre aux gouvernements et entreprises européens d’exécuter un modèle performant sur leur propre matériel, même entièrement hors ligne, plutôt que de dépendre de l’API d’un fournisseur américain.
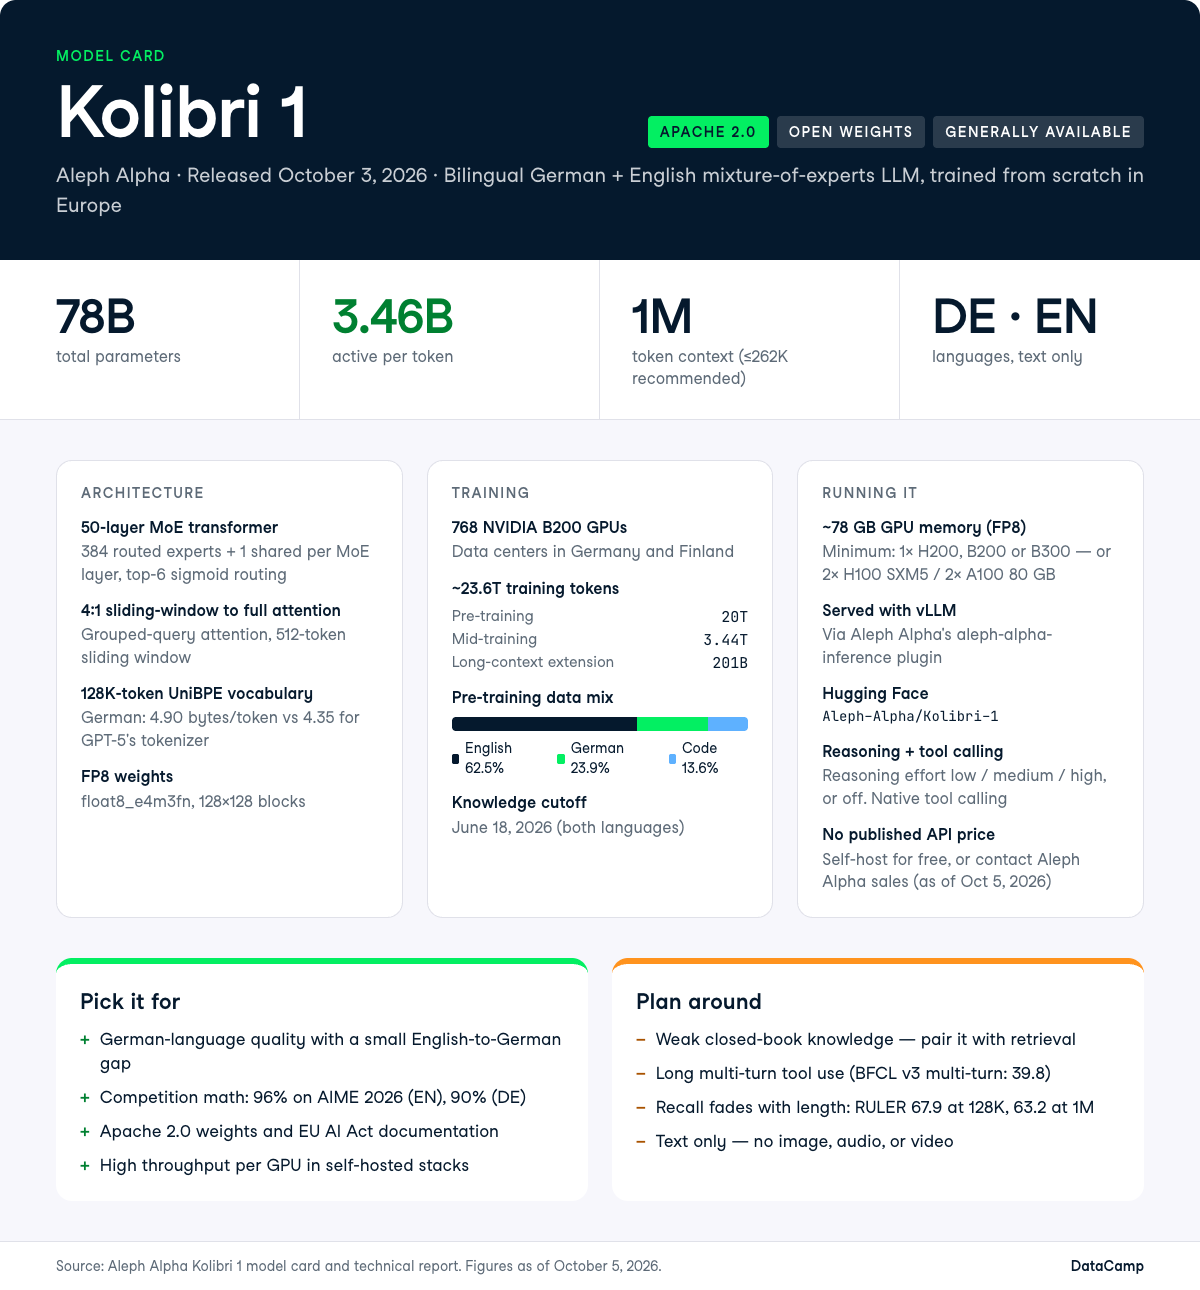
Kolibri 1 est un modèle à mélange d’experts (MoE) totalisant 78 milliards de paramètres et 3,46 milliards actifs par token, entraîné from scratch par Aleph Alpha Research sur 768 GPU NVIDIA B200 dans des centres de données en Allemagne et en Finlande.
Il gère uniquement l’allemand et l’anglais, prend en charge une fenêtre de contexte de 1 048 576 tokens (Aleph Alpha recommande de rester à 262 144 tokens ou en dessous pour l’efficacité en production) et est livré en disponibilité générale, pas en préversion. L’entraînement préliminaire a couvert 20 000 milliards de tokens, suivi de 3,44 T en mid-training et 201 Md pour l’extension long contexte.
Dans cet article, je passe en revue tout ce qu’il y a de nouveau avec Kolibri 1 : ses fonctionnalités clés, ses benchmarks et le coût réel pour l’exécuter.
Kolibri 1 est le grand modèle de langage (LLM) bilingue spécialisé d’Aleph Alpha, sorti le 3 octobre 2026 sous Apache 2.0. C’est un modèle unique en disponibilité générale, sans versions plus petites ou plus grandes.
Sous le capot, c’est un transformeur mixture-of-experts à 50 couches.
Chaque couche contient 384 petits sous-réseaux spécialisés appelés experts, et un routeur envoie chaque token à seulement 6 d’entre eux, plus 1 expert partagé toujours actif. C’est ainsi que 78,1 Md de paramètres totaux deviennent 3,46 Md actifs par token (environ 4,4 %), le modèle étant donc conçu pour un service économique plutôt que pour une capacité maximale.
Deux autres choix de conception le rendent rapide et frugal en mémoire :
Le message clé mis en avant par Aleph Alpha est l’efficacité plutôt que la puissance brute.
Kolibri 1 atteint en moyenne 71 % sur sa suite de benchmarks allemands tout en décodant environ 47 000 octets/s de texte par GPU, contre 68 % et environ 24 000 octets/s pour Nemotron Super A12B.
Le modèle a une date de coupure des connaissances au 18 juin 2026 pour les deux langues et ne gère que du texte : pas d’image, d’audio ni de vidéo en entrée ou sortie.
Pour comprendre d’où vient la compétence en allemand, le mélange de données publié est remarquablement transparent pour une sortie open-weight.
| Domaine | Pré-entraînement | Mid-training | Extension long contexte |
|---|---|---|---|
| Web et documents en anglais | 43,4 % | 1,3 % | 15,8 % |
| Web et documents en allemand | 23,4 % | 2,1 % | 2,6 % |
| Code | 13,6 % | 16,3 % | 13,2 % |
| Code agentique et usage d’outils | ~0 % | 15,4 % | 5,6 % |
| PDF scannés (OCR) | 0 % | 0 % | 33,3 % |
Le tableau n’affiche que les lignes web, code, agentique et PDF. La model card liste aussi des données d’instructions et de raisonnement en anglais et en allemand, des documents STEM, du QA, ainsi que des données juridiques et secteur public spécialisées. En comptant toutes les lignes anglais et allemand, la model card résume le mix de pré-entraînement à environ 62,5 % anglais, 23,9 % allemand et 13,6 % code.
Ce qui distingue surtout Kolibri 1 tient à deux décisions : entraîner correctement la partie allemande au lieu de la traduire, et maintenir le nombre de paramètres actifs suffisamment bas pour qu’une seule H200 puisse le servir.
Kolibri 1 réduit davantage que prévu l’écart entre l’allemand et l’anglais, ce qui est rare pour un modèle open-weight de cette taille.
Sa moyenne globale de benchmarks est de 75,5 en anglais et 70,8 en allemand.
Aleph Alpha a entraîné un vocabulaire de 128 000 tokens avec un nouvel algorithme de tokenizer appelé UniBPE, qui conserve les fusions gloutonnes bottom-up du byte-pair encoding mais utilise l’objectif Unigram pour choisir quelle fusion entre dans le vocabulaire.
Le bénéfice annoncé est une compression allemande de 4,90 octets/token, contre 4,35 pour le tokenizer de GPT-5, tandis que l’anglais reste à 4,58 octets/token (le tokenizer de GPT-5 obtient 4,67).
Cela compte autant pour le coût que pour la qualité.
Une meilleure compression signifie moins de tokens pour un même document en allemand ; un Bescheid de 50 pages (notification administrative officielle allemande) coûte donc moins cher à traiter et laisse plus de marge en contexte.
L’allemand représentait 23,4 % du mix de pré-entraînement contre 43,4 % pour le web et les documents en anglais ; la compétence est donc acquise par les données, pas par un affinement ajouté après la phase principale d’entraînement.
Le modèle annonce 1 048 576 tokens. Il gère nativement 262 144 tokens après une phase d’entraînement long contexte de 201 Md de tokens, et s’étire jusqu’à 1 M par extrapolation, c’est-à-dire sans y avoir été entraîné.
Aleph Alpha recommande elle-même de rester à 262 144 tokens ou en dessous pour l’efficacité en service. RULER, un test de la capacité d’un modèle à retrouver et exploiter des détails enfouis dans de très longues entrées, montre la dégradation du modèle de base : 67,9 à 128K et 63,2 à 1M, contre 89,9 à 128K pour Qwen3.5 35B-A3B Base cité.
Pour être juste, le score de Kolibri à 1M reste supérieur à Nemotron 3 Nano (58,5) et Qwen3.5 (57,5) à cette longueur : il se dégrade moins, malgré un point de départ plus bas.
Traitez donc le « 1M » comme un plafond technique, pas comme un budget opérationnel.
Si votre pipeline de retrieval-augmented generation (RAG) « bourre » 400K tokens de PDF scannés convertis en texte (OCR) dans un prompt et s’attend à ce que le modèle retrouve de façon fiable un détail précis, testez-le avant de vous engager. À noter : 33,3 % du mix d’extension long contexte était constitué de PDF OCRisés, signe que les documents scannés sont clairement une cible d’usage.
Le mode raisonnement signifie que le modèle déroule un problème étape par étape avant de répondre, ce qui améliore la précision mais consomme plus de tokens.
Dans Kolibri 1, c’est un interrupteur que vous contrôlez plutôt qu’un palier de modèle distinct, et l’appel d’outils (le modèle décide d’appeler une fonction ou une API externe, comme une requête base de données) est natif.
Aleph Alpha vise les usages en raisonnement multi-étapes, RAG, tool calling agentique, codage et assistance bilingue. Le mix de mid-training a consacré 15,4 % au code agentique et à l’usage d’outils, contre quasiment zéro en pré-entraînement.
Un retour d’utilisateur, exécutant le modèle en FP8 sur un seul GPU de station de travail RTX Pro 6000, a mesuré environ 170 tokens par seconde et noté une tendance à « délibérer » en dépensant beaucoup de tokens.
Prévoyez ce surcoût si vous laissez le raisonnement activé par défaut dans un parcours sensible à la latence.
Kolibri 1 a été entraîné from scratch ; ce n’est ni un affinement ni une copie du modèle d’un autre éditeur.
C’est important pour la licence et pour savoir précisément quelles données ont été utilisées.
Associé à des poids Apache 2.0, cela signifie que vous pouvez exécuter Kolibri 1 en environnement isolé (déconnecté d’internet), le fine-tuner et l’intégrer dans un produit commercial sans demander d’autorisation.
Le règlement IA de l’UE et son Code de bonnes pratiques pour les « General-Purpose AI » (GPAI) fixent les règles européennes pour les modèles généralistes, notamment la documentation des données d’entraînement.
Aleph Alpha est signataire du Code de bonnes pratiques et publie une model card détaillée couvrant les sources des données d’entraînement, les étapes de décontamination (retrait des questions de benchmark des données) et un point de contact pour les ayants droit — la documentation qu’un audit de conformité au règlement IA exigera.
Pour les acheteurs du secteur public en Allemagne et dans l’UE, ce dossier pèse souvent plus qu’un écart de benchmark.
C’est aussi la partie qu’aucun labo américain ne peut répliquer rapidement.
La model card d’Aleph Alpha liste ouvertement les limites, à lire avant tout achat :
Pour tout déploiement critique, Aleph Alpha précise que des garde-fous supplémentaires et la conformité au Règlement (UE) 2024/1689 sont requis.
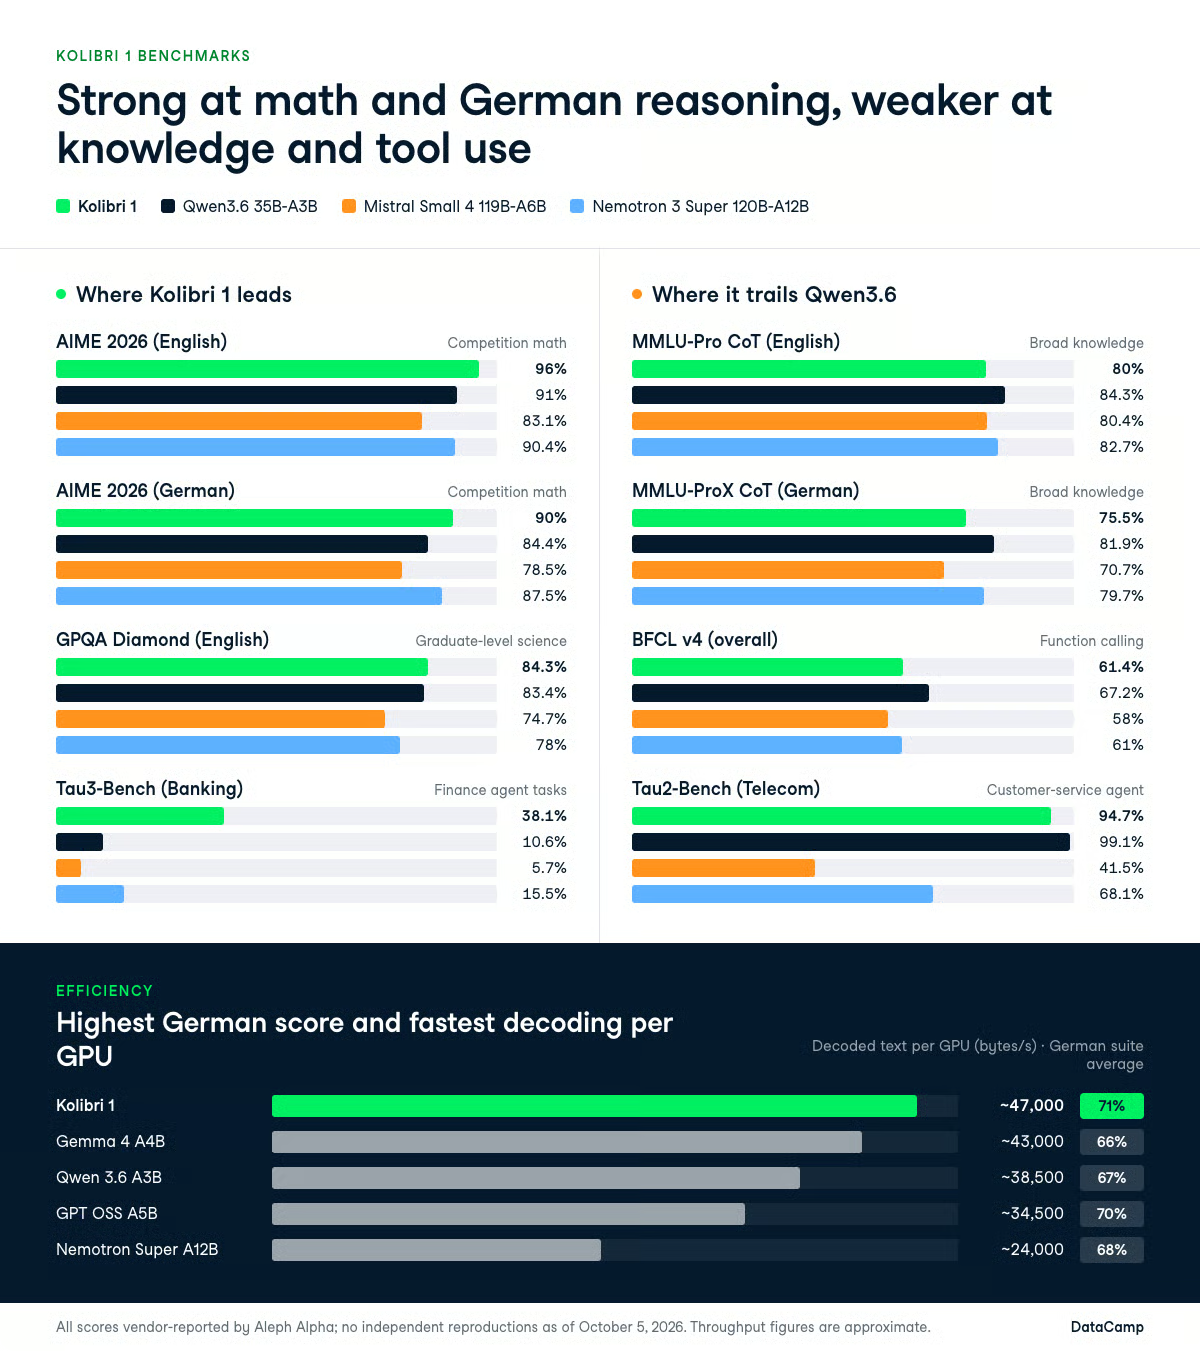
Le profil de Kolibri 1 est volontairement dissymétrique : il devance son groupe de comparaison déclaré en mathématiques de compétition et en raisonnement allemand, et perd face à Qwen3.6 35B-A3B sur la connaissance en closed-book, MMLU-Pro et la plupart des suites d’usage d’outils.
Aleph Alpha se compare à Qwen3.6 35B-A3B, Mistral Small 4 119B-A6B et Nemotron 3 Super 120B-A12B.
La model card liste aussi Qwen3.8 27B, un modèle dense (tous ses paramètres sont actifs à chaque token, contrairement à un MoE) qui surclasse globalement (allemand 79,9 contre 70,8 pour Kolibri) avec environ huit fois plus de paramètres actifs.
Je l’ai laissé hors des tableaux ci-dessous, mais gardez-le à l’esprit en lisant les arguments d’efficacité.
Dans ces noms de modèles, le nombre après le « A » désigne les paramètres actifs par token : 35B-A3B signifie 35 Md totaux et 3 Md actifs. Voici ce que mesurent les benchmarks des tableaux ci-dessous :
Les maths sont le terrain où Kolibri 1 est nettement devant.
Il obtient 96 % sur AIME 2026 (EN) contre 91 % pour Qwen3.6 35B-A3B, 90,4 % pour Nemotron 3 Super et 83,1 % pour Mistral Small 4 ; et 96,9 % sur AIME 2025 (EN) contre 84,6 % pour Qwen3.6.
Sur GPQA Diamond (EN), il atteint 84,3 % contre 83,4 %, et sur Humanity’s Last Exam (EN) 21,5 % contre 21,1 % ; des écarts suffisamment faibles pour parler d’égalité.
Le point faible, sur le même tableau, est la connaissance.
L’AA-Omniscience Index (jeu public) est noté sur une échelle où les valeurs négatives sont courantes et plus haut est meilleur. Kolibri 1 atteint -32,8 contre -12,5 pour Qwen3.6 et -24,0 pour Mistral Small 4, même s’il devance légèrement Nemotron 3 Super (-36,5). Un score d’exactitude AA-Omniscience séparé arrive à 14,8 %, le plus bas des quatre modèles.
Son taux de non-hallucination sur le même benchmark est plus flatteur à 44,0 %, devant Nemotron (13,9 %) et Mistral (34,7 %) mais derrière Qwen3.6 (56,7 %), ce qui correspond au travail d’Aleph Alpha sur l’abstention.
Un modèle à 3,46 Md de paramètres actifs a une capacité limitée à mémoriser des faits ; associez-le donc à de la recherche plutôt que de compter sur le rappel en closed-book.
| Benchmark (EN) | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| AIME 2026 | 96 % | 91 % | 83,1 % | 90,4 % |
| AIME 2025 | 96,9 % | 84,6 % | 79,8 % | 91,7 % |
| GPQA Diamond | 84,3 % | 83,4 % | 74,7 % | 78 % |
| Humanity’s Last Exam | 21,5 % | 21,1 % | 9,7 % | 20,6 % |
| MMLU-Pro CoT | 80 % | 84,3 % | 80,4 % | 82,7 % |
| AA-Omniscience Index (plus haut est mieux) | -32,8 | -12,5 | -24,0 | -36,5 |
Kolibri 1 remporte les benchmarks de maths et de sciences en allemand et perd ceux de connaissance en allemand ; une silhouette identique à son profil anglais.
Il obtient 90 % sur AIME 2026 (DE) contre 84,4 % pour Qwen3.6, et 81,3 % sur GPQA Diamond (DE) contre 80,6 %. Sur MMLU-ProX CoT (DE), il descend à 75,5 % tandis que Qwen3.6 atteint 81,9 % et Nemotron 3 Super 79,7 %, et sur Humanity’s Last Exam (DE) il marque 15,9 % contre 22,3 % pour Nemotron.
Ce qui est réellement intéressant, c’est le faible écart anglais-allemand.
Kolibri perd 6 points en passant AIME 2026 de l’anglais à l’allemand et 3 points sur GPQA Diamond, une baisse plus étroite que celle d’un modèle qui traite l’allemand comme une simple langue cible de traduction.
| Benchmark (DE) | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| AIME 2026 | 90 % | 84,4 % | 78,5 % | 87,5 % |
| AIME 2025 | 87,5 % | 82,9 % | 72,3 % | 85,6 % |
| GPQA Diamond | 81,3 % | 80,6 % | 72,9 % | 76,6 % |
| MMLU-ProX CoT | 75,5 % | 81,9 % | 70,7 % | 79,7 % |
| Humanity’s Last Exam | 15,9 % | 20,5 % | 10,5 % | 22,3 % |
C’est la zone la plus fragile de la sortie.
Sur BFCL v4 global, Kolibri 1 obtient 61,4 % contre 67,2 % pour Qwen3.6, et sur Tau2-Bench (Telecom) il atteint 94,7 % contre 99,1 % pour Qwen3.6. Il devance toutefois Qwen3.6 sur Tau2-Bench (Airline), 76,7 % contre 70,7 %.
Un score multi-tours BFCL v3 rapporté séparément à 39,8 points (53,5 pour Qwen3.6) montre la même faiblesse : les appels d’outil unitaires vont bien, les longues conversations avec allers-retours répétés d’outils moins bien.
Un résultat sort du lot dans l’autre sens.
Sur Tau3-Bench (Banking), Kolibri 1 score 38,1 % tandis que Qwen3.6 obtient 10,6 %, Nemotron 3 Super 15,5 % et Mistral Small 4 seulement 5,7 %. C’est environ 2,5 fois mieux que le deuxième modèle de l’ensemble (3,6 fois Qwen3.6) sur un benchmark agentique à saveur finance ; c’est le résultat que je souhaiterais le plus voir reproduit indépendamment.
| Benchmark | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| Tau2-Bench (Telecom) | 94,7 % | 99,1 % | 41,5 % | 68,1 % |
| Tau2-Bench (Retail) | 69,9 % | 71,6 % | 62,9 % | 67,5 % |
| Tau2-Bench (Airline) | 76,7 % | 70,7 % | 40 % | 72,7 % |
| Tau3-Bench (Banking) | 38,1 % | 10,6 % | 5,7 % | 15,5 % |
| BFCL v4 (global) | 61,4 % | 67,2 % | 58 % | 61 % |
Les résultats rapportés sont 85,9 sur LiveCodeBench v6, 66,4 sur SWE-bench Verified et 27,7 sur Terminal-Bench 2.1.
La génération de code brute paraît solide, l’ingénierie logicielle agentique plus ordinaire, et le score Terminal-Bench indique que les longues séquences multi-étapes en terminal ne sont pas la spécialité du modèle.
Un avertissement de contamination est toutefois à lire avant de citer ces chiffres.
Le rapport technique note que 48 % des données d’évaluation HumanEval en anglais et 47 % en allemand sont apparues dans des matériaux liés à l’entraînement, ce qui gonfle les scores de type HumanEval.
Plusieurs suites des tableaux de comparaison sont propriétaires ou créées par des éditeurs, ce qui complique l’audit complet, et aucune comparaison vérifiée à parité avec les actuels fleurons Claude, GPT ou Gemini n’était disponible au moment de la rédaction.
La revendication d’efficacité résiste le mieux aux réserves liées aux chiffres éditeurs, car c’est une propriété d’architecture plus qu’un score.
Ici, le débit mesure la quantité de texte que le modèle peut générer par GPU et par seconde. Aleph Alpha le mesure en octets plutôt qu’en tokens, afin de comparer équitablement des modèles ayant des tokenizers différents.
Kolibri 1 se situe à 71 % de moyenne sur la suite allemande d’Aleph Alpha tout en décodant environ 47 000 octets/s par GPU. GPT OSS A5B atteint 70 % à environ 34 500 octets/s, Qwen 3.6 A3B 67 % à environ 38 500, Gemma 4 A4B 66 % à environ 43 000 et Nemotron Super A12B 68 % à environ 24 000.
Servir environ 2× plus de texte décodé par GPU que le modèle Nemotron pour une moyenne allemande plus élevée est l’argument pratique pour choisir Kolibri dans une pile auto-hébergée.
Si vous payez vos propres GPU plutôt qu’au token, le débit par GPU est la métrique qui se retrouve sur la facture.
Aucun prix par token n’est publié pour Kolibri 1.
Aleph Alpha n’a pas communiqué de grille tarifaire pour une API hébergée, et aucun ID de modèle Kolibri confirmé n’apparaissait dans la documentation API officielle au 5 octobre 2026.
Le déploiement entreprise passe par l’équipe commerciale d’Aleph Alpha, et l’identifiant de dépôt Aleph-Alpha/Kolibri-1 ne doit pas être considéré comme un ID de modèle API.
Les poids eux-mêmes sont gratuits sous Apache 2.0 ; votre coût, c’est le temps GPU.
L’empreinte mémoire en FP8 est d’environ 78 Go, avec un minimum annoncé de 2× A100 80 Go, 2× H100 SXM5, 1× H200, 1× B200 ou 1× B300, et une configuration recommandée de 2× H100 SXM5, 2× H200, 1× B200 ou 1× B300. Le modèle est en disponibilité générale, sans liste d’attente ni restriction régionale.
Pour situer l’arbitrage, notre dossier sur GPT-6.1 Sol place ce modèle à 2 $ en entrée / 10 $ en sortie par million de tokens. Un récapitulatif tiers liste l’ancien GPT-5.6 Sol à 5 $ / 30 $ et GPT-5.6 Luna à 0,20 $ / 1,20 $ après la baisse de prix du 30 juillet d’OpenAI.
L’auto-hébergement devient gagnant en coût unitaire seulement une fois votre volume au-delà du coût fixe d’une B200.
Kolibri 1 est open-weight sous Apache 2.0, ce qui autorise l’usage commercial, la modification et la redistribution sans seuil d’utilisateurs ni de revenus.
Les poids sont hébergés sur Hugging Face à Aleph-Alpha/Kolibri-1 au format float8_e4m3fn. La model card documente un service via vLLM uniquement, avec le plugin aleph-alpha-inference d’Aleph Alpha. Des builds communautaires GGUF et MLX sont apparus sous quelques jours, mais Aleph Alpha ne les a pas validés, et je n’ai pas trouvé d’entrée Ollama officielle.
Pour un service hébergé, 1× H200 ou 1× B200 contient les ~78 Go de poids FP8 sur une seule carte. Utilisez --tensor-parallel-size 2 sur des H100.
Gardez --max-model-len à 262 144 ou en dessous sauf test spécifique de contextes plus longs. Au-delà, un flag supplémentaire --hf-overrides est requis, comme indiqué dans la model card.
Installez le plugin et lancez le serveur :
pip install 'aleph-alpha-inference>=1'

# Ajouter --tensor-parallel-size 2 sur 2x H100
vllm serve Aleph-Alpha/Kolibri-1 \
  --kv-cache-dtype fp8 \
  --max-model-len 262144 \
  --reasoning-parser kolibri1 \
  --tool-call-parser kolibri1 \
  --enable-auto-tool-choice
Interrogez-le ensuite via l’API compatible OpenAI, avec les paramètres d’échantillonnage recommandés par Aleph Alpha (temperature 1.0, top_p 0,97, top_k 128) :
from openai import OpenAI

client = OpenAI(base_url="http://localhost:8000/v1", api_key="EMPTY")

response = client.chat.completions.create(
    model="Aleph-Alpha/Kolibri-1",
    messages=[{
        "role": "user",
        "content": "Fasse die wichtigsten Fristen aus diesem Bescheid in drei Punkten zusammen.",
    }],
    temperature=1.0,
    top_p=0.97,
    max_tokens=512,
    extra_body={
        "top_k": 128,
        "chat_template_kwargs": {"reasoning_effort": "medium"},
    },
)
print(response.choices[0].message.content)
Le paramètre de raisonnement accepte low, medium et high, et vous pouvez couper la réflexion si la latence compte plus que la profondeur.
Les sorties varient selon les paramètres d’échantillonnage, et la model card note qu’elles peuvent légèrement diverger même avec l’échantillonnage désactivé.
Pour aller plus loin sur l’inférence auto-hébergée et les boucles agentiques, notre tutoriel API sur la construction d’un agent de migration couvre les modèles d’autorisations d’outils et de pilotage qui s’appliquent directement.
Kolibri 1 se veut un modèle d’« IA souveraine », c’est-à-dire qu’un pays ou une organisation peut exécuter, auditer et contrôler son IA sur sa propre infrastructure et sous sa juridiction, sans dépendre de l’API, des prix ou des conditions d’utilisation d’un fournisseur étranger. Pour Kolibri 1, cet argument repose sur des poids Apache 2.0 exécutables en environnement isolé, une infrastructure d’entraînement européenne et une documentation conforme au règlement IA de l’UE.
Cependant, deux éléments de contexte d’entreprise encadrent ce lancement.
Aleph Alpha a signé un accord de fusion contraignant avec l’entreprise canadienne Cohere pour former ce qu’ils décrivent comme la première solution d’IA souveraine transatlantique.
La société combinée opérera sous le nom Cohere, avec un double siège à Toronto et Berlin, et Heidelberg conservée comme centre de recherche. L’opération reste soumise à l’approbation des autorités.
Un argument de souveraineté dépend du maintien du support par le propriétaire du modèle, et la marque Aleph Alpha est appelée à disparaître dans Cohere une fois la fusion finalisée ; deux points à suivre en parallèle des benchmarks.
Aleph Alpha parie que la souveraineté, la licence Apache 2.0 et une conformité documentée au règlement IA de l’UE comptent davantage pour les acheteurs publics européens que quelques points sur MMLU-Pro.
Le pari semble raisonnable, et la fusion avec Cohere suggère que l’entreprise sait qu’elle ne peut pas gagner par l’échelle seule.
On peut dire que Kolibri 1 est le meilleur modèle open-weight en allemand à ce niveau de paramètres actifs, avec une documentation aussi détaillée, mais ce n’est pas celui que je choisirais pour de longues boucles agentiques multi-tours ou du rappel factuel en closed-book.
Face à des MoE « small-active » comparables, Qwen3.6 35B-A3B reste en tête. Si vous pouvez vous offrir un modèle dense 27B, Qwen3.8 27B gagne nettement.
Pour vous mettre à niveau sur l’exécution et l’évaluation de ce type de modèles, commencez par notre parcours de compétences AI Fundamentals.
Meilleurs cours DataCamp
Cours
Cours
Cours
blog
Lynn Heidmann
blog
Nathaniel Taylor-Leach
8 min
blog
Kurtis Pykes
15 min
blog
Tutoriel
Tutoriel
Josef Waples
8 min