
Cursus
AI-ondersteund coderen voor developers
1 uur 30 min
10.5K
Het was een tijdje stil qua nieuwe spelers in de LLM-race. Maar op 3 oktober zette Aleph Alpha zijn nieuwe model Kolibri 1 op Hugging Face onder een Apache 2.0-licentie en riep het Europa op om soevereine AI serieus te nemen.
De pitch: Europese overheden en bedrijven kunnen een capabel model op hun eigen hardware draaien, desnoods volledig offline, in plaats van te leunen op de API van een Amerikaanse aanbieder.
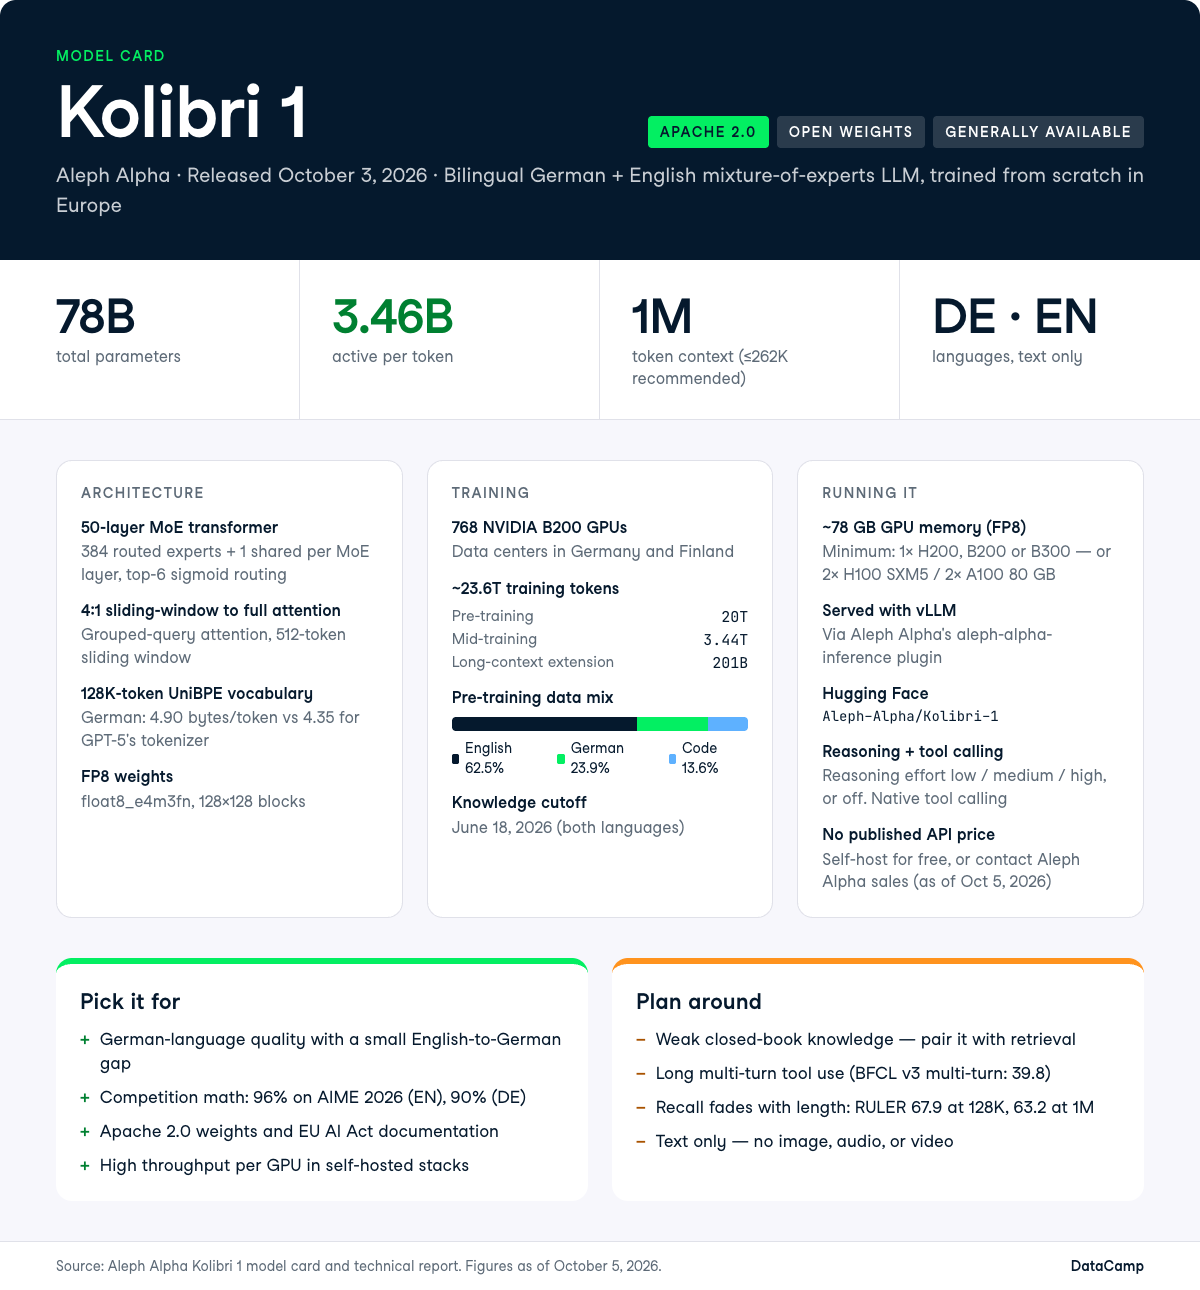
Kolibri 1 is een mixture-of-experts (MoE) model met in totaal 78B parameters en 3,46B actieve per token, vanaf nul getraind door Aleph Alpha Research op 768 NVIDIA B200 GPU's in datacenters in Duitsland en Finland.
Het ondersteunt alleen Duits en Engels, biedt een contextvenster van 1.048.576 tokens (Aleph Alpha raadt aan om op of onder 262.144 tokens te blijven voor efficiënte serving) en wordt als algemeen beschikbaar verscheept, niet als preview. De pre-trainingsrun omvatte 20 biljoen tokens, gevolgd door 3,44T in mid-training en 201B voor long-contextverlenging.
In dit artikel behandel ik alles wat nieuw is aan Kolibri 1: de belangrijkste features, de benchmarks en wat het kost om het echt te draaien.
Kolibri 1 is Aleph Alpha's gespecialiseerde tweetalige large language model (LLM), uitgebracht op 3 oktober 2026 onder Apache 2.0. Het is één algemeen beschikbaar model, zonder kleinere of grotere varianten.
Onder de motorkap is het een 50-laags mixture-of-experts transformer.
Elke laag bevat 384 kleine specialistische subnetwerken, zogenaamde experts, en een router stuurt elk token naar slechts 6 daarvan, plus 1 gedeelde expert die altijd draait. Zo krimpt 78,1B totale parameters naar 3,46B actief per token (ongeveer 4,4%), waardoor het model is gebouwd voor goedkope serving in plaats van maximale capaciteit.
Twee extra ontwerpkeuzes houden het snel en zuinig met geheugen:
Het hoofdpunt dat Aleph Alpha benadrukt is efficiëntie, niet ruwe capaciteit.
Kolibri 1 haalt gemiddeld 71% op zijn Duitse benchmarksuite terwijl het ongeveer 47.000 bytes/s tekst per GPU decodeert, tegenover 68% bij circa 24.000 bytes/s voor Nemotron Super A12B.
Het model heeft een knowledge cutoff van 18 juni 2026 voor beide talen en is alleen tekst: geen beeld-, audio- of video-invoer of -uitvoer.
Als je wilt zien waar de Duitse capaciteit precies vandaan komt, is de gepubliceerde datamix ongewoon transparant voor een open-weight release.
| Domein | Pre-training | Mid-training | Long-contextverlenging |
|---|---|---|---|
| Engelstalig web en documenten | 43,4% | 1,3% | 15,8% |
| Duitstalig web en documenten | 23,4% | 2,1% | 2,6% |
| Code | 13,6% | 16,3% | 13,2% |
| Agentische code en toolgebruik | ~0% | 15,4% | 5,6% |
| OCR'de PDF's | 0% | 0% | 33,3% |
De tabel toont alleen de rijen web, code, agentisch en PDF. De modelkaart noemt ook Engelse en Duitse instructie- en redeneerdata, STEM-documenten, QA en gespecialiseerde juridische en publieke-sector data. Als je alle Engelse en Duitse rijen meetelt, vat de modelkaart de pre-training samen als ongeveer 62,5% Engels, 23,9% Duits en 13,6% code.
Wat Kolibri 1 vooral onderscheidt komt neer op twee keuzes: het Duits goed trainen in plaats van vertalen, en het aantal actieve parameters laag genoeg houden dat één H200 het model kan serven.
Kolibri 1 verkleint de kloof tussen Duits en Engels meer dan je zou verwachten, wat ongebruikelijk is voor een open-weight model van deze grootte.
Het totale benchmarkgemiddelde is 75,5 in het Engels en 70,8 in het Duits.
Aleph Alpha trainde een vocabulaire van 128.000 tokens met een nieuw tokenizer-algoritme genaamd UniBPE, dat de gulzige bottom-up merges van byte-pair encoding behoudt maar de Unigram-doelstelling gebruikt om te kiezen welke merge de vocabulaire in gaat.
De opgegeven opbrengst is Duitse compressie van 4,90 bytes/token, tegenover 4,35 voor de tokenizer van GPT-5, terwijl Engels op 4,58 bytes/token blijft (de tokenizer van GPT-5 haalt 4,67).
Dat is net zo belangrijk voor kosten als voor kwaliteit.
Betere compressie betekent minder tokens voor hetzelfde Duitstalige document, dus een Bescheid van 50 pagina's (een officiële Duitse bestuursrechtelijke kennisgeving) kost minder om te verwerken en laat meer ruimte in de context.
Duits vormde 23,4% van de pre-trainingsmix tegenover 43,4% voor Engelstalig web en documenten, dus de capaciteit is betaald met data, niet met een fine-tune die na de hoofdtraining is aangeplakt.
Het model adverteert 1.048.576 tokens. Het kan 262.144 tokens native aan na een long-context trainingsfase van 201B tokens, en rekt op tot 1M via extrapolatie, wat betekent dat het nooit op die lengte is getraind.
Aleph Alpha raadt zelf aan om op of onder 262.144 tokens te blijven voor efficiënte serving. RULER, een test of een model specifieke details in zeer lange inputs kan vinden en gebruiken, laat de degradatie voor het basismodel zien: 67,9 bij 128K en 63,2 bij 1M, tegenover een genoemde Qwen3.5 35B-A3B Base-score van 89,9 bij 128K.
Eerlijk is eerlijk: Kolibri's 1M-score klopt Nemotron 3 Nano (58,5) en Qwen3.5 (57,5) op die lengte, dus het zakt minder weg dan zij, vanaf een lagere start.
Ik zou de 1M-waarde zien als een plafond dat je technisch kunt raken, niet als een werkbudget.
Als je retrieval-augmented generation (RAG)-pijplijn 400K tokens aan gescande, naar tekst geconverteerde PDF's (OCR) in een prompt stopt en verwacht dat het model betrouwbaar één specifiek detail vindt, test het dan voordat je je commit. Opvallend: 33,3% van de long-contextverlengingsmix bestond uit OCR'de PDF's, dus workloads met gescande documenten zijn duidelijk de beoogde use case.
Reasoning mode betekent dat het model stap voor stap door een probleem heen werkt voordat het antwoordt, wat de nauwkeurigheid verhoogt maar meer tokens kost.
In Kolibri 1 is het een schakelaar die jij bedient in plaats van een aparte modeltier, en tool calling (het model dat besluit een externe functie of API aan te roepen, zoals een databaselookup) is native.
Aleph Alpha noemt meerstapsredeneren, RAG, agentische tool calling, coderen en tweetalig assistentwerk als beoogde toepassingen, en in de mid-trainingmix ging 15,4% naar agentische code en toolgebruik, vanaf vrijwel nul tijdens pre-training.
Eén anekdotisch gebruikersrapport, met het model in FP8 op een enkele RTX Pro 6000 workstation-GPU, mat circa 170 tokens per seconde en merkte een neiging op om veel tokens te besteden aan deliberatie.
Houd daar rekening mee in je budget als je reasoning standaard aan laat in een latency-gevoelige keten.
Kolibri 1 is vanaf nul getraind, dus het is geen fine-tune of kopie van het model van een ander bedrijf.
Dat is belangrijk voor licensering en voor precies weten wat erin zit.
Gecombineerd met Apache 2.0-gewichten betekent dit dat je Kolibri 1 air-gapped kunt draaien (volledig losgekoppeld van internet), het kunt fine-tunen en het in een commercieel product kunt inbouwen zonder iemand om toestemming te vragen.
De EU AI Act en de General-Purpose AI (GPAI) Code of Practice stellen de EU-regels voor general-purpose modellen vast, inclusief documentatie van trainingsdata.
Aleph Alpha is ondertekenaar van de Code of Practice en publiceert een gedetailleerde modelkaart met bronnen van trainingsdata, decontaminatiestappen (het verwijderen van benchmarkvragen uit de trainingsdata) en een contactpunt voor rechthebbenden, oftewel de documentatie waar een EU AI Act compliance-review om zal vragen.
Voor publieke inkopers in Duitsland en de bredere EU is dat papierwerk vaak doorslaggevend, niet een benchmarkdelta.
Het is ook het deel dat geen enkel Amerikaans lab snel kan kopiëren.
Aleph Alpha's modelkaart vermeldt de beperkingen openlijk, en die zijn het lezen waard vóór een inkoopbeslissing:
Voor elke high-stakes uitrol stelt Aleph Alpha dat extra waarborgen en naleving van Verordening (EU) 2024/1689 vereist zijn.
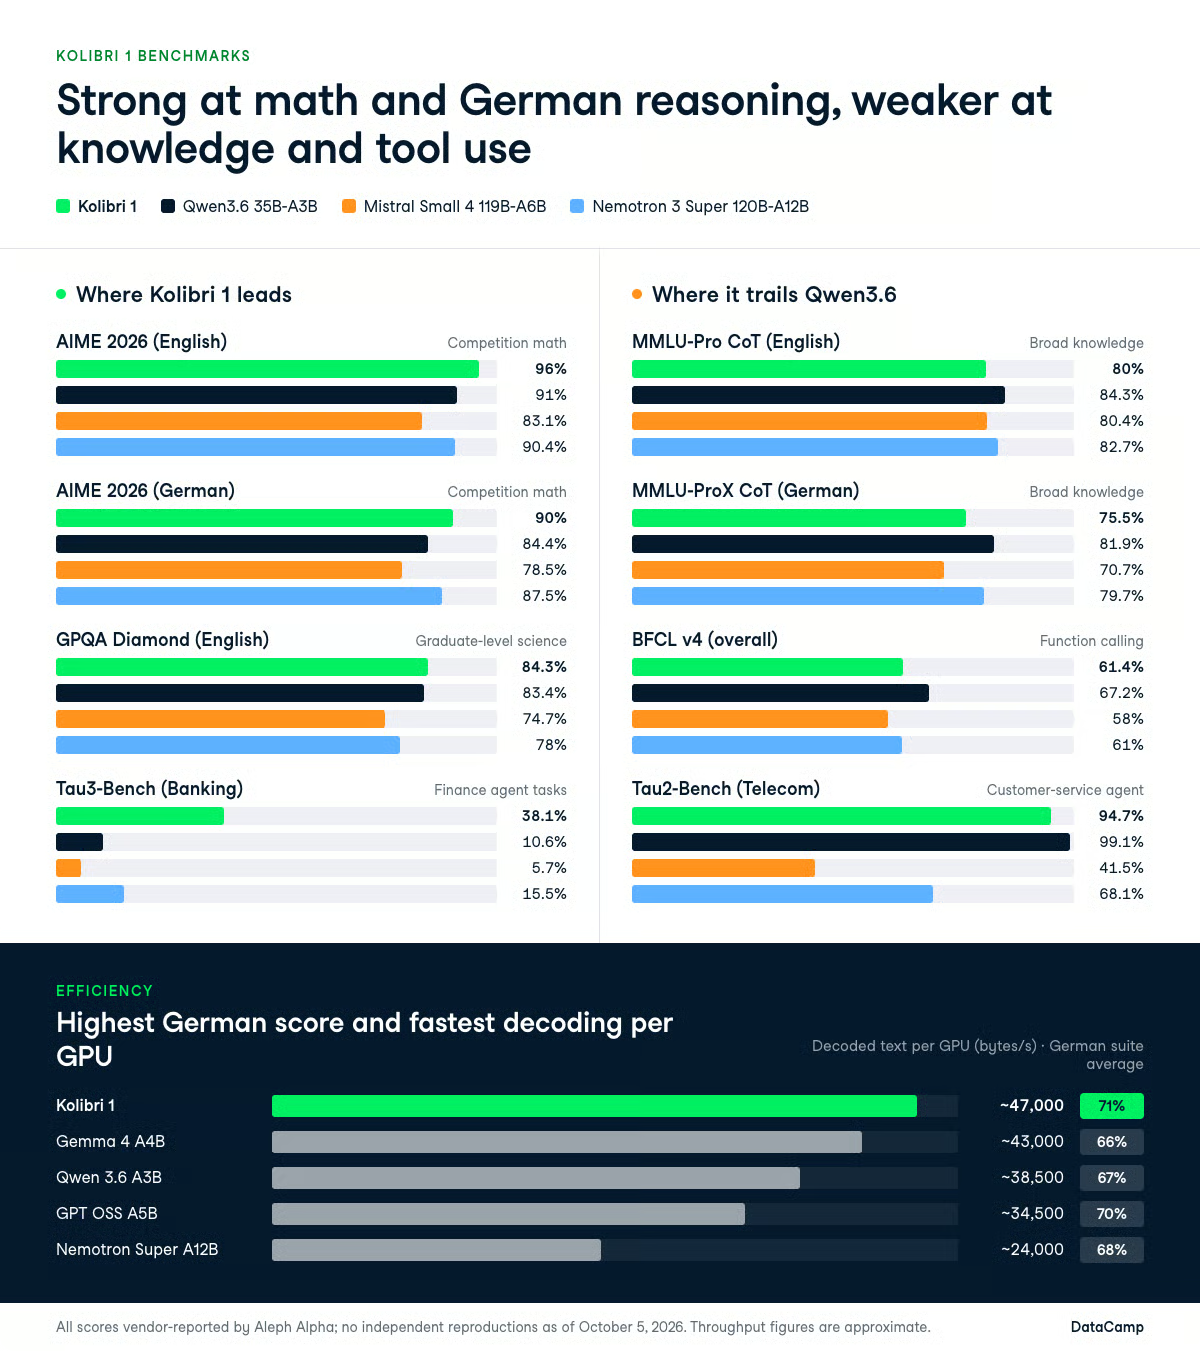
Kolibri 1's benchmarkprofiel is scheef op een nuttige manier: het leidt zijn opgegeven vergelijkingsset op competitieve wiskunde en Duitse redenering, en verliest van Qwen3.6 35B-A3B op closed-book knowledge, MMLU-Pro en de meeste tool-use suites.
Aleph Alpha vergelijkt met Qwen3.6 35B-A3B, Mistral Small 4 119B-A6B en Nemotron 3 Super 120B-A12B.
De modelkaart noemt ook Qwen3.8 27B, een dense model (dat al zijn parameters per token gebruikt, anders dan een MoE) dat overal hoger scoort (totaal Duits 79,9 tegen Kolibri's 70,8) met ongeveer acht keer zoveel actieve parameters.
Ik heb het uit de onderstaande tabellen gelaten, maar houd het in gedachten bij het lezen van de efficiëntieclaims.
In die modelnamen is het getal na de "A" het aantal actieve parameters per token, dus 35B-A3B betekent 35B totaal en 3B actief. Dit is wat de benchmarks in de onderstaande tabellen meten:
Wiskunde is waar Kolibri 1 duidelijk voorligt.
Het scoort 96% op AIME 2026 (EN) tegen 91% voor Qwen3.6 35B-A3B, 90,4% voor Nemotron 3 Super en 83,1% voor Mistral Small 4, en 96,9% op AIME 2025 (EN) tegen 84,6% voor Qwen3.6.
Op GPQA Diamond (EN) haalt het 84,3% versus 83,4%, en op Humanity's Last Exam (EN) 21,5% versus 21,1%, beide dicht genoeg om een gelijkspel te noemen.
De zwakke plek in dezelfde tabel is kennis.
De AA-Omniscience Index (publieke set) wordt gescoord op een schaal waar negatieve getallen gangbaar zijn en hoger beter is. Kolibri 1 haalt -32,8 tegenover -12,5 voor Qwen3.6 en -24,0 voor Mistral Small 4, al zit het wel nipt boven Nemotron 3 Super met -36,5. Een afzonderlijk gemelde AA-Omniscience-nauwkeurigheid komt uit op 14,8%, de laagste van de vier modellen.
Het non-hallucinatiepercentage op dezelfde benchmark is een flatterendere 44,0%, vóór Nemotron (13,9%) en Mistral (34,7%) maar achter Qwen3.6 (56,7%), wat past bij Aleph Alpha's abstention-training.
Een model met 3,46B actieve parameters heeft beperkte ruimte om feiten te memoriseren, dus koppel het aan retrieval in plaats van te vertrouwen op gesloten-boekherinnering.
| Benchmark (EN) | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| AIME 2026 | 96% | 91% | 83,1% | 90,4% |
| AIME 2025 | 96,9% | 84,6% | 79,8% | 91,7% |
| GPQA Diamond | 84,3% | 83,4% | 74,7% | 78% |
| Humanity's Last Exam | 21,5% | 21,1% | 9,7% | 20,6% |
| MMLU-Pro CoT | 80% | 84,3% | 80,4% | 82,7% |
| AA-Omniscience Index (hoger is beter) | -32,8 | -12,5 | -24,0 | -36,5 |
Kolibri 1 pakt de Duitse wiskunde- en wetenschap-benchmarks en verliest de Duitse kennisbenchmarks, wat hetzelfde beeld is als in het Engels.
Het scoort 90% op AIME 2026 (DE) tegen 84,4% voor Qwen3.6, en 81,3% op GPQA Diamond (DE) tegen 80,6%. Op MMLU-ProX CoT (DE) zakt het naar 75,5% terwijl Qwen3.6 81,9% en Nemotron 3 Super 79,7% halen, en op Humanity's Last Exam (DE) komt het op 15,9% tegenover 22,3% voor Nemotron.
Wat ik oprecht interessant vind, is het kleine gat tussen Engels en Duits.
Kolibri verliest 6 punten bij de overgang van AIME 2026 van Engels naar Duits en 3 punten op GPQA Diamond, een kleinere terugval dan je zou verwachten van een model dat Duits als vertaaltarget behandelt.
| Benchmark (DE) | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| AIME 2026 | 90% | 84,4% | 78,5% | 87,5% |
| AIME 2025 | 87,5% | 82,9% | 72,3% | 85,6% |
| GPQA Diamond | 81,3% | 80,6% | 72,9% | 76,6% |
| MMLU-ProX CoT | 75,5% | 81,9% | 70,7% | 79,7% |
| Humanity's Last Exam | 15,9% | 20,5% | 10,5% | 22,3% |
Dit is het zachtste onderdeel van de release.
Op BFCL v4 overall scoort Kolibri 1 61,4% tegen 67,2% voor Qwen3.6, en op Tau2-Bench (Telecom) haalt het 94,7% tegen 99,1% voor Qwen3.6. Het zit wel net vóór Qwen3.6 op Tau2-Bench (Airline), 76,7% tegen 70,7%.
Een afzonderlijk gerapporteerde BFCL v3 multi-turn-score van 39,8 punten (53,5 voor Qwen3.6) laat dezelfde zwakte zien: enkele toolcalls gaan prima, lange gesprekken met herhaalde toolrondjes niet.
De uitschieter gaat de andere kant op.
Op Tau3-Bench (Banking) scoort Kolibri 1 38,1% terwijl Qwen3.6 10,6% haalt, Nemotron 3 Super 15,5% en Mistral Small 4 slechts 5,7%. Dat is ruwweg een marge van 2,5x boven het volgende model in deze vergelijkingsset (3,6x boven Qwen3.6) op een financieel getinte agent-benchmark, en het is het ene resultaat uit deze release dat ik het liefst onafhankelijk gerepliceerd zou willen zien.
| Benchmark | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| Tau2-Bench (Telecom) | 94,7% | 99,1% | 41,5% | 68,1% |
| Tau2-Bench (Retail) | 69,9% | 71,6% | 62,9% | 67,5% |
| Tau2-Bench (Airline) | 76,7% | 70,7% | 40% | 72,7% |
| Tau3-Bench (Banking) | 38,1% | 10,6% | 5,7% | 15,5% |
| BFCL v4 (overall) | 61,4% | 67,2% | 58% | 61% |
Gerapporteerde coderesultaten zijn 85,9 op LiveCodeBench v6, 66,4 op SWE-bench Verified en 27,7 op Terminal-Bench 2.1.
Ruwe codegeneratie oogt sterk, agentische software-engineering oogt gewoontjes, en het Terminal-Bench-cijfer zegt dat lang, meerstaps terminalwerk niet is waar dit model voor bedoeld is.
Er is een contaminatiekanttekening die je moet lezen voordat je hieruit citeert.
Het technisch rapport merkt op dat 48% van de Engelse en 47% van de Duitse HumanEval-evaluatiedata voorkwam in trainingsgerelateerd materiaal, wat HumanEval-achtige scores opblaast.
Verscheidene suites in de vergelijkende tabellen zijn proprietair of door leveranciers gemaakt, wat het volledige geheel lastig te auditen maakt, en er bestond ten tijde van schrijven geen geverifieerde one-to-one-vergelijking met de huidige vlaggenschepen van Claude, GPT of Gemini.
De efficiëntieclaim is degene die de kanttekening bij leveranciersrapportage het best overleeft, omdat het een eigenschap van de architectuur is en geen score.
Doorvoer betekent hier hoeveel tekst het model per GPU per seconde kan genereren. Aleph Alpha meet dit in bytes in plaats van tokens, zodat modellen met verschillende tokenizers eerlijk vergeleken kunnen worden.
Kolibri 1 zit op 71% gemiddeld op Aleph Alpha's Duitse benchmarksuite terwijl het ruwweg 47.000 bytes/s per GPU decodeert. GPT OSS A5B haalt 70% bij ongeveer 34.500 bytes/s, Qwen 3.6 A3B 67% bij ongeveer 38.500, Gemma 4 A4B 66% bij ongeveer 43.000 en Nemotron Super A12B 68% bij ongeveer 24.000.
Ongeveer 2x zoveel gedecodeerde tekst per GPU serveren als het Nemotron-model bij een hoger Duits gemiddelde is het praktische argument om in een zelfgehoste stack voor Kolibri te kiezen.
Als je voor je eigen GPU's betaalt in plaats van per token, is doorvoer per GPU het getal dat op de factuur verschijnt.
Er is geen gepubliceerde tokenprijs voor Kolibri 1.
Aleph Alpha heeft geen prijslijst voor een gehoste API vrijgegeven, en er verscheen geen bevestigde Kolibri API-model-ID in de officiële API-documentatie per 5 oktober 2026.
Enterprise-implementaties lopen via het salesteam van Aleph Alpha, en de repository-identificatie Aleph-Alpha/Kolibri-1 moet niet als een API-model-ID worden gezien.
De gewichten zelf zijn gratis onder Apache 2.0, dus je kosten zijn GPU-tijd.
De FP8-geheugenvoetafdruk is ruwweg 78 GB, met een opgegeven minimum van 2x A100 80 GB, 2x H100 SXM5, 1x H200, 1x B200 of 1x B300, en een aanbevolen configuratie van 2x H100 SXM5, 2x H200, 1x B200 of 1x B300. Het model is algemeen beschikbaar, geen preview, zonder wachtlijst of regiobeperking.
Ter referentie: onze GPT-6.1 Sol-bespreking zet dat model op $2 input / $10 output per miljoen tokens. Een prijszetting van derden noemt de oudere GPT-5.6 Sol op $5 / $30 en GPT-5.6 Luna op $0,20 / $1,20 na OpenAI's prijsverlaging van 30 juli.
Zelf hosten wint qua eenheidskosten pas zodra je volume de vaste kosten van een B200 overstijgt.
Kolibri 1 is open-weight onder Apache 2.0, wat commercieel gebruik, modificatie en redistributie toestaat zonder drempels voor gebruikers of omzet.
De gewichten staan op Aleph-Alpha/Kolibri-1 op Hugging Face in float8_e4m3fn. De modelkaart documenteert serven uitsluitend via vLLM, met Aleph Alpha's aleph-alpha-inference-plugin. Community-builds voor GGUF en MLX verschenen binnen enkele dagen, maar Aleph Alpha heeft die niet gevalideerd en ik kon geen officiële Ollama-entry vinden.
Voor een geserveerde deployment past ~78 GB aan FP8-gewichten op 1x H200 of 1x B200 op één kaart. Gebruik --tensor-parallel-size 2 op H100's.
Houd --max-model-len op of onder 262.144 tenzij je specifiek langere contexten hebt getest. Daarboven is een extra --hf-overrides-vlag nodig, zoals de modelkaart beschrijft.
Installeer de plugin en start de server:
pip install 'aleph-alpha-inference>=1'

# Add --tensor-parallel-size 2 on 2x H100
vllm serve Aleph-Alpha/Kolibri-1 \
  --kv-cache-dtype fp8 \
  --max-model-len 262144 \
  --reasoning-parser kolibri1 \
  --tool-call-parser kolibri1 \
  --enable-auto-tool-choice
Stel daarna je vraag via de OpenAI-compatibele API, met de samplingparameters die Aleph Alpha aanbeveelt (temperature 1,0, top_p 0,97, top_k 128):
from openai import OpenAI

client = OpenAI(base_url="http://localhost:8000/v1", api_key="EMPTY")

response = client.chat.completions.create(
    model="Aleph-Alpha/Kolibri-1",
    messages=[{
        "role": "user",
        "content": "Fasse die wichtigsten Fristen aus diesem Bescheid in drei Punkten zusammen.",
    }],
    temperature=1.0,
    top_p=0.97,
    max_tokens=512,
    extra_body={
        "top_k": 128,
        "chat_template_kwargs": {"reasoning_effort": "medium"},
    },
)
print(response.choices[0].message.content)
Reasoning effort accepteert low, medium en high, en je kunt denken helemaal uitschakelen als latency belangrijker is dan diepgang.
Uitvoer zal variëren met samplingparameters, en de modelkaart merkt op dat resultaten zelfs met uitgeschakelde sampling licht kunnen divergeren.
Voor een diepere setup rond zelfgehoste inferentie en agent-loops behandelt onze API-tutorial over het bouwen van een migratie-agent de toolrechten en stuurpatronen die direct overdraagbaar zijn.
Kolibri one is in naam een 'soevereine AI', wat betekent dat een land of organisatie zijn AI kan draaien, auditen en controleren op de eigen infrastructuur en onder eigen jurisdictie, zonder afhankelijk te zijn van de API, prijsstelling of servicevoorwaarden van een buitenlandse aanbieder. Voor Kolibri 1 rust dat op Apache 2.0-gewichten die je air-gapped kunt draaien (losgekoppeld van het internet), Europese trainingsinfrastructuur en documentatie conform de EU AI Act.
Toch zitten er twee stukken ondernemingscontext achter deze lancering.
Aleph Alpha heeft een bindende fusieovereenkomst getekend met het Canadese Cohere om te vormen tot wat zij omschrijven als de eerste trans-Atlantische soevereine AI-oplossing.
Het gecombineerde bedrijf gaat opereren onder de naam Cohere, met dubbele hoofdkantoren in Toronto en Berlijn, en Heidelberg blijft een onderzoekscentrum. De deal moet nog door de toezichthouders worden goedgekeurd.
Een soevereiniteitspropositie hangt af van het feit dat de eigenaar van het model het blijft ondersteunen, en het merk Aleph Alpha zal opgaan in Cohere zodra de fusie rond is, dus beide punten zijn het waard om samen met de benchmarks te volgen.
Aleph Alpha gokt erop dat soevereiniteit, Apache 2.0-licenties en gedocumenteerde conformiteit met de EU AI Act voor Europese publieke afnemers zwaarder wegen dan een paar punten op MMLU-Pro.
Die gok oogt redelijk, en de fusie met Cohere suggereert dat het bedrijf weet dat het niet puur op schaal kan winnen.
Ik denk dat je gerust kunt zeggen dat Kolibri 1 het beste Duitstalige open-weight-model is op dit actieve-parameterformaat dat we zo goed gedocumenteerd hebben gezien, maar het is niet het model waar ik naar zou grijpen als ik lange, meerstaps agent-runs of gesloten-boek feitelijke herinnering nodig had.
Onder vergelijkbare small-active MoE-modellen wint Qwen3.6 35B-A3B die strijd nog steeds. Als je je een dense 27B-model kunt veroorloven, wint Qwen3.8 27B die glansrijk.
Als je snel wilt bijspijkeren in het draaien en evalueren van dit soort modellen, begin dan met onze AI Fundamentals skill track.
Topcursussen op DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

