课程
面向开发者的 AI 辅助编码
1 小时 30 分钟
10.5K
已经有一段时间没有新的公司加入 LLM 竞赛了。但在 10 月 3 日,Aleph Alpha 将其新模型 Kolibri 1 以 Apache 2.0 许可证发布到 Hugging Face,并呼吁欧洲认真对待主权 AI。
他们的主张是:欧洲的政府和企业可以在自有硬件上运行一款能力足够强的模型,甚至完全离线运行,而无需依赖美国供应商的 API。
Kolibri 1 是一个专家混合(MoE)模型,总参数 780 亿,每个 token 激活 34.6 亿,由 Aleph Alpha Research 在德国和芬兰的数据中心使用 768 张 NVIDIA B200 GPU 从零开始训练。
它仅支持德语和英语,提供 1,048,576 个 token 的上下文窗口(Aleph Alpha 建议为服务效率将上下文保持在 262,144 个 token 以内),并以可用的正式版本发布而非预览版。预训练涵盖 20 万亿 token,其后在中期训练使用 3.44 万亿,长上下文扩展用 2010 亿。
本文将全面介绍 Kolibri 1 的新动态,涵盖关键特性、基准成绩,并核算实际运行成本。
Kolibri 1 是 Aleph Alpha 的专业化双语大语言模型(LLM),于 2026 年 10 月 3 日在 Apache 2.0 许可下发布。它仅有一个正式可用的单一规格,没有更小或更大的兄弟型号。
从架构看,它是一个 50 层的专家混合 Transformer。
每层包含 384 个小型专家子网络,路由器会将每个 token 仅发送给其中 6 个,再加上 1 个始终运行的共享专家。由此,总计 781 亿参数在每个 token 上仅有 34.6 亿处于激活状态(约 4.4%),模型更倾向于低成本服务而非最大容量。
另外两项设计选择也让它在速度和内存上更高效:
Aleph Alpha 主打的是效率,而非纯粹的能力上限。
Kolibri 1 在其德语基准套件上平均 71%,单 GPU 解码速度约 47,000 字节/秒;作为对比,Nemotron Super A12B 约为 68% 且约 24,000 字节/秒。
该模型的知识截止日期为 2026 年 6 月 18 日,适用于两种语言;它仅支持文本,不支持图像、音频或视频的输入或输出。
如果您想了解其德语能力的来源,公开的数据配比在开放权重发布中相当少见地透明。
| 领域 | 预训练 | 中期训练 | 长上下文扩展 |
|---|---|---|---|
| 英语网页与文档 | 43.4% | 1.3% | 15.8% |
| 德语网页与文档 | 23.4% | 2.1% | 2.6% |
| 代码 | 13.6% | 16.3% | 13.2% |
| 具身代理代码与工具使用 | ~0% | 15.4% | 5.6% |
| OCR 扫描 PDF | 0% | 0% | 33.3% |
上表仅展示了网页、代码、具身代理与 PDF 行。模型卡还列出了英语与德语的指令和推理数据、STEM 文档、问答,以及专业的法律与公共部门数据。将英语和德语各行合计后,模型卡将预训练配比总结为约 62.5% 英语、23.9% 德语、13.6% 代码。
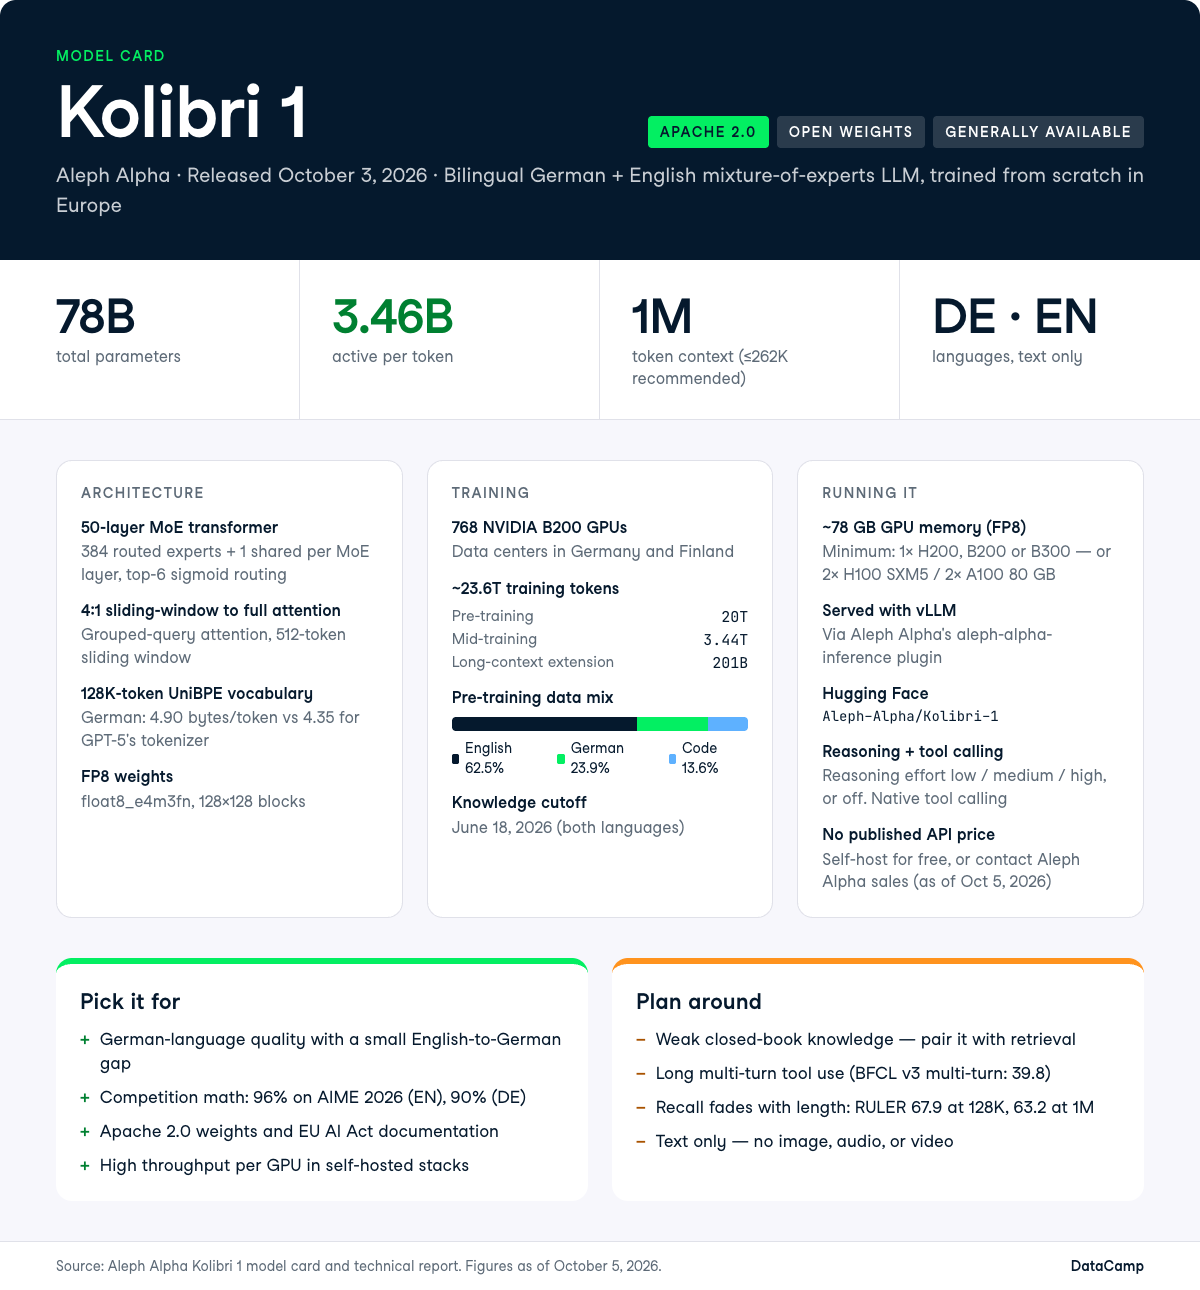
Kolibri 1 的差异化主要体现在两点:其一是用正确方式训练德语而非翻译凑数;其二是将激活参数压到足够低,让单卡 H200 就能提供服务。
Kolibri 1 在德语与英语之间缩小了通常会出现的差距,这在同等规模的开放权重模型中并不常见。
其整体基准平均分为英语 75.5、德语 70.8。
Aleph Alpha 使用一种名为 UniBPE 的新分词算法训练了一个 128,000-token 的词表,它保留了 BPE 的自底向上贪心合并,但用 Unigram 目标来选择进入词表的合并项。
据称收益是:德语压缩率为 4.90 字节/token,优于 GPT-5 分词器的 4.35;英语保持在 4.58 字节/token(GPT-5 分词器为 4.67)。
这既影响质量,也影响成本。
更好的压缩意味着相同德语文档需要更少的 token,因此一份 50 页的 Bescheid (德国官方行政通知)处理成本更低,也为上下文留出更多空间。
德语在预训练配比中占 23.4%,英语网页与文档占 43.4%,这说明这种能力是用数据“买来”的,而不是在主训练完成后用微调生硬拼接。
该模型宣称支持 1,048,576 个 token。它在经历 2010 亿 token 的长上下文训练后,原生支持 262,144 个 token,并通过外推扩展到 100 万,这意味着它从未在该长度上直接训练。
Aleph Alpha 本人建议为服务效率将上下文保持在 262,144 个 token 或以下。RULER(测试模型能否在超长输入中定位并使用特定细节)显示了基座模型的退化:128K 时为 67.9,100 万时为 63.2;作为对比,引用的 Qwen3.5 35B-A3B Base 在 128K 时为 89.9。
公平起见,Kolibri 在 100 万长度的得分仍高于 Nemotron 3 Nano(58.5)和 Qwen3.5(57.5),也就是说它从较低的起点衰减得更慢。
我会将 100 万视为技术上可达的天花板,而非可工作的预算。
如果您的检索增强生成(RAG)流水线把 40 万 token 的扫描 PDF(OCR 转文本)塞进提示,并期待模型可靠找出某个具体细节,请先测试再投入生产。需要注意的是,长上下文扩展训练中有 33.3% 来自 OCR 扫描 PDF,可见扫描文档负载显然是目标用例。
推理模式意味着模型会在作答前逐步推演问题,这能提升准确度,但会消耗更多 token。
在 Kolibri 1 中,这是一项由您控制的开关,而非单独的模型层级;工具调用(模型自行决定调用外部函数或 API,例如数据库查询)是原生支持的。
Aleph Alpha 将多步推理、RAG、具身代理工具调用、编码,以及双语助手工作列为预期用途;其中中期训练将 15.4% 配比放在具身代理代码与工具使用上,而预训练阶段几乎为零。
有一则用户的非正式反馈:在单张 RTX Pro 6000 工作站 GPU 上以 FP8 运行该模型,测得约每秒 170 token,且模型倾向于花较多 token 进行思考。
若在延迟敏感路径中默认开启推理模式,请预留预算。
Kolibri 1 从零训练而来,并非在他家模型上微调或复制。
这对许可合规与可追溯性都很关键。
配合 Apache 2.0 权重,意味着您可以在物理隔离(完全离线)的环境中运行 Kolibri 1,对其进行微调,并将其集成进商业产品而无需额外授权。
欧盟 AI 法案及其通用用途 AI(GPAI)行为准则为通用模型设定了规则,包括训练数据的文档化。
Aleph Alpha 是该行为准则的签署方,并发布了详尽的模型卡,涵盖训练数据来源、去污染步骤(从训练集中移除基准题目),以及权利人联系窗口——这些恰是欧盟 AI 法案合规审查需要的文档。
对于德国乃至更广泛欧盟的公共部门采购方,这些材料往往比基准成绩的微小差距更具决定性。
而这也是美国实验室短期内难以复制的部分。
Aleph Alpha 的模型卡直言列出了限制,采购前值得通读:
对于任何高风险部署,Aleph Alpha 表示需要额外的防护措施,并需符合法规(EU)2024/1689。
Kolibri 1 的基准画像在实用层面上“偏科”:它在竞赛数学与德语推理上领先于其对比集,但在闭卷知识、MMLU-Pro 和大多数工具使用套件上不及 Qwen3.6 35B-A3B。
Aleph Alpha 将其与Qwen3.6 35B-A3B、Mistral Small 4 119B-A6B,以及Nemotron 3 Super 120B-A12B 对比。
模型卡还列出了 Qwen3.8 27B,这是一款致密模型(与 MoE 不同,致密模型对每个 token 都使用全部参数),其在各项指标上更高(德语总体 79.9,Kolibri 为 70.8),但激活参数约为其 8 倍。
下方表格中我未纳入它,但在阅读效率相关论断时请留意这一点。
在这些模型名称中,字母 "A" 后的数字表示每个 token 的激活参数量,因此 35B-A3B 即总参 350 亿、激活 30 亿。下表中的基准指标测量的正是以下内容:
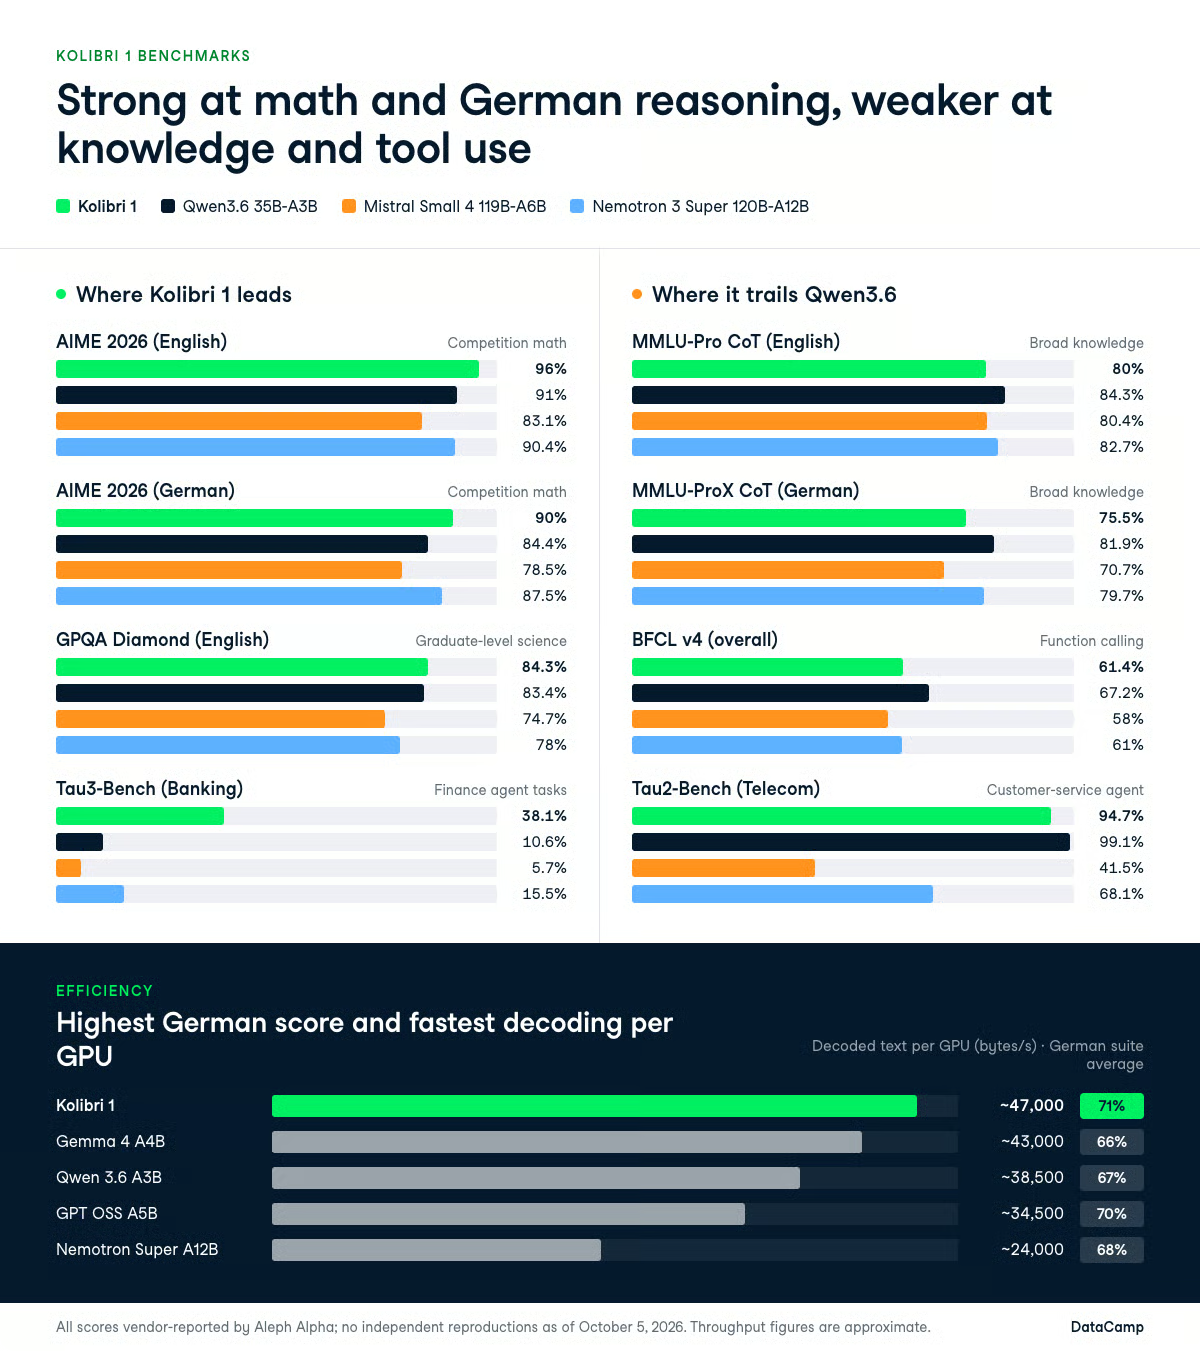
数学是 Kolibri 1 显著领先的领域。
它在 AIME 2026(EN)中得分为 96%,而 Qwen3.6 35B-A3B 为 91%、Nemotron 3 Super 为 90.4%、Mistral Small 4 为 83.1%;在 AIME 2025(EN)中为 96.9%,而 Qwen3.6 为 84.6%。
在 GPQA Diamond(EN)上,它拿到 84.3%,对比 83.4%;在 Humanity's Last Exam(EN)上为 21.5%,对比 21.1%,两者基本算打平。
同一张表里的弱项是知识。
AA-Omniscience 指数(公开集)采用高分更好的量表,负分常见。Kolibri 1 为 -32.8,对比 Qwen3.6 的 -12.5、Mistral Small 4 的 -24.0,虽略胜 Nemotron 3 Super 的 -36.5。另一个 AA-Omniscience 准确率指标为 14.8%,是四个模型中最低的。
在同一基准上的非幻觉率要更好看一些,为 44.0%,领先 Nemotron(13.9%)和 Mistral(34.7%),但落后于 Qwen3.6(56.7%),这与 Aleph Alpha 的放弃式训练相吻合。
一个 3.46B 活跃参数的模型背诵事实的空间有限,因此应结合检索使用,而不是依赖闭卷回忆。
| 基准(EN) | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| AIME 2026 | 96% | 91% | 83.1% | 90.4% |
| AIME 2025 | 96.9% | 84.6% | 79.8% | 91.7% |
| GPQA Diamond | 84.3% | 83.4% | 74.7% | 78% |
| Humanity's Last Exam | 21.5% | 21.1% | 9.7% | 20.6% |
| MMLU-Pro CoT | 80% | 84.3% | 80.4% | 82.7% |
| AA-Omniscience 指数(分数越高越好) | -32.8 | -12.5 | -24.0 | -36.5 |
Kolibri 1 在德语数学与科学基准上领先,在德语知识类基准上落后,其表现曲线与英语大致相同。
它在 AIME 2026(DE)中得分 90%,而 Qwen3.6 为 84.4%;在 GPQA Diamond(DE)中为 81.3%,对比 80.6%。在 MMLU-ProX CoT(DE)中它下降至 75.5%,而 Qwen3.6 达到 81.9%、Nemotron 3 Super 为 79.7%;在 Humanity's Last Exam(DE)上它为 15.9%,对比 Nemotron 的 22.3%。
我觉得真正有意思的是英译德之间的小幅差距。
Kolibri 在把 AIME 2026 从英语切换到德语时仅丢了 6 分,在 GPQA Diamond 上丢了 3 分,这比把德语当作单纯翻译目标的模型通常出现的下滑更小。
| 基准(DE) | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| AIME 2026 | 90% | 84.4% | 78.5% | 87.5% |
| AIME 2025 | 87.5% | 82.9% | 72.3% | 85.6% |
| GPQA Diamond | 81.3% | 80.6% | 72.9% | 76.6% |
| MMLU-ProX CoT | 75.5% | 81.9% | 70.7% | 79.7% |
| Humanity's Last Exam | 15.9% | 20.5% | 10.5% | 22.3% |
这是本次发布中最薄弱的部分。
在 BFCL v4 总体上,Kolibri 1 得分为 61.4%,而 Qwen3.6 为 67.2%;在 Tau2-Bench(Telecom)上它为 94.7%,而 Qwen3.6 为 99.1%。它在 Tau2-Bench(Airline)上略胜 Qwen3.6,76.7% 对 70.7%。
单独报告的 BFCL v3 多轮对话分数为 39.8(Qwen3.6 为 53.5),显示出相同弱点:单次工具调用没问题,但多轮、反复调用工具的长对话表现不佳。
有一个异类结果则相反。
在 Tau3-Bench(Banking)上,Kolibri 1 为 38.1%,而 Qwen3.6 为 10.6%、Nemotron 3 Super 为 15.5%、Mistral Small 4 仅为 5.7%。在这个带有金融色彩的代理基准上,它大约以 2.5 倍于次优模型(对 Qwen3.6 则是 3.6 倍)的优势领先,这是本次发布中我最希望能被独立复现的单项结果。
| 基准 | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| Tau2-Bench(Telecom) | 94.7% | 99.1% | 41.5% | 68.1% |
| Tau2-Bench(Retail) | 69.9% | 71.6% | 62.9% | 67.5% |
| Tau2-Bench(Airline) | 76.7% | 70.7% | 40% | 72.7% |
| Tau3-Bench(Banking) | 38.1% | 10.6% | 5.7% | 15.5% |
| BFCL v4(整体) | 61.4% | 67.2% | 58% | 61% |
报告的编程结果为:LiveCodeBench v6 得分 85.9,SWE-bench Verified 得分 66.4,Terminal-Bench 2.1 得分 27.7。
纯代码生成看起来很强,代理式的软件工程表现一般,而 Terminal-Bench 的分数表明该模型并不擅长长链条的多步终端操作。
在引用这些结果前,有一个关于数据污染的注意事项需要了解。
技术报告指出,英文 HumanEval 数据有 48%、德文有 47% 出现在与训练相关的材料中,这会抬高 HumanEval 类指标。
对比表中的若干测试套件为专有或厂商自建,这使得整体难以全面审计;截至撰稿时,并无与当前 Claude、GPT 或 Gemini 旗舰进行经验证的一致对比。
在厂商自报的注意事项中,效率主张最经得起考验,因为这更多取决于架构属性而非分数。
此处的吞吐指每块 GPU 每秒能生成多少文本。Aleph Alpha 以字节而非 token 计量,便于不同分词器的模型公平对比。
Kolibri 1 在 Aleph Alpha 的德语基准套件上平均为 71%,同时单卡解码速率约为 47,000 字节/秒。GPT OSS A5B 约 70%,约 34,500 字节/秒;Qwen 3.6 A3B 67%,约 38,500;Gemma 4 A4B 66%,约 43,000;Nemotron Super A12B 68%,约 24,000。
在更高的德语平均分下,单卡解码文本量约为 Nemotron 模型的 2 倍,这是在自建部署中选择 Kolibri 的实际理由。
如果您按 GPU 计费而非按 token 计费,那么每块 GPU 的吞吐就是最终体现在账单上的数字。
Kolibri 1 未公布 token 价格。
Aleph Alpha 尚未发布托管 API 的价目表,截至 2026 年 10 月 5 日,官方 API 文档中也未出现确认的 Kolibri API 模型 ID。
企业部署通过 Aleph Alpha 的销售团队推进,且仓库标识 Aleph-Alpha/Kolibri-1 不应视为 API 模型 ID。
模型权重本身以 Apache 2.0 授权免费提供,因此您的成本在于 GPU 时间。
FP8 内存占用约 78 GB,声明的最低配置为 2× A100 80 GB、2× H100 SXM5、1× H200、1× B200 或 1× B300;推荐配置为 2× H100 SXM5、2× H200、1× B200 或 1× B300。该模型为全面可用状态,非预览,无需等待名单或区域限制。
作为参照,我们对 GPT-6.1 Sol 的报道给出的价格为每百万 token 输入 $2、输出 $10。第三方价格汇总显示,较早的 GPT-5.6 Sol 在 7 月 30 日 OpenAI 降价后为 $5 / $30,GPT-5.6 Luna 为 $0.20 / $1.20。
只有当您的用量超过一块 B200 的固定成本后,自建部署在单位经济上才更划算。
Kolibri 1 以 Apache 2.0 的开放权重发布,允许商业使用、修改与再发布,无用户数或营收门槛。
权重托管在 Hugging Face 的 Aleph-Alpha/Kolibri-1,格式为 float8_e4m3fn。模型卡记录了仅通过 vLLM 部署,并使用 Aleph Alpha 的 aleph-alpha-inference 插件。社区在数日内提供了 GGUF 与 MLX 构建,但尚未获 Aleph Alpha 验证,我也未找到官方的 Ollama 条目。
对于托管部署,1× H200 或 1× B200 即可在单卡上容纳约 78 GB 的 FP8 权重。在 H100 上使用 --tensor-parallel-size 2。
将 --max-model-len 设为不超过 262,144,除非您已对更长上下文进行过专门测试。超过该值需要额外的 --hf-overrides 标志,模型卡有说明。
安装插件并启动服务:
pip install 'aleph-alpha-inference>=1'

# Add --tensor-parallel-size 2 on 2x H100
vllm serve Aleph-Alpha/Kolibri-1 \
  --kv-cache-dtype fp8 \
  --max-model-len 262144 \
  --reasoning-parser kolibri1 \
  --tool-call-parser kolibri1 \
  --enable-auto-tool-choice
然后通过与 OpenAI 兼容的 API 进行请求,使用 Aleph Alpha 推荐的采样参数(temperature 1.0、top_p 0.97、top_k 128):
from openai import OpenAI

client = OpenAI(base_url="http://localhost:8000/v1", api_key="EMPTY")

response = client.chat.completions.create(
    model="Aleph-Alpha/Kolibri-1",
    messages=[{
        "role": "user",
        "content": "Fasse die wichtigsten Fristen aus diesem Bescheid in drei Punkten zusammen.",
    }],
    temperature=1.0,
    top_p=0.97,
    max_tokens=512,
    extra_body={
        "top_k": 128,
        "chat_template_kwargs": {"reasoning_effort": "medium"},
    },
)
print(response.choices[0].message.content)
reasoning effort 接受 low、medium 与 high,如果时延比深度更重要,您也可以完全关闭思维链。
输出会随采样参数变化。模型卡指出,即使关闭采样,结果也可能略有差异。
若要更深入地搭建自托管推理与代理循环,我们的迁移代理 API 教程涵盖了可直接迁移的工具权限与引导模式。
Kolibri 在概念上是一款“主权 AI”,意味着国家或组织可以在自有基础设施与司法辖区内运行、审计并控制其 AI,而无需依赖国外供应商的 API、定价或服务条款。对 Kolibri 1 而言,这一主张依托于可在物理隔离环境(离网)运行的 Apache 2.0 权重、欧洲的训练基础设施,以及符合欧盟《AI 法案》的文件。
不过,此次发布背后有两点公司层面的背景。
Aleph Alpha 已与加拿大公司 Cohere 签署具有约束力的合并协议,双方称之为首个跨大西洋的主权 AI 解决方案。
合并后的公司将沿用 Cohere 之名,在多伦多与柏林设双总部,海德堡继续作为研究中心。该交易仍需监管批准。
主权的卖点取决于模型所有者能否持续提供支持;而在合并完成后,Aleph Alpha 品牌将并入 Cohere,因此在关注基准成绩的同时,这两点也值得跟进。
Aleph Alpha 押注于主权、Apache 2.0 许可,以及已记录的欧盟《AI 法案》合规性,对欧洲公共部门买家而言,这些比 MMLU-Pro 上的几分差距更重要。
这看起来是合理的判断,而与 Cohere 的合并也表明公司清楚,仅凭规模难以取胜。
可以说,Kolibri 1 是我们所见文档最完整、在这一活跃参数规模下表现最好的德语开源权重模型,但如果需要进行长时多轮的代理任务,或依赖闭卷事实回忆,我不会首选它。
在可比的小活跃 MoE 模型中,Qwen3.6 35B-A3B 仍然占优;若能承担致密 27B 模型的成本,Qwen3.8 27B 则是明显的赢家。
如果您想快速上手这类模型的运行与评估,请从我们的AI 基础技能路径开始。
DataCamp 热门课程
课程
课程
课程