コース
開発者のための AI 支援コーディング
1時間30分
10.5K
LLM競争に新顔が現れるのは久しぶりです。10月3日、Aleph Alphaは新モデルKolibri 1をApache 2.0ライセンスでHugging Faceに公開し、欧州におけるソブリンAIの重要性を訴えました。
狙いは、欧州の政府や企業が米国プロバイダのAPIに依存せず、オフラインも含め自社ハードウェア上で有能なモデルを運用できるようにすることです。
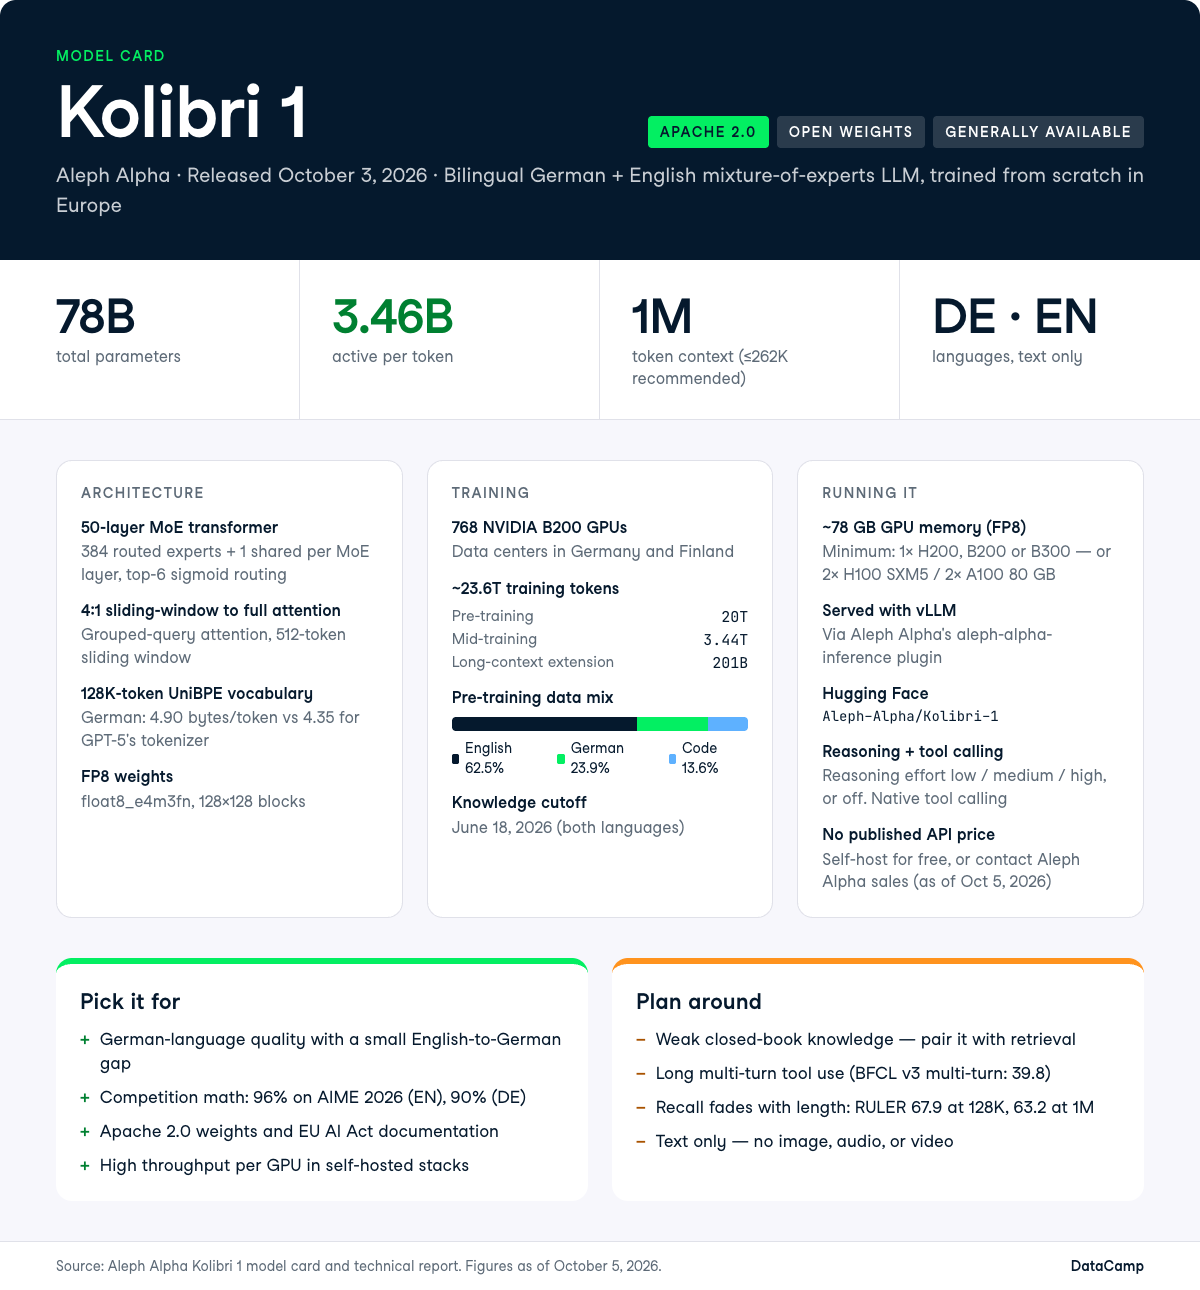
Kolibri 1は混合専門家(MoE)型モデルで、総パラメータ78B、トークン当たり3.46Bがアクティブ。Aleph Alpha ResearchがドイツとフィンランドのデータセンターでNVIDIA B200 GPUを768基用い、ゼロから学習しました。
対応言語はドイツ語と英語のみ。コンテキストウィンドウは1,048,576トークン(提供効率の観点で262,144トークン以下を推奨)で、プレビューではなく一般提供として出荷。事前学習は20兆トークン、その後の中間学習3.44兆、長文コンテキスト拡張に2010億トークンを投じています。
本記事では、Kolibri 1の新要素を網羅し、主要機能、ベンチマーク、実運用コストを順に見ていきます。
Kolibri 1はAleph Alphaの特化型二言語LLMで、2026年10月3日にApache 2.0で公開。単一の一般提供モデルで、派生の小型・大型モデルはありません。
内部は50層のMixture-of-Expertsトランスフォーマです。
各層に384の小型専門サブネットワーク(エキスパート)があり、ルータが各トークンを6つのエキスパートへ振り分け、さらに常時動作の共有エキスパートが1つ。これにより総78.1Bパラメータのうち、トークン当たりのアクティブは3.46B(約4.4%)まで圧縮され、最大能力よりも低コスト提供に最適化されています。
さらに2つの設計判断で、高速かつ省メモリ化を図っています。
Aleph Alphaが強調するのは、能力の絶対値よりも効率です。
Kolibri 1はドイツ語ベンチマーク群で平均71%を記録し、GPUあたり約47,000バイト/秒でデコード。一方Nemotron Super A12Bは68%・約24,000バイト/秒です。
ナレッジカットオフは両言語とも2026年6月18日。入出力はテキストのみで、画像・音声・動画には非対応です。
ドイツ語の実力の源泉を確認したい場合、公開データ配合はオープンウェイトとしては異例に透明です。
| 分野 | 事前学習 | 中間学習 | 長文コンテキスト拡張 |
|---|---|---|---|
| 英語のWebとドキュメント | 43.4% | 1.3% | 15.8% |
| ドイツ語のWebとドキュメント | 23.4% | 2.1% | 2.6% |
| コード | 13.6% | 16.3% | 13.2% |
| エージェント的コードとツール使用 | ~0% | 15.4% | 5.6% |
| OCR済みPDF | 0% | 0% | 33.3% |
表ではWeb、コード、エージェント、PDFのみを示しています。モデルカードにはこのほか、英独の指示・推論データ、STEM文書、QA、法務・公共分野の特化データも記載。英独すべてを合算すると、事前学習の配合は概ね英語62.5%、ドイツ語23.9%、コード13.6%と要約されています。
Kolibri 1を特徴づけるのは主に2点です。ドイツ語を翻訳頼みでなく正攻法で学習したこと、そしてアクティブパラメータを単体のH200で提供可能な水準に抑えたこと。
Kolibri 1は、この規模のオープンウェイトとしては珍しく、英語とのギャップを大きく詰めています。
総合ベンチマーク平均は英語75.5、ドイツ語70.8。
Aleph AlphaはUniBPEという新しいトークナイザ手法で128,000語彙を学習。BPEの貪欲なボトムアップ結合を保ちつつ、どの結合を語彙に採用するかはUnigram目的で選定します。
公表値では、ドイツ語の圧縮率は4.90バイト/トークン(GPT-5のトークナイザは4.35)で、英語は4.58バイト/トークン(GPT-5のトークナイザは4.67)を維持。
これは品質だけでなくコストにも効いてきます。
圧縮率が高ければ同じドイツ語文書でもトークン数が減るため、50ページのBescheid (ドイツの行政通知)の処理コストは下がり、コンテキストの余裕も増えます。
事前学習におけるドイツ語の比率は23.4%で、英語のWeb・文書(43.4%)に次ぐ規模。つまり能力はメイン学習後の微調整の「付け足し」ではなく、データ投入で獲得したものです。
モデルは1,048,576トークンを標榜。2010億トークンの長文学習によりネイティブには262,144トークンまで対応し、100万は外挿で到達している(=その長さでの学習は未実施)という位置づけです。
Aleph Alpha自身、提供効率のため262,144トークン以下に収めることを推奨。超長文中の特定情報を拾えるかを測るRULERでは、ベースモデルで128Kが67.9、1Mが63.2。参考として挙げられたQwen3.5 35B-A3B Baseは128Kで89.9です。
とはいえ、Kolibriの1Mスコアは同長でのNemotron 3 Nano(58.5)やQwen3.5(57.5)を上回り、低めの初期値からの劣化幅は小さい方です。
100万トークンは「技術的に到達可能な上限」であって「実用の予算」とは見なさない方が現実的です。
もしRAG(検索拡張生成)のパイプラインで、スキャンPDFのOCRテキスト40万トークンをプロンプトに詰め込み、特定の一情報を確実に引き当てたいなら、導入前に実験してください。長文拡張のデータ配合の33.3%がOCR済みPDFであり、スキャン文書のワークロードを明確に想定しています。
推論モードは、回答前に段階的に思考を展開する設定。精度が上がる一方、使用トークンは増えます。
Kolibri 1では別モデルではなくスイッチで制御でき、ツール呼び出し(データベース照会など外部関数やAPIの呼出判断)もネイティブ対応です。
Aleph Alphaは想定用途として、多段推論、RAG、エージェント的ツール呼び出し、コーディング、二言語アシスタントを挙げており、中間学習ではエージェント的コード・ツール使用を15.4%まで引き上げ(事前学習時はほぼゼロ)、強化しています。
あるユーザー報告では、単一のRTX Pro 6000ワークステーションGPU上でFP8動作させた際、毎秒約170トークンを計測し、思考に多くのトークンを費やす傾向が見られたとのこと。
レイテンシに厳しい経路で推論モードを常時オンにする場合は、その分の予算取りを。
Kolibri 1はスクラッチ学習で、他社モデルのファインチューニングや派生ではありません。
これはライセンス上の明確さや、投入データの可視性の点で重要です。
Apache 2.0の重みと併せ、エアギャップ(完全オフライン)運用、ファインチューニング、商用製品への組み込みが、許諾不要で可能です。
EUの一般目的AI(GPAI)行動規範を含むEU AI法は、トレーニングデータのドキュメンテーションなど、汎用モデルに求められるルールを定めています。
Aleph Alphaは行動規範の署名企業で、学習データ源、脱汚染手順(ベンチマーク問題の除去)、権利者窓口を含む詳細なモデルカードを公開。EU AI法の適合審査で求められる資料に対応しています。
ドイツやEUの公共調達では、ベンチ差よりもこの書類面が決め手になることが多々あります。
そしてこれは、米国の研究所が短期で模倣しづらい部分でもあります。
Aleph Alphaのモデルカードは制約事項を明確に公表しており、調達前に読む価値があります。
高リスク用途では、追加のガードレールと、Regulation (EU) 2024/1689への準拠が必要と明記されています。
Kolibri 1のプロファイルは、実務的に有用な「偏り」があります。競技数学とドイツ語推論では比較対象をリードする一方、クローズドブック知識、MMLU-Pro、多くのツール使用スイートではQwen3.6 35B-A3Bに劣後します。
Aleph Alphaは比較対象として、Qwen3.6 35B-A3B、Mistral Small 4 119B-A6B、Nemotron 3 Super 120B-A12Bを挙げています。
モデルカードにはQwen3.8 27B(MoEではない高密度モデル)も記載され、全般に高スコア(ドイツ語総合79.9、Kolibriは70.8)ですが、アクティブパラメータは約8倍です。
以下の表からは外していますが、効率性の主張を読む際は頭に置いておくとよいでしょう。
なお、モデル名の「A」の後ろの数字はトークン当たりのアクティブパラメータ数を示します。つまり35B-A3Bは総35B・アクティブ3Bという意味です。以下の表のベンチマークは、次のような指標を測っています。
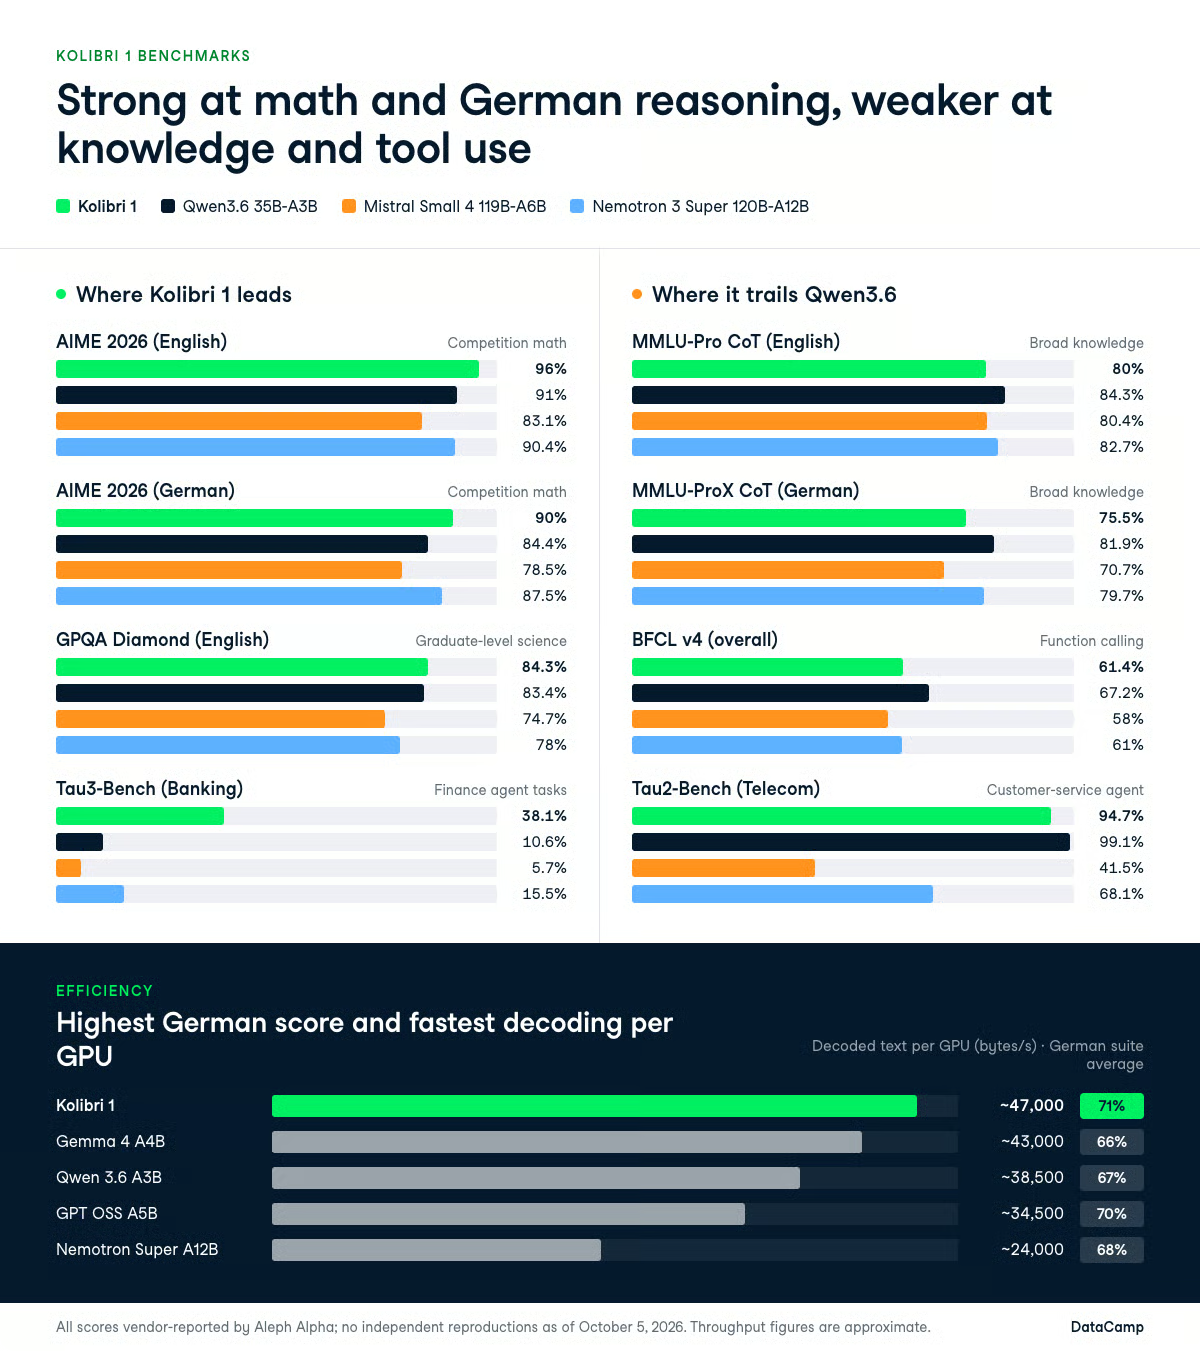
数学では、Kolibri 1 の優位がはっきりしています。
AIME 2026(EN)で96%(Qwen3.6 35B-A3Bは91%、Nemotron 3 Superは90.4%、Mistral Small 4は83.1%)、AIME 2025(EN)で96.9%(Qwen3.6は84.6%)を記録しています。
GPQA Diamond(EN)では84.3%対83.4%、Humanity's Last Exam(EN)では21.5%対21.1%で、いずれも事実上の互角と言えます。
同じ表での弱点は知識分野です。
AA-Omniscience Index(公開セット)は負の値が一般的で、高いほど良いスケールです。Kolibri 1 は-32.8で、Qwen3.6の-12.5やMistral Small 4の-24.0に劣る一方、Nemotron 3 Superの-36.5は上回ります。別掲のAA-Omniscience精度は14.8%で、4モデル中最も低い数値です。
同ベンチマークにおける非ハルシネーション率は44.0%と良好で、Nemotron(13.9%)やMistral(34.7%)を上回る一方、Qwen3.6(56.7%)には及びません。これはAleph Alphaのアブステンション(棄権)学習と整合的です。
アクティブパラメータ3.46Bのモデルは事実の丸暗記に限界があるため、クローズドブック想起を過信せず、検索併用(RAG)を組み合わせて使うべきです。
| ベンチマーク(EN) | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| AIME 2026 | 96% | 91% | 83.1% | 90.4% |
| AIME 2025 | 96.9% | 84.6% | 79.8% | 91.7% |
| GPQA Diamond | 84.3% | 83.4% | 74.7% | 78% |
| Humanity's Last Exam | 21.5% | 21.1% | 9.7% | 20.6% |
| MMLU-Pro CoT | 80% | 84.3% | 80.4% | 82.7% |
| AA-Omniscience Index(高いほど良い) | -32.8 | -12.5 | -24.0 | -36.5 |
Kolibri 1 はドイツ語の数学・科学系では強く、知識系では弱いという、英語と同じプロファイルを示しています。
AIME 2026(DE)で90%(Qwen3.6は84.4%)、GPQA Diamond(DE)で81.3%(同80.6%)。一方、MMLU-ProX CoT(DE)では75.5%と落ち、Qwen3.6は81.9%、Nemotron 3 Superは79.7%。Humanity's Last Exam(DE)では15.9%で、Nemotronの22.3%に及びません。
個人的に興味深いのは、英語からドイツ語へのギャップが小さい点です。
Kolibri はAIME 2026で英語からドイツ語に移ると6ポイント低下、GPQA Diamondで3ポイント低下に留まり、ドイツ語を単なる翻訳対象として扱うモデルに比べて落ち幅が小さく見えます。
| ベンチマーク(DE) | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| AIME 2026 | 90% | 84.4% | 78.5% | 87.5% |
| AIME 2025 | 87.5% | 82.9% | 72.3% | 85.6% |
| GPQA Diamond | 81.3% | 80.6% | 72.9% | 76.6% |
| MMLU-ProX CoT | 75.5% | 81.9% | 70.7% | 79.7% |
| Humanity's Last Exam | 15.9% | 20.5% | 10.5% | 22.3% |
この領域は今回の発表で最も弱い部分です。
BFCL v4 全体では、Kolibri 1 は61.4%で、Qwen3.6の67.2%に及びません。Tau2-Bench(Telecom)では94.7%(Qwen3.6は99.1%)。一方、Tau2-Bench(Airline)では76.7%でQwen3.6の70.7%を上回ります。
別掲のBFCL v3マルチターンは39.8ポイント(Qwen3.6は53.5)で、同じ弱点を示します。単発のツール呼び出しは問題ない一方、ツール往復を繰り返す長い対話は不得手です。
ただし、逆方向の外れ値があります。
Tau3-Bench(Banking)では、Kolibri 1 が38.1%で、Qwen3.6の10.6%、Nemotron 3 Superの15.5%、Mistral Small 4の5.7%を大きく上回ります。金融色の強いエージェント系ベンチマークで次点モデルに対して約2.5倍(Qwen3.6比では3.6倍)の差であり、この発表全体で最も第三者検証を望みたい結果です。
| ベンチマーク | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| Tau2-Bench(Telecom) | 94.7% | 99.1% | 41.5% | 68.1% |
| Tau2-Bench(Retail) | 69.9% | 71.6% | 62.9% | 67.5% |
| Tau2-Bench(Airline) | 76.7% | 70.7% | 40% | 72.7% |
| Tau3-Bench(Banking) | 38.1% | 10.6% | 5.7% | 15.5% |
| BFCL v4(全体) | 61.4% | 67.2% | 58% | 61% |
報告されたコーディング結果は、LiveCodeBench v6で85.9、SWE-bench Verifiedで66.4、Terminal-Bench 2.1で27.7です。
生のコード生成は強く、エージェント的なソフトウェアエンジニアリングは平凡、Terminal-Benchの数値は、長い多段のターミナル作業には不向きであることを示します。
引用前に読むべき汚染(コンタミ)に関する注意点があります。
技術レポートでは、HumanEval評価データの48%(英語)と47%(ドイツ語)が学習関連素材に出現しており、HumanEval系スコアを押し上げると指摘しています。
比較表に含まれるスイートのいくつかはプロプライエタリまたはベンダー作成で、全体の監査は難しく、執筆時点で現行のClaude、GPT、Geminiの旗艦と検証済みの厳密な同条件比較は存在しませんでした。
効率に関する主張は、ベンダー報告の留保の中でも最も生き残るもので、スコアではなくアーキテクチャの特性だからです。
ここでのスループットとは、GPUあたり毎秒どれだけのテキストを生成できるかを意味します。Aleph Alphaはトークンではなくバイトで測定するため、トークナイザが異なるモデル間でも公正に比較できます。
Kolibri 1 はAleph Alphaのドイツ語ベンチマークスイートで平均71%を達成しつつ、GPUあたり約47,000 bytes/sでデコードします。GPT OSS A5Bは約34,500 bytes/sで70%、Qwen 3.6 A3Bは約38,500で67%、Gemma 4 A4Bは約43,000で66%、Nemotron Super A12Bは約24,000で68%です。
Nemotronモデルより高いドイツ語平均を維持しつつ、GPUあたりのデコード済みテキスト量で約2倍を出せることは、セルフホスト環境でKolibriを選ぶ実利的な根拠になります。
トークン単価ではなく自前のGPUに支払う場合、GPUあたりのスループットこそが請求書に反映される数値です。
Kolibri 1 のトークン単価は公開されていません。
Aleph Alphaはホスト型APIの価格表を公開しておらず、2026年10月5日時点の公式APIドキュメントに、確定したKolibriのAPIモデルIDは掲載されていませんでした。
エンタープライズ導入はAleph Alphaの営業経由で行われ、リポジトリ識別子 Aleph-Alpha/Kolibri-1 はAPIモデルIDとして扱うべきではありません。
重み自体はApache 2.0で無償提供されているため、コストはGPU時間です。
FP8のメモリフットプリントは約78 GBで、最小構成は2x A100 80 GB、2x H100 SXM5、1x H200、1x B200、または1x B300。推奨構成は2x H100 SXM5、2x H200、1x B200、または1x B300。一般提供(GA)で、プレビューではなく、ウェイトリストや地域制限はありません。
比較材料として、当社のGPT-6.1 Solのカバレッジでは、そのモデルは100万トークンあたり入力$2/出力$10としています。第三者の価格まとめでは、旧世代のGPT-5.6 Solが$5/$30、GPT-5.6 LunaがOpenAIの7月30日の値下げ後で$0.20/$1.20と記載されています。
セルフホスティングが単価面で有利になるのは、B200の固定費を超えるボリュームを確保できてからです。
Kolibri 1 はApache 2.0のオープンウェイトで、商用利用、改変、再配布を、ユーザー数や収益のしきい値なしに許可します。
重みはHugging Faceの Aleph-Alpha/Kolibri-1 に float8_e4m3fn 形式で公開されています。モデルカードではAleph Alphaの aleph-alpha-inference プラグインを用いたvLLM経由での提供のみを記載。コミュニティ製のGGUFやMLXビルドは数日で登場しましたが、Aleph Alphaはそれらを検証しておらず、公式のOllamaエントリは見当たりませんでした。
提供環境では、1x H200または1x B200で約78 GBのFP8ウェイトを単一カードに格納できます。H100では --tensor-parallel-size 2 を使用してください。
--max-model-len は、特別に長文コンテキストを検証していない限り262,144以下に保ってください。それ以上にするには追加の --hf-overrides フラグが必要で、モデルカードに記載があります。
プラグインをインストールしてサーバーを起動します:
pip install 'aleph-alpha-inference>=1'

# Add --tensor-parallel-size 2 on 2x H100
vllm serve Aleph-Alpha/Kolibri-1 \
  --kv-cache-dtype fp8 \
  --max-model-len 262144 \
  --reasoning-parser kolibri1 \
  --tool-call-parser kolibri1 \
  --enable-auto-tool-choice
次に、OpenAI互換API経由で、Aleph Alpha推奨のサンプリングパラメータ(temperature 1.0、top_p 0.97、top_k 128)を使って問い合わせます:
from openai import OpenAI

client = OpenAI(base_url="http://localhost:8000/v1", api_key="EMPTY")

response = client.chat.completions.create(
    model="Aleph-Alpha/Kolibri-1",
    messages=[{
        "role": "user",
        "content": "Fasse die wichtigsten Fristen aus diesem Bescheid in drei Punkten zusammen.",
    }],
    temperature=1.0,
    top_p=0.97,
    max_tokens=512,
    extra_body={
        "top_k": 128,
        "chat_template_kwargs": {"reasoning_effort": "medium"},
    },
)
print(response.choices[0].message.content)
reasoning_effort は low、medium、high を受け付け、レイテンシを優先する場合は思考プロセスを完全にオフにできます。
出力はサンプリングパラメータにより変動し、サンプリングを無効にしてもわずかに発散する場合があるとモデルカードに記載されています。
セルフホスト推論やエージェントループの詳細なセットアップについては、当社の移行エージェント構築に関するAPIチュートリアルで、ツール権限や誘導のパターンを解説しています(そのまま応用できます)。
Kolibri 1 は概念上「ソブリンAI」であり、国外プロバイダのAPI、価格、利用規約に依存せず、自らのインフラと法域の下でAIを運用・監査・制御できるという意味合いです。Kolibri 1 の場合、その根拠はオフライン(エアギャップ)運用可能なApache 2.0のウェイト、欧州の学習インフラ、EU AI Act準拠の文書化にあります。
ただし、このリリースの背後には企業としての文脈が2点あります。
Aleph Alpha はカナダのCohere社と拘束力のある合併契約を締結し、彼らの言う「初の大西洋横断ソブリンAIソリューション」を形成します。
統合後の会社はCohereの社名で、トロントとベルリンの二本社体制となり、ハイデルベルクは研究拠点として継続。取引はなお規制当局の承認が必要です。
主権性の訴求は、モデルの所有者が継続的に支援するかに依存します。合併成立後はAleph AlphaブランドがCohereに統合される予定であるため、これらの点はベンチマークと併せて注視する価値があります。
Aleph Alpha は、主権性、Apache 2.0ライセンス、EU AI Actの文書化が、MMLU-Proで数ポイント上回ることよりも、欧州の公共部門の購買において重要だと見ています。
その見立ては妥当に思われ、Cohereとの合併はスケールだけでは勝てないとの認識を示唆します。
Kolibri 1 は、このアクティブパラメータ規模で、ここまで丁寧に文書化されたドイツ語対応のオープンウェイトモデルとして最良と言ってよいでしょう。ただし、長いマルチターンのエージェント運用やクローズドブックの事実想起が必要なら、第一選択にはなりません。
同等の小規模アクティブMoEモデルの中では、Qwen3.6 35B-A3Bが依然として優勢です。高密度の27Bモデルを許容できるなら、Qwen3.8 27Bが明確に勝ります。
この種のモデルの運用や評価を素早くキャッチアップしたい場合は、まずは当社のAI Fundamentals スキルトラックから始めてください。
DataCampのおすすめコース
コース
コース
コース