
Khóa học
Lập trình với AI dành cho Developer
1 giờ 30 phút
10.5K
Đã khá lâu rồi mới có một công ty mới tham gia cuộc đua LLM. Nhưng vào ngày 3 tháng 10, Aleph Alpha đã đưa mô hình mới Kolibri 1 lên Hugging Face theo giấy phép Apache 2.0 và kêu gọi châu Âu nghiêm túc với AI có chủ quyền.
Lập luận là các chính phủ và doanh nghiệp châu Âu có thể vận hành một mô hình đủ mạnh trên hạ tầng của riêng mình, thậm chí hoàn toàn ngoại tuyến, thay vì phụ thuộc vào API của một nhà cung cấp Mỹ.
Kolibri 1 là mô hình mixture-of-experts (MoE) với tổng 78B tham số và 3,46B tham số hoạt động mỗi token, được Aleph Alpha Research huấn luyện từ đầu trên 768 GPU NVIDIA B200 tại các trung tâm dữ liệu ở Đức và Phần Lan.
Mô hình chỉ hỗ trợ tiếng Đức và tiếng Anh, có cửa sổ ngữ cảnh 1.048.576 token (Aleph Alpha khuyến nghị duy trì ở mức 262.144 token hoặc thấp hơn để phục vụ hiệu quả), và phát hành ở trạng thái sẵn sàng chung thay vì bản xem trước. Giai đoạn tiền huấn luyện bao phủ 20 nghìn tỷ token, tiếp theo là 3,44T ở giữa quá trình huấn luyện và 201B cho mở rộng ngữ cảnh dài.
Trong bài viết này, tôi sẽ điểm qua mọi điều mới với Kolibri 1, xem các tính năng chính, đào sâu vào điểm chuẩn, và đi qua chi phí vận hành thực tế.
Kolibri 1 là mô hình ngôn ngữ lớn (LLM) song ngữ chuyên biệt của Aleph Alpha, phát hành ngày 3 tháng 10, 2026 theo Apache 2.0. Đây là một mô hình sẵn sàng chung duy nhất, không có bản nhỏ hơn hay lớn hơn.
Về kiến trúc, đây là transformer mixture-of-experts 50 lớp.
Mỗi lớp có 384 mạng con chuyên gia nhỏ, và một bộ định tuyến gửi mỗi token đến chỉ 6 chuyên gia trong số đó, cùng 1 chuyên gia dùng chung luôn chạy. Nhờ đó 78,1B tham số tổng thu gọn còn 3,46B tham số hoạt động mỗi token (khoảng 4,4%), hướng mô hình tới phục vụ rẻ thay vì dung lượng tối đa.
Hai lựa chọn thiết kế khác giữ cho mô hình nhanh và nhẹ bộ nhớ:
Kết quả nổi bật mà Aleph Alpha nhấn mạnh là hiệu suất, không phải năng lực thô.
Kolibri 1 đạt trung bình 71% trên bộ điểm chuẩn tiếng Đức của họ trong khi giải mã khoảng 47.000 byte/giây mỗi GPU, so với 68% ở khoảng 24.000 byte/giây của Nemotron Super A12B.
Mô hình có mốc kiến thức ngày 18 tháng 6, 2026 cho cả hai ngôn ngữ, và chỉ xử lý văn bản, không có đầu vào hay đầu ra hình ảnh, âm thanh, hoặc video.
Nếu bạn muốn xem năng lực tiếng Đức đến từ đâu, phối trộn dữ liệu được công bố minh bạch khác thường đối với một bản phát hành trọng số mở.
| Lĩnh vực | Tiền huấn luyện | Giữa huấn luyện | Mở rộng ngữ cảnh dài |
|---|---|---|---|
| Web và tài liệu tiếng Anh | 43,4% | 1,3% | 15,8% |
| Web và tài liệu tiếng Đức | 23,4% | 2,1% | 2,6% |
| Mã nguồn | 13,6% | 16,3% | 13,2% |
| Mã và sử dụng công cụ tác tử | ~0% | 15,4% | 5,6% |
| PDF OCR | 0% | 0% | 33,3% |
Bảng trên chỉ hiển thị hàng web, mã, tác tử và PDF. Thẻ mô hình cũng liệt kê dữ liệu hướng dẫn và lập luận tiếng Anh và tiếng Đức, tài liệu STEM, QA, và dữ liệu pháp lý cùng khu vực công chuyên biệt. Tính tất cả các hàng tiếng Anh và tiếng Đức, thẻ mô hình tóm tắt phối trộn tiền huấn luyện khoảng 62,5% tiếng Anh, 23,9% tiếng Đức và 13,6% mã nguồn.
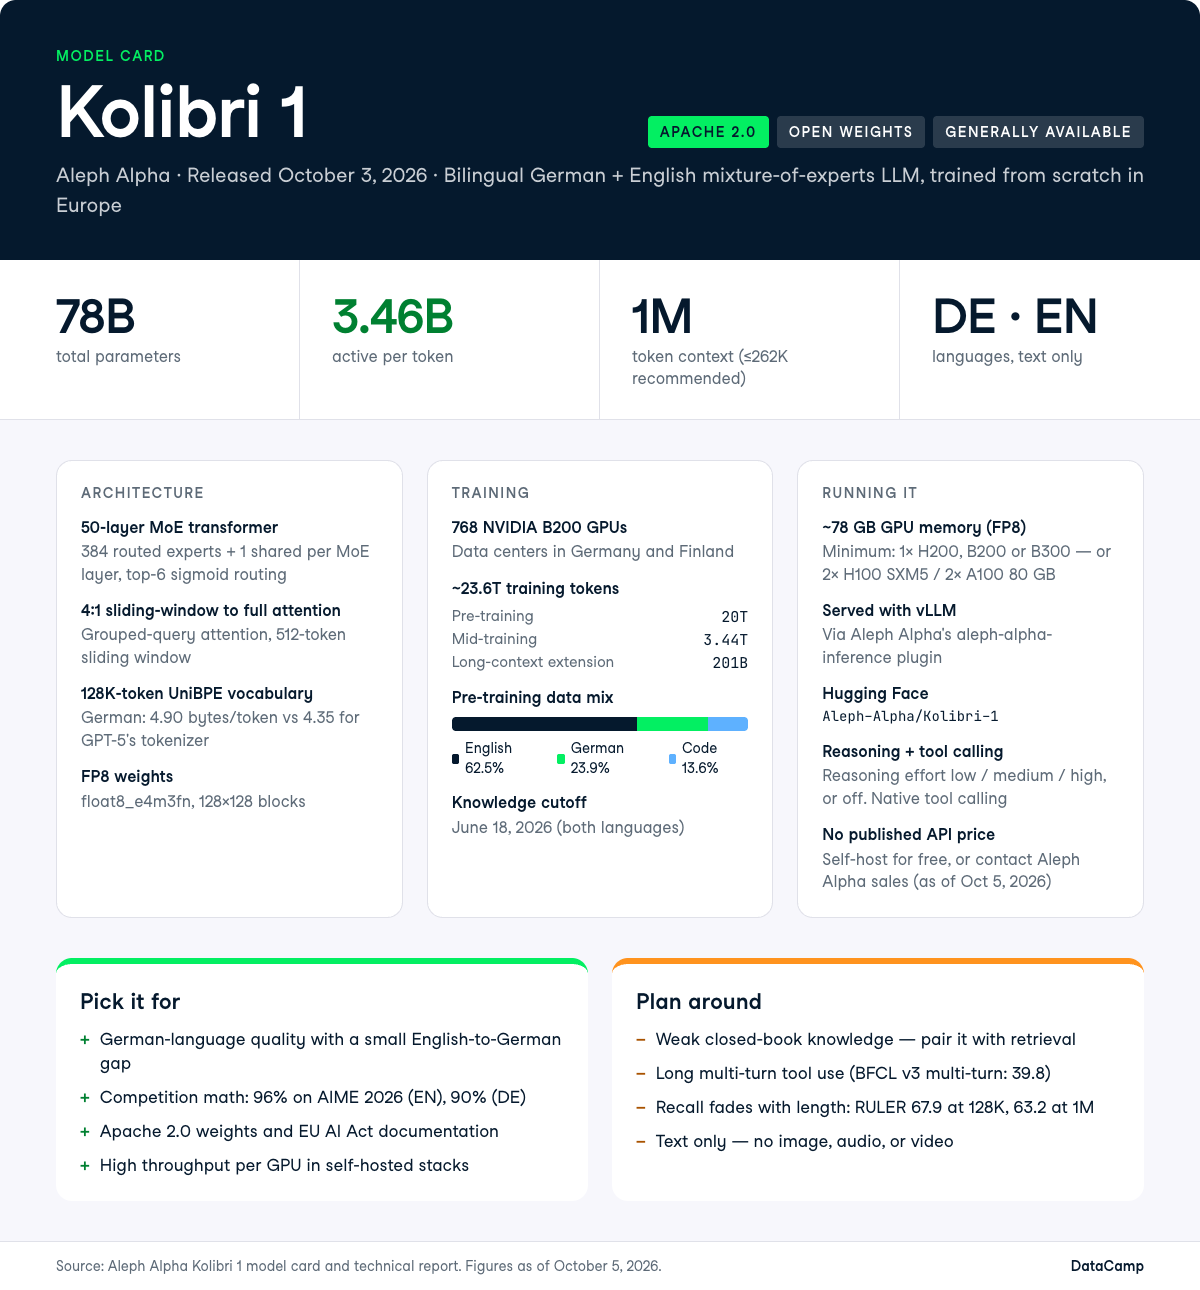
Phần lớn khác biệt của Kolibri 1 xuất phát từ hai quyết định: huấn luyện tiếng Đức đúng nghĩa thay vì dịch lại, và giữ số tham số hoạt động đủ thấp để một H200 đơn lẻ có thể phục vụ.
Kolibri 1 thu hẹp khoảng cách giữa tiếng Đức và tiếng Anh nhiều hơn bạn trông đợi, điều hiếm thấy với một mô hình trọng số mở cỡ này.
Điểm trung bình điểm chuẩn tổng thể là 75,5 ở tiếng Anh và 70,8 ở tiếng Đức.
Aleph Alpha huấn luyện một bộ từ vựng 128.000 token với thuật toán tokenizer mới tên UniBPE, giữ cách gộp tham lam từ dưới lên của byte-pair encoding nhưng dùng mục tiêu Unigram để chọn phép gộp đưa vào từ vựng.
Kết quả tuyên bố là nén tiếng Đức đạt 4,90 byte/token, so với 4,35 của tokenizer GPT-5, còn tiếng Anh giữ ở 4,58 byte/token (tokenizer GPT-5 đạt 4,67).
Điều này quan trọng cho chi phí cũng như chất lượng.
Nén tốt hơn nghĩa là ít token hơn cho cùng một tài liệu tiếng Đức, vì vậy một Bescheid 50 trang (một thông báo hành chính chính thức của Đức) tốn ít chi phí xử lý hơn và chừa nhiều chỗ hơn trong ngữ cảnh.
Tiếng Đức chiếm 23,4% phối trộn tiền huấn luyện so với 43,4% cho web và tài liệu tiếng Anh, nên năng lực này được trả bằng dữ liệu, không phải tinh chỉnh gắn thêm sau khi chạy huấn luyện chính.
Mô hình quảng bá 1.048.576 token. Nó xử lý nguyên bản 262.144 token sau một giai đoạn huấn luyện ngữ cảnh dài 201B token, và kéo giãn lên 1M bằng ngoại suy, nghĩa là chưa từng được huấn luyện ở độ dài đó.
Chính Aleph Alpha khuyến nghị duy trì ở mức 262.144 token hoặc thấp hơn để phục vụ hiệu quả. RULER, bài kiểm tra khả năng mô hình tìm và dùng chi tiết cụ thể bị chôn trong đầu vào rất dài, cho thấy suy giảm ở bản base: 67,9 tại 128K và 63,2 tại 1M, so với kết quả viện dẫn của Qwen3.5 35B-A3B Base là 89,9 tại 128K.
Công bằng mà nói, điểm 1M của Kolibri vẫn vượt Nemotron 3 Nano (58,5) và Qwen3.5 (57,5) ở độ dài đó, nên mức suy giảm ít hơn, dù xuất phát điểm thấp hơn.
Hãy coi con số 1M là trần kỹ thuật có thể chạm tới hơn là ngân sách vận hành thực tế.
Nếu pipeline RAG của bạn nhồi 400K token PDF quét chuyển thành văn bản (OCR) vào prompt và kỳ vọng mô hình tìm chính xác một chi tiết, hãy kiểm thử trước khi triển khai. Đáng chú ý, 33,3% phối trộn mở rộng ngữ cảnh dài là PDF đã OCR, nên tác vụ tài liệu quét rõ ràng là trường hợp sử dụng mục tiêu.
Chế độ lý giải nghĩa là mô hình đi qua bài toán từng bước trước khi trả lời, giúp tăng độ chính xác nhưng dùng nhiều token hơn.
Trong Kolibri 1, đây là một công tắc bạn điều khiển chứ không phải một tầng mô hình riêng, và gọi công cụ (mô hình tự quyết định gọi hàm hay API bên ngoài, như truy vấn cơ sở dữ liệu) là tính năng gốc.
Aleph Alpha liệt kê lý giải nhiều bước, RAG, gọi công cụ tác tử, lập trình, và trợ lý song ngữ là các mục đích sử dụng dự kiến, và ở giữa quá trình huấn luyện đã dành 15,4% cho mã tác tử và sử dụng công cụ, tăng từ gần như bằng 0 ở tiền huấn luyện.
Một báo cáo người dùng mang tính giai thoại, chạy mô hình ở FP8 trên một GPU workstation RTX Pro 6000 đơn lẻ, đo được khoảng 170 token/giây và lưu ý xu hướng tiêu tốn nhiều token để cân nhắc.
Hãy dự trù cho điều đó nếu bạn bật mặc định chế độ lý giải trong một luồng nhạy cảm với độ trễ.
Kolibri 1 được huấn luyện từ đầu, nên không phải tinh chỉnh hay bản sao của mô hình công ty khác.
Điều này quan trọng về giấy phép và về việc biết chính xác những gì đã đưa vào mô hình.
Kết hợp với trọng số theo Apache 2.0, điều đó nghĩa là bạn có thể chạy Kolibri 1 trong môi trường cách ly mạng (hoàn toàn không kết nối internet), tinh chỉnh, và đóng gói trong sản phẩm thương mại mà không cần xin phép ai.
Đạo luật AI của EU và Bộ Quy tắc Thực hành GPAI đặt ra quy định của EU cho các mô hình mục đích chung, bao gồm tài liệu về dữ liệu huấn luyện.
Aleph Alpha là bên ký kết Bộ Quy tắc và công bố thẻ mô hình chi tiết bao gồm nguồn dữ liệu huấn luyện, bước khử nhiễm (loại bỏ câu hỏi điểm chuẩn khỏi dữ liệu huấn luyện), và đầu mối liên hệ cho chủ sở hữu quyền, đây là tài liệu mà một cuộc rà soát tuân thủ Đạo luật AI của EU sẽ yêu cầu.
Đối với khách hàng khu vực công ở Đức và EU rộng hơn, giấy tờ này thường là yếu tố quyết định thay vì chênh lệch điểm chuẩn.
Đây cũng là phần mà các phòng thí nghiệm Mỹ không thể sao chép nhanh.
Thẻ mô hình của Aleph Alpha liệt kê cởi mở các hạn chế, đáng để đọc trước khi mua sắm:
Với mọi triển khai rủi ro cao, Aleph Alpha nêu rõ cần bổ sung hàng rào bảo vệ và tuân thủ Quy định (EU) 2024/1689.
Hồ sơ điểm chuẩn của Kolibri 1 lệch nhưng hữu ích: dẫn đầu tập so sánh công bố ở toán thi đấu và lập luận tiếng Đức, và thua Qwen3.6 35B-A3B ở kiến thức closed-book, MMLU-Pro và đa số bộ công cụ.
Aleph Alpha so sánh với Qwen3.6 35B-A3B, Mistral Small 4 119B-A6B, và Nemotron 3 Super 120B-A12B.
Thẻ mô hình cũng liệt kê Qwen3.8 27B, một mô hình đặc dày (dense, dùng tất cả tham số cho mỗi token, không như MoE) có điểm cao hơn trên toàn bộ (tiếng Đức tổng thể 79,9 so với 70,8 của Kolibri) với số tham số hoạt động gấp khoảng tám lần.
Tôi đã bỏ mô hình đó khỏi các bảng dưới đây, nhưng hãy ghi nhớ khi đọc các tuyên bố về hiệu suất.
Trong các tên mô hình đó, con số sau chữ "A" là tham số hoạt động mỗi token, nên 35B-A3B nghĩa là tổng 35B và 3B hoạt động. Dưới đây là ý nghĩa các điểm chuẩn trong bảng:
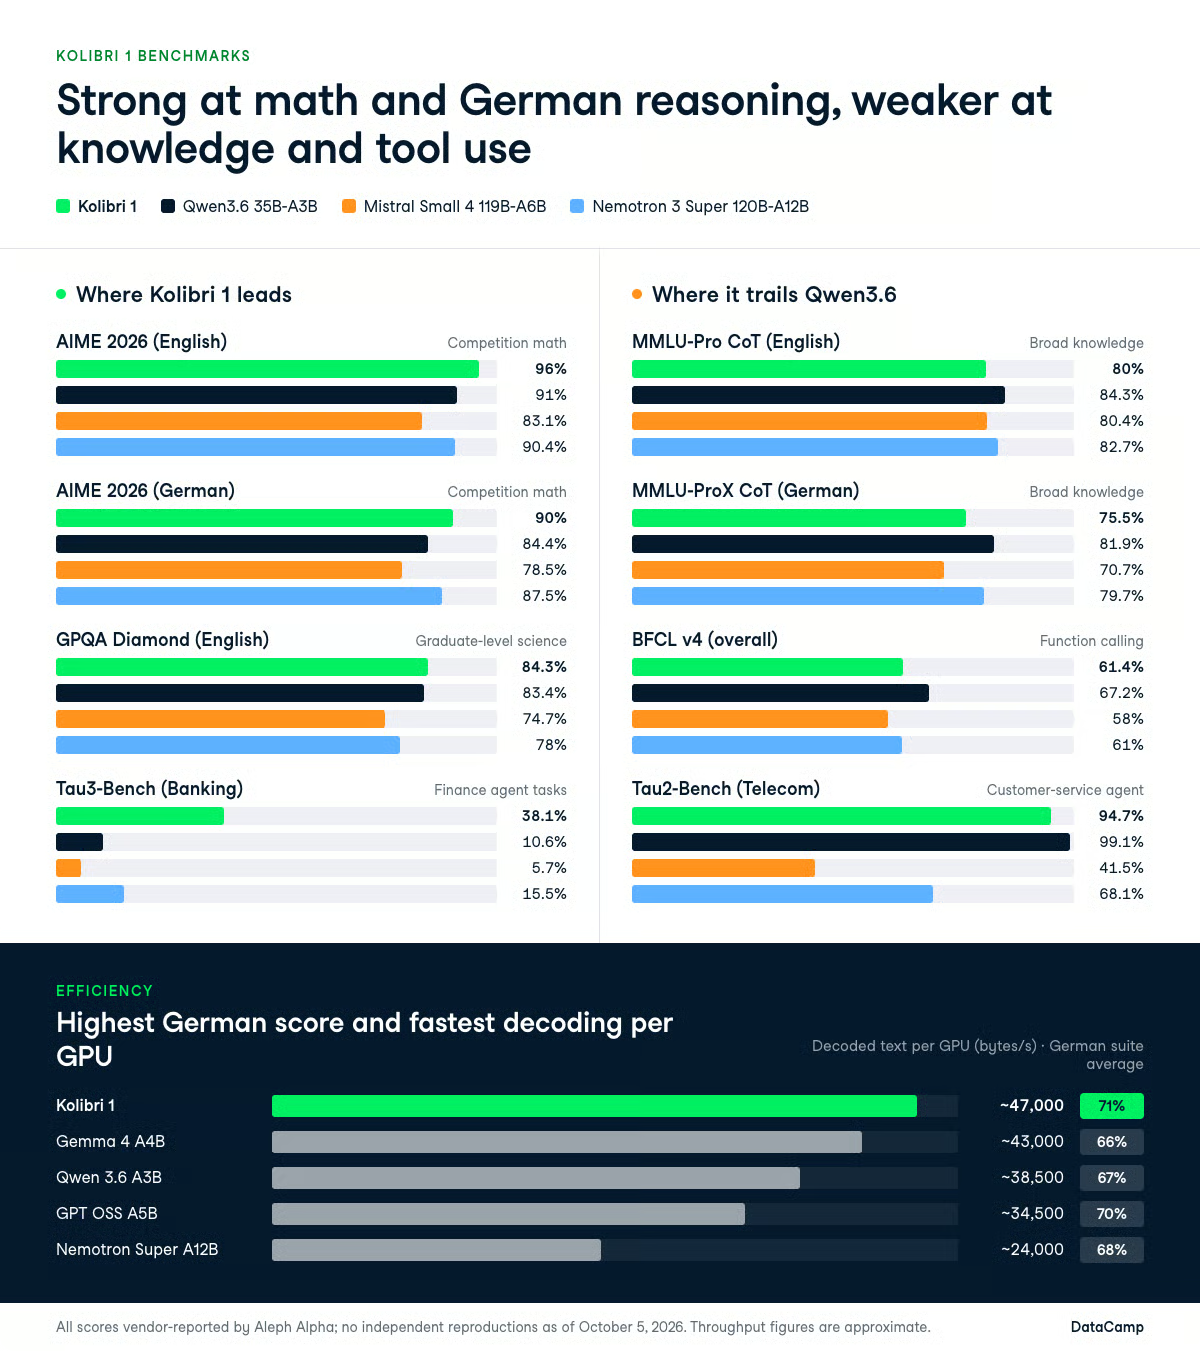
Toán là nơi Kolibri 1 vượt trội rõ rệt.
Mô hình đạt 96% trên AIME 2026 (EN) so với 91% của Qwen3.6 35B-A3B, 90,4% của Nemotron 3 Super, và 83,1% của Mistral Small 4; và 96,9% trên AIME 2025 (EN) so với 84,6% của Qwen3.6.
Trên GPQA Diamond (EN) mô hình đạt 84,3% so với 83,4%, và trên Humanity's Last Exam (EN) 21,5% so với 21,1%, đều đủ sát để coi như hòa.
Điểm yếu trong cùng bảng là kiến thức.
AA-Omniscience Index (bộ công khai) chấm theo thang mà số âm là phổ biến và cao hơn là tốt hơn. Kolibri 1 đạt -32,8 so với -12,5 của Qwen3.6 và -24,0 của Mistral Small 4, dù nhỉnh hơn -36,5 của Nemotron 3 Super. Một con số độ chính xác AA-Omniscience riêng biệt là 14,8%, thấp nhất trong bốn mô hình.
Tỷ lệ không ảo giác trên cùng benchmark là 44,0% khả quan hơn, vượt Nemotron (13,9%) và Mistral (34,7%) nhưng kém Qwen3.6 (56,7%), phù hợp với huấn luyện "abstention" của Aleph Alpha.
Một mô hình 3,46B tham số hoạt động có ít chỗ để ghi nhớ sự kiện, nên hãy ghép với truy xuất (retrieval) thay vì tin vào nhớ lại dạng đóng.
| Benchmark (EN) | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| AIME 2026 | 96% | 91% | 83,1% | 90,4% |
| AIME 2025 | 96,9% | 84,6% | 79,8% | 91,7% |
| GPQA Diamond | 84,3% | 83,4% | 74,7% | 78% |
| Humanity's Last Exam | 21,5% | 21,1% | 9,7% | 20,6% |
| MMLU-Pro CoT | 80% | 84,3% | 80,4% | 82,7% |
| AA-Omniscience Index (cao hơn là tốt hơn) | -32,8 | -12,5 | -24,0 | -36,5 |
Kolibri 1 dẫn ở các benchmark toán và khoa học tiếng Đức và thua ở các bài kiến thức tiếng Đức, cùng hình dạng với hồ sơ tiếng Anh của nó.
Mô hình đạt 90% trên AIME 2026 (DE) so với 84,4% của Qwen3.6, và 81,3% trên GPQA Diamond (DE) so với 80,6%. Trên MMLU-ProX CoT (DE) mô hình giảm xuống 75,5% trong khi Qwen3.6 đạt 81,9% và Nemotron 3 Super 79,7%, và trên Humanity's Last Exam (DE) đạt 15,9% so với 22,3% của Nemotron.
Điều tôi thấy thực sự thú vị là khoảng cách Anh–Đức nhỏ.
Kolibri mất 6 điểm khi chuyển AIME 2026 từ tiếng Anh sang tiếng Đức và 3 điểm trên GPQA Diamond, mức sụt hẹp hơn kỳ vọng ở một mô hình coi tiếng Đức như đích dịch thuật.
| Benchmark (DE) | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| AIME 2026 | 90% | 84,4% | 78,5% | 87,5% |
| AIME 2025 | 87,5% | 82,9% | 72,3% | 85,6% |
| GPQA Diamond | 81,3% | 80,6% | 72,9% | 76,6% |
| MMLU-ProX CoT | 75,5% | 81,9% | 70,7% | 79,7% |
| Humanity's Last Exam | 15,9% | 20,5% | 10,5% | 22,3% |
Đây là phần yếu nhất của bản phát hành.
Trên BFCL v4 tổng thể, Kolibri 1 đạt 61,4% so với 67,2% của Qwen3.6, và trên Tau2-Bench (Telecom) đạt 94,7% so với 99,1% của Qwen3.6. Mô hình lại nhỉnh hơn Qwen3.6 trên Tau2-Bench (Airline), 76,7% so với 70,7%.
Một con số đa lượt BFCL v3 báo cáo riêng là 39,8 điểm (Qwen3.6 đạt 53,5) cho thấy cùng điểm yếu: các lần gọi công cụ đơn lẻ thì ổn, hội thoại dài với nhiều vòng gọi đi gọi về thì không.
Điểm ngoại lệ theo chiều ngược lại.
Trên Tau3-Bench (Banking), Kolibri 1 đạt 38,1% trong khi Qwen3.6 được 10,6%, Nemotron 3 Super 15,5%, và Mistral Small 4 chỉ 5,7%. Đó là biên độ khoảng 2,5 lần so với mô hình tốt thứ hai trong tập so sánh này (3,6 lần so với Qwen3.6) trên một benchmark tác tử mang màu sắc tài chính, và đây là kết quả duy nhất trong bản phát hành mà tôi muốn được tái lập độc lập nhất.
| Benchmark | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| Tau2-Bench (Telecom) | 94,7% | 99,1% | 41,5% | 68,1% |
| Tau2-Bench (Retail) | 69,9% | 71,6% | 62,9% | 67,5% |
| Tau2-Bench (Airline) | 76,7% | 70,7% | 40% | 72,7% |
| Tau3-Bench (Banking) | 38,1% | 10,6% | 5,7% | 15,5% |
| BFCL v4 (tổng thể) | 61,4% | 67,2% | 58% | 61% |
Kết quả lập trình được báo cáo là 85,9 trên LiveCodeBench v6, 66,4 trên SWE-bench Verified, và 27,7 trên Terminal-Bench 2.1.
Sinh mã thô có vẻ mạnh, kỹ nghệ phần mềm theo kiểu tác tử ở mức bình thường, và con số Terminal-Bench cho thấy công việc terminal nhiều bước dài không phải sở trường của mô hình này.
Có một lưu ý về nhiễm bẩn dữ liệu bạn nên đọc trước khi trích dẫn.
Báo cáo kỹ thuật cho biết 48% dữ liệu đánh giá HumanEval tiếng Anh và 47% tiếng Đức xuất hiện trong tài liệu liên quan huấn luyện, làm thổi phồng các điểm kiểu HumanEval.
Một số bộ trong các bảng so sánh là độc quyền hoặc do nhà cung cấp tạo, khiến toàn bộ tập khó kiểm toán, và tại thời điểm viết bài chưa có so sánh đã xác minh, tương đương từng mục với các đầu bảng hiện tại của Claude, GPT, hay Gemini.
Tuyên bố về hiệu năng là yếu tố ít bị ảnh hưởng nhất bởi lưu ý về báo cáo từ nhà cung cấp, vì đó là thuộc tính của kiến trúc chứ không phải một điểm số.
Ở đây, thông lượng nghĩa là lượng văn bản mô hình có thể tạo ra trên mỗi GPU mỗi giây. Aleph Alpha đo theo byte thay vì token, nên có thể so sánh công bằng giữa các mô hình dùng tokenizer khác nhau.
Kolibri 1 đạt trung bình 71% trên bộ benchmark tiếng Đức của Aleph Alpha trong khi giải mã khoảng 47.000 byte/giây mỗi GPU. GPT OSS A5B đạt 70% khoảng 34.500 byte/giây, Qwen 3.6 A3B 67% khoảng 38.500, Gemma 4 A4B 66% khoảng 43.000, và Nemotron Super A12B 68% khoảng 24.000.
Việc phục vụ lượng văn bản giải mã xấp xỉ gấp đôi trên mỗi GPU so với mô hình Nemotron trong khi điểm trung bình tiếng Đức cao hơn là luận điểm thực tế để chọn Kolibri trong một stack tự lưu trữ.
Nếu bạn trả tiền cho GPU của chính mình thay vì trả theo token, thông lượng trên mỗi GPU là con số xuất hiện trên hóa đơn.
Không có giá theo token được công bố cho Kolibri 1.
Aleph Alpha chưa phát hành bảng giá API lưu trữ, và chưa có ID mô hình API Kolibri được xác nhận trong tài liệu API chính thức tính đến ngày 5 tháng 10, 2026.
Triển khai cho doanh nghiệp thông qua đội ngũ bán hàng của Aleph Alpha, và định danh kho Aleph-Alpha/Kolibri-1 không nên được coi là ID mô hình API.
Bản trọng số bản thân được miễn phí theo Apache 2.0, nên chi phí của bạn là thời gian GPU.
Dấu chân bộ nhớ FP8 khoảng 78 GB, với cấu hình tối thiểu là 2x A100 80 GB, 2x H100 SXM5, 1x H200, 1x B200, hoặc 1x B300, và cấu hình khuyến nghị là 2x H100 SXM5, 2x H200, 1x B200, hoặc 1x B300. Mô hình sẵn sàng chung, không phải bản xem trước, không có danh sách chờ hay khóa vùng.
Để hình dung bạn đang so sánh với gì, bài viết về GPT-6.1 Sol của chúng tôi định giá mô hình đó ở mức $2 đầu vào / $10 đầu ra cho mỗi triệu token. Một tổng hợp giá của bên thứ ba liệt kê GPT-5.6 Sol cũ hơn ở $5 / $30 và GPT-5.6 Luna ở $0,20 / $1,20 sau đợt giảm giá ngày 30 tháng 7 của OpenAI.
Tự lưu trữ chỉ thắng về đơn giá khi sản lượng của bạn vượt qua chi phí cố định của một B200.
Kolibri 1 là open-weight theo Apache 2.0, cho phép sử dụng thương mại, sửa đổi và phân phối lại không có ngưỡng người dùng hay doanh thu.
Các trọng số nằm tại Aleph-Alpha/Kolibri-1 trên Hugging Face ở dạng float8_e4m3fn. Thẻ mô hình ghi tài liệu phục vụ qua vLLM, dùng plugin aleph-alpha-inference của Aleph Alpha. Bản dựng GGUF và MLX từ cộng đồng xuất hiện trong vài ngày, nhưng Aleph Alpha chưa xác nhận chúng, và tôi không tìm thấy mục Ollama chính thức.
Với triển khai phục vụ, 1x H200 hoặc 1x B200 chứa ~78 GB trọng số FP8 trên một card. Dùng --tensor-parallel-size 2 trên H100.
Giữ --max-model-len ở hoặc dưới 262.144 trừ khi bạn đã kiểm thử cụ thể ngữ cảnh dài hơn. Vượt quá mức đó cần cờ --hf-overrides bổ sung, được nêu trong thẻ mô hình.
Cài plugin và khởi động máy chủ:
pip install 'aleph-alpha-inference>=1'

# Add --tensor-parallel-size 2 on 2x H100
vllm serve Aleph-Alpha/Kolibri-1 \
  --kv-cache-dtype fp8 \
  --max-model-len 262144 \
  --reasoning-parser kolibri1 \
  --tool-call-parser kolibri1 \
  --enable-auto-tool-choice
Sau đó truy vấn qua API tương thích OpenAI, dùng tham số sampling Aleph Alpha khuyến nghị (temperature 1.0, top_p 0,97, top_k 128):
from openai import OpenAI

client = OpenAI(base_url="http://localhost:8000/v1", api_key="EMPTY")

response = client.chat.completions.create(
    model="Aleph-Alpha/Kolibri-1",
    messages=[{
        "role": "user",
        "content": "Fasse die wichtigsten Fristen aus diesem Bescheid in drei Punkten zusammen.",
    }],
    temperature=1.0,
    top_p=0.97,
    max_tokens=512,
    extra_body={
        "top_k": 128,
        "chat_template_kwargs": {"reasoning_effort": "medium"},
    },
)
print(response.choices[0].message.content)
Reasoning effort chấp nhận low, medium và high, và bạn có thể tắt hoàn toàn phần tư duy nếu độ trễ quan trọng hơn chiều sâu.
Kết quả sẽ thay đổi theo tham số sampling, và thẻ mô hình lưu ý rằng chúng có thể lệch nhẹ ngay cả khi tắt sampling.
Để thiết lập sâu hơn cho suy luận tự lưu trữ và vòng lặp tác tử, hướng dẫn API về xây dựng tác tử di trú của chúng tôi bao quát các mẫu cấp quyền công cụ và điều hướng có thể chuyển giao trực tiếp.
Kolibri 1 về danh nghĩa là một "AI có chủ quyền", nghĩa là một quốc gia hoặc tổ chức có thể vận hành, kiểm toán và kiểm soát AI trên hạ tầng của riêng mình và theo thẩm quyền pháp lý của mình, không phụ thuộc vào API, giá hay điều khoản dịch vụ của nhà cung cấp nước ngoài. Với Kolibri 1, lập luận đó dựa trên trọng số Apache 2.0 bạn có thể chạy trong môi trường cách ly (không nối mạng), hạ tầng huấn luyện đặt tại châu Âu, và tài liệu tuân thủ Đạo luật AI của EU.
Tuy nhiên, có hai bối cảnh doanh nghiệp đứng sau lần ra mắt này.
Aleph Alpha đã ký thỏa thuận sáp nhập ràng buộc với công ty Canada Cohere để hình thành cái mà họ mô tả là giải pháp AI có chủ quyền xuyên Đại Tây Dương đầu tiên.
Công ty hợp nhất sẽ hoạt động dưới tên Cohere, với hai trụ sở tại Toronto và Berlin, và Heidelberg tiếp tục là trung tâm nghiên cứu. Thỏa thuận vẫn cần sự phê duyệt của cơ quan quản lý.
Một đề xuất về chủ quyền phụ thuộc vào việc chủ sở hữu mô hình tiếp tục hỗ trợ nó, và thương hiệu Aleph Alpha dự kiến sẽ sát nhập vào Cohere khi thương vụ hoàn tất, nên cả hai điểm này đều đáng theo dõi song song với các benchmark.
Aleph Alpha đặt cược rằng chủ quyền, giấy phép Apache 2.0 và tài liệu tuân thủ Đạo luật AI của EU quan trọng hơn với các khách hàng khu vực công châu Âu so với vài điểm trên MMLU-Pro.
Canh bạc đó có vẻ hợp lý, và việc công ty sáp nhập với Cohere cho thấy họ hiểu rằng không thể thắng chỉ bằng quy mô.
Tôi cho rằng có thể nói công bằng rằng Kolibri 1 là mô hình open-weight tiếng Đức tốt nhất ở kích thước tham số hoạt động này mà chúng ta từng thấy được ghi chép kỹ như vậy, nhưng không phải là mô hình tôi sẽ chọn nếu cần các lần chạy tác tử nhiều lượt dài hoặc nhớ lại sự kiện dạng đóng.
Trong số các mô hình MoE tham số hoạt động nhỏ tương đương, Qwen3.6 35B-A3B vẫn thắng ở mặt đó. Nếu bạn kham nổi mô hình dense 27B, Qwen3.8 27B thắng dứt điểm.
Nếu bạn muốn cập nhật nhanh về vận hành và đánh giá các mô hình như thế này, hãy bắt đầu với lộ trình kỹ năng AI Fundamentals của chúng tôi.
Các khóa học hàng đầu trên DataCamp
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
