Kurs
Kodowanie wspomagane przez AI dla programistów
1 godz. 30 min
10.5K
Minęło sporo czasu, odkąd nowa firma dołączyła do wyścigu LLM. Ale 3 października Aleph Alpha udostępniło swój nowy model Kolibri 1 na Hugging Face na licencji Apache 2.0 i poprosiło Europę, by poważnie potraktowała suwerenną AI.
Założenie jest takie, że europejskie rządy i firmy mogą uruchamiać wydajny model na własnym sprzęcie, nawet całkowicie offline, zamiast polegać na API amerykańskiego dostawcy.
Kolibri 1 to model mixture-of-experts (MoE) z 78 mld łącznych parametrów i 3,46 mld aktywnych na token, wytrenowany od zera przez Aleph Alpha Research na 768 GPU NVIDIA B200 w centrach danych w Niemczech i Finlandii.
Obsługuje wyłącznie język niemiecki i angielski, ma okno kontekstu 1 048 576 tokenów (Aleph Alpha zaleca pozostanie przy 262 144 tokenach lub mniej ze względów wydajnościowych) i jest udostępniony jako ogólnie dostępny, a nie w wersji zapoznawczej. Pre-trening objął 20 bilionów tokenów, następnie 3,44 bln w trakcie mid-treningu i 201 mld na rozszerzenie długiego kontekstu.
W tym artykule omawiam wszystko, co nowe w Kolibri 1: kluczowe funkcje, benchmarki i realne koszty uruchomienia.
Kolibri 1 to wyspecjalizowany dwujęzyczny duży model językowy (LLM) Aleph Alpha, wydany 3 października 2026 r. na licencji Apache 2.0. To pojedynczy, ogólnie dostępny model, bez mniejszych ani większych wariantów.
Pod spodem to 50-warstwowy transformer mixture-of-experts.
Każda warstwa zawiera 384 małe, wyspecjalizowane podsieci zwane ekspertami, a router kieruje każdy token tylko do 6 z nich, plus 1 współdzielonego eksperta, który działa zawsze. Dzięki temu 78,1 mld łącznych parametrów sprowadza się do 3,46 mld aktywnych na token (około 4,4%), więc model jest zbudowany pod tani serving, a nie maksymalną pojemność.
Dwie kolejne decyzje projektowe utrzymują szybkość i niskie zużycie pamięci:
Główne przesłanie Aleph Alpha to efektywność, a nie surowa moc.
Kolibri 1 osiąga średnio 71% na niemieckim zestawie benchmarków, dekodując około 47 000 bajtów/s tekstu na GPU, wobec 68% przy około 24 000 bajtów/s dla Nemotron Super A12B.
Model ma cutoff wiedzy na 18 czerwca 2026 r. dla obu języków i obsługuje wyłącznie tekst, bez wejścia ani wyjścia obrazu, dźwięku czy wideo.
Jeśli chcesz zobaczyć, skąd faktycznie bierze się niemiecka kompetencja, publikowany miks danych jest wyjątkowo przejrzysty jak na wydanie open-weight.
| Domena | Pre-trening | Mid-trening | Rozszerzenie długiego kontekstu |
|---|---|---|---|
| Angielska sieć i dokumenty | 43,4% | 1,3% | 15,8% |
| Niemiecka sieć i dokumenty | 23,4% | 2,1% | 2,6% |
| Kod | 13,6% | 16,3% | 13,2% |
| Kod agentowy i użycie narzędzi | ~0% | 15,4% | 5,6% |
| PDF-y po OCR | 0% | 0% | 33,3% |
Tabela pokazuje tylko wiersze dotyczące sieci, kodu, komponentów agentowych i PDF-ów. Karta modelu uwzględnia też dane instruktażowe i rozumowanie po angielsku i niemiecku, dokumenty STEM, QA oraz wyspecjalizowane dane prawne i sektora publicznego. Licząc wszystkie wiersze angielskie i niemieckie, karta modelu streszcza miks pre-treningowy jako około 62,5% angielskiego, 23,9% niemieckiego i 13,6% kodu.
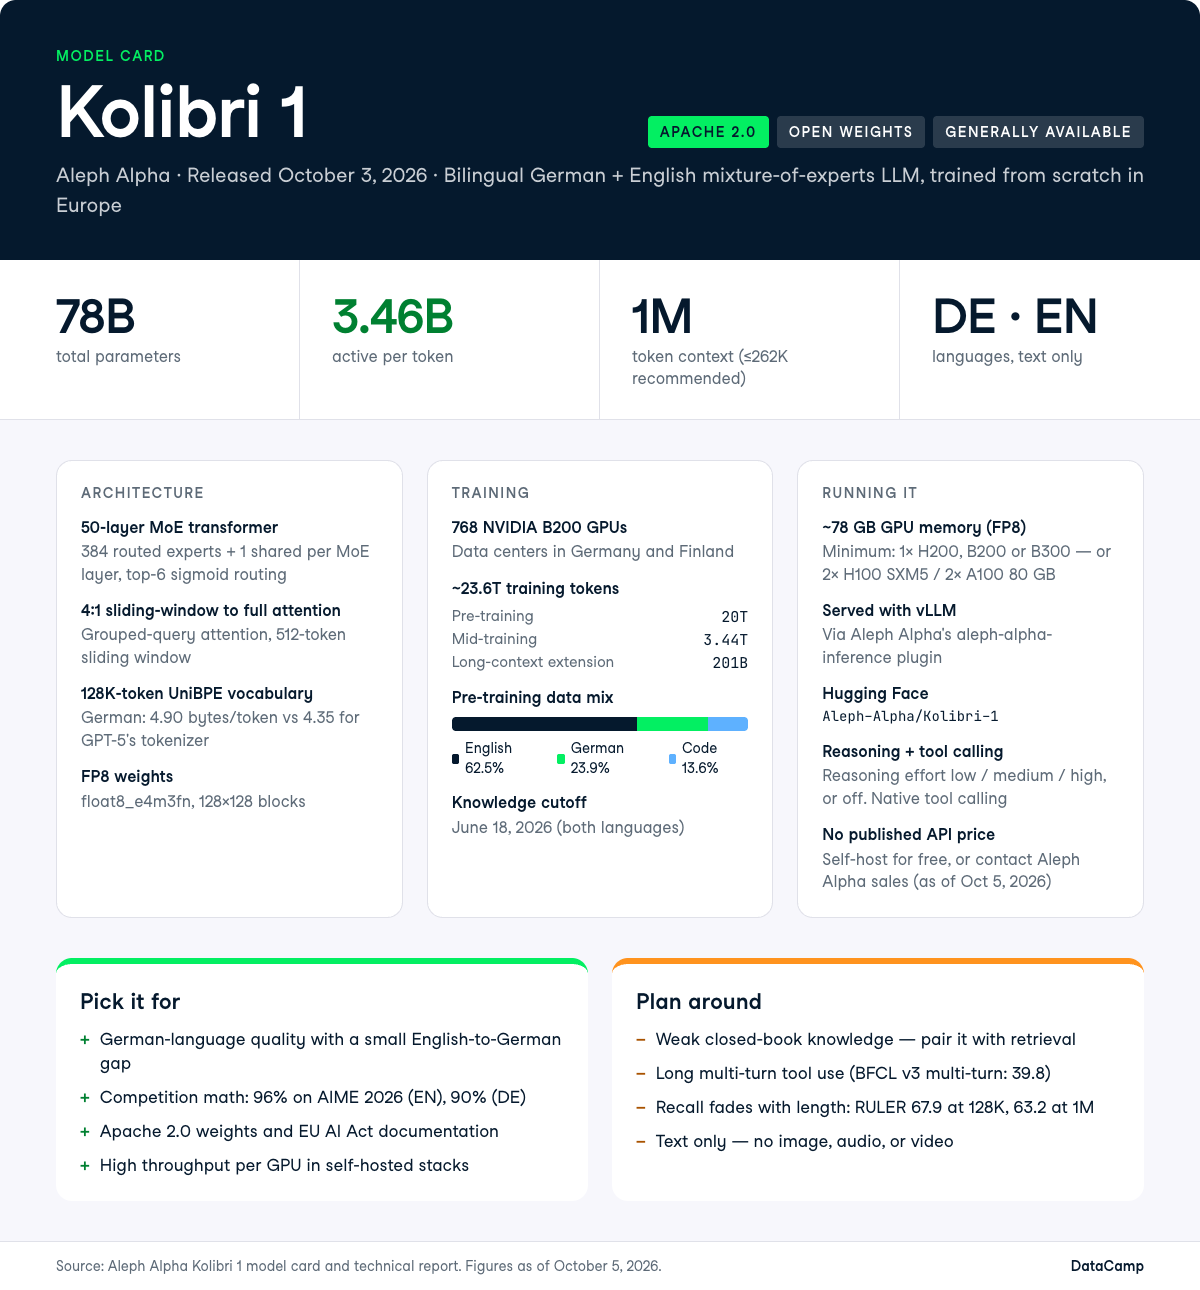
Większość wyróżników Kolibri 1 sprowadza się do dwóch decyzji: porządnie wytrenować stronę niemiecką zamiast ją tłumaczyć oraz utrzymać liczbę aktywnych parametrów na tyle niską, by pojedyncza H200 mogła go serwować.
Kolibri 1 bardziej niż można by się spodziewać zmniejsza różnicę między niemieckim a angielskim, co jest nietypowe dla open-weight tej wielkości.
Średnia na benchmarkach to 75,5 po angielsku i 70,8 po niemiecku.
Aleph Alpha wytrenowało słownik 128 000 tokenów z nowym algorytmem tokenizacji o nazwie UniBPE, który zachowuje zachłanne, oddolne łączenia byte-pair encoding, ale używa celu Unigram do wyboru, które łączenie trafia do słownika.
Podawany efekt to kompresja po niemiecku na poziomie 4,90 bajta/token wobec 4,35 dla tokenizera GPT-5, przy angielskim na poziomie 4,58 bajta/token (tokenizer GPT-5 uzyskuje 4,67).
To ma znaczenie tak samo dla kosztu, jak i jakości.
Lepsza kompresja oznacza mniej tokenów dla tego samego niemieckiego dokumentu, więc 50-stronicowy Bescheid (oficjalne niemieckie pismo administracyjne) kosztuje mniej w przetwarzaniu i zostawia więcej miejsca w kontekście.
Niemiecki stanowił 23,4% miksu pre-treningowego wobec 43,4% dla angielskiej sieci i dokumentów, więc kompetencja jest opłacona danymi, a nie fine-tuningiem doczepionym po głównym treningu.
Model ogłasza 1 048 576 tokenów. Natywnie obsługuje 262 144 tokeny po 201 mld-tokenowym etapie treningu długiego kontekstu i rozciąga się do 1M przez ekstrapolację, czyli nigdy nie był trenowany przy takiej długości.
Samo Aleph Alpha zaleca pozostanie przy 262 144 tokenach lub mniej dla wydajnego serwowania. RULER, test sprawdzający, czy model potrafi znaleźć i wykorzystać konkretne szczegóły ukryte w bardzo długich wejściach, pokazuje degradację dla modelu bazowego: 67,9 przy 128K i 63,2 przy 1M, wobec cytowanego wyniku Qwen3.5 35B-A3B Base na poziomie 89,9 przy 128K.
Uczciwie mówiąc, wynik 1M Kolibri nadal przebija Nemotron 3 Nano (58,5) i Qwen3.5 (57,5) przy tej długości, więc spadek jest mniejszy, choć start z niższego poziomu.
Traktowałbym 1M jako sufit, który technicznie da się osiągnąć, a nie roboczy budżet.
Jeśli twój pipeline retrieval-augmented generation (RAG) pakuje 400K tokenów zeskanowanych PDF-ów przekonwertowanych na tekst (OCR) do promptu i oczekuje, że model niezawodnie znajdzie jeden konkretny szczegół, przetestuj to, zanim się zobowiążesz. Warto zauważyć, że 33,3% miksu na rozszerzenie długiego kontekstu stanowiły PDF-y po OCR, więc obciążenia na zeskanowanych dokumentach są wyraźnie przypadkiem docelowym.
Tryb rozumowania oznacza, że model przechodzi przez problem krok po kroku przed odpowiedzią, co poprawia trafność, ale zużywa więcej tokenów.
W Kolibri 1 to przełącznik, który kontrolujesz, a nie osobny poziom modelu, a wywoływanie narzędzi (decyzja modelu o wywołaniu zewnętrznej funkcji lub API, np. zapytania do bazy danych) jest natywne.
Aleph Alpha wymienia wieloetapowe rozumowanie, RAG, agentowe wywoływanie narzędzi, kodowanie i dwujęzycznego asystenta jako docelowe zastosowania, a miks mid-treningowy przeznaczył 15,4% na kod agentowy i użycie narzędzi, w górę z praktycznie zera podczas pre-treningu.
Jedna anegdotyczna relacja użytkownika, uruchamiającego model w FP8 na pojedynczym GPU RTX Pro 6000 w stacji roboczej, zmierzyła około 170 tokenów na sekundę i zauważyła tendencję do wydawania wielu tokenów na deliberację.
Uwzględnij to w budżecie, jeśli zostawisz rozumowanie włączone domyślnie na ścieżce wrażliwej na opóźnienia.
Kolibri 1 został wytrenowany od zera, więc nie jest fine-tuningiem ani kopią modelu innej firmy.
Ma to znaczenie dla licencjonowania i świadomości, co dokładnie do niego trafiło.
W połączeniu z wagami Apache 2.0 oznacza to, że możesz uruchamiać Kolibri 1 w izolacji (całkowicie odłączony od internetu), dostrajać go i dostarczać wewnątrz komercyjnego produktu bez proszenia kogokolwiek o zgodę.
Unijna ustawa o AI i jej kodeks dobrych praktyk dla GPAI wyznaczają zasady UE dla modeli ogólnego przeznaczenia, w tym dokumentację danych treningowych.
Aleph Alpha podpisało Kodeks i publikuje szczegółową kartę modelu obejmującą źródła danych treningowych, kroki dekonatminacji (usuwanie pytań benchmarkowych z danych treningowych) oraz punkt kontaktowy dla podmiotów praw autorskich — czyli dokumentację, o którą poprosi audyt zgodności z unijną ustawą o AI.
Dla nabywców z sektora publicznego w Niemczech i szerzej w UE to często czynnik decydujący, a nie różnica w benchmarkach.
To też element, którego żadne amerykańskie laboratorium szybko nie skopiuje.
Aleph Alpha otwarcie wymienia ograniczenia w karcie modelu i warto je przeczytać przed zakupem:
W przypadku wdrożeń wysokiego ryzyka Aleph Alpha wskazuje, że wymagane są dodatkowe zabezpieczenia i zgodność z rozporządzeniem (UE) 2024/1689.
Profil benchmarków Kolibri 1 jest nierówny w pożyteczny sposób: prowadzi w swojej grupie porównawczej w konkursowej matematyce i rozumowaniu po niemiecku, a przegrywa z Qwen3.6 35B-A3B w wiedzy bez dostępu do źródeł, MMLU-Pro i większości zestawów do użycia narzędzi.
Aleph Alpha porównuje z Qwen3.6 35B-A3B, Mistral Small 4 119B-A6B i Nemotron 3 Super 120B-A12B.
Karta modelu wymienia też Qwen3.8 27B, model gęsty (taki, który używa wszystkich parametrów dla każdego tokena, w przeciwieństwie do MoE), który osiąga wyższe wyniki we wszystkich kategoriach (łączny niemiecki 79,9 wobec 70,8 Kolibri) przy około ośmiokrotnie większej liczbie aktywnych parametrów.
Pominąłem go w poniższych tabelach, ale miej to w pamięci przy lekturze argumentów o efektywności.
W tych nazwach modeli liczba po "A" to aktywne parametry na token, więc 35B-A3B znaczy 35 mld łącznych i 3 mld aktywnych. Oto co mierzą benchmarki w poniższych tabelach:
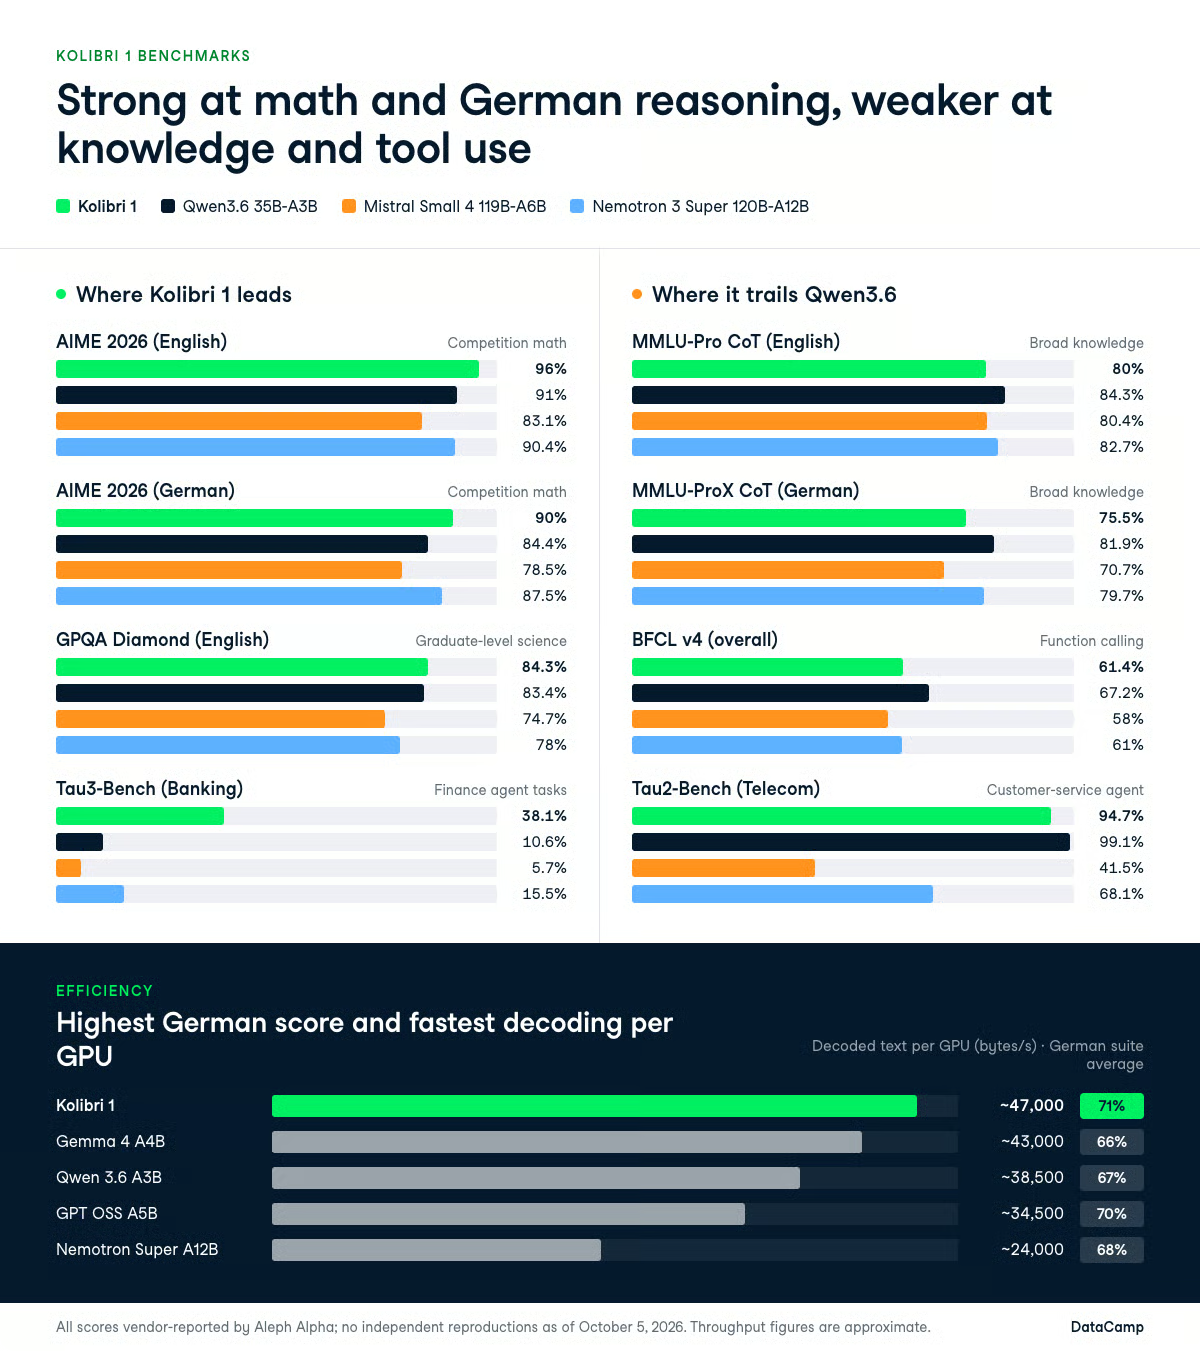
Matematyka to obszar, w którym Kolibri 1 wyraźnie prowadzi.
Uzyskuje 96% na AIME 2026 (EN) wobec 91% dla Qwen3.6 35B-A3B, 90,4% dla Nemotron 3 Super i 83,1% dla Mistral Small 4, oraz 96,9% na AIME 2025 (EN) przy 84,6% Qwen3.6.
Na GPQA Diamond (EN) zdobywa 84,3% wobec 83,4%, a na Humanity's Last Exam (EN) 21,5% wobec 21,1% — wyniki na tyle zbliżone, że można mówić o remisie.
Słaby punkt w tej samej tabeli to wiedza.
AA-Omniscience Index (zestaw publiczny) jest liczony w skali, gdzie wartości ujemne są częste, a wyższy wynik jest lepszy. Kolibri 1 osiąga -32,8 wobec -12,5 dla Qwen3.6 i -24,0 dla Mistral Small 4, choć wyprzedza -36,5 Nemotrona 3 Super. Osobna wartość dokładności AA-Omniscience to 14,8% — najniższy wynik z czterech modeli.
Wskaźnik braku halucynacji na tym samym benchmarku wypada korzystniej: 44,0%, przed Nemotronem (13,9%) i Mistralem (34,7%), lecz za Qwen3.6 (56,7%), co pasuje do treningu wstrzemięźliwości Aleph Alpha.
Model z 3,46 mld aktywnych parametrów ma ograniczone możliwości zapamiętywania faktów, więc lepiej łączyć go z wyszukiwaniem niż ufać pamięci „zamkniętej książki”.
| Benchmark (EN) | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| AIME 2026 | 96% | 91% | 83,1% | 90,4% |
| AIME 2025 | 96,9% | 84,6% | 79,8% | 91,7% |
| GPQA Diamond | 84,3% | 83,4% | 74,7% | 78% |
| Humanity's Last Exam | 21,5% | 21,1% | 9,7% | 20,6% |
| MMLU-Pro CoT | 80% | 84,3% | 80,4% | 82,7% |
| AA-Omniscience Index (im wyżej, tym lepiej) | -32,8 | -12,5 | -24,0 | -36,5 |
Kolibri 1 wygrywa niemieckie benchmarki z matematyki i nauk ścisłych, a przegrywa wiedzę ogólną po niemiecku — podobnie jak w profilu angielskim.
Uzyskuje 90% na AIME 2026 (DE) wobec 84,4% dla Qwen3.6, oraz 81,3% na GPQA Diamond (DE) wobec 80,6%. Na MMLU-ProX CoT (DE) spada do 75,5%, podczas gdy Qwen3.6 sięga 81,9%, a Nemotron 3 Super 79,7%, a na Humanity's Last Exam (DE) osiąga 15,9% wobec 22,3% Nemotrona.
Co naprawdę ciekawe, różnica między angielskim a niemieckim jest niewielka.
Kolibri traci 6 punktów przy przejściu z angielskiego na niemiecki w AIME 2026 i 3 punkty na GPQA Diamond, co jest mniejszym spadkiem, niż można by oczekiwać od modelu, który traktuje niemiecki jak język docelowy tłumaczenia.
| Benchmark (DE) | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| AIME 2026 | 90% | 84,4% | 78,5% | 87,5% |
| AIME 2025 | 87,5% | 82,9% | 72,3% | 85,6% |
| GPQA Diamond | 81,3% | 80,6% | 72,9% | 76,6% |
| MMLU-ProX CoT | 75,5% | 81,9% | 70,7% | 79,7% |
| Humanity's Last Exam | 15,9% | 20,5% | 10,5% | 22,3% |
To najsłabszy element premiery.
W BFCL v4 ogółem Kolibri 1 uzyskuje 61,4% wobec 67,2% dla Qwen3.6, a na Tau2-Bench (Telecom) ma 94,7% wobec 99,1% Qwen3.6. Wyprzedza za to Qwen3.6 na Tau2-Bench (Airline), 76,7% do 70,7%.
Oddzielnie raportowana wartość BFCL v3 dla wielu tur to 39,8 punktu (53,5 dla Qwen3.6), pokazując tę samą słabość: pojedyncze wywołania narzędzi działają dobrze, długie rozmowy z wielokrotnymi rundami narzędzi — już nie.
Wynik odstający działa w drugą stronę.
Na Tau3-Bench (Banking) Kolibri 1 uzyskuje 38,1%, podczas gdy Qwen3.6 10,6%, Nemotron 3 Super 15,5%, a Mistral Small 4 zaledwie 5,7%. To około 2,5x przewagi nad kolejnym najlepszym modelem w tym zestawie porównawczym (3,6x nad Qwen3.6) na finansowym benchmarku agentowym i to jedyny wynik z tej premiery, który najchętniej zobaczyłbym niezależnie odtworzony.
| Benchmark | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| Tau2-Bench (Telecom) | 94,7% | 99,1% | 41,5% | 68,1% |
| Tau2-Bench (Retail) | 69,9% | 71,6% | 62,9% | 67,5% |
| Tau2-Bench (Airline) | 76,7% | 70,7% | 40% | 72,7% |
| Tau3-Bench (Banking) | 38,1% | 10,6% | 5,7% | 15,5% |
| BFCL v4 (ogółem) | 61,4% | 67,2% | 58% | 61% |
Raportowane wyniki w kodowaniu to 85,9 na LiveCodeBench v6, 66,4 na SWE-bench Verified i 27,7 na Terminal-Bench 2.1.
Generowanie surowego kodu wygląda mocno, agentowa inżynieria oprogramowania — przeciętnie, a wynik w Terminal-Bench mówi, że długie, wieloetapowe zadania w terminalu nie są domeną tego modelu.
Jest jednak zastrzeżenie o możliwym „skażeniu” danych, które warto przeczytać przed cytowaniem czegokolwiek.
Raport techniczny odnotowuje, że 48% angielskich i 47% niemieckich danych oceny HumanEval pojawiło się w materiałach powiązanych z treningiem, co zawyża wyniki w stylu HumanEval.
Wiele zestawów w tabelach porównań jest zastrzeżonych lub stworzonych przez dostawców, co utrudnia pełny audyt, a zweryfikowanego porównania 1:1 z aktualnymi flagowcami Claude, GPT czy Gemini nie było w momencie pisania.
Twierdzenie o efektywności najlepiej przechodzi przez sito zastrzeżeń co do raportów dostawcy, bo to cecha architektury, a nie wyniku.
Przepustowość oznacza tu, ile tekstu model może wygenerować na GPU na sekundę. Aleph Alpha mierzy ją w bajtach, a nie tokenach, więc można uczciwie porównywać modele z różnymi tokenizatorami.
Kolibri 1 ma średnio 71% na niemieckim zestawie benchmarków Aleph Alpha, dekodując około 47 000 bajtów/s na GPU. GPT OSS A5B osiąga 70% przy około 34 500 bajtów/s, Qwen 3.6 A3B 67% przy około 38 500, Gemma 4 A4B 66% przy około 43 000, a Nemotron Super A12B 68% przy około 24 000.
Serwowanie mniej więcej 2x więcej zdekodowanego tekstu na GPU niż model Nemotron przy wyższej średniej po niemiecku to praktyczny argument za wyborem Kolibri w samodzielnie hostowanym stosie.
Jeśli płacisz za własne GPU, a nie za tokeny, przepustowość na GPU to liczba, która trafia na fakturę.
Nie ma opublikowanej ceny za token dla Kolibri 1.
Aleph Alpha nie udostępniło cennika hostowanego API, a w oficjalnej dokumentacji API na 5 października 2026 r. nie było potwierdzonego ID modelu API Kolibri.
Wdrożenia korporacyjne obsługuje zespół sprzedaży Aleph Alpha, a identyfikator repozytorium Aleph-Alpha/Kolibri-1 nie powinien być traktowany jako ID modelu API.
Same wagi są bezpłatne na licencji Apache 2.0, więc koszt to czas GPU.
Ślad pamięci FP8 to około 78 GB, z deklarowanym minimum 2x A100 80 GB, 2x H100 SXM5, 1x H200, 1x B200 lub 1x B300 oraz rekomendowaną konfiguracją 2x H100 SXM5, 2x H200, 1x B200 lub 1x B300. Model jest ogólnie dostępny, to nie jest podgląd — bez listy oczekujących i blokad regionalnych.
Dla porównania, nasze omówienie GPT-6.1 Sol podaje cenę 2 USD za wejście / 10 USD za wyjście za milion tokenów. Zewnętrzne zestawienie cen wymienia starszy GPT-5.6 Sol po 5 USD / 30 USD i GPT-5.6 Luna po 0,20 USD / 1,20 USD po obniżce cen OpenAI z 30 lipca.
Samodzielny hosting zaczyna wygrywać jednostkowo dopiero, gdy wolumen przebije stały koszt B200.
Kolibri 1 ma otwarte wagi na licencji Apache 2.0, co pozwala na komercyjne użycie, modyfikację i redystrybucję bez progów użytkowników czy przychodów.
Wagi są dostępne jako Aleph-Alpha/Kolibri-1 na Hugging Face w formacie float8_e4m3fn. Karta modelu dokumentuje serwowanie wyłącznie przez vLLM z użyciem wtyczki aleph-alpha-inference od Aleph Alpha. Społecznościowe buildy GGUF i MLX pojawiły się w kilka dni, ale Aleph Alpha ich nie zweryfikowało, a nie znalazłem oficjalnej pozycji dla Ollamy.
Dla wdrożenia serwowanego 1x H200 lub 1x B200 pomieści ~78 GB wag FP8 na jednej karcie. Użyj --tensor-parallel-size 2 na H100.
Utrzymuj --max-model-len na poziomie 262 144 lub niżej, chyba że przetestowałeś dłuższe konteksty. Wyjście poza to wymaga dodatkowej flagi --hf-overrides, co opisuje karta modelu.
Zainstaluj wtyczkę i uruchom serwer:
pip install 'aleph-alpha-inference>=1'

# Add --tensor-parallel-size 2 on 2x H100
vllm serve Aleph-Alpha/Kolibri-1 \
  --kv-cache-dtype fp8 \
  --max-model-len 262144 \
  --reasoning-parser kolibri1 \
  --tool-call-parser kolibri1 \
  --enable-auto-tool-choice
Następnie zadawaj zapytania przez API kompatybilne z OpenAI, używając parametrów próbkowania zalecanych przez Aleph Alpha (temperature 1.0, top_p 0.97, top_k 128):
from openai import OpenAI

client = OpenAI(base_url="http://localhost:8000/v1", api_key="EMPTY")

response = client.chat.completions.create(
    model="Aleph-Alpha/Kolibri-1",
    messages=[{
        "role": "user",
        "content": "Fasse die wichtigsten Fristen aus diesem Bescheid in drei Punkten zusammen.",
    }],
    temperature=1.0,
    top_p=0.97,
    max_tokens=512,
    extra_body={
        "top_k": 128,
        "chat_template_kwargs": {"reasoning_effort": "medium"},
    },
)
print(response.choices[0].message.content)
Parametr reasoning effort przyjmuje wartości low, medium i high, a myślenie można całkowicie wyłączyć, jeśli latencja jest ważniejsza niż głębokość.
Wyniki będą się różnić w zależności od parametrów próbkowania, a karta modelu zaznacza, że mogą delikatnie się rozchodzić nawet przy wyłączonym próbkowaniu.
W kwestii głębszej konfiguracji w inferencji self-hosted i pętlach agentowych, nasz samouczek API o budowie agenta migracyjnego omawia wzorce uprawnień do narzędzi i sterowania, które przenoszą się wprost.
Kolibri 1 jest z założenia „suwerenną AI”, czyli taką, którą kraj lub organizacja może uruchamiać, audytować i kontrolować we własnej infrastrukturze i we własnej jurysdykcji, bez zależności od zagranicznego dostawcy API, cen czy regulaminu. W przypadku Kolibri 1 argument opiera się na wagach Apache 2.0 możliwych do uruchomienia w sieci odciętej od internetu, europejskiej infrastrukturze treningowej i dokumentacji zgodnej z unijnym Aktem o AI.
Za tą premierą stoją jednak dwa konteksty korporacyjne.
Aleph Alpha podpisało wiążącą umowę fuzji z kanadyjską firmą Cohere, by stworzyć to, co określają jako pierwsze transatlantyckie suwerenne rozwiązanie AI.
Połączona spółka będzie działać pod marką Cohere, z dwiema głównymi siedzibami w Toronto i Berlinie, a Heidelberg pozostanie centrum badawczym. Transakcja wciąż wymaga zgody regulatorów.
Oferta suwerenności zależy od tego, czy właściciel modelu nadal będzie go wspierał, a marka Aleph Alpha ma zniknąć w Cohere po finalizacji fuzji, więc oba wątki warto śledzić równolegle z benchmarkami.
Aleph Alpha stawia na to, że suwerenność, licencja Apache 2.0 i udokumentowana zgodność z unijnym Aktem o AI są dla europejskich nabywców sektora publicznego ważniejsze niż kilka punktów na MMLU-Pro.
To wygląda rozsądnie, a fuzja z Cohere sugeruje, że firma wie, iż samą skalą nie wygra.
Można uczciwie powiedzieć, że Kolibri 1 to najlepszy model open-weight po niemiecku w tej klasie liczby aktywnych parametrów, jaki dotąd tak dobrze opisano, ale nie jest to model, po który sięgnąłbym przy długich, wieloturowych zadaniach agentowych ani przy odtwarzaniu faktów „z pamięci”.
Wśród porównywalnych małoaktywnych modeli MoE wciąż wygrywa Qwen3.6 35B-A3B. Jeśli stać cię na gęsty model 27B, Qwen3.8 27B wygrywa bezapelacyjnie.
Jeśli chcesz szybko wejść w uruchamianie i ocenę takich modeli, zacznij od naszego ścieżki umiejętności AI Fundamentals.
Najlepsze kursy DataCamp
Kurs
Kurs
Kurs