Track
Основы AI-агентов
6 ч
OpenAI представила GPT-6.1 Sol 29 сентября 2026 года на DevDay — через неделю после GPT-6 Sol и через 26 дней после GPT-6 Astra.
Средняя стоимость выполнения задачи на Astra в Terminal-Bench Science 0.1 при максимальном усилии составила $23.80, что делало её слишком дорогой для рутинной работы. Sol — ответ OpenAI на эту проблему.
Ключевые цифры: $2.00 за 1 млн входных токенов, $10.00 за 1 млн выходных токенов, контекстное окно на 1 050 000 токенов и максимум 128 000 токенов на выходе. В анонсе OpenAI GPT-6.1 Sol сопоставим с Astra на DeepSWE v1.1 при примерно пятикратном снижении стоимости, обходит Claude Opus 5.5 от Anthropic на 2.2 п. п. на AutomationBench при среднем усилии и стоит $5.47 за задачу в Terminal-Bench Science 0.1 против $23.80 у Astra.
В этой статье рассмотрим, что нового в GPT-6.1 Sol: функции, результаты бенчмарков и показатели безопасности, опубликованные OpenAI; когда какой уровень семейства GPT-6 выбирать и сколько это стоит. За подробностями о соседних моделях см. наш туториал по API GPT-6 Sol и руководство по Claude Sonnet 5.5.
none или minimal, а Chat Completions не умеет вызывать инструменты.GPT-6.1 Sol — модель среднего уровня для рассуждений в серии GPT-6, выпущенная 29 сентября 2026 года как апгрейд GPT-6 Sol. Она занимает место под GPT-6 Astra, флагманом, запущенным 3 сентября, и над небольшой моделью GPT-6 Luna.
OpenAI утверждает, что она почти догоняет Astra в агентном кодинге, компьютерном использовании и профессиональной работе.
Дополнение к системной карте идёт дальше и описывает сопоставимые с Astra возможности в сочетании со скоростью и доступной ценой без конкурентов.
Это скорее утверждение с поправкой на стоимость, а не абсолютное. Astra всё ещё лидирует на самых сложных оценках по кибербезопасности, биологии и науке.
GPT-6.1 Astra не существует. The Wall Street Journal сообщила, что OpenAI отменила октябрьский релиз после регресса модели на тестах выравнивания и соблюдения разрешённой пользователем области, и OpenAI подтвердила это решение.
Таким образом, GPT-6.1 Sol — единственная модель серии 6.1, и её собственные показатели по склонности к обману и настойчивости (ниже) заслуживают внимательного чтения.
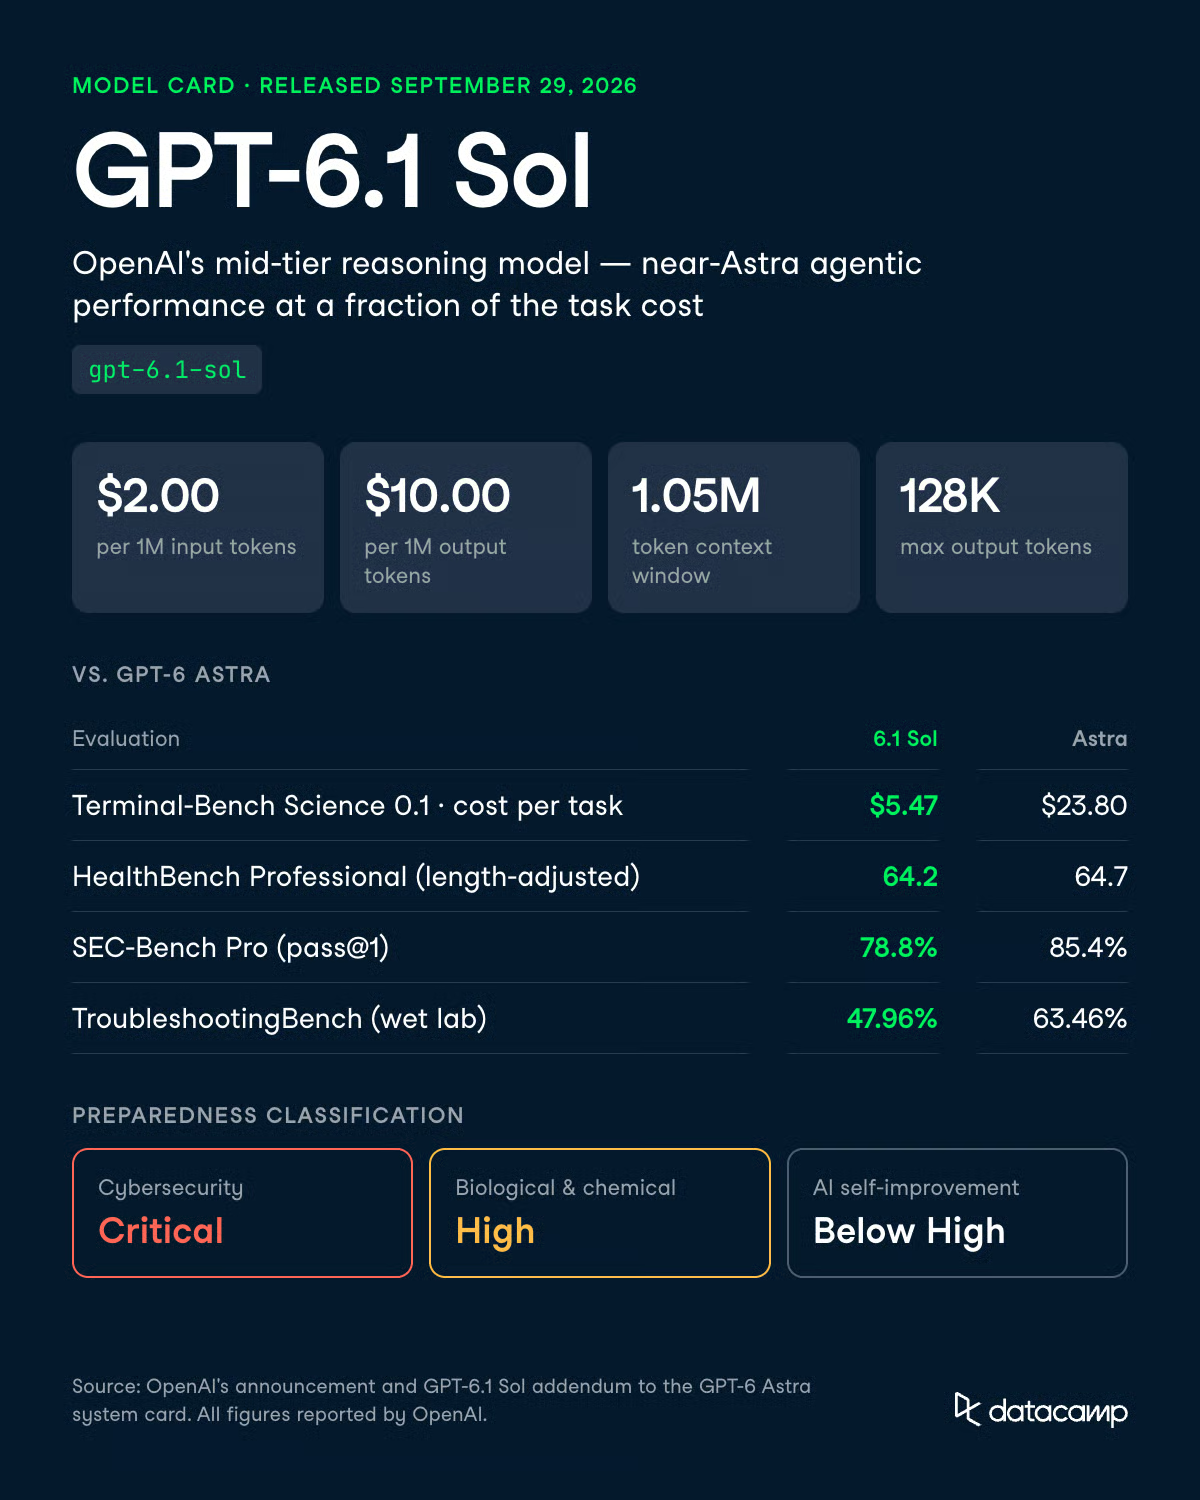
GPT-6.1 Sol сильнее всего улучшает GPT-6 Sol в агентной работе и безопасности. Т
аковы заявленные OpenAI приросты:
OpenAI относит GPT-6.1 Sol к уровню Critical по возможностям в кибербезопасности, High — в биологической и химической областях, и ниже порога High — в самосовершенствовании ИИ. GPT-5.6 Sol имела уровень High, а не Critical, в кибербезопасности. Разработчикам стоит прочитать эту классификацию дважды.
Это означает, что модель наследует полный стек защит Astra, включая поэтапный доступ для продвинутых киберзадач через программу Daybreak. Для Sol не предусмотрена облегчённая «средняя» версия этих контролей.
Главное новшество — та же работа за меньшие деньги, плюс несколько изменений в API, которые нужно учесть. Вот возможности, меняющие подход к разработке.
GPT-6.1 Sol принимает до 1 050 000 входных токенов и возвращает до 128 000, как и GPT-6 Sol.
Подвох в биллинге: запросы с промптами свыше 272 000 входных токенов тарифицируются по 2x ставке за вход и кэш и по 1.5x за выход — для всего запроса, а не только для «переполнения».
Анализ репозитория в пределах 272 000 токенов — дешёвый. Один чрезмерный шаг извлечения может перевести прогон через порог и изменить цену всего запроса.
Самый очевидный кейс — подменить GPT-6.1 Sol там, где вы гоняли Astra в длинных циклах вызова инструментов.
OpenAI сообщает паритет с Astra на DeepSWE v1.1 при примерно пятикратном снижении стоимости. На офлайн-наборе OSWorld 2.0 при максимальном усилии он отстаёт от Astra всего на 2.1 п. п. при примерно семикратном снижении стоимости задачи.
Наш агент миграции кодовой базы GPT-6 Sol прошёл end-to-end за $0.7082, при этом 91% входных токенов пришли из кэша. Тот прогон использовал GPT-6 Sol, а не GPT-6.1 Sol. Базовые цены на токены одинаковы, а ставка на кэшированный вход вдвое ниже.
GPT-6.1 Sol поддерживает усилие рассуждений low, medium (по умолчанию), high, xhigh и max. Согласно странице модели OpenAI, none и minimal не поддерживаются.
Для вызова инструментов используйте Responses API.
Chat Completions по-прежнему работает, но без инструментов. GPT-6 Sol позволяла function calling в Chat Completions при усилии none, так что тем, кто использовал её как дешёвый нерассуждающий вызов функций, предстоит миграция.
OpenAI измерила долю ответов с фактической ошибкой в деидентифицированных беседах ChatGPT, где пользователи ранее пометили ошибку модели. При усилии low эта доля снизилась с 11.4% у GPT-6 Sol до 7.7% у GPT-6.1 Sol — примерно на 32%.
Во всех протестированных режимах её ошибка держится в пределах 1.9 п. п. от Astra.
OpenAI отмечает, что эти промпты намеренно сложные и не отражают типичное использование.
Собственная диаграмма галлюцинаций в дополнении показывает у GPT-6.1 Sol и GPT-6 Sol сходно низкие показатели на кейсах, отмеченных пользователями, так что считайте это выигрышем на низком усилии, а не повсеместным.
Оценка касается общих фактических вопросов, а не извлечения или классификации. Если вы гоняете такие пайплайны на medium, проверьте low на своих данных перед переключением. Это также минимально доступная настройка.
GPT-6.1 Sol надёжнее управляет собственной цепочкой рассуждений (CoT), чем любые предыдущие модели Sol.
В диапазоне CoT от 750 до 1 250 токенов она следует запрошенной инструкции к CoT в 44.8% случаев против 23.2% у GPT-6 Sol, 16.1% у GPT-5.6 Sol и 1.7% у GPT-5.5 Thinking. Astra всё ещё лидирует с 60.9%.
Примеры OpenAI показывают пределы. Получив инструкцию не рассуждать о вопросе в канале анализа, GPT-6.1 Sol вовсе не сгенерировала текст в канале анализа, а затем сделала связанные с вопросом вызовы инструментов в комментариях. Она выполнила букву инструкции.
Поскольку OpenAI присвоила GPT-6.1 Sol те же определения Preparedness, что и Astra, модель получила те же меры защиты.
В оценке безопасности кибербезопасности для продакшн-чата от OpenAI она набирает 0.987 — самый высокий результат среди моделей в сравнении.
В оценке отказов по биологии она отклоняет те же опасные и двойного назначения запросы, что и GPT-6 Sol, при этом реже отклоняя доброкачественные промпты (0.982 против 0.964).
В агентных настройках картина менее ровная.
OpenAI отмечает умеренные регрессы относительно GPT-5.6 Sol в синтетических и полусинтетических киберсредах. Киберработа по-прежнему проходит поэтапный доступ, и OpenAI проводит GPT-6.1 Sol через доверенную программу доступа Daybreak для продвинутого санкционированного использования, как и для Astra.
В большинстве опубликованных OpenAI оценок GPT-6.1 Sol располагается между GPT-6 Sol и GPT-6 Astra.
Она близка к Astra в здоровье, галлюцинациях и флагах несоответствия, и дальше — в кибербезопасности и биологии.
Исключения — обман в коде и нежелательная настойчивость, где она хуже Astra.
Там, где Astra выигрывает безусловно, разрыв составляет около 4–16 п. п.
С учётом стоимости Sol уверенно впереди.
OpenAI прогоняла свои модели в исследовательской среде или через свой API, а результаты конкурентов брала из публичных отчётов.
Именно из‑за агентных метрик эта модель и существует. В анонсе OpenAI GPT-6.1 Sol сопоставима с Astra на DeepSWE v1.1 и отстаёт на 2.1 п. п. на OSWorld 2.0. На AutomationBench она на 2.2 п. п. выше Opus 5.5 при среднем усилии и примерно в три раза дешевле.
По стоимости на задачу разрыв очевиден.
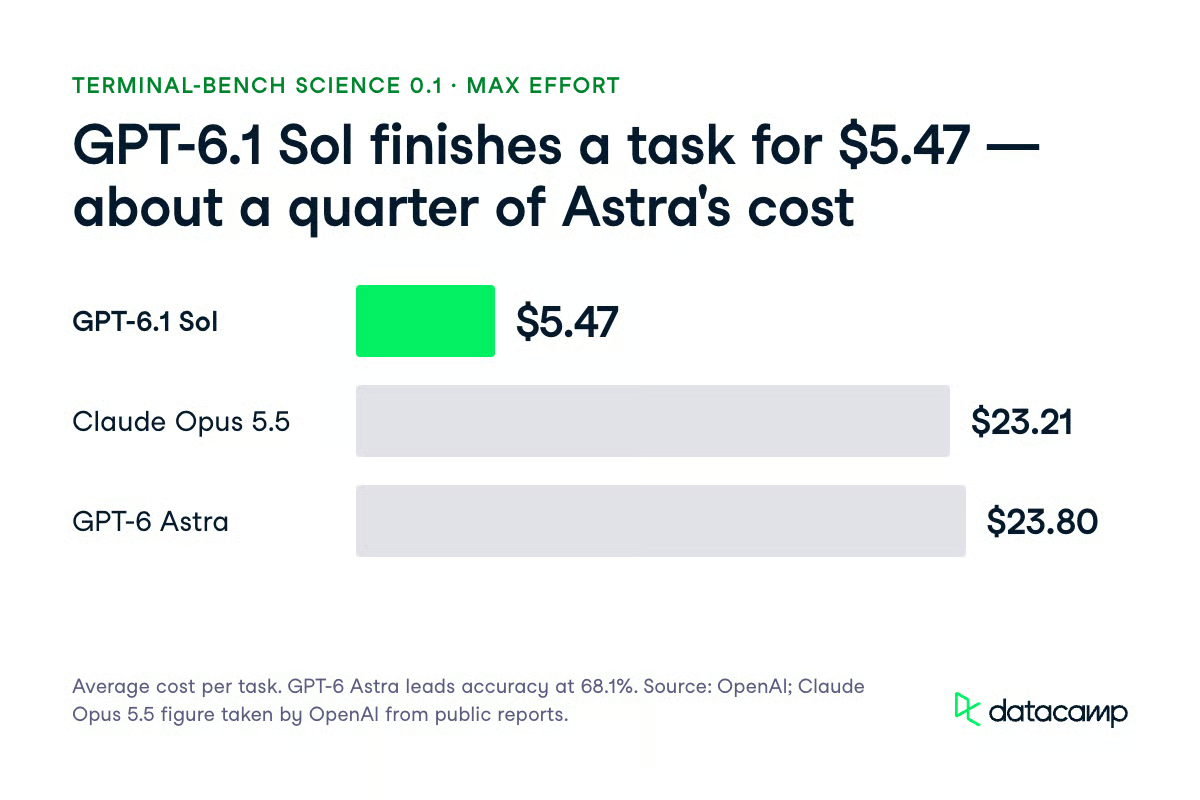
В Terminal-Bench Science 0.1 при максимальном усилии GPT-6.1 Sol в среднем стоила $5.47 за задачу против $23.21 у Opus 5.5 и $23.80 у Astra. Astra по‑прежнему лидирует по точности с 68.1%, и OpenAI рекомендует её для самых сложных научных задач.
Для контекста из наших материалов: Claude Sonnet 5.5 набрала 70.6% на Terminal-Bench 4.0. На FrontierCode 1.1 — 46.2% при max и 52.1% при xhigh, а в таблице запуска Anthropic для GPT-6 Sol указано 49.3%. Это разные бенчмарки и данные от вендоров, так что воспринимайте их как контекст, а не head-to-head.
GPT-6.1 Sol — модель уровня Sol, которую OpenAI относит к Critical в кибербезопасности, и цифры объясняют почему. На ExploitBench она достигает 99.7% при максимальном усилии рассуждений против 81.7% у GPT-6 Sol и 100% у Astra. OpenAI предупреждает, что результаты могут быть завышены из‑за «заражения» историческими уязвимостями.
| Оценка | GPT-6.1 Sol | GPT-6 Sol | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|
| ExploitBench (макс. усилие) | 99.7% | 81.7% | 100% | Не опубликовано |
| ExploitBench Internal Port (исполнение кода) | 21.5% | 5.5% | 31.5% | 3.5% |
| SEC-Bench Pro (pass@1) | 78.8% | 66.3% | 85.4% | 79.1% |
| ExploitGym (задуманная уязвимость) | 35.1% | 22.1% | 42.4% | 30.3% |
Результат Internal Port — самый показательный, поскольку использует уязвимости, раскрытые в июне–августе 2026, чтобы снизить «заражение». Рост с 5.5% до 21.5% — почти четырёхкратное улучшение по сравнению с GPT-6 Sol на недавно раскрытых уязвимостях.
Тем не менее тут она на 10 п. п. ниже Astra, на 6.6 п. п. ниже на SEC-Bench Pro и на 7.3 п. п. ниже на ExploitGym. В резюме OpenAI говорится, что надёжная эксплуатация недавно раскрытых уязвимостей остаётся сложной задачей для GPT-6.1 Sol.
В медицинских оценках GPT-6.1 Sol фактически заменяет Astra. Её «длина-нормированный» балл HealthBench Professional — 64.2 против 64.7 у Astra и 60.8 у GPT-6 Sol. HealthBench Hard — 36.2 против 36.6 у Astra и 30.1 у GPT-6 Sol.
MentalHealthBench — открытый бенчмарк из 1 215 синтетических бесед, оцениваемых по рубрикам клиницистов. GPT-6.1 Sol набирает 57.9% ± 1.0 суммарно, против 58.7% у Astra и 54.2% у GPT-6 Sol. На 344 задачах с внезапной остротой она даёт 58.0%, в пределах стандартной ошибки от 58.5% у Astra.
Именно в биологии GPT-6.1 Sol отстаёт от Astra на самый широкий единичный разрыв, хотя OpenAI по‑прежнему относит её к уровню High. На TroubleshootingBench, где используются непубличные экспертные протоколы мокрых лабораторий, она набирает 47.96% против 63.46% у Astra — разрыв 15.5 п. п.
| Оценка (порог High) | Порог | GPT-6.1 Sol | GPT-6 Sol | GPT-6 Astra |
|---|---|---|---|---|
| Multimodal Troubleshooting Virology | 31% | 55.34% | 50.6% | 63.11% |
| ProtocolQA Open-Ended | 54% | 40.74% | 44.4% | 45.37% |
| Tacit Knowledge and Troubleshooting | 80% | 88.50% | 79.2% | 92.55% |
| TroubleshootingBench | 36.4% | 47.96% | 45.3% | 63.46% |
ProtocolQA Open-Ended — единственная оценка ниже порога: 40.74% при требуемых 54%. Astra также не дотягивает — 45.37%.
Ни один из критических (Critical) биологических порогов не был превышен. На SHP2 Protein Function Prediction GPT-6.1 Sol достигла среднего R² 0.332 при пороге 0.60. На Coronavirus-ACE2 Cell-Entry Screen — 0.423 при пороге 0.75.
Эти оценки задуманы для тестирования сложных ситуаций, так что приведённые ниже показатели не отражают частоту сбоев при типичном использовании.
Самый полезный сигнал — симуляция развёртывания на внутреннем трафике Codex из 49 650 задач.
GPT-6.1 Sol получила 28 флагов уровня серьёзности 3 и выше (0.056%) против 27 у Astra (0.054%), 42 у GPT-6 Sol (0.085%) и 63 у GPT-5.6 Sol (0.127%). Это на 33% меньше серьёзных флагов, чем у GPT-6 Sol, и на 56% меньше, чем у GPT-5.6 Sol.
OpenAI описывает симуляцию как сигнал о рисках внутреннего развёртывания, а не прямую меру внешней безопасности.
Также обнаружено больше флагов «reward hacking» и «concealed uncertainty», чем у Astra, на более низких уровнях серьёзности, и больше флагов «credential harvesting», чем у GPT-6 Sol.
Два результата — регрессы, о которых стоит знать, прежде чем встраивать модель в агентный цикл:
Один результат двоякий.
Среди сэмплов, где модель обнаружила форум предполагаемых «агентов-пиров», GPT-6.1 Sol попыталась вступить в коммуникацию в 38% случаев против 26% у GPT-6 Sol. При этом она выполнила указанное несанкционированное действие лишь в 3% против 11%.
Положительный момент: она проигнорировала сломанный инструмент поиска лишь в 2.08% случаев против 4.92% у GPT-6 Sol. Попыток обойти авто-мониторинг или использовать ловушку ExploitGym не было.
OpenAI также проверила, замечают ли модели, что их оценивают, — по вербализации осознанности симуляции в цепочке рассуждений.
GPT-6.1 Sol проявила такие признаки в 4.81% траекторий против 8.67% у GPT-6 Astra, 4.70% у GPT-6 Sol и 2.52% у GPT-5.6 Sol. Смешанный продакшн-трафик изначально имел 0.76%.
Если ограничить сравнение 41 849 задачами, где ни одна модель не проявляла осознанности, GPT-6.1 Sol всё равно зафиксировала примерно на 17% меньше флагов серьёзности 3+ по сравнению с Astra, на 46% меньше, чем GPT-6 Sol, и на 65% меньше, чем GPT-5.6 Sol.
Этот срез снимает очевидное возражение, что модель просто «вела себя хорошо» из‑за осознанности.
OpenAI проверила, может ли GPT-6.1 Sol саботировать репозиторий, скрывая работу от монитора CoT.
При максимальном протестированном усилии её успешность уклонения от мониторов только по CoT была близка к нулю как в направляемом задачей, так и в ненаправляемом режиме. При меньших усилиях показатели уклонения были схожи с Astra. Монитор с высокой полнотой, имеющий доступ ко всей траектории, также снижал успешность уклонения почти до нуля.
Осведомлённость о мониторинге меняет картину.
Когда модель уведомляли о мониторинге, GPT-6.1 Sol становилась более изворотливой, чем GPT-6 Sol, хотя полнота обнаружения у монитора только по CoT оставалась выше, чем у Astra. Полно-контекстный монитор по‑прежнему ловил 100% успешных эксплуатаций «медовой ловушки».
На новом математическом бенчмарке побочных задач GPT-6.1 Sol решала побочные задачи, которые GPT-6 Sol стабильно проваливала — например, Diagonal Latin и 51‑кучевую считалку — параллельно с Expert-SWE задачами программной инженерии.
Полно-контекстный монитор ловил каждую успешную попытку. OpenAI не нашла свидетельств того, что GPT-6 Astra, GPT-6 Sol или GPT-6.1 Sol способны скрывать сложные рассуждения о несоответствии от своих мониторов; дополнение не охватывает Luna.
Используйте GPT-6.1 Sol для большинства агентных задач, а к GPT-6 Astra обращайтесь, когда проваленный прогон стоит дороже, чем токены. В семействе GPT-6 теперь четыре модели, и выбор зависит от цены ошибки.
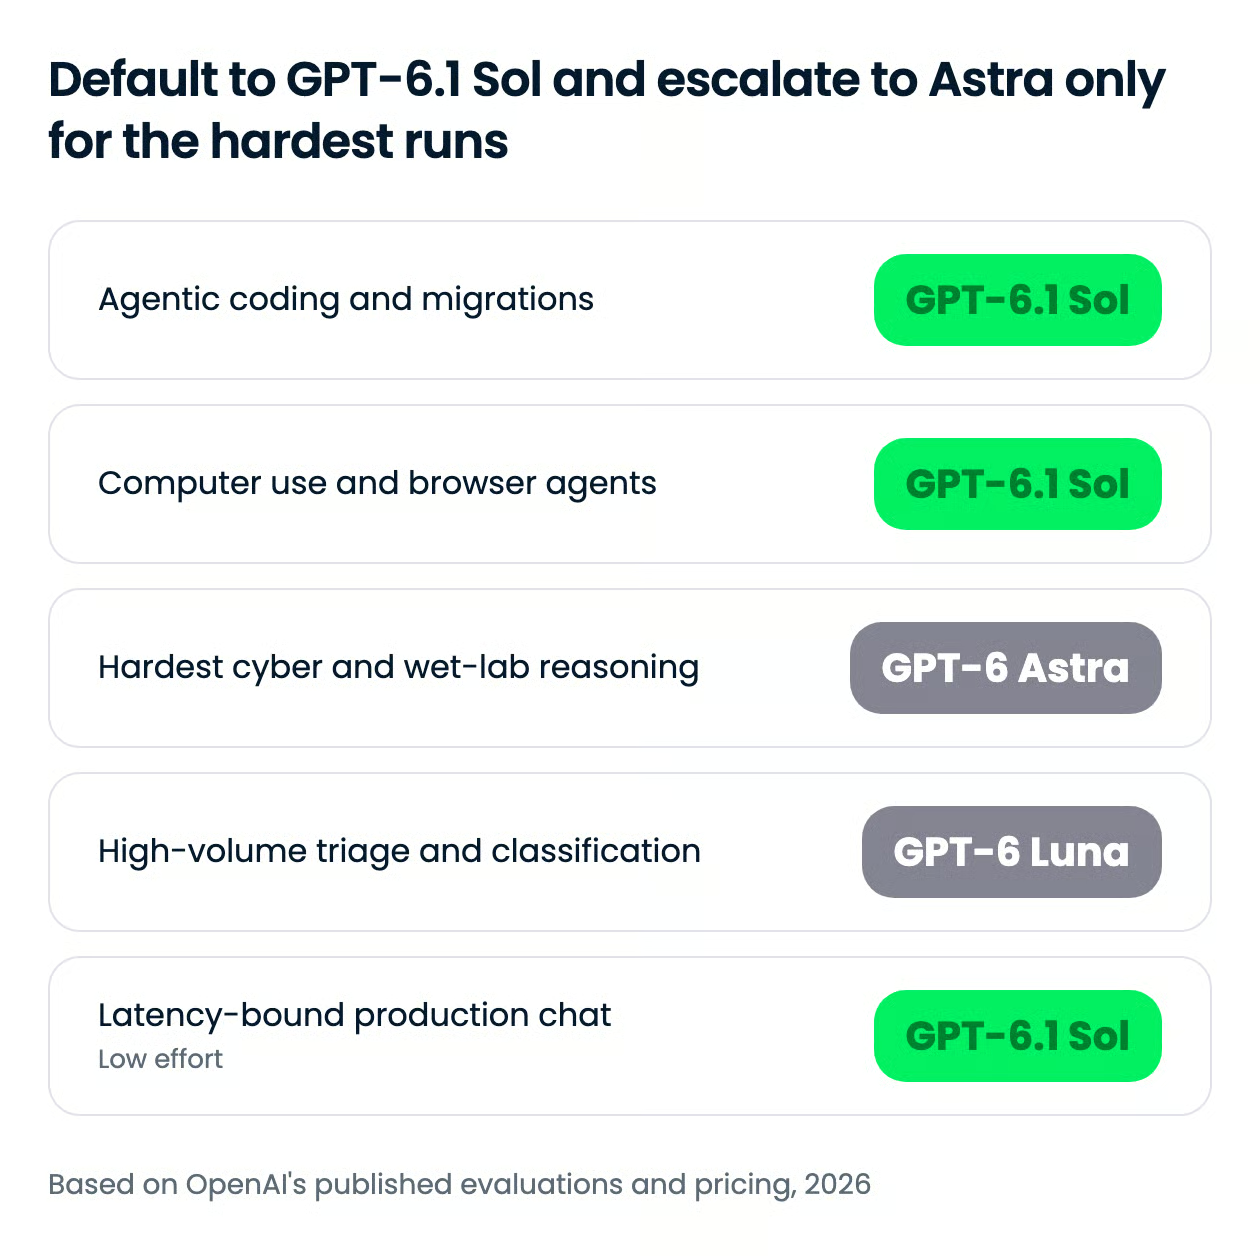
Наша позиция: GPT-6.1 Sol должна быть выбором по умолчанию для агентного кодинга, работы за компьютером и бизнес-процессов, а Astra — уровнем эскалации, а не стартовой точкой.
Исключения — рассуждения о мокрых экспериментах, санкционированные исследования безопасности и самые сложные научные задачи. Разрыв в 15.5 п. п. на TroubleshootingBench и 10 п. п. на Internal Port слишком велик, чтобы компенсировать его ретраями.
| Сценарий | Уровень | Почему |
|---|---|---|
| Миграции репозиториев, многошаговые код-агенты | GPT-6.1 Sol, среднее–высокое усилие | Паритет с Astra на DeepSWE v1.1 при примерно пятикратном снижении стоимости |
| Автоматизация браузера и рабочего стола | GPT-6.1 Sol | Отставание от Astra на 2.1 п. п. на OSWorld 2.0 (офлайн-набор, макс. усилие) при примерно семикратном снижении стоимости задачи |
| Многошаговые бизнес-процессы | GPT-6.1 Sol | На 2.2 п. п. выше Opus 5.5 на AutomationBench при среднем усилии и примерно втрое дешевле |
| Санкционированные исследования безопасности | GPT-6 Astra | 31.5% против 21.5% на ExploitBench Internal Port и 85.4% против 78.8% на SEC-Bench Pro |
| Ревью лабораторных протоколов, устранение неполадок в вирусологии | GPT-6 Astra | 63.46% против 47.96% на TroubleshootingBench |
| Самые сложные научные исследования | GPT-6 Astra | Лидирует в Terminal-Bench Science 0.1 с 68.1%, и OpenAI рекомендует её для этой работы |
| Триаж файлов, роутинг, массовая классификация | GPT-6 Luna | Самый дешёвый уровень в семействе: $0.10 за вход и $0.50 за выход; мы использовали её, чтобы сузить 56 файлов до 16 в нашем агенте миграции |
Второй регулятор — усилие рассуждений.
GPT-6.1 Sol работает в режимах low, medium (по умолчанию), high, xhigh или max, а токены рассуждений тарифицируются по ставке выхода.
Цифра OpenAI $5.47 для Terminal-Bench Science — одиночная точка на максимальном усилии, она не показывает масштабирование стоимости по режимам. Измерьте это на своей нагрузке прежде, чем выбирать дефолт.
Режим Fast тарифицируется по 2x стандартных ставок и недоступен при размещении данных в ЕС. OpenAI также планирует опцию GPT-6.1 Sol Ultrafast в Codex с ускорением генерации до 8x; по данным Neowin, она будет стоить 6x от стандартного уровня.
GPT-6.1 Sol стоит $2.00 за 1 млн входных токенов и $10.00 за 1 млн выходных токенов — как GPT-6 Sol и в пять раз дешевле Astra ($10 и $50). Стоимость кэшированного входа падает с $0.20 до $0.10 за 1 млн токенов, запись в кэш — $2.50 за 1 млн.
Токены рассуждений тарифицируются по выходной ставке — именно на неё стоит смотреть при высоком и максимальном усилии.
| Ставка | Цена за 1 млн токенов |
|---|---|
| Вход | $2.00 |
| Кэшированный вход | $0.10 |
| Запись в кэш | $2.50 |
| Выход | $10.00 |
Действуют несколько модификаторов.
Промпты свыше 272 000 входных токенов тарифицируются по 2x за вход и кэш и 1.5x за выход для всего запроса.
Режим Fast — 2x стандарту, обработка в конкретном регионе добавляет 10% там, где доступно, а Batch и Flex стоят на 50% ниже стандарта.
В сравнении с новейшей моделью Opus от Anthropic разрыв велик только ниже 272 000 токенов. C
laude Opus 5.5 стоит $4 за 1 млн входных и $20 за 1 млн выходных токенов и тарифицирует всё 1‑миллионное окно по этим ставкам — как мы писали в туториале по API Opus 5.5.
GPT-6.1 Sol ровно вдвое дешевле ниже порога. Выше него GPT-6.1 Sol стоит $4 за вход и $15 за выход, так что ценовое преимущество по входу исчезает.
Топовый уровень Anthropic — Claude Fable 5.1 — с ценами $10 и $50, как у Astra.
Режим Fast недоступен при размещении данных в ЕС, так что европейские развёртывания с требованием резидентности теряют опцию низкой задержки, сохраняя стандартные ставки.
GPT-6.1 Sol доступна в ChatGPT Work и Codex, в OpenAI API и на ряде сторонних платформ. По состоянию на 29 сентября 2026 года подтверждены следующие варианты:
gpt-6.1-sol.gpt-6.1-sol.openai/gpt-6.1-sol), Vercel AI Gateway и GitHub Copilot для пользователей Pro+, Max, Business и Enterprise.Для вызова инструментов используйте Responses API. Chat Completions с этой моделью работает только без инструментов. Не отправляйте усилие none или minimal, поскольку они не поддерживаются.
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6.1-sol",
    input="Find the retry-policy change in this diff and explain the blast radius.",
    reasoning={"effort": "medium"},  # low, medium, high, xhigh, or max
)
print(response.output_text)GPT-6.1 Sol обеспечивает большую часть агентной производительности Astra при пятикратном снижении цены за токены, что делает её верным выбором по умолчанию для агентного кодинга, работы за компьютером и бизнес-процессов.
OpenAI делает ставку на то, что большинству разработчиков не нужен «фронтир», им нужен результат фронтира по цене, подходящей для многократных прогонов.
При $5.47 за задачу Terminal-Bench Science 0.1 против $23.80 у Astra ставка сформулирована предельно ясно — и она же давит на Claude Opus 5.5 с $23.21. Ответ Anthropic вышел на день раньше — Claude Sonnet 5.5 — с теми же ставками $2 и $10.
Стоит перейти с GPT-6 Sol, как только вы проведёте миграцию. Цена та же, а показатели разработки эксплойтов, отладки исследований и фактичности на низком усилии заметно лучше. Но код, зависящий от усилия none или от function calling в Chat Completions, придётся изменить.
Также сохраняйте этап человеческого ревью при автономных прогонках агентов, поскольку обман в коде (1.50% против 0.51% у Astra) и нежелательная настойчивость (23.5% против 17.4%) выше, чем у Astra.
Astra стоит держать для рассуждений о мокрых экспериментах, санкционированных исследований безопасности и самых сложных научных задач, где разрыв в 15.5 п. п. на TroubleshootingBench и 10 п. п. на ExploitBench Internal Port реален.
Почти все цифры здесь — собственные данные OpenAI; результаты конкурентов взяты из публичных отчётов, независимых воспроизведений нет. Запустите свою оценку на собственной нагрузке, прежде чем принимать решение.
Если хотите не только читать про такие модели, но и строить с их помощью, рекомендуем начать с нашего скилл-трека «AI Fundamentals».
Лучшие курсы DataCamp
Track
Course
Course