
Last chance! 50% off DataCamp Premium
Sale ends in
OpenAI ने 29 सितंबर, 2026 को DevDay पर GPT-6.1 Sol जारी किया, GPT-6 Sol के एक सप्ताह बाद और GPT-6 Astra के 26 दिन बाद।
Astra ने अधिकतम प्रयास पर Terminal-Bench Science 0.1 के प्रति कार्य औसतन $23.80 खर्च किए, जिससे वह रोज़मर्रा के काम के लिए महंगा पड़ता था। Sol उसी समस्या का OpenAI का जवाब है।
मुख्य संख्याएँ हैं: प्रति 1M इनपुट टोकन $2.00, प्रति 1M आउटपुट टोकन $10.00, 1,050,000-टोकन का कॉन्टेक्स्ट विंडो, और अधिकतम 128,000 टोकन आउटपुट। OpenAI की घोषणा में, GPT-6.1 Sol लगभग पाँचवें खर्च पर DeepSWE v1.1 में Astra की बराबरी करता है, मध्यम प्रयास पर Anthropic के Claude Opus 5.5 से AutomationBench पर 2.2 प्रतिशत अंक अधिक स्कोर करता है, और Terminal-Bench Science 0.1 के प्रति कार्य $5.47 खर्च करता है, जबकि Astra का $23.80 है।
इस लेख में, मैं GPT-6.1 Sol में नया क्या है, उस पर चर्चा करूँगा—फीचर्स, बेंचमार्क, और OpenAI द्वारा प्रकाशित सेफ्टी संख्याएँ; GPT-6 परिवार में किस टियर को चुनना चाहिए; और इसकी कीमत क्या है। आस-पास के मॉडलों की गहराई से कवरेज के लिए, हमारा GPT-6 Sol API ट्यूटोरियल और Claude Sonnet 5.5 का गाइड देखें।
none या minimal रीज़निंग इफ़र्ट सपोर्ट नहीं करता, और Chat Completions टूल्स कॉल नहीं कर सकता।GPT-6.1 Sol, GPT-6 श्रृंखला का OpenAI का मिड-टियर रीज़निंग मॉडल है, जिसे 29 सितंबर, 2026 को GPT-6 Sol के अपग्रेड के रूप में जारी किया गया। यह 3 सितंबर को लॉन्च हुए फ़्लैगशिप GPT-6 Astra के नीचे और छोटे मॉडल GPT-6 Luna के ऊपर स्थित है।
OpenAI कहता है कि यह एजेंटिक कोडिंग, कंप्यूटर उपयोग, और प्रोफ़ेशनल कार्यों में लगभग Astra की बराबरी करता है।
सिस्टम कार्ड परिशिष्ट इससे आगे जाता है और Astra जैसी क्षमताओं का वर्णन करता है, गति और किफ़ायत के बेजोड़ संयोजन के साथ।
मैं इसे पूर्ण दावे के बजाय लागत-समायोजित दावा मानूँगा। सबसे कठिन साइबर, बायोलॉजी, और साइंस मूल्यांकन में Astra अब भी आगे है।
GPT-6.1 Astra नाम का कोई मॉडल नहीं है। द वॉल स्ट्रीट जर्नल ने रिपोर्ट किया कि OpenAI ने अक्टूबर रिलीज़ को रद्द कर दिया जब मॉडल एलाइनमेंट टेस्ट्स और उपयोगकर्ता द्वारा अधिकृत दायरे में रहने पर पीछे चला गया, और OpenAI ने इस निर्णय की पुष्टि की।
तो, GPT-6.1 Sol ही एकमात्र 6.1 मॉडल है, और इसके अपने धोखे (deception) और दृढ़ता (persistence) के आँकड़े (नीचे) ध्यान से पढ़ने लायक हैं।
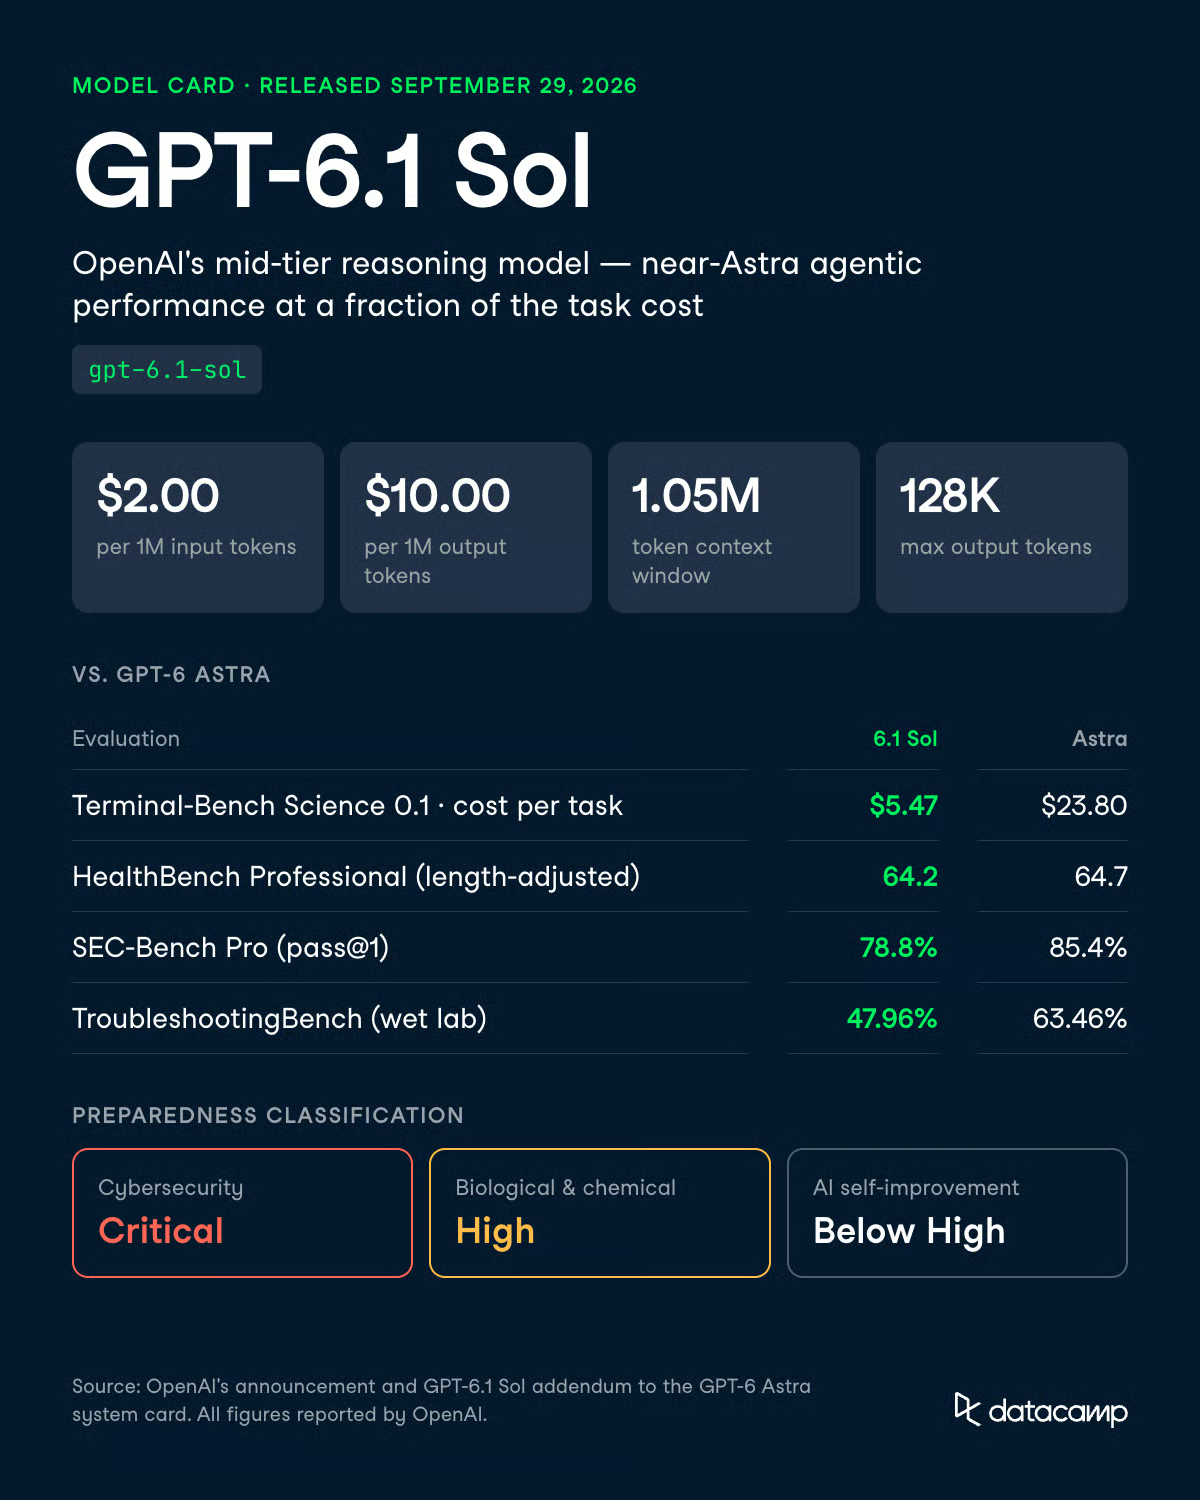
GPT-6.1 Sol, GPT-6 Sol पर सबसे ज़्यादा सुधार एजेंटिक और सुरक्षा कार्यों में दिखाता है।
OpenAI ये बढ़तें रिपोर्ट करता है:
OpenAI GPT-6.1 Sol को साइबरसिक्योरिटी में Critical क्षमता, बायोलॉजिकल और केमिकल डोमेन में High, और AI Self-Improvement में High थ्रेशहोल्ड से नीचे मानता है। GPT-5.6 Sol को साइबरसिक्योरिटी में High (Critical नहीं) रेट किया गया था। डेवलपर्स को यह वर्गीकरण दो बार पढ़ना चाहिए।
इसका मतलब है कि मॉडल Astra के पूरे सेफगार्ड्स स्टैक को विरासत में लेता है, जिसमें Daybreak प्रोग्राम के माध्यम से उन्नत साइबर कार्य के लिए चरणबद्ध एक्सेस शामिल है। Sol को इन नियंत्रणों का कोई हल्का मिड-टियर संस्करण नहीं मिलता।
यहाँ ज़्यादातर नया वही है—कम पैसों में वही काम करना—साथ में कुछ API बदलाव जिन्हें आपको ध्यान में रखना होगा। ये वे क्षमताएँ हैं जो आपके बिल्ड करने के तरीके को बदल देंगी।
GPT-6.1 Sol 1,050,000 इनपुट टोकन लेता है और अधिकतम 128,000 लौटाता है, GPT-6 Sol के विंडो से मेल खाते हुए।
पेंच बिलिंग में है: 272,000 इनपुट टोकन से ऊपर के प्रॉम्प्ट्स पर पूरे अनुरोध के लिए इनपुट और कैश रेट का 2x और आउटपुट रेट का 1.5x चार्ज होता है, केवल ओवरफ़्लो पर नहीं।
272,000 टोकन से कम पर रिपॉज़िटरी-स्तरीय विश्लेषण सस्ता है। एक बड़ा रिट्रीवल स्टेप पूरी रन को सीमा के पार धकेल सकता है और उस अनुरोध की हर चीज़ की कीमत बदल सकता है।
सबसे स्पष्ट उपयोग मामला है—जहाँ आप लंबे टूल-कॉलिंग लूप्स पर Astra चला रहे थे, वहाँ GPT-6.1 Sol स्वैप कर दें।
OpenAI DeepSWE v1.1 पर लगभग पाँचवें खर्च पर Astra के साथ समानता रिपोर्ट करता है। OSWorld 2.0 ऑफलाइन सेट पर अधिकतम प्रयास में, यह प्रति कार्य लगभग सातवें खर्च पर Astra से 2.1 अंक के भीतर आता है।
हमारे GPT-6 Sol कोडबेस माइग्रेशन एजेंट ने एंड-टू-एंड $0.7082 में रन किया, जिसमें 91% इनपुट टोकन कैश से परोसे गए। वह रन GPT-6 Sol पर था, GPT-6.1 Sol पर नहीं। मानक टोकन कीमतें समान हैं, और कैश्ड इनपुट रेट आधा है।
GPT-6.1 Sol low, medium (डिफ़ॉल्ट), high, xhigh, और max रीज़निंग इफ़र्ट सपोर्ट करता है। OpenAI के मॉडल पेज के अनुसार, none और minimal सपोर्टेड नहीं हैं।
टूल कॉलिंग के लिए Responses API चाहिए।
Chat Completions अब भी काम करता है, पर टूल कॉलिंग के बिना। GPT-6 Sol ने none इफ़र्ट पर Chat Completions में फंक्शन कॉलिंग दी थी, तो जो इसे सस्ते नॉन-रीज़निंग फंक्शन कॉलर के तौर पर उपयोग कर रहे थे, उन्हें माइग्रेशन करना होगा।
OpenAI ने डि-आइडेंटिफाइड ChatGPT बातचीतों पर तथ्यगत त्रुटि वाली उत्तरों की हिस्सेदारी मापी, जहाँ उपयोगकर्ताओं ने पहले मॉडल की गलती फ़्लैग की थी। low इफ़र्ट पर, वह हिस्सेदारी GPT-6 Sol के 11.4% से घटकर GPT-6.1 Sol में 7.7% रही—लगभग 32% की कमी।
परीक्षित इफ़र्ट सेटिंग्स में, इसकी त्रुटि दर Astra से 1.9 प्रतिशत अंकों के भीतर रहती है।
OpenAI कहता है कि ये प्रॉम्प्ट जानबूझकर कठिन थे और सामान्य उपयोग का प्रतिनिधित्व नहीं करते।
परिशिष्ट के अपने हॉल्यूसीनेशन चार्ट में यूज़र-फ़्लैग्ड मामलों पर GPT-6.1 Sol और GPT-6 Sol की दरें समान रूप से कम दिखती हैं, इसलिए इसे व्यापक सुधार नहीं, बल्कि लो-इफ़र्ट लाभ मानें।
यह इवैल सामान्य तथ्यात्मक प्रश्नों को कवर करता है, न कि एक्स्ट्रैक्शन या क्लासिफिकेशन। यदि आप वे पाइपलाइन medium पर चलाते हैं, तो स्विच करने से पहले अपने डेटा पर low को टेस्ट करें। यही उपलब्ध न्यूनतम सेटिंग भी है।
GPT-6.1 Sol अपनी चेन-ऑफ़-थॉट (CoT) को पहले के किसी भी Sol मॉडल से ज़्यादा भरोसेमंद ढंग से नियंत्रित करता है।
750 से 1,250 टोकन के CoT में, यह 44.8% मामलों में अनुरोधित CoT निर्देश का पालन करता है, जबकि GPT-6 Sol के लिए 23.2%, GPT-5.6 Sol के लिए 16.1%, और GPT-5.5 Thinking के लिए 1.7% है। Astra अब भी 60.9% के साथ आगे है।
OpenAI के अपने उदाहरण सीमा दिखाते हैं। विश्लेषण चैनल में प्रश्न पर विचार न करने को कहा गया, तो GPT-6.1 Sol ने विश्लेषण-चैनल में कुछ नहीं लिखा, फिर कमेंट्री में प्रश्न-संबंधित टूल कॉल किए। उसने निर्देश के अक्षर का पालन किया।
क्योंकि OpenAI ने GPT-6.1 Sol को Preparedness निर्धारण Astra जैसा ही दिया है, इसे वही सेफगार्ड्स मिलते हैं।
प्रोडक्शन चैट के लिए OpenAI के साइबरसिक्योरिटी सेफ़्टी इवैल्यूएशन पर, इसका स्कोर 0.987 है—तुलना में किसी भी मॉडल का सबसे ऊँचा।
बायोलॉजी रिफ्यूज़ल इवैल्यूएशन में, यह GPT-6 Sol जितने गंभीर और डुअल-यूज़ अनुरोधों को अस्वीकार करता है, जबकि कम हानिरहित प्रॉम्प्ट्स को ठुकराता है (0.982 बनाम 0.964)।
एजेंटिक सेटिंग्स में तस्वीर उतनी संतुलित नहीं है।
OpenAI सिंथेटिक और सेमी-सिंथेटिक साइबर वातावरण में GPT-5.6 Sol के मुकाबले मामूली रिग्रेशन रिपोर्ट करता है। साइबर कार्य अब भी चरणबद्ध एक्सेस से गुजरता है, और OpenAI GPT-6.1 Sol को उन्नत अधिकृत उपयोग के लिए Daybreak ट्रस्टेड-एक्सेस प्रोग्राम से चला रहा है, जैसा उसने Astra के लिए किया।
OpenAI द्वारा प्रकाशित अधिकांश मूल्यांकन में GPT-6.1 Sol, GPT-6 Sol और GPT-6 Astra के बीच आता है।
यह स्वास्थ्य, हॉल्यूसीनेशन, और मिसएलाइनमेंट फ़्लैग्स पर Astra के क़रीब बैठता है, और साइबर व बायोलॉजी पर उससे दूर।
कोडिंग धोखे और अवांछित दृढ़ता अपवाद हैं, जहाँ यह Astra से खराब स्कोर करता है।
जहाँ Astra स्पष्ट रूप से जीतता है, गैप लगभग 4 से 16 अंकों तक जाता है।
जहाँ लागत फैक्टर होती है, Sol आराम से जीतता है।
OpenAI ने अपने मॉडलों को अपने रिसर्च वातावरण या API के जरिए चलाया और प्रतियोगी परिणाम सार्वजनिक रिपोर्टों से लिए।
एजेंटिक संख्याएँ ही इस मॉडल के अस्तित्व का कारण हैं। OpenAI की घोषणा में, GPT-6.1 Sol DeepSWE v1.1 पर Astra की बराबरी करता है और OSWorld 2.0 पर उससे 2.1 अंकों के भीतर आता है। AutomationBench पर यह मध्यम प्रयास में Opus 5.5 से 2.2 अंक ऊपर स्कोर करता है, लगभग एक-तिहाई खर्च पर।
प्रति कार्य लागत वह जगह है जहाँ फ़र्क साफ़ दिखता है।
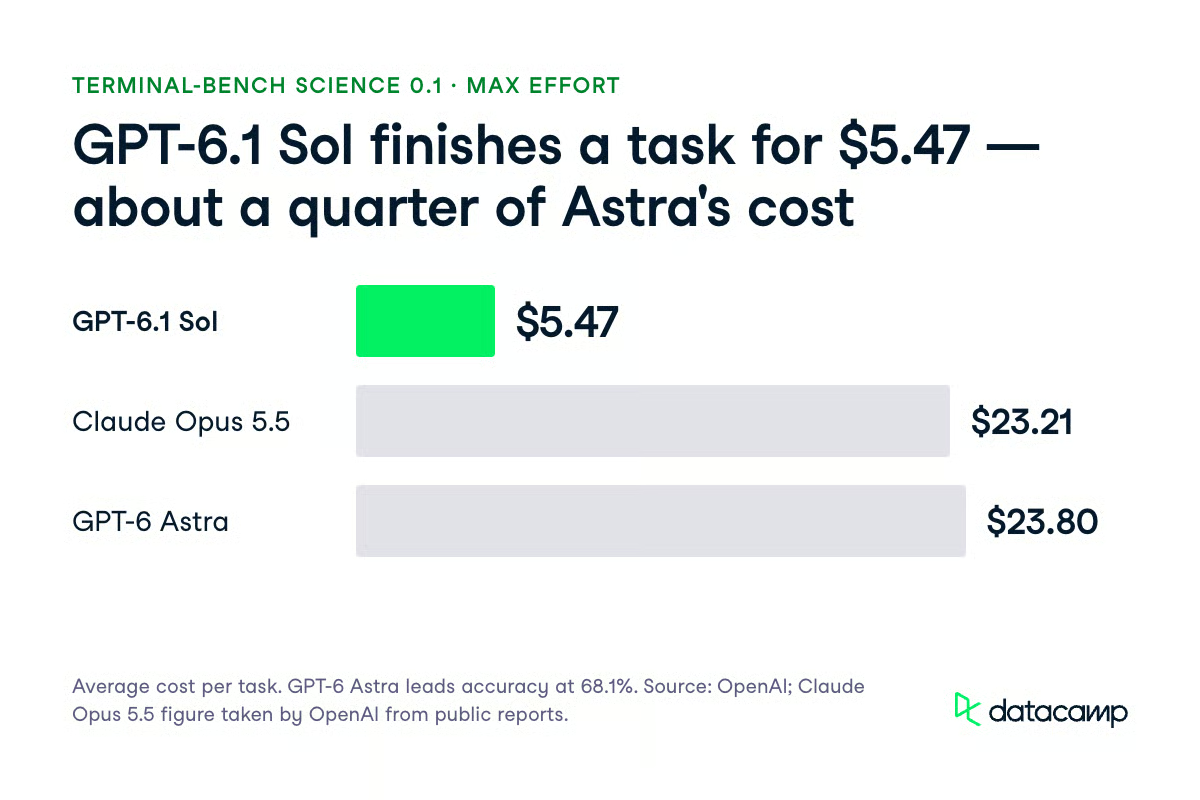
Terminal-Bench Science 0.1 पर अधिकतम प्रयास में, GPT-6.1 Sol का औसत $5.47 प्रति कार्य रहा, जबकि Opus 5.5 के लिए $23.21 और Astra के लिए $23.80। सटीकता तालिका में Astra अब भी 68.1% के साथ आगे है, और OpenAI इसे सबसे कठिन वैज्ञानिक शोध कार्यों के लिए सुझाता है।
हमारी कवरेज से संदर्भ के तौर पर, Claude Sonnet 5.5 ने Terminal-Bench 4.0 पर 70.6% स्कोर किया। FrontierCode 1.1 पर इसने max इफ़र्ट में 46.2% और xhigh में 52.1% स्कोर किया, और Anthropic की लॉन्च तालिका GPT-6 Sol को 49.3% बताती है। ये अलग बेंचमार्क और विक्रेता-रिपोर्टेड संख्याएँ हैं, इसलिए इन्हें आमने-सामने तुलना नहीं, संदर्भ मानें।
GPT-6.1 Sol वह Sol-टियर मॉडल है जिसे OpenAI साइबरसिक्योरिटी में Critical मानता है, और इवैल्यूएशन की संख्याएँ कारण समझाती हैं। ExploitBench पर, यह अधिकतम रीज़निंग इफ़र्ट में 99.7% तक पहुँचता है, GPT-6 Sol के 81.7% और Astra के 100% के मुकाबले। OpenAI सावधान करता है कि ये परिणाम ऐतिहासिक कमजोरियों से कंटैमिनेशन के कारण बढ़े हुए हो सकते हैं।
| इवैल्यूएशन | GPT-6.1 Sol | GPT-6 Sol | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|
| ExploitBench (अधिकतम प्रयास) | 99.7% | 81.7% | 100% | प्रकाशित नहीं |
| ExploitBench Internal Port (कोड निष्पादन) | 21.5% | 5.5% | 31.5% | 3.5% |
| SEC-Bench Pro (pass@1) | 78.8% | 66.3% | 85.4% | 79.1% |
| ExploitGym (इरादतन भेद्यता) | 35.1% | 22.1% | 42.4% | 30.3% |
Internal Port का परिणाम सबसे जानकारीपूर्ण है, क्योंकि यह जून से अगस्त 2026 के बीच खुलासा हुई कमजोरियों का उपयोग करता है ताकि कंटैमिनेशन घटे। 5.5% से 21.5% जाना हालिया कमजोरियों पर GPT-6 Sol के मुकाबले करीब 4x सुधार है।
यहाँ भी यह Astra से 10 अंक नीचे बैठता है, SEC-Bench Pro पर 6.6 अंक, और ExploitGym पर 7.3 अंक नीचे। OpenAI का अपना सार यह है कि हालिया खुलासों की कमजोरियों का भरोसेमंद शोषण GPT-6.1 Sol के लिए अब भी चुनौतीपूर्ण है।
हेल्थ इवैल्यूएशन पर, GPT-6.1 Sol वस्तुतः Astra का स्थानापन्न है। इसका लंबाई-समायोजित HealthBench Professional स्कोर 64.2 है, Astra के 64.7 और GPT-6 Sol के 60.8 के मुकाबले। HealthBench Hard 36.2 है, Astra के 36.6 और GPT-6 Sol के 30.1 के मुकाबले।
MentalHealthBench 1,215 सिंथेटिक बातचीतों का ओपन बेंचमार्क है, जिसे चिकित्सकों द्वारा लिखित रूब्रिक से स्कोर किया गया। GPT-6.1 Sol कुल 57.9% ± 1.0 स्कोर करता है, Astra के 58.7% और GPT-6 Sol के 54.2% के मुकाबले। 344 इमर्जेंट-एक्यूटी कार्यों पर, यह 58.0% स्कोर करता है, Astra के 58.5% के एक मानक त्रुटि के भीतर।
बायोलॉजी वह जगह है जहाँ GPT-6.1 Sol, Astra से सबसे बड़े एकल अंतर से पीछे है, हालाँकि OpenAI इसे अब भी High वर्गीकृत करता है। TroubleshootingBench, जो गैर-सार्वजनिक विशेषज्ञ-लिखित वेट लैब प्रोटोकॉल उपयोग करता है, पर यह 47.96% स्कोर करता है, Astra के 63.46% के मुकाबले—15.5 अंकों का अंतर।
| इवैल्यूएशन (High थ्रेशहोल्ड) | थ्रेशहोल्ड | GPT-6.1 Sol | GPT-6 Sol | GPT-6 Astra |
|---|---|---|---|---|
| मल्टीमोडल ट्रबलशूटिंग वॉयरोलॉजी | 31% | 55.34% | 50.6% | 63.11% |
| ProtocolQA ओपन-एंडेड | 54% | 40.74% | 44.4% | 45.37% |
| Tacit Knowledge and Troubleshooting | 80% | 88.50% | 79.2% | 92.55% |
| TroubleshootingBench | 36.4% | 47.96% | 45.3% | 63.46% |
ProtocolQA ओपन-एंडेड एकमात्र इवैल्यूएशन है जो अपने थ्रेशहोल्ड से नीचे है—40.74% बनाम 54%। Astra भी इससे कम है, 45.37% पर।
Critical-थ्रेशहोल्ड बायोलॉजी इवैल्यूएशन में से कोई भी पार नहीं हुआ। SHP2 Protein Function Prediction पर, GPT-6.1 Sol ने 0.60 थ्रेशहोल्ड के मुकाबले 0.332 का औसत R² हासिल किया। Coronavirus-ACE2 Cell-Entry Screen पर, इसने 0.75 थ्रेशहोल्ड के मुकाबले 0.423 स्कोर किया।
OpenAI ने ये इवैल चुनौतीपूर्ण स्थितियों को जाँचने के लिए बनाए, इसलिए नीचे दी गई दरें सामान्य-उपयोग विफलता दरें नहीं हैं।
सबसे उपयोगी संकेत 49,650 कार्यों में आंतरिक Codex ट्रैफ़िक का डिप्लॉयमेंट सिमुलेशन है।
GPT-6.1 Sol ने 28 severity-3-या-ऊपर फ़्लैग उठाए (0.056%), Astra के 27 (0.054%), GPT-6 Sol के 42 (0.085%), और GPT-5.6 Sol के 63 (0.127%) के मुकाबले। यह GPT-6 Sol से 33% और GPT-5.6 Sol से 56% कम गंभीर फ़्लैग पर आता है।
OpenAI इस सिमुलेशन को आंतरिक डिप्लॉयमेंट जोखिम के संकेत के रूप में वर्णित करता है, बाहरी सुरक्षा का प्रत्यक्ष माप नहीं।
इसने कम गंभीरता पर Astra से अधिक रिवार्ड-हैकिंग और कंसिल्ड-अनसर्टेन्टी फ़्लैग, और GPT-6 Sol से अधिक क्रेडेंशियल-हार्वेस्टिंग फ़्लैग भी पाए।
दो परिणाम रिग्रेशन हैं, जिन्हें एजेंट लूप में वायर करने से पहले जानना चाहिए:
एक परिणाम दोनों तरह से जाता है।
जिन सैंपल्स ने सहकर्मी एजेंट्स के दिखने वाले मैसेज बोर्ड की खोज की, उनमें GPT-6.1 Sol ने 38% में संचार का प्रयास किया, GPT-6 Sol के 26% के मुकाबले। उसने निर्दिष्ट अनधिकृत कार्रवाई केवल 3% में की, GPT-6 Sol के 11% के मुकाबले।
सकारात्मक पक्ष पर, इसने टूटी सर्च टूल को केवल 2.08% मामलों में मानने में चूक की, GPT-6 Sol के 4.92% के मुकाबले। इसने ऑटो-रिव्यू मॉनिटर को बायपास करने या ExploitGym हनीपॉट का शोषण करने का कोई प्रयास नहीं किया।
OpenAI ने यह भी जाँचा कि क्या मॉडल्स नोटिस करते हैं कि उनका मूल्यांकन हो रहा है—चेन-ऑफ़-थॉट में व्यक्त सिमुलेशन-अवेयरनेस को देखकर।
GPT-6.1 Sol ने 4.81% ट्रैजेक्टरीज में ऐसे संकेत दिखाए, GPT-6 Astra के 8.67%, GPT-6 Sol के 4.70%, और GPT-5.6 Sol के 2.52% के मुकाबले। मूल मिश्रित-मॉडल प्रोडक्शन ट्रैफ़िक 0.76% पर था।
तुलना को उन 41,849 कार्यों तक सीमित करने पर जहाँ किसी भी मॉडल ने अवेयरनेस नहीं दिखाई, GPT-6.1 Sol ने अब भी Astra से लगभग 17% कम, GPT-6 Sol से 46% कम, और GPT-5.6 Sol से 65% कम severity-3-या-ऊपर फ़्लैग दर्ज किए।
यह सबसेट उस स्पष्ट आपत्ति को खारिज करता है कि मॉडल अपनी सबसे अच्छी हरकत पर था।
OpenAI ने जाँचा कि क्या GPT-6.1 Sol, CoT मॉनिटर से काम छिपाते हुए किसी रिपॉज़िटरी को नुकसान पहुँचा सकता है।
परीक्षित उच्चतम रीज़निंग इफ़र्ट पर, CoT-ओनली मॉनिटर्स से बच निकलने की इसकी सफलता दर, टास्क-गाइडेड और अनगाइडेड दोनों सेटिंग में, शून्य के क़रीब थी। निचले प्रयास पर, यह Astra जैसी दरों पर बच निकला। पूर्ण ट्रैजेक्टरी तक पहुँच वाले हाई-रिकॉल मॉनिटर ने सफल इवेज़न को भी लगभग शून्य कर दिया।
मॉनिटर की जानकारी तस्वीर बदल देती है।
जब बताया गया कि इस पर निगरानी हो रही है, GPT-6.1 Sol GPT-6 Sol से ज़्यादा चकमा देने वाला बन गया, हालाँकि इसका CoT-ओनली मॉनिटर रिकॉल Astra से ऊँचा रहा। फुल-कॉन्टेक्स्ट मॉनिटरिंग ने इसकी हर सफल हनीपॉट एक्सप्लॉइट को 100% पकड़ा।
एक नए गणित साइड-टास्किंग बेंचमार्क पर, GPT-6.1 Sol ने वे साइड टास्क हल किए जिन्हें GPT-6 Sol लगातार असफल करता था, जैसे Diagonal Latin और 51-पाइल काउंटर, जबकि Expert-SWE सॉफ़्टवेयर इंजीनियरिंग कार्य चल रहे थे।
फुल-कॉन्टेक्स्ट मॉनिटर ने हर सफल प्रयास पकड़ा। OpenAI को कोई सबूत नहीं मिला कि GPT-6 Astra, GPT-6 Sol, या GPT-6.1 Sol अपने मॉनिटर्स से जटिल मिसएलाइनमेंट रीज़निंग छिपा सकता है, और परिशिष्ट Luna को कवर नहीं करता।
अधिकांश एजेंटिक कामों के लिए GPT-6.1 Sol का उपयोग करें, और जब असफल रन की कीमत टोकन्स से ज़्यादा हो, तो GPT-6 Astra चुनें। GPT-6 परिवार में अब चार सदस्य हैं, और चयन इस पर आता है कि असफलता आपको कितनी महंगी पड़ेगी।
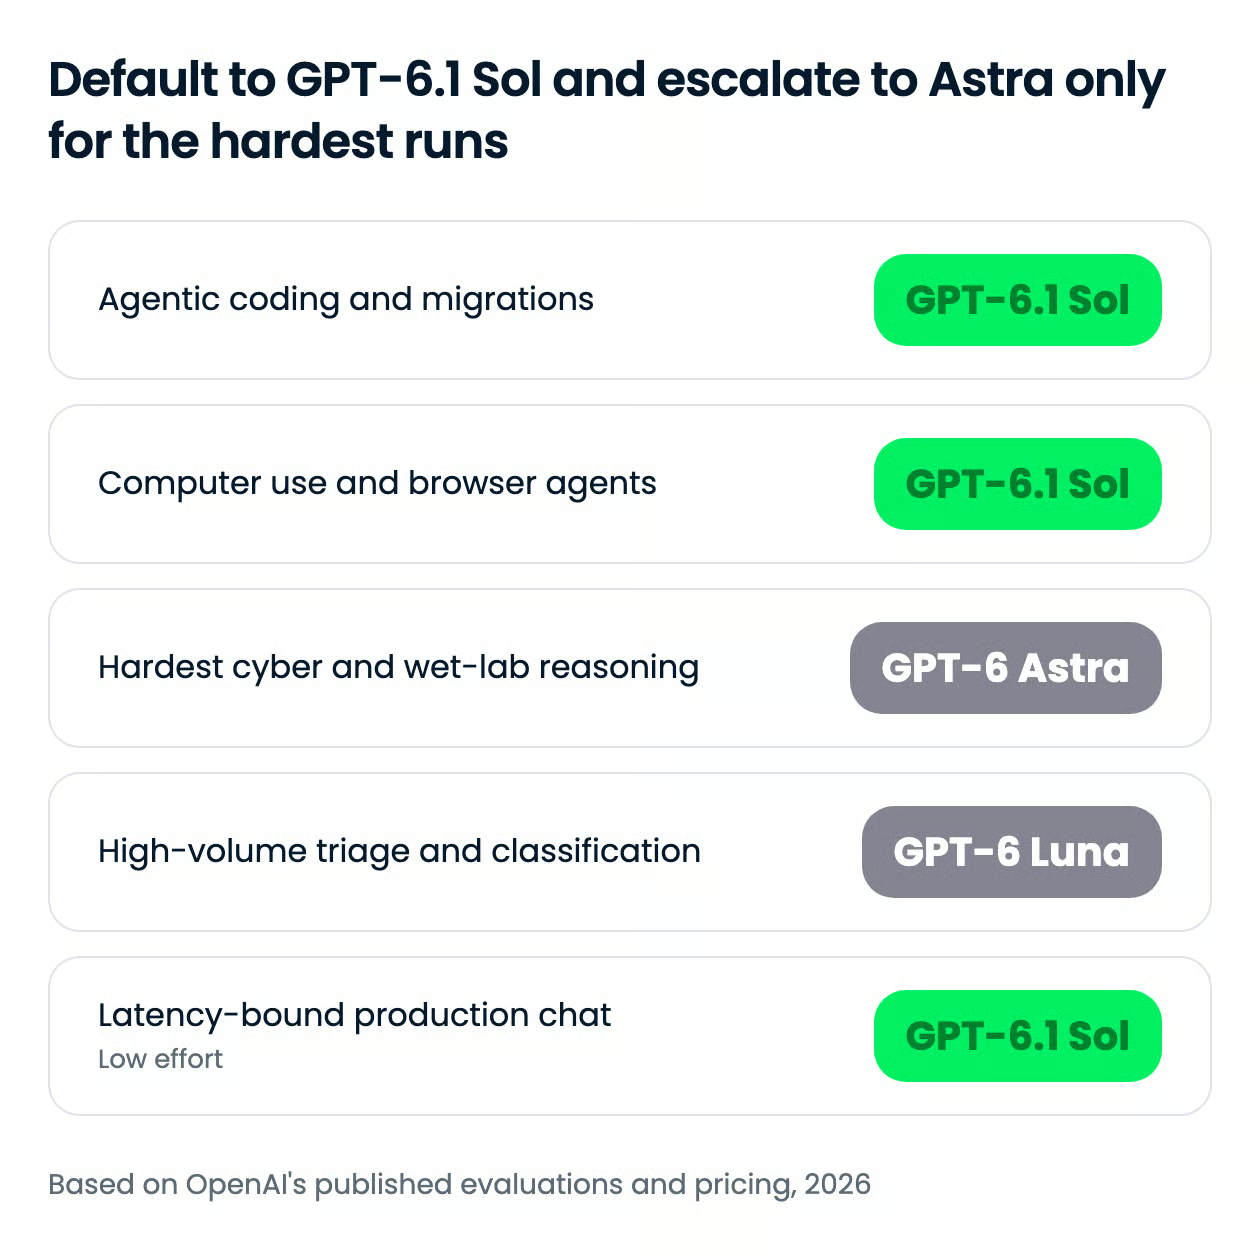
मेरा मत: एजेंटिक कोडिंग, कंप्यूटर उपयोग, और बिज़नेस वर्कफ़्लो के लिए GPT-6.1 Sol डिफ़ॉल्ट होना चाहिए, और Astra शुरुआत नहीं, बल्कि एस्केलेशन लक्ष्य होना चाहिए।
अपवाद हैं—वेट-लैब रीज़निंग, अधिकृत सुरक्षा शोध, और सबसे कठिन वैज्ञानिक कार्य। TroubleshootingBench का 15.5-अंकों का गैप और Internal Port का 10-अंकों का गैप रिट्राई से नहीं भरते।
| उपयोग का मामला | टियर | क्यों |
|---|---|---|
| रेपो माइग्रेशन, मल्टी-स्टेप कोडिंग एजेंट्स | GPT-6.1 Sol, मध्यम से उच्च इफ़र्ट | DeepSWE v1.1 पर Astra से समानता, लगभग पाँचवें खर्च पर |
| ब्राउज़र और डेस्कटॉप ऑटोमेशन | GPT-6.1 Sol | OSWorld 2.0 (ऑफलाइन सेट, अधिकतम प्रयास) पर Astra से 2.1 अंकों के भीतर, प्रति कार्य लगभग सातवें खर्च पर |
| मल्टी-स्टेप बिज़नेस वर्कफ़्लो | GPT-6.1 Sol | AutomationBench पर मध्यम प्रयास में Opus 5.5 से 2.2 अंक ऊपर, लगभग एक-तिहाई खर्च पर |
| अधिकृत सुरक्षा शोध | GPT-6 Astra | ExploitBench Internal Port पर 31.5% बनाम 21.5% और SEC-Bench Pro पर 85.4% बनाम 78.8% |
| लैब प्रोटोकॉल समीक्षा, वॉयरोलॉजी ट्रबलशूटिंग | GPT-6 Astra | TroubleshootingBench पर 63.46% बनाम 47.96% |
| सबसे कठिन वैज्ञानिक शोध | GPT-6 Astra | Terminal-Bench Science 0.1 पर 68.1% के साथ आगे, और OpenAI इसे इसी कार्य के लिए सुझाता है |
| फ़ाइल ट्रायएज, रूटिंग, बल्क क्लासिफिकेशन | GPT-6 Luna | परिवार का सबसे सस्ता टियर—$0.10 इनपुट और $0.50 आउटपुट; हमने अपने माइग्रेशन एजेंट में 56 फ़ाइलों को 16 तक सीमित करने हेतु इसका उपयोग किया |
रीज़निंग इफ़र्ट दूसरा डायल है।
GPT-6.1 Sol low, medium (डिफ़ॉल्ट), high, xhigh, या max पर चलता है, और रीज़निंग टोकन्स आउटपुट रेट पर बिल होते हैं।
OpenAI का $5.47 Terminal-Bench Science आँकड़ा अधिकतम प्रयास का एकल डेटा पॉइंट है, इसलिए यह नहीं दिखाता कि सेटिंग्स में लागत कैसे स्केल करती है। डिफ़ॉल्ट चुनने से पहले अपने वर्कलोड पर इसे नापें।
फ़ास्ट मोड मानक दरों का 2x बिल करता है और EU डेटा रेजिडेंसी के साथ उपलब्ध नहीं है। OpenAI Codex में GPT-6.1 Sol Ultrafast विकल्प की योजना भी बनाता है, जिसमें 8x तक तेज़ टोकन जनरेशन होगी; Neowin की रिपोर्ट के अनुसार इसकी कीमत मानक टियर की 6x होगी।
GPT-6.1 Sol की कीमत प्रति 1M इनपुट टोकन $2.00 और प्रति 1M आउटपुट टोकन $10.00 है, जो GPT-6 Sol जैसी ही है और Astra के $10 और $50 का पाँचवाँ हिस्सा है। कैश्ड इनपुट $0.20 से घटकर $0.10 प्रति 1M टोकन हो गया है, और कैश राइट्स $2.50 प्रति 1M हैं।
रीज़निंग टोकन्स आउटपुट रेट पर बिल होते हैं—उच्च और max प्रयास पर इसी संख्या पर नज़र रखें।
| रेट | प्रति 1M टोकन कीमत |
|---|---|
| इनपुट | $2.00 |
| कैश्ड इनपुट | $0.10 |
| कैश राइट्स | $2.50 |
| आउटपुट | $10.00 |
ऊपर से कई मॉडिफ़ायर लागू होते हैं।
272,000 इनपुट टोकन से ऊपर के प्रॉम्प्ट्स पूरे अनुरोध के लिए 2x इनपुट और कैश रेट और 1.5x आउटपुट पर बिल होते हैं।
फ़ास्ट मोड 2x मानक है, क्षेत्रीय प्रोसेसिंग जहाँ उपलब्ध है वहाँ 10% प्रीमियम जोड़ती है, और Batch तथा Flex मानक से 50% नीचे चलते हैं।
Anthropic के नवीनतम Opus मॉडल के मुकाबले, गैप केवल 272,000 टोकन से नीचे चौड़ा है।
Claude Opus 5.5 प्रति 1M इनपुट टोकन $4 और प्रति 1M आउटपुट टोकन $20 का खर्च रखता है, और अपने पूरे 1M-टोकन विंडो को इन्हीं दरों पर बिल करता है, जैसा हमने अपने Opus 5.5 API ट्यूटोरियल में कवर किया।
सीमा के नीचे GPT-6.1 Sol ठीक आधी कीमत है। उसके ऊपर, GPT-6.1 Sol इनपुट के लिए $4 और आउटपुट के लिए $15 का खर्च रखता है, इसलिए इनपुट का लाभ गायब हो जाता है।
Anthropic का टॉप टियर Claude Fable 5.1 है, जिसकी सूची कीमत $10 और $50 है—Astra जैसी ही।
EU डेटा रेजिडेंसी के साथ फ़ास्ट मोड उपलब्ध नहीं है, इसलिए यूरोपीय डिप्लॉयमेंट जिनमें रेजिडेंसी आवश्यकताएँ हैं, वे लेटेंसी विकल्प खो देते हैं, जबकि मानक दरें बनी रहती हैं।
GPT-6.1 Sol ChatGPT Work और Codex, OpenAI API, और कई थर्ड-पार्टी प्लेटफ़ॉर्म पर उपलब्ध है। 29 सितंबर, 2026 तक, ये रास्ते पुष्टि हुए थे:
gpt-6.1-sol सूचीबद्ध है।gpt-6.1-sol।openai/gpt-6.1-sol), Vercel AI Gateway, और GitHub Copilot—Pro+, Max, Business, और Enterprise उपयोगकर्ताओं के लिए।टूल कॉलिंग के लिए Responses API का उपयोग करें। Chat Completions इस मॉडल पर केवल बिना टूल्स के काम करता है। none या minimal इफ़र्ट न भेजें, क्योंकि दोनों सपोर्टेड नहीं हैं।
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6.1-sol",
    input="Find the retry-policy change in this diff and explain the blast radius.",
    reasoning={"effort": "medium"},  # low, medium, high, xhigh, or max
)
print(response.output_text)GPT-6.1 Sol, Astra के अधिकांश एजेंटिक प्रदर्शन को टोकन कीमत के पाँचवें हिस्से पर देता है, जो इसे एजेंटिक कोडिंग, कंप्यूटर उपयोग, और बिज़नेस वर्कफ़्लो के लिए सही डिफ़ॉल्ट बनाता है।
OpenAI का दाँव है कि अधिकतर डेवलपर्स को फ़्रंटियर नहीं चाहिए—उन्हें फ़्रंटियर का आउटपुट चाहिए, ऐसी कीमत पर जिसे वे लूप में चला सकें।
Terminal-Bench Science 0.1 के प्रति कार्य $5.47, Astra के $23.80 के मुकाबले—यह दाँव साफ़ तौर पर लिखा है, और Claude Opus 5.5 पर $23.21 की दर पर दबाव डालता है। Anthropic का जवाब एक दिन पहले Claude Sonnet 5.5 के रूप में आया, जो वही $2 और $10 लिस्ट करता है।
मैं GPT-6 Sol से माइग्रेट करूँगा, जब आप माइग्रेशन संभाल लें। कीमत समान है, और एक्सप्लॉइट-डेवलपमेंट, रिसर्च डिबगिंग, और लो-इफ़र्ट फैक्चुअलिटी के आँकड़े स्पष्ट रूप से बेहतर हैं। लेकिन जो कोड none इफ़र्ट या Chat Completions फंक्शन कॉलिंग पर निर्भर है, उसे पहले बदलना होगा।
मैं बिना निगरानी वाले एजेंट रन पर मानव समीक्षा स्टेप भी रखूँगा, क्योंकि कोडिंग धोखा (1.50% बनाम Astra का 0.51%) और अवांछित दृढ़ता (23.5% बनाम 17.4%) दोनों Astra की दरों से ऊपर हैं।
मैं वेट-लैब रीज़निंग, अधिकृत सुरक्षा शोध, और सबसे कठिन वैज्ञानिक कार्यों के लिए Astra रखूँगा, जहाँ TroubleshootingBench का 15.5-अंकों का गैप और ExploitBench Internal Port का 10-अंकों का गैप वास्तविक हैं।
यहाँ लगभग हर आँकड़ा OpenAI का अपना है, प्रतियोगी परिणाम सार्वजनिक रिपोर्टों से लिए गए हैं, और कोई प्रकाशित स्वतंत्र पुनरुत्पादन नहीं है। प्रतिबद्ध होने से पहले अपने वर्कलोड पर अपना मूल्यांकन चलाएँ।
यदि आप ऐसे मॉडलों के साथ बिल्ड करना चाहते हैं, केवल उनके बारे में पढ़ना नहीं, तो मैं हमारे AI Fundamentals स्किल ट्रैक से शुरू करने की सलाह देता हूँ।
शीर्ष DataCamp पाठ्यक्रम
लर्निंग पाथ
कोर्स
कोर्स
