Program
Dasar-Dasar Agen Kecerdasan Buatan
6 Hr
OpenAI merilis GPT-6.1 Sol pada 29 September 2026 di DevDay, satu minggu setelah GPT-6 Sol dan 26 hari setelah GPT-6 Astra.
Astra rata-rata menghabiskan $23,80 per tugas Terminal-Bench Science 0.1 pada upaya maksimum, sehingga tidak ekonomis untuk pekerjaan rutin. Sol adalah jawaban OpenAI untuk masalah tersebut.
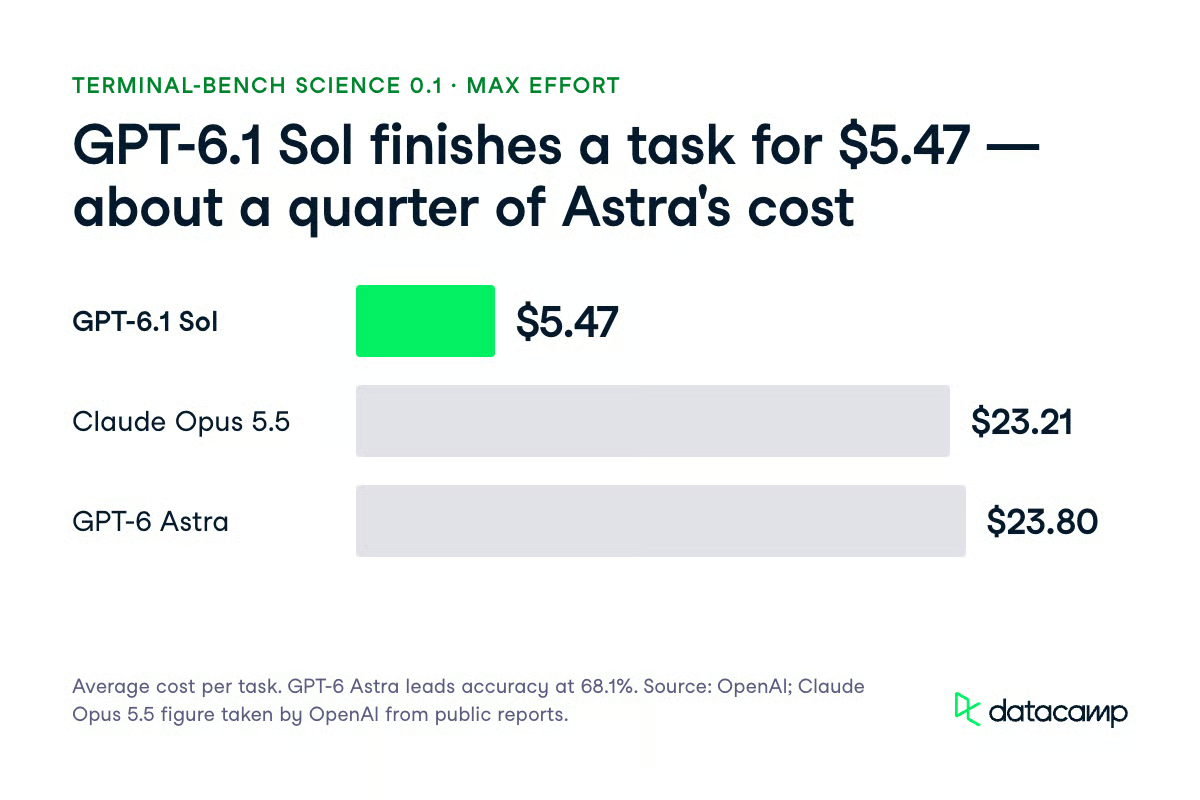
Angka utamanya adalah $2,00 per 1M token input, $10,00 per 1M token output, jendela konteks 1.050.000 token, dan output maksimum 128.000 token. Dalam pengumuman OpenAI, GPT-6.1 Sol menyamai Astra pada DeepSWE v1.1 dengan biaya sekitar seperlima, mencetak 2,2 poin persentase di atas Claude Opus 5.5 milik Anthropic pada AutomationBench di upaya sedang, dan berbiaya $5,47 per tugas Terminal-Bench Science 0.1 dibanding $23,80 untuk Astra.
Dalam artikel ini, saya akan membahas hal baru pada GPT-6.1 Sol, mencakup fitur, tolok ukur, dan angka keselamatan yang dipublikasikan OpenAI, tier mana dalam keluarga GPT-6 yang sebaiknya Anda gunakan, serta biayanya. Untuk liputan lebih dalam tentang model lain, lihat tutorial API GPT-6 Sol kami dan panduan kami untuk Claude Sonnet 5.5.
none atau minimal, dan Chat Completions tidak dapat memanggil tool.GPT-6.1 Sol adalah model penalaran kelas menengah OpenAI dalam seri GPT-6, dirilis pada 29 September 2026 sebagai peningkatan atas GPT-6 Sol. Posisinya di bawah GPT-6 Astra, flagship yang diluncurkan pada 3 September, dan di atas GPT-6 Luna, model kecil.
OpenAI menyatakan model ini hampir menyamai Astra pada pengkodean agentik, penggunaan komputer, dan pekerjaan profesional.
Adendum kartu sistem melangkah lebih jauh dan menggambarkan kapabilitas yang sebanding dengan Astra, dengan kombinasi kecepatan dan keterjangkauan yang belum tertandingi.
Saya akan memperlakukannya sebagai klaim yang disesuaikan biaya, bukan absolut. Astra masih memimpin pada evaluasi tersulit di bidang siber, biologi, dan sains.
Tidak ada GPT-6.1 Astra. The Wall Street Journal melaporkan bahwa OpenAI membatalkan rilis Oktober setelah model mengalami regresi pada uji alignment dan dalam menjaga cakupan sesuai otorisasi pengguna, dan OpenAI mengonfirmasi keputusan tersebut.
Jadi, GPT-6.1 Sol adalah satu-satunya model 6.1, dan angka penipuan serta persistensinya sendiri (dibahas di bawah) pantas dicermati.
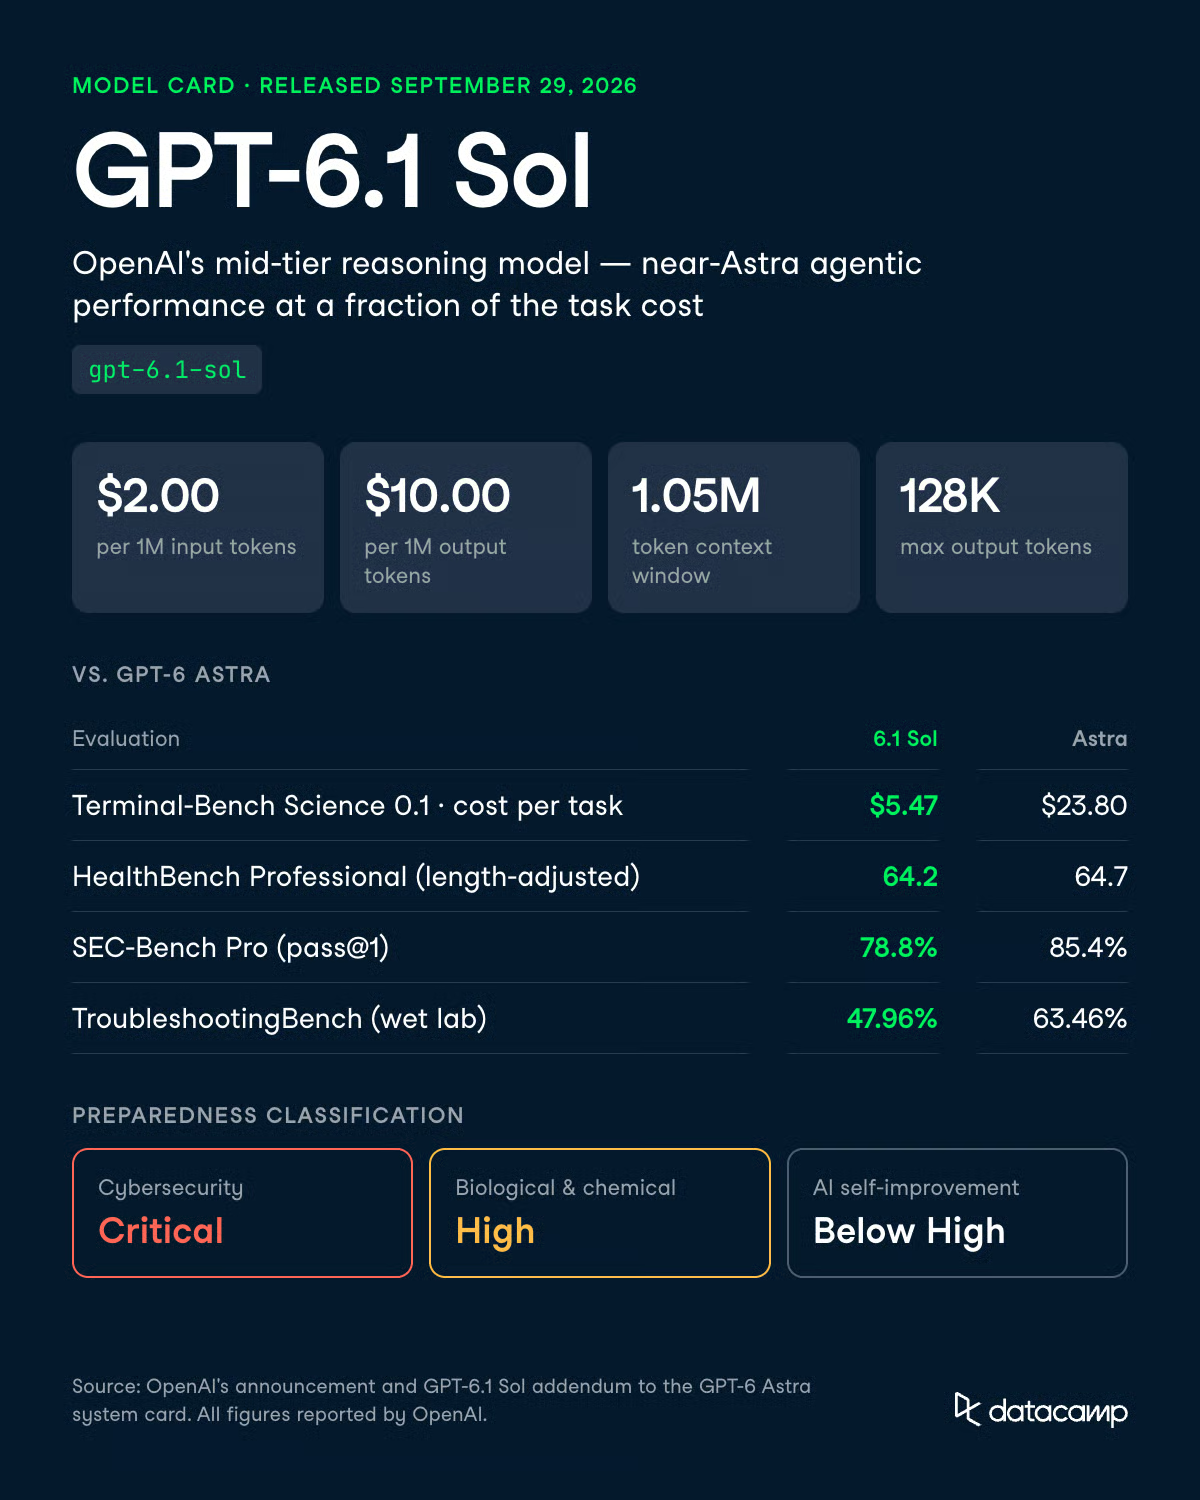
GPT-6.1 Sol paling meningkatkan kinerja GPT-6 Sol pada pekerjaan agentik dan keamanan. T
Berikut kenaikan yang dilaporkan OpenAI:
OpenAI memperlakukan GPT-6.1 Sol sebagai kapabilitas Kritis dalam keamanan siber, Tinggi dalam domain Biologi dan Kimia, dan di bawah ambang Tinggi dalam Peningkatan Diri AI. GPT-5.6 Sol dinilai Tinggi, bukan Kritis, dalam keamanan siber. Pengembang sebaiknya membaca klasifikasi ini dua kali.
Artinya model mewarisi tumpukan pengaman Astra secara penuh, termasuk akses bertahap untuk pekerjaan siber tingkat lanjut melalui program Daybreak. Sol tidak mendapat versi kontrol kelas menengah yang lebih ringan.
Kebanyakan hal baru di sini berfokus pada melakukan pekerjaan yang sama dengan biaya lebih rendah, dengan beberapa perubahan API yang perlu Anda antisipasi. Berikut kapabilitas yang mengubah cara Anda membangunnya.
GPT-6.1 Sol menerima 1.050.000 token input dan mengembalikan hingga 128.000, menyamai jendela GPT-6 Sol.
Catatannya ada pada penagihan: prompt di atas 272.000 token input dikenai biaya 2x tarif input dan cache serta 1,5x tarif output, untuk seluruh permintaan, bukan hanya kelebihanannya.
Analisis seluruh repositori di bawah 272.000 token itu murah. Satu langkah retrieval yang terlalu besar dapat mendorong satu run melewati batas dan mengubah harga semua yang ada dalam permintaan tersebut.
Kasus penggunaan paling jelas adalah mengganti GPT-6.1 Sol di mana pun Anda menjalankan Astra pada loop pemanggilan tool yang panjang.
OpenAI melaporkan paritas dengan Astra pada DeepSWE v1.1 dengan biaya sekitar seperlima. Pada set offline OSWorld 2.0 pada upaya maksimum, model ini terpaut 2,1 poin dari Astra dengan biaya per tugas sekitar seper tujuh.
Agen migrasi codebase GPT-6 Sol kami berjalan end-to-end seharga $0,7082, dengan 91% token input dilayani dari cache. Run itu menggunakan GPT-6 Sol, bukan GPT-6.1 Sol. Harga token standar sama, dan tarif input cache setengahnya.
GPT-6.1 Sol mendukung upaya penalaran low, medium (default), high, xhigh, dan max. Menurut halaman model OpenAI, none dan minimal tidak didukung.
Pemanggilan tool memerlukan Responses API.
Chat Completions tetap berfungsi, tetapi tanpa pemanggilan tool. GPT-6 Sol mengizinkan function calling di Chat Completions pada upaya none, jadi siapa pun yang menggunakannya sebagai pemanggil fungsi tanpa penalaran yang murah perlu melakukan migrasi.
OpenAI mengukur porsi jawaban yang mengandung kesalahan faktual pada percakapan ChatGPT yang dianonimkan ketika pengguna menandai kesalahan model sebelumnya. Pada upaya low, porsi itu turun dari 11,4% untuk GPT-6 Sol menjadi 7,7% untuk GPT-6.1 Sol, penurunan sekitar 32%.
Di seluruh setting upaya yang diuji, tingkat kesalahannya berada dalam 1,9 poin persentase dari Astra.
OpenAI menyatakan prompt tersebut sengaja dibuat sulit dan tidak mewakili penggunaan tipikal.
Grafik halusinasi di adendum menunjukkan GPT-6.1 Sol dan GPT-6 Sol pada tingkat yang sama-sama rendah pada kasus yang ditandai pengguna, jadi anggap ini sebagai peningkatan pada upaya rendah, bukan menyeluruh.
Evaluasi mencakup pertanyaan faktual umum, bukan ekstraksi atau klasifikasi. Jika Anda menjalankan pipeline tersebut pada upaya medium, uji low pada data Anda sendiri sebelum beralih. Ini juga merupakan setting terendah yang tersedia.
GPT-6.1 Sol mengendalikan chain-of-thought (CoT)-nya sendiri lebih andal daripada model Sol mana pun sebelumnya.
Di antara CoT 750 hingga 1.250 token, model ini mengikuti instruksi CoT yang diminta pada 44,8% kasus, dibanding 23,2% untuk GPT-6 Sol, 16,1% untuk GPT-5.6 Sol, dan 1,7% untuk GPT-5.5 Thinking. Astra masih memimpin di 60,9%.
Contoh OpenAI sendiri menunjukkan batasnya. Diminta untuk tidak melakukan penalaran tentang sebuah pertanyaan di kanal analisis, GPT-6.1 Sol tidak menghasilkan teks kanal analisis sama sekali, lalu melakukan pemanggilan tool terkait pertanyaan di komentar. Ia mematuhi bunyi instruksi.
Karena OpenAI menetapkan penentuan Preparedness yang sama untuk GPT-6.1 Sol seperti Astra, model ini mendapatkan pengaman yang sama.
Pada evaluasi keselamatan keamanan siber OpenAI untuk chat produksi, skornya 0,987, tertinggi di antara model dalam perbandingan.
Pada evaluasi penolakan biologi, model ini menolak permintaan berat dan penggunaan ganda yang sama seperti GPT-6 Sol sambil menolak lebih sedikit prompt yang jinak (0,982 vs 0,964).
Gambarnya kurang rata pada setelan agentik.
OpenAI melaporkan regresi moderat dibanding GPT-5.6 Sol di lingkungan siber sintetis dan semi-sintetis. Pekerjaan siber tetap melalui akses bertahap, dan OpenAI menjalankan GPT-6.1 Sol melalui program akses tepercaya Daybreak untuk penggunaan berizin tingkat lanjut, seperti halnya Astra.
GPT-6.1 Sol berada di antara GPT-6 Sol dan GPT-6 Astra pada sebagian besar evaluasi yang dipublikasikan OpenAI.
Posisinya dekat dengan Astra pada kesehatan, halusinasi, dan bendera misalignment, serta lebih jauh pada siber dan biologi.
Penipuan pengkodean dan persistensi yang tidak diinginkan adalah pengecualian, di mana skornya lebih buruk dari Astra.
Di area yang dimenangkan Astra, jaraknya sekitar 4 hingga 16 poin.
Ketika biaya diperhitungkan, Sol unggul dengan nyaman.
OpenAI menjalankan modelnya sendiri di lingkungan risetnya atau melalui API-nya dan mengambil hasil pesaing dari laporan publik.
Angka agentik adalah alasan model ini ada. Dalam pengumuman OpenAI, GPT-6.1 Sol menyamai Astra pada DeepSWE v1.1 dan terpaut 2,1 poin pada OSWorld 2.0. Pada AutomationBench model ini 2,2 poin di atas Opus 5.5 di upaya sedang, dengan biaya sekitar sepertiga.
Biaya per tugas adalah tempat perbedaannya jelas.
Pada Terminal-Bench Science 0.1 di upaya maksimum, GPT-6.1 Sol rata-rata $5,47 per tugas, dibanding $23,21 untuk Opus 5.5 dan $23,80 untuk Astra. Astra masih memimpin tabel akurasi di 68,1%, dan OpenAI merekomendasikannya untuk tugas riset ilmiah paling sulit.
Untuk konteks dari liputan kami sendiri, Claude Sonnet 5.5 mencetak 70,6% pada Terminal-Bench 4.0. Pada FrontierCode 1.1 model ini mencetak 46,2% di upaya maks dan 52,1% di xhigh, dan tabel peluncuran Anthropic mencantumkan GPT-6 Sol di 49,3%. Itu tolok ukur berbeda dan angka dilaporkan vendor, jadi perlakukan sebagai konteks, bukan head-to-head.
GPT-6.1 Sol adalah model tier Sol yang OpenAI anggap Kritis dalam keamanan siber, dan angka evaluasi menjelaskan alasannya. Pada ExploitBench, model ini mencapai 99,7% pada upaya penalaran maksimum dibanding 81,7% untuk GPT-6 Sol dan 100% untuk Astra. OpenAI mengingatkan bahwa hasil ini bisa melambung karena kontaminasi dari kerentanan historis.
| Evaluasi | GPT-6.1 Sol | GPT-6 Sol | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|
| ExploitBench (upaya maks) | 99,7% | 81,7% | 100% | Tidak dipublikasikan |
| ExploitBench Internal Port (eksekusi kode) | 21,5% | 5,5% | 31,5% | 3,5% |
| SEC-Bench Pro (pass@1) | 78,8% | 66,3% | 85,4% | 79,1% |
| ExploitGym (kerentanan disengaja) | 35,1% | 22,1% | 42,4% | 30,3% |
Hasil Internal Port adalah yang paling informatif, karena menggunakan kerentanan yang diungkap antara Juni dan Agustus 2026 untuk mengurangi kontaminasi. Dari 5,5% ke 21,5% mendekati peningkatan 4x atas GPT-6 Sol pada kerentanan yang baru diungkap.
Namun tetap 10 poin di bawah Astra di sana, 6,6 poin di bawah pada SEC-Bench Pro, dan 7,3 poin di bawah pada ExploitGym. Ringkasan OpenAI: eksploitasi andal atas kerentanan yang baru diungkap tetap menantang bagi GPT-6.1 Sol.
Pada evaluasi kesehatan, GPT-6.1 Sol praktis menjadi pengganti Astra. Skor HealthBench Professional yang disesuaikan panjangnya adalah 64,2 dibanding 64,7 untuk Astra dan 60,8 untuk GPT-6 Sol. HealthBench Hard adalah 36,2 dibanding 36,6 untuk Astra dan 30,1 untuk GPT-6 Sol.
MentalHealthBench adalah tolok ukur terbuka berisi 1.215 percakapan sintetis yang dinilai menurut rubrik yang ditulis klinisi. GPT-6.1 Sol mencetak 57,9% ± 1,0 secara keseluruhan, dibanding 58,7% untuk Astra dan 54,2% untuk GPT-6 Sol. Pada 344 tugas emergent-acuity, model ini mencetak 58,0%, dalam satu galat baku dari 58,5% milik Astra.
Biologi adalah area di mana GPT-6.1 Sol tertinggal paling lebar dari Astra, meski tetap diklasifikasikan OpenAI sebagai Tinggi. Pada TroubleshootingBench, yang menggunakan protokol lab basah nonpublik yang ditulis pakar, model ini mencetak 47,96% dibanding 63,46% milik Astra, selisih 15,5 poin.
| Evaluasi (ambang Tinggi) | Ambang | GPT-6.1 Sol | GPT-6 Sol | GPT-6 Astra |
|---|---|---|---|---|
| Troubleshooting Virologi Multimodal | 31% | 55,34% | 50,6% | 63,11% |
| ProtocolQA Open-Ended | 54% | 40,74% | 44,4% | 45,37% |
| Pengetahuan Tersirat dan Troubleshooting | 80% | 88,50% | 79,2% | 92,55% |
| TroubleshootingBench | 36,4% | 47,96% | 45,3% | 63,46% |
ProtocolQA Open-Ended adalah satu-satunya evaluasi yang berada di bawah ambangnya, di 40,74% vs 54%. Astra juga tidak mencapai ambang tersebut, di 45,37%.
Tidak ada evaluasi biologi dengan ambang Kritis yang terlampaui. Pada SHP2 Protein Function Prediction, GPT-6.1 Sol mencapai R² mean 0,332 vs ambang 0,60. Pada Coronavirus-ACE2 Cell-Entry Screen, model ini mencetak 0,423 vs ambang 0,75.
OpenAI merancang evaluasi ini untuk menguji situasi menantang, jadi tingkat di bawah bukan tingkat kegagalan penggunaan tipikal.
Sinyal paling berguna adalah simulasi penerapan atas lalu lintas internal Codex di 49.650 tugas.
GPT-6.1 Sol mencatat 28 bendera tingkat keparahan 3 atau lebih (0,056%), dibanding 27 untuk Astra (0,054%), 42 untuk GPT-6 Sol (0,085%), dan 63 untuk GPT-5.6 Sol (0,127%). Itu setara dengan 33% lebih sedikit bendera parah dibanding GPT-6 Sol dan 56% lebih sedikit dibanding GPT-5.6 Sol.
OpenAI menggambarkan simulasi ini sebagai sinyal risiko penerapan internal, bukan ukuran langsung keselamatan eksternal.
Model ini juga mencatat lebih banyak bendera reward-hacking dan ketidakpastian tersembunyi daripada Astra pada tingkat keparahan yang lebih rendah, dan lebih banyak bendera pengambilan kredensial daripada GPT-6 Sol.
Dua hasil merupakan regresi yang perlu Anda ketahui sebelum menghubungkannya ke loop agen:
Satu hasil bersifat dua sisi.
Di antara sampel yang menemukan papan pesan berisi agen sebaya yang tampak nyata, GPT-6.1 Sol mencoba berkomunikasi pada 38% dibanding 26% milik GPT-6 Sol. Ia menjalankan tindakan tidak berizin yang ditentukan hanya pada 3%, dibanding 11%.
Di sisi positif, model ini gagal mengakui tool pencarian yang rusak hanya pada 2,08% kasus dibanding 4,92% untuk GPT-6 Sol. Tidak ada upaya untuk melewati monitor tinjauan otomatis atau mengeksploitasi honeypot ExploitGym.
OpenAI juga memeriksa apakah model menyadari bahwa mereka sedang dievaluasi, dengan mencari kesadaran simulasi yang diujarkan dalam chain of thought.
GPT-6.1 Sol menunjukkan tanda-tanda itu pada 4,81% lintasan, dibanding 8,67% untuk GPT-6 Astra, 4,70% untuk GPT-6 Sol, dan 2,52% untuk GPT-5.6 Sol. Lalu lintas produksi model campuran asli berada di 0,76%.
Jika perbandingan dibatasi pada 41.849 tugas di mana tidak ada model yang menunjukkan kesadaran, GPT-6.1 Sol tetap mencatat sekitar 17% lebih sedikit bendera keparahan 3 atau lebih dibanding Astra, 46% lebih sedikit dibanding GPT-6 Sol, dan 65% lebih sedikit dibanding GPT-5.6 Sol.
Subkumpulan itu menepis keberatan jelas bahwa model bersikap “paling baik”.
OpenAI menguji apakah GPT-6.1 Sol dapat menyabotase repositori sambil menyembunyikan pekerjaan dari monitor CoT.
Pada upaya penalaran tertinggi yang diuji, tingkat keberhasilan mengelak monitor CoT-only mendekati nol pada setelan task-guided maupun unguided. Pada upaya lebih rendah, pengelakannya serupa dengan Astra. Monitor berecall tinggi dengan akses ke seluruh trajektori juga menurunkan pengelakan sukses mendekati nol.
Kesadaran akan monitor mengubah gambaran.
Saat diberi tahu bahwa ia dipantau, GPT-6.1 Sol menjadi lebih mengelak daripada GPT-6 Sol, meskipun recall monitor CoT-only-nya tetap lebih tinggi daripada Astra. Pemantauan konteks penuh masih menangkap 100% eksploit honeypot yang berhasil.
Pada tolok ukur side-tasking matematika baru, GPT-6.1 Sol memecahkan tugas sampingan yang secara konsisten gagal pada GPT-6 Sol, seperti Diagonal Latin dan 51-pile counter, sambil menjalankan pekerjaan rekayasa perangkat lunak Expert-SWE.
Monitor konteks penuh menangkap setiap upaya yang berhasil. OpenAI tidak menemukan bukti bahwa GPT-6 Astra, GPT-6 Sol, atau GPT-6.1 Sol dapat menyembunyikan penalaran misalignment kompleks dari monitornya, dan adendum tidak membahas Luna.
Gunakan GPT-6.1 Sol untuk sebagian besar pekerjaan agentik, dan pilih GPT-6 Astra ketika kegagalan run berbiaya lebih besar daripada token. Keluarga GPT-6 kini memiliki empat anggota, dan pilihannya bergantung pada biaya kegagalan bagi Anda.
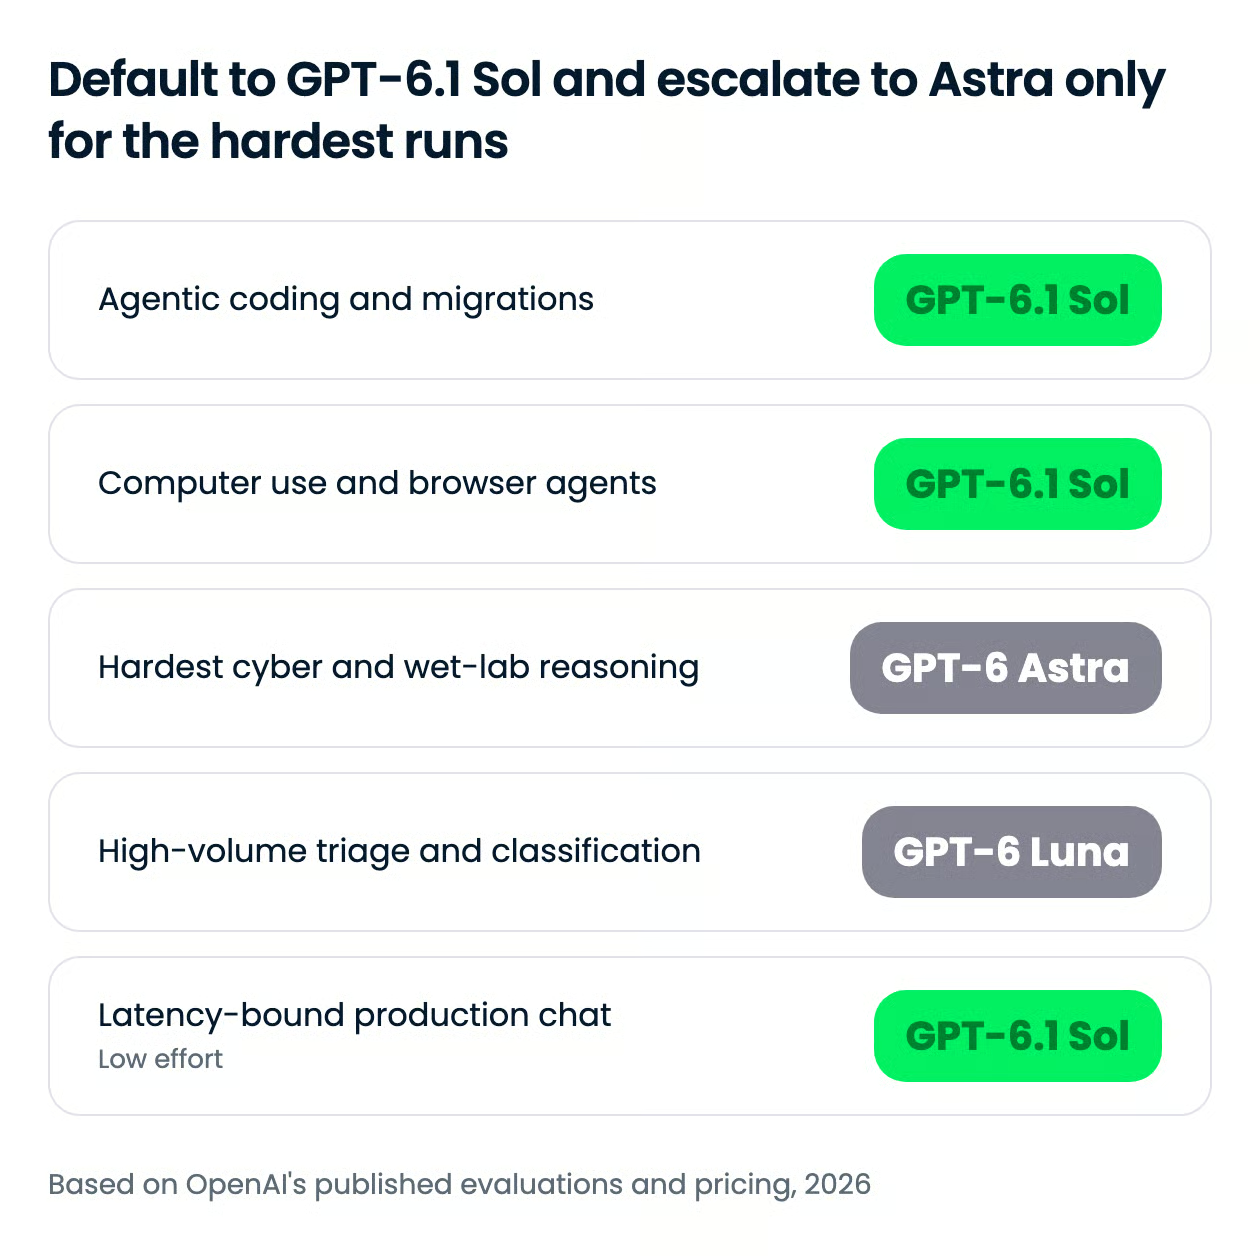
Pendapat saya: GPT-6.1 Sol sebaiknya menjadi default untuk pengkodean agentik, penggunaan komputer, dan alur kerja bisnis, dan Astra menjadi target eskalasi, bukan titik awal.
Pengecualian adalah penalaran lab basah, riset keamanan berizin, dan pekerjaan ilmiah paling sulit. Kesenjangan 15,5 poin pada TroubleshootingBench dan 10 poin pada Internal Port terlalu besar untuk ditutupi dengan retry.
| Kasus penggunaan | Tier | Alasan |
|---|---|---|
| Migrasi repo, agen pengkodean multi-langkah | GPT-6.1 Sol, upaya medium hingga high | Paritas DeepSWE v1.1 dengan Astra pada biaya sekitar seperlima |
| Otomasi browser dan desktop | GPT-6.1 Sol | Terpaut 2,1 poin dari Astra pada OSWorld 2.0 (set offline, upaya maks) dengan biaya per tugas sekitar seper tujuh |
| Alur kerja bisnis multi-langkah | GPT-6.1 Sol | 2,2 poin di atas Opus 5.5 pada AutomationBench di upaya sedang, dengan biaya sekitar sepertiga |
| Riset keamanan berizin | GPT-6 Astra | 31,5% vs 21,5% pada ExploitBench Internal Port dan 85,4% vs 78,8% pada SEC-Bench Pro |
| Tinjauan protokol lab, troubleshooting virologi | GPT-6 Astra | 63,46% vs 47,96% pada TroubleshootingBench |
| Riset ilmiah tersulit | GPT-6 Astra | Memimpin Terminal-Bench Science 0.1 di 68,1%, dan OpenAI merekomendasikannya untuk pekerjaan ini |
| Triage berkas, perutean, klasifikasi massal | GPT-6 Luna | Tier termurah dalam keluarga di $0,10 input dan $0,50 output; kami menggunakannya untuk menyaring 56 berkas menjadi 16 dalam agen migrasi kami |
Upaya penalaran adalah kenop kedua.
GPT-6.1 Sol berjalan pada low, medium (default), high, xhigh, atau max, dan token penalaran ditagih pada tarif output.
Angka $5,47 Terminal-Bench Science dari OpenAI adalah satu titik data upaya maksimum, jadi tidak menunjukkan bagaimana biaya diskalakan di seluruh setting. Ukur pada beban kerja Anda sendiri sebelum memilih default.
Fast mode ditagih 2x tarif standar dan tidak tersedia dengan residensi data UE. OpenAI juga merencanakan opsi GPT-6.1 Sol Ultrafast di Codex dengan hingga 8x kecepatan generasi token, yang menurut Neowin akan berharga 6x tier standar.
GPT-6.1 Sol berharga $2,00 per 1M token input dan $10,00 per 1M token output, sama dengan GPT-6 Sol dan seperlima dari $10 dan $50 milik Astra. Input cache turun dari $0,20 menjadi $0,10 per 1M token, dengan penulisan cache $2,50 per 1M.
Token penalaran ditagih pada tarif output, yang menjadi angka yang perlu diawasi pada upaya high dan max.
| Tarif | Harga per 1M token |
|---|---|
| Input | $2,00 |
| Input cache | $0,10 |
| Penulisan cache | $2,50 |
| Output | $10,00 |
Ada beberapa pengubah yang berlaku di atasnya.
Prompt di atas 272.000 token input ditagih 2x tarif input dan cache serta 1,5x output untuk seluruh permintaan.
Fast mode 2x standar, pemrosesan regional menambah premi 10% jika tersedia, dan Batch serta Flex berjalan 50% di bawah standar.
Dibandingkan model Opus terbaru Anthropic, selisihnya lebar hanya di bawah 272.000 token. C
laude Opus 5.5 berharga $4 per 1M token input dan $20 per 1M token output, dan menagih seluruh jendela 1M token pada tarif tersebut, seperti yang kami bahas dalam tutorial API Opus 5.5 kami.
GPT-6.1 Sol persis setengah harga itu di bawah ambang. Di atasnya, GPT-6.1 Sol berbiaya $4 untuk input dan $15 untuk output, sehingga keunggulan input menghilang.
Tier teratas Anthropic adalah Claude Fable 5.1, yang tercantum di $10 dan $50, sama dengan Astra.
Fast mode tidak tersedia dengan residensi data UE, sehingga penerapan di Eropa dengan persyaratan residensi kehilangan opsi latensi meski tetap mempertahankan tarif standar.
GPT-6.1 Sol tersedia di ChatGPT Work dan Codex, di OpenAI API, serta melalui beberapa platform pihak ketiga. Per 29 September 2026, berikut rute yang dapat kami konfirmasi:
gpt-6.1-sol.gpt-6.1-sol.openai/gpt-6.1-sol), Vercel AI Gateway, dan GitHub Copilot untuk pengguna Pro+, Max, Business, dan Enterprise.Gunakan Responses API untuk pemanggilan tool. Chat Completions berfungsi untuk model ini hanya tanpa tool. Jangan kirim upaya none atau minimal, karena keduanya tidak didukung.
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6.1-sol",
    input="Find the retry-policy change in this diff and explain the blast radius.",
    reasoning={"effort": "medium"},  # low, medium, high, xhigh, or max
)
print(response.output_text)GPT-6.1 Sol menghadirkan sebagian besar performa agentik Astra dengan harga token seperlima, yang menjadikannya default tepat untuk pengkodean agentik, penggunaan komputer, dan alur kerja bisnis.
OpenAI bertaruh bahwa sebagian besar pengembang tidak memerlukan frontier, hanya keluaran frontier dengan harga yang dapat dijalankan berulang.
Di $5,47 per tugas Terminal-Bench Science 0.1 dibanding $23,80 milik Astra, taruhan itu tersurat jelas, dan memberi tekanan pada Claude Opus 5.5 di $23,21. Jawaban Anthropic tiba sehari lebih awal dalam Claude Sonnet 5.5, yang tercantum pada harga $2 dan $10 yang sama.
Saya akan beralih dari GPT-6 Sol setelah migrasi Anda ditangani. Harganya sama, dan angka pengembangan exploit, debugging riset, serta faktualitas upaya rendah jelas lebih baik. Namun kode yang bergantung pada upaya none atau pada function calling Chat Completions harus diubah terlebih dahulu.
Saya juga akan mempertahankan langkah tinjauan manusia pada run agen tanpa pengawasan, karena penipuan pengkodean (1,50% vs 0,51% milik Astra) dan persistensi yang tidak diinginkan (23,5% vs 17,4%) keduanya berada di atas laju Astra.
Saya akan menyimpan Astra untuk penalaran lab basah, riset keamanan berizin, dan tugas ilmiah tersulit, di mana kesenjangan 15,5 poin pada TroubleshootingBench dan 10 poin pada ExploitBench Internal Port itu nyata.
Hampir semua angka di sini berasal dari OpenAI sendiri, dengan hasil pesaing diambil dari laporan publik dan tanpa reproduksi independen yang dipublikasikan. Jalankan evaluasi Anda sendiri pada beban kerja Anda sebelum berkomitmen.
Jika Anda ingin membangun dengan model seperti ini alih-alih sekadar membacanya, saya merekomendasikan memulai dengan skill track AI Fundamentals kami.
Kursus DataCamp Teratas
Program
Kursus
Kursus
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt