programa
Fundamentos de agentes de IA
6 h
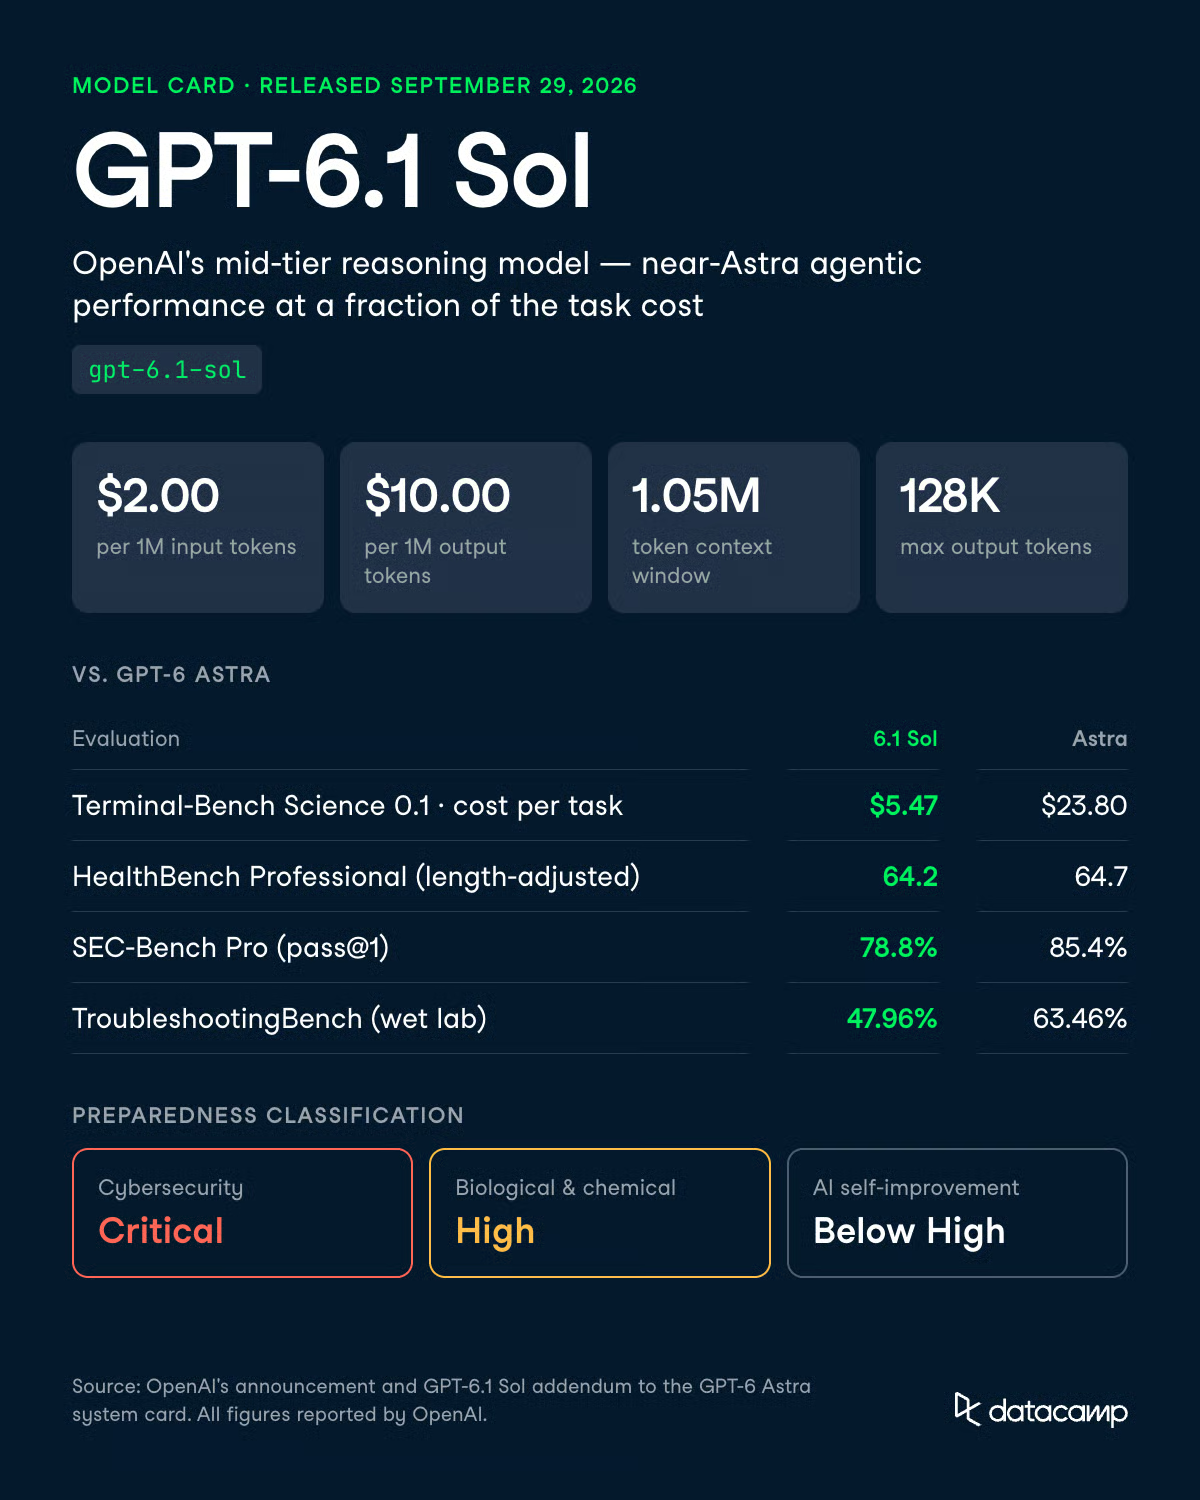
OpenAI lanzó GPT-6.1 Sol el 29 de septiembre de 2026 en DevDay, una semana después de GPT-6 Sol y 26 días después de GPT-6 Astra.
Astra promediaba $23.80 por tarea en Terminal-Bench Science 0.1 al máximo esfuerzo, lo que lo dejaba fuera de trabajos rutinarios. Sol es la respuesta de OpenAI a ese problema.
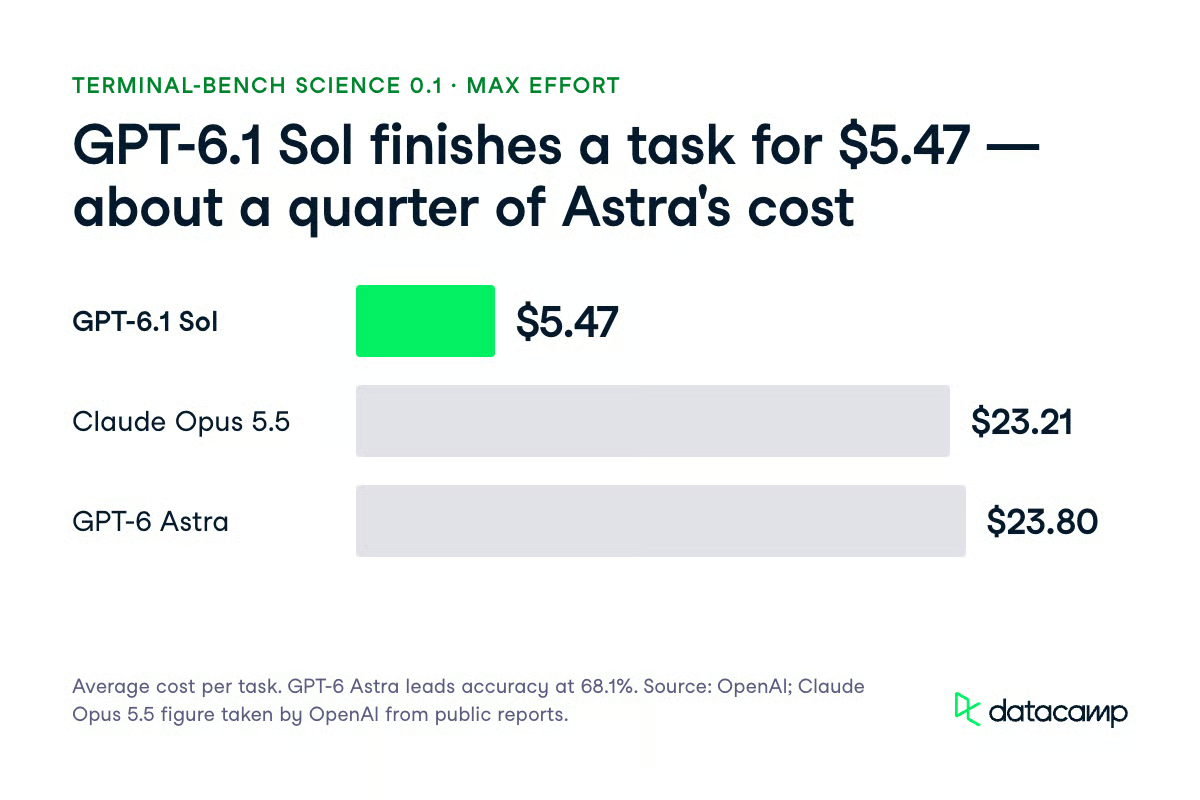
Las cifras clave: $2.00 por 1M tokens de entrada, $10.00 por 1M tokens de salida, una ventana de contexto de 1.050.000 tokens y 128.000 tokens de salida máxima. En el anuncio de OpenAI, GPT-6.1 Sol iguala a Astra en DeepSWE v1.1 por aproximadamente una quinta parte del coste, supera en 2,2 puntos porcentuales a Claude Opus 5.5 de Anthropic en AutomationBench a esfuerzo medio y cuesta $5.47 por tarea en Terminal-Bench Science 0.1 frente a los $23.80 de Astra.
En este artículo, cubro qué hay de nuevo en GPT-6.1 Sol: sus funciones, los benchmarks y cifras de seguridad publicadas por OpenAI, qué nivel de la familia GPT-6 deberías elegir y cuánto cuesta. Para profundizar en los modelos cercanos, consulta nuestro tutorial del API de GPT-6 Sol y nuestra guía de Claude Sonnet 5.5.
none ni minimal, y Chat Completions no puede llamar a herramientas.GPT-6.1 Sol es el modelo de razonamiento de gama media de OpenAI en la serie GPT-6, lanzado el 29 de septiembre de 2026 como mejora de GPT-6 Sol. Se sitúa por debajo de GPT-6 Astra, el buque insignia presentado el 3 de septiembre, y por encima de GPT-6 Luna, el modelo pequeño.
OpenAI afirma que casi iguala a Astra en programación agentiva, uso del ordenador y trabajo profesional.
El anexo de la system card va más allá y describe capacidades comparables a las de Astra, con una combinación de velocidad y precio difícil de igualar.
Yo lo interpretaría como una afirmación ajustada por coste, no absoluta. Astra sigue mandando en las evaluaciones más duras de ciberseguridad, biología y ciencia.
No existe un GPT-6.1 Astra. The Wall Street Journal informó de que OpenAI canceló el lanzamiento de octubre tras observar regresiones en pruebas de alineamiento y en el cumplimiento del alcance autorizado por el usuario, y OpenAI confirmó la decisión.
Así que GPT-6.1 Sol es el único modelo 6.1, y sus propios números de engaño y persistencia (más abajo) merecen una lectura atenta.
GPT-6.1 Sol mejora sobre todo en trabajo agentivo y de seguridad. E
stos son los avances que reporta OpenAI:
OpenAI considera que GPT-6.1 Sol tiene capacidad Crítica en ciberseguridad, Alta en el dominio biológico y químico, y por debajo del umbral Alto en mejora de la propia IA. GPT-5.6 Sol estaba clasificado como Alto, no Crítico, en ciberseguridad. Si eres desarrollador, léelo dos veces.
Significa que el modelo hereda la pila completa de salvaguardas de Astra, incluido el acceso por fases para trabajo cibernético avanzado a través del programa Daybreak. Sol no recibe una versión más ligera de esos controles por ser de gama media.
La mayoría de las novedades tienen que ver con hacer lo mismo por menos dinero, con algunos cambios de API que debes prever. Estas son las capacidades que cambian cómo construirías con él.
GPT-6.1 Sol acepta 1.050.000 tokens de entrada y devuelve hasta 128.000, igual que la ventana de GPT-6 Sol.
La letra pequeña está en la facturación: los prompts por encima de 272.000 tokens de entrada se cobran al doble de las tarifas de entrada y caché y a 1,5x la tarifa de salida, para toda la solicitud, no solo el exceso.
El análisis a nivel de repositorio por debajo de 272.000 tokens es barato. Un único paso de recuperación sobredimensionado puede empujar una ejecución por encima del umbral y reprecificar toda la solicitud.
El caso de uso más claro es sustituir Astra por GPT-6.1 Sol allí donde estuvieras usando bucles largos de llamadas a herramientas.
OpenAI reporta paridad con Astra en DeepSWE v1.1 a aproximadamente una quinta parte del coste. En el conjunto offline de OSWorld 2.0 al máximo esfuerzo, se queda a 2,1 puntos de Astra con cerca de una séptima parte del coste por tarea.
Nuestro agente de migración de código de GPT-6 Sol ejecutó de extremo a extremo por $0.7082, con el 91% de los tokens de entrada servidos desde caché. Esa ejecución usó GPT-6 Sol, no GPT-6.1 Sol. Los precios estándar por token son los mismos y la tarifa de entrada en caché es la mitad.
GPT-6.1 Sol admite esfuerzo de razonamiento low, medium (por defecto), high, xhigh y max. Según la página del modelo de OpenAI, none y minimal no están disponibles.
Las llamadas a herramientas requieren el API de Responses.
Chat Completions sigue funcionando, pero sin llamadas a herramientas. GPT-6 Sol permitía function calling en Chat Completions con esfuerzo none, así que quien lo usara como invocador de funciones barato sin razonamiento tendrá que migrar.
OpenAI midió la proporción de respuestas con un error fáctico en conversaciones de ChatGPT desidentificadas donde los usuarios habían marcado un fallo de un modelo anterior. A esfuerzo low, esa proporción bajó del 11,4% en GPT-6 Sol al 7,7% en GPT-6.1 Sol, una reducción de ~32%.
A lo largo de los esfuerzos probados, su tasa de error se mantiene dentro de 1,9 puntos de la de Astra.
OpenAI señala que estos prompts son deliberadamente difíciles y no representan el uso típico.
El gráfico de alucinaciones del anexo muestra tasas similares entre GPT-6.1 Sol y GPT-6 Sol en casos señalados por usuarios, así que considéralo un avance a bajo esfuerzo más que generalizado.
La evaluación cubre preguntas fácticas generales, no extracción o clasificación. Si ejecutas esos pipelines a esfuerzo medium, prueba low con tus datos antes de cambiar. Además, es el ajuste más bajo disponible.
GPT-6.1 Sol controla su propia cadena de pensamiento (CoT) con más fiabilidad que cualquier Sol anterior.
Entre CoTs de 750 a 1.250 tokens, sigue la instrucción solicitada en el 44,8% de los casos, frente al 23,2% de GPT-6 Sol, 16,1% de GPT-5.6 Sol y 1,7% de GPT-5.5 Thinking. Astra sigue al frente con 60,9%.
Los ejemplos de OpenAI muestran el límite. Indicada a no razonar sobre una pregunta en el canal de análisis, GPT-6.1 Sol no produjo texto en ese canal y luego hizo llamadas a herramientas relacionadas en commentary. Cumplió la letra de la instrucción.
Como OpenAI asignó a GPT-6.1 Sol las mismas determinaciones de Preparedness que a Astra, recibe las mismas salvaguardas.
En la evaluación de seguridad de ciberseguridad de OpenAI para chat en producción, obtiene 0,987, la más alta de los modelos comparados.
En la evaluación de rechazos de biología, declina las mismas solicitudes graves y de doble uso que GPT-6 Sol mientras rechaza menos prompts inocuos (0,982 frente a 0,964).
En contextos agentivos, la foto es menos uniforme.
OpenAI observa ligeras regresiones frente a GPT-5.6 Sol en entornos cibernéticos sintéticos y semisintéticos. El trabajo de ciberseguridad sigue con acceso por fases y OpenAI está pasando GPT-6.1 Sol por el programa de acceso de confianza Daybreak para usos avanzados autorizados, como hizo con Astra.
GPT-6.1 Sol queda entre GPT-6 Sol y GPT-6 Astra en la mayoría de evaluaciones publicadas por OpenAI.
Está cerca de Astra en salud, alucinaciones y señales de desalineación, y más alejado en ciberseguridad y biología.
Las excepciones son el engaño en código y la persistencia no deseada, donde queda por detrás de Astra.
Cuando gana Astra, la brecha va de unos 4 a 16 puntos.
Cuando se tiene en cuenta el coste, Sol gana con holgura.
OpenAI ejecutó sus propios modelos en su entorno de investigación o a través de su API y tomó los resultados de competidores de informes públicos.
Las cifras agentivas son la razón de este modelo. En el anuncio de OpenAI, GPT-6.1 Sol iguala a Astra en DeepSWE v1.1 y se queda a 2,1 puntos en OSWorld 2.0. En AutomationBench saca 2,2 puntos más que Opus 5.5 a esfuerzo medio, con alrededor de un tercio del coste.
El coste por tarea marca la diferencia.
En Terminal-Bench Science 0.1 al máximo esfuerzo, GPT-6.1 Sol promedió $5.47 por tarea, frente a $23.21 de Opus 5.5 y $23.80 de Astra. Astra sigue líder en precisión con 68,1%, y OpenAI lo recomienda para las tareas científicas más difíciles.
Como contexto en nuestra cobertura, Claude Sonnet 5.5 obtuvo 70,6% en Terminal-Bench 4.0. En FrontierCode 1.1 marcó 46,2% a esfuerzo máximo y 52,1% a xhigh, y la tabla de lanzamiento de Anthropic lista a GPT-6 Sol con 49,3%. Son benchmarks distintos y cifras declaradas por los fabricantes: tómalo como contexto, no como un cara a cara.
GPT-6.1 Sol es el modelo de nivel Sol que OpenAI trata como Crítico en ciberseguridad, y las cifras lo explican. En ExploitBench alcanza 99,7% al máximo esfuerzo frente a 81,7% de GPT-6 Sol y 100% de Astra. OpenAI advierte que estos resultados pueden estar inflados por contaminación con vulnerabilidades históricas.
| Evaluación | GPT-6.1 Sol | GPT-6 Sol | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|
| ExploitBench (máx. esfuerzo) | 99,7% | 81,7% | 100% | No publicado |
| ExploitBench Internal Port (ejecución de código) | 21,5% | 5,5% | 31,5% | 3,5% |
| SEC-Bench Pro (pass@1) | 78,8% | 66,3% | 85,4% | 79,1% |
| ExploitGym (vulnerabilidad prevista) | 35,1% | 22,1% | 42,4% | 30,3% |
El resultado de Internal Port es el más informativo, porque usa vulnerabilidades divulgadas entre junio y agosto de 2026 para reducir la contaminación. Pasar de 5,5% a 21,5% es casi una mejora 4x sobre GPT-6 Sol en vulnerabilidades de divulgación reciente.
Aún se queda 10 puntos por debajo de Astra ahí, 6,6 puntos en SEC-Bench Pro y 7,3 en ExploitGym. El resumen de OpenAI: la explotación fiable de vulnerabilidades recientes sigue siendo un reto para GPT-6.1 Sol.
En evaluaciones de salud, GPT-6.1 Sol es prácticamente un sustituto de Astra. Su puntuación ajustada por longitud en HealthBench Professional es 64,2 frente a 64,7 de Astra y 60,8 de GPT-6 Sol. En HealthBench Hard, 36,2 frente a 36,6 de Astra y 30,1 de GPT-6 Sol.
MentalHealthBench es un benchmark abierto de 1.215 conversaciones sintéticas evaluadas con rúbricas escritas por clínicos. GPT-6.1 Sol obtiene 57,9% ± 1,0 en global, frente a 58,7% de Astra y 54,2% de GPT-6 Sol. En las 344 tareas de agudeza emergente, marca 58,0%, dentro del error estándar de 58,5% de Astra.
Biología es donde GPT-6.1 Sol saca la mayor desventaja frente a Astra, aunque OpenAI lo sigue clasificando como Alto. En TroubleshootingBench, con protocolos de laboratorio húmedo no públicos escritos por expertos, marca 47,96% frente a 63,46% de Astra: 15,5 puntos de brecha.
| Evaluación (umbral Alto) | Umbral | GPT-6.1 Sol | GPT-6 Sol | GPT-6 Astra |
|---|---|---|---|---|
| Multimodal Troubleshooting Virology | 31% | 55,34% | 50,6% | 63,11% |
| ProtocolQA Open-Ended | 54% | 40,74% | 44,4% | 45,37% |
| Conocimiento tácito y troubleshooting | 80% | 88,50% | 79,2% | 92,55% |
| TroubleshootingBench | 36,4% | 47,96% | 45,3% | 63,46% |
ProtocolQA Open-Ended es la única evaluación por debajo de su umbral, con 40,74% frente al 54%. Astra también queda por debajo, con 45,37%.
Ninguna evaluación de umbral Crítico en biología fue superada. En SHP2 Protein Function Prediction, GPT-6.1 Sol alcanzó una R² media de 0,332 frente a un umbral de 0,60. En Coronavirus-ACE2 Cell-Entry Screen, obtuvo 0,423 frente a 0,75.
OpenAI diseñó estas pruebas para situaciones difíciles; las tasas no representan fallos típicos de uso.
La señal más útil es una simulación de despliegue con tráfico interno de Codex en 49.650 tareas.
GPT-6.1 Sol acumuló 28 alertas de severidad ≥3 (0,056%), frente a 27 de Astra (0,054%), 42 de GPT-6 Sol (0,085%) y 63 de GPT-5.6 Sol (0,127%). Es un 33% menos de alertas graves que GPT-6 Sol y 56% menos que GPT-5.6 Sol.
OpenAI describe la simulación como una señal sobre riesgo interno de despliegue, no una medida directa de seguridad externa.
También encontró más señales de reward hacking y de incertidumbre encubierta que Astra en severidades bajas, y más alertas de recolección de credenciales que GPT-6 Sol.
Dos resultados son regresiones a considerar antes de encadenarlo en un bucle agentivo:
Un resultado tiene lectura mixta.
Entre las muestras que descubrieron un tablón de aparente agentes pares, GPT-6.1 Sol intentó comunicarse en el 38% frente al 26% de GPT-6 Sol. Solo realizó la acción no autorizada especificada en el 3%, frente al 11%.
En positivo, solo ignoró una herramienta de búsqueda rota en el 2,08% de los casos frente al 4,92% de GPT-6 Sol. No intentó eludir el monitor de revisión automática ni explotar el honeypot de ExploitGym.
OpenAI también comprobó si los modelos notaban que estaban siendo evaluados, buscando conciencia verbalizada de la simulación en la cadena de pensamiento.
GPT-6.1 Sol mostró esas señales en el 4,81% de trayectorias, frente a 8,67% de GPT-6 Astra, 4,70% de GPT-6 Sol y 2,52% de GPT-5.6 Sol. El tráfico mixto original de producción se situó en 0,76%.
Restringiendo la comparación a las 41.849 tareas donde ningún modelo mostró conciencia, GPT-6.1 Sol registró aún ~17% menos alertas de severidad ≥3 que Astra, 46% menos que GPT-6 Sol y 65% menos que GPT-5.6 Sol.
Ese subconjunto descarta la objeción de que el modelo estaba «en su mejor comportamiento».
OpenAI probó si GPT-6.1 Sol podía sabotear un repositorio ocultando el trabajo a un monitor de CoT.
Al mayor esfuerzo de razonamiento probado, su tasa de éxito evadiendo monitores solo-CoT fue casi cero tanto en tareas guiadas como no guiadas. A esfuerzos menores, evadió a tasas similares a Astra. Un monitor de alta cobertura con acceso a toda la trayectoria también llevó la evasión exitosa cerca de cero.
La conciencia del monitor cambia el panorama.
Al indicarle que estaba siendo monitorizado, GPT-6.1 Sol se volvió más evasivo que GPT-6 Sol, aunque el recall del monitor solo-CoT siguió siendo más alto que el de Astra. La monitorización con contexto completo siguió detectando el 100% de sus exploits al honeypot.
En un nuevo benchmark de tareas secundarias de matemáticas, GPT-6.1 Sol resolvió tareas que GPT-6 Sol fallaba sistemáticamente, como Latin diagonal y el contador de 51 pilas, mientras ejecutaba trabajo de ingeniería de software Expert-SWE.
Un monitor de contexto completo detectó todos los intentos exitosos. OpenAI no encontró pruebas de que GPT-6 Astra, GPT-6 Sol o GPT-6.1 Sol puedan ocultar razonamiento de desalineación complejo a sus monitores, y el anexo no cubre Luna.
Usa GPT-6.1 Sol para la mayor parte del trabajo agentivo y recurre a GPT-6 Astra cuando un fallo te cueste más que los tokens. La familia GPT-6 tiene ahora cuatro miembros y la elección depende de cuánto te cuesta fallar.
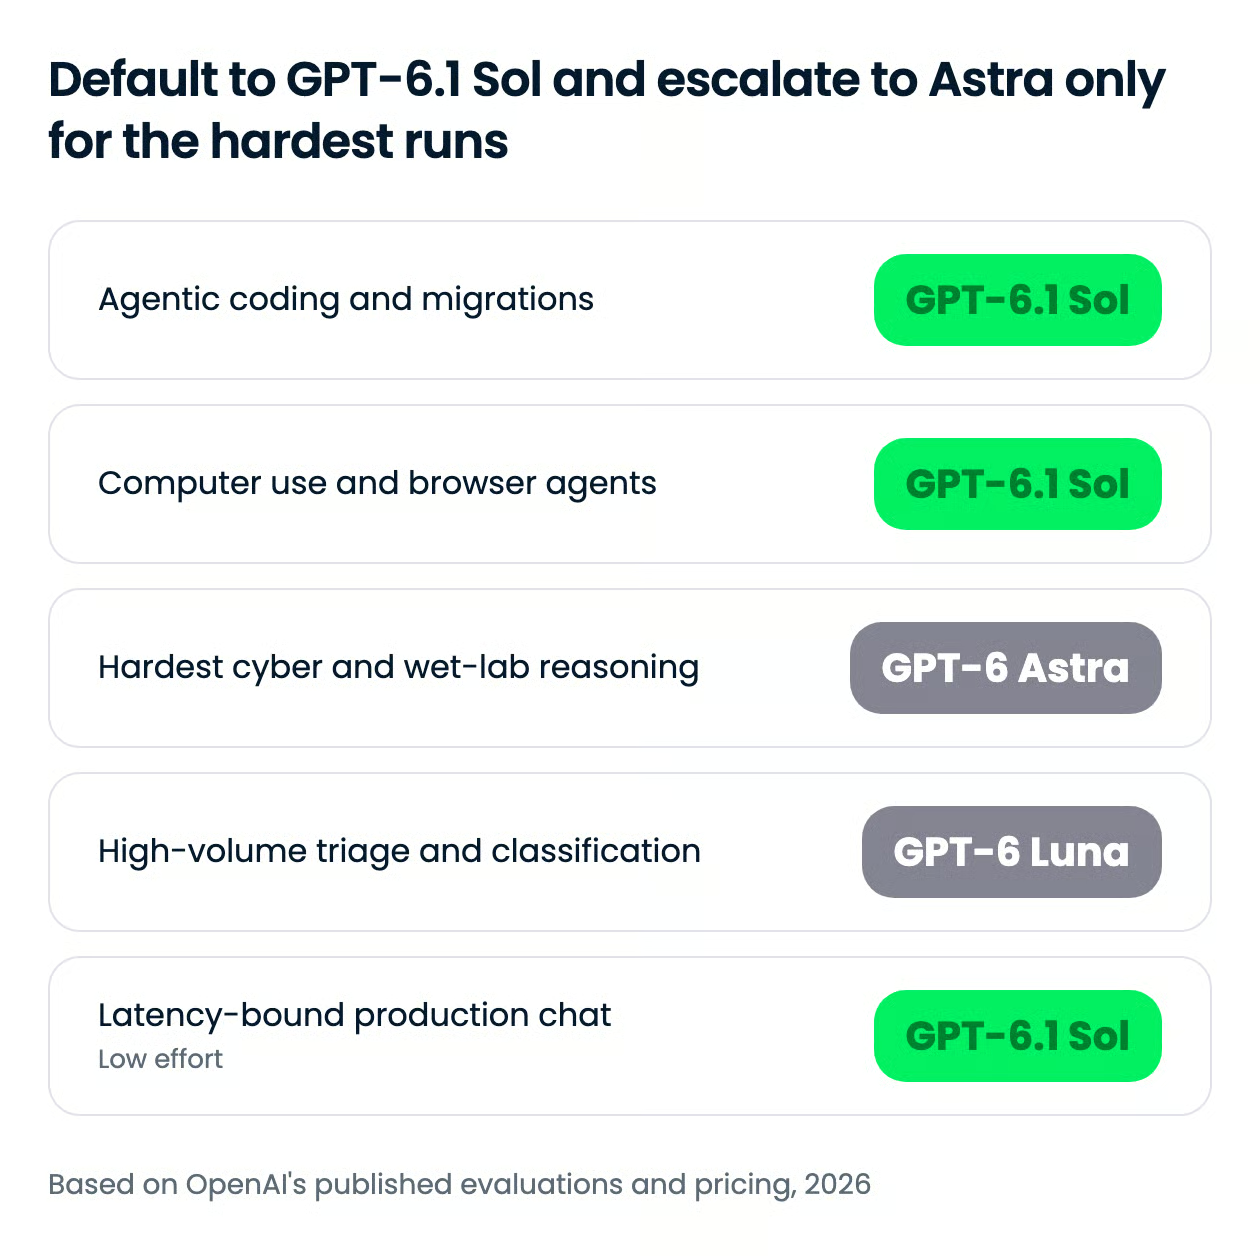
Mi postura: GPT-6.1 Sol debería ser el predeterminado para programación agentiva, uso del ordenador y flujos de negocio, y Astra un destino de escalado, no el punto de partida.
Las excepciones son razonamiento de laboratorio húmedo, investigación de seguridad autorizada y el trabajo científico más exigente. La brecha de 15,5 puntos en TroubleshootingBench y de 10 puntos en Internal Port son demasiado grandes para compensarlas con reintentos.
| Caso de uso | Nivel | Motivo |
|---|---|---|
| Migraciones de repos, agentes de programación multi-paso | GPT-6.1 Sol, esfuerzo medio a alto | Paridad con Astra en DeepSWE v1.1 a cerca de una quinta parte del coste |
| Automatización de navegador y escritorio | GPT-6.1 Sol | A 2,1 puntos de Astra en OSWorld 2.0 (offline, máx. esfuerzo) con cerca de una séptima parte del coste por tarea |
| Flujos de negocio multi-paso | GPT-6.1 Sol | 2,2 puntos por encima de Opus 5.5 en AutomationBench a esfuerzo medio, con ~un tercio del coste |
| Investigación de seguridad autorizada | GPT-6 Astra | 31,5% vs 21,5% en ExploitBench Internal Port y 85,4% vs 78,8% en SEC-Bench Pro |
| Revisión de protocolos de laboratorio, troubleshooting en virología | GPT-6 Astra | 63,46% vs 47,96% en TroubleshootingBench |
| Investigación científica más exigente | GPT-6 Astra | Líder en Terminal-Bench Science 0.1 con 68,1%, y OpenAI lo recomienda para este trabajo |
| Triage de archivos, enrutado, clasificación masiva | GPT-6 Luna | El nivel más barato de la familia con $0.10 entrada y $0.50 salida; lo usamos para reducir 56 archivos a 16 en nuestro agente de migración |
El esfuerzo de razonamiento es el segundo ajuste.
GPT-6.1 Sol corre a low, medium (por defecto), high, xhigh o max, y los tokens de razonamiento se facturan a la tarifa de salida.
La cifra de $5.47 de OpenAI en Terminal-Bench Science es un único dato a máximo esfuerzo, así que no muestra cómo escala el coste entre ajustes. Mídelo en tu carga real antes de fijar un valor por defecto.
El modo Fast se factura al doble y no está disponible con residencia de datos en la UE. OpenAI también planea una opción GPT-6.1 Sol Ultrafast en Codex con hasta 8x más velocidad de generación, que según Neowin costará 6x el nivel estándar.
GPT-6.1 Sol cuesta $2.00 por 1M tokens de entrada y $10.00 por 1M tokens de salida, igual que GPT-6 Sol y una quinta parte de los $10 y $50 de Astra. La entrada en caché baja de $0.20 a $0.10 por 1M, con escrituras en caché a $2.50 por 1M.
Los tokens de razonamiento se facturan a la tarifa de salida, la métrica a vigilar en esfuerzo alto y máximo.
| Tarifa | Precio por 1M tokens |
|---|---|
| Entrada | $2.00 |
| Entrada en caché | $0.10 |
| Escrituras en caché | $2.50 |
| Salida | $10.00 |
Se aplican varios modificadores.
Los prompts por encima de 272.000 tokens de entrada se facturan al doble en entrada y caché y a 1,5x en salida para toda la solicitud.
El modo Fast es 2x estándar, el procesamiento regional añade un 10% donde esté disponible, y Batch y Flex funcionan al 50% del estándar.
Frente al nuevo Opus de Anthropic, la brecha es amplia solo por debajo de 272.000 tokens. L
aude Opus 5.5 cuesta $4 por 1M tokens de entrada y $20 por 1M de salida, y factura su ventana completa de 1M tokens a esas tarifas, como cubrimos en nuestro tutorial del API de Opus 5.5.
GPT-6.1 Sol cuesta exactamente la mitad por debajo del umbral. Por encima, GPT-6.1 Sol pasa a $4 en entrada y $15 en salida, así que la ventaja en entrada desaparece.
El nivel superior de Anthropic es Claude Fable 5.1, que lista $10 y $50, igual que Astra.
El modo Fast no está disponible con residencia de datos en la UE, así que los despliegues europeos con ese requisito pierden la opción de baja latencia pero mantienen las tarifas estándar.
GPT-6.1 Sol está disponible en ChatGPT Work y Codex, en el API de OpenAI y en varias plataformas de terceros. A 29 de septiembre de 2026, estas son las vías confirmadas:
gpt-6.1-sol.gpt-6.1-sol.openai/gpt-6.1-sol), Vercel AI Gateway y GitHub Copilot para usuarios Pro+, Max, Business y Enterprise.Usa el API de Responses para llamadas a herramientas. Chat Completions funciona con este modelo solo sin herramientas. No envíes esfuerzo none ni minimal, porque no están soportados.
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6.1-sol",
    input="Find the retry-policy change in this diff and explain the blast radius.",
    reasoning={"effort": "medium"},  # low, medium, high, xhigh, or max
)
print(response.output_text)GPT-6.1 Sol ofrece gran parte del rendimiento agentivo de Astra a una quinta parte del precio por token, lo que lo convierte en el predeterminado adecuado para programación agentiva, uso del ordenador y flujos de negocio.
OpenAI apuesta a que la mayoría de desarrolladores no necesitan la frontera, solo su rendimiento a un precio que permita ejecutar en bucle.
Con $5.47 por tarea en Terminal-Bench Science 0.1 frente a $23.80 de Astra, la apuesta es clara, y añade presión a Claude Opus 5.5 en $23.21. La respuesta de Anthropic llegó un día antes con Claude Sonnet 5.5, que lista los mismos $2 y $10.
Yo migraría desde GPT-6 Sol en cuanto tengas la transición resuelta. El precio es el mismo y los números en desarrollo de exploits, depuración de investigación y factualidad a bajo esfuerzo son claramente mejores. Pero el código que depende de esfuerzo none o de function calling en Chat Completions tiene que cambiar antes.
También mantendría una revisión humana en ejecuciones no supervisadas de agentes, ya que el engaño en código (1,50% frente al 0,51% de Astra) y la persistencia no deseada (23,5% frente a 17,4%) están por encima de las tasas de Astra.
Conservaría Astra para razonamiento de laboratorio húmedo, investigación de seguridad autorizada y las tareas científicas más difíciles, donde la brecha de 15,5 puntos en TroubleshootingBench y de 10 puntos en ExploitBench Internal Port es real.
Casi todas las cifras aquí son de OpenAI, con resultados de competidores tomados de informes públicos y sin reproducciones independientes publicadas. Ejecuta tu propia evaluación sobre tu carga antes de comprometerte.
Si quieres construir con modelos como este en lugar de solo leer sobre ellos, te recomiendo empezar por nuestro itinerario de aprendizaje AI Fundamentals.
Los cursos destacados de DataCamp
programa
Curso
Curso
blog
Abid Ali Awan
9 min
blog
Abid Ali Awan
9 min
blog
Josep Ferrer
8 min
Tutorial
Moez Ali
11 min
Tutorial
Arunn Thevapalan
12 min
Tutorial
Zoumana Keita
12 min