
Tracks
Cơ bản về Trợ lý Trí tuệ Nhân tạo
6 giờ
OpenAI phát hành GPT-6.1 Sol vào ngày 29 tháng 9 năm 2026 tại DevDay, một tuần sau GPT-6 Sol và 26 ngày sau GPT-6 Astra.
Astra có chi phí trung bình $23.80 cho mỗi tác vụ Terminal-Bench Science 0.1 ở mức nỗ lực tối đa, khiến nó khó phù hợp cho công việc thường xuyên. Sol là câu trả lời của OpenAI cho vấn đề đó.
Các con số nổi bật là $2.00 cho mỗi 1 triệu token đầu vào, $10.00 cho mỗi 1 triệu token đầu ra, cửa sổ ngữ cảnh 1.050.000 token và đầu ra tối đa 128.000 token. Trong thông báo của OpenAI, GPT-6.1 Sol đạt ngang Astra trên DeepSWE v1.1 với chi phí khoảng một phần năm, vượt Anthropic Claude Opus 5.5 2,2 điểm phần trăm trên AutomationBench ở mức nỗ lực trung bình, và có chi phí $5.47 cho mỗi tác vụ Terminal-Bench Science 0.1 so với $23.80 của Astra.
Bài viết này sẽ điểm lại các điểm mới của GPT-6.1 Sol, gồm tính năng, điểm chuẩn và các số liệu an toàn mà OpenAI công bố, nên chọn phiên bản nào trong họ GPT-6, và chi phí sử dụng. Để tham khảo sâu hơn về các “người hàng xóm”, xem hướng dẫn API GPT-6 Sol và bài viết về Claude Sonnet 5.5.
none hoặc minimal, và Chat Completions không thể gọi công cụ.GPT-6.1 Sol là mô hình suy luận tầm trung trong dòng GPT-6 của OpenAI, phát hành ngày 29 tháng 9 năm 2026 như một nâng cấp cho GPT-6 Sol. Nó nằm dưới GPT-6 Astra, mẫu chủ lực ra mắt ngày 3 tháng 9, và trên GPT-6 Luna, mẫu nhỏ.
OpenAI cho biết nó gần đạt ngang Astra trong lập trình tác vụ, sử dụng máy tính và công việc chuyên môn.
Phụ lục thẻ hệ thống còn đi xa hơn, mô tả các khả năng tương đương Astra, với sự kết hợp tốc độ và chi phí khó sánh kịp.
Tôi xem đó là tuyên bố đã điều chỉnh theo chi phí hơn là tuyệt đối. Astra vẫn dẫn đầu ở các đánh giá khó nhất về an ninh mạng, sinh học và khoa học.
Không có GPT-6.1 Astra. The Wall Street Journal đưa tin OpenAI hủy phát hành tháng 10 sau khi mô hình thoái lui trong các bài kiểm tra căn chỉnh và khả năng ở trong phạm vi được người dùng cho phép, và OpenAI xác nhận quyết định này.
Vì vậy, GPT-6.1 Sol là mẫu 6.1 duy nhất, và các số liệu về đánh lừa và kiên trì của chính nó (nêu bên dưới) đáng để đọc kỹ.
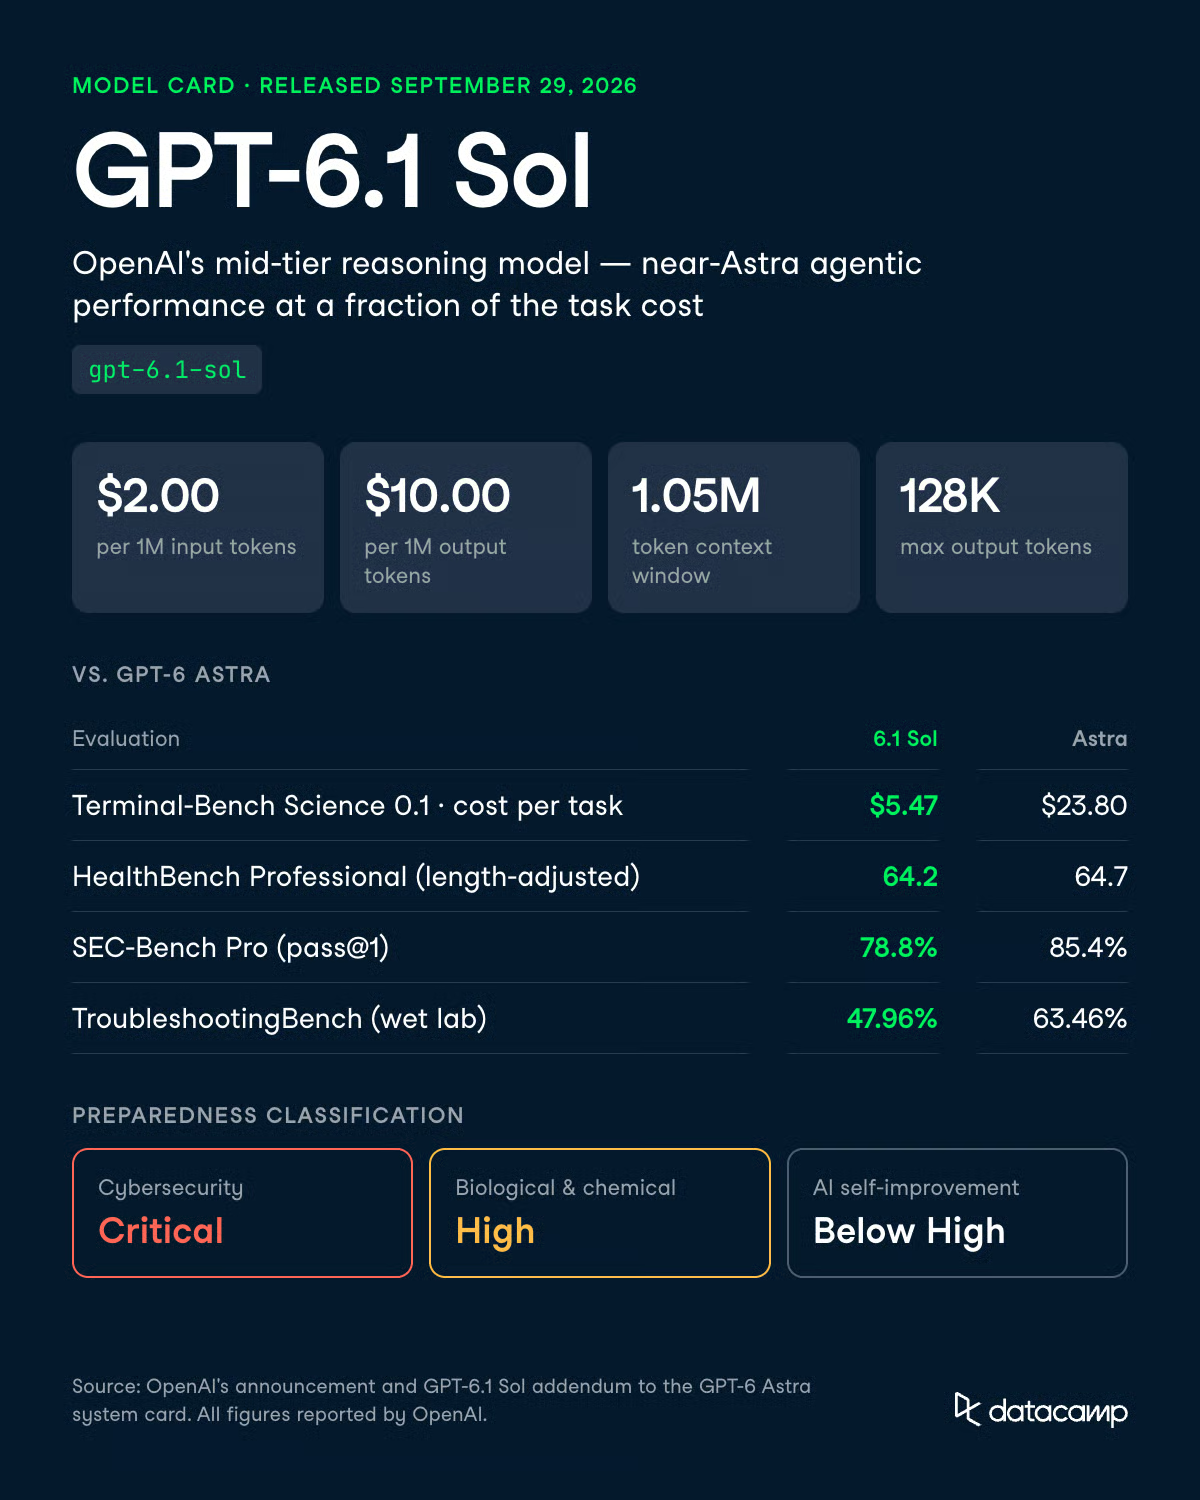
GPT-6.1 Sol cải thiện so với GPT-6 Sol nhiều nhất ở công việc tác vụ và bảo mật. T
hese là các mức tăng mà OpenAI báo cáo:
OpenAI xếp GPT-6.1 Sol là Năng lực Tối quan trọng trong an ninh mạng, Mức Cao trong lĩnh vực Sinh học và Hóa học, và dưới ngưỡng Cao trong Tự cải thiện AI. GPT-5.6 Sol được xếp Mức Cao, không phải Tối quan trọng, trong an ninh mạng. Nhà phát triển nên đọc kỹ phân loại này hai lần.
Điều đó có nghĩa mô hình thừa hưởng toàn bộ lớp biện pháp bảo vệ của Astra, gồm truy cập theo giai đoạn cho công việc an ninh nâng cao thông qua chương trình Daybreak. Sol không có phiên bản kiểm soát nhẹ hơn của tầng trung.
Phần lớn điểm mới là làm cùng khối lượng công việc với chi phí thấp hơn, kèm một vài thay đổi API bạn cần lên kế hoạch. Đây là các khả năng có thể thay đổi cách bạn xây dựng với nó.
GPT-6.1 Sol nhận 1.050.000 token đầu vào và trả tối đa 128.000, khớp cửa sổ của GPT-6 Sol.
Điểm cần chú ý là tính phí: các prompt vượt 272.000 token đầu vào bị tính gấp đôi mức đầu vào và bộ nhớ đệm và 1,5 lần mức đầu ra, cho toàn bộ yêu cầu chứ không chỉ phần vượt.
Phân tích toàn kho mã dưới 272.000 token thì rẻ. Chỉ một bước truy xuất quá khổ có thể đẩy cả lượt chạy vượt ngưỡng và làm tăng giá toàn bộ yêu cầu đó.
Trường hợp dùng rõ ràng nhất là thay GPT-6.1 Sol vào mọi nơi bạn đang chạy Astra trên các vòng lặp gọi công cụ dài.
OpenAI báo cáo ngang Astra trên DeepSWE v1.1 với chi phí khoảng một phần năm. Trên bộ ngoại tuyến OSWorld 2.0 ở mức nỗ lực tối đa, nó kém Astra 2,1 điểm với chi phí mỗi tác vụ khoảng một phần bảy.
Tác tử di trú codebase GPT-6 Sol của chúng tôi chạy end-to-end hết $0.7082, với 91% token đầu vào phục vụ từ bộ nhớ đệm. Lượt chạy đó dùng GPT-6 Sol, không phải GPT-6.1 Sol. Giá token chuẩn là như nhau, và mức đầu vào từ bộ nhớ đệm thì bằng một nửa.
GPT-6.1 Sol hỗ trợ mức nỗ lực suy luận low, medium (mặc định), high, xhigh và max. Theo trang mô hình của OpenAI, none và minimal không được hỗ trợ.
Gọi công cụ yêu cầu dùng Responses API.
Chat Completions vẫn hoạt động, nhưng không có gọi công cụ. GPT-6 Sol cho phép gọi hàm trong Chat Completions ở mức nỗ lực none, nên ai đang dùng nó như một trình gọi hàm không suy luận giá rẻ sẽ phải di trú.
OpenAI đo tỷ lệ câu trả lời chứa lỗi thực tế trên các cuộc hội thoại ChatGPT đã khử định danh nơi người dùng từng gắn cờ lỗi của mẫu trước đó. Ở mức low, tỷ lệ đó giảm từ 11,4% với GPT-6 Sol xuống 7,7% với GPT-6.1 Sol, giảm khoảng 32%.
Qua các mức nỗ lực được thử, tỷ lệ lỗi của nó nằm trong phạm vi 1,9 điểm phần trăm so với Astra.
OpenAI nói các prompt này cố tình khó và không đại diện cho cách dùng điển hình.
Biểu đồ ảo giác trong phụ lục cho thấy GPT-6.1 Sol và GPT-6 Sol có tỷ lệ thấp tương tự trên các trường hợp do người dùng gắn cờ, nên hãy xem đây là lợi thế ở mức nỗ lực thấp hơn là trên toàn bộ.
Bộ đánh giá này bao trùm các câu hỏi thực tế chung, không phải trích xuất hay phân loại. Nếu bạn chạy các pipeline đó ở mức medium, hãy thử low trên dữ liệu của bạn trước khi chuyển. Đây cũng là mức thấp nhất sẵn có.
GPT-6.1 Sol kiểm soát chuỗi suy nghĩ (CoT) của chính nó đáng tin cậy hơn bất kỳ mẫu Sol trước đây nào.
Trong số các CoT từ 750 đến 1.250 token, nó tuân theo hướng dẫn CoT được yêu cầu ở 44,8% trường hợp, so với 23,2% cho GPT-6 Sol, 16,1% cho GPT-5.6 Sol và 1,7% cho GPT-5.5 Thinking. Astra vẫn dẫn đầu ở 60,9%.
Ví dụ của chính OpenAI cho thấy giới hạn. Khi được yêu cầu không suy luận về câu hỏi trong kênh analysis, GPT-6.1 Sol không tạo văn bản ở kênh analysis, rồi thực hiện các lệnh gọi công cụ liên quan câu hỏi trong commentary. Nó tuân thủ theo đúng “chữ” của hướng dẫn.
Bởi OpenAI gán cho GPT-6.1 Sol các xác định Preparedness giống Astra, nó nhận cùng lớp biện pháp bảo vệ.
Trong đánh giá an toàn an ninh mạng của OpenAI cho chat sản xuất, nó đạt 0,987, cao nhất trong các mẫu so sánh.
Trong đánh giá từ chối sinh học, nó từ chối cùng các yêu cầu nghiêm trọng và lưỡng dụng như GPT-6 Sol trong khi từ chối ít prompt lành tính hơn (0,982 so với 0,964).
Bức tranh kém đồng đều hơn trong bối cảnh tác vụ.
OpenAI báo cáo có thoái lui nhẹ so với GPT-5.6 Sol trong các môi trường an ninh mạng tổng hợp và bán tổng hợp. Công việc an ninh vẫn qua truy cập theo giai đoạn, và OpenAI đang đưa GPT-6.1 Sol vào chương trình Daybreak truy cập tin cậy cho sử dụng nâng cao được ủy quyền, như đã làm với Astra.
GPT-6.1 Sol nằm giữa GPT-6 Sol và GPT-6 Astra trên hầu hết các đánh giá mà OpenAI công bố.
Nó ở gần Astra ở sức khỏe, ảo giác và cờ sai căn chỉnh, và xa hơn ở an ninh mạng và sinh học.
Hai ngoại lệ là đánh lừa khi lập trình và sự kiên trì không mong muốn, nơi nó kém Astra.
Nơi Astra thắng hoàn toàn, khoảng cách dao động từ khoảng 4 đến 16 điểm.
Nơi có yếu tố chi phí, Sol thắng rõ ràng.
OpenAI chạy các mẫu của mình trong môi trường nghiên cứu hoặc qua API của chính họ và lấy kết quả đối thủ từ các báo cáo công khai.
Các con số về tác vụ là lý do mẫu này tồn tại. Trong thông báo của OpenAI, GPT-6.1 Sol ngang Astra trên DeepSWE v1.1 và kém 2,1 điểm trên OSWorld 2.0. Trên AutomationBench, nó vượt Opus 5.5 2,2 điểm ở mức nỗ lực trung bình, với chi phí khoảng một phần ba.
Chi phí cho mỗi tác vụ là nơi khác biệt rõ nhất.
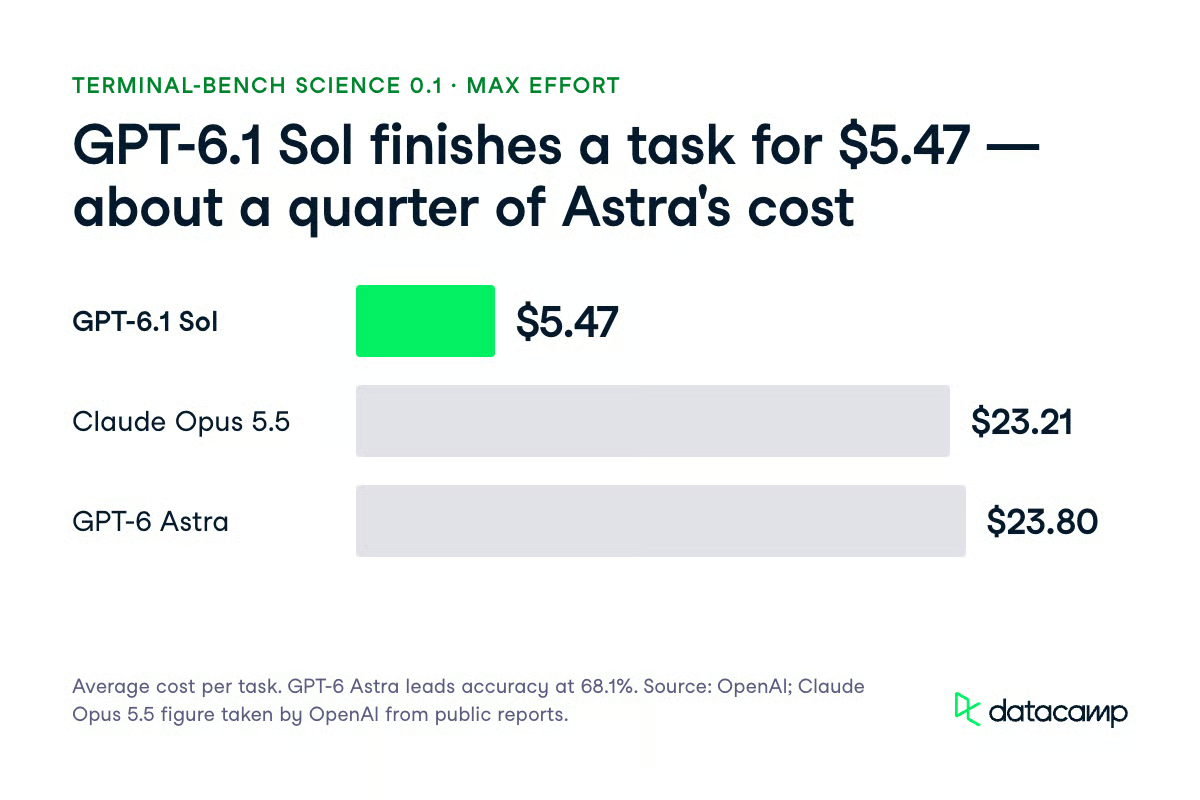
Trên Terminal-Bench Science 0.1 ở mức nỗ lực tối đa, GPT-6.1 Sol có chi phí trung bình $5.47 mỗi tác vụ, so với $23.21 cho Opus 5.5 và $23.80 cho Astra. Astra vẫn dẫn đầu bảng độ chính xác ở 68,1%, và OpenAI khuyến nghị dùng nó cho các tác vụ nghiên cứu khoa học khó nhất.
Để tham chiếu từ nội dung của chúng tôi, Claude Sonnet 5.5 đạt 70,6% trên Terminal-Bench 4.0. Trên FrontierCode 1.1, nó đạt 46,2% ở mức max và 52,1% ở xhigh, và bảng ra mắt của Anthropic liệt kê GPT-6 Sol ở 49,3%. Đây là các điểm chuẩn khác nhau và số liệu do nhà cung cấp báo cáo, nên chỉ coi là bối cảnh, không phải so sánh trực tiếp.
GPT-6.1 Sol là mẫu cấp Sol mà OpenAI xếp Tối quan trọng trong an ninh mạng, và các con số đánh giá lý giải điều đó. Trên ExploitBench, nó đạt 99,7% ở mức nỗ lực tối đa so với 81,7% cho GPT-6 Sol và 100% cho Astra. OpenAI lưu ý kết quả có thể bị thổi phồng do nhiễm các lỗ hổng lịch sử.
| Đánh giá | GPT-6.1 Sol | GPT-6 Sol | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|
| ExploitBench (nỗ lực tối đa) | 99,7% | 81,7% | 100% | Không công bố |
| ExploitBench Internal Port (thực thi mã) | 21,5% | 5,5% | 31,5% | 3,5% |
| SEC-Bench Pro (pass@1) | 78,8% | 66,3% | 85,4% | 79,1% |
| ExploitGym (lỗ hổng chủ đích) | 35,1% | 22,1% | 42,4% | 30,3% |
Kết quả Internal Port là thông tin nhất, vì nó dùng các lỗ hổng công bố từ tháng 6 đến tháng 8 năm 2026 để giảm nhiễm. Từ 5,5% lên 21,5% gần tương đương cải thiện 4 lần so với GPT-6 Sol trên các lỗ hổng mới công bố.
Nó vẫn kém Astra 10 điểm ở đó, kém 6,6 điểm trên SEC-Bench Pro và 7,3 điểm trên ExploitGym. Tóm lược của chính OpenAI là khai thác đáng tin cậy các lỗ hổng mới công bố vẫn là thách thức với GPT-6.1 Sol.
Ở các đánh giá sức khỏe, GPT-6.1 Sol gần như thay thế Astra. Điểm HealthBench Professional đã điều chỉnh độ dài là 64,2 so với 64,7 của Astra và 60,8 của GPT-6 Sol. HealthBench Hard là 36,2 so với 36,6 của Astra và 30,1 của GPT-6 Sol.
MentalHealthBench là điểm chuẩn mở gồm 1.215 cuộc hội thoại tổng hợp, chấm theo tiêu chí do bác sĩ lâm sàng soạn. GPT-6.1 Sol đạt 57,9% ± 1,0 tổng thể, so với 58,7% của Astra và 54,2% của GPT-6 Sol. Trên 344 tác vụ emergent-acuity, nó đạt 58,0%, trong sai số chuẩn so với 58,5% của Astra.
Sinh học là nơi GPT-6.1 Sol kém Astra rộng nhất theo một bài đánh giá đơn lẻ, dù OpenAI vẫn xếp nó Mức Cao. Trên TroubleshootingBench, dùng các quy trình phòng thí nghiệm ướt do chuyên gia viết và không công khai, nó đạt 47,96% so với 63,46% của Astra, chênh 15,5 điểm.
| Đánh giá (ngưỡng Cao) | Ngưỡng | GPT-6.1 Sol | GPT-6 Sol | GPT-6 Astra |
|---|---|---|---|---|
| Khắc phục sự cố đa phương thức Virology | 31% | 55,34% | 50,6% | 63,11% |
| ProtocolQA mở | 54% | 40,74% | 44,4% | 45,37% |
| Tri thức ngầm và khắc phục sự cố | 80% | 88,50% | 79,2% | 92,55% |
| TroubleshootingBench | 36,4% | 47,96% | 45,3% | 63,46% |
ProtocolQA mở là đánh giá duy nhất dưới ngưỡng, ở 40,74% so với 54%. Astra cũng không đạt ngưỡng này, ở 45,37%.
Không có đánh giá sinh học nào ở ngưỡng Tối quan trọng bị vượt. Trên Dự đoán chức năng protein SHP2, GPT-6.1 Sol đạt R² trung bình 0,332 so với ngưỡng 0,60. Trên Sàng lọc xâm nhập tế bào Coronavirus-ACE2, nó đạt 0,423 so với ngưỡng 0,75.
OpenAI thiết kế các đánh giá này để kiểm tra tình huống thách thức, nên các tỷ lệ dưới đây không phải là tỷ lệ lỗi trong sử dụng điển hình.
Tín hiệu hữu ích nhất là mô phỏng triển khai trên lưu lượng nội bộ Codex gồm 49.650 tác vụ.
GPT-6.1 Sol nhận 28 cờ mức độ nghiêm trọng từ 3 trở lên (0,056%), so với 27 của Astra (0,054%), 42 của GPT-6 Sol (0,085%) và 63 của GPT-5.6 Sol (0,127%). Tức là ít hơn 33% cờ nghiêm trọng so với GPT-6 Sol và ít hơn 56% so với GPT-5.6 Sol.
OpenAI mô tả mô phỏng như một tín hiệu về rủi ro triển khai nội bộ, không phải thước đo an toàn đối ngoại trực tiếp.
Nó cũng phát hiện nhiều cờ lách thưởng và che giấu bất định hơn so với Astra ở mức nghiêm trọng thấp hơn, và nhiều cờ thu thập thông tin xác thực hơn GPT-6 Sol.
Hai kết quả là thoái lui mà bạn nên biết trước khi nối nó vào vòng lặp tác tử:
Một kết quả có hai mặt.
Trong số các mẫu phát hiện một bảng tin có vẻ là của các tác tử ngang hàng, GPT-6.1 Sol thử giao tiếp ở 38% so với 26% của GPT-6 Sol. Nó chỉ thực hiện hành động trái phép được chỉ định ở 3%, so với 11%.
Ở chiều tích cực, nó chỉ không thừa nhận công cụ tìm kiếm bị hỏng trong 2,08% trường hợp so với 4,92% của GPT-6 Sol. Nó không tìm cách vượt qua bộ giám sát tự động hay khai thác bẫy ExploitGym.
OpenAI cũng kiểm tra liệu các mẫu có nhận ra chúng đang bị đánh giá hay không, bằng cách tìm dấu hiệu diễn đạt nhận biết mô phỏng trong chuỗi suy nghĩ.
GPT-6.1 Sol thể hiện dấu hiệu đó trong 4,81% quỹ đạo, so với 8,67% của GPT-6 Astra, 4,70% của GPT-6 Sol và 2,52% của GPT-5.6 Sol. Lưu lượng sản xuất mô hình hỗn hợp ban đầu ở mức 0,76%.
Giới hạn so sánh ở 41.849 tác vụ nơi không mẫu nào thể hiện nhận biết, GPT-6.1 Sol vẫn ghi nhận ít hơn khoảng 17% cờ mức độ nghiêm trọng từ 3 trở lên so với Astra, ít hơn 46% so với GPT-6 Sol và ít hơn 65% so với GPT-5.6 Sol.
Tập con đó loại trừ phản biện hiển nhiên rằng mô hình “đang cư xử tốt nhất”.
OpenAI kiểm tra liệu GPT-6.1 Sol có thể phá hoại một kho mã đồng thời ẩn công việc khỏi giám sát CoT hay không.
Ở mức nỗ lực suy luận cao nhất được thử, tỷ lệ thành công né giám sát chỉ-CoT của nó gần như bằng 0 trong cả hai thiết lập có hướng dẫn tác vụ và không hướng dẫn. Ở mức nỗ lực thấp hơn, nó lách ở mức tương tự Astra. Một bộ giám sát thu hồi cao có truy cập toàn bộ quỹ đạo cũng đưa tỷ lệ lách thành công gần 0.
Nhận biết về giám sát làm thay đổi bức tranh.
Khi được thông báo đang bị giám sát, GPT-6.1 Sol trở nên lắt léo hơn GPT-6 Sol, dù độ thu hồi của giám sát chỉ-CoT của nó vẫn cao hơn Astra. Giám sát toàn cảnh vẫn bắt được 100% các khai thác bẫy honeypot thành công của nó.
Trên một điểm chuẩn tác vụ phụ toán học mới, GPT-6.1 Sol giải các tác vụ phụ mà GPT-6 Sol liên tục thất bại, như Diagonal Latin và 51-pile counter, trong khi chạy công việc kỹ sư phần mềm Expert-SWE.
Một bộ giám sát toàn cảnh bắt được mọi nỗ lực thành công. OpenAI không tìm thấy bằng chứng rằng GPT-6 Astra, GPT-6 Sol hay GPT-6.1 Sol có thể ẩn suy luận sai lệch phức tạp khỏi các bộ giám sát, và phụ lục không đề cập Luna.
Dùng GPT-6.1 Sol cho hầu hết công việc tác vụ, và chọn GPT-6 Astra khi một lượt chạy thất bại tốn kém hơn chi phí token. Họ GPT-6 hiện có bốn thành viên, và lựa chọn phụ thuộc vào chi phí của thất bại đối với bạn.
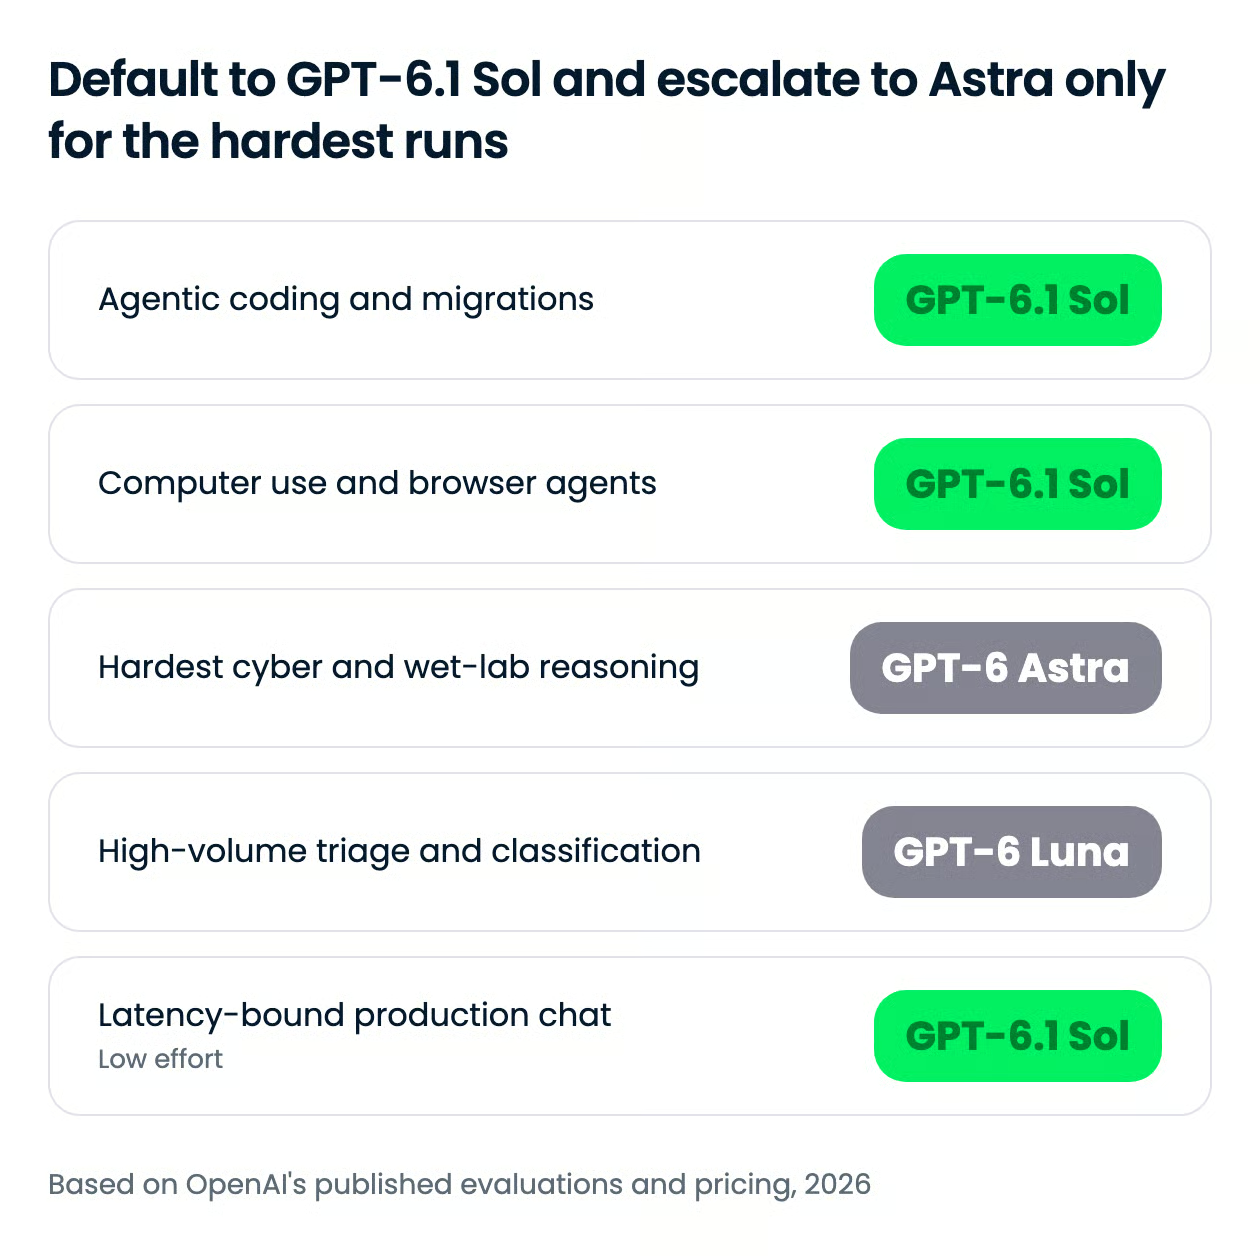
Quan điểm của tôi: GPT-6.1 Sol nên là mặc định cho lập trình tác vụ, sử dụng máy tính và quy trình công việc doanh nghiệp, và Astra nên là điểm leo thang thay vì điểm khởi đầu.
Ngoại lệ là suy luận phòng thí nghiệm ướt, nghiên cứu bảo mật được ủy quyền và các công việc khoa học khó nhất. Chênh 15,5 điểm trên TroubleshootingBench và 10 điểm trên Internal Port là quá lớn để khắc phục bằng thử lại.
| Trường hợp sử dụng | Phiên bản | Lý do |
|---|---|---|
| Di trú kho mã, tác tử lập trình nhiều bước | GPT-6.1 Sol, nỗ lực trung bình đến cao | Ngang DeepSWE v1.1 với Astra ở chi phí khoảng một phần năm |
| Tự động hóa trình duyệt và desktop | GPT-6.1 Sol | Kém Astra 2,1 điểm trên OSWorld 2.0 (bộ ngoại tuyến, nỗ lực tối đa) với chi phí mỗi tác vụ khoảng một phần bảy |
| Quy trình công việc doanh nghiệp nhiều bước | GPT-6.1 Sol | Vượt Opus 5.5 2,2 điểm trên AutomationBench ở mức nỗ lực trung bình, với chi phí khoảng một phần ba |
| Nghiên cứu bảo mật được ủy quyền | GPT-6 Astra | 31,5% so với 21,5% trên ExploitBench Internal Port và 85,4% so với 78,8% trên SEC-Bench Pro |
| Rà soát quy trình phòng thí nghiệm, khắc phục sự cố virus học | GPT-6 Astra | 63,46% so với 47,96% trên TroubleshootingBench |
| Nghiên cứu khoa học khó nhất | GPT-6 Astra | Dẫn đầu Terminal-Bench Science 0.1 ở 68,1%, và OpenAI khuyến nghị cho công việc này |
| Phân loại sơ bộ tệp, định tuyến, phân loại hàng loạt | GPT-6 Luna | Tầng rẻ nhất trong họ với $0.10 đầu vào và $0.50 đầu ra; chúng tôi dùng để thu hẹp 56 tệp xuống 16 trong tác tử di trú |
Mức nỗ lực suy luận là nút điều chỉnh thứ hai.
GPT-6.1 Sol chạy ở low, medium (mặc định), high, xhigh hoặc max, và token suy luận được tính theo mức đầu ra.
Con số $5.47 trên Terminal-Bench Science của OpenAI là một điểm dữ liệu ở mức nỗ lực tối đa, nên không cho thấy chi phí mở rộng theo các thiết lập. Hãy đo trên khối lượng công việc của bạn trước khi đặt mặc định.
Chế độ nhanh tính phí gấp đôi mức chuẩn và không khả dụng với cư trú dữ liệu EU. OpenAI cũng dự kiến tùy chọn GPT-6.1 Sol Ultrafast trong Codex với tốc độ sinh token nhanh hơn đến 8 lần, mà theo Neowin sẽ có giá gấp 6 lần tầng chuẩn.
GPT-6.1 Sol có giá $2.00 cho mỗi 1 triệu token đầu vào và $10.00 cho mỗi 1 triệu token đầu ra, giống GPT-6 Sol và bằng một phần năm mức $10 và $50 của Astra. Đầu vào từ bộ nhớ đệm giảm từ $0.20 xuống $0.10 cho mỗi 1 triệu token, ghi bộ nhớ đệm ở $2.50 cho mỗi 1 triệu.
Token suy luận được tính theo mức đầu ra, đây là con số cần chú ý ở mức nỗ lực cao và tối đa.
| Mức | Giá cho mỗi 1 triệu token |
|---|---|
| Đầu vào | $2.00 |
| Đầu vào từ bộ nhớ đệm | $0.10 |
| Ghi bộ nhớ đệm | $2.50 |
| Đầu ra | $10.00 |
Có một số hệ số điều chỉnh áp dụng bổ sung.
Các prompt vượt 272.000 token đầu vào bị tính gấp đôi mức đầu vào và bộ nhớ đệm và 1,5 lần mức đầu ra cho toàn bộ yêu cầu.
Chế độ nhanh gấp 2 lần mức chuẩn, xử lý theo vùng cộng phụ phí 10% nơi khả dụng, và Batch cùng Flex thấp hơn 50% so với chuẩn.
So với mẫu Opus mới nhất của Anthropic, khoảng cách chỉ rộng dưới mốc 272.000 token. C
laude Opus 5.5 có giá $4 cho mỗi 1 triệu token đầu vào và $20 cho mỗi 1 triệu token đầu ra, và tính toàn bộ cửa sổ 1 triệu token ở các mức đó, như chúng tôi đã đề cập trong hướng dẫn API Opus 5.5.
GPT-6.1 Sol rẻ bằng đúng một nửa dưới ngưỡng. Trên ngưỡng, GPT-6.1 Sol có giá $4 cho đầu vào và $15 cho đầu ra, nên lợi thế đầu vào biến mất.
Tầng cao nhất của Anthropic là Claude Fable 5.1, niêm yết $10 và $50, giống Astra.
Chế độ nhanh không khả dụng với cư trú dữ liệu EU, nên các triển khai châu Âu có yêu cầu cư trú mất tùy chọn độ trễ thấp trong khi vẫn giữ mức giá chuẩn.
GPT-6.1 Sol khả dụng trong ChatGPT Work và Codex, trong OpenAI API, và qua một số nền tảng bên thứ ba. Tính đến ngày 29 tháng 9 năm 2026, đây là các kênh chúng tôi xác nhận được:
gpt-6.1-sol.gpt-6.1-sol.openai/gpt-6.1-sol), Vercel AI Gateway, và GitHub Copilot cho người dùng Pro+, Max, Business và Enterprise.Dùng Responses API để gọi công cụ. Chat Completions chỉ hoạt động với mẫu này khi không có công cụ. Không gửi mức nỗ lực none hoặc minimal, vì cả hai đều không hỗ trợ.
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6.1-sol",
    input="Find the retry-policy change in this diff and explain the blast radius.",
    reasoning={"effort": "medium"},  # low, medium, high, xhigh, or max
)
print(response.output_text)GPT-6.1 Sol mang lại phần lớn hiệu năng tác vụ của Astra với giá token bằng một phần năm, khiến nó trở thành mặc định hợp lý cho lập trình tác vụ, sử dụng máy tính và quy trình doanh nghiệp.
OpenAI đặt cược rằng đa số nhà phát triển không cần “giới hạn tiên phong”, mà chỉ cần đầu ra của nó ở mức giá có thể chạy lặp.
Với $5.47 cho mỗi tác vụ Terminal-Bench Science 0.1 so với $23.80 của Astra, ván cược đó rất rõ ràng, và tạo sức ép lên Claude Opus 5.5 ở $23.21. Câu trả lời của Anthropic đến sớm một ngày với Claude Sonnet 5.5, cũng niêm yết $2 và $10.
Tôi sẽ chuyển từ GPT-6 Sol sau khi bạn xử lý di trú. Giá là như nhau, và các con số về phát triển khai thác, gỡ lỗi nghiên cứu và tính thực tế ở nỗ lực thấp đều tốt hơn rõ rệt. Nhưng mã dựa vào mức none hoặc gọi hàm Chat Completions sẽ cần thay đổi trước.
Tôi cũng sẽ giữ bước kiểm duyệt của con người cho các lượt chạy tác tử không giám sát, vì đánh lừa khi lập trình (1,50% so với 0,51% của Astra) và kiên trì không mong muốn (23,5% so với 17,4%) đều cao hơn Astra.
Tôi sẽ giữ Astra cho suy luận phòng thí nghiệm ướt, nghiên cứu bảo mật được ủy quyền và các tác vụ khoa học khó nhất, nơi chênh 15,5 điểm trên TroubleshootingBench và 10 điểm trên ExploitBench Internal Port là đáng kể.
Gần như mọi con số ở đây là của chính OpenAI, với kết quả đối thủ từ báo cáo công khai và chưa có tái lập độc lập được công bố. Hãy tự chạy đánh giá trên khối lượng công việc của bạn trước khi cam kết.
Nếu bạn muốn xây dựng với các mô hình như thế này thay vì chỉ đọc về chúng, tôi khuyên bắt đầu với lộ trình kỹ năng AI Fundamentals.
Các khóa học hàng đầu trên DataCamp
Tracks
Courses
Courses
blogs
Matt Crabtree
10 phút
