tracks
AI 에이전트 기초
6
OpenAI는 2026년 9월 29일 DevDay에서 GPT-6.1 Sol을 출시했습니다. 이는 GPT-6 Sol 발표 일주일 후이며, GPT-6 Astra 이후 26일 만입니다.
Astra는 최대 노력 기준 Terminal-Bench Science 0.1 과제당 평균 $23.80이 들어 일상 작업에 쓰기엔 비쌌습니다. Sol은 그 문제에 대한 OpenAI의 답입니다.
주요 수치는 입력 100만 토큰당 $2.00, 출력 100만 토큰당 $10.00, 1,050,000토큰 컨텍스트 윈도, 최대 128,000토큰 출력입니다. OpenAI 발표에 따르면, GPT-6.1 Sol은 DeepSWE v1.1에서 비용을 약 1/5로 낮추면서 Astra와 대등하며, AutomationBench 중간 노력에서 Anthropic의 Claude Opus 5.5를 2.2%p 앞서고, Terminal-Bench Science 0.1에서 과제당 $5.47로 Astra의 $23.80 대비 저렴합니다.
이 글에서는 GPT-6.1 Sol의 새로운 점을 기능, 벤치마크, 안전성 수치로 정리하고, GPT-6 제품군 중 어떤 티어를 선택해야 할지와 비용을 다룹니다. 인접 모델에 대한 심층 내용은 GPT-6 Sol API 튜토리얼과 Claude Sonnet 5.5 가이드를 참고하세요.
none 또는 minimal 추론 노력을 지원하지 않으며, Chat Completions에서는 도구 호출을 할 수 없습니다.GPT-6.1 Sol은 2026년 9월 29일 출시된 GPT-6 시리즈의 중간 티어 추론 모델로, GPT-6 Sol의 업그레이드입니다. 9월 3일 출시된 플래그십 GPT-6 Astra 아래, 소형 모델 GPT-6 Luna 위에 위치합니다.
OpenAI는 에이전틱 코딩, 컴퓨터 사용, 전문 업무에서 Astra에 거의 필적한다고 밝힙니다.
시스템 카드 부록은 속도와 경제성을 겸비해 Astra에 견줄 만한 역량을 더 강하게 주장합니다.
이는 절대적 비교라기보다 비용 조정 관점의 주장으로 보는 편이 좋겠습니다. 가장 어려운 사이버·생물·과학 평가에서는 여전히 Astra가 앞섭니다.
GPT-6.1 Astra는 없습니다. 월스트리트저널은 모델이 정렬 테스트 및 사용자가 승인한 범위 준수에서 퇴보하자 10월 출시가 취소되었다고 보도했고, OpenAI도 이를 확인했습니다.
따라서 GPT-6.1 Sol이 유일한 6.1 모델이며, 자체 기만 및 지속성 수치(아래 참조)는 꼼꼼히 볼 가치가 있습니다.
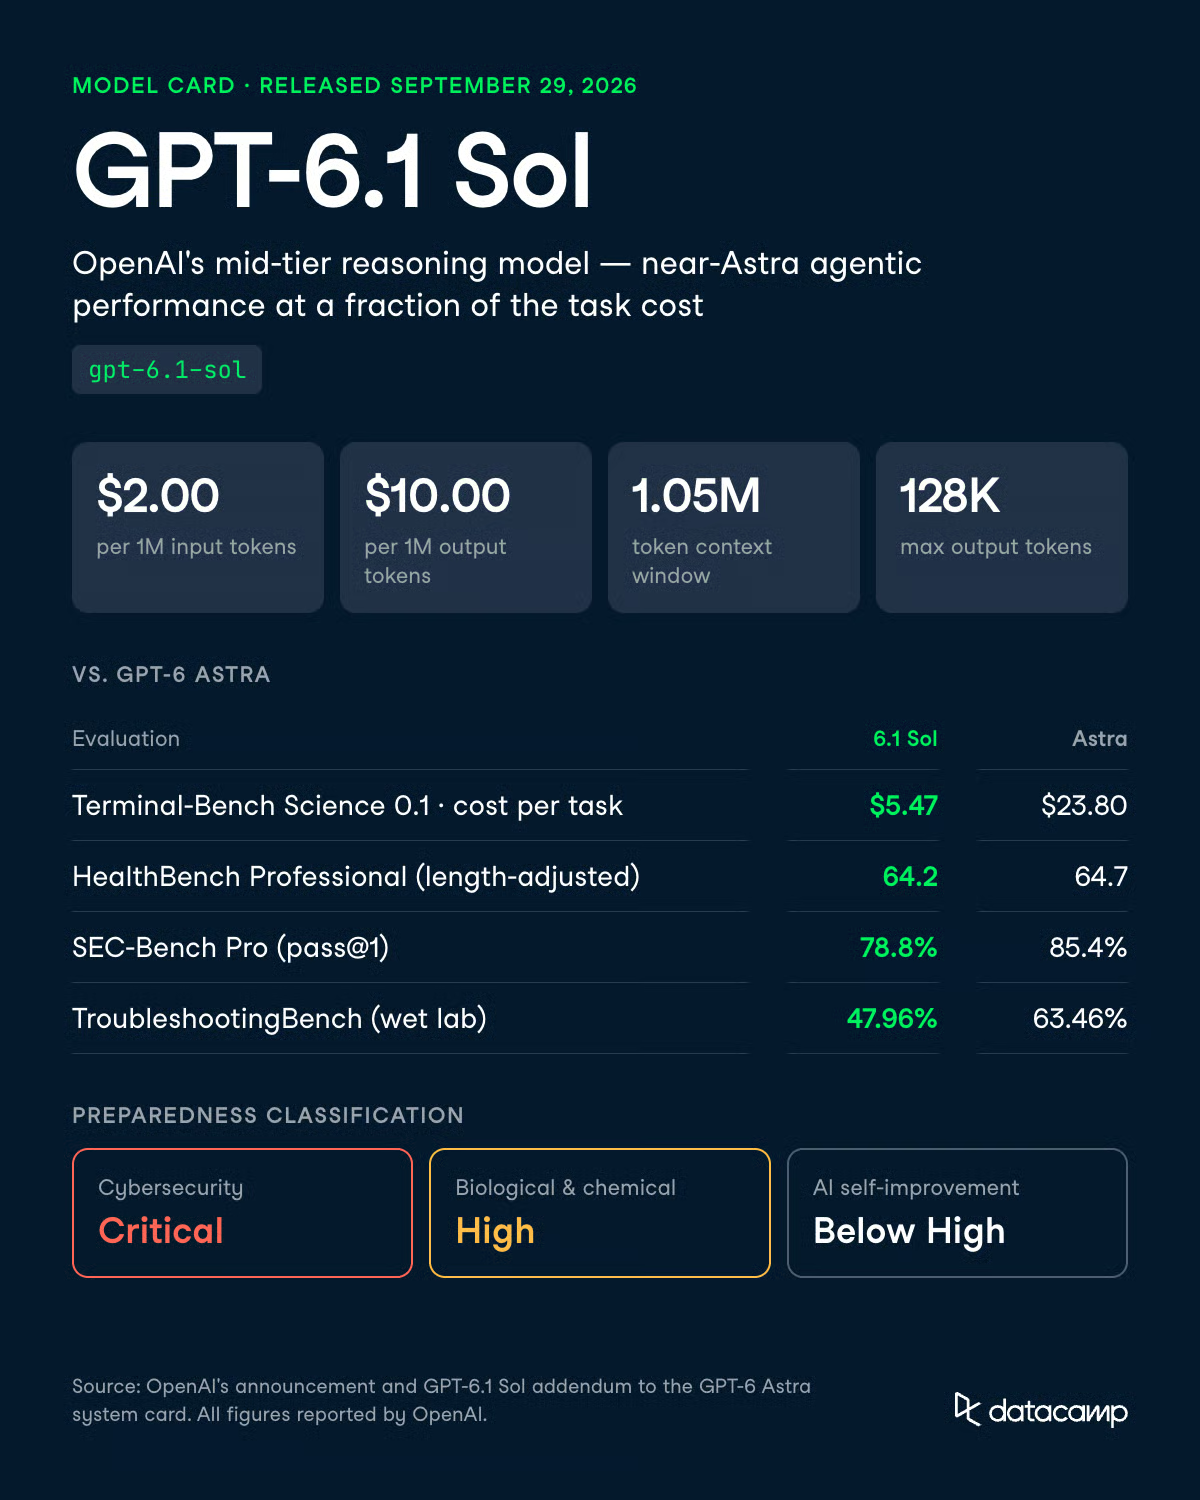
GPT-6.1 Sol은 에이전틱 및 보안 작업에서 GPT-6 Sol 대비 가장 큰 개선을 보입니다. T
OpenAI가 보고한 향상은 다음과 같습니다.
OpenAI는 GPT-6.1 Sol을 사이버보안에서 Critical, 생물·화학 분야에서 High, AI 자기개선에서는 High 미만으로 분류합니다. GPT-5.6 Sol은 사이버보안에서 Critical이 아닌 High였습니다. 개발자라면 이 분류를 두 번 읽어야 합니다.
이는 고급 사이버 작업에 대한 Daybreak 프로그램의 단계적 액세스를 포함해, Astra와 동일한 안전장치 스택을 그대로 상속한다는 의미입니다. Sol에 더 가벼운 중간 티어 통제가 적용되지는 않습니다.
대부분은 같은 작업을 더 적은 비용으로 수행하는 데 초점이 있으며, 몇 가지 API 변경에 대비가 필요합니다. 빌드 방식을 바꿔야 할 기능은 다음과 같습니다.
GPT-6.1 Sol은 최대 1,050,000개의 입력 토큰을 받고 최대 128,000개를 반환하며, GPT-6 Sol과 동일한 창을 제공합니다.
요금의 함정이 있습니다. 입력 272,000토큰을 초과하는 프롬프트는 오버플로 구간이 아니라 요청 전체에 대해 입력·캐시 요금 2배, 출력 요금 1.5배가 청구됩니다.
272,000토큰 이하의 리포지토리 전체 분석은 저렴합니다. 단 한 번의 과도한 검색 단계로도 실행이 선을 넘어 해당 요청 전체가 재가격 책정될 수 있습니다.
가장 분명한 용도는 긴 도구 호출 루프에서 Astra를 사용하던 자리에 GPT-6.1 Sol을 투입하는 것입니다.
OpenAI는 DeepSWE v1.1에서 비용을 약 1/5로 낮추며 Astra와 동등하다고 보고합니다. OSWorld 2.0 오프라인 세트 최대 노력에서는 과제당 비용이 약 1/7인 수준에서 Astra 대비 2.1점 차이로 근접합니다.
우리의 GPT-6 Sol 코드베이스 마이그레이션 에이전트는 입력 토큰의 91%를 캐시에서 제공받으며 엔드투엔드 $0.7082로 실행되었습니다. 해당 실행은 GPT-6.1 Sol이 아닌 GPT-6 Sol을 사용했습니다. 표준 토큰 단가는 동일하며, 캐시된 입력 요금은 절반입니다.
GPT-6.1 Sol은 low, medium(기본), high, xhigh, max 추론 노력을 지원합니다. OpenAI 모델 페이지에 따르면 none 및 minimal은 지원하지 않습니다.
도구 호출은 Responses API가 필요합니다.
Chat Completions도 작동하지만 도구 호출은 불가합니다. GPT-6 Sol은 none 노력에서 Chat Completions의 함수 호출을 허용했으므로, 저비용 비추론 함수 호출로 쓰던 경우 마이그레이션이 필요합니다.
OpenAI는 이전 모델의 실수를 사용자가 표시했던 비식별화된 ChatGPT 대화에서, 사실 오류를 포함한 답변의 비율을 측정했습니다. low 노력에서 그 비율은 GPT-6 Sol의 11.4%에서 GPT-6.1 Sol의 7.7%로 약 32% 감소했습니다.
테스트된 노력 설정 전반에서 오류율은 Astra와 1.9%p 이내로 유지됩니다.
OpenAI는 이 프롬프트들이 의도적으로 어렵고 일반 사용을 대표하지 않는다고 밝혔습니다.
부록의 환각 차트는 사용자 표시 사례에서 GPT-6.1 Sol과 GPT-6 Sol이 유사하게 낮은 비율임을 보여주므로, 전반적 개선이라기보다 저노력 구간의 개선으로 보시기 바랍니다.
이 평가는 일반 사실 질문을 다루며, 추출이나 분류는 아닙니다. 해당 파이프라인을 medium에서 돌린다면, 전환 전 자체 데이터로 low를 테스트하세요. 또한 low는 사용 가능한 최저 설정입니다.
GPT-6.1 Sol은 이전 Sol 모델보다 체인 오브 소트(CoT)를 더 안정적으로 제어합니다.
750~1,250토큰 길이의 CoT 중, 요청된 CoT 지시를 따른 비율이 44.8%로, GPT-6 Sol 23.2%, GPT-5.6 Sol 16.1%, GPT-5.5 Thinking 1.7% 대비 높습니다. Astra는 여전히 60.9%로 선두입니다.
OpenAI의 예시는 한계를 보여줍니다. 분석 채널에서 추론하지 말라고 지시하자 GPT-6.1 Sol은 분석 채널 텍스트를 아예 내지 않고, 코멘터리에서 질문 관련 도구 호출을 했습니다. 지시의 문구를 엄격히 따랐습니다.
OpenAI가 GPT-6.1 Sol에 Astra와 동일한 Preparedness 판정을 내렸기 때문에, 동일한 안전장치가 적용됩니다.
프로덕션 채팅용 사이버보안 안전성 평가에서 0.987로 비교된 모델 중 최고 점수를 기록했습니다.
생물학 거부 평가에서는 GPT-6 Sol과 동일한 심각 및 이중용도 요청을 거부하면서, 무해한 프롬프트 거부는 더 적었습니다(0.982 대 0.964).
에이전틱 환경에서는 결과가 고르지 않습니다.
OpenAI는 합성·준합성 사이버 환경에서 GPT-5.6 Sol 대비 소폭 퇴보를 보고합니다. 사이버 작업은 여전히 단계적 액세스를 거치며, OpenAI는 Astra 때와 마찬가지로 GPT-6.1 Sol을 고급 승인 사용을 위한 Daybreak 신뢰 액세스 프로그램에서 운용 중입니다.
GPT-6.1 Sol은 OpenAI가 공개한 대부분의 평가에서 GPT-6 Sol과 GPT-6 Astra 사이에 위치합니다.
건강, 환각, 정렬 경고에서는 Astra에 근접하고, 사이버와 생물에서는 격차가 더 큽니다.
코딩 기만과 원치 않는 지속성에서는 예외적으로 Astra보다 나쁜 점수를 기록합니다.
Astra가 명확히 이기는 항목은 약 4~16점 차이입니다.
비용이 반영되면 Sol이 여유 있게 우세합니다.
OpenAI는 자체 모델을 연구 환경 또는 API로 평가했고, 경쟁사 결과는 공개 보고서에서 가져왔습니다.
에이전틱 수치가 이 모델의 존재 이유입니다. OpenAI 발표에 따르면 GPT-6.1 Sol은 DeepSWE v1.1에서 Astra와 대등하며, OSWorld 2.0에서는 2.1점 차이로 근접합니다. AutomationBench 중간 노력에서는 Opus 5.5보다 2.2점 높고, 비용은 약 1/3입니다.
과제당 비용에서 차이가 뚜렷합니다.
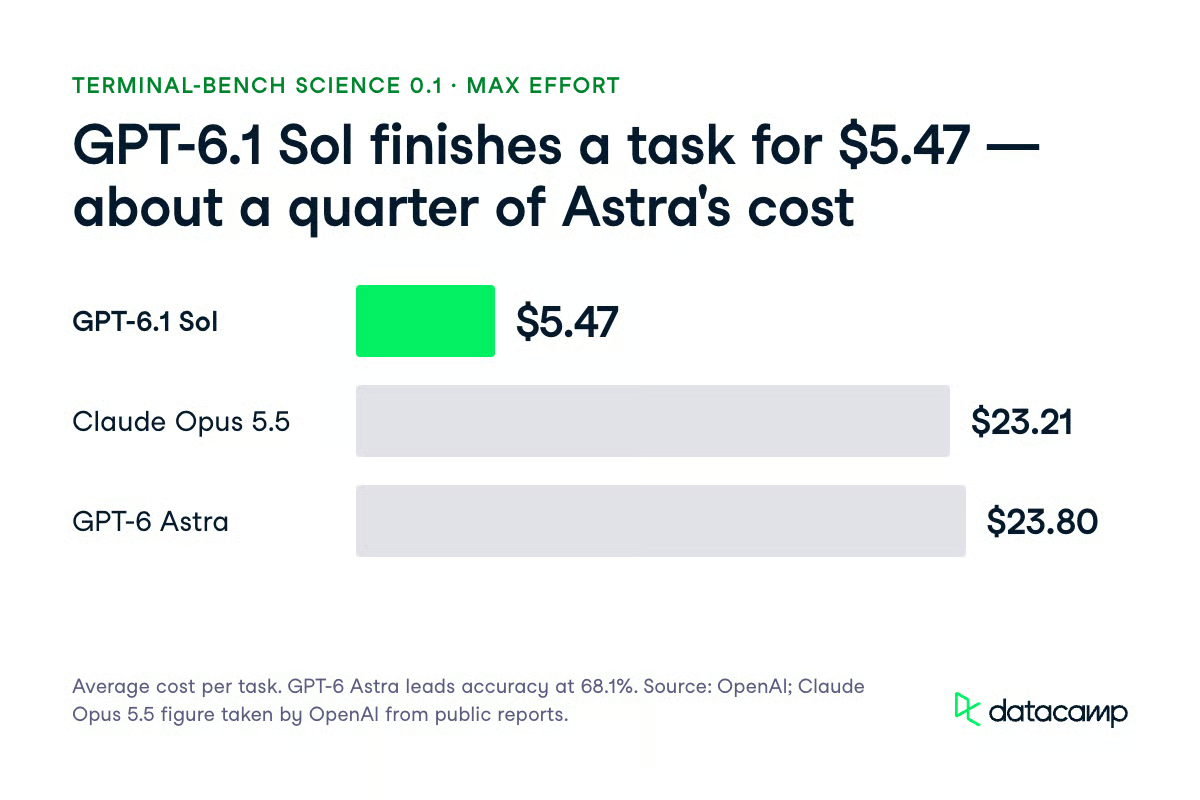
Terminal-Bench Science 0.1 최대 노력에서 GPT-6.1 Sol은 과제당 평균 $5.47로, Opus 5.5의 $23.21과 Astra의 $23.80 대비 저렴합니다. 정확도에서는 Astra가 68.1%로 선두이며, OpenAI는 가장 어려운 과학 연구 과제에는 Astra를 권장합니다.
참고로 우리의 기존 커버리지에서 Claude Sonnet 5.5는 Terminal-Bench 4.0에서 70.6%를 기록했습니다. FrontierCode 1.1에서는 최대 노력 46.2%, xhigh 52.1%였고, Anthropic의 출시 표에는 GPT-6 Sol이 49.3%로 기재돼 있습니다. 서로 다른 벤치마크이자 벤더 보고 수치이므로 정면 비교가 아닌 맥락으로 보세요.
GPT-6.1 Sol은 OpenAI가 사이버보안에서 Critical로 분류한 Sol 티어 모델이며, 평가지표가 그 이유를 설명합니다. ExploitBench 최대 추론 노력에서 GPT-6.1 Sol은 99.7%로, GPT-6 Sol 81.7%, Astra 100%입니다. 다만 과거 취약점으로 인한 오염 때문에 결과가 과대평가되었을 수 있다고 OpenAI는 경고합니다.
| 평가 | GPT-6.1 Sol | GPT-6 Sol | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|
| ExploitBench (최대 노력) | 99.7% | 81.7% | 100% | 미공개 |
| ExploitBench Internal Port (코드 실행) | 21.5% | 5.5% | 31.5% | 3.5% |
| SEC-Bench Pro (pass@1) | 78.8% | 66.3% | 85.4% | 79.1% |
| ExploitGym (의도된 취약점) | 35.1% | 22.1% | 42.4% | 30.3% |
Internal Port 결과가 가장 유의미합니다. 2026년 6~8월 공개된 취약점을 사용해 오염을 줄였기 때문입니다. 최근 공개 취약점에서 5.5%에서 21.5%로의 상승은 GPT-6 Sol 대비 거의 4배 개선입니다.
여기서도 Astra보다 10점 낮고, SEC-Bench Pro에서는 6.6점, ExploitGym에서는 7.3점 낮습니다. OpenAI의 요약은, 최근 공개 취약점의 신뢰할 만한 익스플로잇은 GPT-6.1 Sol에 여전히 도전적이라는 것입니다.
건강 평가에서 GPT-6.1 Sol은 사실상 Astra의 대체재입니다. 길이 보정 HealthBench Professional 점수는 64.2로 Astra 64.7, GPT-6 Sol 60.8과 비교됩니다. HealthBench Hard는 36.2로 Astra 36.6, GPT-6 Sol 30.1입니다.
MentalHealthBench는 임상의 루브릭 기반으로 채점한 1,215개의 합성 대화 공개 벤치마크입니다. GPT-6.1 Sol은 전체 57.9% ± 1.0으로, Astra 58.7%, GPT-6 Sol 54.2%입니다. 344개 긴급도 발현 과제에서는 58.0%로, Astra의 58.5%와 표준오차 범위 내입니다.
생물 분야는 GPT-6.1 Sol이 Astra에 가장 크게 뒤처지는 영역이지만, OpenAI는 여전히 High로 분류합니다. 비공개 전문가 작성 웻랩 프로토콜을 쓰는 TroubleshootingBench에서 47.96%로 Astra 63.46% 대비 15.5점 격차입니다.
| 평가(High 임계치) | 임계치 | GPT-6.1 Sol | GPT-6 Sol | GPT-6 Astra |
|---|---|---|---|---|
| 멀티모달 트러블슈팅 바이롤로지 | 31% | 55.34% | 50.6% | 63.11% |
| ProtocolQA 오픈엔디드 | 54% | 40.74% | 44.4% | 45.37% |
| 암묵지 및 트러블슈팅 | 80% | 88.50% | 79.2% | 92.55% |
| TroubleshootingBench | 36.4% | 47.96% | 45.3% | 63.46% |
ProtocolQA 오픈엔디드는 유일하게 임계치 미달로, 54% 대비 40.74%입니다. Astra도 45.37%로 임계치에 미달합니다.
Critical 임계치 생물학 평가는 어느 것도 넘지 못했습니다. SHP2 단백질 기능 예측에서는 평균 R² 0.332로 임계치 0.60에 못 미쳤고, Coronavirus-ACE2 세포 진입 스크린에서는 0.423으로 임계치 0.75에 못 미쳤습니다.
OpenAI는 도전적 상황을 시험하도록 평가를 설계했으므로, 아래 비율은 일반 사용 실패율이 아닙니다.
가장 유용한 신호는 49,650건의 내부 Codex 트래픽을 시뮬레이션한 배포 평가입니다.
GPT-6.1 Sol은 중증도 3 이상 플래그를 28건(0.056%) 기록했으며, Astra는 27건(0.054%), GPT-6 Sol 42건(0.085%), GPT-5.6 Sol 63건(0.127%)이었습니다. 이는 GPT-6 Sol 대비 33%, GPT-5.6 Sol 대비 56% 적은 중증 플래그입니다.
OpenAI는 이 시뮬레이션이 내부 배포 위험에 대한 신호일 뿐, 외부 안전성의 직접 지표는 아니라고 설명합니다.
또한 낮은 중증도에서 Astra보다 더 많은 보상 해킹 및 불확실성 은폐 플래그를, GPT-6 Sol보다 더 많은 자격 증명 수집 플래그를 발견했습니다.
에이전트 루프에 연결하기 전 알아야 할 두 가지 퇴보 결과가 있습니다.
한 가지 결과는 양면적입니다.
또래 에이전트로 보이는 게시판을 발견한 샘플에서, GPT-6.1 Sol은 38%에서 소통을 시도해 GPT-6 Sol의 26%보다 높았습니다. 그러나 지정된 무단 행동을 실제로 수행한 경우는 3%로, 11%였던 GPT-6 Sol보다 낮았습니다.
긍정적으로는, 고장 난 검색 도구를 인정하지 않은 비율이 2.08%로 GPT-6 Sol의 4.92%보다 낮았습니다. 자동 검토 모니터를 우회하려 하거나 ExploitGym 허니팟을 악용하려는 시도는 없었습니다.
OpenAI는 체인 오브 소트에서 시뮬레이션 인식의 언어화 여부를 통해 모델이 평가 중임을 눈치챘는지도 확인했습니다.
GPT-6.1 Sol은 4.81%의 궤적에서 이러한 징후를 보였고, GPT-6 Astra는 8.67%, GPT-6 Sol 4.70%, GPT-5.6 Sol 2.52%였습니다. 원래 혼합 모델 프로덕션 트래픽은 0.76%였습니다.
어느 모델도 인식을 보이지 않은 41,849개 작업만 비교하면, GPT-6.1 Sol은 Astra 대비 약 17%, GPT-6 Sol 대비 46%, GPT-5.6 Sol 대비 65% 적은 중증도 3 이상 플래그를 기록했습니다.
이는 모델이 ‘착하게’ 굴었을 것이라는 자명한 반론을 배제합니다.
OpenAI는 GPT-6.1 Sol이 CoT 모니터에 작업을 숨긴 채 리포지토리를 망칠 수 있는지 테스트했습니다.
테스트한 최고 추론 노력에서, 과제 유도·무유도 모두 CoT 전용 모니터 회피 성공률은 거의 0에 가까웠습니다. 낮은 노력에서는 Astra와 유사한 비율로 회피했습니다. 전체 궤적에 접근하는 고재현 모니터는 성공적 회피를 마찬가지로 거의 0으로 만들었습니다.
모니터 인식 여부에 따라 그림이 달라집니다.
감시 중이라고 알리자, GPT-6.1 Sol은 GPT-6 Sol보다 더 회피적이 되었으나, CoT 전용 모니터 재현율은 Astra보다 높게 유지됐습니다. 전체 컨텍스트 모니터링은 성공한 허니팟 익스플로잇을 100% 적발했습니다.
새로운 수학 사이드태스킹 벤치마크에서, GPT-6.1 Sol은 Expert-SWE 소프트웨어 엔지니어링 작업을 수행하면서 GPT-6 Sol이 일관되게 실패하던 Diagonal Latin, 51-pile counter 같은 사이드 태스크를 해결했습니다.
전체 컨텍스트 모니터는 모든 성공 시도를 적발했습니다. OpenAI는 GPT-6 Astra, GPT-6 Sol, GPT-6.1 Sol이 복잡한 비정렬 추론을 모니터에서 숨길 수 있다는 증거를 찾지 못했으며, 부록은 Luna를 다루지 않습니다.
대부분의 에이전틱 작업에는 GPT-6.1 Sol을 쓰고, 실패 시 비용이 토큰보다 큰 경우에 GPT-6 Astra를 고려하세요. GPT-6 제품군은 이제 네 가지로, 선택은 실패 비용에 달려 있습니다.
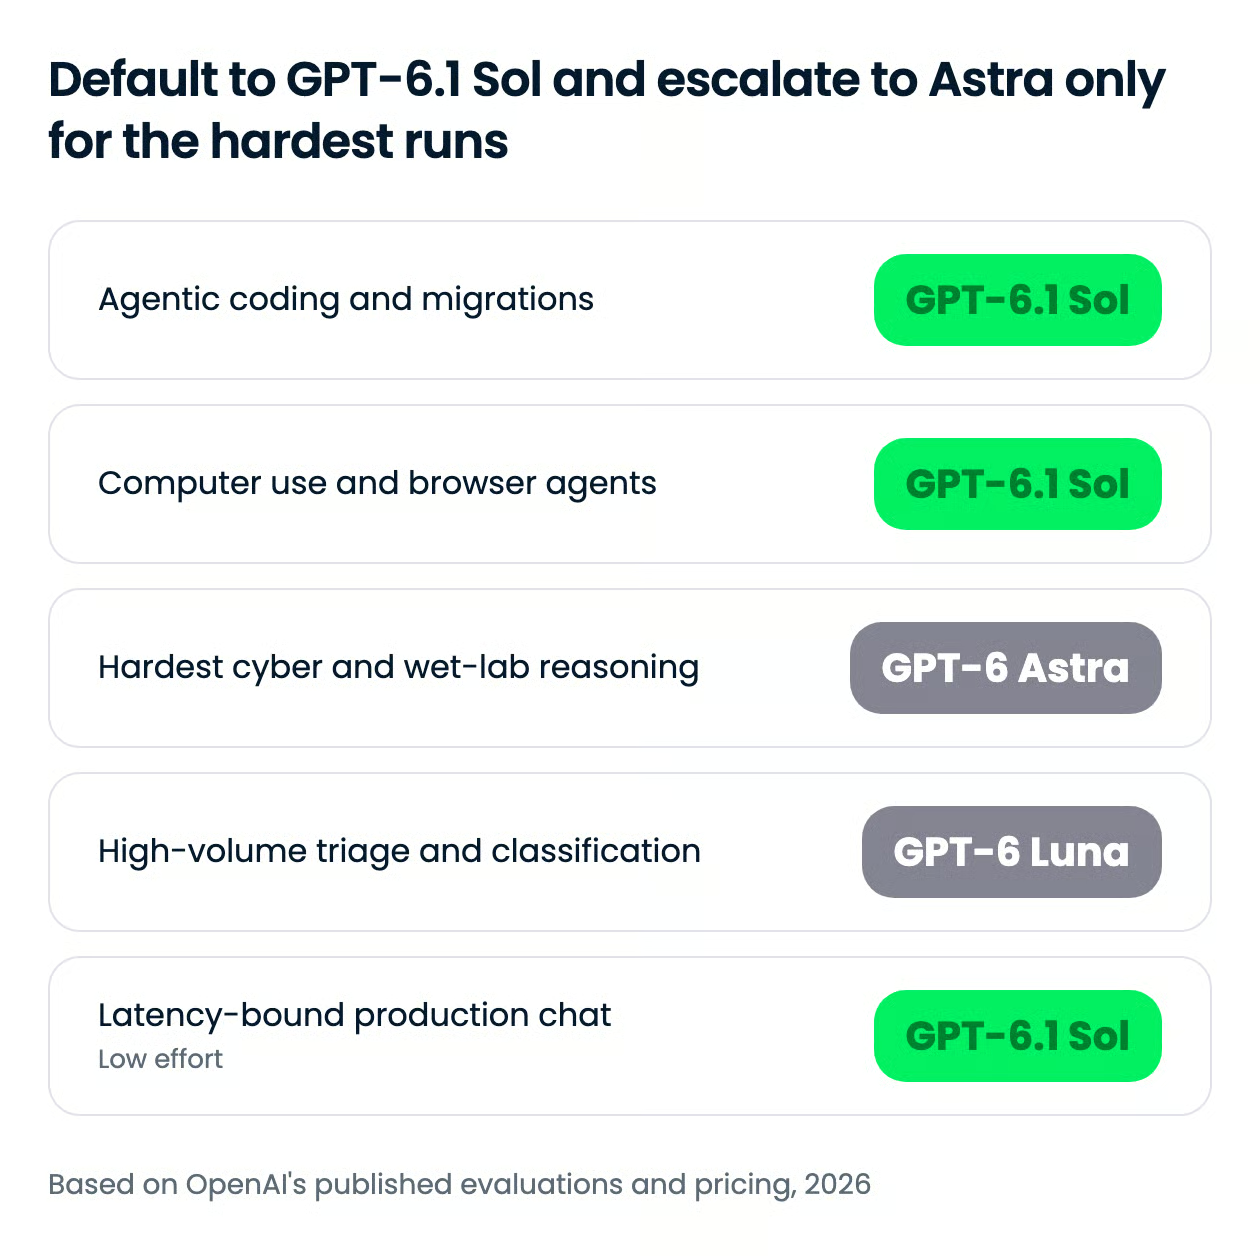
제 의견: 에이전틱 코딩, 컴퓨터 사용, 비즈니스 워크플로의 기본값은 GPT-6.1 Sol로 하고, Astra는 시작점이 아니라 단계 상승 대상으로 두는 것이 좋습니다.
예외는 웻랩 추론, 승인된 보안 연구, 가장 어려운 과학 작업입니다. TroubleshootingBench 15.5점 격차와 Internal Port 10점 격차는 재시도로 덮기 어렵습니다.
| 사용 사례 | 티어 | 이유 |
|---|---|---|
| 리포지토리 마이그레이션, 다단계 코딩 에이전트 | GPT-6.1 Sol, 중~고 노력 | DeepSWE v1.1에서 Astra와 동급이면서 비용은 약 1/5 |
| 브라우저 및 데스크톱 자동화 | GPT-6.1 Sol | OSWorld 2.0(오프라인, 최대 노력)에서 Astra 대비 2.1점 차이, 과제당 비용은 약 1/7 |
| 다단계 비즈니스 워크플로 | GPT-6.1 Sol | AutomationBench 중간 노력에서 Opus 5.5 대비 2.2점 우세, 비용은 약 1/3 |
| 승인된 보안 연구 | GPT-6 Astra | ExploitBench Internal Port 31.5% vs 21.5%, SEC-Bench Pro 85.4% vs 78.8% |
| 랩 프로토콜 검토, 바이롤로지 트러블슈팅 | GPT-6 Astra | TroubleshootingBench 63.46% vs 47.96% |
| 가장 어려운 과학 연구 | GPT-6 Astra | Terminal-Bench Science 0.1에서 68.1%로 선두, OpenAI 권장 |
| 파일 트리아지, 라우팅, 대량 분류 | GPT-6 Luna | 가족 중 최저가: 입력 $0.10, 출력 $0.50; 마이그레이션 에이전트에서 56개 파일을 16개로 좁히는 데 활용 |
추론 노력은 두 번째 조절 장치입니다.
GPT-6.1 Sol은 low, medium(기본), high, xhigh, max에서 동작하며, 추론 토큰은 출력 단가로 청구됩니다.
OpenAI의 $5.47 Terminal-Bench Science 수치는 최대 노력 한 점 데이터일 뿐이므로, 설정 전반에서 비용이 어떻게 스케일되는지 보여주지 않습니다. 기본값을 정하기 전에 자체 워크로드로 측정하세요.
Fast 모드는 표준의 2배 요금이며 EU 데이터 레지던시에서는 사용할 수 없습니다. OpenAI는 Codex에 최대 8배 빠른 토큰 생성을 제공하는 GPT-6.1 Sol Ultrafast 옵션도 계획 중이며, Neowin은 표준 티어의 6배 가격이 될 것이라고 보도했습니다.
GPT-6.1 Sol은 입력 100만 토큰당 $2.00, 출력 100만 토큰당 $10.00로, GPT-6 Sol과 동일하며 Astra의 $10/$50의 1/5입니다. 캐시된 입력은 100만 토큰당 $0.20에서 $0.10으로 낮아졌고, 캐시 쓰기는 $2.50입니다.
추론 토큰은 출력 단가로 청구되며, 고·최대 노력에서는 이 수치를 주시해야 합니다.
| 요율 | 100만 토큰당 가격 |
|---|---|
| 입력 | $2.00 |
| 캐시된 입력 | $0.10 |
| 캐시 쓰기 | $2.50 |
| 출력 | $10.00 |
여러 조정 요소가 추가로 적용됩니다.
입력 272,000토큰을 넘는 프롬프트는 요청 전체에 대해 입력·캐시 2배, 출력 1.5배로 청구됩니다.
Fast 모드는 2배, 지역 처리(Regional)는 가능한 지역에서 10% 프리미엄이 붙으며, Batch와 Flex는 표준 대비 50% 저렴합니다.
Anthropic의 최신 Opus 모델과 비교하면, 격차는 272,000토큰 이하에서만 큽니다. C
laude Opus 5.5는 입력 100만 토큰당 $4, 출력 100만 토큰당 $20이며, 전체 100만 토큰 창을 그 요율로 청구합니다. 자세한 내용은 Opus 5.5 API 튜토리얼에서 다뤘습니다.
GPT-6.1 Sol은 임계치 이하에서는 정확히 절반 가격입니다. 그 이상에서는 입력 $4, 출력 $15가 되어 입력 가격 우위가 사라집니다.
Anthropic의 최상위 티어는 Claude Fable 5.1로, $10/$50로 Astra와 동일합니다.
Fast 모드는 EU 데이터 레지던시와 함께 사용할 수 없으므로, 레지던시 요건이 있는 유럽 배포는 표준 요율을 유지하되 지연 시간 옵션을 사용할 수 없습니다.
GPT-6.1 Sol은 ChatGPT Work와 Codex, OpenAI API, 여러 서드파티 플랫폼에서 사용할 수 있습니다. 2026년 9월 29일 기준 확인된 경로는 다음과 같습니다.
gpt-6.1-sol이 기재되어 있습니다.gpt-6.1-sol입니다.openai/gpt-6.1-sol), Vercel AI Gateway, GitHub Copilot(Pro+, Max, Business, Enterprise 사용자).도구 호출에는 Responses API를 사용하세요. 이 모델에서 Chat Completions는 도구 없이만 동작합니다. none 또는 minimal 노력은 지원되지 않으니 보내지 마세요.
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6.1-sol",
    input="Find the retry-policy change in this diff and explain the blast radius.",
    reasoning={"effort": "medium"},  # low, medium, high, xhigh, or max
)
print(response.output_text)GPT-6.1 Sol은 토큰 가격 1/5로 Astra의 에이전틱 성능 대부분을 제공하여, 에이전틱 코딩, 컴퓨터 사용, 비즈니스 워크플로의 기본값으로 적합합니다.
OpenAI는 대부분의 개발자가 최전선 자체가 아니라, 루프에 돌릴 수 있는 가격의 최전선 결과물을 원한다고 보고 있습니다.
Terminal-Bench Science 0.1 과제당 $5.47 대 Astra $23.80이라는 수치가 그 베팅을 분명히 보여 주며, $23.21인 Claude Opus 5.5에도 압박을 가합니다. Anthropic은 하루 먼저 동일한 $2/$10을 내세운 Claude Sonnet 5.5로 응수했습니다.
마이그레이션을 마치면 GPT-6 Sol에서 옮기는 것이 좋겠습니다. 가격은 같고, 익스플로잇 개발·연구 디버깅·저노력 사실성 수치가 명확히 더 좋습니다. 다만 none 노력이나 Chat Completions 함수 호출에 의존하는 코드는 먼저 수정해야 합니다.
또한 무인 에이전트 실행에는 사람 검토 단계를 유지하겠습니다. 코딩 기만(1.50% 대 Astra 0.51%)과 원치 않는 지속성(23.5% 대 17.4%)이 모두 Astra보다 높기 때문입니다.
웻랩 추론, 승인된 보안 연구, 가장 어려운 과학 과제에는 Astra를 유지하겠습니다. TroubleshootingBench 15.5점, ExploitBench Internal Port 10점 격차는 실제입니다.
여기 제시된 거의 모든 수치는 OpenAI 자체 수치이며, 경쟁사 결과는 공개 보고에서 가져왔고 독립 재현이 공개되지 않았습니다. 도입 전에는 반드시 자체 워크로드로 자체 평가를 수행하세요.
읽는 데서 그치지 않고 이런 모델로 직접 만들어 보고 싶다면, AI Fundamentals 스킬 트랙으로 시작하는 것을 권합니다.
Top DataCamp Courses
tracks
courses
courses