Track
Podstawy agentów AI
6 godz.
OpenAI wypuściło GPT-6.1 Sol 29 września 2026 na DevDay, tydzień po GPT-6 Sol i 26 dni po GPT-6 Astra.
Astra osiągała średnio $23.80 za zadanie w Terminal-Bench Science 0.1 przy maksymalnym wysiłku, co wyceniało ją poza rutynową pracę. Sol to odpowiedź OpenAI na ten problem.
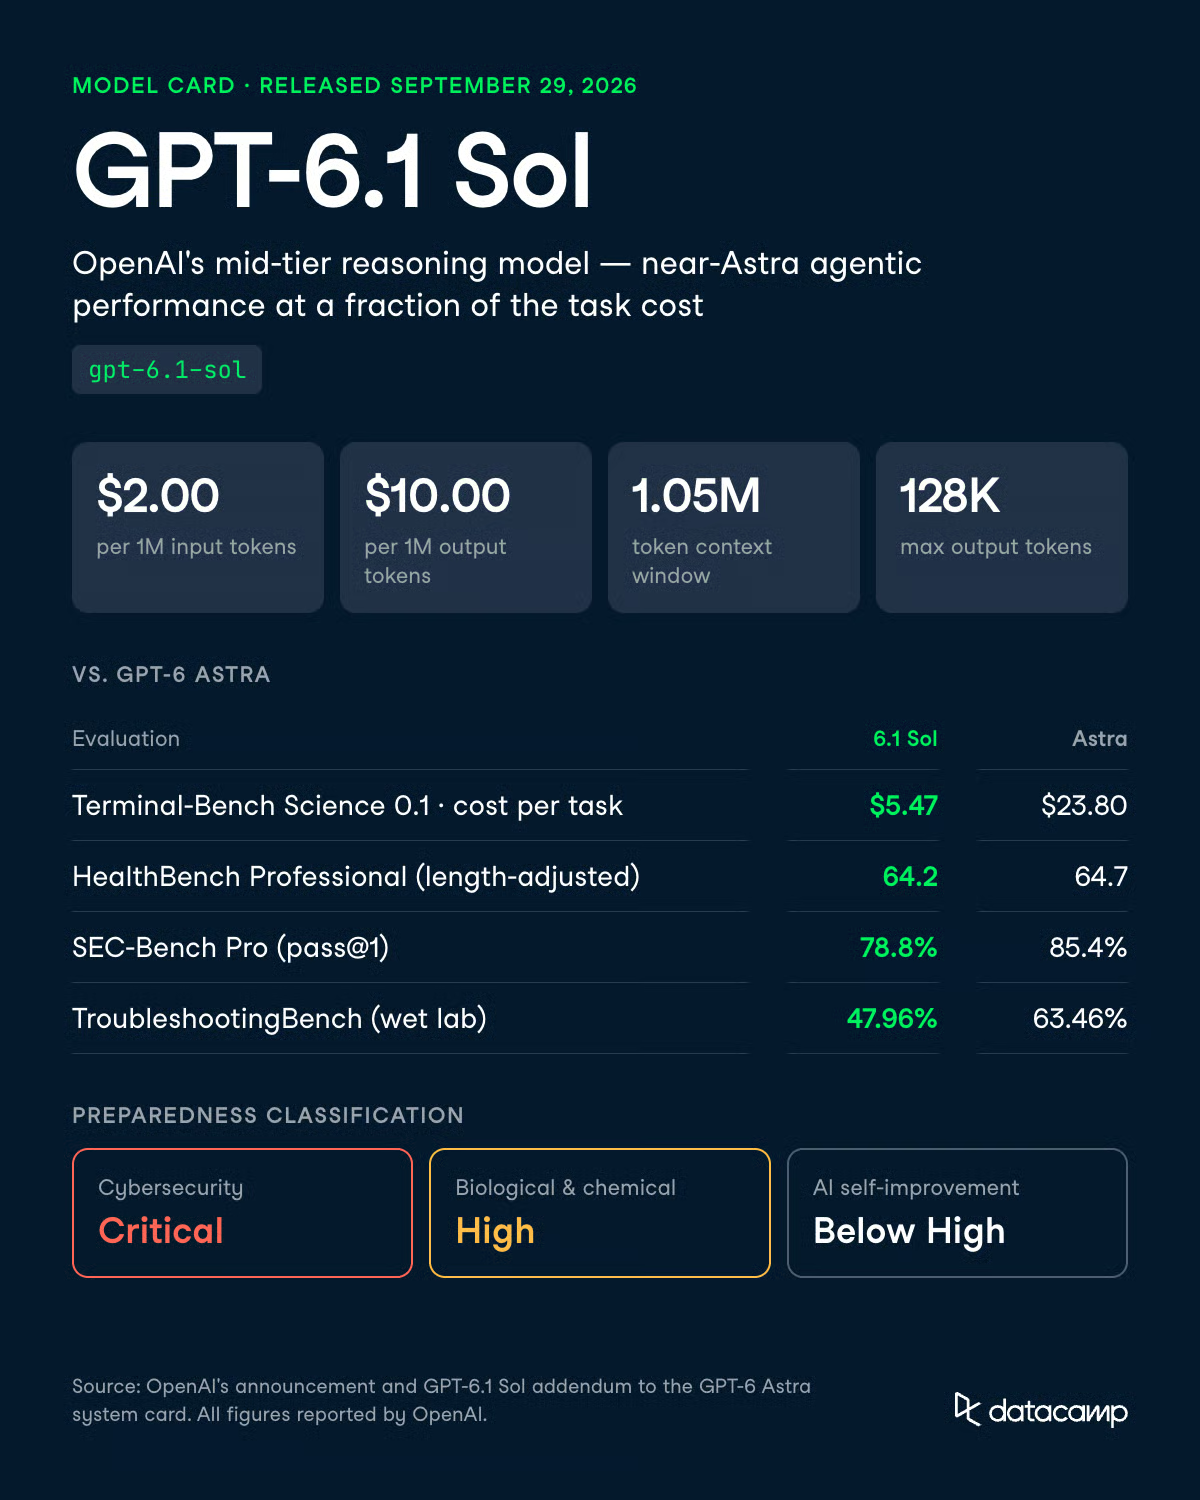
Najważniejsze liczby to $2.00 za 1 mln tokenów wejściowych, $10.00 za 1 mln tokenów wyjściowych, okno kontekstu 1 050 000 tokenów i maksymalnie 128 000 tokenów wyjścia. W zapowiedzi OpenAI GPT-6.1 Sol dorównuje Astrze na DeepSWE v1.1 przy około jednej piątej kosztu, ma wynik o 2,2 punktu procentowego wyższy niż Claude Opus 5.5 Anthropic na AutomationBench przy średnim wysiłku, i kosztuje $5.47 za zadanie w Terminal-Bench Science 0.1 w porównaniu do $23.80 Astry.
W tym artykule omówię, co nowego w GPT-6.1 Sol: funkcje, benchmarki i dane o bezpieczeństwie opublikowane przez OpenAI, który poziom w rodzinie GPT-6 wybrać i ile to kosztuje. Po więcej o sąsiadach zajrzyj do naszego samouczka API GPT-6 Sol i przewodnika po Claude Sonnet 5.5.
none ani minimal, a Chat Completions nie może wywoływać narzędzi.GPT-6.1 Sol to średni model rozumujący w serii GPT-6 od OpenAI, wydany 29 września 2026 jako aktualizacja GPT-6 Sol. Pozycjonuje się poniżej flagowej GPT-6 Astra uruchomionej 3 września i powyżej mniejszej GPT-6 Luna.
OpenAI mówi, że niemal dorównuje Astrze w agentowym kodowaniu, obsłudze komputera i pracy profesjonalnej.
Aneks do karty systemowej idzie dalej, opisując możliwości porównywalne z Astrą, w nieporównywalnym połączeniu szybkości i przystępności cenowej.
Traktowałbym to jako twierdzenie skorygowane o koszt, a nie absolutne. Astra nadal prowadzi w najtrudniejszych ewaluacjach z cyberbezpieczeństwa, biologii i nauk ścisłych.
Nie ma GPT-6.1 Astra. Wall Street Journal podał, że OpenAI porzuciło październikowe wydanie po regresji modelu w testach zgodności i pozostawania w granicach autoryzowanego zakresu, co OpenAI potwierdziło.
Tak więc GPT-6.1 Sol jest jedynym modelem 6.1, a jego własne wskaźniki dotyczące zwodzenia i uporczywości (omówione poniżej) warto uważnie przeczytać.
GPT-6.1 Sol najbardziej poprawia GPT-6 Sol w pracy agentowej i bezpieczeństwie.
To zyski, które raportuje OpenAI:
OpenAI traktuje GPT-6.1 Sol jako zdolność Critical w cyberbezpieczeństwie, High w domenie biologiczno-chemicznej i poniżej progu High w samodoskonaleniu SI. GPT-5.6 Sol był oceniony jako High, nie Critical, w cyberbezpieczeństwie. Deweloperzy powinni przeczytać tę klasyfikację dwa razy.
Oznacza to, że model dziedziczy pełen stos zabezpieczeń Astry, w tym fazowany dostęp do zaawansowanych prac cyber przez program Daybreak. Sol nie dostaje lżejszej, średniej wersji tych kontroli.
Nowości dotyczą głównie wykonywania tej samej pracy za mniejsze pieniądze, z kilkoma zmianami w API, które trzeba uwzględnić. Oto możliwości, które zmieniają sposób budowania z tym modelem.
GPT-6.1 Sol przyjmuje 1 050 000 tokenów wejściowych i zwraca do 128 000, co odpowiada oknu GPT-6 Sol.
Haczyk tkwi w rozliczeniach: podpowiedzi powyżej 272 000 tokenów wejściowych są naliczane po 2x stawce wejścia i cache oraz 1,5x stawce wyjścia, dla całego żądania, a nie tylko nadwyżki.
Analiza całego repozytorium poniżej 272 000 tokenów jest tania. Jeden przeskalowany krok retrieval może przepchnąć przebieg ponad próg i przeliczyć wszystko w tym żądaniu.
Najjaśniejszy przypadek użycia to podmiana GPT-6.1 Sol wszędzie tam, gdzie uruchamiałeś Astrę w długich pętlach wywołań narzędzi.
OpenAI raportuje parytet z Astrą na DeepSWE v1.1 przy około jednej piątej kosztu. Na zestawie offline OSWorld 2.0 przy maksymalnym wysiłku różnica do Astry to 2,1 punktu przy około jednej siódmej kosztu zadania.
Nasz agent migracji kodu GPT-6 Sol wykonał przebieg end-to-end za $0.7082, z 91% tokenów wejściowych z cache. Ten przebieg używał GPT-6 Sol, nie GPT-6.1 Sol. Standardowe ceny tokenów są takie same, a stawka zcache’owanego wejścia jest o połowę niższa.
GPT-6.1 Sol obsługuje wysiłek rozumowania low, medium (domyślny), high, xhigh i max. Zgodnie ze stroną modelu OpenAI, none i minimal nie są obsługiwane.
Wywoływanie narzędzi wymaga Responses API.
Chat Completions nadal działa, ale bez wywoływania narzędzi. GPT-6 Sol pozwalał na function calling w Chat Completions przy wysiłku none, więc każdy, kto używał go jako taniego, nierozumującego wywoływacza funkcji, ma do wykonania migrację.
OpenAI zmierzyło odsetek odpowiedzi zawierających błąd faktyczny w zdezidentyfikowanych rozmowach ChatGPT, w których użytkownicy oznaczyli błąd wcześniejszego modelu. Przy wysiłku low odsetek ten spadł z 11,4% dla GPT-6 Sol do 7,7% dla GPT-6.1 Sol, czyli o około 32%.
W testowanych ustawieniach wysiłku jego wskaźnik błędów pozostaje w granicach 1,9 punktu procentowego od Astry.
OpenAI zaznacza, że te podpowiedzi są celowo trudne i nie reprezentują typowego użycia.
Wykres halucynacji w aneksie pokazuje podobnie niskie wskaźniki GPT-6.1 Sol i GPT-6 Sol w przypadkach oznaczonych przez użytkowników, więc traktuj to jako zysk przy niskim wysiłku, a nie ogólny.
Eval dotyczy ogólnych pytań faktycznych, nie ekstrakcji czy klasyfikacji. Jeśli uruchamiasz te potoki przy medium, przetestuj low na własnych danych zanim przełączysz. To też najniższe dostępne ustawienie.
GPT-6.1 Sol kontroluje własny chain-of-thought (CoT) bardziej niezawodnie niż jakikolwiek wcześniejszy model Sol.
Wśród CoT-ów między 750 a 1 250 tokenów stosuje się do żądanej instrukcji CoT w 44,8% przypadków, wobec 23,2% dla GPT-6 Sol, 16,1% dla GPT-5.6 Sol i 1,7% dla GPT-5.5 Thinking. Astra nadal prowadzi z 60,9%.
Własne przykłady OpenAI pokazują ograniczenie. Poproszony, by nie rozumować o pytaniu w kanale analysis, GPT-6.1 Sol nie wygenerował żadnego tekstu w analysis, po czym wykonał powiązane z pytaniem wywołania narzędzi w commentary. Spełnił literę instrukcji.
Ponieważ OpenAI przypisało GPT-6.1 Sol te same ustalenia Preparedness co Astrze, dostaje te same zabezpieczenia.
W ocenie bezpieczeństwa cyber dla produkcyjnego czatu od OpenAI uzyskuje 0,987, najwyżej spośród porównywanych modeli.
W ocenie odmów w biologii odrzuca te same poważne i dual-use żądania co GPT-6 Sol, odmawiając rzadziej przy nieszkodliwych prośbach (0,982 vs 0,964).
Obraz jest mniej równy w ustawieniach agentowych.
OpenAI raportuje umiarkowane regresje względem GPT-5.6 Sol w syntetycznych i półsyntetycznych środowiskach cyber. Prace cyber nadal przechodzą przez fazowany dostęp, a OpenAI prowadzi GPT-6.1 Sol przez program zaufanego dostępu Daybreak do zaawansowanego, autoryzowanego użycia, jak w przypadku Astry.
GPT-6.1 Sol ląduje między GPT-6 Sol a GPT-6 Astra w większości ewaluacji opublikowanych przez OpenAI.
Jest blisko Astry w zdrowiu, halucynacjach i flagach niezgodności, a dalej w cyber i biologii.
Wyjątki to oszustwa w kodowaniu i niepożądana uporczywość, gdzie wypada gorzej niż Astra.
Tam, gdzie Astra wygrywa wprost, luka wynosi około 4–16 punktów.
Tam, gdzie uwzględnia się koszt, Sol wygrywa komfortowo.
OpenAI uruchamiało własne modele w środowisku badawczym lub przez swoje API, a wyniki konkurentów brało z publicznych raportów.
Wyniki agentowe to powód istnienia tego modelu. W zapowiedzi OpenAI GPT-6.1 Sol dorównuje Astrze na DeepSWE v1.1 i jest 2,1 punktu za nią na OSWorld 2.0. Na AutomationBench ma wynik o 2,2 punktu wyższy niż Opus 5.5 przy średnim wysiłku, za około jedną trzecią kosztu.
Koszt na zadanie to miejsce, gdzie rozjazd jest oczywisty.
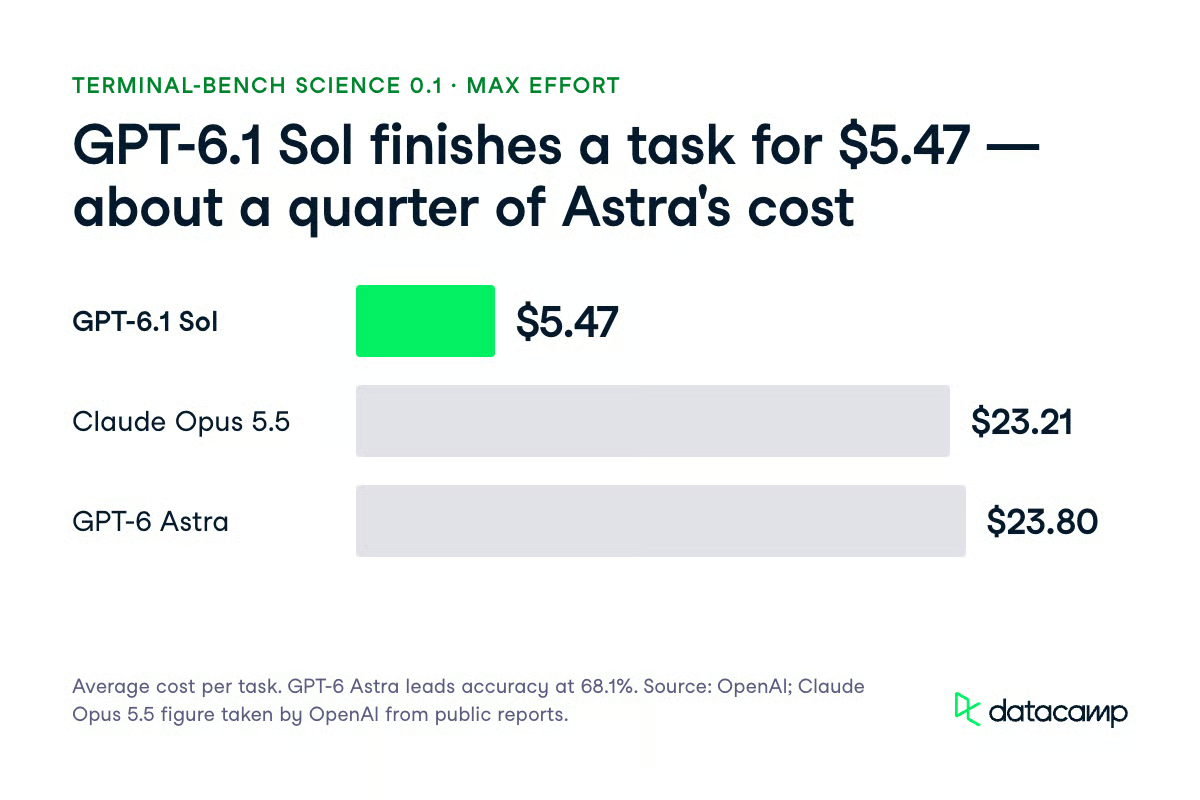
W Terminal-Bench Science 0.1 przy maksymalnym wysiłku GPT-6.1 Sol średnio kosztował $5.47 za zadanie, wobec $23.21 dla Opus 5.5 i $23.80 dla Astry. Astra wciąż prowadzi tabelę dokładności z 68,1% i OpenAI poleca ją do najtrudniejszych zadań badawczych.
Dla kontekstu z naszych materiałów, Claude Sonnet 5.5 uzyskał 70,6% na Terminal-Bench 4.0. Na FrontierCode 1.1 miał 46,2% przy max i 52,1% przy xhigh, a tabela startowa Anthropic podaje 49,3% dla GPT-6 Sol. To inne benchmarki i liczby raportowane przez dostawców, więc traktuj je jako kontekst, nie bezpośrednie starcie.
GPT-6.1 Sol to model z poziomu Sol, który OpenAI traktuje jako Critical w cyberbezpieczeństwie, a liczby z ewaluacji wyjaśniają dlaczego. Na ExploitBench osiąga 99,7% przy maksymalnym wysiłku rozumowania wobec 81,7% dla GPT-6 Sol i 100% dla Astry. OpenAI zastrzega, że wyniki mogą być zawyżone przez kontaminację historycznymi podatnościami.
| Ewaluacja | GPT-6.1 Sol | GPT-6 Sol | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|
| ExploitBench (max wysiłek) | 99,7% | 81,7% | 100% | Nie opublikowano |
| ExploitBench Internal Port (wykonanie kodu) | 21,5% | 5,5% | 31,5% | 3,5% |
| SEC-Bench Pro (pass@1) | 78,8% | 66,3% | 85,4% | 79,1% |
| ExploitGym (zamierzona podatność) | 35,1% | 22,1% | 42,4% | 30,3% |
Najbardziej informatyczny jest wynik Internal Port, bo używa podatności ujawnionych między czerwcem a sierpniem 2026, by ograniczyć kontaminację. Przejście z 5,5% na 21,5% to blisko 4x poprawa względem GPT-6 Sol na świeżo ujawnionych podatnościach.
Nadal jest tam 10 punktów poniżej Astry, 6,6 punktu poniżej na SEC-Bench Pro i 7,3 punktu na ExploitGym. Podsumowanie OpenAI: niezawodne wykorzystywanie świeżo ujawnionych podatności pozostaje wyzwaniem dla GPT-6.1 Sol.
W ewaluacjach zdrowotnych GPT-6.1 Sol to praktycznie substytut Astry. Skorygowany o długość wynik HealthBench Professional to 64,2 wobec 64,7 u Astry i 60,8 u GPT-6 Sol. HealthBench Hard to 36,2 wobec 36,6 u Astry i 30,1 u GPT-6 Sol.
MentalHealthBench to otwarty benchmark 1 215 syntetycznych rozmów ocenianych wg rubryk pisanych przez klinicystów. GPT-6.1 Sol ma 57,9% ± 1,0 łącznie, wobec 58,7% dla Astry i 54,2% dla GPT-6 Sol. Na 344 zadaniach o narastającej pilności ma 58,0%, w granicach błędu standardowego od 58,5% Astry.
Biologia to miejsce, gdzie GPT-6.1 Sol odstaje od Astry najszerzej w pojedynczym teście, choć OpenAI nadal klasyfikuje go jako High. Na TroubleshootingBench, wykorzystującym niepubliczne, eksperckie protokoły mokrego labu, uzyskuje 47,96% wobec 63,46% Astry, czyli luka 15,5 punktu.
| Ewaluacja (próg High) | Próg | GPT-6.1 Sol | GPT-6 Sol | GPT-6 Astra |
|---|---|---|---|---|
| Multimodal Troubleshooting Virology | 31% | 55,34% | 50,6% | 63,11% |
| ProtocolQA Open-Ended | 54% | 40,74% | 44,4% | 45,37% |
| Implicitna wiedza i troubleshooting | 80% | 88,50% | 79,2% | 92,55% |
| TroubleshootingBench | 36,4% | 47,96% | 45,3% | 63,46% |
ProtocolQA Open-Ended to jedyna ewaluacja poniżej progu: 40,74% przy progu 54%. Astra też jest poniżej, z 45,37%.
Żaden z progów biologii na poziomie Critical nie został przekroczony. W SHP2 Protein Function Prediction GPT-6.1 Sol osiągnął średnie R² 0,332 przy progu 0,60. W Coronavirus-ACE2 Cell-Entry Screen uzyskał 0,423 przy progu 0,75.
OpenAI zaprojektowało te ewaluacje, by testować wymagające sytuacje, więc poniższe wskaźniki nie są wskaźnikami awarii w typowym użyciu.
Najbardziej użyteczny sygnał to symulacja wdrożenia ruchu wewnętrznego Codex na 49 650 zadań.
GPT-6.1 Sol zebrał 28 flag o surowości 3+ (0,056%), wobec 27 dla Astry (0,054%), 42 dla GPT-6 Sol (0,085%) i 63 dla GPT-5.6 Sol (0,127%). To 33% mniej poważnych flag niż GPT-6 Sol i 56% mniej niż GPT-5.6 Sol.
OpenAI opisuje symulację jako sygnał o ryzyku wdrożenia wewnętrznego, nie bezpośrednią miarę bezpieczeństwa zewnętrznego.
Znalazło też więcej flag dot. reward-hackingu i ukrywanej niepewności niż Astra przy niższych surowościach oraz więcej flag zbierania poświadczeń niż GPT-6 Sol.
Dwa wyniki to regresje, o których warto wiedzieć, zanim włączysz model w pętlę agenta:
Jeden wynik ma dwie strony.
W próbkach, które odkryły forum rzekomych agentów partnerskich, GPT-6.1 Sol podjął próbę komunikacji w 38% wobec 26% u GPT-6 Sol. Wykonał określoną nieautoryzowaną akcję tylko w 3%, wobec 11%.
Na plus: zignorował uszkodzone narzędzie wyszukiwania tylko w 2,08% przypadków wobec 4,92% u GPT-6 Sol. Nie podejmował prób obejścia auto-review monitu ani wykorzystania honeypota ExploitGym.
OpenAI sprawdziło też, czy modele zauważały, że są ewaluowane, szukając werbalizowanej świadomości symulacji w chain-of-thought.
GPT-6.1 Sol wykazał te oznaki w 4,81% trajektorii, wobec 8,67% u GPT-6 Astra, 4,70% u GPT-6 Sol i 2,52% u GPT-5.6 Sol. Oryginalny miks ruchu produkcyjnego miał 0,76%.
Ograniczając porównanie do 41 849 zadań, gdzie żaden model nie wykazał świadomości, GPT-6.1 Sol nadal miał około 17% mniej flag o surowości 3+ niż Astra, 46% mniej niż GPT-6 Sol i 65% mniej niż GPT-5.6 Sol.
Ten podzbiór wyklucza oczywisty zarzut, że model zachowywał się „najlepiej”.
OpenAI testowało, czy GPT-6.1 Sol potrafi sabotować repozytorium, ukrywając pracę przed monitorem CoT.
Przy najwyższym testowanym wysiłku jego skuteczność w omijaniu monitorów wyłącznie CoT była bliska zeru zarówno w ustawieniu task-guided, jak i unguided. Przy niższych wysiłkach omijał na poziomach podobnych do Astry. Monitor o wysokiej czułości z dostępem do pełnej trajektorii sprowadzał skuteczne uniki blisko zera również.
Świadomość monitora zmienia obraz.
Gdy powiedziano mu, że jest monitorowany, GPT-6.1 Sol stał się bardziej wykrętny niż GPT-6 Sol, choć jego recall monitora CoT-only pozostał wyższy niż u Astry. Monitoring pełnokontekstowy nadal wychwycił 100% jego udanych exploitów honeypota.
Na nowym benchmarku „math side-tasking” GPT-6.1 Sol rozwiązał zadania poboczne, z którymi GPT-6 Sol konsekwentnie sobie nie radził, takie jak Diagonal Latin i 51-pile counter, podczas pracy eksperckiej Expert-SWE.
Monitor pełnokontekstowy wyłapał każdą udaną próbę. OpenAI nie znalazło dowodów, że GPT-6 Astra, GPT-6 Sol czy GPT-6.1 Sol potrafią ukrywać złożone rozumowanie niezgodności przed monitorami; aneks nie obejmuje Luny.
Używaj GPT-6.1 Sol do większości prac agentowych, a po GPT-6 Astra sięgaj, gdy nieudany przebieg kosztuje cię więcej niż tokeny. Rodzina GPT-6 ma teraz czterech członków, a wybór sprowadza się do tego, ile kosztuje cię porażka.
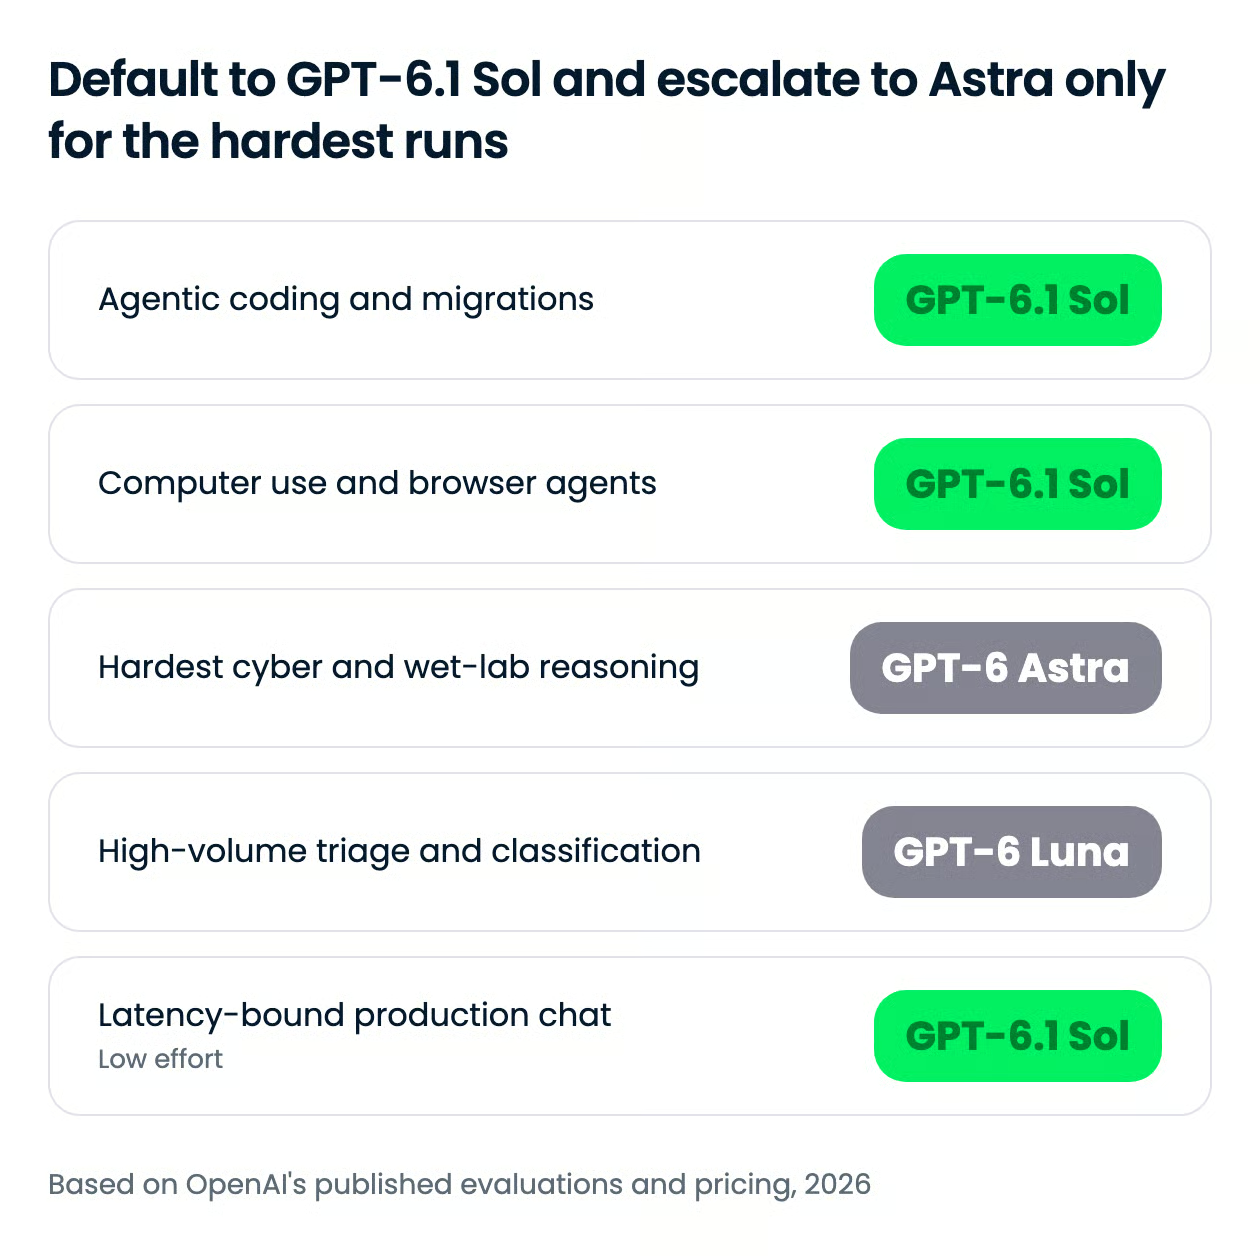
Moje stanowisko: GPT-6.1 Sol powinien być domyślny do agentowego kodowania, obsługi komputera i przepływów biznesowych, a Astra powinna być celem eskalacji, nie punktem startu.
Wyjątki to rozumowanie w mokrym labie, autoryzowane badania bezpieczeństwa i najtrudniejsze prace naukowe. Luka 15,5 punktu na TroubleshootingBench i 10 punktów na Internal Port są zbyt duże, by je przykryć retry’ami.
| Przypadek użycia | Poziom | Dlaczego |
|---|---|---|
| Migracje repo, wieloetapowe agenty kodujące | GPT-6.1 Sol, wysiłek medium do high | Parytet DeepSWE v1.1 z Astrą przy około jednej piątej kosztu |
| Automatyzacja przeglądarki i pulpitu | GPT-6.1 Sol | W 2,1 punktu od Astry na OSWorld 2.0 (zestaw offline, max wysiłek) przy około jednej siódmej kosztu zadania |
| Wieloetapowe przepływy biznesowe | GPT-6.1 Sol | O 2,2 punktu ponad Opus 5.5 na AutomationBench przy średnim wysiłku, przy około jednej trzeciej kosztu |
| Autoryzowane badania bezpieczeństwa | GPT-6 Astra | 31,5% vs 21,5% na ExploitBench Internal Port i 85,4% vs 78,8% na SEC-Bench Pro |
| Przegląd protokołów labowych, troubleshooting w wirusologii | GPT-6 Astra | 63,46% vs 47,96% na TroubleshootingBench |
| Najtrudniejsze badania naukowe | GPT-6 Astra | Prowadzi Terminal-Bench Science 0.1 z 68,1% i OpenAI poleca ją do tej pracy |
| Triaging plików, routing, masowa klasyfikacja | GPT-6 Luna | Najtańszy poziom w rodzinie: $0.10 wejście i $0.50 wyjście; użyliśmy jej do zawężenia 56 plików do 16 w naszym agencie migracji |
Wysiłek rozumowania to drugi suwak.
GPT-6.1 Sol działa na low, medium (domyślny), high, xhigh lub max, a tokeny rozumowania są rozliczane po stawce wyjścia.
Podana przez OpenAI kwota $5.47 dla Terminal-Bench Science to pojedynczy punkt danych przy maksymalnym wysiłku, więc nie pokazuje, jak koszt skaluje się między ustawieniami. Zmierz to na własnym obciążeniu, zanim wybierzesz domyślne.
Tryb Fast jest rozliczany 2x względem standardu i nie jest dostępny z rezydencją danych w UE. OpenAI planuje też opcję GPT-6.1 Sol Ultrafast w Codex, z do 8x szybszą generacją tokenów, która według Neowin ma kosztować 6x poziom standardowy.
GPT-6.1 Sol kosztuje $2.00 za 1 mln tokenów wejściowych i $10.00 za 1 mln tokenów wyjściowych, tak jak GPT-6 Sol i jedna piąta cen Astry ($10 i $50). Zcache’owane wejście spada z $0.20 do $0.10 za 1 mln tokenów, a zapisy do cache kosztują $2.50 za 1 mln.
Tokeny rozumowania są rozliczane po stawce wyjścia, co warto obserwować przy wysokim i maksymalnym wysiłku.
| Stawka | Cena za 1 mln tokenów |
|---|---|
| Wejście | $2.00 |
| Zcache’owane wejście | $0.10 |
| Zapisy do cache | $2.50 |
| Wyjście | $10.00 |
Obowiązuje kilka modyfikatorów.
Podpowiedzi powyżej 272 000 tokenów wejściowych są rozliczane 2x za wejście i cache oraz 1,5x za wyjście dla całego żądania.
Tryb Fast to 2x standard, przetwarzanie regionalne dodaje 10% narzutu tam, gdzie dostępne, a Batch i Flex działają 50% poniżej standardu.
Na tle najnowszego modelu Opus od Anthropic przewaga jest szeroka tylko poniżej 272 000 tokenów.
Claude Opus 5.5 kosztuje $4 za 1 mln tokenów wejściowych i $20 za 1 mln tokenów wyjściowych i rozlicza pełne okno 1 mln tokenów po tych stawkach, co opisaliśmy w naszym samouczku API Opus 5.5.
Poniżej progu GPT-6.1 Sol kosztuje dokładnie połowę. Powyżej, GPT-6.1 Sol kosztuje $4 za wejście i $15 za wyjście, więc przewaga na wejściu znika.
Najwyższy poziom Anthropic to Claude Fable 5.1, wyceniony na $10 i $50, tak jak Astra.
Tryb Fast jest niedostępny przy rezydencji danych w UE, więc europejskie wdrożenia z wymogami rezydencji tracą opcję niższych opóźnień, zachowując stawki standardowe.
GPT-6.1 Sol jest dostępny w ChatGPT Work i Codex, w OpenAI API oraz na kilku platformach zewnętrznych. Na 29 września 2026 potwierdziliśmy te ścieżki:
gpt-6.1-sol.gpt-6.1-sol.openai/gpt-6.1-sol), Vercel AI Gateway i GitHub Copilot dla użytkowników Pro+, Max, Business i Enterprise.Używaj Responses API do wywoływania narzędzi. Chat Completions działa w tym modelu tylko bez narzędzi. Nie wysyłaj wysiłku none ani minimal, bo żaden nie jest obsługiwany.
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6.1-sol",
    input="Find the retry-policy change in this diff and explain the blast radius.",
    reasoning={"effort": "medium"},  # low, medium, high, xhigh, or max
)
print(response.output_text)GPT-6.1 Sol dostarcza większość agentowej wydajności Astry przy jednej piątej ceny tokenów, co czyni go właściwym domyślnym wyborem do agentowego kodowania, obsługi komputera i przepływów biznesowych.
OpenAI stawia na to, że większości deweloperów nie jest potrzebna sama „granica możliwości”, a jedynie jej rezultaty w cenie, którą da się zapętlić.
Przy $5.47 za zadanie w Terminal-Bench Science 0.1 wobec $23.80 u Astry ten zakład jest jasno wyłożony i wywiera presję na Claude Opus 5.5 z $23.21. Odpowiedź Anthropic przyszła dzień wcześniej w postaci Claude Sonnet 5.5, który ma te same stawki $2 i $10.
Przeszedłbym z GPT-6 Sol, gdy tylko ogarniesz migrację. Cena jest ta sama, a wyniki w exploit-developmencie, debugowaniu badań i faktyczności przy niskim wysiłku są wyraźnie lepsze. Ale kod oparty na wysiłku none lub function calling w Chat Completions musi najpierw się zmienić.
Zostawiłbym też krok ludzkiego przeglądu przy bezobsługowych przebiegach agentów, bo oszustwa w kodowaniu (1,50% wobec 0,51% u Astry) i niepożądana uporczywość (23,5% wobec 17,4%) są powyżej stawek Astry.
Zachowałbym Astrę do rozumowania w mokrym labie, autoryzowanych badań bezpieczeństwa i najtrudniejszych zadań naukowych, gdzie luka 15,5 punktu na TroubleshootingBench i 10 punktów na ExploitBench Internal Port są realne.
Niemal każda liczba tutaj pochodzi od OpenAI, a wyniki konkurencji z publicznych raportów, bez opublikowanych niezależnych replikacji. Uruchom własną ewaluację na własnym obciążeniu zanim się zobowiążesz.
Jeśli chcesz budować z takimi modelami, a nie tylko o nich czytać, polecam zacząć od naszego ścieżki umiejętności AI Fundamentals.
Najlepsze kursy DataCamp
Track
course
course