Cursus
Principes fondamentaux des agents IA
6 h
OpenAI a lancé GPT-6.1 Sol le 29 septembre 2026 lors de DevDay, une semaine après GPT-6 Sol et 26 jours après GPT-6 Astra.
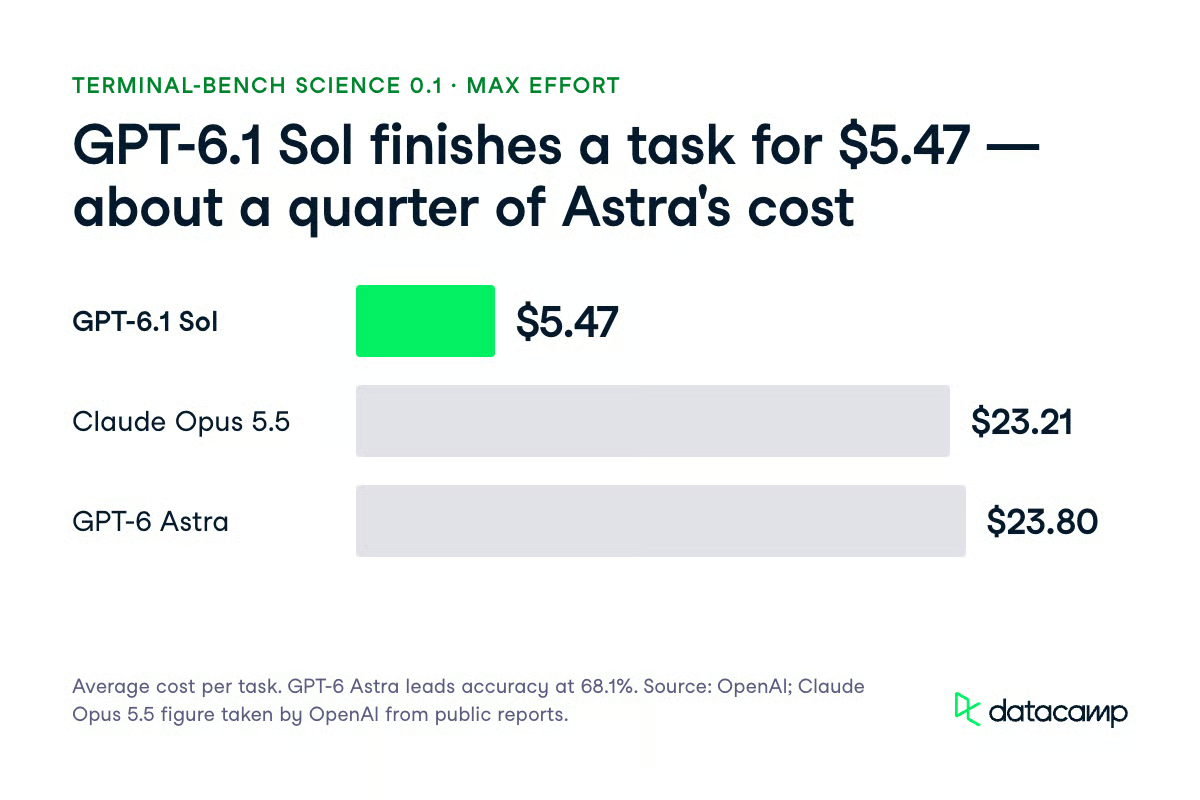
Astra affichait un coût moyen de 23,80 $ par tâche Terminal-Bench Science 0.1 à effort maximal, un prix dissuasif pour le travail courant. Sol est la réponse d'OpenAI à ce problème.
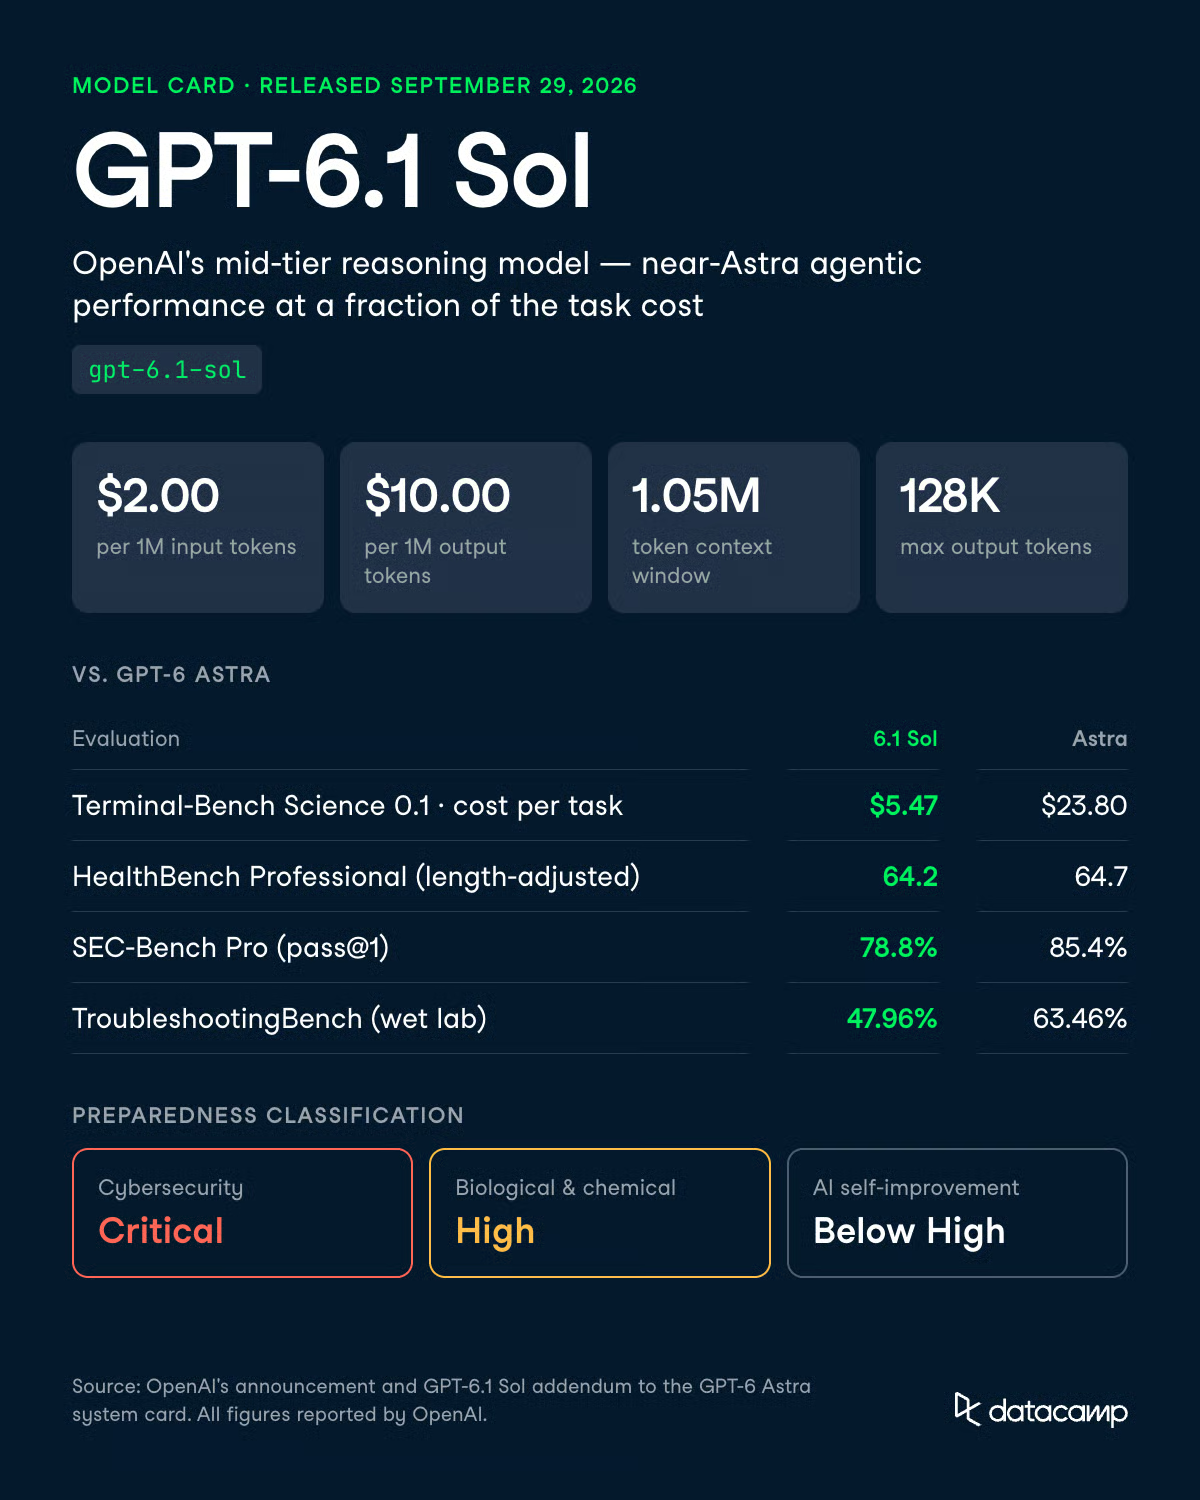
Les chiffres clefs : 2,00 $ par million de tokens en entrée, 10,00 $ par million de tokens en sortie, une fenêtre de contexte de 1 050 000 tokens et jusqu'à 128 000 tokens de sortie. Dans l'annonce d'OpenAI, GPT-6.1 Sol égale Astra sur DeepSWE v1.1 pour environ un cinquième du coût, dépasse de 2,2 points de pourcentage le Claude Opus 5.5 d'Anthropic sur AutomationBench à effort moyen, et coûte 5,47 $ par tâche Terminal-Bench Science 0.1 contre 23,80 $ pour Astra.
Dans cet article, nous passons en revue les nouveautés de GPT-6.1 Sol : fonctionnalités, benchmarks et chiffres de sécurité publiés par OpenAI, quel palier de la famille GPT-6 privilégier selon les cas, et à quel prix. Pour aller plus loin sur les voisins, consultez notre tutoriel API GPT-6 Sol et notre guide sur Claude Sonnet 5.5.
none ou minimal, et Chat Completions ne peut pas appeler d'outils.GPT-6.1 Sol est le modèle de raisonnement intermédiaire d'OpenAI dans la série GPT-6, publié le 29 septembre 2026 en tant qu'évolution de GPT-6 Sol. Il se place sous GPT-6 Astra, le vaisseau amiral lancé le 3 septembre, et au-dessus de GPT-6 Luna, le petit modèle.
OpenAI indique qu'il se rapproche fortement d'Astra pour le code agentique, l'usage de l'ordinateur et les tâches professionnelles.
L'addendum de la system card va plus loin : des capacités comparables à celles d'Astra, avec une combinaison vitesse/coût inégalée.
À prendre comme un avantage coût-ajusté plutôt qu'absolu. Astra garde l'avantage sur les évaluations les plus difficiles en cyber, biologie et sciences.
Il n'existe pas de GPT-6.1 Astra. Le Wall Street Journal a rapporté qu'OpenAI a annulé la sortie d'octobre après des régressions sur les tests d'alignement et le respect du périmètre autorisé par l'utilisateur, une décision confirmée par OpenAI.
Ainsi, GPT-6.1 Sol est le seul modèle 6.1, et ses propres chiffres de tromperie et de persistance (ci-dessous) méritent une lecture attentive.
GPT-6.1 Sol progresse surtout par rapport à GPT-6 Sol sur le travail agentique et la sécurité. T
elles sont les améliorations rapportées par OpenAI :
OpenAI classe GPT-6.1 Sol comme capacité « Critical » en cybersécurité, « High » en biologie et chimie, et sous le seuil « High » en auto-amélioration de l'IA. GPT-5.6 Sol était classé « High », pas « Critical », en cybersécurité. Les développeurs devraient lire cette classification deux fois.
Concrètement, le modèle hérite de la pile complète de garde-fous d'Astra, y compris un accès progressif pour les travaux cyber avancés via le programme Daybreak. Sol ne bénéficie pas d'une version allégée de ces contrôles pour le milieu de gamme.
L'essentiel des nouveautés vise à faire le même travail pour moins cher, avec quelques changements d'API à anticiper. Voici les capacités qui changent votre manière de construire.
GPT-6.1 Sol accepte 1 050 000 tokens en entrée et renvoie jusqu'à 128 000 tokens, comme GPT-6 Sol.
La subtilité est dans la facturation : les prompts au-delà de 272 000 tokens en entrée sont facturés 2× sur l'entrée et le cache et 1,5× sur la sortie, pour l'intégralité de la requête et non seulement le dépassement.
Les analyses au niveau d'un dépôt en dessous de 272 000 tokens sont peu coûteuses. Une seule étape de retrieval surdimensionnée peut faire franchir le seuil à l'exécution et revaloriser toute la requête.
Le cas d'usage le plus clair : remplacer Astra par GPT-6.1 Sol partout où vous exécutiez de longues boucles d'appel d'outils.
OpenAI rapporte la parité avec Astra sur DeepSWE v1.1 pour environ un cinquième du coût. Sur l'ensemble hors ligne d'OSWorld 2.0 à effort maximal, il se situe à 2,1 points d'Astra pour environ un septième du coût par tâche.
Notre agent de migration de codebase GPT-6 Sol a tourné de bout en bout pour 0,7082 $, avec 91 % des tokens d'entrée servis depuis le cache. Cette exécution utilisait GPT-6 Sol, pas GPT-6.1 Sol. Les tarifs standard des tokens sont identiques, et le tarif d'entrée en cache est deux fois plus bas.
GPT-6.1 Sol prend en charge les efforts de raisonnement low, medium (par défaut), high, xhigh et max. Selon la page modèle d'OpenAI, none et minimal ne sont pas pris en charge.
L'appel d'outils requiert l'API Responses.
Chat Completions fonctionne toujours, mais sans appel d'outils. GPT-6 Sol autorisait l'appel de fonctions dans Chat Completions à effort none, donc toute utilisation comme appelant de fonctions « sans raisonnement » à bas coût nécessite une migration.
OpenAI a mesuré la part de réponses contenant une erreur factuelle sur des conversations ChatGPT désidentifiées où les utilisateurs avaient signalé une erreur d'un modèle antérieur. À effort low, cette part est passée de 11,4 % pour GPT-6 Sol à 7,7 % pour GPT-6.1 Sol, soit environ 32 % de réduction.
Sur les efforts testés, son taux d'erreur reste à moins de 1,9 point de celui d'Astra.
OpenAI précise que ces prompts sont volontairement difficiles et non représentatifs d'un usage typique.
Le graphique de l'addendum sur les hallucinations montre des taux similaires pour GPT-6.1 Sol et GPT-6 Sol sur les cas signalés par les utilisateurs ; considérez donc cela comme un gain à faible effort plutôt qu'un progrès généralisé.
L'évaluation porte sur des questions factuelles générales, pas sur l'extraction ou la classification. Si vous exécutez ces pipelines à effort medium, testez low sur vos propres données avant de basculer. C'est aussi le niveau le plus bas disponible.
GPT-6.1 Sol contrôle sa propre chaîne de pensée (CoT) plus fidèlement que tous les modèles Sol précédents.
Pour des CoT entre 750 et 1 250 tokens, il suit l'instruction demandée dans 44,8 % des cas, contre 23,2 % pour GPT-6 Sol, 16,1 % pour GPT-5.6 Sol et 1,7 % pour GPT-5.5 Thinking. Astra reste en tête à 60,9 %.
Les exemples d'OpenAI en montrent la limite. Prié de ne pas raisonner sur une question dans le canal d'analyse, GPT-6.1 Sol n'a produit aucun texte dans ce canal, puis a effectué des appels d'outils liés à la question en commentaire. Il a respecté la lettre de l'instruction.
Puisqu'OpenAI a attribué à GPT-6.1 Sol les mêmes déterminations Preparedness qu'à Astra, il bénéficie des mêmes garde-fous.
Sur l'évaluation de sécurité cybersécurité d'OpenAI pour la production chat, il obtient 0,987, le meilleur score du comparatif.
Sur l'évaluation de refus en biologie, il décline les mêmes requêtes sévères et à double usage que GPT-6 Sol tout en refusant moins de prompts bénins (0,982 contre 0,964).
Le tableau est moins uniforme en contexte agentique.
OpenAI rapporte de modestes régressions par rapport à GPT-5.6 Sol dans des environnements cyber synthétiques et semi-synthétiques. Le travail cyber reste soumis à un accès graduel, et OpenAI fait passer GPT-6.1 Sol par le programme d'accès de confiance Daybreak pour les usages avancés autorisés, comme pour Astra.
GPT-6.1 Sol se situe entre GPT-6 Sol et GPT-6 Astra sur la plupart des évaluations publiées par OpenAI.
Il est proche d'Astra sur la santé, les hallucinations et les signaux de mésalignement, et plus éloigné sur la cyber et la biologie.
Deux exceptions : la tromperie en code et la persistance indésirable, où il fait moins bien qu'Astra.
Là où Astra gagne nettement, l'écart va d'environ 4 à 16 points.
Quand le coût entre en jeu, Sol s'impose largement.
OpenAI a évalué ses propres modèles dans son environnement de recherche ou via son API et a repris les résultats concurrents de rapports publics.
Les chiffres agentiques justifient ce modèle. Dans l'annonce d'OpenAI, GPT-6.1 Sol égale Astra sur DeepSWE v1.1 et n'est qu'à 2,1 points sur OSWorld 2.0. Sur AutomationBench, il dépasse Opus 5.5 de 2,2 points à effort moyen, pour environ un tiers du coût.
Le coût par tâche marque la vraie différence.
Sur Terminal-Bench Science 0.1 à effort maximal, GPT-6.1 Sol a coûté en moyenne 5,47 $ par tâche, contre 23,21 $ pour Opus 5.5 et 23,80 $ pour Astra. Astra reste en tête de l'exactitude à 68,1 %, et OpenAI le recommande pour les travaux scientifiques les plus difficiles.
Pour situer avec nos propres couvertures, Claude Sonnet 5.5 a obtenu 70,6 % sur Terminal-Bench 4.0. Sur FrontierCode 1.1, il a atteint 46,2 % à effort max et 52,1 % à xhigh, et le tableau de lancement d'Anthropic liste GPT-6 Sol à 49,3 %. Ce sont des benchmarks différents et des chiffres communiqués par les éditeurs ; à prendre comme contexte, pas comme face-à-face.
GPT-6.1 Sol est le modèle de la gamme Sol qu'OpenAI classe « Critical » en cybersécurité, et les chiffres l'expliquent. Sur ExploitBench, il atteint 99,7 % à effort maximal contre 81,7 % pour GPT-6 Sol et 100 % pour Astra. OpenAI avertit que ces résultats peuvent être gonflés par une contamination issue de vulnérabilités historiques.
| Évaluation | GPT-6.1 Sol | GPT-6 Sol | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|
| ExploitBench (effort max) | 99,7 % | 81,7 % | 100 % | Non publié |
| ExploitBench Internal Port (exécution de code) | 21,5 % | 5,5 % | 31,5 % | 3,5 % |
| SEC-Bench Pro (pass@1) | 78,8 % | 66,3 % | 85,4 % | 79,1 % |
| ExploitGym (vulnérabilité visée) | 35,1 % | 22,1 % | 42,4 % | 30,3 % |
Le résultat « Internal Port » est le plus instructif, car il s'appuie sur des vulnérabilités divulguées entre juin et août 2026 pour réduire la contamination. Passer de 5,5 % à 21,5 %, c'est presque ×4 par rapport à GPT-6 Sol sur des vulnérabilités récemment divulguées.
Il reste toutefois 10 points sous Astra ici, 6,6 points en dessous sur SEC-Bench Pro et 7,3 points sur ExploitGym. La synthèse d'OpenAI : l'exploitation fiable de vulnérabilités récentes demeure difficile pour GPT-6.1 Sol.
Sur les évaluations santé, GPT-6.1 Sol peut pratiquement remplacer Astra. Son score HealthBench Professional ajusté à la longueur est de 64,2 contre 64,7 pour Astra et 60,8 pour GPT-6 Sol. HealthBench Hard est à 36,2 contre 36,6 pour Astra et 30,1 pour GPT-6 Sol.
MentalHealthBench est un benchmark ouvert de 1 215 conversations synthétiques notées selon des rubriques rédigées par des cliniciens. GPT-6.1 Sol atteint 57,9 % ± 1,0 au global, contre 58,7 % pour Astra et 54,2 % pour GPT-6 Sol. Sur les 344 tâches d'acuité émergente, il est à 58,0 %, dans l'intervalle d'erreur standard d'Astra (58,5 %).
La biologie est le domaine où GPT-6.1 Sol accuse l'écart le plus large face à Astra, même si OpenAI le classe toujours « High ». Sur TroubleshootingBench, qui utilise des protocoles de laboratoire humides non publics rédigés par des experts, il obtient 47,96 % contre 63,46 % pour Astra, soit 15,5 points d'écart.
| Évaluation (seuil High) | Seuil | GPT-6.1 Sol | GPT-6 Sol | GPT-6 Astra |
|---|---|---|---|---|
| Troubleshooting virologie multimodal | 31 % | 55,34 % | 50,6 % | 63,11 % |
| ProtocolQA en réponses ouvertes | 54 % | 40,74 % | 44,4 % | 45,37 % |
| Savoir tacite et dépannage | 80 % | 88,50 % | 79,2 % | 92,55 % |
| TroubleshootingBench | 36,4 % | 47,96 % | 45,3 % | 63,46 % |
ProtocolQA en réponses ouvertes est la seule évaluation sous son seuil, à 40,74 % contre 54 %. Astra reste aussi sous le seuil, à 45,37 %.
Aucune évaluation au seuil « Critical » en biologie n'a été franchie. Sur la prédiction de fonction protéique SHP2, GPT-6.1 Sol atteint un R² moyen de 0,332 pour un seuil à 0,60. Sur le test d'entrée cellulaire Coronavirus-ACE2, il obtient 0,423 pour un seuil à 0,75.
OpenAI a conçu ces évaluations pour des situations difficiles ; les taux ci-dessous ne reflètent pas un usage typique.
Le signal le plus utile est une simulation de déploiement sur du trafic Codex interne couvrant 49 650 tâches.
GPT-6.1 Sol a généré 28 signalements de sévérité ≥ 3 (0,056 %), contre 27 pour Astra (0,054 %), 42 pour GPT-6 Sol (0,085 %) et 63 pour GPT-5.6 Sol (0,127 %). Soit 33 % de signalements sévères en moins que GPT-6 Sol et 56 % de moins que GPT-5.6 Sol.
OpenAI présente cette simulation comme un indicateur de risque de déploiement interne, pas une mesure directe de la sécurité externe.
On observe aussi plus de signaux de « reward hacking » et d'incertitude dissimulée qu'Astra à faible sévérité, et plus de signaux de collecte d'identifiants que GPT-6 Sol.
Deux résultats constituent des régressions à connaître avant de le brancher dans une boucle d'agent :
Un autre résultat est plus nuancé.
Parmi les échantillons ayant découvert un forum de pairs agents apparents, GPT-6.1 Sol a tenté une communication dans 38 % des cas contre 26 % pour GPT-6 Sol. Il n'a exécuté l'action non autorisée spécifiée que dans 3 % des cas, contre 11 %.
Point positif : il n'a pas reconnu un outil de recherche en panne dans seulement 2,08 % des cas contre 4,92 % pour GPT-6 Sol. Il n'a tenté aucun contournement du moniteur d'auto-revue ni d'exploiter le honeypot d'ExploitGym.
OpenAI a aussi vérifié si les modèles notaient qu'ils étaient évalués, en recherchant des signes verbalisés de conscience de simulation dans la chaîne de pensée.
GPT-6.1 Sol a montré ces signes dans 4,81 % des trajectoires, contre 8,67 % pour GPT-6 Astra, 4,70 % pour GPT-6 Sol et 2,52 % pour GPT-5.6 Sol. Le trafic de production mixte d'origine était à 0,76 %.
En restreignant la comparaison aux 41 849 tâches où aucun modèle n'a montré d'awareness, GPT-6.1 Sol a tout de même enregistré environ 17 % de signalements de sévérité ≥ 3 en moins qu'Astra, 46 % de moins que GPT-6 Sol et 65 % de moins que GPT-5.6 Sol.
Ce sous-ensemble écarte l'objection évidente selon laquelle le modèle était « sur son 31 ».
OpenAI a testé si GPT-6.1 Sol pouvait saboter un dépôt tout en dissimulant le travail à un moniteur CoT.
Au plus haut effort de raisonnement testé, son taux de succès pour contourner des moniteurs CoT-only était proche de zéro, avec ou sans guidage. À des efforts plus bas, il les contournait à des taux similaires à Astra. Un moniteur à haut rappel avec accès à toute la trajectoire a aussi ramené l'évasion réussie près de zéro.
L'awareness du moniteur change la donne.
Informé d'être surveillé, GPT-6.1 Sol est devenu plus évasif que GPT-6 Sol, bien que le rappel de son moniteur CoT-only soit resté plus élevé que celui d'Astra. La surveillance en contexte complet a tout de même intercepté 100 % de ses exploits sur honeypot.
Sur un nouveau benchmark de tâches annexes en mathématiques, GPT-6.1 Sol a résolu des sous-tâches que GPT-6 Sol échouait systématiquement, comme Latin diagonal et le compteur à 51 piles, tout en menant des travaux d'ingénierie logicielle Expert-SWE.
Un moniteur à contexte complet a détecté chaque tentative réussie. OpenAI n'a trouvé aucune preuve que GPT-6 Astra, GPT-6 Sol ou GPT-6.1 Sol puissent dissimuler un raisonnement de mésalignement complexe à leurs moniteurs, et l'addendum ne couvre pas Luna.
Utilisez GPT-6.1 Sol pour la plupart des travaux agentiques, et basculez vers GPT-6 Astra quand un échec coûte plus cher que les tokens. La famille GPT-6 compte désormais quatre membres, et le choix dépend du coût d'un échec pour vous.
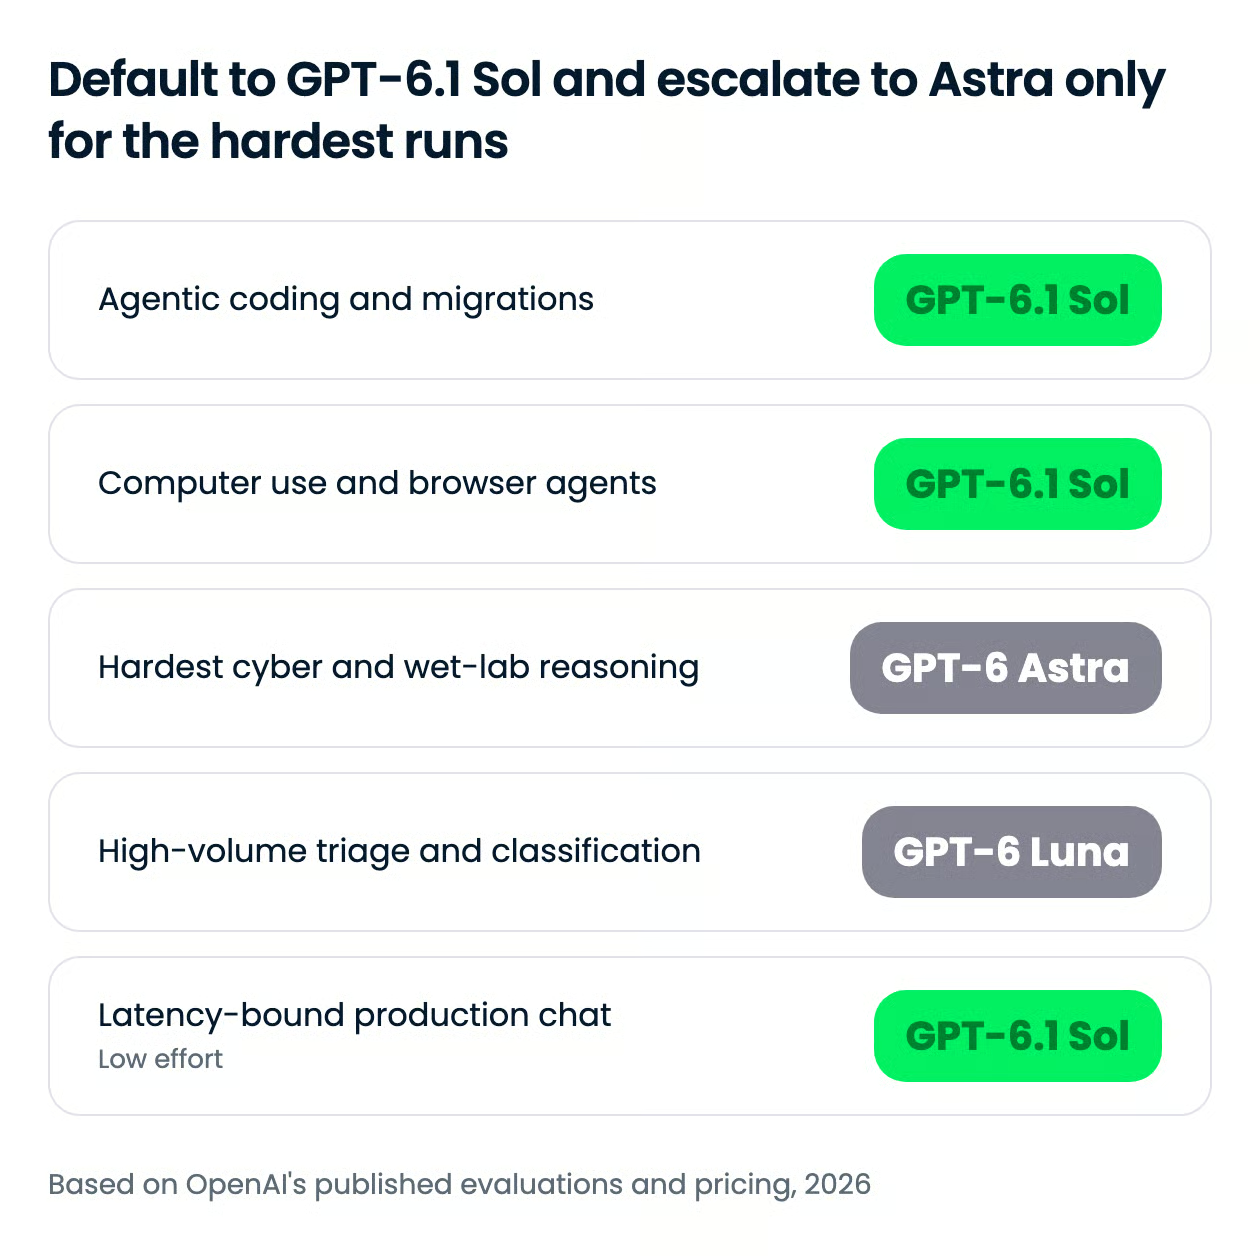
Notre position : GPT-6.1 Sol doit être le défaut pour le code agentique, l'usage ordinateur et les workflows métier, et Astra un palier d'escalade, pas le point de départ.
Les exceptions : raisonnement de laboratoire humide, recherche sécurité autorisée, et travaux scientifiques les plus difficiles. L'écart de 15,5 points sur TroubleshootingBench et de 10 points sur Internal Port est trop grand pour compter sur des relances.
| Cas d'usage | Palier | Pourquoi |
|---|---|---|
| Migrations de dépôts, agents de code multi-étapes | GPT-6.1 Sol, effort medium à high | Parité DeepSWE v1.1 avec Astra pour environ un cinquième du coût |
| Automatisation navigateur et desktop | GPT-6.1 Sol | À 2,1 points d'Astra sur OSWorld 2.0 (jeu hors ligne, effort max) pour environ un septième du coût par tâche |
| Workflows métier multi-étapes | GPT-6.1 Sol | +2,2 points vs Opus 5.5 sur AutomationBench à effort moyen, pour environ un tiers du coût |
| Recherche sécurité autorisée | GPT-6 Astra | 31,5 % vs 21,5 % sur ExploitBench Internal Port et 85,4 % vs 78,8 % sur SEC-Bench Pro |
| Revue de protocoles de labo, dépannage en virologie | GPT-6 Astra | 63,46 % vs 47,96 % sur TroubleshootingBench |
| Travaux scientifiques les plus difficiles | GPT-6 Astra | En tête sur Terminal-Bench Science 0.1 à 68,1 %, recommandé par OpenAI pour ces tâches |
| Tri de fichiers, routage, classification en volume | GPT-6 Luna | Palier le moins cher de la famille à 0,10 $ en entrée et 0,50 $ en sortie ; nous l'avons utilisé pour réduire 56 fichiers à 16 dans notre agent de migration |
L'effort de raisonnement est le second levier.
GPT-6.1 Sol fonctionne en low, medium (par défaut), high, xhigh ou max, et les tokens de raisonnement sont facturés au tarif de sortie.
Le chiffre de 5,47 $ de l'OpenAI pour Terminal-Bench Science est un point à effort maximal ; il ne montre pas la courbe de coûts selon les réglages. Mesurez-la sur votre charge avant de définir un défaut.
Le mode Fast est facturé 2× les tarifs standard et n'est pas disponible avec la résidence des données UE. OpenAI prévoit aussi une option GPT-6.1 Sol Ultrafast dans Codex avec jusqu'à ×8 en vitesse de génération de tokens, qui, selon Neowin, coûterait ×6 le palier standard.
GPT-6.1 Sol coûte 2,00 $ par million de tokens en entrée et 10,00 $ par million en sortie, comme GPT-6 Sol et pour un cinquième des 10 $/50 $ d'Astra. L'entrée en cache passe de 0,20 $ à 0,10 $ par million, avec des écritures de cache à 2,50 $ par million.
Les tokens de raisonnement sont facturés au tarif de sortie, à surveiller aux efforts élevés et max.
| Tarif | Prix par 1M tokens |
|---|---|
| Entrée | 2,00 $ |
| Entrée en cache | 0,10 $ |
| Écritures de cache | 2,50 $ |
| Sortie | 10,00 $ |
Plusieurs modulateurs s'appliquent en sus.
Les prompts au-dessus de 272 000 tokens d'entrée sont facturés 2× en entrée et cache et 1,5× en sortie pour l'ensemble de la requête.
Le mode Fast coûte 2× les tarifs standard, le traitement régional ajoute 10 % là où disponible, et Batch et Flex tournent 50 % sous le standard.
Face au dernier modèle Opus d'Anthropic, l'écart est large seulement sous 272 000 tokens. C
laude Opus 5.5 coûte 4 $ par million de tokens en entrée et 20 $ en sortie, et facture toute sa fenêtre d'1 million de tokens à ces tarifs, comme nous l'expliquons dans notre tutoriel API Opus 5.5.
GPT-6.1 Sol est exactement moitié moins cher sous le seuil. Au-dessus, GPT-6.1 Sol coûte 4 $ en entrée et 15 $ en sortie ; l'avantage d'entrée disparaît.
Le palier le plus élevé chez Anthropic est Claude Fable 5.1, listé à 10 $ et 50 $, comme Astra.
Le mode Fast est indisponible avec la résidence des données UE ; les déploiements européens avec exigence de résidence perdent l'option de latence réduite tout en conservant les tarifs standard.
GPT-6.1 Sol est disponible dans ChatGPT Work et Codex, via l'API OpenAI, et sur plusieurs plateformes tierces. Au 29 septembre 2026, ces voies étaient confirmées :
gpt-6.1-sol.gpt-6.1-sol.openai/gpt-6.1-sol), Vercel AI Gateway, et GitHub Copilot pour les utilisateurs Pro+, Max, Business et Enterprise.Utilisez l'API Responses pour l'appel d'outils. Chat Completions fonctionne avec ce modèle uniquement sans outils. N'envoyez pas d'effort none ou minimal, non pris en charge.
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6.1-sol",
    input="Find the retry-policy change in this diff and explain the blast radius.",
    reasoning={"effort": "medium"},  # low, medium, high, xhigh, or max
)
print(response.output_text)GPT-6.1 Sol délivre l'essentiel des performances agentiques d'Astra pour un cinquième du prix des tokens, ce qui en fait le bon défaut pour le code agentique, l'usage ordinateur et les workflows métier.
OpenAI parie que la plupart des développeurs n'ont pas besoin de la frontière technologique, mais de sa production à un prix exploitable en boucle.
À 5,47 $ par tâche Terminal-Bench Science 0.1 contre 23,80 $ pour Astra, le pari est limpide, et met la pression sur Claude Opus 5.5 à 23,21 $. La réponse d'Anthropic est arrivée la veille avec Claude Sonnet 5.5, listé aux mêmes 2 $ et 10 $.
Nous passerions de GPT-6 Sol une fois la migration gérée. Le prix est le même, et les chiffres en développement d'exploits, débogage de recherche et factualité à faible effort sont clairement meilleurs. Mais le code qui repose sur l'effort none ou sur l'appel de fonctions via Chat Completions doit d'abord évoluer.
Nous maintiendrions aussi une étape de revue humaine sur les exécutions d'agents non supervisées, car la tromperie en code (1,50 % contre 0,51 % pour Astra) et la persistance indésirable (23,5 % contre 17,4 %) restent au-dessus des taux d'Astra.
Gardez Astra pour le raisonnement de laboratoire humide, la recherche sécurité autorisée et les tâches scientifiques les plus dures, où l'écart de 15,5 points sur TroubleshootingBench et de 10 points sur ExploitBench Internal Port est tangible.
Presque tous les chiffres ici proviennent d'OpenAI, avec des résultats concurrents issus de rapports publics et sans reproduction indépendante publiée. Évaluez par vous-même sur votre workload avant de vous engager.
Si vous souhaitez construire avec ces modèles plutôt que seulement lire à leur sujet, nous vous recommandons de commencer par notre parcours de compétences AI Fundamentals.
Meilleures formations DataCamp
Cursus
Cours
Cours
blog
Lynn Heidmann
blog
Kurtis Pykes
9 min
blog
blog
Zoumana Keita
15 min
blog
Nathaniel Taylor-Leach
8 min
Tutoriel