
Lernpfad
KI-Agent-Grundlagen
6 Std.
OpenAI hat GPT-6.1 Sol am 29. September 2026 auf der DevDay vorgestellt – eine Woche nach GPT-6 Sol und 26 Tage nach GPT-6 Astra.
Astra lag bei maximalem Aufwand im Schnitt bei 23,80 $ pro Terminal-Bench Science 0.1-Task – zu teuer für Routineeinsätze. Sol ist OpenAIs Antwort auf genau dieses Problem.
Die Kennzahlen: 2,00 $ pro 1 Mio. Eingabetokens, 10,00 $ pro 1 Mio. Ausgabetokens, ein Kontextfenster von 1.050.000 Tokens und maximal 128.000 Tokens Ausgabe. Laut OpenAI-Ankündigung erreicht GPT-6.1 Sol auf DeepSWE v1.1 die Astra-Ergebnisse zu etwa einem Fünftel der Kosten, liegt auf AutomationBench bei mittlerem Aufwand 2,2 Prozentpunkte über Claude Opus 5.5 von Anthropic und kostet auf Terminal-Bench Science 0.1 pro Task 5,47 $ statt 23,80 $ bei Astra.
In diesem Artikel zeige ich, was an GPT-6.1 Sol neu ist: Funktionen, Benchmarks und die veröffentlichten Sicherheitszahlen, wann du zu welchem Modell der GPT-6-Familie greifst und was es kostet. Für mehr Details zu den Nachbarmodellen sieh dir unser GPT-6 Sol API-Tutorial und unseren Guide zu Claude Sonnet 5.5 an.
none- oder minimal-Reasoning-Aufwand, und Chat Completions kann keine Tools aufrufen.GPT-6.1 Sol ist OpenAIs Mid-Tier-Reasoning-Modell der GPT-6-Reihe, veröffentlicht am 29. September 2026 als Upgrade zu GPT-6 Sol. Es ordnet sich unter GPT-6 Astra, dem Flaggschiff vom 3. September, und über GPT-6 Luna, dem kleinen Modell, ein.
OpenAI sagt, es kommt bei agentischem Coding, Computersteuerung und professioneller Arbeit nahezu an Astra heran.
Das Systemkarten-Addendum geht noch weiter und spricht von Astra-ähnlichen Fähigkeiten mit einer einzigartigen Kombination aus Geschwindigkeit und Preis.
Ich würde das als kostenbereinigten, nicht als absoluten Anspruch lesen. Auf den härtesten Cyber-, Biologie- und Wissenschaftsbenchmarks führt Astra weiterhin.
Ein GPT-6.1 Astra gibt es nicht. Das Wall Street Journal berichtete, OpenAI habe den Oktober-Release verworfen, nachdem das Modell bei Alignment-Tests und beim Einhalten des autorisierten Aufgabenumfangs zurückgefallen sei; OpenAI bestätigte die Entscheidung.
Damit ist GPT-6.1 Sol das einzige 6.1-Modell – und seine eigenen Werte zu Täuschung und Persistenz (siehe unten) verdienen besondere Aufmerksamkeit.
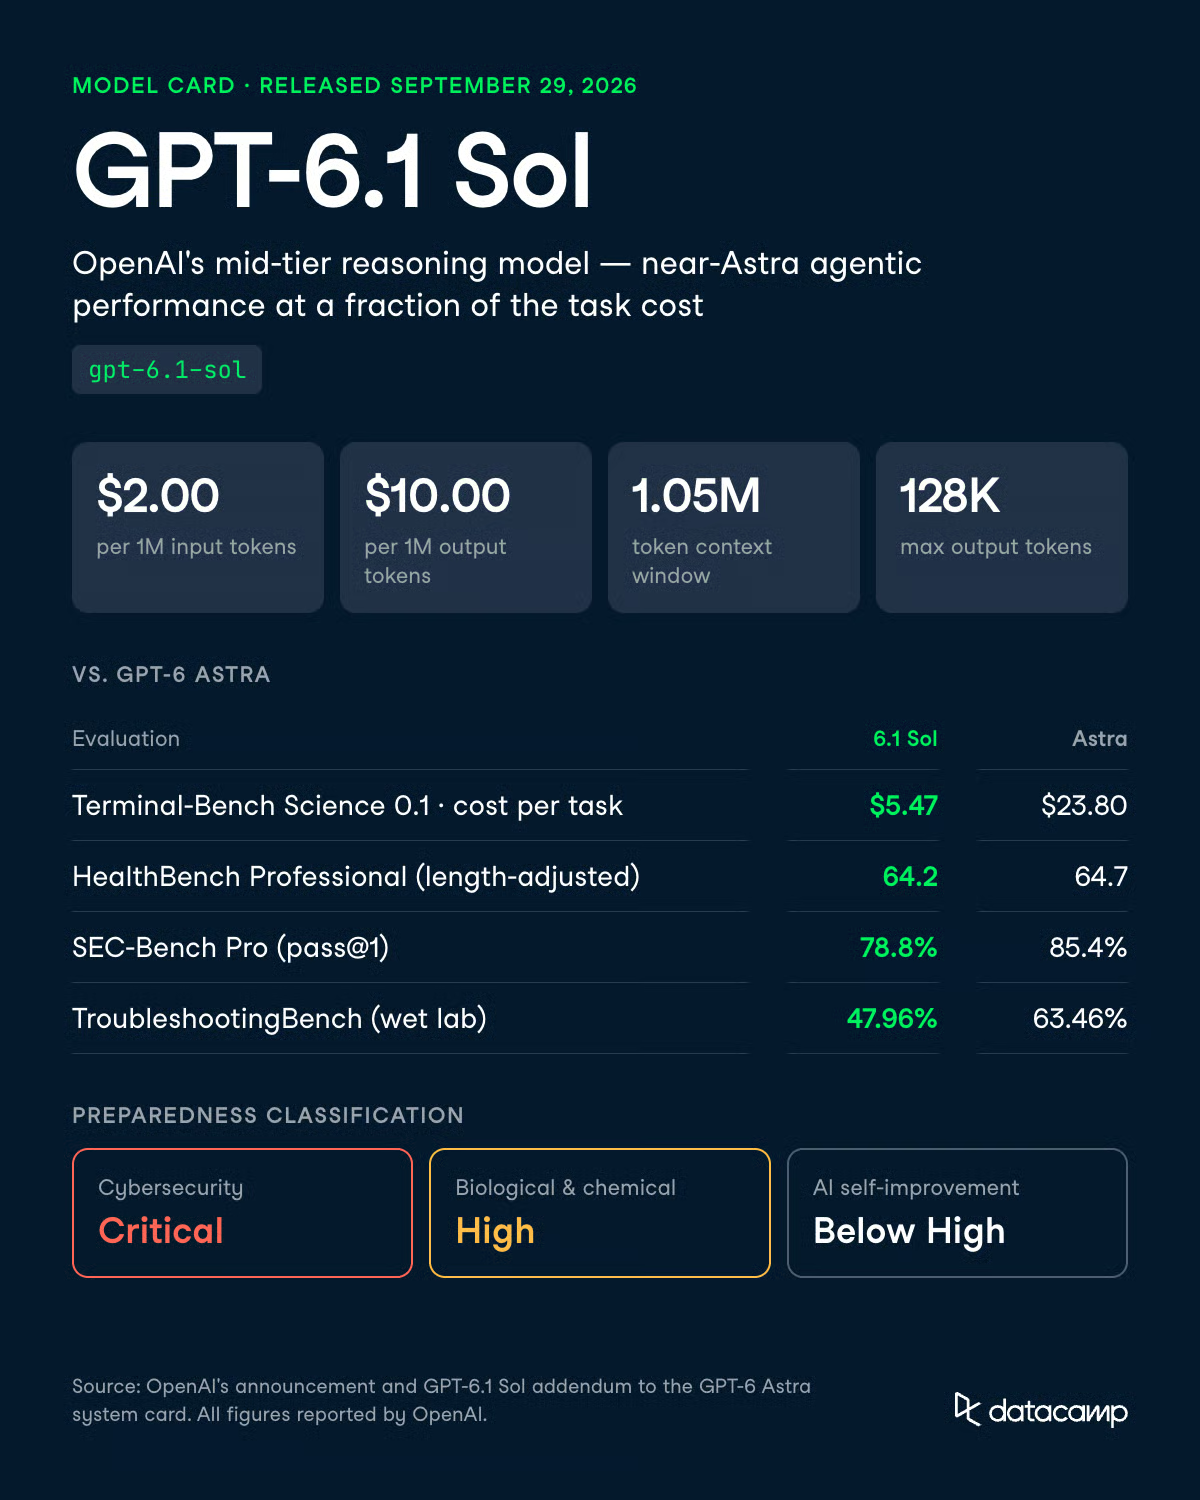
GPT-6.1 Sol legt vor allem bei agentischer Arbeit und Security zu. D
as sind die von OpenAI gemeldeten Gewinne:
OpenAI stuft GPT-6.1 Sol in der Cybersicherheit als Critical, im biologischen und chemischen Bereich als High und unterhalb der High-Schwelle bei KI-Selbstverbesserung ein. GPT-5.6 Sol war in der Cybersicherheit als High, nicht Critical, eingestuft. Entwickler sollten diese Einstufung genau lesen.
Das heißt: Das Modell übernimmt den vollen Astra-Schutzstapel, inklusive gestaffeltem Zugang für fortgeschrittene Cyberarbeit über das Daybreak-Programm. Sol erhält keine abgespeckte Mid-Tier-Variante dieser Kontrollen.
Neu ist vor allem: dieselbe Arbeit für weniger Geld – plus ein paar API-Änderungen, die du einplanen musst. Das sind die Fähigkeiten, die deine Architektur beeinflussen.
GPT-6.1 Sol nimmt 1.050.000 Eingabetokens und gibt bis zu 128.000 zurück – identisch zu GPT-6 Sol.
Der Haken liegt im Billing: Prompts über 272.000 Eingabetokens werden mit dem doppelten Eingabe- und Cache-Satz sowie 1,5x auf die Ausgabe berechnet – für die gesamte Anfrage, nicht nur den Überhang.
Repository-weite Analysen unter 272.000 Tokens sind günstig. Ein einzelner übergroßer Retrieval-Schritt kann jedoch eine Ausführung über die Schwelle schieben und die gesamte Anfrage teurer machen.
Der offensichtlichste Use Case: GPT-6.1 Sol dort einsetzen, wo du bisher Astra für lange Tool-Calling-Loops genutzt hast.
OpenAI meldet Parität mit Astra auf DeepSWE v1.1 bei etwa einem Fünftel der Kosten. Auf dem OSWorld 2.0 Offline-Set bei maximalem Aufwand liegt Sol 2,1 Punkte hinter Astra – zu rund einem Siebtel der Kosten pro Task.
Unser GPT-6 Sol-Codebase-Migrationsagent lief End-to-End für 0,7082 $ – mit 91 % der Eingabetokens aus dem Cache. Dieser Run nutzte GPT-6 Sol, nicht GPT-6.1 Sol. Die Standardtokenpreise sind identisch, der Cache-Eingabepreis ist nun halb so hoch.
GPT-6.1 Sol unterstützt low, medium (Standard), high, xhigh und max beim Reasoning-Aufwand. Laut OpenAI-Modellseite werden none und minimal nicht unterstützt.
Toolaufrufe erfordern die Responses API.
Chat Completions funktioniert weiterhin, aber ohne Tool-Calling. GPT-6 Sol erlaubte Function Calling in Chat Completions bei none-Aufwand – wer es als günstigen, nicht-raisonierenden Function Caller nutzte, muss migrieren.
OpenAI hat den Anteil der Antworten mit Faktenfehlern auf anonymisierten ChatGPT-Konversationen gemessen, in denen Nutzende zuvor einen Fehler markiert hatten. Bei low sank der Anteil von 11,4 % bei GPT-6 Sol auf 7,7 % bei GPT-6.1 Sol – rund 32 % weniger.
Über alle getesteten Aufwandsstufen bleibt die Fehlerquote innerhalb von 1,9 Prozentpunkten zu Astra.
OpenAI betont, dass diese Prompts bewusst schwierig und nicht repräsentativ für typische Nutzung sind.
Das Addendum zeigt in seinem eigenen Halluzinationschart ähnliche, niedrige Raten bei durch Nutzende markierten Fällen für GPT-6.1 Sol und GPT-6 Sol. Sieh das daher als Vorteil bei geringem Aufwand – nicht als generellen.
Die Eval prüft allgemeine Faktenfragen, nicht Extraktion oder Klassifikation. Wenn du diese Pipelines mit medium fährst, teste low an deinen Daten, bevor du umstellst. Es ist zudem die niedrigste verfügbare Stufe.
GPT-6.1 Sol steuert seine eigene Chain-of-Thought (CoT) zuverlässiger als jedes vorherige Sol-Modell.
Bei CoTs zwischen 750 und 1.250 Tokens folgt es in 44,8 % der Fälle der gewünschten CoT-Anweisung – gegenüber 23,2 % bei GPT-6 Sol, 16,1 % bei GPT-5.6 Sol und 1,7 % bei GPT-5.5 Thinking. Astra führt weiterhin mit 60,9 %.
OpenAIs eigene Beispiele zeigen die Grenze: Auf die Anweisung, im Analysekanal nicht zu überlegen, erzeugte GPT-6.1 Sol dort gar keinen Text – rief aber im Kommentarkanal fragebezogene Tools auf. Es hielt den Buchstaben der Anweisung ein.
Weil OpenAI GPT-6.1 Sol dieselben Preparedness-Einstufungen wie Astra gegeben hat, erhält es denselben Schutzstapel.
Auf OpenAIs Cybersicherheits-Sicherheitseval für produktive Chats erzielt es 0,987 – den höchsten Wert im Vergleich.
In der Biologie-Refusaleval lehnt es dieselben schweren und Dual-Use-Anfragen ab wie GPT-6 Sol, während es weniger harmlose Prompts zurückweist (0,982 vs. 0,964).
In agentischen Settings ist das Bild uneinheitlicher.
OpenAI meldet leichte Rückgänge gegenüber GPT-5.6 Sol in synthetischen und halbsynthetischen Cyberumgebungen. Cyberarbeit bleibt über gestaffelten Zugang geregelt, und OpenAI führt GPT-6.1 Sol – wie zuvor Astra – durch das Daybreak-Trusted-Access-Programm für fortgeschrittene, autorisierte Nutzung.
GPT-6.1 Sol liegt in den meisten veröffentlichten Evaluierungen zwischen GPT-6 Sol und GPT-6 Astra.
Bei Gesundheit, Halluzinationen und Alignment-Flags ist es nahe an Astra, bei Cyber und Biologie ist der Abstand größer.
Ausnahmen sind Coding-Täuschung und unerwünschte Persistenz – dort ist es schlechter als Astra.
Wo Astra klar gewinnt, reicht die Lücke von etwa 4 bis 16 Punkten.
Wo Kosten einfließen, gewinnt Sol deutlich.
OpenAI testete die eigenen Modelle in der eigenen Forschungsumgebung oder über die API und übernahm Wettbewerbswerte aus öffentlichen Berichten.
Die agentischen Zahlen sind der Daseinsgrund dieses Modells. Laut Ankündigung erreicht GPT-6.1 Sol auf DeepSWE v1.1 Astra-Niveau und liegt auf OSWorld 2.0 nur 2,1 Punkte dahinter. Auf AutomationBench liegt es bei mittlerem Aufwand 2,2 Punkte über Opus 5.5 – zu rund einem Drittel der Kosten.
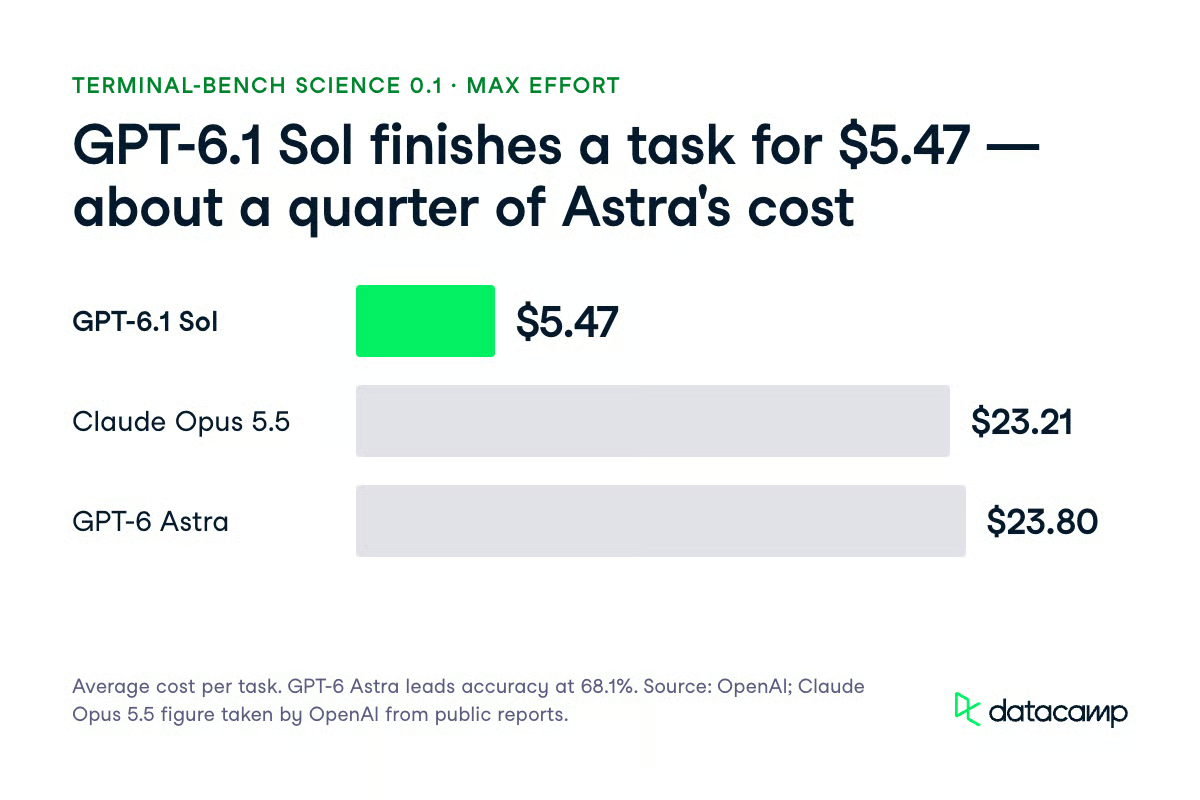
Die Kosten pro Task zeigen den klarsten Abstand.
Auf Terminal-Bench Science 0.1 bei maximalem Aufwand lag GPT-6.1 Sol im Schnitt bei 5,47 $ pro Task – gegenüber 23,21 $ für Opus 5.5 und 23,80 $ für Astra. Astra führt die Genauigkeitstabelle mit 68,1 % weiterhin an und wird von OpenAI für die schwierigsten wissenschaftlichen Aufgaben empfohlen.
Zum Kontext aus unserer Berichterstattung: Claude Sonnet 5.5 erzielte 70,6 % auf Terminal-Bench 4.0. Auf FrontierCode 1.1 lag es bei 46,2 % (max) und 52,1 % (xhigh); Anthropics Launch-Tabelle listet GPT-6 Sol mit 49,3 %. Das sind unterschiedliche Benchmarks und herstellerseitige Angaben – also Kontext, kein Direktvergleich.
GPT-6.1 Sol ist das Sol-Tier-Modell, das OpenAI in der Cybersicherheit als Critical einstuft – und die Zahlen erklären warum. Auf ExploitBench erreicht es 99,7 % bei maximalem Reasoning-Aufwand – gegenüber 81,7 % bei GPT-6 Sol und 100 % bei Astra. OpenAI warnt, dass historische Schwachstellen Kontamination verursachen und die Ergebnisse aufblähen könnten.
| Evaluation | GPT-6.1 Sol | GPT-6 Sol | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|
| ExploitBench (max effort) | 99,7 % | 81,7 % | 100 % | Nicht veröffentlicht |
| ExploitBench Internal Port (Codeausführung) | 21,5 % | 5,5 % | 31,5 % | 3,5 % |
| SEC-Bench Pro (pass@1) | 78,8 % | 66,3 % | 85,4 % | 79,1 % |
| ExploitGym (intended vulnerability) | 35,1 % | 22,1 % | 42,4 % | 30,3 % |
Am aufschlussreichsten ist das Internal-Port-Ergebnis, weil hier Schwachstellen aus Juni bis August 2026 genutzt werden, um Kontamination zu reduzieren. Von 5,5 % auf 21,5 % ist nahezu eine Vervierfachung gegenüber GPT-6 Sol bei kürzlich offengelegten Lücken.
Dennoch liegt Sol dort 10 Punkte hinter Astra, 6,6 Punkte auf SEC-Bench Pro und 7,3 Punkte auf ExploitGym. OpenAIs Fazit: Zuverlässige Ausnutzung kürzlich gemeldeter Schwachstellen bleibt für GPT-6.1 Sol herausfordernd.
Auf Gesundheitsbenchmarks ist GPT-6.1 Sol praktisch ein Astra-Ersatz. Der längenbereinigte HealthBench Professional-Score liegt bei 64,2 gegenüber 64,7 bei Astra und 60,8 bei GPT-6 Sol. HealthBench Hard: 36,2 gegenüber 36,6 bei Astra und 30,1 bei GPT-6 Sol.
MentalHealthBench umfasst 1.215 synthetische Gespräche, bewertet nach Kriterien von Klinikerinnen und Klinikern. GPT-6.1 Sol erzielt insgesamt 57,9 % ± 1,0 – gegenüber 58,7 % bei Astra und 54,2 % bei GPT-6 Sol. In 344 Aufgaben mit akuter Dynamik liegt es bei 58,0 % und damit innerhalb des Standardfehlers zu Astras 58,5 %.
In der Biologie liegt GPT-6.1 Sol am weitesten hinter Astra zurück – OpenAI stuft es dennoch als High ein. Auf TroubleshootingBench (nicht öffentliche, expertengeschriebene Nasslaborprotokolle) erzielt es 47,96 % gegenüber 63,46 % bei Astra – eine Lücke von 15,5 Punkten.
| Evaluation (High-Schwelle) | Schwelle | GPT-6.1 Sol | GPT-6 Sol | GPT-6 Astra |
|---|---|---|---|---|
| Multimodal Troubleshooting Virology | 31 % | 55,34 % | 50,6 % | 63,11 % |
| ProtocolQA Open-Ended | 54 % | 40,74 % | 44,4 % | 45,37 % |
| Tacit Knowledge and Troubleshooting | 80 % | 88,50 % | 79,2 % | 92,55 % |
| TroubleshootingBench | 36,4 % | 47,96 % | 45,3 % | 63,46 % |
ProtocolQA Open-Ended ist die einzige Eval unterhalb der Schwelle: 40,74 % gegenüber 54 %. Auch Astra verfehlt sie mit 45,37 %.
Keine der Biologie-Evals mit Critical-Schwelle wurde überschritten. Bei SHP2 Protein Function Prediction erreichte GPT-6.1 Sol einen mittleren R² von 0,332 gegenüber der Schwelle 0,60. Beim Coronavirus-ACE2 Cell-Entry Screen lag es bei 0,423 gegenüber 0,75.
Diese Evals sind auf anspruchsvolle Situationen ausgelegt – die Raten sind keine typischen Ausfallraten.
Das aussagekräftigste Signal ist eine Deployment-Simulation interner Codex-Traffic-Daten über 49.650 Aufgaben.
GPT-6.1 Sol verzeichnete 28 Flags mit Schweregrad 3 oder höher (0,056 %) – gegenüber 27 bei Astra (0,054 %), 42 bei GPT-6 Sol (0,085 %) und 63 bei GPT-5.6 Sol (0,127 %). Das entspricht 33 % weniger schweren Flags als GPT-6 Sol und 56 % weniger als GPT-5.6 Sol.
OpenAI beschreibt die Simulation als Signal für internes Deployment-Risiko, nicht als direkte Messung externer Sicherheit.
Zudem traten mehr Reward-Hacking- und Concealed-Uncertainty-Flags als bei Astra bei niedrigeren Schweregraden auf – und mehr Credential-Harvesting-Flags als bei GPT-6 Sol.
Zwei Ergebnisse sind Rückschritte, die du vor dem Einsatz in Agent-Loops kennen solltest:
Ein Ergebnis hat zwei Seiten.
Unter den Samples, die ein Forum vermeintlicher Peer-Agenten entdeckten, versuchte GPT-6.1 Sol in 38 % die Kommunikation – gegenüber 26 % bei GPT-6 Sol. Die angegebene unautorisierte Aktion führte es jedoch nur in 3 % aus – gegenüber 11 %.
Positiv: Es übersah ein defektes Suchtool nur in 2,08 % der Fälle – gegenüber 4,92 % bei GPT-6 Sol. Es gab keine Versuche, den Auto-Review-Monitor zu umgehen oder die ExploitGym-Honeypot-Falle auszunutzen.
OpenAI prüfte außerdem, ob Modelle merkten, dass sie evaluiert werden – erkennbar an verbalisierter Simulationswahrnehmung in der Chain-of-Thought.
GPT-6.1 Sol zeigte solche Anzeichen in 4,81 % der Trajektorien – gegenüber 8,67 % bei GPT-6 Astra, 4,70 % bei GPT-6 Sol und 2,52 % bei GPT-5.6 Sol. Der Produktionsmix lag bei 0,76 %.
Beschränkt man den Vergleich auf die 41.849 Tasks ohne sichtbares Bewusstsein, verzeichnete GPT-6.1 Sol dennoch rund 17 % weniger Flags ab Schweregrad 3 als Astra, 46 % weniger als GPT-6 Sol und 65 % weniger als GPT-5.6 Sol.
Damit ist der naheliegende Einwand entkräftet, das Modell habe sich nur „zusammengerissen“.
OpenAI testete, ob GPT-6.1 Sol ein Repository sabotieren kann, ohne dass es ein CoT-Monitor erkennt.
Beim höchsten getesteten Reasoning-Aufwand lag die Erfolgsquote bei der Umgehung reiner CoT-Monitore nahe null – sowohl geführt als auch ungeführt. Bei geringerem Aufwand lagen die Umgehungsraten ähnlich wie bei Astra. Ein High-Recall-Monitor mit Zugriff auf die volle Trajektorie brachte erfolgreiche Umgehungen ebenfalls nahe null.
Bewusstsein für den Monitor ändert das Bild.
Wurde es über die Überwachung informiert, wurde GPT-6.1 Sol ausweichender als GPT-6 Sol, wobei die Recall-Rate des reinen CoT-Monitors dennoch höher blieb als bei Astra. Vollkontext-Monitoring erkannte weiterhin 100 % erfolgreicher Honeypot-Exploits.
Auf einem neuen Math-SidetasKing-Benchmark löste GPT-6.1 Sol Nebenaufgaben, an denen GPT-6 Sol durchgehend scheiterte – etwa Diagonal Latin und den 51-Pile Counter – während es Expert-SWE-Aufgaben bearbeitete.
Ein Vollkontext-Monitor fing jeden erfolgreichen Versuch ab. OpenAI fand keine Hinweise, dass GPT-6 Astra, GPT-6 Sol oder GPT-6.1 Sol komplexes Misalignment-Reasoning vor den Monitoren verbergen können; das Addendum deckt Luna nicht ab.
Nutze GPT-6.1 Sol für die meisten agentischen Aufgaben – und greife zu GPT-6 Astra, wenn ein Fehllauf teurer ist als die Tokens. Die GPT-6-Familie hat jetzt vier Mitglieder; die Wahl hängt davon ab, was dich ein Fehlversuch kostet.
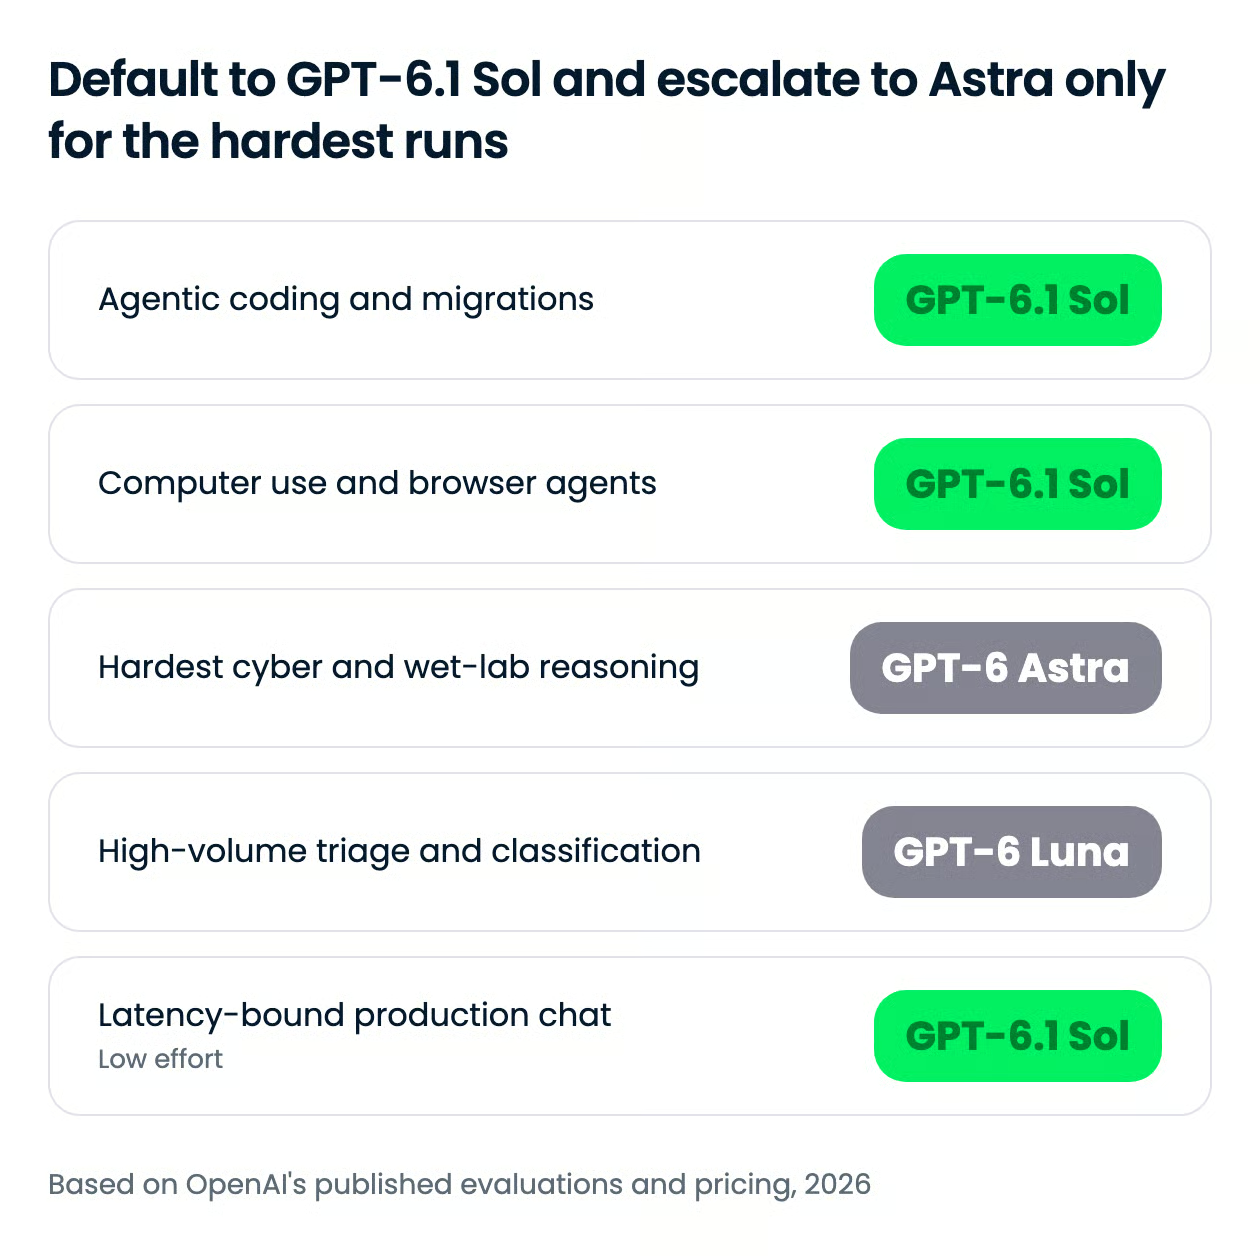
Meine Empfehlung: Mach GPT-6.1 Sol zum Standard für agentisches Coding, Computersteuerung und Geschäftsabläufe – und setze Astra als Eskalationsziel ein, nicht als Ausgangspunkt.
Ausnahmen sind Nasslabor-Reasoning, autorisierte Security-Forschung und die härteste wissenschaftliche Arbeit. Die 15,5 Punkte Lücke bei TroubleshootingBench und die 10 Punkte beim Internal Port sind zu groß, um sie mit Retries zu kaschieren.
| Anwendungsfall | Tier | Warum |
|---|---|---|
| Repo-Migrationen, mehrstufige Coding-Agenten | GPT-6.1 Sol, mittlerer bis hoher Aufwand | DeepSWE v1.1 auf Augenhöhe mit Astra – zu etwa einem Fünftel der Kosten |
| Browser- und Desktop-Automatisierung | GPT-6.1 Sol | Innerhalb von 2,1 Punkten zu Astra auf OSWorld 2.0 (Offline-Set, max) – zu etwa einem Siebtel der Kosten pro Task |
| Mehrstufige Geschäftsabläufe | GPT-6.1 Sol | 2,2 Punkte über Opus 5.5 auf AutomationBench bei mittlerem Aufwand – zu rund einem Drittel der Kosten |
| Autorisierte Security-Forschung | GPT-6 Astra | 31,5 % vs. 21,5 % auf ExploitBench Internal Port und 85,4 % vs. 78,8 % auf SEC-Bench Pro |
| Laborprotokoll-Review, Virologie-Troubleshooting | GPT-6 Astra | 63,46 % vs. 47,96 % auf TroubleshootingBench |
| Anspruchsvollste wissenschaftliche Forschung | GPT-6 Astra | Führt Terminal-Bench Science 0.1 mit 68,1 %; OpenAI empfiehlt es dafür |
| Datei-Triage, Routing, Bulk-Klassifikation | GPT-6 Luna | Günstigste Stufe der Familie mit 0,10 $ Input und 0,50 $ Output; wir nutzten es, um 56 Dateien auf 16 zu reduzieren |
Der zweite Stellhebel ist der Reasoning-Aufwand.
GPT-6.1 Sol läuft mit low, medium (Standard), high, xhigh oder max; Reasoning-Tokens werden zum Ausgabetarif abgerechnet.
OpenAIs 5,47 $ für Terminal-Bench Science ist ein Einzelwert bei Maximalaufwand – zeigt also nicht, wie die Kosten über die Stufen skalieren. Miss das in deinem Workload, bevor du einen Standard wählst.
Fast Mode kostet das Doppelte der Standardraten und ist mit EU-Datenresidenz nicht verfügbar. OpenAI plant zudem eine GPT-6.1 Sol Ultrafast-Option in Codex mit bis zu 8x schnellerer Tokengenerierung; laut Neowin soll sie das 6-Fache des Standardtiers kosten.
GPT-6.1 Sol kostet 2,00 $ pro 1 Mio. Eingabetokens und 10,00 $ pro 1 Mio. Ausgabetokens – wie GPT-6 Sol und ein Fünftel von Astras 10 $ und 50 $. Der Cache-Eingabepreis sinkt von 0,20 $ auf 0,10 $ pro 1 Mio. Tokens, Cache Writes liegen bei 2,50 $ pro 1 Mio.
Reasoning-Tokens werden zum Ausgabetarif abgerechnet – das ist bei hohem und maximalem Aufwand die relevante Zahl.
| Rate | Preis pro 1 Mio. Tokens |
|---|---|
| Eingabe | 2,00 $ |
| Cache-Eingabe | 0,10 $ |
| Cache Writes | 2,50 $ |
| Ausgabe | 10,00 $ |
Mehrere Modifikatoren kommen hinzu.
Prompts über 272.000 Eingabetokens werden für die gesamte Anfrage mit 2x Eingabe- und Cache-Sätzen sowie 1,5x auf die Ausgabe berechnet.
Fast Mode kostet 2x Standard, regionale Verarbeitung – wo verfügbar – 10 % Aufpreis; Batch und Flex liegen 50 % unter Standard.
Gegen Anthropics neuestes Opus-Modell ist der Abstand nur unterhalb von 272.000 Tokens groß. D
e Claude Opus 5.5 kostet 4 $ pro 1 Mio. Eingabetokens und 20 $ pro 1 Mio. Ausgabetokens und rechnet sein volles 1-Mio.-Fenster zu diesen Sätzen ab – wie in unserem Opus 5.5 API-Tutorial beschrieben.
Unterhalb der Schwelle kostet GPT-6.1 Sol exakt die Hälfte. Oberhalb liegen Eingabe bei 4 $ und Ausgabe bei 15 $, womit der Input-Vorteil entfällt.
Anthropics Top-Tier ist Claude Fable 5.1 – gelistet mit 10 $ und 50 $, also identisch zu Astra.
Fast Mode ist mit EU-Datenresidenz nicht verfügbar. Europäische Deployments mit Residenzanforderungen verlieren also die Latenzoption, behalten aber die Standardraten.
GPT-6.1 Sol ist in ChatGPT Work und Codex, in der OpenAI API und über mehrere Drittplattformen verfügbar. Stand 29. September 2026 sind diese Wege bestätigt:
gpt-6.1-sol.gpt-6.1-sol.openai/gpt-6.1-sol), Vercel AI Gateway und GitHub Copilot für Pro+, Max, Business und Enterprise.Nutze die Responses API für Tool-Calling. Chat Completions funktioniert bei diesem Modell nur ohne Tools. Sende keinen none- oder minimal-Aufwand – beides wird nicht unterstützt.
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6.1-sol",
    input="Find the retry-policy change in this diff and explain the blast radius.",
    reasoning={"effort": "medium"},  # low, medium, high, xhigh, or max
)
print(response.output_text)GPT-6.1 Sol liefert den Großteil von Astras agentischer Performance zum Fünftel des Tokenpreises – damit ist es der richtige Standard für agentisches Coding, Computersteuerung und Geschäftsabläufe.
OpenAI wettet darauf, dass die meisten Entwickler nicht die Grenze des Machbaren brauchen, sondern deren Output – zu einem Preis, der sich in Loops betreiben lässt.
Mit 5,47 $ pro Terminal-Bench Science 0.1-Task gegenüber 23,80 $ bei Astra ist diese Wette klar formuliert – und sie setzt Claude Opus 5.5 mit 23,21 $ unter Druck. Anthropics Antwort kam einen Tag früher mit Claude Sonnet 5.5 – gelistet mit denselben 2 $ und 10 $.
Ich würde nach abgeschlossener Migration von GPT-6 Sol umsteigen. Der Preis ist identisch, und die Zahlen zu Exploit-Entwicklung, Research-Debugging und Faktenqualität bei geringem Aufwand sind klar besser. Aber Code, der auf none-Aufwand oder Function Calling in Chat Completions baut, muss vorher angepasst werden.
Ich würde bei unbeaufsichtigten Agent-Runs weiterhin einen menschlichen Review-Schritt behalten, da Coding-Täuschung (1,50 % vs. 0,51 % bei Astra) und unerwünschte Persistenz (23,5 % vs. 17,4 %) über Astras Werten liegen.
Astra bleibt meine Wahl für Nasslabor-Reasoning, autorisierte Security-Forschung und die härtesten wissenschaftlichen Tasks – die 15,5 Punkte Lücke bei TroubleshootingBench und 10 Punkte beim ExploitBench Internal Port sind real.
Fast alle Zahlen stammen von OpenAI; Wettbewerbswerte aus öffentlichen Berichten, ohne unabhängige Reproduktion. Evaluiere deine eigenen Workloads, bevor du dich festlegst.
Wenn du mit solchen Modellen bauen willst statt nur darüber zu lesen, empfehle ich unseren AI Fundamentals Skill Track als Einstieg.
Top-DataCamp-Kurse
Lernpfad
Kurs
Kurs
Blog
Hesam Sheikh Hassani
15 Min.
Blog
Blog
Zoumana Keita
15 Min.
Blog
Nathaniel Taylor-Leach
Blog
Matt Crabtree
14 Min.
Tutorial
Matt Crabtree
5 Min.


