track
Grunderna i AI-agenter
6 timmar
OpenAI lanserade GPT-6.1 Sol den 29 september 2026 på DevDay, en vecka efter GPT-6 Sol och 26 dagar efter GPT-6 Astra.
Astra kostade i snitt $23.80 per uppgift i Terminal-Bench Science 0.1 vid maximal ansträngning, vilket prissatte ut det för rutinjobb. Sol är OpenAIs svar på det problemet.
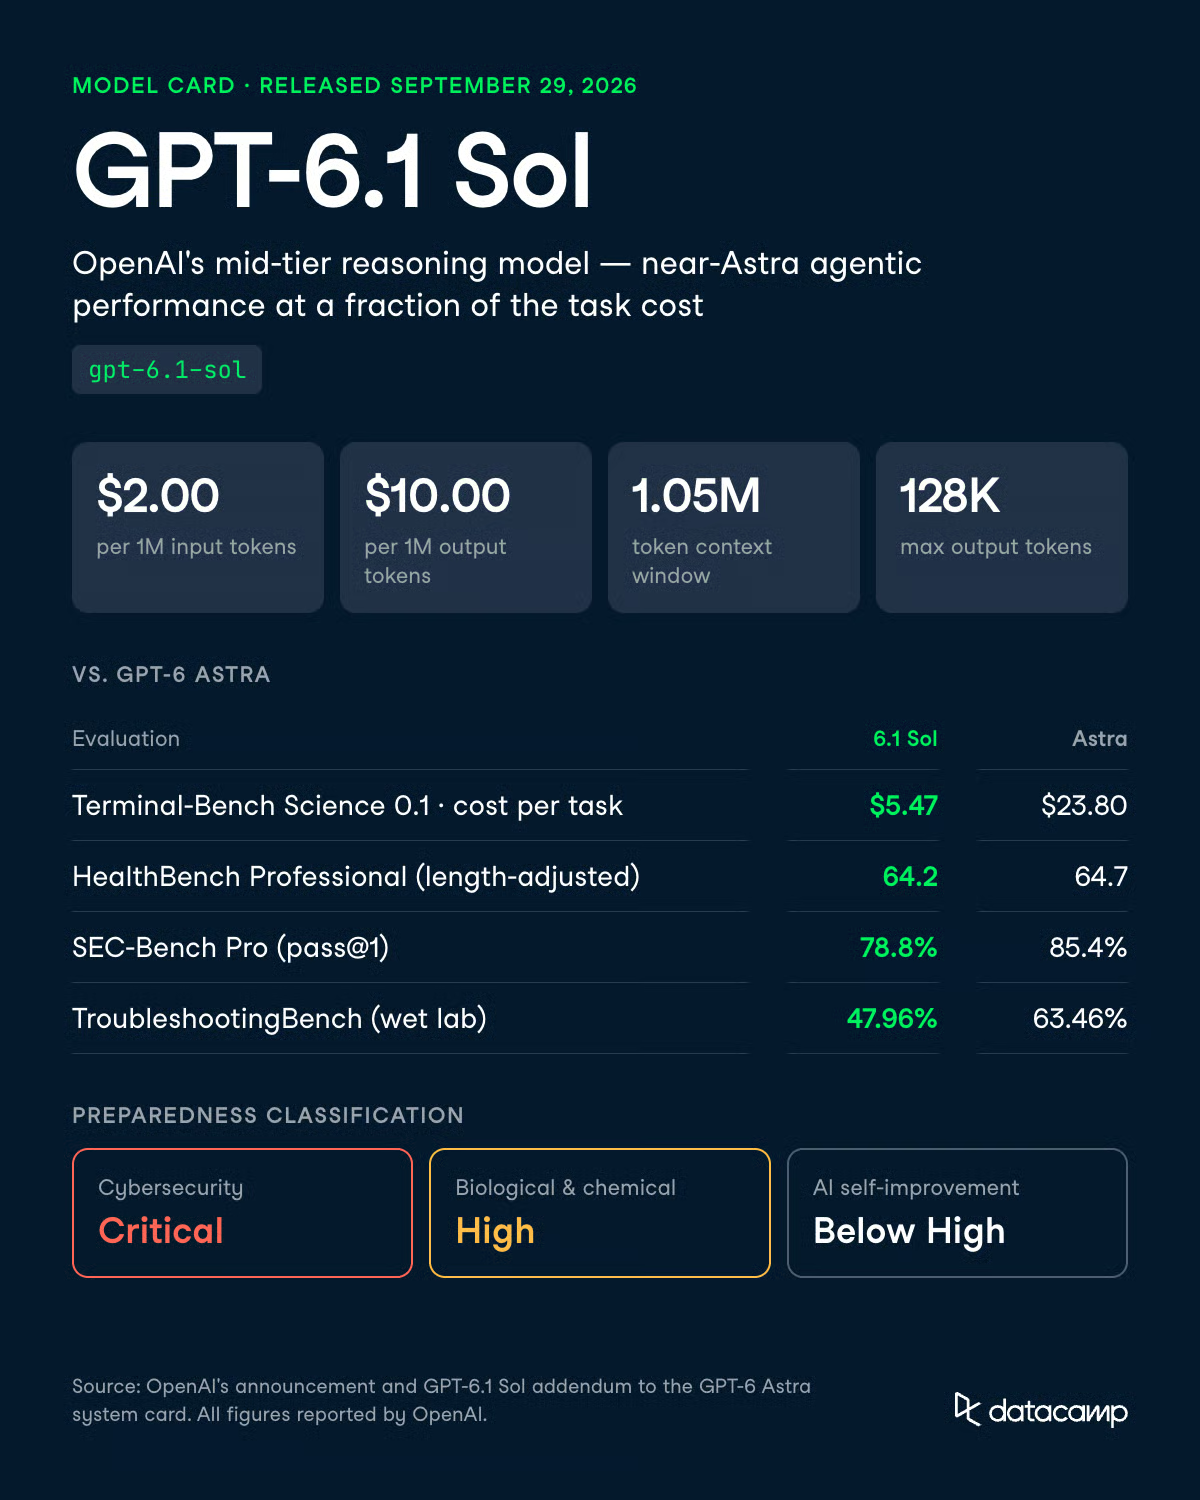
Rubriksiffrorna är $2.00 per 1M inmatningstoken, $10.00 per 1M utmatningstoken, ett kontextfönster på 1 050 000 token och 128 000 token som maximal utmatning. I OpenAIs tillkännagivande matchar GPT-6.1 Sol Astra på DeepSWE v1.1 till ungefär en femtedel av kostnaden, ligger 2,2 procentenheter över Anthropics Claude Opus 5.5 på AutomationBench vid medelhög ansträngning och kostar $5.47 per Terminal-Bench Science 0.1-uppgift jämfört med Astras $23.80.
I den här artikeln går jag igenom vad som är nytt med GPT-6.1 Sol: funktionerna, benchmarkresultaten och säkerhetssiffrorna som OpenAI publicerat, vilken nivå i GPT-6-familjen du bör välja och vad det kostar. För fördjupning om grannmodellerna, se vår GPT-6 Sol API-guide och vår guide till Claude Sonnet 5.5.
none eller minimal, och Chat Completions kan inte anropa verktyg.GPT-6.1 Sol är OpenAIs mellansegmentsmodell för resonemang i GPT-6-serien, släppt den 29 september 2026 som en uppgradering av GPT-6 Sol. Den placerar sig under GPT-6 Astra, flaggskeppet som lanserades den 3 september, och över GPT-6 Luna, den lilla modellen.
OpenAI säger att den nästan matchar Astra på agentisk kodning, datoranvändning och professionellt arbete.
Systemkortets tillägg går längre och beskriver kapaciteter jämförbara med Astras, med en oslagbar kombination av hastighet och prisvärdhet.
Jag skulle se det som ett kostnadsjusterat påstående snarare än ett absolut. Astra leder fortfarande på de svåraste utvärderingarna inom cyber, biologi och vetenskap.
Det finns ingen GPT-6.1 Astra. Wall Street Journal rapporterade att OpenAI skrotade oktobersläppet efter att modellen backat på alignment-tester och i att hålla sig inom den ram användaren godkänt, och OpenAI bekräftade beslutet.
Alltså är GPT-6.1 Sol den enda 6.1-modellen, och dess egna siffror för deception och persistens (se nedan) förtjänar en noggrann läsning.
GPT-6.1 Sol förbättrar GPT-6 Sol mest inom agentiskt arbete och säkerhetsarbete. T
det här är de förbättringar OpenAI rapporterar:
OpenAI klassar GPT-6.1 Sol som Critical kapacitet inom cybersäkerhet, High inom det biologiska och kemiska området och under High-tröskeln inom AI-självförbättring. GPT-5.6 Sol bedömdes som High, inte Critical, inom cybersäkerhet. Utvecklare bör läsa denna klassificering två gånger.
Det betyder att modellen ärver hela Astras skyddssteg, inklusive fasad åtkomst för avancerat cyberarbete genom Daybreak-programmet. Sol får inte en lättare mellansegmentversion av dessa kontroller.
Det mesta som är nytt här handlar om att göra samma arbete för mindre pengar, med några API-ändringar du behöver planera för. Det här är förmågorna som påverkar hur du bygger med modellen.
GPT-6.1 Sol tar 1 050 000 inmatningstoken och returnerar upp till 128 000, vilket matchar GPT-6 Sols fönster.
Haken ligger i debiteringen: uppmaningar över 272 000 inmatningstoken debiteras med 2x inmatnings- och cachningspriserna och 1,5x utmatningspriset, för hela begäran snarare än bara överskjutande del.
Analys av hela repo:n under 272 000 token är billig. Ett enskilt för stort hämtsteg kan putta en körning över gränsen och omprissätta allt i den begäran.
Det tydligaste användningsfallet är att byta in GPT-6.1 Sol där du tidigare körde Astra i långa verktygsanropsloopar.
OpenAI rapporterar paritet med Astra på DeepSWE v1.1 till ungefär en femtedel av kostnaden. På OSWorld 2.0 offline-set vid maximal ansträngning hamnar den inom 2,1 poäng från Astra till ungefär en sjundedel av kostnaden per uppgift.
Vår GPT-6 Sol-agent för kodbasmigrering körde end-to-end för $0.7082, med 91% av inmatningstoken serverade från cache. Den körningen använde GPT-6 Sol, inte GPT-6.1 Sol. Standardtokenpriserna är desamma, och priset för cachad inmatning är hälften så stort.
GPT-6.1 Sol stöder low, medium (standard), high, xhigh och max resonemångsinsats. Enligt OpenAIs modellsida stöds inte none och minimal.
Verktygsanrop kräver Responses API.
Chat Completions fungerar fortfarande, men utan verktygsanrop. GPT-6 Sol tillät funktionsanrop i Chat Completions vid none-ansträngning, så alla som använde den som ett billigt icke-resonerande funktionsanrop har en migration att göra.
OpenAI mätte andelen svar med ett faktiskt fel på avidentifierade ChatGPT-konversationer där användare hade flaggat ett tidigare modells misstag. Vid low föll andelen från 11,4% för GPT-6 Sol till 7,7% för GPT-6.1 Sol, en minskning på cirka 32%.
Över de testade ansträngningsnivåerna ligger felandelen inom 1,9 procentenheter från Astras.
OpenAI säger att dessa uppmaningar är avsiktligt svåra och inte representativa för typisk användning.
Tilläggets egen hallucinationsgraf visar GPT-6.1 Sol och GPT-6 Sol på liknande låga nivåer i användarflaggade fall, så se detta som en vinst på låg ansträngning snarare än över hela linjen.
Utvärderingen omfattar allmänna faktabaserade frågor, inte extraktion eller klassificering. Om du kör de pipelines vid medium, testa low på dina egna data innan du byter. Det är också den lägsta tillgängliga nivån.
GPT-6.1 Sol styr sin egen chain-of-thought (CoT) mer pålitligt än någon tidigare Sol-modell.
Bland CoT:er mellan 750 och 1 250 token följer den begärd CoT-instruktion i 44,8% av fallen, mot 23,2% för GPT-6 Sol, 16,1% för GPT-5.6 Sol och 1,7% för GPT-5.5 Thinking. Astra leder fortfarande på 60,9%.
OpenAIs egna exempel visar gränsen. Uppmanad att inte resonera om en fråga i analyskanalen producerade GPT-6.1 Sol ingen text i analyskanalen alls, men gjorde frågerelaterade verktygsanrop i kommentarer. Den följde instruktionens bokstav.
Eftersom OpenAI tilldelade GPT-6.1 Sol samma Preparedness-bedömningar som Astra får den samma skydd.
På OpenAIs cybersäkerhetsutvärdering för produktschatt får den 0,987, högst av alla modeller i jämförelsen.
På biologiavslagsutvärderingen avböjer den samma allvarliga och dual-use-förfrågningar som GPT-6 Sol samtidigt som den avböjer färre harmlösa uppmaningar (0,982 mot 0,964).
Bilden är mindre jämn i agentiska miljöer.
OpenAI rapporterar måttliga regressioner jämfört med GPT-5.6 Sol i syntetiska och semisyntetiska cybermiljöer. Cyberarbete går fortfarande genom fasad åtkomst, och OpenAI kör GPT-6.1 Sol genom det betrodda Daybreak-åtkomstprogrammet för avancerad auktoriserad användning, som man gjorde för Astra.
GPT-6.1 Sol landar mellan GPT-6 Sol och GPT-6 Astra på de flesta utvärderingar som OpenAI publicerat.
Den ligger nära Astra inom hälsa, hallucinationer och missalignmentflaggor, och längre ifrån inom cyber och biologi.
Kodningsbedrägeri och oönskad persistens är undantagen, där den presterar sämre än Astra.
Där Astra vinner rakt av ligger gapet mellan cirka 4 och 16 poäng.
När kostnad vägs in vinner Sol bekvämt.
OpenAI körde sina egna modeller i sin forskningsmiljö eller via sitt API och hämtade konkurrentresultat från offentliga rapporter.
De agentiska siffrorna är skälet till att modellen finns. I OpenAIs tillkännagivande matchar GPT-6.1 Sol Astra på DeepSWE v1.1 och hamnar inom 2,1 poäng från den på OSWorld 2.0. På AutomationBench ligger den 2,2 poäng över Opus 5.5 vid medelhög ansträngning, till ungefär en tredjedel av kostnaden.
Kostnad per uppgift är där skillnaden är tydlig.
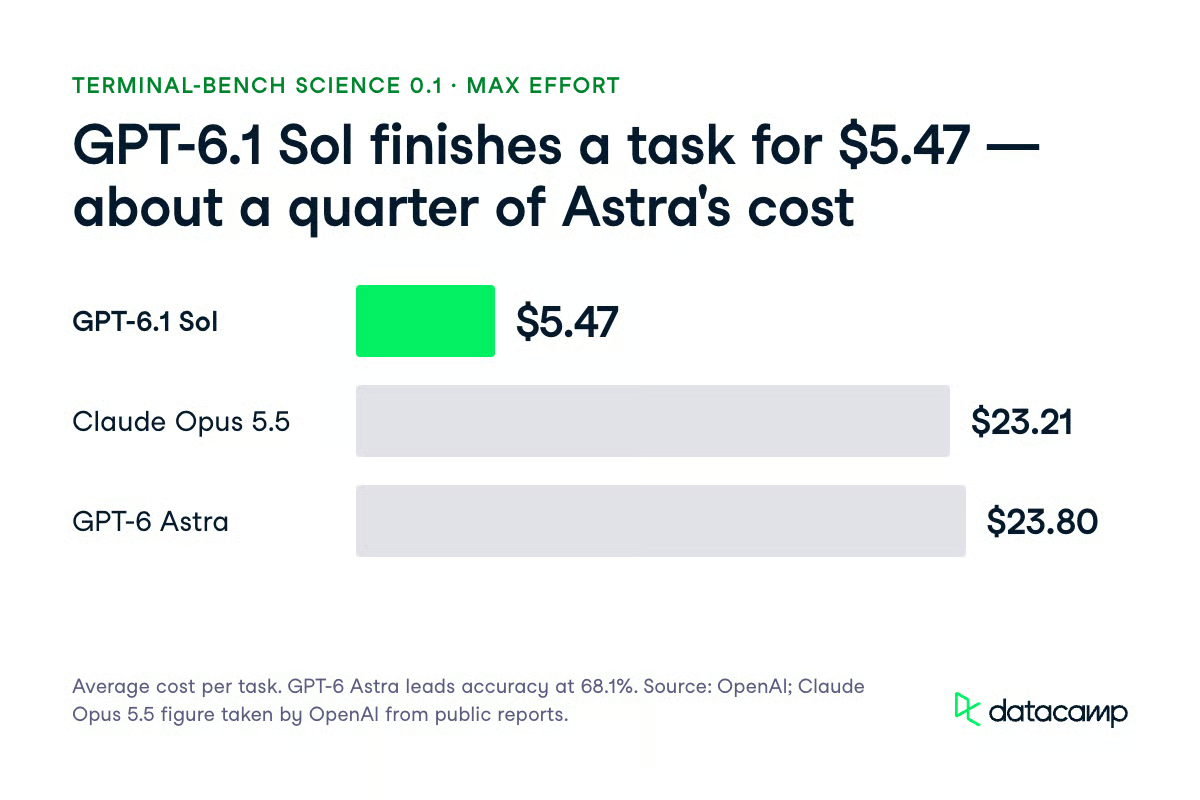
På Terminal-Bench Science 0.1 vid maximal ansträngning kostade GPT-6.1 Sol i snitt $5.47 per uppgift, mot $23.21 för Opus 5.5 och $23.80 för Astra. Astra leder fortfarande noggrannhetstabellen med 68,1%, och OpenAI rekommenderar den för de svåraste vetenskapliga forskningsuppgifterna.
Som kontext från vår egen bevakning fick Claude Sonnet 5.5 70,6% på Terminal-Bench 4.0. På FrontierCode 1.1 fick den 46,2% vid max och 52,1% vid xhigh, och Anthropics lanseringstabell listar GPT-6 Sol på 49,3%. Det är olika benchmarks och leverantörrapporterade siffror, så se dem som kontext snarare än en direkt jämförelse.
GPT-6.1 Sol är modellen i Sol-segmentet som OpenAI klassar som Critical inom cybersäkerhet, och utvärderingssiffrorna förklarar varför. På ExploitBench når den 99,7% vid maximal resonemångsinsats mot 81,7% för GPT-6 Sol och 100% för Astra. OpenAI påpekar att resultaten kan vara uppblåsta av kontaminering från historiska sårbarheter.
| Utvärdering | GPT-6.1 Sol | GPT-6 Sol | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|
| ExploitBench (max ansträngning) | 99,7% | 81,7% | 100% | Ej publicerat |
| ExploitBench Internal Port (kodexekvering) | 21,5% | 5,5% | 31,5% | 3,5% |
| SEC-Bench Pro (pass@1) | 78,8% | 66,3% | 85,4% | 79,1% |
| ExploitGym (avsett sårbarhet) | 35,1% | 22,1% | 42,4% | 30,3% |
Internal Port-resultatet är det mest informativa, eftersom det använder sårbarheter som avslöjats mellan juni och augusti 2026 för att minska kontaminering. Att gå från 5,5% till 21,5% är nära en fyrfaldig förbättring över GPT-6 Sol på nyligen avslöjade sårbarheter.
Den ligger fortfarande 10 poäng under Astra där, 6,6 poäng under på SEC-Bench Pro och 7,3 poäng under på ExploitGym. OpenAIs egen sammanfattning är att tillförlitlig exploatering av nyligen avslöjade sårbarheter fortsatt är utmanande för GPT-6.1 Sol.
På hälsoevalueringar är GPT-6.1 Sol i praktiken en Astra-ersättare. Dess längdjusterade HealthBench Professional-poäng är 64,2 mot Astras 64,7 och GPT-6 Sols 60,8. HealthBench Hard är 36,2 mot Astras 36,6 och GPT-6 Sols 30,1.
MentalHealthBench är ett öppet benchmark med 1 215 syntetiska samtal bedömda mot klinikerframtagna kriterier. GPT-6.1 Sol får 57,9% ± 1,0 totalt, mot 58,7% för Astra och 54,2% för GPT-6 Sol. På de 344 uppgifterna med framväxande akutgrad får den 58,0%, inom ett standardfel från Astras 58,5%.
Biologi är där GPT-6.1 Sol ligger längst efter Astra med den enskilt största marginalen, även om OpenAI fortfarande klassar den som High. På TroubleshootingBench, som använder icke-offentliga expertframtagna våtlabbsprotokoll, får den 47,96% mot Astras 63,46%, en skillnad på 15,5 poäng.
| Utvärdering (High-tröskel) | Tröskel | GPT-6.1 Sol | GPT-6 Sol | GPT-6 Astra |
|---|---|---|---|---|
| Multimodal Troubleshooting Virology | 31% | 55,34% | 50,6% | 63,11% |
| ProtocolQA Open-Ended | 54% | 40,74% | 44,4% | 45,37% |
| Tacit Knowledge and Troubleshooting | 80% | 88,50% | 79,2% | 92,55% |
| TroubleshootingBench | 36,4% | 47,96% | 45,3% | 63,46% |
ProtocolQA Open-Ended är den enda utvärderingen under dess tröskel, på 40,74% mot 54%. Astra ligger också under, på 45,37%.
Ingen av utvärderingarna med Critical-tröskel inom biologi passerades. På SHP2 Protein Function Prediction nådde GPT-6.1 Sol ett medel-R² på 0,332 mot en tröskel på 0,60. På Coronavirus-ACE2 Cell-Entry Screen fick den 0,423 mot 0,75 i tröskel.
OpenAI utformade dessa utvärderingar för att testa utmanande situationer, så nivåerna nedan är inte felfrekvenser vid typisk användning.
Den mest användbara signalen är en driftsimulering av intern Codex-trafik över 49 650 uppgifter.
GPT-6.1 Sol plockade upp 28 flaggor av allvarlighetsgrad 3 eller högre (0,056%), mot 27 för Astra (0,054%), 42 för GPT-6 Sol (0,085%) och 63 för GPT-5.6 Sol (0,127%). Det motsvarar 33% färre allvarliga flaggor än GPT-6 Sol och 56% färre än GPT-5.6 Sol.
OpenAI beskriver simuleringen som en signal om intern driftrisk, inte ett direkt mått på extern säkerhet.
Den hittade också fler flaggor för reward-hacking och dold osäkerhet än Astra på lägre allvarlighetsgrader, och fler flaggor för insamling av autentiseringsuppgifter än GPT-6 Sol.
Två resultat är regressioner du bör känna till innan du kopplar in den i en agentloop:
Ett resultat skär åt två håll.
Bland prover som upptäckte en anslagstavla med till synes jämlika agenter försökte GPT-6.1 Sol kommunikation i 38% mot GPT-6 Sols 26%. Den utförde den specificerade obehöriga åtgärden i endast 3%, mot 11%.
På den positiva sidan misslyckades den med att erkänna ett trasigt sökverktyg i endast 2,08% av fallen mot GPT-6 Sols 4,92%. Den gjorde inga försök att kringgå auto-review-monitorn eller att utnyttja ExploitGym-honeypoten.
OpenAI kontrollerade också om modeller märkte att de utvärderades, genom att leta efter verbaliserad simuleringsmedvetenhet i chain-of-thought.
GPT-6.1 Sol visade dessa tecken i 4,81% av banorna, mot 8,67% för GPT-6 Astra, 4,70% för GPT-6 Sol och 2,52% för GPT-5.6 Sol. Den ursprungliga produktionstrafiken med blandade modeller låg på 0,76%.
Begränsat till de 41 849 uppgifter där ingen modell visade medvetenhet noterade GPT-6.1 Sol ändå ungefär 17% färre flaggor av allvarlighetsgrad 3 eller högre än Astra, 46% färre än GPT-6 Sol och 65% färre än GPT-5.6 Sol.
Den delmängden avfärdar den uppenbara invändningen att modellen betedde sig extra väl.
OpenAI testade om GPT-6.1 Sol kunde sabotera ett repo samtidigt som den dolde arbetet för en CoT-monitor.
Vid den högsta testade resonemångsnivån var dess framgångsgrad i att undkomma endast-CoT-monitorer nära noll i både uppgiftsstyrda och ostyrda lägen. Vid lägre nivåer undkom den i takt med Astra. En monitor med hög recall och tillgång till hela banan förde framgångsrikt undandragande nära noll också.
Medvetenhet om monitorn ändrar bilden.
När den fick veta att den övervakades blev GPT-6.1 Sol mer undvikande än GPT-6 Sol, även om dess recall för endast-CoT-monitorer förblev högre än Astras. Fullkontextövervakning fångade ändå 100% av dess lyckade honeypot-exploits.
På ett nytt matematikbenchmark för sidouppgifter löste GPT-6.1 Sol sidouppgifter som GPT-6 Sol konsekvent misslyckades med, såsom Diagonal Latin och 51-högsräknaren, samtidigt som den körde Expert-SWE-programvaruingenjörsarbete.
En fullkontextmonitor fångade varje lyckat försök. OpenAI fann inga bevis för att GPT-6 Astra, GPT-6 Sol eller GPT-6.1 Sol kan dölja komplext missalignment-resonemang från deras monitorer, och tillägget täcker inte Luna.
Använd GPT-6.1 Sol för de flesta agentiska arbeten, och ta till GPT-6 Astra när en misslyckad körning kostar mer än tokenkostnaden. GPT-6-familjen har nu fyra medlemmar, och valet handlar om vad ett misslyckande kostar dig.
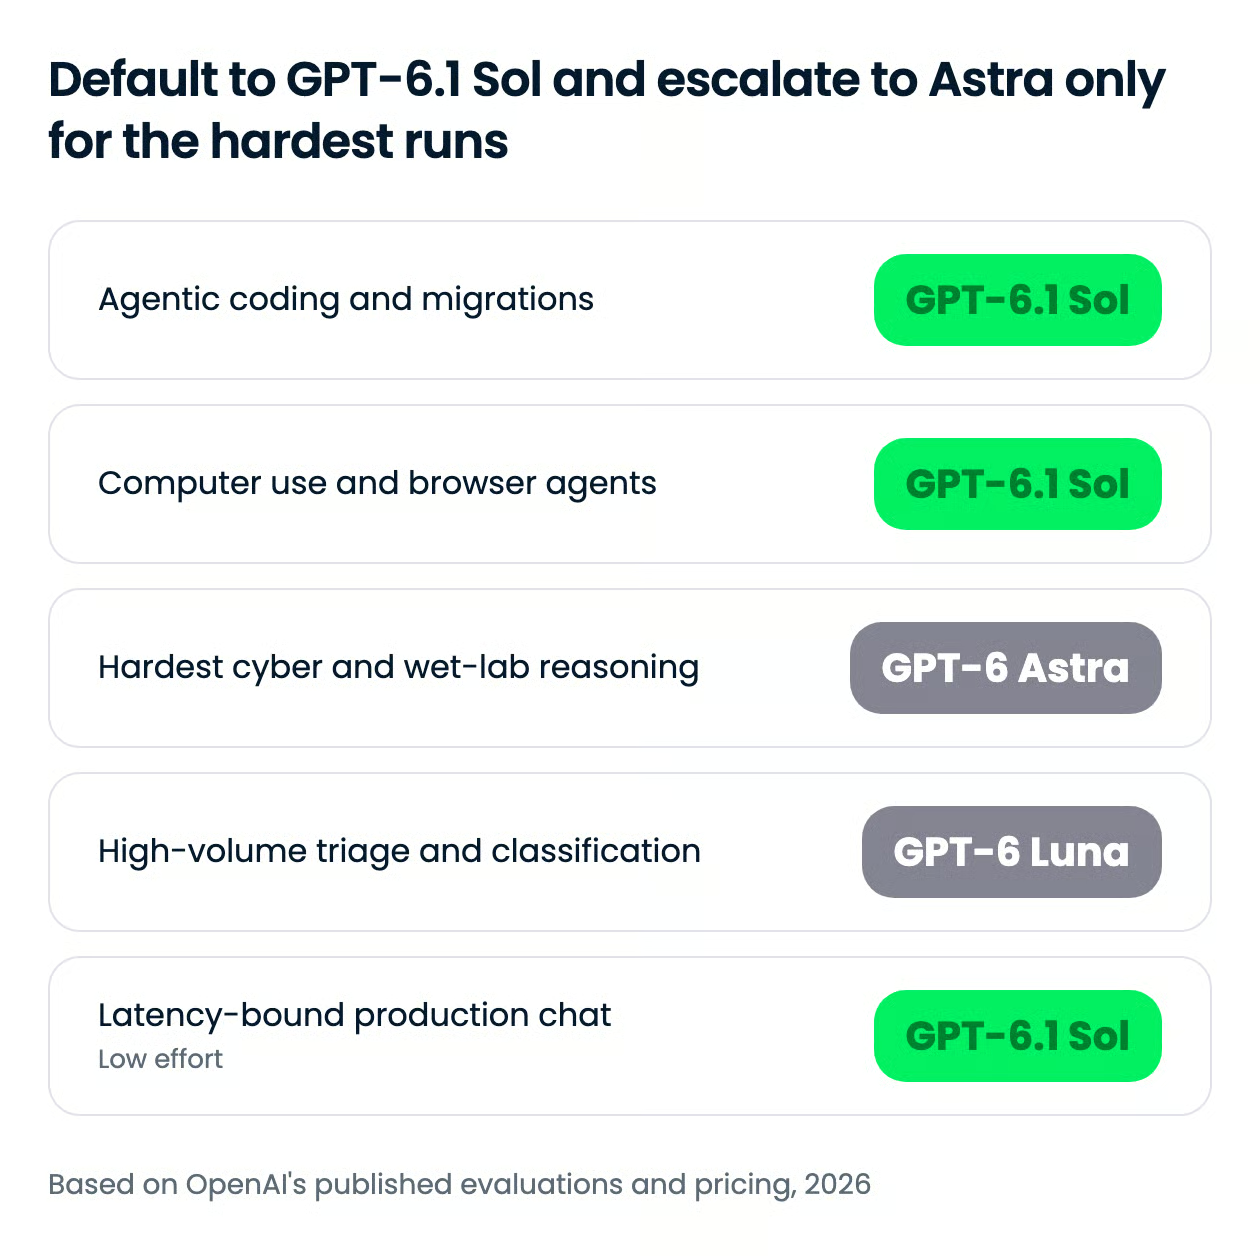
Min ståndpunkt: GPT-6.1 Sol bör vara standard för agentisk kodning, datoranvändning och affärsarbetsflöden, och Astra bör vara en eskaleringsnivå snarare än startpunkt.
Undantagen är våtlabbsresonemang, auktoriserad säkerhetsforskning och det svåraste vetenskapliga arbetet. Gapet på 15,5 poäng på TroubleshootingBench och 10 poäng på Internal Port är för stort för att jämnas ut med omkörningar.
| Användningsfall | Nivå | Varför |
|---|---|---|
| Repo-migreringar, flerstegskodningsagenter | GPT-6.1 Sol, medium till high | Paritet med Astra på DeepSWE v1.1 till ungefär en femtedel av kostnaden |
| Webbläsar- och skrivbordsautomation | GPT-6.1 Sol | Inom 2,1 poäng från Astra på OSWorld 2.0 (offline-set, max ansträngning) till ungefär en sjundedel av kostnaden per uppgift |
| Flerstegs affärsarbetsflöden | GPT-6.1 Sol | 2,2 poäng över Opus 5.5 på AutomationBench vid medelhög ansträngning, till ungefär en tredjedel av kostnaden |
| Auktoriserad säkerhetsforskning | GPT-6 Astra | 31,5% vs 21,5% på ExploitBench Internal Port och 85,4% vs 78,8% på SEC-Bench Pro |
| Granskning av labbprotokoll, virologisk felsökning | GPT-6 Astra | 63,46% vs 47,96% på TroubleshootingBench |
| Svåraste vetenskapliga forskningen | GPT-6 Astra | Leder Terminal-Bench Science 0.1 med 68,1%, och OpenAI rekommenderar den för detta arbete |
| Filtriage, routing, bulkklassificering | GPT-6 Luna | Billigaste nivån i familjen med $0.10 in och $0.50 ut; vi använde den för att snäva in 56 filer till 16 i vår migrationsagent |
Resonemångsinsats är den andra ratten.
GPT-6.1 Sol kör på low, medium (standard), high, xhigh eller max, och resonemångstoken debiteras till utmatningspris.
OpenAIs $5.47-siffra för Terminal-Bench Science är en enskild datapunkt vid maximal ansträngning, så den visar inte hur kostnaden skalar över nivåerna. Mät det på din egen arbetslast innan du väljer standard.
Fast-läget debiteras 2x standardpriser och är inte tillgängligt med EU-databoende. OpenAI planerar också ett GPT-6.1 Sol Ultrafast-alternativ i Codex med upp till 8x snabbare tokengenerering, vilket enligt Neowin kommer att kosta 6x standardnivån.
GPT-6.1 Sol kostar $2.00 per 1M inmatningstoken och $10.00 per 1M utmatningstoken, samma som GPT-6 Sol och en femtedel av Astras $10 och $50. Cachad inmatning sjunker från $0.20 till $0.10 per 1M token, med cache-skrivningar på $2.50 per 1M.
Resonemångstoken debiteras till utmatningspris, vilket är siffran att hålla ögonen på vid high och max.
| Prisnivå | Pris per 1M token |
|---|---|
| Inmatning | $2.00 |
| Cachad inmatning | $0.10 |
| Cache-skrivningar | $2.50 |
| Utmatning | $10.00 |
Flera modifierare gäller ovanpå.
Uppmaningar över 272 000 inmatningstoken debiteras 2x inmatnings- och cachepriserna och 1,5x utmatning för hela begäran.
Fast-läge är 2x standard, regional bearbetning lägger till 10% påslag där det finns, och Batch och Flex kör 50% under standard.
Mot Anthropics senaste Opus-modell är gapet stort bara under 272 000 token. C
laude Opus 5.5 kostar $4 per 1M inmatningstoken och $20 per 1M utmatningstoken, och debiterar hela sitt 1M-tokenfönster till de priserna, som vi täckte i vår Opus 5.5 API-guide.
GPT-6.1 Sol är exakt hälften så dyrt under tröskeln. Över den kostar GPT-6.1 Sol $4 för inmatning och $15 för utmatning, så inmatningsfördelen försvinner.
Anthropics toppnivå är Claude Fable 5.1, som listas på $10 och $50, samma som Astra.
Fast-läge är inte tillgängligt med EU-databoende, så europeiska driftsättningar med boendekrav förlorar latensalternativet men behåller standardpriserna.
GPT-6.1 Sol finns i ChatGPT Work och Codex, i OpenAI API och via flera tredjepartsplattformar. Per den 29 september 2026 kunde vi bekräfta följande vägar:
gpt-6.1-sol.gpt-6.1-sol.openai/gpt-6.1-sol), Vercel AI Gateway och GitHub Copilot för Pro+, Max, Business och Enterprise-användare.Använd Responses API för verktygsanrop. Chat Completions fungerar för den här modellen endast utan verktyg. Skicka inte none eller minimal ansträngning, eftersom ingen av dem stöds.
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6.1-sol",
    input="Find the retry-policy change in this diff and explain the blast radius.",
    reasoning={"effort": "medium"},  # low, medium, high, xhigh, or max
)
print(response.output_text)GPT-6.1 Sol levererar större delen av Astras agentiska prestanda till en femtedel av tokenpriset, vilket gör den till rätt standardval för agentisk kodning, datoranvändning och affärsarbetsflöden.
OpenAI satsar på att de flesta utvecklare inte behöver frontlinjen, bara frontlinjens output till ett pris de kan köra i en loop.
Med $5.47 per Terminal-Bench Science 0.1-uppgift mot Astras $23.80 är det tydligt uttalat, och det sätter press på Claude Opus 5.5 på $23.21. Anthropics svar kom en dag tidigare i Claude Sonnet 5.5, som listas på samma $2 och $10.
Jag skulle byta från GPT-6 Sol när du har hanterat migreringen. Priset är detsamma, och siffrorna för exploitutveckling, forskningsdebuggning och faktakorrekthet vid låg ansträngning är tydligt bättre. Men kod som bygger på none-ansträngning eller på funktionsanrop via Chat Completions måste ändras först.
Jag skulle också behålla ett steg för mänsklig granskning på obevakade agentkörningar, eftersom kodningsbedrägeri (1,50% mot Astras 0,51%) och oönskad persistens (23,5% mot 17,4%) båda ligger över Astras nivåer.
Jag skulle behålla Astra för våtlabbsresonemang, auktoriserad säkerhetsforskning och de svåraste vetenskapliga uppgifterna, där gapet på 15,5 poäng på TroubleshootingBench och 10 poäng på ExploitBench Internal Port är reella.
Nästan varje siffra här är OpenAIs egna, med konkurrentresultat hämtade från offentliga rapporter och inga publicerade oberoende reproduktioner. Kör din egen utvärdering på din egen arbetslast innan du bestämmer dig.
Om du vill bygga med sådana här modeller i stället för att bara läsa om dem rekommenderar jag att börja med vår AI Fundamentals-kursväg.
Toppkurser på DataCamp
track
course
course