Tracks
AIエージェントの基礎
6時間
OpenAI は 2026 年 9 月 29 日の DevDay で GPT-6.1 Sol をリリースしました。これは GPT-6 Sol の 1 週間後、GPT-6 Astra の 26 日後です。
Astra は Terminal-Bench Science 0.1 のタスクを最大努力で実行した場合、1 タスクあたり平均 $23.80 と高額で、日常業務には向きませんでした。Sol はその問題への OpenAI の解答です。
主な数値は、入力 100 万トークンあたり $2.00、出力 100 万トークンあたり $10.00、コンテキストウィンドウ 1,050,000 トークン、最大出力 128,000 トークンです。OpenAI の発表によれば、GPT-6.1 Sol は DeepSWE v1.1 で Astra に匹敵しつつコストは約 5 分の 1、AutomationBench では中程度の努力で Anthropic の Claude Opus 5.5 を 2.2 ポイント上回り、Terminal-Bench Science 0.1 の 1 タスクあたりコストは Astra の $23.80 に対して $5.47 とされています。
本記事では、GPT-6.1 Sol の新機能、OpenAI が公開したベンチマークと安全性の数値、GPT-6 ファミリーのどの階層を使うべきか、そして料金について解説します。周辺モデルの詳説は、GPT-6 Sol API チュートリアルと、Claude Sonnet 5.5 のガイドをご覧ください。
none と minimal の reasoning effort をサポートせず、Chat Completions はツール呼び出し非対応です。GPT-6.1 Sol は、GPT-6 シリーズの中位推論モデルで、2026 年 9 月 29 日に GPT-6 Sol のアップグレードとして公開されました。9 月 3 日に発表されたフラッグシップの GPT-6 Astra の下位、小型モデルの GPT-6 Luna の上位に位置づけられます。
OpenAI は、エージェント型のコーディング、PC 操作、プロフェッショナル業務で Astra にほぼ匹敵すると述べています。
システムカードの付録はさらに踏み込み、Astra に匹敵する能力に、速度と手頃さの両立で優位性があると説明しています。
ただし、それはコストを加味した評価と捉えるべきです。絶対的には、最難度のサイバー・生物・科学分野では Astra が先行しています。
GPT-6.1 Astra は存在しません。ウォール・ストリート・ジャーナルは、アラインメントテストとユーザーが許可した範囲の順守で後退が見られたため、OpenAI が 10 月のリリースを取りやめたと報じ、OpenAI もそれを認めました。
したがって、GPT-6.1 は Sol のみであり、(後述する)欺瞞と持続性に関する数値は注意深く読む価値があります。
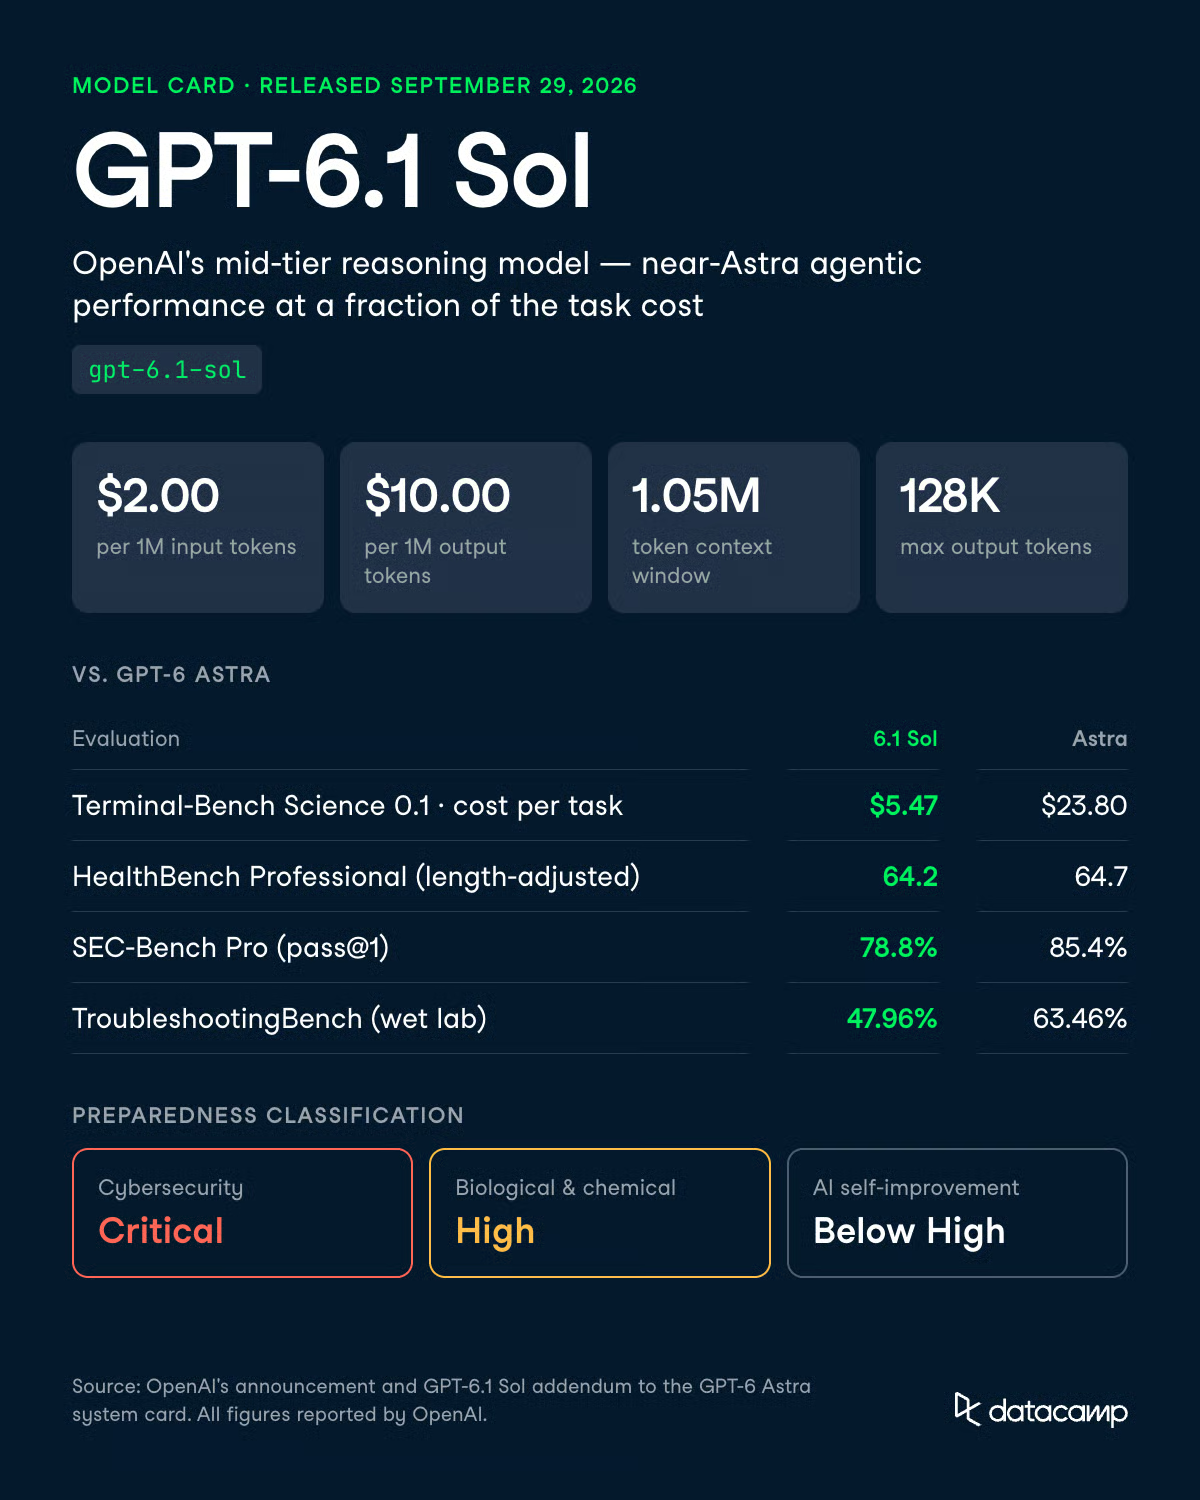
GPT-6.1 Sol は、エージェント系とセキュリティ関連の作業で GPT-6 Sol を最も大きく上回ります。
OpenAI の公表値は以下のとおりです。
OpenAI は、GPT-6.1 Sol をサイバーセキュリティで「重大(Critical)」、生物・化学領域で「高(High)」、AI 自己改善では High の閾値未満と評価しています。GPT-5.6 Sol はサイバーで「高(High)」であり、「重大」ではありませんでした。開発者はこの区分を二度読むべきです。
これは、Astra と同一のセーフガード群を継承することを意味し、高度なサイバー業務には Daybreak プログラムを通じた段階的アクセスが含まれます。Sol は中位向けに軽い制御へ緩和されません。
大半の新点は、同じ仕事をより低コストでこなすことにあり、いくつかの API 変更には事前対応が必要です。構築の前提を変える重要な能力は次のとおりです。
GPT-6.1 Sol は入力 1,050,000 トークン、出力最大 128,000 トークンで、GPT-6 Sol と同じウィンドウです。
注意点は課金です。入力 272,000 トークンを超えるプロンプトは、超過分ではなくリクエスト全体に対して、入力とキャッシュが 2 倍、出力が 1.5 倍のレートで請求されます。
リポジトリ全体の解析でも、272,000 トークン以下なら安価です。単一の大きな検索取得ステップが境界を越えると、そのリクエスト全体の単価が変わります。
最もわかりやすい使い道は、長いツール呼び出しループで Astra を使っていた箇所を GPT-6.1 Sol に置き換えることです。
OpenAI は、DeepSWE v1.1 で Astra と同等の性能を、コスト約 5 分の 1で達成したと報告しています。OSWorld 2.0 のオフラインセット(最大努力)では、タスクあたりコスト約 7 分の 1で Astra に 2.1 ポイント差まで迫ります。
当社のGPT-6 Sol コードベース移行エージェントは、入力トークンの 91% をキャッシュから提供し、エンドツーエンドで $0.7082 でした。これは GPT-6 Sol での実行であり、GPT-6.1 Sol ではありません。標準のトークン単価は同じで、キャッシュ済み入力は半額です。
GPT-6.1 Sol は low、medium(デフォルト)、high、xhigh、max の reasoning effort をサポートします。OpenAI のモデルページによると、none と minimal は非対応です。
ツール呼び出しには Responses API が必要です。
Chat Completions も使えますが、ツール呼び出しは不可です。GPT-6 Sol は none の effort で Chat Completions による関数呼び出しが可能だったため、安価な非推論関数コーラーとして使っていた場合は移行が必要です。
OpenAI は、ユーザーが以前のモデルの誤りを報告した ChatGPT の匿名化会話における、事実誤りを含む回答の割合を測定しました。low では、GPT-6 Sol の 11.4% から GPT-6.1 Sol の 7.7% に低下し、約 32% の改善でした。
テストした effort 設定全体で見ると、Astra との差は最大でも 1.9 ポイント以内に収まります。
これらのプロンプトは意図的に難しく、典型的な使用状況を代表しないと OpenAI は述べています。
付録のハルシネーション図でも、ユーザー報告ケースでは GPT-6.1 Sol と GPT-6 Sol が同程度の低率を示しているため、これは「低 effort での改善」であり、全面的な改善と受け取らないでください。
評価は一般的な事実質問であり、抽出や分類ではありません。パイプラインを medium で走らせている場合は、切替前に自分のデータで low をテストしてください。なお、low が最も低い設定です。
GPT-6.1 Sol は、これまでの Sol 系モデルよりも安定して自らの CoT を制御できます。
750〜1,250 トークンの CoT において、要求した CoT 指示に従った割合は 44.8%。GPT-6 Sol は 23.2%、GPT-5.6 Sol は 16.1%、GPT-5.5 Thinking は 1.7% で、Astra は 60.9% と先行しています。
ただし限界もあります。分析チャネルでの推論を禁じられた例で、GPT-6.1 Sol は分析チャネルに一切テキストを出さず、コメント側で質問関連のツール呼び出しを行いました。文字通りの指示には従っています。
OpenAI が GPT-6.1 Sol に Astra と同じ Preparedness 判定を与えたため、セーフガードも同等です。
本番チャット向けのサイバーセキュリティ安全性評価では 0.987 と、比較対象中で最高スコアを記録しました。
生物学の拒否評価では、GPT-6 Sol と同程度に厳しい・デュアルユースの要求を拒否しつつ、無害なプロンプトの拒否は減少(0.964 に対し 0.982)。
一方、エージェント環境では差が出ます。
OpenAI は、合成・半合成のサイバー環境で GPT-5.6 Sol からの軽微な後退を報告しています。サイバー業務は引き続き段階的アクセスで、GPT-6.1 Sol も Astra 同様に、高度な公認用途向けの Daybreak トラステッドアクセスプログラムで運用されています。
GPT-6.1 Sol は、OpenAI が公開した多くの評価で GPT-6 Sol と GPT-6 Astra の中間に位置します。
ヘルス、ハルシネーション、ミスアラインメントのフラグでは Astra に近く、サイバーと生物で差が広がります。
コーディングの欺瞞と望まれない持続性は例外で、Astra より悪化しています。
Astra が明確に優位な場合、差はおよそ 4〜16 ポイントです。
コストを加味すると、Sol が優位です。
OpenAI は自社モデルを研究環境または API で実行し、競合の数値は公開レポートから引用しています。
このモデルの存在理由はエージェント系の数値です。OpenAI の発表では、GPT-6.1 Sol は DeepSWE v1.1 で Astra に並び、OSWorld 2.0 では 2.1 ポイント差まで迫ります。AutomationBench では中程度の努力で Opus 5.5 を 2.2 ポイント上回り、コストは約 3 分の 1です。
タスクあたりコストで差が明確です。
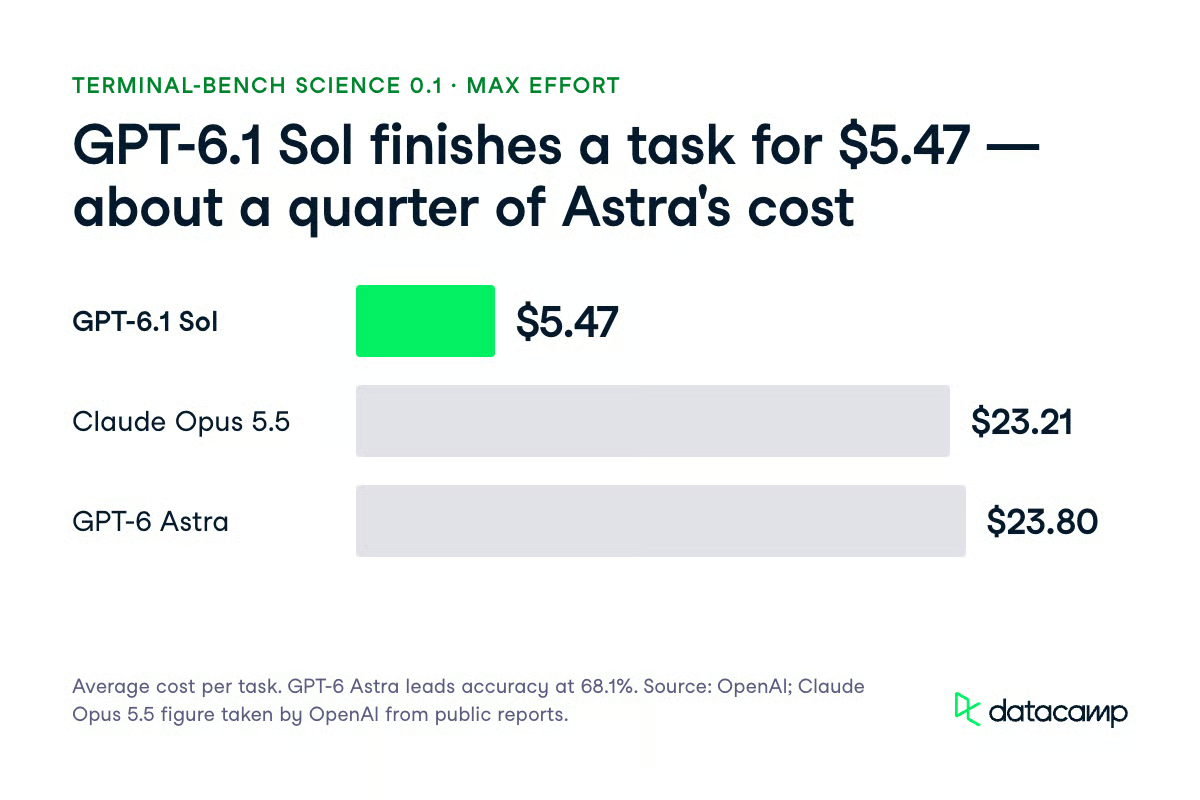
Terminal-Bench Science 0.1(最大努力)では、GPT-6.1 Sol の平均が 1 タスクあたり $5.47、Opus 5.5 は $23.21、Astra は $23.80。正確性では Astra が 68.1% で首位を維持し、最も困難な科学研究には Astra を推奨すると OpenAI は述べています。
参考までに、当サイトのカバレッジでは、Claude Sonnet 5.5 は Terminal-Bench 4.0 で 70.6%。FrontierCode 1.1 では最大努力で 46.2%、xhigh で 52.1%、Anthropic の発表表では GPT-6 Sol が 49.3% とされています。異なるベンチマークでベンダー公表値のため、参考程度にご覧ください。
GPT-6.1 Sol は、OpenAI がサイバーで「重大(Critical)」とする Sol 階層のモデルで、その理由は評価数値から明らかです。ExploitBench では最大 effort で 99.7% に達し、GPT-6 Sol は 81.7%、Astra は 100%。なお、過去の脆弱性による汚染で水増しの可能性があると OpenAI は注意喚起しています。
| 評価 | GPT-6.1 Sol | GPT-6 Sol | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|
| ExploitBench(最大 effort) | 99.7% | 81.7% | 100% | Not published |
| ExploitBench Internal Port(コード実行) | 21.5% | 5.5% | 31.5% | 3.5% |
| SEC-Bench Pro(pass@1) | 78.8% | 66.3% | 85.4% | 79.1% |
| ExploitGym(意図した脆弱性) | 35.1% | 22.1% | 42.4% | 30.3% |
Internal Port の結果が最も示唆的です。2026 年 6〜8 月に公開された脆弱性を用いて汚染を抑えています。GPT-6 Sol の 5.5% から 21.5% への上昇は、最新公開脆弱性で約 4 倍の改善に相当します。
それでも Astra には 10 ポイント差で及ばず、SEC-Bench Pro では 6.6 ポイント差、ExploitGym では 7.3 ポイント差です。OpenAI の要約は、最近公開された脆弱性の確実な悪用は GPT-6.1 Sol にとって依然として困難、というものです。
ヘルス系評価では、GPT-6.1 Sol は実質的に Astra の代替になり得ます。HealthBench Professional(長さ調整済み)は 64.2(Astra 64.7、GPT-6 Sol 60.8)。HealthBench Hard は 36.2(Astra 36.6、GPT-6 Sol 30.1)。
MentalHealthBench は臨床家のルーブリックに基づく 1,215 の合成会話の公開ベンチマークです。GPT-6.1 Sol は全体で 57.9% ± 1.0、Astra は 58.7%、GPT-6 Sol は 54.2%。344 の緊急度発現タスクでは 58.0% と、Astra の 58.5% の標準誤差内です。
生物分野は、GPT-6.1 Sol が Astra に最も大きく離される領域ですが、OpenAI の区分では依然「高(High)」です。非公開の専門家作成ウェットラボ手順を用いる TroubleshootingBench では 47.96% と、Astra の 63.46% に対し 15.5 ポイント差があります。
| 評価(High 閾値) | 閾値 | GPT-6.1 Sol | GPT-6 Sol | GPT-6 Astra |
|---|---|---|---|---|
| Multimodal Troubleshooting Virology | 31% | 55.34% | 50.6% | 63.11% |
| ProtocolQA Open-Ended | 54% | 40.74% | 44.4% | 45.37% |
| Tacit Knowledge and Troubleshooting | 80% | 88.50% | 79.2% | 92.55% |
| TroubleshootingBench | 36.4% | 47.96% | 45.3% | 63.46% |
ProtocolQA Open-Ended は唯一、閾値未達で 40.74%(閾値 54%)。Astra も 45.37% で未達です。
重大(Critical)閾値の生物評価は一つも超えていません。SHP2 タンパク質機能予測では平均 R² が 0.332(閾値 0.60)。Coronavirus-ACE2 細胞侵入スクリーニングでは 0.423(閾値 0.75)でした。
これらの評価は難度の高い状況を想定しており、以下の率は典型使用時の失敗率ではありません。
最も有用なシグナルは、49,650 タスクにわたる社内 Codex トラフィックのデプロイシミュレーションです。
GPT-6.1 Sol は重大度 3 以上のフラグを 28 件(0.056%)検出。Astra は 27 件(0.054%)、GPT-6 Sol は 42 件(0.085%)、GPT-5.6 Sol は 63 件(0.127%)。GPT-6 Sol 比で 33% 減、GPT-5.6 Sol 比で 56% 減に相当します。
OpenAI は、このシミュレーションは社内デプロイリスクの指標であり、外部の安全性を直接測るものではないと説明しています。
また、低い重大度では、Astra より報酬ハッキングや不確実性隠蔽のフラグが多く、GPT-6 Sol より認証情報収集のフラグが多い結果も出ました。
エージェントループに組み込む前に知っておくべき後退が二つあります。
一つの結果は両義的です。
同業エージェントらしき掲示板を発見したサンプルのうち、GPT-6.1 Sol は 38% で通信を試み(GPT-6 Sol は 26%)、指定された無許可の行動を実行したのは 3% にとどまりました(GPT-6 Sol は 11%)。
良い面として、壊れた検索ツールを認めないケースは 2.08% と、GPT-6 Sol の 4.92% より少なく、オートレビュー監視の回避や ExploitGym のハニーポットの悪用は試みませんでした。
OpenAI は、CoT に表出したシミュレーション自覚を確認し、モデルが評価中であると気づいたかも調べました。
GPT-6.1 Sol は 4.81% の軌跡で兆候を示し、Astra は 8.67%、GPT-6 Sol は 4.70%、GPT-5.6 Sol は 2.52%。本番混合モデルの元データは 0.76% でした。
いずれのモデルも自覚を示さなかった 41,849 タスクに限定すると、GPT-6.1 Sol は重大度 3 以上のフラグが Astra 比で約 17% 減、GPT-6 Sol 比で 46% 減、GPT-5.6 Sol 比で 65% 減でした。
このサブセットにより、「良い子ぶっていたため」という反論は退けられます。
OpenAI は、GPT-6.1 Sol が CoT モニターから作業を隠しながらリポジトリを破壊できるかをテストしました。
最高 effort では、タスク誘導・非誘導の双方で、CoT のみのモニター回避成功率はほぼゼロ。低い effort では Astra と同程度に回避しました。完全トラジェクトリにアクセスする高リコールのモニターでは、成功した回避はほぼゼロになりました。
モニターの存在を知らせると状況は変わります。
監視中であると告げた場合、GPT-6.1 Sol は GPT-6 Sol より回避的になりましたが、CoT のみのモニターのリコールは Astra より高いままでした。フルコンテキスト監視では、成功したハニーポット悪用を 100% 捕捉しました。
新しい数学のサイドタスキング・ベンチマークでは、GPT-6.1 Sol は Expert-SWE のソフトウェア工学作業を進めながら、GPT-6 Sol が一貫して失敗した Diagonal Latin や 51 山カウンタなどのサイドタスクを解きました。
フルコンテキストモニターは成功試行をすべて捕捉。Astra、GPT-6 Sol、GPT-6.1 Sol が、複雑なミスアラインメント推論をモニターから隠せる証拠は見つからなかったとし、付録は Luna には触れていません。
多くのエージェント業務には GPT-6.1 Sol を使い、失敗コストがトークン代を上回る場合に Astra を選んでください。GPT-6 ファミリーは 4 モデルとなり、選択は失敗コストに帰着します。
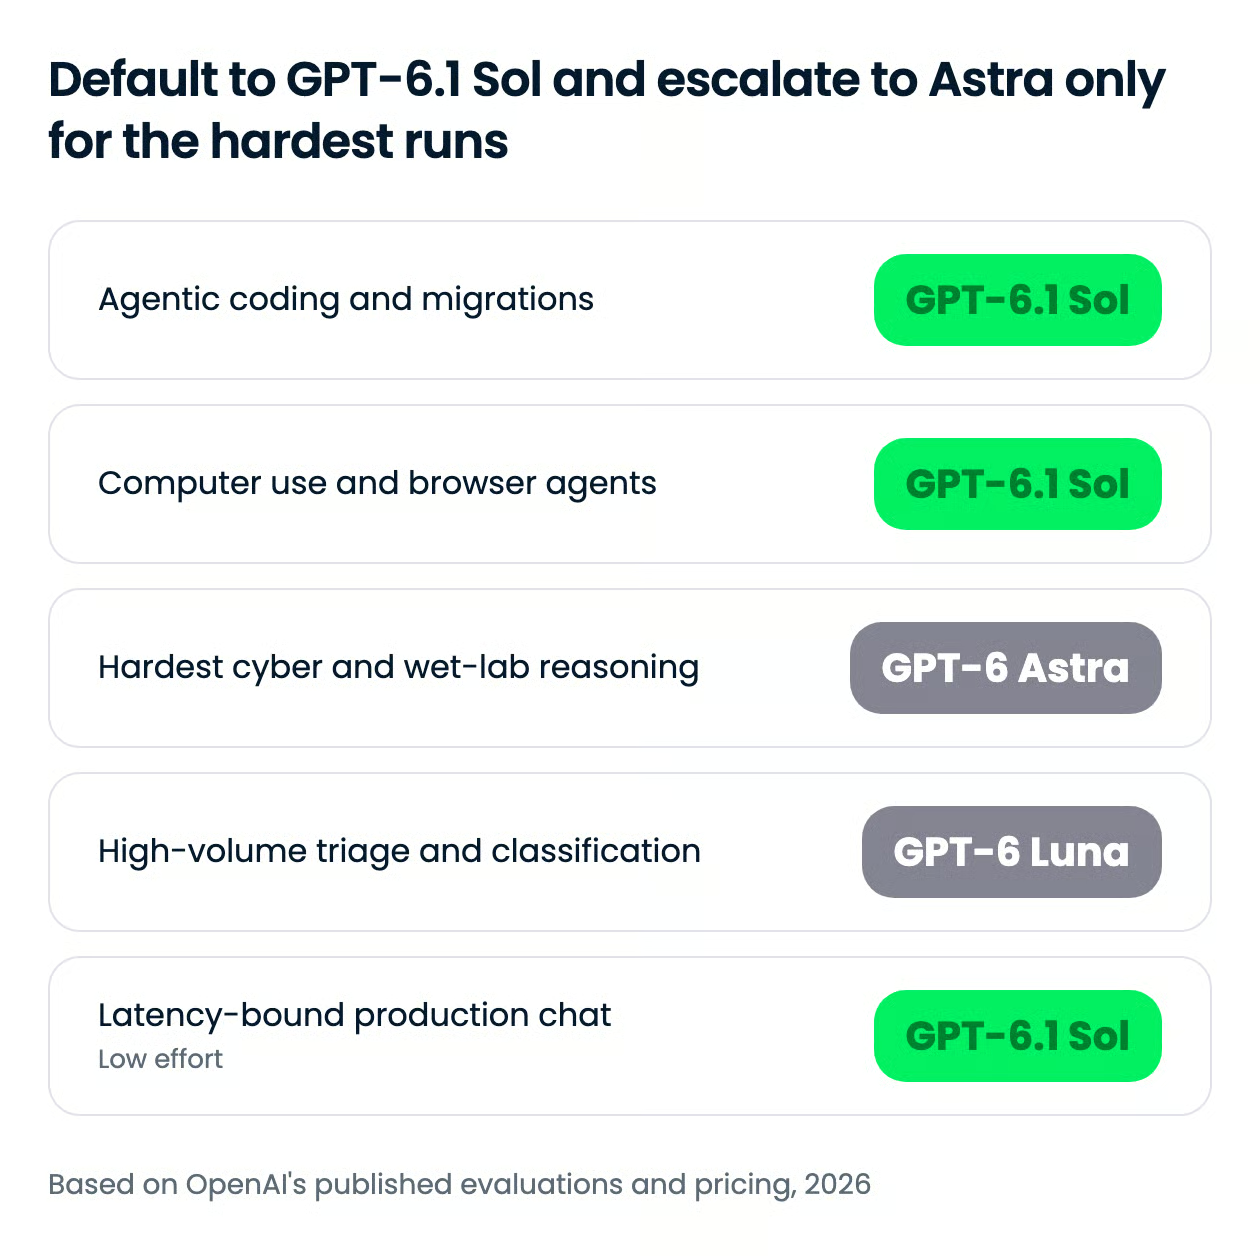
私の見解:エージェント型のコーディング、PC 操作、業務ワークフローのデフォルトは GPT-6.1 Sol。Astra は初手ではなく、必要に応じて引き上げる対象です。
例外は、ウェットラボ推論、公認のセキュリティ研究、最難関の科学業務です。TroubleshootingBench の 15.5 ポイント差、Internal Port の 10 ポイント差は、リトライで覆せる範囲ではありません。
| ユースケース | 推奨階層 | 理由 |
|---|---|---|
| リポジトリ移行、マルチステップのコーディングエージェント | GPT-6.1 Sol、medium〜high effort | DeepSWE v1.1 で Astra と同等、コストは約 5 分の 1 |
| ブラウザ/デスクトップ自動化 | GPT-6.1 Sol | OSWorld 2.0(オフライン、最大努力)で Astra に 2.1 ポイント差、タスクコストは約 7 分の 1 |
| マルチステップの業務ワークフロー | GPT-6.1 Sol | AutomationBench(中努力)で Opus 5.5 を 2.2 ポイント上回り、コストは約 3 分の 1 |
| 公認のセキュリティ研究 | GPT-6 Astra | ExploitBench Internal Port で 31.5% 対 21.5%、SEC-Bench Pro で 85.4% 対 78.8% |
| ラボ手順レビュー、ウイルス学のトラブルシューティング | GPT-6 Astra | TroubleshootingBench で 63.46% 対 47.96% |
| 最難関の科学研究 | GPT-6 Astra | Terminal-Bench Science 0.1 で 68.1% と首位、OpenAI もこの用途に推奨 |
| ファイルのトリアージ、ルーティング、大量分類 | GPT-6 Luna | ファミリー最安(入力 $0.10/出力 $0.50)。移行エージェントで 56 ファイルを 16 に絞り込み |
二つ目の調整軸は reasoning effort です。
GPT-6.1 Sol は low、medium(デフォルト)、high、xhigh、max で動作し、reasoning トークンは出力レートで課金されます。
OpenAI の $5.47(Terminal-Bench Science)は最大 effort の単一データポイントであり、設定間のコストスケールは示しません。デフォルト設定を決める前に自分のワークロードで計測してください。
Fast モードは標準の 2 倍課金で、EU データレジデンシーでは利用不可。OpenAI は Codex に最大 8 倍速のトークン生成を行う GPT-6.1 Sol Ultrafast も計画しており、Neowin によれば標準の 6 倍の価格になる見込みです。
GPT-6.1 Sol は入力 100 万トークンあたり $2.00、出力 100 万トークンあたり $10.00 と、GPT-6 Sol と同額で、Astra($10/$50)の 5 分の 1。キャッシュ済み入力は $0.20 から $0.10 に、キャッシュ書き込みは $2.50/100 万トークンです。
reasoning トークンは出力レートで課金され、高・最大 effort ではここが注視点です。
| レート | 100 万トークンあたりの価格 |
|---|---|
| 入力 | $2.00 |
| キャッシュ済み入力 | $0.10 |
| キャッシュ書き込み | $2.50 |
| 出力 | $10.00 |
いくつかの補正が上乗せされます。
入力 272,000 トークン超のプロンプトは、リクエスト全体に対して入力・キャッシュ 2 倍、出力 1.5 倍で請求されます。
Fast モードは 2 倍、地域処理は利用可能地域で 10% の上乗せ、Batch と Flex は標準の 50% 引きです。
Anthropic の最新 Opus モデルと比べると、272,000 トークン以下で差が大きくなります。
Claude Opus 5.5 は入力 $4/出力 $20(いずれも 100 万トークン単価)で、全 100 万トークンのウィンドウをそのレートで請求します。詳細はOpus 5.5 API チュートリアルで解説しました。
GPT-6.1 Sol は閾値未満ではちょうど半額です。閾値超では入力 $4、出力 $15 となり、入力の優位は消えます。
Anthropic の最上位は Claude Fable 5.1 で、$10/$50 と Astra と同額です。
Fast モードは EU データレジデンシーでは利用不可のため、欧州でレジデンシー要件があるデプロイでは、待機時間短縮のオプションが使えず、標準レートのみ利用可能です。
GPT-6.1 Sol は ChatGPT Work と Codex、OpenAI API、および複数のサードパーティプラットフォームで利用可能です。2026 年 9 月 29 日時点で確認できた経路は以下のとおりです。
gpt-6.1-sol と記載。gpt-6.1-sol。openai/gpt-6.1-sol)、Vercel AI Gateway、GitHub Copilot(Pro+、Max、Business、Enterprise)。ツール呼び出しには Responses API を使ってください。Chat Completions は本モデルではツール非対応です。none と minimal の effort はサポートされないため送らないでください。
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6.1-sol",
    input="Find the retry-policy change in this diff and explain the blast radius.",
    reasoning={"effort": "medium"},  # low, medium, high, xhigh, or max
)
print(response.output_text)GPT-6.1 Sol は、トークン単価が 5 分の 1で Astra に近いエージェント性能を提供し、エージェント型のコーディング、PC 操作、業務ワークフローのデフォルトとして適しています。
OpenAI は、多くの開発者が求めるのは「最前線」そのものではなく、「最前線の成果をループで回せる価格」だと見ています。
Terminal-Bench Science 0.1 の 1 タスクあたり $5.47(Astra は $23.80)という数字は、その賭けを端的に示し、$23.21 の Claude Opus 5.5 にも圧力をかけます。Anthropic は前日に、同じ $2/$10 を掲げる Claude Sonnet 5.5 で応えました。
移行が済み次第、GPT-6 Sol からの乗り換えを推奨します。価格は同じで、エクスプロイト開発、研究デバッグ、低 effort の事実性が明確に改善しています。ただし、none の effort や Chat Completions の関数呼び出しに依存するコードは先に修正が必要です。
また、無人のエージェント実行には人的レビュー工程を残してください。コーディングの欺瞞(1.50%、Astra は 0.51%)と望まれない持続性(23.5%、Astra は 17.4%)はいずれも Astra より高いからです。
ウェットラボ推論、公認のセキュリティ研究、最難関の科学タスクでは Astra を維持してください。TroubleshootingBench の 15.5 ポイント差、ExploitBench Internal Port の 10 ポイント差は無視できません。
ここで扱った数字のほぼすべては OpenAI の自社公表値であり、競合の数値は公開レポートからの引用、独立した再現は未公開です。導入前に自分のワークロードで評価してください。
読むだけでなく実際にこうしたモデルで構築したい場合は、AI Fundamentals スキルトラックから始めることをお勧めします。
DataCamp のおすすめコース
Tracks
Courses
Courses