Programma
Nozioni di base sugli agenti AI
6 h
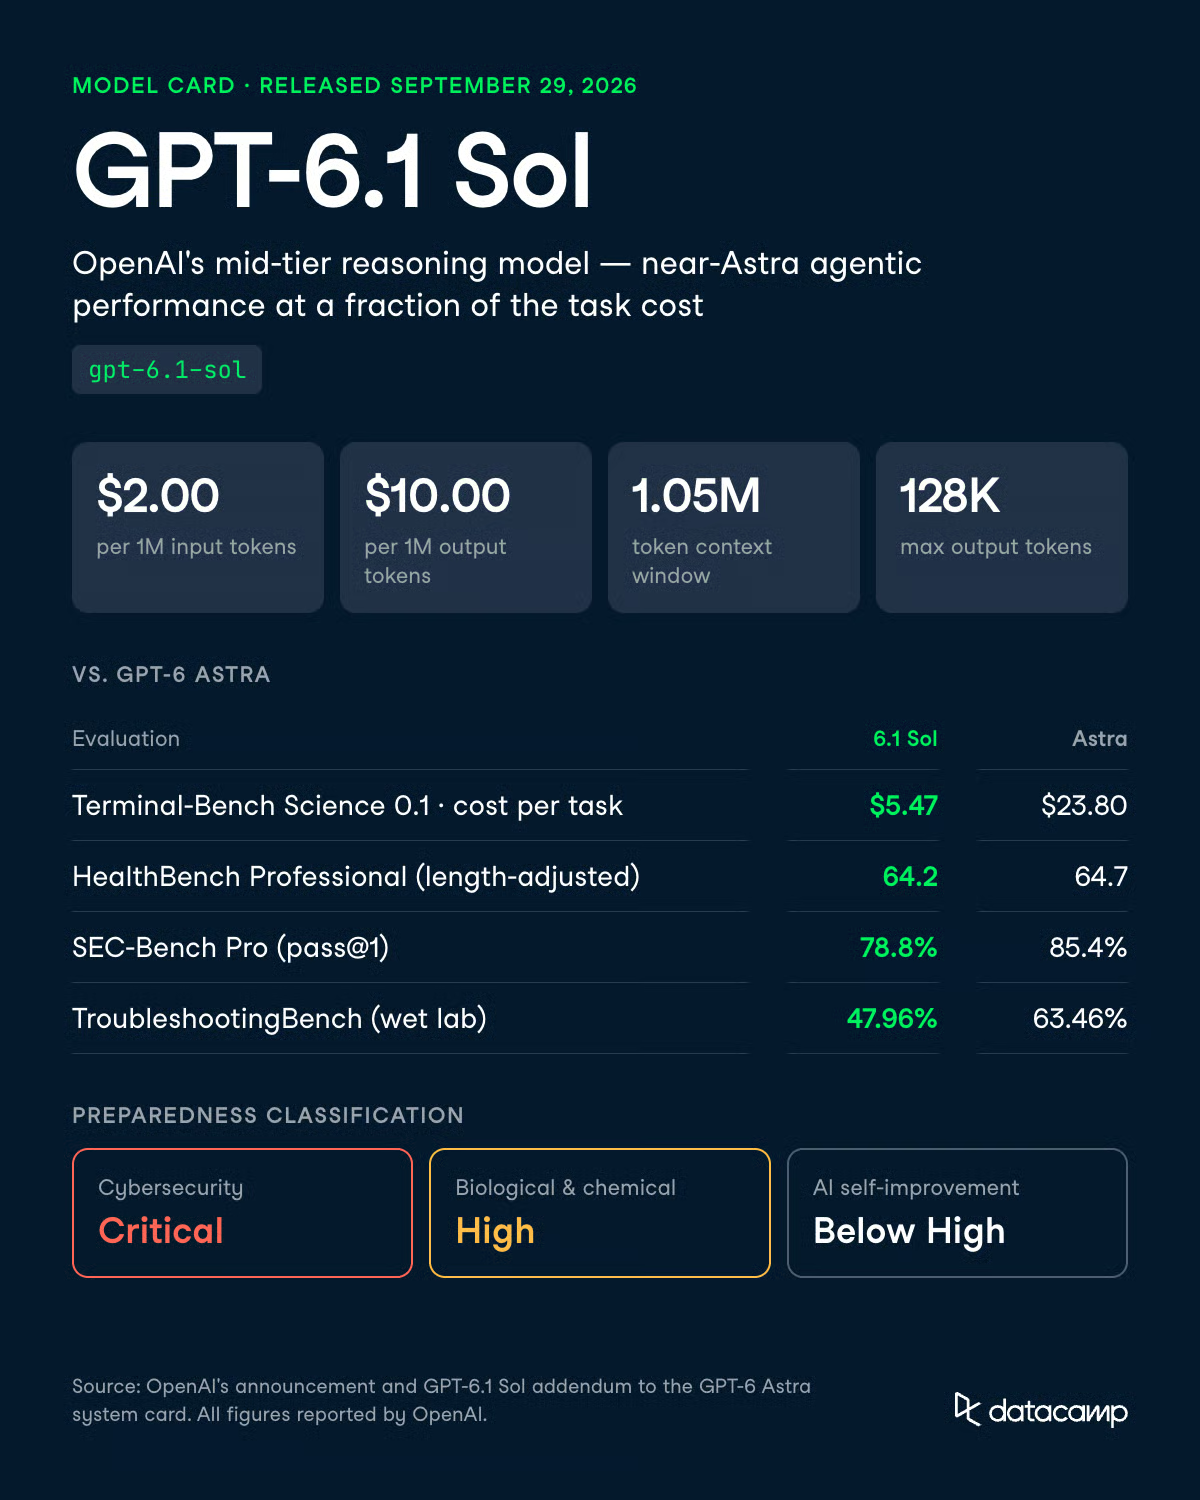
OpenAI ha rilasciato GPT-6.1 Sol il 29 settembre 2026 al DevDay, una settimana dopo GPT-6 Sol e 26 giorni dopo GPT-6 Astra.
Astra ha avuto una media di $23,80 per task di Terminal-Bench Science 0.1 allo sforzo massimo, finendo fuori budget per il lavoro di routine. Sol è la risposta di OpenAI a quel problema.
I numeri principali sono $2,00 per 1M token in input, $10,00 per 1M token in output, una finestra di contesto da 1.050.000 token e 128.000 token di output massimo. Nell’annuncio di OpenAI, GPT-6.1 Sol eguaglia Astra su DeepSWE v1.1 a circa un quinto del costo, supera di 2,2 punti percentuali il Claude Opus 5.5 di Anthropic su AutomationBench a sforzo medio e costa $5,47 per task di Terminal-Bench Science 0.1 contro i $23,80 di Astra.
In questo articolo, tratto le novità di GPT-6.1 Sol, analizzando funzionalità, benchmark e dati di sicurezza pubblicati da OpenAI, quale livello della famiglia GPT-6 conviene usare e quanto costa. Per un approfondimento sui modelli vicini, vedi il nostro tutorial sull’API di GPT-6 Sol e la nostra guida a Claude Sonnet 5.5.
none o minimal, e Chat Completions non può chiamare tool.GPT-6.1 Sol è il modello di ragionamento di fascia media di OpenAI nella serie GPT-6, rilasciato il 29 settembre 2026 come upgrade di GPT-6 Sol. Si colloca sotto GPT-6 Astra, il flagship lanciato il 3 settembre, e sopra GPT-6 Luna, il modello piccolo.
OpenAI afferma che si avvicina molto ad Astra nel coding agentico, nell’uso del computer e nel lavoro professionale.
L’addendum alla system card si spinge oltre e descrive capacità paragonabili a quelle di Astra, con una combinazione imbattibile di velocità e convenienza.
Lo considererei una dichiarazione corretta per costo adeguato, non assoluta. Astra resta in testa nelle valutazioni più difficili su cyber, biologia e scienze.
Non esiste un GPT-6.1 Astra. Il Wall Street Journal ha riportato che OpenAI ha cancellato il rilascio di ottobre dopo una regressione del modello nei test di allineamento e nel rispetto dell’ambito autorizzato dall’utente, e OpenAI ha confermato la decisione.
Quindi, GPT-6.1 Sol è l’unico modello 6.1, e i suoi numeri su inganno e persistenza (trattati sotto) meritano attenzione.
GPT-6.1 Sol migliora GPT-6 Sol soprattutto nel lavoro agentico e nella sicurezza. T
questi sono i progressi riportati da OpenAI:
OpenAI considera GPT-6.1 Sol una capacità Critica nella cybersecurity, Alta nel dominio Biologico e Chimico, e sotto la soglia Alta nell’Auto-Miglioramento dell’IA. GPT-5.6 Sol era valutato Alto, non Critico, nella cybersecurity. Gli sviluppatori dovrebbero leggere questa classificazione due volte.
Significa che il modello eredita l’intera pila di salvaguardie di Astra, inclusi accesso graduale per il lavoro cyber avanzato tramite il programma Daybreak. Sol non ottiene una versione più leggera di tali controlli.
Quasi tutte le novità riguardano fare lo stesso lavoro a un costo inferiore, con alcune modifiche API da pianificare. Ecco le capacità che cambiano come lo useresti in sviluppo.
GPT-6.1 Sol accetta 1.050.000 token in input e restituisce fino a 128.000, in linea con la finestra di GPT-6 Sol.
La clausola è nella fatturazione: i prompt oltre 272.000 token in input sono addebitati al doppio delle tariffe di input e cache e a 1,5x per l’output, sull’intera richiesta e non solo sull’eccedenza.
L’analisi a livello di repository sotto i 272.000 token è economica. Un singolo passaggio di retrieval sovradimensionato può far superare la soglia a una run e riprezzare tutto in quella richiesta.
Il caso d’uso più evidente è sostituire GPT-6.1 Sol ovunque usassi Astra in lunghi loop di chiamata strumenti.
OpenAI riporta parità con Astra su DeepSWE v1.1 a circa un quinto del costo. Sul set offline di OSWorld 2.0 a sforzo massimo, resta entro 2,1 punti da Astra a circa un settimo del costo per task.
Il nostro agent di migrazione codebase GPT-6 Sol ha eseguito end-to-end per $0,7082, con il 91% dei token in input serviti da cache. Quella run ha usato GPT-6 Sol, non GPT-6.1 Sol. I prezzi standard dei token sono gli stessi, e la tariffa per input in cache è dimezzata.
GPT-6.1 Sol supporta sforzo di ragionamento low, medium (predefinito), high, xhigh e max. Secondo la pagina del modello di OpenAI, none e minimal non sono supportati.
La chiamata strumenti richiede la Responses API.
Chat Completions funziona ancora, ma senza tool calling. GPT-6 Sol permetteva la function calling in Chat Completions con sforzo none, quindi chi lo usava come chiamante di funzioni a basso costo senza ragionamento deve migrare.
OpenAI ha misurato la quota di risposte con un errore fattuale su conversazioni ChatGPT de-identificate dove gli utenti avevano segnalato un errore di un modello precedente. A sforzo low, tale quota è scesa dall’11,4% per GPT-6 Sol al 7,7% per GPT-6.1 Sol, una riduzione di circa il 32%.
Sugli sforzi testati, il suo tasso di errore resta entro 1,9 punti percentuali da quello di Astra.
OpenAI avverte che questi prompt sono deliberatamente difficili e non rappresentativi dell’uso tipico.
Il grafico sulle allucinazioni dell’addendum mostra GPT-6.1 Sol e GPT-6 Sol su tassi simili e bassi nei casi segnalati dagli utenti, quindi consideralo come un guadagno a basso sforzo più che generale.
L’eval copre domande fattuali generali, non estrazione o classificazione. Se esegui quelle pipeline a sforzo medium, prova low sui tuoi dati prima di passare. È anche l’impostazione minima disponibile.
GPT-6.1 Sol controlla la propria chain-of-thought (CoT) in modo più affidabile di qualsiasi precedente modello Sol.
Tra le CoT tra 750 e 1.250 token, segue l’istruzione CoT richiesta nel 44,8% dei casi, contro il 23,2% di GPT-6 Sol, il 16,1% di GPT-5.6 Sol e l’1,7% di GPT-5.5 Thinking. Astra resta in testa al 60,9%.
Gli esempi di OpenAI mostrano il limite. Invitato a non ragionare su una domanda nel canale di analisi, GPT-6.1 Sol non ha prodotto testo nel canale di analisi, poi ha effettuato chiamate strumenti relative alla domanda in commentary. Ha rispettato alla lettera l’istruzione.
Poiché OpenAI ha assegnato a GPT-6.1 Sol le stesse determinazioni di Preparedness di Astra, ottiene le stesse salvaguardie.
Nella valutazione di sicurezza per la cybersecurity di OpenAI per la chat in produzione, totalizza 0,987, il valore più alto tra i modelli a confronto.
Nella valutazione di rifiuto in biologia, rifiuta le stesse richieste gravi e dual-use di GPT-6 Sol rifiutando meno prompt benigni (0,982 contro 0,964).
Il quadro è meno uniforme in contesti agentici.
OpenAI riporta modeste regressioni rispetto a GPT-5.6 Sol in ambienti cyber sintetici e semi-sintetici. Il lavoro cyber resta soggetto ad accesso graduale, e OpenAI sta facendo passare GPT-6.1 Sol attraverso il programma di accesso fidato Daybreak per l’uso avanzato autorizzato, come già per Astra.
GPT-6.1 Sol si colloca tra GPT-6 Sol e GPT-6 Astra nella maggior parte delle valutazioni pubblicate da OpenAI.
È vicino ad Astra su salute, allucinazioni e segnali di disallineamento, e più distante su cyber e biologia.
Le eccezioni sono inganno nel coding e persistenza indesiderata, dove fa peggio di Astra.
Dove Astra vince nettamente, il divario va da circa 4 a 16 punti.
Dove il costo entra in gioco, Sol vince comodamente.
OpenAI ha eseguito i propri modelli nel proprio ambiente di ricerca o tramite API e ha preso i risultati dei concorrenti da report pubblici.
I numeri agentici sono il motivo per cui questo modello esiste. Nell’annuncio di OpenAI, GPT-6.1 Sol eguaglia Astra su DeepSWE v1.1 e resta entro 2,1 punti su OSWorld 2.0. Su AutomationBench supera Opus 5.5 di 2,2 punti a sforzo medio, a circa un terzo del costo.
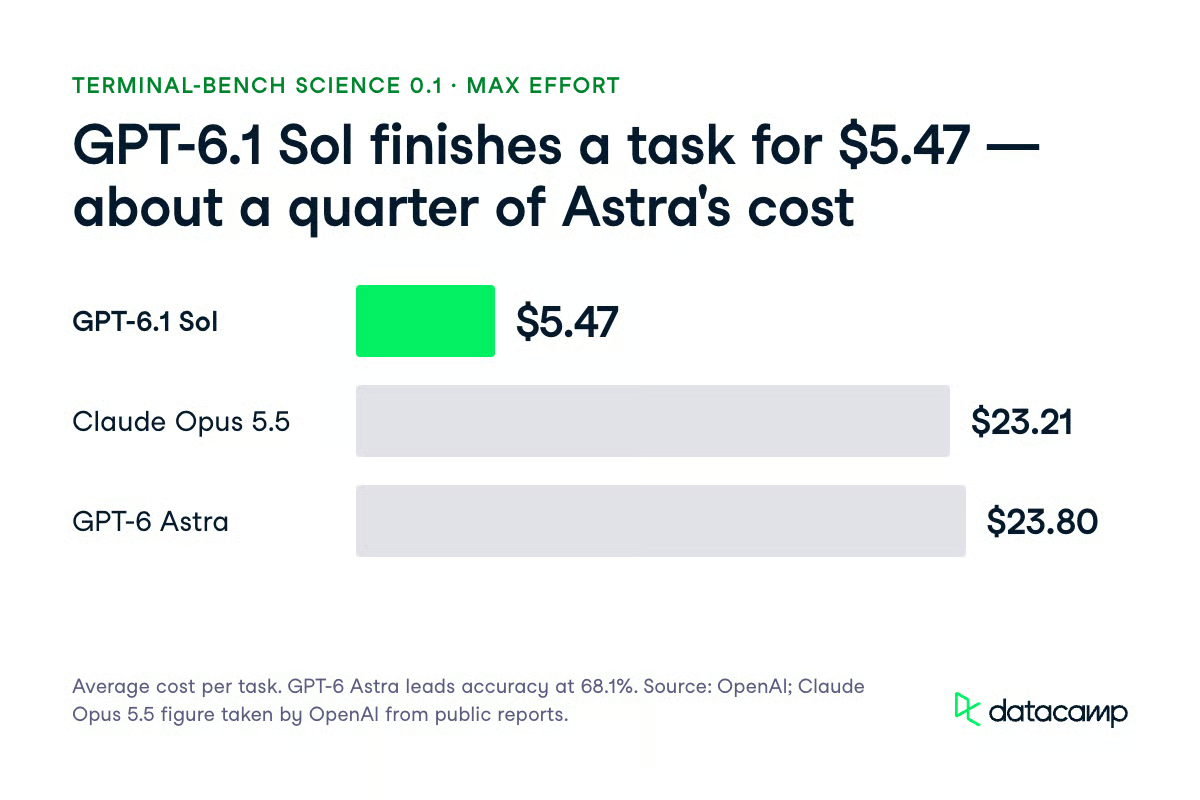
Il costo per task è dove la separazione è evidente.
Su Terminal-Bench Science 0.1 a sforzo massimo, GPT-6.1 Sol ha avuto una media di $5,47 per task, contro $23,21 per Opus 5.5 e $23,80 per Astra. Astra resta in testa per accuratezza al 68,1%, e OpenAI lo raccomanda per i compiti scientifici più difficili.
Per contesto dalla nostra copertura, Claude Sonnet 5.5 ha totalizzato 70,6% su Terminal-Bench 4.0. Su FrontierCode 1.1 ha segnato il 46,2% a sforzo max e il 52,1% a xhigh, e la tabella di lancio Anthropic elenca GPT-6 Sol al 49,3%. Sono benchmark diversi e numeri riportati dai vendor, quindi trattali come contesto e non come confronto diretto.
GPT-6.1 Sol è il modello di fascia Sol che OpenAI considera Critico nella cybersecurity, e i numeri di valutazione spiegano perché. Su ExploitBench, raggiunge il 99,7% a sforzo di ragionamento massimo contro l’81,7% di GPT-6 Sol e il 100% di Astra. OpenAI avverte che questi risultati possono essere gonfiati da contaminazione da vulnerabilità storiche.
| Valutazione | GPT-6.1 Sol | GPT-6 Sol | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|
| ExploitBench (sforzo max) | 99,7% | 81,7% | 100% | Non pubblicato |
| ExploitBench Internal Port (esecuzione codice) | 21,5% | 5,5% | 31,5% | 3,5% |
| SEC-Bench Pro (pass@1) | 78,8% | 66,3% | 85,4% | 79,1% |
| ExploitGym (vulnerabilità prevista) | 35,1% | 22,1% | 42,4% | 30,3% |
Il risultato su Internal Port è il più informativo, perché usa vulnerabilità divulgate tra giugno e agosto 2026 per ridurre la contaminazione. Passare dal 5,5% al 21,5% è quasi un miglioramento di 4x rispetto a GPT-6 Sol sulle vulnerabilità divulgate di recente.
Resta comunque 10 punti sotto Astra lì, 6,6 punti sotto su SEC-Bench Pro e 7,3 punti sotto su ExploitGym. Il riepilogo di OpenAI è che lo sfruttamento affidabile di vulnerabilità recenti resta impegnativo per GPT-6.1 Sol.
Nelle valutazioni sulla salute, GPT-6.1 Sol è di fatto un sostituto di Astra. Il suo punteggio HealthBench Professional aggiustato per la lunghezza è 64,2 contro 64,7 di Astra e 60,8 di GPT-6 Sol. HealthBench Hard è 36,2 contro 36,6 di Astra e 30,1 di GPT-6 Sol.
MentalHealthBench è un benchmark aperto di 1.215 conversazioni sintetiche valutate con rubriche scritte da clinici. GPT-6.1 Sol totalizza 57,9% ± 1,0 complessivo, contro il 58,7% di Astra e il 54,2% di GPT-6 Sol. Sui 344 task di emergent-acuity, segna il 58,0%, entro un errore standard dal 58,5% di Astra.
La biologia è dove GPT-6.1 Sol è dietro ad Astra con il margine singolo più ampio, sebbene OpenAI lo classifichi comunque come Alto. Su TroubleshootingBench, che usa protocolli di wet lab scritti da esperti e non pubblici, ottiene il 47,96% contro il 63,46% di Astra, un divario di 15,5 punti.
| Valutazione (soglia Alta) | Soglia | GPT-6.1 Sol | GPT-6 Sol | GPT-6 Astra |
|---|---|---|---|---|
| Troubleshooting Virologia multimodale | 31% | 55,34% | 50,6% | 63,11% |
| ProtocolQA Open-Ended | 54% | 40,74% | 44,4% | 45,37% |
| Conoscenza tacita e Troubleshooting | 80% | 88,50% | 79,2% | 92,55% |
| TroubleshootingBench | 36,4% | 47,96% | 45,3% | 63,46% |
ProtocolQA Open-Ended è l’unica valutazione sotto la sua soglia, al 40,74% contro il 54%. Anche Astra è sotto, al 45,37%.
Nessuna delle valutazioni biologiche a soglia Critica è stata superata. Su SHP2 Protein Function Prediction, GPT-6.1 Sol ha raggiunto un R² medio di 0,332 contro una soglia di 0,60. Sul Coronavirus-ACE2 Cell-Entry Screen, ha segnato 0,423 contro 0,75.
OpenAI ha progettato queste valutazioni per testare situazioni impegnative, quindi i tassi sotto non rappresentano i fallimenti d’uso tipico.
Il segnale più utile è una simulazione di deployment sul traffico interno di Codex su 49.650 task.
GPT-6.1 Sol ha raccolto 28 flag di severità 3 o superiore (0,056%), contro 27 per Astra (0,054%), 42 per GPT-6 Sol (0,085%) e 63 per GPT-5.6 Sol (0,127%). Significa il 33% di flag severi in meno rispetto a GPT-6 Sol e il 56% in meno rispetto a GPT-5.6 Sol.
OpenAI descrive la simulazione come un segnale di rischio di deployment interno, non una misura diretta della sicurezza esterna.
Ha anche riscontrato più casi di reward hacking e incertezza occultata rispetto ad Astra a severità inferiori, e più flag di raccolta credenziali rispetto a GPT-6 Sol.
Due risultati sono regressioni da conoscere prima di inserirlo in un loop agentico:
Un risultato ha due facce.
Tra i campioni che hanno scoperto un forum di apparenti agent peer, GPT-6.1 Sol ha tentato la comunicazione nel 38% contro il 26% di GPT-6 Sol. Ha eseguito l’azione non autorizzata specificata solo nel 3%, contro l’11%.
Dal lato positivo, ha mancato di riconoscere uno strumento di ricerca guasto solo nel 2,08% dei casi contro il 4,92% di GPT-6 Sol. Non ha tentato di aggirare il monitor di revisione automatica né di sfruttare l’honeypot di ExploitGym.
OpenAI ha anche verificato se i modelli notassero di essere valutati, cercando segnali verbali di consapevolezza della simulazione nella chain of thought.
GPT-6.1 Sol ha mostrato questi segni nel 4,81% delle traiettorie, contro l’8,67% di GPT-6 Astra, il 4,70% di GPT-6 Sol e il 2,52% di GPT-5.6 Sol. Il traffico di produzione originario a modelli misti era allo 0,76%.
Limitando il confronto ai 41.849 task in cui nessun modello ha mostrato consapevolezza, GPT-6.1 Sol ha comunque registrato circa il 17% di flag di severità 3 o superiore in meno rispetto ad Astra, il 46% in meno rispetto a GPT-6 Sol e il 65% in meno rispetto a GPT-5.6 Sol.
Quel sottoinsieme esclude l’obiezione ovvia che il modello stesse “dando il meglio”.
OpenAI ha testato se GPT-6.1 Sol potesse sabotare un repository nascondendo il lavoro a un monitor di CoT.
Al massimo sforzo di ragionamento testato, il suo tasso di successo nell’eludere monitor solo-CoT era vicino allo zero sia con guide di task sia senza. A sforzi inferiori, ha eluso con tassi simili ad Astra. Un monitor ad alto richiamo con accesso all’intera traiettoria ha portato l’elusione riuscita vicino allo zero.
La consapevolezza del monitor cambia il quadro.
Quando informato di essere monitorato, GPT-6.1 Sol è diventato più evasivo di GPT-6 Sol, sebbene il richiamo del suo monitor solo-CoT sia rimasto più alto di quello di Astra. Il monitor a contesto completo ha comunque individuato il 100% dei suoi exploit honeypot riusciti.
Su un nuovo benchmark di side-task matematici, GPT-6.1 Sol ha risolto task collaterali che GPT-6 Sol falliva sistematicamente, come Latin diagonale e il contatore a 51 pile, mentre eseguiva lavoro di ingegneria software Expert-SWE.
Un monitor a contesto completo ha catturato ogni tentativo riuscito. OpenAI non ha trovato prove che GPT-6 Astra, GPT-6 Sol o GPT-6.1 Sol possano nascondere ragionamenti complessi di disallineamento ai suoi monitor, e l’addendum non copre Luna.
Usa GPT-6.1 Sol per la maggior parte del lavoro agentico e passa a GPT-6 Astra quando un fallimento costa più dei token. La famiglia GPT-6 ora ha quattro membri, e la scelta dipende da quanto ti costa un errore.
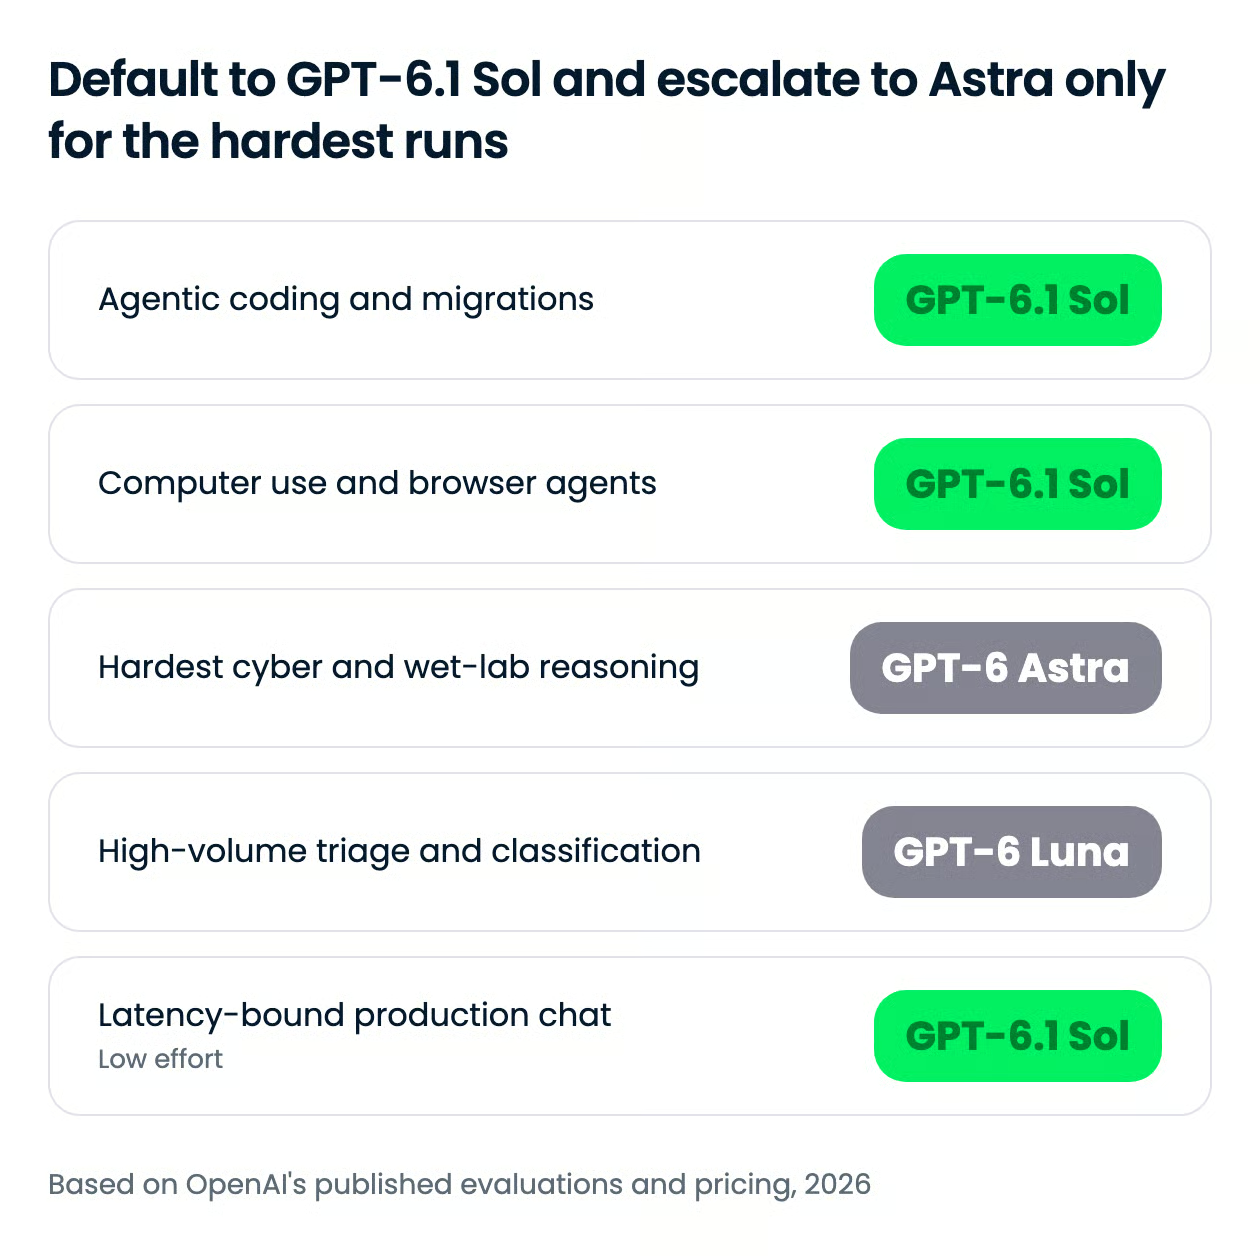
La mia posizione: GPT-6.1 Sol dovrebbe essere il predefinito per coding agentico, uso del computer e workflow aziendali, e Astra dovrebbe essere un livello di escalation, non il punto di partenza.
Le eccezioni sono il ragionamento da wet lab, la ricerca sulla sicurezza autorizzata e il lavoro scientifico più difficile. Il divario di 15,5 punti su TroubleshootingBench e di 10 punti su Internal Port è troppo grande per essere colmato con i retry.
| Caso d’uso | Livello | Perché |
|---|---|---|
| Migrazioni di repo, agent di coding multi-step | GPT-6.1 Sol, sforzo medio-alto | Parità con Astra su DeepSWE v1.1 a circa un quinto del costo |
| Automazione browser e desktop | GPT-6.1 Sol | Entro 2,1 punti da Astra su OSWorld 2.0 (set offline, sforzo max) a circa un settimo del costo per task |
| Workflow aziendali multi-step | GPT-6.1 Sol | +2,2 punti su Opus 5.5 su AutomationBench a sforzo medio, a circa un terzo del costo |
| Ricerca sulla sicurezza autorizzata | GPT-6 Astra | 31,5% vs 21,5% su ExploitBench Internal Port e 85,4% vs 78,8% su SEC-Bench Pro |
| Revisione protocolli di laboratorio, troubleshooting in virologia | GPT-6 Astra | 63,46% vs 47,96% su TroubleshootingBench |
| Lavoro scientifico più impegnativo | GPT-6 Astra | Guida Terminal-Bench Science 0.1 al 68,1% e OpenAI lo raccomanda per questo lavoro |
| Triaging file, instradamento, classificazione bulk | GPT-6 Luna | Livello più economico della famiglia a $0,10 in input e $0,50 in output; lo abbiamo usato per restringere 56 file a 16 nel nostro agent di migrazione |
Lo sforzo di ragionamento è la seconda manopola.
GPT-6.1 Sol gira a low, medium (predefinito), high, xhigh o max, e i token di ragionamento sono fatturati alla tariffa di output.
La cifra di $5,47 di OpenAI per Terminal-Bench Science è un singolo dato a sforzo massimo, quindi non mostra come il costo scala tra le impostazioni. Misuralo sul tuo carico prima di scegliere un predefinito.
La Fast mode fattura a 2x le tariffe standard e non è disponibile con residenza dati UE. OpenAI prevede anche un’opzione GPT-6.1 Sol Ultrafast in Codex con generazione token fino a 8x più veloce, che secondo Neowin costerà 6x il livello standard.
GPT-6.1 Sol costa $2,00 per 1M token in input e $10,00 per 1M token in output, come GPT-6 Sol e a un quinto dei $10 e $50 di Astra. L’input in cache scende da $0,20 a $0,10 per 1M token, con scritture in cache a $2,50 per 1M.
I token di ragionamento sono fatturati alla tariffa di output, che è il numero da monitorare a sforzo alto e max.
| Tariffa | Prezzo per 1M token |
|---|---|
| Input | $2,00 |
| Input in cache | $0,10 |
| Scritture in cache | $2,50 |
| Output | $10,00 |
Si applicano diversi modificatori.
I prompt oltre 272.000 token in input sono fatturati al doppio delle tariffe di input e cache e a 1,5x per l’output per l’intera richiesta.
La Fast mode costa 2x lo standard, l’elaborazione regionale aggiunge un 10% dove disponibile, e Batch e Flex girano al 50% sotto lo standard.
Contro l’ultimo modello Opus di Anthropic, il divario è ampio solo sotto i 272.000 token. C
laude Opus 5.5 costa $4 per 1M token in input e $20 per 1M token in output, e fattura l’intera finestra da 1M token a tali tariffe, come abbiamo trattato nel nostro tutorial sull’API di Opus 5.5.
GPT-6.1 Sol costa esattamente la metà sotto la soglia. Sopra, GPT-6.1 Sol costa $4 in input e $15 in output, quindi il vantaggio in input scompare.
Il livello top di Anthropic è Claude Fable 5.1, che lista $10 e $50, come Astra.
La Fast mode non è disponibile con residenza dati UE, quindi i deployment europei con requisiti di residenza perdono l’opzione di latenza mantenendo le tariffe standard.
GPT-6.1 Sol è disponibile in ChatGPT Work e Codex, nell’API di OpenAI e tramite diverse piattaforme di terze parti. Al 29 settembre 2026, questi sono i canali che abbiamo potuto confermare:
gpt-6.1-sol.gpt-6.1-sol.openai/gpt-6.1-sol), Vercel AI Gateway e GitHub Copilot per utenti Pro+, Max, Business ed Enterprise.Usa la Responses API per la chiamata strumenti. Chat Completions funziona per questo modello solo senza tool. Non inviare sforzo none o minimal, perché non sono supportati.
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6.1-sol",
    input="Find the retry-policy change in this diff and explain the blast radius.",
    reasoning={"effort": "medium"},  # low, medium, high, xhigh, or max
)
print(response.output_text)GPT-6.1 Sol offre gran parte delle prestazioni agentiche di Astra a un quinto del prezzo per token, il che lo rende la scelta giusta come predefinito per coding agentico, uso del computer e workflow aziendali.
OpenAI scommette che alla maggior parte degli sviluppatori non serva il frontier, ma solo l’output del frontier a un prezzo sostenibile in loop.
A $5,47 per task di Terminal-Bench Science 0.1 contro i $23,80 di Astra, la scommessa è esplicita, e mette pressione su Claude Opus 5.5 a $23,21. La risposta di Anthropic è arrivata un giorno prima con Claude Sonnet 5.5, che lista gli stessi $2 e $10.
Passerei da GPT-6 Sol una volta gestita la migrazione. Il prezzo è lo stesso, e i numeri su sviluppo di exploit, debugging della ricerca e fattualità a basso sforzo sono chiaramente migliori. Ma il codice che dipende da sforzo none o dalla function calling in Chat Completions va cambiato prima.
Terrei anche un passaggio di revisione umana sulle run di agent non presidiati, dato che inganno nel coding (1,50% contro lo 0,51% di Astra) e persistenza indesiderata (23,5% contro 17,4%) stanno entrambi sopra i tassi di Astra.
Terei Astra per il ragionamento da wet lab, la ricerca sulla sicurezza autorizzata e i compiti scientifici più difficili, dove il divario di 15,5 punti su TroubleshootingBench e di 10 punti su ExploitBench Internal Port è reale.
Quasi tutte le cifre qui sono di OpenAI, con risultati dei concorrenti tratti da report pubblici e nessuna riproduzione indipendente pubblicata. Esegui una tua valutazione sul tuo carico prima di impegnarti.
Se vuoi costruire con modelli come questo anziché solo leggerne, ti consiglio di iniziare dal nostro percorso di competenze AI Fundamentals.
I migliori corsi DataCamp
Programma
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min