
Last chance! 50% off DataCamp Premium
Sale ends in
OpenAI a folosit DevDay pe 29 septembrie pentru a lansa GPT-6.1 Sol, un upgrade al modelului său din gama medie, despre care spune că se apropie de vârful de gamă GPT-6 Astra la o cincime din prețul pe token al lui Astra. Cu o săptămână mai devreme, Anthropic a lansat Claude Opus 5.5, prezentat ca performanță de nivel Fable 5.1 pentru cu 40% mai puțin.
Ambele sunt mișcări pentru eficiență, iar postarea de lansare a OpenAI îl menționează direct pe Opus 5.5, revendicând avantaje la fluxuri de lucru de business și lucru pe documente, la o fracțiune din costul per task. Totuși, graficele OpenAI spun o poveste mai interesantă decât titlul, pentru că comparația se schimbă în funcție de setarea de efort pe care o citești.
În articolul de față, comparăm GPT-6.1 Sol cu Opus 5.5 în principal pentru că postarea de lansare a OpenAI face această potrivire direct, dar Claude Sonnet 5.5 este o altă comparație corectă, pe care o acoperim în articolul nostru GPT-6.1 Sol vs Claude Sonnet 5.5.
GPT-6.1 Sol este modelul de raționare din gama medie al OpenAI din familia GPT-6, lansat pe 29 septembrie 2026 ca upgrade la GPT-6 Sol.
Punctul său forte: rezultate aproape de Astra la programare, utilizarea computerului și muncă profesională la un preț mult mai mic, cu input în cache mai ieftin, gândit pentru agenți care refolosesc contextul între cereri.
Ghidul nostru GPT-6.1 Sol acoperă lansarea; tutorialul API pentru GPT-6 Sol construiește un agent de migrare a codebase-ului pe versiunea anterioară.
Claude Opus 5.5 este modelul de vârf al liniei Opus de la Anthropic, lansat ca primul model din familia Claude 5.5.
Anthropic îl poziționează pentru sesiuni lungi de programare agentică și lucru cu cunoștințe, egalând Claude Fable 5.1 la majoritatea taskurilor la un cost mai mic, cu gândire adaptivă mereu activată.
Ghidul nostru Claude Opus 5.5 acoperă lansarea; tutorialul Opus 5.5 API construiește un investigator AI pentru incidente.
GPT-6.1 Sol și Opus 5.5 se suprapun pe doar trei benchmark-uri publicate, toate din graficele de lansare ale OpenAI. Opus 5.5 obține cel mai mare scor maxim pe două dintre ele, iar GPT-6.1 Sol ajunge la rezultate pentru de 2x până la 5x mai puțin per task pe toate trei.
| Feature | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| AutomationBench (cel mai bun scor, cost per task) | 36,1% la maxim, 0,30 $ | 42,5% la maxim, 1,44 $ |
| GDP.pdf (cel mai bun scor, cost per task) | 32,0% la high, 0,35 $ | 28,8% la high, 0,83 $ |
| Terminal-Bench Science 0.1 (efort maxim) | 57,0%, 5,47 $ | 63,3%, 23,21 $ |
| DeepSWE v1.1 | 75,2% la high | Nepublicat |
| Terminal-Bench 4.0 | Nepublicat | 66,4% la maxim |
| Utilizare computer | 71,4% pe OSWorld 2.0 offline (max) | 81,8% pe OSWorld 2.1 |
| Fereastră de context / output maxim | 1,05M / 128K | 1M / 128K |
| Knowledge cutoff | Aprilie 2026 | Iunie 2026 |
| Nivele de efort | low, medium (implicit), high, xhigh, max | low, medium (implicit), high, xhigh, max |
Primele trei rânduri vin din graficele OpenAI, care etichetează rezultatele Claude „Opus 5.5 w/ fallbacks”. Restul sunt rapoarte ale fiecărui vendor despre propriul model.
Aici a ales OpenAI confruntarea, și aici setarea de efort decide câștigătorul.
Titlul OpenAI spune că GPT-6.1 Sol obține cu 2,2 puncte peste Opus 5.5 pe AutomationBench, testul Zapier pentru agenți care finalizează fluxuri de lucru multi-step în zeci de instrumente de business. Asta e adevărat la efort mediu, unde GPT-6.1 Sol marchează 31,7% la 0,19 $ per task față de 29,5% la 0,65 $ pentru Opus 5.5.
Dă-le ambelor setarea pe maxim și ordinea se inversează. Opus 5.5 urcă la 42,5%, peste chiar GPT-6 Astra, în timp ce GPT-6.1 Sol se oprește la 36,1%. Opus 5.5 plătește pentru asta cu aproape 5x cost per task, așa că întrebarea este dacă șase puncte de succes pe fluxul de lucru merită pentru agentul tău. Pentru un bot de suport care procesează mii de tichete, probabil nu. Pentru un flux financiar unde un eșec înseamnă că un om reia totul, poate.
GPT-6.1 Sol oferă cel mai bun raport valoare/preț pentru lucru pe documente și automatizări de zi cu zi. Opus 5.5 este alegerea când cele mai grele rulari trebuie să reușească.
Nu există un benchmark comun pentru programare, așa că cifra fiecărui vendor stă singură în tabel. OpenAI spune că GPT-6.1 Sol se potrivește cu GPT-6 Astra pe DeepSWE v1.1, care testează inginerie pe orizont lung în codebase-uri reale, în timp ce Anthropic raportează că Opus 5.5 conduce GPT-6 Astra pe Terminal-Bench 4.0 și FrontierCode.
În testul nostru practic anterior, GPT-6 Sol, versiunea anterioară, l-a depășit pe Opus 5.5 într-un build de Tetris la sub o treime din costul rularii (vezi comparația GPT-6 Sol vs Claude Opus 5.5), deci bănuim că GPT-6.1 Sol iese câștigător.
Deocamdată, modelele nu pot fi comparate aici. OpenAI raportează GPT-6.1 Sol pe setul offline OSWorld 2.0, la 2,1 puncte de GPT-6 Astra, în timp ce Anthropic raportează Opus 5.5 pe OSWorld 2.1, o versiune mai nouă cu taskuri diferite. Niciun vendor nu a publicat versiunea celuilalt, așa că cifrele din tabelul rezumat nu sunt o confruntare directă. Consideră „utilizarea computerului” deschisă până când cineva le rulează pe ambele pe același set.
În practică, Opus 5.5 este modelul mai restrictiv. Anthropic redirecționează majoritatea taskurilor de securitate cibernetică către Opus 4.8, cu excepția cazului în care ești în Cyber Verification Program, iar lucrul pe biologie trece prin fallback-uri similare. De aceea graficele OpenAI etichetează rezultatele Claude „cu fallback-uri”.
Constrângerile lui GPT-6.1 Sol țin mai mult de API. Nu are setări de efort none sau minimal, iar apelarea de unelte funcționează doar prin Responses API, nu Chat Completions. Opus 5.5 păstrează gândirea adaptivă mereu pornită și respinge forțarea folosirii uneltelor. Pentru echipele de securitate, rutarea din Opus 5.5 este diferența practică mai mare; pentru dezvoltatorii care migrează cod, sunt schimbările de API ale lui GPT-6.1 Sol.
GPT-6.1 Sol costă exact jumătate din Opus 5.5 la fiecare tarif standard, până când un prompt depășește 272K tokeni de input.
| Rate | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| Input, per 1M tokeni | 2,00 $ | 4,00 $ |
| Output, per 1M tokeni | 10,00 $ | 20,00 $ |
| Citire input în cache, per 1M tokeni | 0,10 $ | 0,20 $ |
| Scriere cache, per 1M tokeni | 2,50 $ | 5,00 $ (5 minute), 8,00 $ (1 oră) |
| Suprataxă pentru context lung | Peste 272K tokeni input: 2x input și cache, 1,5x output pentru toată cererea | Nicio |
| Reducere la batch | 50% | 50% |
| Mod rapid | 2x tarifele standard | 8 $ / 40 $ per 1M tokeni |
Multiplicatorul fix de 0,5x se menține la input, output și citiri din cache, deci pentru prompturi de dimensiuni normale comparația se reduce la „GPT-6.1 Sol costă jumătate”. Ambele modele facturează tokenii de raționare ca output, ceea ce contează mai mult pentru Opus 5.5, din moment ce gândirea lui nu poate fi oprită.
| Workload | GPT-6.1 Sol | Claude Opus 5.5 | Diferență |
|---|---|---|---|
| Asistent echilibrat: 1M in / 250K out | 4,50 $ | 9,00 $ | 4,50 $ (cu 50% mai puțin) |
| Retrieval, fiecare cerere sub 272K: 10M in / 1M out | 30 $ | 60 $ | 30 $ (cu 50% mai puțin) |
| Retrieval, fiecare cerere peste 272K: 10M in / 1M out | 55 $ | 60 $ | 5 $ (cu 8% mai puțin) |
Fiecare total este (volum ÷ 1M) × tarif, însumat între input și output, la tarife standard.
Cei doi vendori folosesc tokenizatoare diferite și niciunul nu a publicat numărători de tokeni pentru un workload comun, așa că tratează aceste totaluri ca o comparație de tarife, nu ca o factură.
Benchmark-urile de mai sus sunt ale vendorilor, așa că am rulat o sarcină de build împotriva GPT-6.1 Sol și Claude Opus 5.5 cu un prompt identic și unelte identice.
Sarcina: un programator de programări într-un singur fișier HTML pentru o clinică de sănătate comunitară, cu o vedere pe săptămână de luni până duminică pentru programări de fizioterapie, stomatologie, imagistică și pediatrie, un formular pentru adăugare, editare și ștergere rezervări, persistență în localStorage și o săptămână de exemplu cu vreo zece programări. Fără pas de build, fără dependențe, fără rețea.
Partea grea este logica de conflict, care trebuie să respecte mai multe reguli simultan:
Îmi place acest test pentru că sondează afirmația OpenAI că GPT-6.1 Sol se potrivește cu GPT-6 Astra la inginerie pe codebase-uri reale și argumentul Anthropic pentru Opus 5.5 ca agent de programare pe sesiuni lungi.
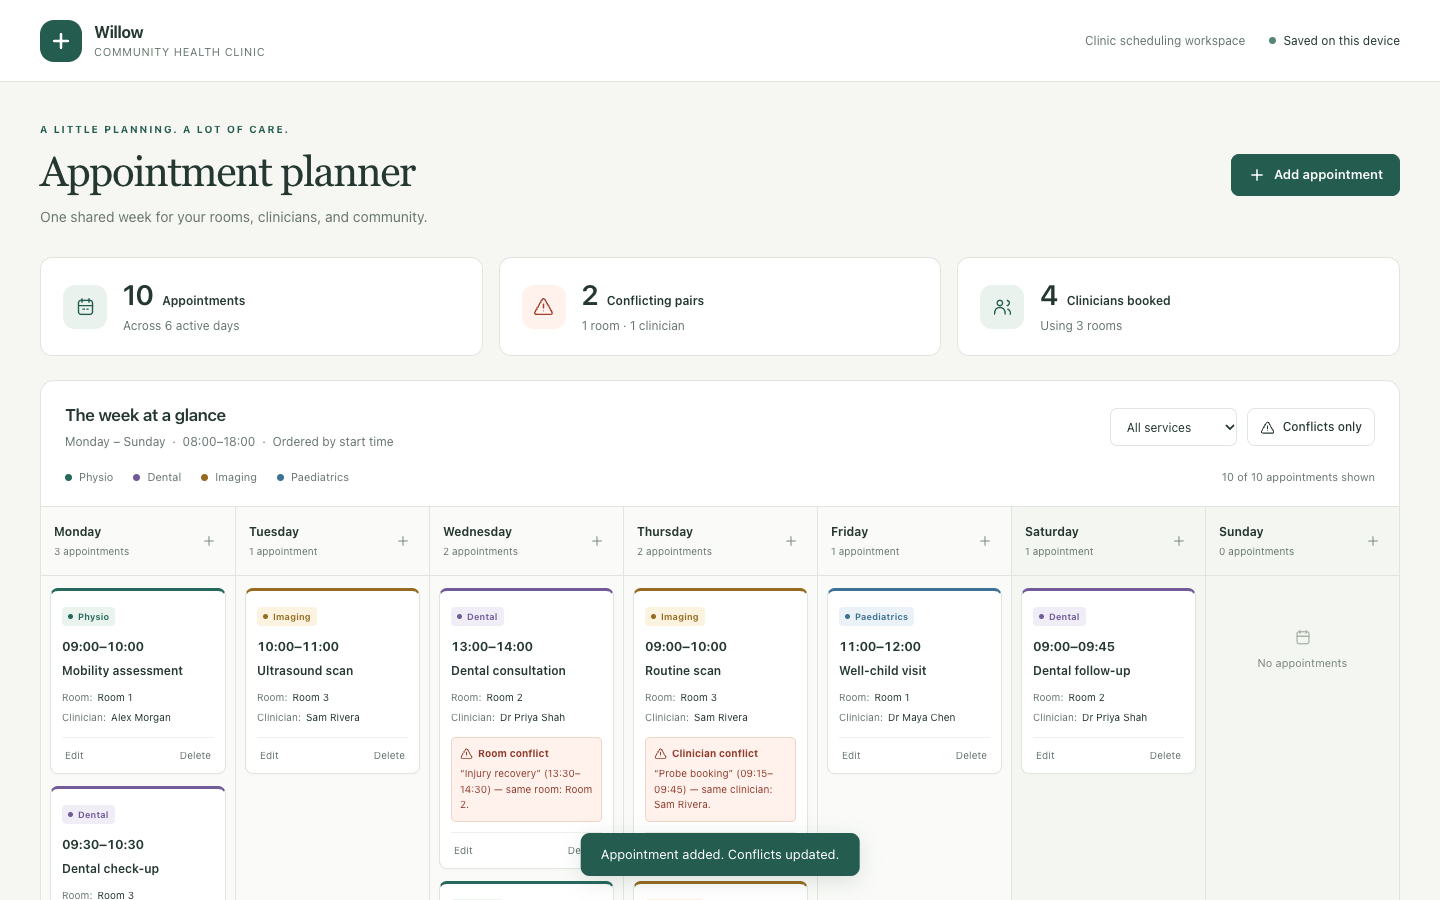
Iată programatorul lui GPT-6.1 Sol după ce am mutat o rezervare, am șters una și am adăugat una nouă care dublează un clinician. Rezervarea nouă de joi este semnalizată, numind programarea cu care intră în conflict:
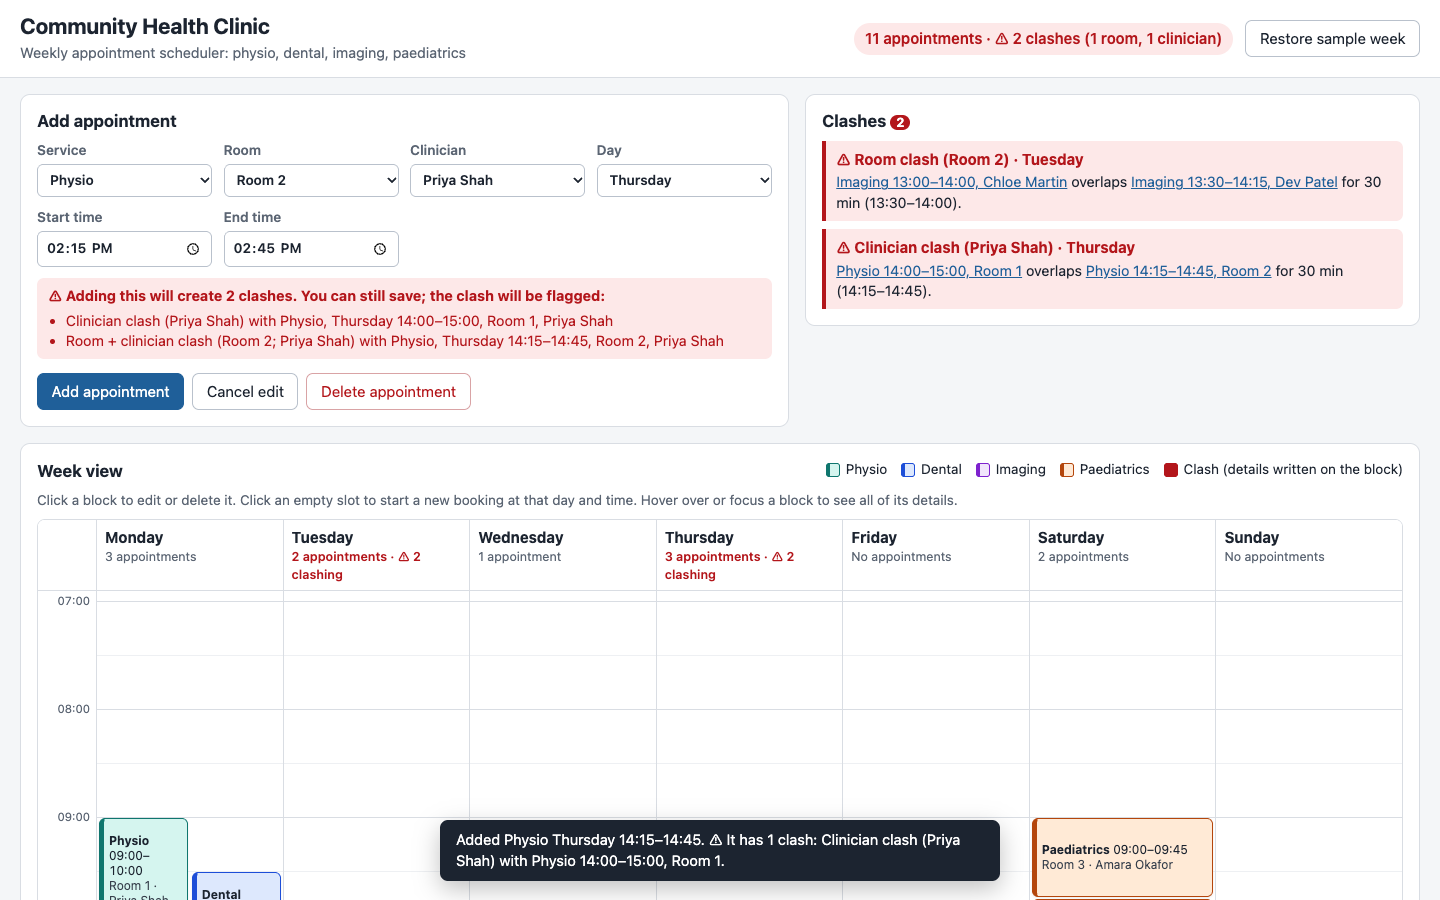
Și iată-l pe cel al lui Opus 5.5 după aceiași pași, cu un panou de conflicte care listează fiecare pereche rămasă și durata suprapunerii:
Concluziile principale:
Am punctat ambele cu 5 din 5 pentru respectarea specificațiilor și logica de conflict. GPT-6.1 Sol a luat 5 pentru uzabilitate și layout, iar Opus 5.5 a luat 4 pentru că vederea pe săptămână nu încape pe un singur ecran.
La cost apare diferența. Opus 5.5 a cheltuit mai mult de două ori mai mulți tokeni de output, majoritatea pe gândire:
Deci care câștigă? La această sarcină, GPT-6.1 Sol, și mai ales la preț. Ambele au livrat un programator corect, funcțional, iar GPT-6.1 Sol a făcut-o la circa un sfert din cost.
Pentru majoritatea echipelor, diferența cheie este costul per task: GPT-6.1 Sol atinge scorurile raportate de OpenAI pentru aproximativ o cincime până la jumătate din cât cheltuie Opus 5.5. Excepțiile sunt prompturile lungi, ultimele câteva puncte de succes pe rularile grele și locul unde implementezi.
| Surface | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| Aplicație pentru consumatori | ChatGPT Work și Codex (Plus, Pro, Business, Enterprise, Edu); încă nu în Chat | Aplicațiile Claude (Pro, Max, Team, Enterprise) |
| API de primă parte | OpenAI API (apel de unelte via Responses API) | Claude API |
| Platforme cloud | Azure AI Foundry; nelistat în documentația Vertex AI la 30 septembrie 2026 | Amazon Bedrock, Google Vertex AI, Azure AI Foundry |
| Agenți de programare | Codex, GitHub Copilot; nelistat în documentația Cursor la 30 septembrie 2026 | Claude Code, Cursor, GitHub Copilot |
| Routere terțe | OpenRouter (openai/gpt-6.1-sol) | OpenRouter (anthropic/claude-opus-5.5) |
| ID model API | gpt-6.1-sol |
claude-opus-5-5 |
Cea mai mare diferență este acoperirea: Opus 5.5 este pe toate cele trei cloud-uri majore și în Cursor, în timp ce GPT-6.1 Sol este concentrat pe produsele proprii OpenAI, Azure și Copilot.
Cele două modele folosesc SDK-uri diferite, așa că schimbarea înseamnă schimbarea clientului, nu doar a stringului modelului:
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6.1-sol",
    reasoning={"effort": "medium"},
    input="Summarize the payment terms in this contract: ...",
)
print(response.output_text)
from anthropic import Anthropic
client = Anthropic()
response = client.messages.create(
model="claude-opus-5-5",
max_tokens=2048,
messages=[{"role": "user", "content": "Summarize the payment terms in this contract: ..."}],
)
print(next(b.text for b in response.content if b.type == "text"))Pentru build-uri complete, vezi tutorialul API pentru GPT-6 Sol și tutorialul API pentru Opus 5.5, pe care le-am menționat și mai devreme.
Dacă limita ta este costul per task, folosește GPT-6.1 Sol. Dacă ai nevoie de cea mai mare rată de succes pe rulari grele, trimiți prompturi lungi sau implementezi prin Cursor sau Bedrock, folosește Opus 5.5.
Ce mi se pare cel mai relevant este că propriile grafice ale OpenAI argumentează pentru ambele. A ales punctul de efort mediu pentru titlu, dar același grafic îl arată pe Opus 5.5 în frunte la efort maxim. OpenAI pariază că majoritatea cumpărătorilor sunt interesați de punctul mai ieftin de pe curbă și, pentru agenții de zi cu zi, cred că are dreptate.
Pentru că Sol este un model din gama medie, merită testat și GPT-6.1 Sol vs. Claude Sonnet 5.5.
Iar dacă construiești pe oricare dintre modele, îți recomand OpenAI Fundamentals sau cursul nostru Introduction to Claude Models.