OpenAI ने 29 सितंबर को DevDay पर GPT-6.1 Sol जारी किया—अपने मिड-टियर मॉडल का एक अपग्रेड, जिसके बारे में कहा गया है कि यह फ्लैगशिप GPT-6 Astra के क़रीब आता है, और Astra के टोकन मूल्य का पाँचवां हिस्सा ही लेता है। एक हफ्ते पहले, Anthropic ने Claude Opus 5.5 लॉन्च किया, जिसे Fable 5.1-स्तरीय प्रदर्शन 40% कम लागत पर बताया गया।
ये दक्षता पर केंद्रित पेशकशें हैं, और OpenAI की लॉन्च पोस्ट ने सीधे Opus 5.5 का नाम लिया, यह दावा करते हुए कि बिज़नेस वर्कफ़्लो और डॉक्युमेंट कार्यों में प्रति-कार्य लागत के एक छोटे हिस्से पर जीत मिलती है। हालाँकि, OpenAI के अपने चार्ट सुर्खियों से ज़्यादा दिलचस्प कहानी बताते हैं—तुलना इस पर निर्भर करती है कि आप किस प्रयास-स्तर को देखते हैं।
अब, इस लेख में हम GPT-6.1 Sol की तुलना Opus 5.5 से कर रहे हैं, मुख्यतः क्योंकि OpenAI की लॉन्च पोस्ट ने यही मुकाबला सीधे किया है, लेकिन Claude Sonnet 5.5 भी एक उचित तुलना है, जिसे हम अपने GPT-6.1 Sol बनाम Claude Sonnet 5.5 लेख में कवर करते हैं।
TL;DR
- GPT-6.1 Sol प्रति-कार्य लागत का नेता है: जिन बेंचमार्क पर दोनों मॉडल ओवरलैप करते हैं, उन सभी में यह Opus 5.5 की खर्च का एक अंश लेकर वहाँ पहुँच जाता है।
- हालाँकि, 272K टोकन से बड़े प्रॉम्प्ट्स पर, जहाँ GPT-6.1 Sol का सरचार्ज लागू होता है, मूल्य का फ़र्क़ काफ़ी हद तक ग़ायब हो जाता है।
- अधिकतम प्रयास पर चलाने पर, बिज़नेस ऑटोमेशन और वैज्ञानिक टर्मिनल कार्य में Opus 5.5 की ऊपरी सीमा अब भी अधिक है।
GPT-6.1 Sol क्या है?
GPT-6.1 Sol, GPT-6 परिवार में OpenAI का मिड-टियर रीजनिंग मॉडल है, जिसे 29 सितंबर, 2026 को GPT-6 Sol के अपग्रेड के रूप में जारी किया गया।
इसकी ख़ासियत है—कोडिंग, कंप्यूटर उपयोग, और प्रोफ़ेशनल काम में लगभग-Astra जैसी गुणवत्ता, बहुत कम क़ीमत पर; साथ ही सस्ते कैश्ड इनपुट जो उन एजेंट्स के लिए उपयोगी हैं जो अनुरोधों के बीच संदर्भ को दोहराते हैं।
हमारा GPT-6.1 Sol गाइड लॉन्च को कवर करता है; हमारा GPT-6 Sol API ट्यूटोरियल पिछले संस्करण पर एक कोडबेस माइग्रेशन एजेंट बनाता है।
Claude Opus 5.5 क्या है?
Claude Opus 5.5, Anthropic का फ्लैगशिप Opus मॉडल है, जो Claude 5.5 परिवार के पहले मॉडल के रूप में जारी हुआ।
Anthropic इसे लंबे समय तक चलने वाले एजेंटिक कोडिंग और नॉलेज कार्य के लिए पेश करता है, जो अधिकांश कार्यों पर Claude Fable 5.1 के बराबर है, कम लागत पर, और इसमें हमेशा-ऑन एडेप्टिव थिंकिंग रहती है।
हमारा Claude Opus 5.5 गाइड लॉन्च को कवर करता है; हमारा Opus 5.5 API ट्यूटोरियल एक AI इन्सिडेंट इन्वेस्टिगेटर बनाता है।
GPT-6.1 Sol बनाम Claude Opus 5.5: आमने-सामने तुलना
GPT-6.1 Sol और Opus 5.5 केवल तीन प्रकाशित बेंचमार्क पर ओवरलैप करते हैं, जो सभी OpenAI के लॉन्च चार्ट से हैं। Opus 5.5 उनमें से दो पर उच्चतम बेस्ट स्कोर देता है, और GPT-6.1 Sol तीनों पर प्रति-कार्य 2x से 5x कम लागत में अपने परिणाम तक पहुँचता है।
| Feature | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| AutomationBench (best score, cost per task) | 36.1% at max, $0.30 | 42.5% at max, $1.44 |
| GDP.pdf (best score, cost per task) | 32.0% at high, $0.35 | 28.8% at high, $0.83 |
| Terminal-Bench Science 0.1 (max effort) | 57.0%, $5.47 | 63.3%, $23.21 |
| DeepSWE v1.1 | 75.2% at high | Not published |
| Terminal-Bench 4.0 | Not published | 66.4% at max |
| Computer use | 71.4% on OSWorld 2.0 offline (max) | 81.8% on OSWorld 2.1 |
| Context window / max output | 1.05M / 128K | 1M / 128K |
| Knowledge cutoff | April 2026 | June 2026 |
| Effort levels | low, medium (default), high, xhigh, max | low, medium (default), high, xhigh, max |
पहली तीन पंक्तियाँ OpenAI के चार्ट से हैं, जो Claude के परिणामों को "Opus 5.5 w/ fallbacks" के रूप में लेबल करते हैं। बाकी सब प्रत्येक विक्रेता द्वारा अपने मॉडल पर रिपोर्ट है।
बिज़नेस वर्कफ़्लो और दस्तावेज़
यही वह जगह है जहाँ OpenAI ने चुनौती चुनी, और जहाँ प्रयास-सेटिंग विजेता तय करती है।
OpenAI की हेडलाइन कहती है कि AutomationBench पर GPT-6.1 Sol, Opus 5.5 से 2.2 अंक आगे है—Zapier का यह टेस्ट दर्जनों बिज़नेस टूल्स में मल्टी-स्टेप वर्कफ़्लो पूरा करने वाले एजेंट्स को परखता है। यह मध्यम प्रयास पर सही है, जहाँ GPT-6.1 Sol $0.19 प्रति कार्य पर 31.7% स्कोर करता है, जबकि Opus 5.5 $0.65 पर 29.5%।
दोनों को अधिकतम पर करें, और क्रम उलट जाता है। Opus 5.5 42.5% तक चढ़ जाता है, यहाँ तक कि GPT-6 Astra से भी ऊपर, जबकि GPT-6.1 Sol 36.1% पर रुकता है। Opus 5.5 इसकी क़ीमत लगभग 5x प्रति-कार्य लागत से चुकाता है, तो सवाल है—क्या वर्कफ़्लो सफलता के छह अतिरिक्त अंक आपके एजेंट के लिए वाज़िब हैं? हज़ारों टिकट संभालने वाले सपोर्ट बॉट के लिए, शायद नहीं। किसी फ़ाइनेंस वर्कफ़्लो में जहाँ असफल रन का मतलब है कि इंसान को दोबारा करना पड़े, हो सकता है।
डॉक्यूमेंट कार्य और रोज़मर्रा की ऑटोमेशन के लिए GPT-6.1 Sol बेहतर वैल्यू है। जब सबसे कठिन वर्कफ़्लो रन को हर हाल में सफल होना हो, तब Opus 5.5 सही चुनाव है।
कोडिंग और वैज्ञानिक कार्य
यहाँ कोई साझा कोडिंग बेंचमार्क नहीं है, इसलिए तालिका में प्रत्येक विक्रेता की संख्या अलग-थलग खड़ी है। OpenAI कहता है कि GPT-6.1 Sol, DeepSWE v1.1 पर GPT-6 Astra के बराबर है—जो वास्तविक कोडबेस में लंबी-अवधि की इंजीनियरिंग को परखता है—जबकि Anthropic रिपोर्ट करता है कि Opus 5.5, Terminal-Bench 4.0 और FrontierCode पर GPT-6 Astra से आगे है।
हमारे पहले के हैंड्स-ऑन टेस्ट में, पिछले संस्करण GPT-6 Sol ने Tetris बिल्ड पर Opus 5.5 को हराया था, और रन लागत का एक-तिहाई से भी कम खर्च किया था (देखें हमारा GPT-6 Sol बनाम Claude Opus 5.5 तुलना), तो हमारा अनुमान है कि GPT-6.1 Sol आगे निकलता है।
कंप्यूटर उपयोग
यहाँ अभी दोनों मॉडलों की सीधे तुलना नहीं हो सकती। OpenAI ने GPT-6.1 Sol को OSWorld 2.0 के ऑफ़लाइन सेट पर रिपोर्ट किया है, GPT-6 Astra से 2.1 अंक के भीतर; जबकि Anthropic ने Opus 5.5 को OSWorld 2.1 पर रिपोर्ट किया है—यह नया संस्करण है और कार्य अलग हैं। किसी ने भी दूसरे का संस्करण प्रकाशित नहीं किया, इसलिए सारणी के नंबर आमने-सामने तुलना नहीं हैं। जब तक कोई दोनों को एक ही सेट पर नहीं चलाता, कंप्यूटर उपयोग को खुला मानें।
गार्डरेल्स और API बाधाएँ
व्यवहार में Opus 5.5 ज़्यादा प्रतिबंधित है। Anthropic अधिकांश साइबरसिक्योरिटी कार्यों को Opus 4.8 की ओर रूट करता है जब तक कि आप इसके Cyber Verification Program में न हों, और बायोलॉजी कार्यों पर भी इसी तरह फॉलबैक्स लगते हैं। इसी वजह से OpenAI के चार्ट Claude के परिणामों को "with fallbacks" कहते हैं।
GPT-6.1 Sol की बाधाएँ API से जुड़ी हैं। इसमें none या minimal प्रयास-सेटिंग नहीं है, और टूल कॉलिंग केवल Responses API के माध्यम से काम करती है, Chat Completions से नहीं। Opus 5.5 एडेप्टिव थिंकिंग को हमेशा-ऑन रखता है और फ़ोर्स्ड टूल यूज़ को अस्वीकार करता है। सुरक्षा टीमों के लिए, Opus 5.5 का रूटिंग अधिक व्यावहारिक फ़र्क़ है; डेवलपर्स के लिए जो कोड माइग्रेट कर रहे हैं, GPT-6.1 Sol के API बदलाव मायने रखते हैं।
मूल्य निर्धारण: आप वास्तव में क्या चुकाते हैं
मानक दरों पर, 272K इनपुट टोकन से पहले तक, GPT-6.1 Sol की लागत Opus 5.5 की ठीक आधी है।
टोकन दरें साथ-साथ
| Rate | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| Input, per 1M tokens | $2.00 | $4.00 |
| Output, per 1M tokens | $10.00 | $20.00 |
| Cached input read, per 1M tokens | $0.10 | $0.20 |
| Cache write, per 1M tokens | $2.50 | $5.00 (5-minute), $8.00 (1-hour) |
| Long-context surcharge | Over 272K input tokens: 2x input and cache, 1.5x output for the whole request | None |
| Batch discount | 50% | 50% |
| Fast mode | 2x standard rates | $8 / $40 per 1M tokens |
इनपुट, आउटपुट और कैश-रीड्स पर 0.5x का सीधा गुणक लागू होता है, इसलिए सामान्य आकार के प्रॉम्प्ट्स में तुलना "GPT-6.1 Sol की लागत आधी" तक सिमट जाती है। दोनों मॉडल रीजनिंग टोकन को आउटपुट के रूप में बिल करते हैं—यह Opus 5.5 के लिए ज़्यादा मायने रखता है क्योंकि उसकी थिंकिंग बंद नहीं की जा सकती।
वास्तविक वर्कलोड की लागत
| Workload | GPT-6.1 Sol | Claude Opus 5.5 | Difference |
|---|---|---|---|
| Balanced assistant: 1M in / 250K out | $4.50 | $9.00 | $4.50 (50% कम) |
| Retrieval, प्रत्येक अनुरोध 272K से कम: 10M in / 1M out | $30 | $60 | $30 (50% कम) |
| Retrieval, प्रत्येक अनुरोध 272K से अधिक: 10M in / 1M out | $55 | $60 | $5 (8% कम) |
प्रत्येक कुल = (वॉल्यूम ÷ 1M) × दर, इनपुट और आउटपुट पर जोड़कर, मानक दरों पर।
- Balanced assistant: सीधा आधी-कीमत वाला केस—अधिकांश चैट और एजेंट वर्कलोड ऐसे ही दिखते हैं।
- थ्रेशहोल्ड से नीचे रिट्रीवल: अब भी आधी कीमत, तो वे RAG सेटअप जो प्रत्येक प्रॉम्प्ट छोटा रखते हैं, पूरी बचत पाते हैं।
- थ्रेशहोल्ड से ऊपर रिट्रीवल: सरचार्ज GPT-6.1 Sol की इनपुट दर को दोगुना करके Opus 5.5 के स्तर पर ले आता है, और बचत नगण्य रह जाती है। यदि आपके प्रॉम्प्ट्स में नियमित रूप से पूरे कोडबेस आते हैं, तो बजट ऐसे बनाएँ जैसे दोनों की लागत समान हो।
दोनों विक्रेता अलग टोकनाइज़र इस्तेमाल करते हैं, और किसी साझा वर्कलोड के लिए टोकन काउंट प्रकाशित नहीं हुआ है, तो इन टोटल्स को बिल के बजाय दर तुलना मानें।
GPT-6.1 Sol और Claude Opus 5.5 ने कैसे प्रदर्शन किया
ऊपर के बेंचमार्क विक्रेताओं के अपने हैं, इसलिए मैंने एक बिल्ड टास्क GPT-6.1 Sol और Claude Opus 5.5 पर एक समान प्रॉम्प्ट और एक समान टूलिंग के साथ चलाया।
कार्य: एकल-फ़ाइल HTML अपॉइंटमेंट शेड्यूलर, एक सामुदायिक हेल्थ क्लिनिक के लिए—फ़िज़ियो, डेंटल, इमेजिंग और पीडियाट्रिक्स अपॉइंटमेंट्स का सोमवार-से-रविवार सप्ताह-दृश्य; बुकिंग जोड़ने, संपादित करने और हटाने का फ़ॉर्म; localStorage परसिस्टेंस; और लगभग दस अपॉइंटमेंट्स वाला सीडेड सैंपल सप्ताह। कोई बिल्ड स्टेप नहीं, न डिपेंडेंसी, न नेटवर्क।
कठिन हिस्सा है कॉन्फ्लिक्ट लॉजिक, जिसे एक साथ कई नियम पकड़ने होते हैं:
- यदि एक ही कमरे में ओवरलैप हो, या एक ही क्लिनिशियन के साथ ओवरलैप हो, तो दो अपॉइंटमेंट्स टकराते हैं
- बैक-टू-बैक बुकिंग—जहाँ एक ठीक उसी वक्त खत्म होती है जब अगली शुरू होती है—टकरानी नहीं चाहिए
- हर फ़्लैग को दूसरे अपॉइंटमेंट का नाम और कारण बताना चाहिए, सिर्फ़ लाल नहीं होना चाहिए
- हर एडिट और डिलीट के बाद फ़्लैग अपडेट होने चाहिए, और रीलोड के बाद भी बने रहने चाहिए
- सीडेड सप्ताह में ठीक दो रूम क्लैश और एक क्लिनिशियन क्लैश होना चाहिए
मुझे यह टेस्ट पसंद है क्योंकि यह OpenAI के इस दावे को परखता है कि GPT-6.1 Sol वास्तविक कोडबेस इंजीनियरिंग में GPT-6 Astra की बराबरी करता है, और Anthropic की यह पिच कि Opus 5.5 एक लंबे समय तक चलने वाला कोडिंग एजेंट है।
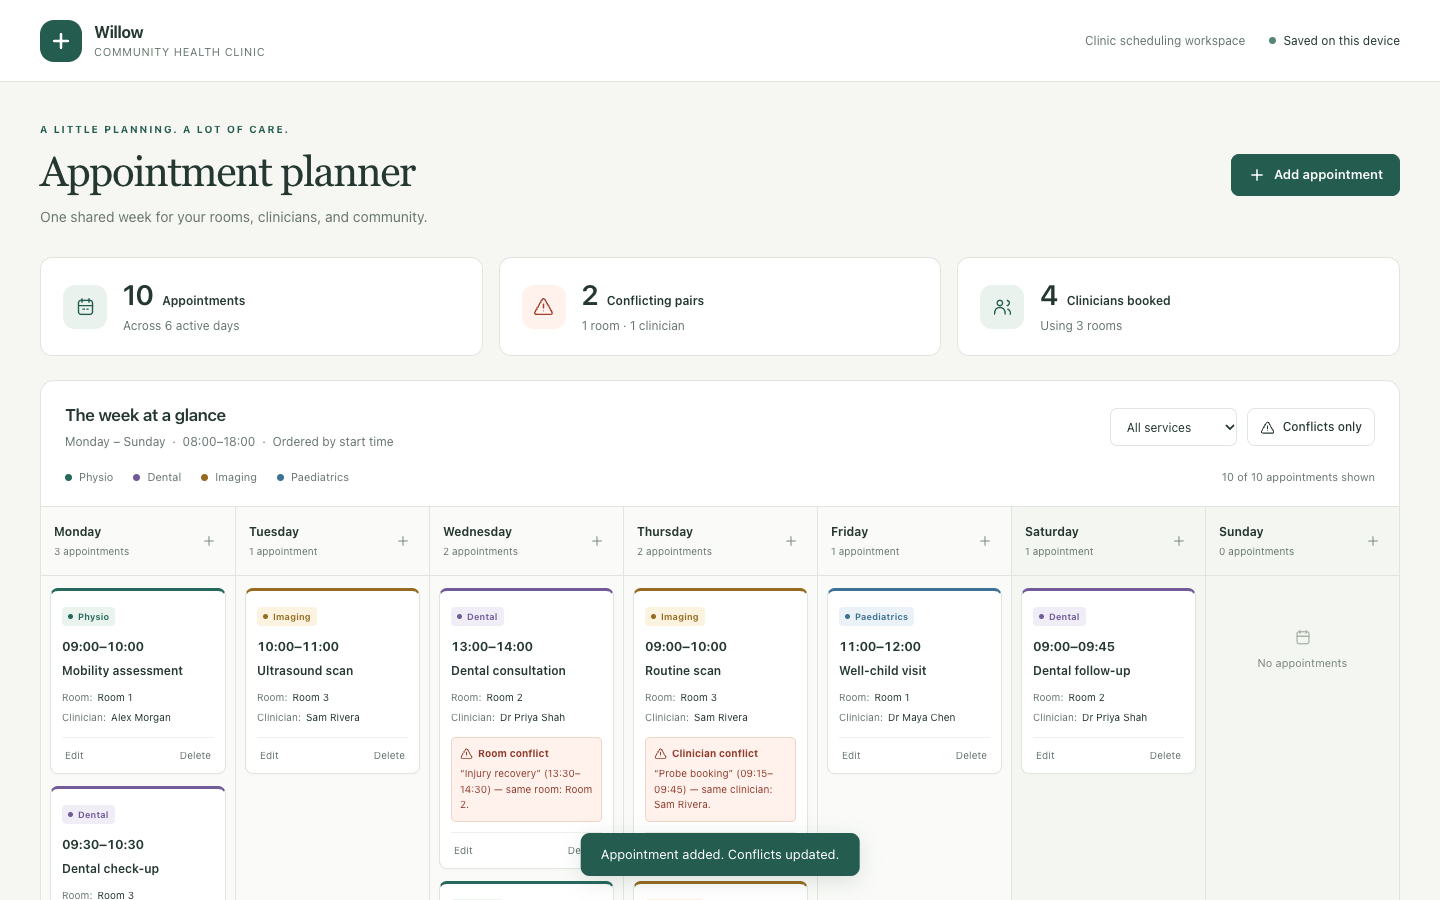
यह रहा GPT-6.1 Sol का शेड्यूलर—मैंने एक बुकिंग मूव की, एक हटाई, और एक नई जोड़ी जो एक क्लिनिशियन को डबल-बुक करती है। नई गुरुवार वाली बुकिंग फ़्लैग हुई है, और जिस अपॉइंटमेंट से टकरा रही है, उसका नाम दिया है:
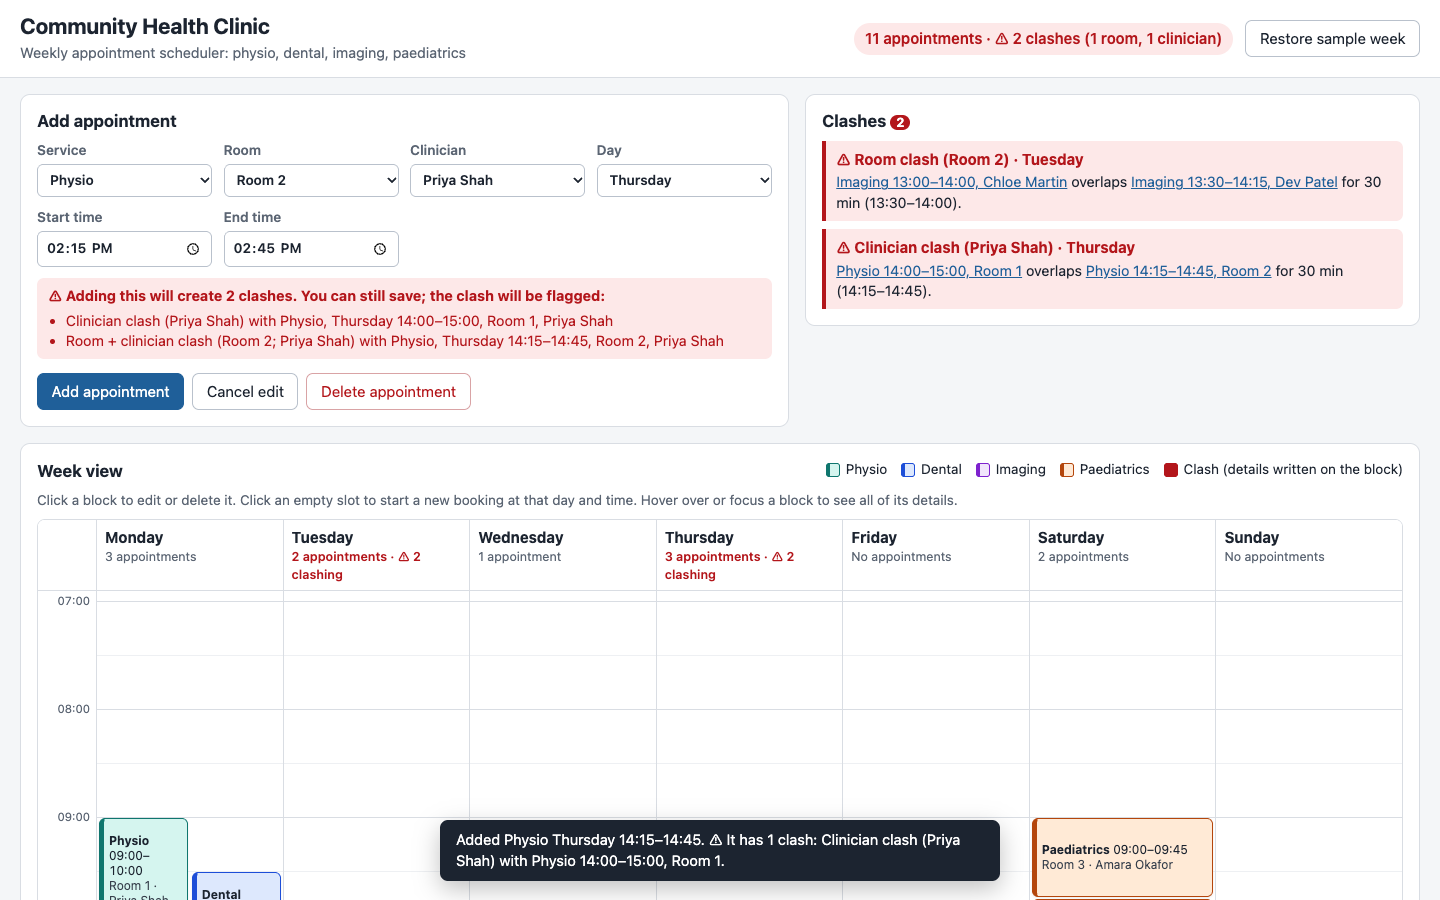
और यह रहा Opus 5.5 का—उसी चरणों के बाद—जहाँ इसका क्लैश पैनल हर बचे जोड़े और ओवरलैप की अवधि दिखाता है:
मुख्य निष्कर्ष:
- कॉन्फ्लिक्ट लॉजिक पर कोई अलग नहीं निकला। दोनों पेज ठीक दो रूम क्लैश और एक क्लिनिशियन क्लैश के साथ खुले, हर फ़्लैग ने दूसरे अपॉइंटमेंट और कारण का नाम दिया, और दोनों ने बैक-टू-बैक बुकिंग्स को नहीं छेड़ा।
- एडिट, डिलीट और रीलोड में भी किसी की चूक नहीं हुई। किसी बुकिंग को खाली कमरे में ले जाने से उसके क्लैश के दोनों हिस्से साफ़ हुए; क्लिनिशियन क्लैश के एक हिस्से को हटाने से दूसरा भी साफ़ हुआ; एक नई बुकिंग जो क्लिनिशियन को डबल-बुक करती थी, सही तरह फ़्लैग हुई; और सब कुछ रीलोड के बाद भी बना रहा।
- फ़र्क़ सिर्फ़ प्रस्तुति में थे। GPT-6.1 Sol ने ज़्यादा पॉलिश्ड पेज बनाया—समरी कार्ड्स, सर्विस फ़िल्टर, और "सिर्फ़ कॉन्फ्लिक्ट्स" टॉगल के साथ—लेकिन यह हर दिन की बुकिंग्स को समय-क्रम में दिखाता है, टाइम-ग्रिड पर नहीं। Opus 5.5 ने एक क्लैश पैनल जोड़ा जो हर ओवरलैप की अवधि दिखाता है और सेव से पहले चेतावनी देता है, लेकिन इसका सप्ताह-ग्रिड स्क्रॉल मांगता है।
- Opus 5.5 ने ज़्यादा पेचीदा सैंपल सप्ताह लिखा। इसके सीड में अलग-अलग कमरों और अलग क्लिनिशियनों के साथ एक ओवरलैप शामिल था।
मैंने दोनों को स्पेक-अनुपालन और कॉन्फ्लिक्ट लॉजिक के लिए 5 में से 5 दिए। उपयोगिता और लेआउट के लिए GPT-6.1 Sol को 5 मिले, और Opus 5.5 को 4—क्योंकि इसका सप्ताह-दृश्य एक स्क्रीन में नहीं समाता।
क़ीमत पर दोनों अलग हो गए। Opus 5.5 ने आउटपुट टोकन दोगुने से भी ज़्यादा खर्च किए—ज्यादातर थिंकिंग पर:
- GPT-6.1 Sol: $0.27
- Claude Opus 5.5: $1.11
तो विजेता कौन? इस कार्य पर—GPT-6.1 Sol, और वह भी मुख्यतः क़ीमत पर। दोनों ने सही, काम करने वाला शेड्यूलर दिया, और GPT-6.1 Sol ने यह लगभग एक-चौथाई लागत में किया।
GPT-6.1 Sol बनाम Claude Opus 5.5: कब किसे चुनें
अधिकांश टीमों के लिए फ़ैसला प्रति-कार्य लागत पर आता है: OpenAI के रिपोर्टेड स्कोर तक GPT-6.1 Sol लगभग पाँचवें से आधे खर्च में पहुँचता है। अपवाद हैं—लंबे प्रॉम्प्ट्स, कठिन रन पर अंतिम कुछ सफलता-अंक, और आप कहाँ तैनात करते हैं।
GPT-6.1 Sol चुनें, अगर...
- आप बड़े पैमाने पर एजेंट्स चलाते हैं। बिज़नेस-वર્કफ़्लो ऑटोमेशन में, यह मध्यम प्रयास पर Opus 5.5 को हराता है—लगभग एक-तिहाई प्रति-कार्य लागत पर—जो हज़ारों रन में कंपाउंड होता है।
- आपका काम सघन दस्तावेज़ों पर प्रश्न पूछना है। OpenAI के PDF बेंचमार्क पर यह हर प्रयास-सेटिंग में Opus 5.5 से आगे है, और वह भी आधी से कम लागत पर।
- आपकी टीम पहले से ChatGPT Work या Codex में काम करती है। जटिल कोडिंग और एजेंटिक कार्य के लिए OpenAI वहीं इस मॉडल की सिफारिश करता है।
- आप लंबे सिस्टम प्रॉम्प्ट्स या संदर्भ को दोबारा इस्तेमाल करते हैं। प्रति मिलियन टोकन $0.10 पर कैश्ड इनपुट, दोहराव-भारी एजेंट लूप्स को सस्ता बनाता है—बशर्ते प्रत्येक प्रॉम्प्ट 272K टोकन से नीचे रहे।
Claude Opus 5.5 चुनें, अगर...
- आपके प्रॉम्प्ट्स अक्सर 272K टोकन से ऊपर जाते हैं। वहाँ GPT-6.1 Sol का सरचार्ज इसकी अधिकतर मूल्य-लाभ को मिटा देता है, और Opus 5.5 पर कोई लॉन्ग-कॉंटेक्स्ट सरचार्ज नहीं है।
- असफल रन की क़ीमत टोकन से ज़्यादा है। अधिकतम प्रयास पर, OpenAI के अपने चार्ट में AutomationBench पर Opus 5.5 का स्कोर सबसे ऊँचा है—GPT-6 Astra सहित।
- आप Cursor, Amazon Bedrock, या Google Vertex AI के माध्यम से तैनाती करते हैं। Opus 5.5 तीनों पर सूचीबद्ध है; GPT-6.1 Sol अभी Cursor या Vertex AI डॉक्युमेंटेशन में सूचीबद्ध नहीं है।
- आप अनअटेंडेड एजेंट्स के लिए Anthropic के सतर्क डिफ़ॉल्ट चाहते हैं। इसके सेफ़गार्ड्स जोखिम भरे सिक्योरिटी और बायोलॉजी कार्यों को प्रयास करने के बजाय दूसरे मॉडलों की ओर रूट कर देते हैं।
GPT-6.1 Sol और Claude Opus 5.5 के साथ कैसे शुरू करें
| Surface | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| Consumer app | ChatGPT Work और Codex (Plus, Pro, Business, Enterprise, Edu); अभी Chat में नहीं | Claude apps (Pro, Max, Team, Enterprise) |
| First-party API | OpenAI API (टूल कॉलिंग केवल Responses API के जरिए) | Claude API |
| Cloud platforms | Azure AI Foundry; 30 सितंबर, 2026 तक Vertex AI डॉक्युमेंटेशन में सूचीबद्ध नहीं | Amazon Bedrock, Google Vertex AI, Azure AI Foundry |
| Coding agents | Codex, GitHub Copilot; 30 सितंबर, 2026 तक Cursor डॉक्युमेंटेशन में सूचीबद्ध नहीं | Claude Code, Cursor, GitHub Copilot |
| Third-party routers | OpenRouter (openai/gpt-6.1-sol) | OpenRouter (anthropic/claude-opus-5.5) |
| API model ID | gpt-6.1-sol |
claude-opus-5-5 |
सबसे बड़ा फ़र्क़ पहुँच का है: Opus 5.5 तीनों बड़े क्लाउड्स और Cursor पर है, जबकि GPT-6.1 Sol मुख्यतः OpenAI के अपने उत्पादों, Azure, और Copilot पर केंद्रित है।
अपनी पहली API कॉल करना
दोनों मॉडल अलग SDK इस्तेमाल करते हैं, इसलिए स्विच करने का मतलब है क्लाइंट के साथ-साथ मॉडल स्ट्रिंग भी बदलना:
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6.1-sol",
    reasoning={"effort": "medium"},
    input="Summarize the payment terms in this contract: ...",
)
print(response.output_text)
from anthropic import Anthropic
client = Anthropic()
response = client.messages.create(
model="claude-opus-5-5",
max_tokens=2048,
messages=[{"role": "user", "content": "Summarize the payment terms in this contract: ..."}],
)
print(next(b.text for b in response.content if b.type == "text"))पूरी बिल्ड्स के लिए, हमारा GPT-6 Sol API ट्यूटोरियल और हमारा Opus 5.5 API ट्यूटोरियल देखें—इन्हें मैंने ऊपर भी साझा किया है।
अंतिम विचार
यदि आपकी सीमा प्रति-कार्य लागत है, तो GPT-6.1 Sol का उपयोग करें। यदि आपको कठिन एजेंट रन पर उच्चतम सफलता दर चाहिए, लंबे प्रॉम्प्ट्स भेजते हैं, या Cursor या Bedrock के माध्यम से तैनाती करते हैं, तो Opus 5.5 चुनें।
मुझे सबसे उल्लेखनीय यह लगता है कि OpenAI के अपने चार्ट दोनों के पक्ष में दलील देते हैं। उसने अपनी हेडलाइन के लिए मध्यम-प्रयास बिंदु चुना, लेकिन वही चार्ट अधिकतम प्रयास पर Opus 5.5 को शीर्ष पर दिखाता है। OpenAI दांव लगा रहा है कि अधिकांश ख़रीदार कर्व पर सस्ते बिंदु की परवाह करते हैं—और रोज़मर्रा के एजेंट्स के लिए, मुझे लगता है यह सही है।
क्योंकि Sol एक मिड-टियर मॉडल है, GPT-6.1 Sol बनाम Claude Sonnet 5.5 भी जाँचना चाहिए।
और यदि आप किसी भी मॉडल पर बिल्ड कर रहे हैं, तो मैं हमारा OpenAI Fundamentals स्किल ट्रैक या हमारा Introduction to Claude Models कोर्स सुझाता हूँ।