A OpenAI aproveitou o DevDay em 29 de setembro para lançar o GPT-6.1 Sol, um upgrade do seu modelo intermediário que, segundo a empresa, chega perto do carro-chefe GPT-6 Astra por um quinto do preço de tokens do Astra. Uma semana antes, a Anthropic lançou o Claude Opus 5.5, apresentado como desempenho no nível do Fable 5.1 por 40% a menos.
São apostas em eficiência, e o post de lançamento da OpenAI cita diretamente o Opus 5.5, reivindicando vitórias em fluxos de trabalho de negócios e tarefas com documentos por uma fração do custo por tarefa. Os próprios gráficos da OpenAI contam uma história mais interessante do que a manchete, porque a comparação muda conforme o nível de esforço.
Neste artigo, a gente compara o GPT-6.1 Sol com o Opus 5.5 principalmente porque o post da OpenAI coloca esse duelo de frente, mas o Claude Sonnet 5.5 também é uma comparação válida, que cobrimos em GPT-6.1 Sol vs Claude Sonnet 5.5.
Resumo
- O GPT-6.1 Sol lidera em custo por tarefa: em todos os benchmarks que ambos compartilham, ele atinge os resultados por uma fração do gasto do Opus 5.5.
- Mas essa diferença praticamente some em prompts acima de 272K tokens, quando entra a sobretaxa do GPT-6.1 Sol.
- No esforço máximo, o Opus 5.5 ainda tem teto mais alto em automação de negócios e trabalho científico no terminal.
O que é o GPT-6.1 Sol?
O GPT-6.1 Sol é o modelo de raciocínio intermediário da OpenAI na família GPT-6, lançado em 29 de setembro de 2026 como upgrade do GPT-6 Sol.
O diferencial é entregar resultados próximos ao Astra em código, uso de computador e trabalho profissional por um preço bem menor, com leitura de entrada em cache mais barata para agentes que reutilizam contexto entre requisições.
Nosso guia do GPT-6.1 Sol cobre o lançamento; nosso tutorial da API do GPT-6 Sol constrói um agente de migração de codebase na versão anterior.
O que é o Claude Opus 5.5?
O Claude Opus 5.5 é o modelo Opus carro-chefe da Anthropic, o primeiro da família Claude 5.5.
A Anthropic posiciona o modelo para codificação agente de longa duração e trabalho de conhecimento, igualando o Claude Fable 5.1 na maioria das tarefas por um custo menor, com raciocínio adaptativo sempre ativo.
Nosso guia do Claude Opus 5.5 cobre o lançamento; nosso tutorial da API do Opus 5.5 constrói um investigador de incidentes de IA.
GPT-6.1 Sol vs Claude Opus 5.5: comparação direta
GPT-6.1 Sol e Opus 5.5 se sobrepõem em apenas três benchmarks publicados, todos dos gráficos de lançamento da OpenAI. O Opus 5.5 tem o melhor score em dois deles, e o GPT-6.1 Sol chega aos resultados gastando de 2 a 5 vezes menos por tarefa nos três.
| Recurso | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| AutomationBench (melhor score, custo por tarefa) | 36,1% no máximo, US$ 0,30 | 42,5% no máximo, US$ 1,44 |
| GDP.pdf (melhor score, custo por tarefa) | 32,0% no alto, US$ 0,35 | 28,8% no alto, US$ 0,83 |
| Terminal-Bench Science 0.1 (esforço máximo) | 57,0%, US$ 5,47 | 63,3%, US$ 23,21 |
| DeepSWE v1.1 | 75,2% no alto | Não publicado |
| Terminal-Bench 4.0 | Não publicado | 66,4% no máximo |
| Uso de computador | 71,4% no OSWorld 2.0 offline (máx.) | 81,8% no OSWorld 2.1 |
| Janela de contexto / saída máx. | 1,05M / 128K | 1M / 128K |
| Knowledge cutoff | Abril de 2026 | Junho de 2026 |
| Níveis de esforço | low, medium (padrão), high, xhigh, max | low, medium (padrão), high, xhigh, max |
As três primeiras linhas vêm dos gráficos da OpenAI, que rotulam os resultados do Claude como "Opus 5.5 w/ fallbacks". O restante é cada fornecedor reportando seu próprio modelo.
Fluxos de trabalho de negócios e documentos
É aqui que a OpenAI comprou a briga — e onde o nível de esforço define o vencedor.
A manchete da OpenAI diz que o GPT-6.1 Sol fica 2,2 pontos acima do Opus 5.5 no AutomationBench, o teste da Zapier de agentes concluindo fluxos de trabalho multietapas em dezenas de ferramentas de negócios. Isso é verdade no esforço médio: o GPT-6.1 Sol marca 31,7% a US$ 0,19 por tarefa contra 29,5% do Opus 5.5 a US$ 0,65.
Se você sobe ambos para o máximo, a ordem inverte. O Opus 5.5 vai a 42,5%, acima até do GPT-6 Astra, enquanto o GPT-6.1 Sol atinge 36,1%. O Opus 5.5 paga por isso com quase 5x o custo por tarefa, então a questão é se seis pontos a mais de sucesso no fluxo valem a pena para o seu agente. Para um bot de suporte lidando com milhares de tickets, provavelmente não. Para um processo financeiro em que uma falha implica retrabalho humano, talvez.
Para documentos e automações do dia a dia, o GPT-6.1 Sol entrega mais valor. Quando as execuções mais difíceis precisam dar certo, o Opus 5.5 é a escolha.
Codificação e trabalho científico
Não há benchmark de código compartilhado, então cada número na tabela fica isolado. A OpenAI diz que o GPT-6.1 Sol iguala o GPT-6 Astra no DeepSWE v1.1, que testa engenharia de longo horizonte em codebases reais, enquanto a Anthropic reporta o Opus 5.5 à frente do GPT-6 Astra no Terminal-Bench 4.0 e no FrontierCode.
No nosso teste prático anterior, o GPT-6 Sol, a versão anterior, superou o Opus 5.5 ao construir um Tetris por menos de um terço do custo da execução (veja a comparação GPT-6 Sol vs Claude Opus 5.5), então suspeitamos que o GPT-6.1 Sol leve vantagem.
Uso de computador
Aqui ainda não dá para comparar. A OpenAI reporta o GPT-6.1 Sol no conjunto offline do OSWorld 2.0, a 2,1 pontos do GPT-6 Astra, enquanto a Anthropic reporta o Opus 5.5 no OSWorld 2.1, versão mais nova e com tarefas diferentes. Nenhum dos dois publicou o resultado na versão do outro, então os números da tabela não são confronto direto. Trate uso de computador como em aberto até alguém rodar ambos no mesmo conjunto.
Guardrails e restrições de API
Na prática, o Opus 5.5 é o modelo mais restrito. A Anthropic encaminha a maior parte das tarefas de cibersegurança para o Opus 4.8 a menos que você esteja no Cyber Verification Program, e trabalhos de biologia seguem lógicas semelhantes de fallback. Por isso os gráficos da OpenAI rotulam os resultados do Claude como "with fallbacks".
As restrições do GPT-6.1 Sol são mais de API. Não há nível de esforço none ou minimal, e o uso de ferramentas funciona só pela Responses API, não por Chat Completions. O Opus 5.5 mantém o raciocínio adaptativo sempre ligado e rejeita forçar o uso de ferramentas. Para times de segurança, o roteamento do Opus 5.5 é a diferença mais prática; para devs migrando código, são as mudanças de API do GPT-6.1 Sol.
Preços: o que você realmente paga
O GPT-6.1 Sol custa exatamente metade do Opus 5.5 em todas as tarifas padrão — até o prompt passar de 272K tokens de entrada.
Tarifas de tokens, lado a lado
| Tarifa | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| Entrada, por 1M tokens | US$ 2,00 | US$ 4,00 |
| Saída, por 1M tokens | US$ 10,00 | US$ 20,00 |
| Leitura de cache, por 1M tokens | US$ 0,10 | US$ 0,20 |
| Gravação em cache, por 1M tokens | US$ 2,50 | US$ 5,00 (5 min), US$ 8,00 (1 h) |
| Sobretaxa de contexto longo | Acima de 272K tokens de entrada: 2x em entrada e cache, 1,5x em saída para toda a requisição | Nenhuma |
| Desconto em batch | 50% | 50% |
| Modo rápido | 2x as tarifas padrão | US$ 8 / US$ 40 por 1M tokens |
O múltiplo fixo de 0,5x vale para entrada, saída e leituras de cache, então, em prompts de tamanho normal, a comparação se resume a: "o GPT-6.1 Sol custa metade". Ambos cobram tokens de raciocínio como saída, o que pesa mais no Opus 5.5, já que o thinking não pode ser desligado.
Quanto custa um workload real
| Workload | GPT-6.1 Sol | Claude Opus 5.5 | Diferença |
|---|---|---|---|
| Assistente equilibrado: 1M in / 250K out | US$ 4,50 | US$ 9,00 | US$ 4,50 (50% menos) |
| Retrieval, cada requisição abaixo de 272K: 10M in / 1M out | US$ 30 | US$ 60 | US$ 30 (50% menos) |
| Retrieval, cada requisição acima de 272K: 10M in / 1M out | US$ 55 | US$ 60 | US$ 5 (8% menos) |
Cada total é (volume ÷ 1M) × tarifa, somado entre entrada e saída, nas tarifas padrão.
- Assistente equilibrado: o caso clássico de metade do preço — é o perfil da maioria dos workloads de chat e agentes.
- Retrieval abaixo do limite: continua metade do preço, então setups de RAG que mantêm cada prompt pequeno capturam toda a economia.
- Retrieval acima do limite: a sobretaxa dobra a tarifa de entrada do GPT-6.1 Sol para o nível do Opus 5.5, e a economia vira detalhe. Se seus prompts carregam codebases inteiras com frequência, orce como se os dois custassem o mesmo.
Os dois fornecedores usam tokenizers diferentes, e nenhum publicou contagens de tokens para um workload compartilhado, então trate esses totais como comparação de tarifas, não de fatura.
Como o GPT-6.1 Sol e o Claude Opus 5.5 se saíram
Os benchmarks acima são dos próprios fornecedores, então rodei uma tarefa de build com o mesmo prompt e as mesmas ferramentas no GPT-6.1 Sol e no Claude Opus 5.5.
A tarefa: um agendador de consultas em HTML de arquivo único para uma clínica comunitária, com visão semanal de segunda a domingo para fisioterapia, odontologia, imagem e pediatria; formulário para adicionar, editar e excluir agendamentos; persistência em localStorage; e uma semana de exemplo pré-carregada com cerca de dez consultas. Sem build, sem dependências, sem rede.
A parte difícil é a lógica de conflitos, que precisa manter várias regras ao mesmo tempo:
- Duas consultas entram em conflito se se sobrepõem na mesma sala, ou se se sobrepõem com o mesmo profissional
- Agendamentos encadeados, em que um termina exatamente quando o próximo começa, não podem conflitar
- Cada alerta precisa nomear a outra consulta e o motivo, não só ficar vermelho
- Alertas precisam atualizar após cada edição e exclusão, e sobreviver a um reload
- A semana de exemplo precisa conter exatamente dois conflitos de sala e um de profissional
Gosto desse teste porque ele verifica a promessa da OpenAI de que o GPT-6.1 Sol iguala o GPT-6 Astra em engenharia de codebases reais e o posicionamento da Anthropic para o Opus 5.5 como agente de código de longa duração.
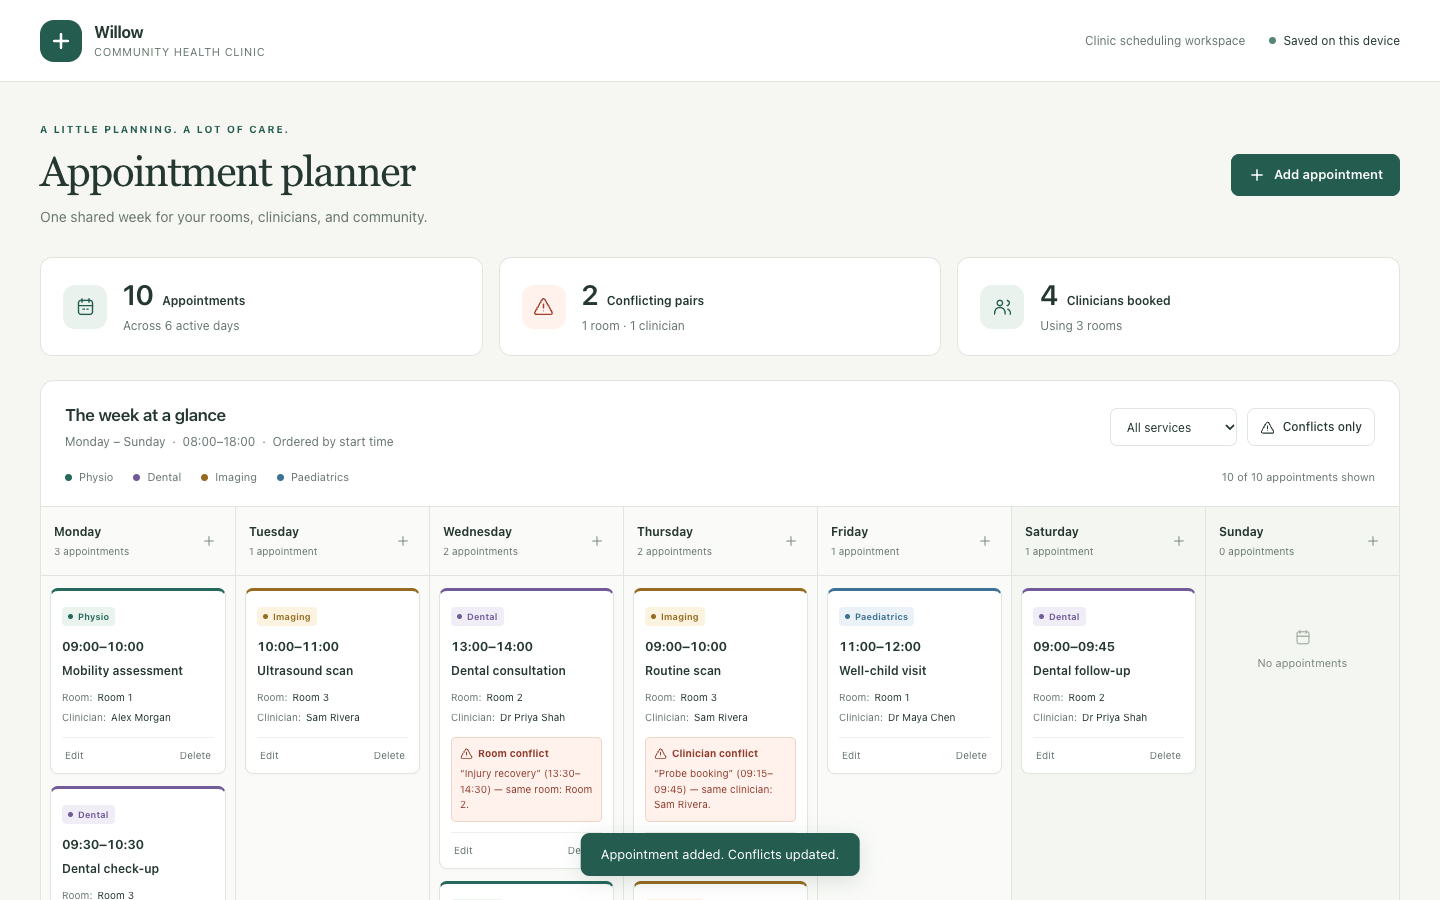
Veja o agendador do GPT-6.1 Sol depois que movi um agendamento, deletei outro e adicionei um novo que duplica um profissional. A nova consulta de quinta-feira é sinalizada, nomeando o agendamento com que conflita:
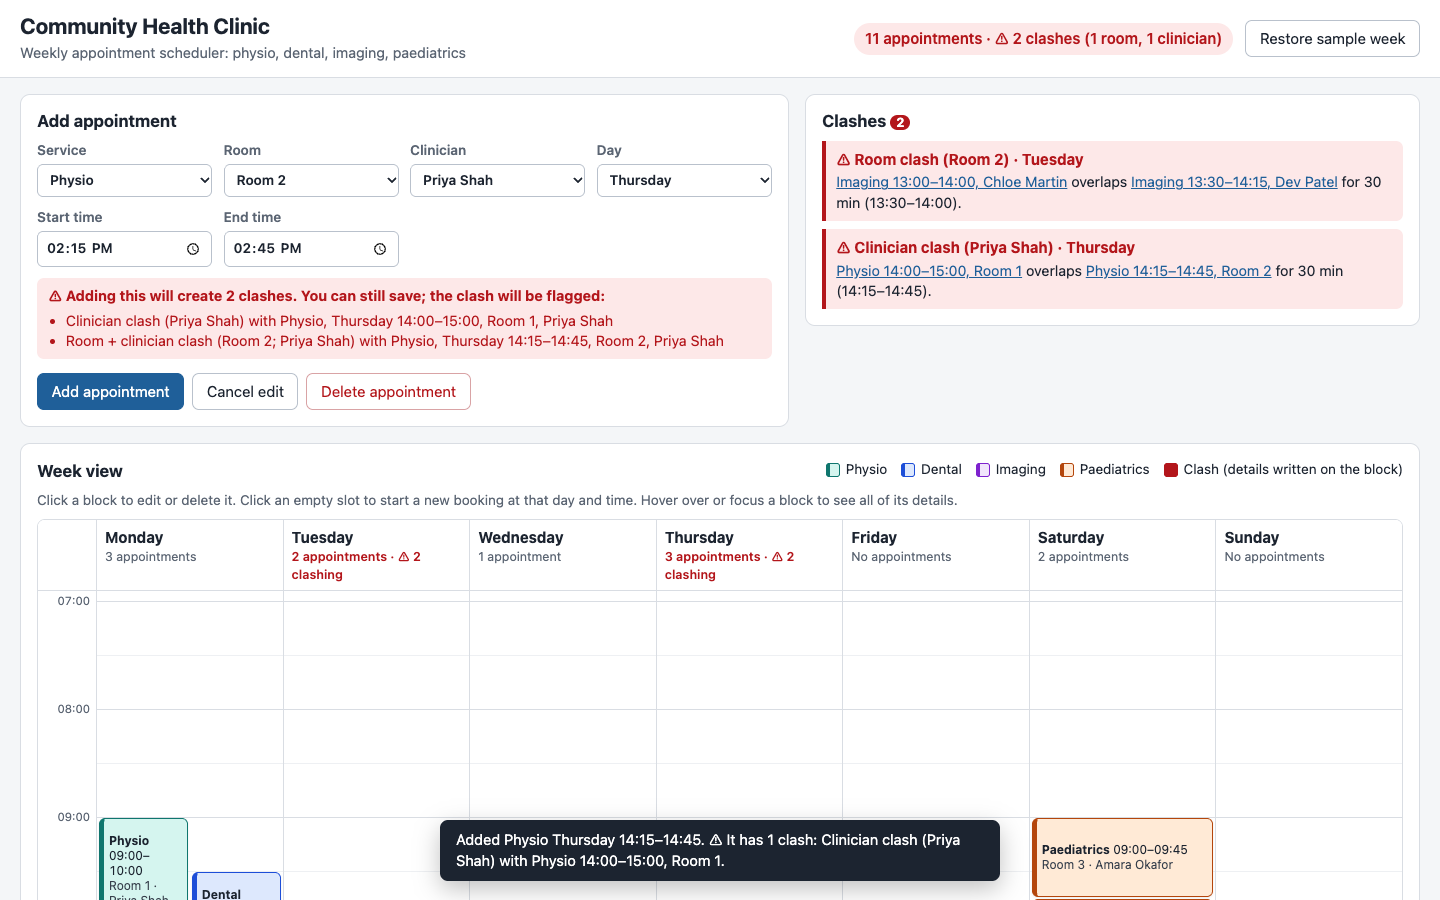
E aqui está o do Opus 5.5 após os mesmos passos, com um painel de conflitos listando cada par restante e quanto tempo dura a sobreposição:
Principais achados:
- Na lógica de conflitos, ninguém destoou. Ambas as páginas abriram com exatamente dois conflitos de sala e um de profissional, cada um nomeando a outra consulta e o motivo, e ambas deixaram agendamentos encadeados em paz.
- Edição, exclusão e reload também não derrubaram ninguém. Mover um agendamento para sala livre limpou as duas metades do conflito, deletar uma das metades do conflito de profissional limpou a outra, um novo agendamento que duplicou um profissional foi corretamente sinalizado, e tudo sobreviveu ao reload.
- As diferenças foram de apresentação. O GPT-6.1 Sol construiu uma página mais polida, com cards de resumo, filtro por serviço e um toggle "Apenas conflitos", mas lista os agendamentos do dia em ordem de horário, não em grade temporal. O Opus 5.5 adicionou um painel que mostra a duração de cada sobreposição e avisa sobre conflitos antes de salvar, mas a grade semanal exige rolagem.
- O Opus 5.5 escreveu a semana de exemplo mais complexa. Ele incluiu uma sobreposição em salas diferentes com profissionais diferentes.
Dei nota 5 de 5 para ambos em aderência ao escopo e lógica de conflitos. O GPT-6.1 Sol levou 5 em usabilidade e layout; o Opus 5.5 ficou com 4 porque a visão semanal não cabe inteira na tela.
No custo é que separa. O Opus 5.5 gastou mais que o dobro de tokens de saída, a maior parte em raciocínio:
- GPT-6.1 Sol: US$ 0,27
- Claude Opus 5.5: US$ 1,11
Então, quem vence? Nesta tarefa, o GPT-6.1 Sol — principalmente pelo preço. Ambos entregaram um agendador correto e funcional, e o GPT-6.1 Sol fez isso por cerca de um quarto do custo.
Quando escolher GPT-6.1 Sol vs Claude Opus 5.5
Para a maioria dos times, o divisor é o custo por tarefa: o GPT-6.1 Sol atinge os scores reportados pela OpenAI por algo entre um quinto e metade do que o Opus 5.5 gasta. As exceções são prompts longos, os últimos pontos de sucesso em execuções difíceis e onde você vai implantar.
Escolha o GPT-6.1 Sol se...
- Você roda agentes em grande volume. Em automação de fluxos de trabalho de negócios, ele supera o Opus 5.5 no esforço médio por cerca de um terço do custo por tarefa — isso se multiplica em milhares de execuções.
- Seu trabalho é fazer perguntas sobre documentos densos. Ele lidera o Opus 5.5 no benchmark de PDF da OpenAI em todos os níveis de esforço, por menos da metade do custo.
- Seu time já usa ChatGPT Work ou Codex. É o modelo recomendado pela OpenAI para código complexo e trabalho agente lá dentro.
- Você reutiliza prompts de sistema ou contexto longos. Leitura em cache a US$ 0,10 por milhão de tokens barateia loops de agentes com muita repetição, desde que cada prompt fique abaixo de 272K tokens.
Escolha o Claude Opus 5.5 se...
- Seus prompts costumam passar de 272K tokens. A sobretaxa do GPT-6.1 Sol elimina quase toda a vantagem de preço, e o Opus 5.5 não tem sobretaxa para contexto longo.
- Uma falha custa mais do que os tokens. No esforço máximo, o Opus 5.5 registra o maior score no AutomationBench no gráfico da própria OpenAI, acima do GPT-6 Astra.
- Você implanta via Cursor, Amazon Bedrock ou Google Vertex AI. O Opus 5.5 está listado nos três; o GPT-6.1 Sol ainda não aparece na documentação do Cursor ou do Vertex AI.
- Você quer os padrões conservadores da Anthropic para agentes autônomos. Os guardrails encaminham trabalhos de segurança e biologia arriscados para outros modelos, em vez de tentar executá-los.
Como começar com GPT-6.1 Sol e Claude Opus 5.5
| Superfície | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| App para consumidor | ChatGPT Work e Codex (Plus, Pro, Business, Enterprise, Edu); ainda não no Chat | Apps do Claude (Pro, Max, Team, Enterprise) |
| API de primeiro nível | OpenAI API (chamada de ferramentas via Responses API) | Claude API |
| Plataformas em nuvem | Azure AI Foundry; não listado na documentação do Vertex AI em 30 de setembro de 2026 | Amazon Bedrock, Google Vertex AI, Azure AI Foundry |
| Agentes de código | Codex, GitHub Copilot; não listado na documentação do Cursor em 30 de setembro de 2026 | Claude Code, Cursor, GitHub Copilot |
| Roteadores de terceiros | OpenRouter (openai/gpt-6.1-sol) | OpenRouter (anthropic/claude-opus-5.5) |
| ID do modelo na API | gpt-6.1-sol |
claude-opus-5-5 |
A maior diferença é o alcance: o Opus 5.5 está nas três grandes nuvens e no Cursor, enquanto o GPT-6.1 Sol se concentra nos produtos da própria OpenAI, no Azure e no Copilot.
Fazendo sua primeira chamada de API
Os dois modelos usam SDKs diferentes, então trocar significa mudar o client e também a string do modelo:
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6.1-sol",
    reasoning={"effort": "medium"},
    input="Summarize the payment terms in this contract: ...",
)
print(response.output_text)
from anthropic import Anthropic
client = Anthropic()
response = client.messages.create(
model="claude-opus-5-5",
max_tokens=2048,
messages=[{"role": "user", "content": "Summarize the payment terms in this contract: ..."}],
)
print(next(b.text for b in response.content if b.type == "text"))Para builds completos, veja nosso tutorial da API do GPT-6 Sol e nosso tutorial da API do Opus 5.5, que já citei acima.
Considerações finais
Se o seu limite é custo por tarefa, vá de GPT-6.1 Sol. Se você precisa da maior taxa de sucesso em execuções difíceis de agentes, envia prompts longos ou implanta via Cursor ou Bedrock, use o Opus 5.5.
O mais revelador é que os próprios gráficos da OpenAI sustentam os dois lados. A empresa escolheu o esforço médio para a manchete, mas o mesmo gráfico mostra o Opus 5.5 no topo no esforço máximo. A aposta da OpenAI é que a maioria se importa com o ponto mais barato da curva — e, para agentes do dia a dia, eu concordo.
Como o Sol é um modelo intermediário, também vale testar GPT-6.1 Sol vs. Claude Sonnet 5.5.
E se você vai construir em cima de qualquer um dos dois, recomendo a nossa trilha de habilidades OpenAI Fundamentals ou o curso Introduction to Claude Models.