OpenAI menggunakan DevDay pada 29 September untuk merilis GPT-6.1 Sol, peningkatan untuk model tingkat menengahnya yang diklaim mendekati kemampuan GPT-6 Astra andalan dengan harga token seperlima dari Astra. Seminggu sebelumnya, Anthropic meluncurkan Claude Opus 5.5, diposisikan sebagai performa setara Fable 5.1 dengan biaya 40% lebih rendah.
Ini adalah langkah efisiensi, dan postingan peluncuran OpenAI menyebut Opus 5.5 secara langsung, mengklaim kemenangan pada alur kerja bisnis dan pekerjaan dokumen dengan sebagian kecil dari biaya per tugas. Namun, grafik OpenAI sendiri menceritakan kisah yang lebih menarik daripada judulnya, karena perbandingan berubah tergantung pada pengaturan upaya yang Anda lihat.
Dalam artikel ini, kami membandingkan GPT-6.1 Sol dengan Opus 5.5 terutama karena postingan peluncuran OpenAI membuat pertarungan itu secara langsung, tetapi Claude Sonnet 5.5 juga merupakan perbandingan yang adil, yang kami bahas dalam artikel GPT-6.1 Sol vs Claude Sonnet 5.5.
Ringkasan
- GPT-6.1 Sol memimpin biaya per tugas: pada setiap benchmark yang sama-sama dibagikan kedua model, ia mencapainya dengan sebagian kecil dari pengeluaran Opus 5.5.
- Namun, selisih harga sebagian besar hilang pada prompt di atas 272K token, saat biaya tambahan GPT-6.1 Sol berlaku.
- Opus 5.5 masih memiliki plafon lebih tinggi pada otomasi bisnis dan pekerjaan terminal sains saat dijalankan pada upaya maksimum.
Apa itu GPT-6.1 Sol?
GPT-6.1 Sol adalah model penalaran tingkat menengah OpenAI dalam keluarga GPT-6, dirilis pada 29 September 2026 sebagai peningkatan untuk GPT-6 Sol.
Keunggulannya adalah hasil mendekati Astra pada pengodean, penggunaan komputer, dan pekerjaan profesional dengan harga jauh lebih rendah, dengan input cache yang lebih murah untuk agen yang memakai ulang konteks lintas permintaan.
Panduan GPT-6.1 Sol kami membahas peluncurannya; tutorial API GPT-6 Sol kami membangun agen migrasi basis kode pada versi sebelumnya.
Apa itu Claude Opus 5.5?
Claude Opus 5.5 adalah model Opus andalan Anthropic, dirilis sebagai model pertama dalam keluarga Claude 5.5.
Anthropic memosisikannya untuk pengodean agentik jangka panjang dan pekerjaan pengetahuan, menyamai Claude Fable 5.1 pada sebagian besar tugas dengan biaya lebih rendah, dengan pemikiran adaptif yang selalu aktif.
Panduan Claude Opus 5.5 kami membahas peluncurannya; tutorial API Opus 5.5 kami membangun investigator insiden AI.
GPT-6.1 Sol vs Claude Opus 5.5: Perbandingan Langsung
GPT-6.1 Sol dan Opus 5.5 tumpang tindih hanya pada tiga benchmark yang dipublikasikan, semuanya dari grafik peluncuran OpenAI. Opus 5.5 mencatat skor terbaik lebih tinggi pada dua di antaranya, dan GPT-6.1 Sol meraih hasilnya dengan biaya per tugas 2x hingga 5x lebih rendah pada ketiganya.
| Fitur | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| AutomationBench (skor terbaik, biaya per tugas) | 36,1% pada max, $0,30 | 42,5% pada max, $1,44 |
| GDP.pdf (skor terbaik, biaya per tugas) | 32,0% pada high, $0,35 | 28,8% pada high, $0,83 |
| Terminal-Bench Science 0.1 (upaya maksimum) | 57,0%, $5,47 | 63,3%, $23,21 |
| DeepSWE v1.1 | 75,2% pada high | Tidak dipublikasikan |
| Terminal-Bench 4.0 | Tidak dipublikasikan | 66,4% pada max |
| Penggunaan komputer | 71,4% pada OSWorld 2.0 offline (max) | 81,8% pada OSWorld 2.1 |
| Jendela konteks / output maksimum | 1,05M / 128K | 1M / 128K |
| Batas pengetahuan | April 2026 | Juni 2026 |
| Tingkat upaya | low, medium (default), high, xhigh, max | low, medium (default), high, xhigh, max |
Tiga baris pertama berasal dari grafik OpenAI, yang memberi label hasil Claude "Opus 5.5 w/ fallbacks". Sisanya adalah laporan masing-masing vendor untuk modelnya sendiri.
Alur kerja bisnis dan dokumen
Di sinilah OpenAI memilih medan pertarungan, dan pengaturan upaya yang menentukan pemenang.
Judul OpenAI menyatakan GPT-6.1 Sol unggul 2,2 poin atas Opus 5.5 pada AutomationBench, uji Zapier untuk agen yang menuntaskan alur kerja multi-langkah di puluhan alat bisnis. Itu benar pada upaya medium, saat GPT-6.1 Sol mencetak 31,7% dengan $0,19 per tugas dibanding 29,5% dengan $0,65 pada Opus 5.5.
Tingkatkan keduanya ke max, dan urutannya berbalik. Opus 5.5 naik ke 42,5%, di atas GPT-6 Astra sekalipun, sementara GPT-6.1 Sol mentok di 36,1%. Opus 5.5 membayarnya dengan hampir 5x biaya per tugas, jadi pertanyaannya apakah enam poin keberhasilan alur kerja itu sepadan untuk agen Anda. Untuk bot dukungan yang menangani ribuan tiket, mungkin tidak. Untuk alur kerja keuangan di mana kegagalan berarti manusia mengulang, mungkin ya.
GPT-6.1 Sol lebih bernilai untuk pekerjaan dokumen dan otomasi sehari-hari. Opus 5.5 adalah pilihan saat alur kerja tersulit harus berhasil.
Pengodean dan pekerjaan sains
Tidak ada benchmark pengodean bersama, jadi angka masing-masing vendor berdiri sendiri dalam tabel. OpenAI menyebut GPT-6.1 Sol menyamai GPT-6 Astra pada DeepSWE v1.1, yang menguji rekayasa jangka panjang di basis kode nyata, sementara Anthropic melaporkan Opus 5.5 memimpin GPT-6 Astra pada Terminal-Bench 4.0 dan FrontierCode.
Dalam uji coba langsung kami sebelumnya, GPT-6 Sol, versi sebelumnya, mengalahkan Opus 5.5 pada pembuatan Tetris dengan biaya kurang dari sepertiga run (lihat perbandingan GPT-6 Sol vs Claude Opus 5.5), jadi kami menduga GPT-6.1 Sol unggul.
Penggunaan komputer
Kedua model belum bisa dibandingkan di sini. OpenAI melaporkan GPT-6.1 Sol pada set offline OSWorld 2.0, terpaut 2,1 poin dari GPT-6 Astra, sementara Anthropic melaporkan Opus 5.5 pada OSWorld 2.1, versi lebih baru dengan tugas berbeda. Tidak ada vendor yang memublikasikan versi milik pihak lain, jadi angka pada tabel ringkasan bukan perbandingan langsung. Anggap penggunaan komputer masih terbuka sampai ada yang menjalankan keduanya pada set yang sama.
Pagar pengaman dan batasan API
Dalam praktiknya, Opus 5.5 lebih terbatas. Anthropic merutekan sebagian besar tugas keamanan siber ke Opus 4.8 kecuali Anda berada di Cyber Verification Program-nya, dan pekerjaan biologi melalui fallback serupa. Itulah juga alasan grafik OpenAI memberi label hasil Claude sebagai "with fallbacks".
Keterbatasan GPT-6.1 Sol lebih pada API. Tidak ada pengaturan upaya none atau minimal, dan pemanggilan alat hanya berfungsi melalui Responses API, bukan Chat Completions. Opus 5.5 menjaga pemikiran adaptif tetap aktif dan menolak pemaksaan penggunaan alat. Bagi tim keamanan, perutean Opus 5.5 adalah perbedaan praktis yang lebih besar; bagi pengembang yang memigrasikan kode, perubahan API GPT-6.1 Sol-lah yang paling terasa.
Harga: yang benar-benar Anda bayar
GPT-6.1 Sol berharga tepat setengah dari Opus 5.5 pada setiap tarif standar, hingga sebuah prompt melewati 272K token input.
Tarif token berdampingan
| Tarif | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| Input, per 1M token | $2,00 | $4,00 |
| Output, per 1M token | $10,00 | $20,00 |
| Baca input cache, per 1M token | $0,10 | $0,20 |
| Tulis cache, per 1M token | $2,50 | $5,00 (5 menit), $8,00 (1 jam) |
| Biaya tambahan konteks panjang | Di atas 272K token input: 2x input dan cache, 1,5x output untuk seluruh permintaan | Tidak ada |
| Diskon batch | 50% | 50% |
| Mode cepat | 2x tarif standar | $8 / $40 per 1M token |
Faktor tetap 0,5x berlaku pada input, output, dan baca cache, jadi untuk prompt berukuran normal perbandingan menyederhana menjadi "GPT-6.1 Sol berharga separuhnya". Kedua model menagih token penalaran sebagai output, yang lebih berarti bagi Opus 5.5 karena pemikirannya tidak bisa dimatikan.
Biaya beban kerja nyata
| Beban kerja | GPT-6.1 Sol | Claude Opus 5.5 | Selisih |
|---|---|---|---|
| Asisten seimbang: 1M in / 250K out | $4,50 | $9,00 | $4,50 (50% lebih murah) |
| Retrieval, tiap permintaan di bawah 272K: 10M in / 1M out | $30 | $60 | $30 (50% lebih murah) |
| Retrieval, tiap permintaan di atas 272K: 10M in / 1M out | $55 | $60 | $5 (8% lebih murah) |
Setiap total adalah (volume ÷ 1M) × tarif, dijumlahkan antara input dan output, pada tarif standar.
- Asisten seimbang: kasus harga setengah yang lugas, dan ini yang paling mirip dengan sebagian besar beban kerja chat dan agen.
- Retrieval di bawah ambang: masih setengah harga, jadi setup RAG yang menjaga setiap prompt tetap kecil mendapatkan penghematan penuh.
- Retrieval di atas ambang: biaya tambahan menggandakan tarif input GPT-6.1 Sol ke level Opus 5.5, dan penghematannya menyusut jadi nyaris nol. Jika prompt Anda rutin memuat seluruh basis kode, anggarkan seolah keduanya berbiaya sama.
Kedua vendor menggunakan tokenizer berbeda, dan tidak ada yang memublikasikan hitungan token untuk beban kerja bersama, jadi perlakukan total ini sebagai perbandingan tarif, bukan tagihan.
Performa GPT-6.1 Sol dan Claude Opus 5.5
Benchmark di atas berasal dari vendor, jadi saya menjalankan satu tugas pembuatan terhadap GPT-6.1 Sol dan Claude Opus 5.5 dengan prompt dan tooling identik.
Tugas: penjadwal janji temu HTML satu-berkas untuk klinik kesehatan komunitas, dengan tampilan minggu Senin–Minggu untuk janji fisio, gigi, pencitraan, dan pediatri, formulir untuk menambah, mengedit, dan menghapus pemesanan, persistensi localStorage, dan contoh minggu awal sekitar sepuluh janji. Tanpa langkah build, tanpa dependensi, tanpa jaringan.
Bagian tersulit adalah logika konflik, yang harus menegakkan beberapa aturan sekaligus:
- Dua janji bentrok jika tumpang tindih di ruangan yang sama, atau jika tumpang tindih dengan klinisi yang sama
- Pemesanan berurutan, saat satu berakhir tepat ketika berikutnya mulai, tidak boleh dianggap bentrok
- Setiap penanda harus menyebutkan janji lain dan alasannya, bukan hanya berubah merah
- Penanda harus diperbarui setelah setiap edit dan hapus, dan tetap ada setelah muat ulang
- Minggu awal harus memuat tepat dua bentrok ruangan dan satu bentrok klinisi
Saya menyukai tes ini karena menguji klaim OpenAI bahwa GPT-6.1 Sol menyamai GPT-6 Astra pada rekayasa basis kode nyata dan janji Anthropic untuk Opus 5.5 sebagai agen pengodean jangka panjang.
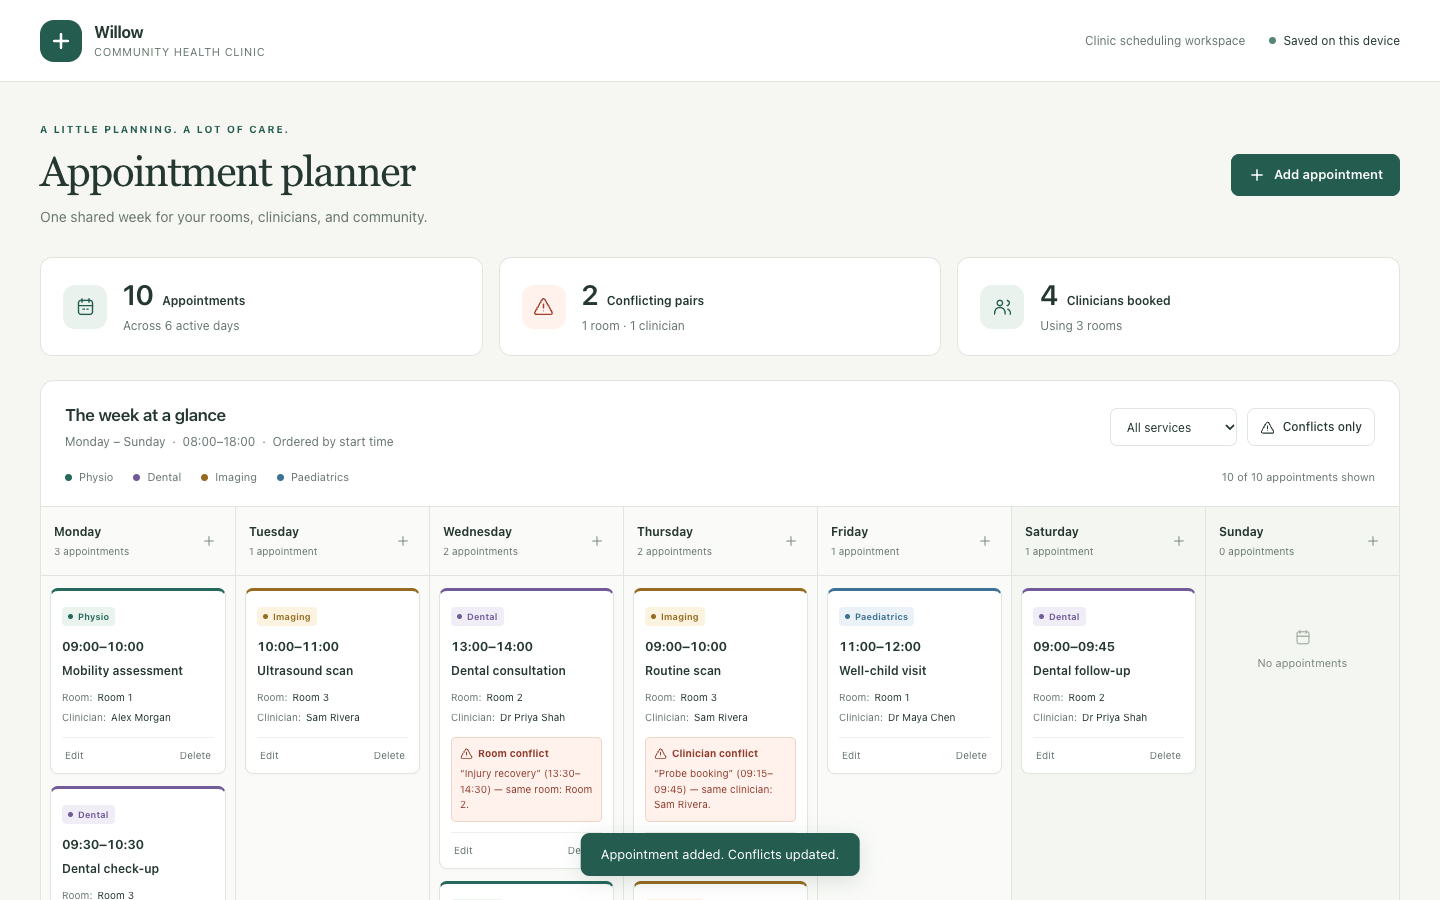
Berikut penjadwal GPT-6.1 Sol setelah saya memindahkan satu pemesanan, menghapus satu, dan menambahkan yang baru yang membuat klinisi double-booked. Pemesanan Kamis baru diberi penanda, menyebutkan janji yang berbenturan:
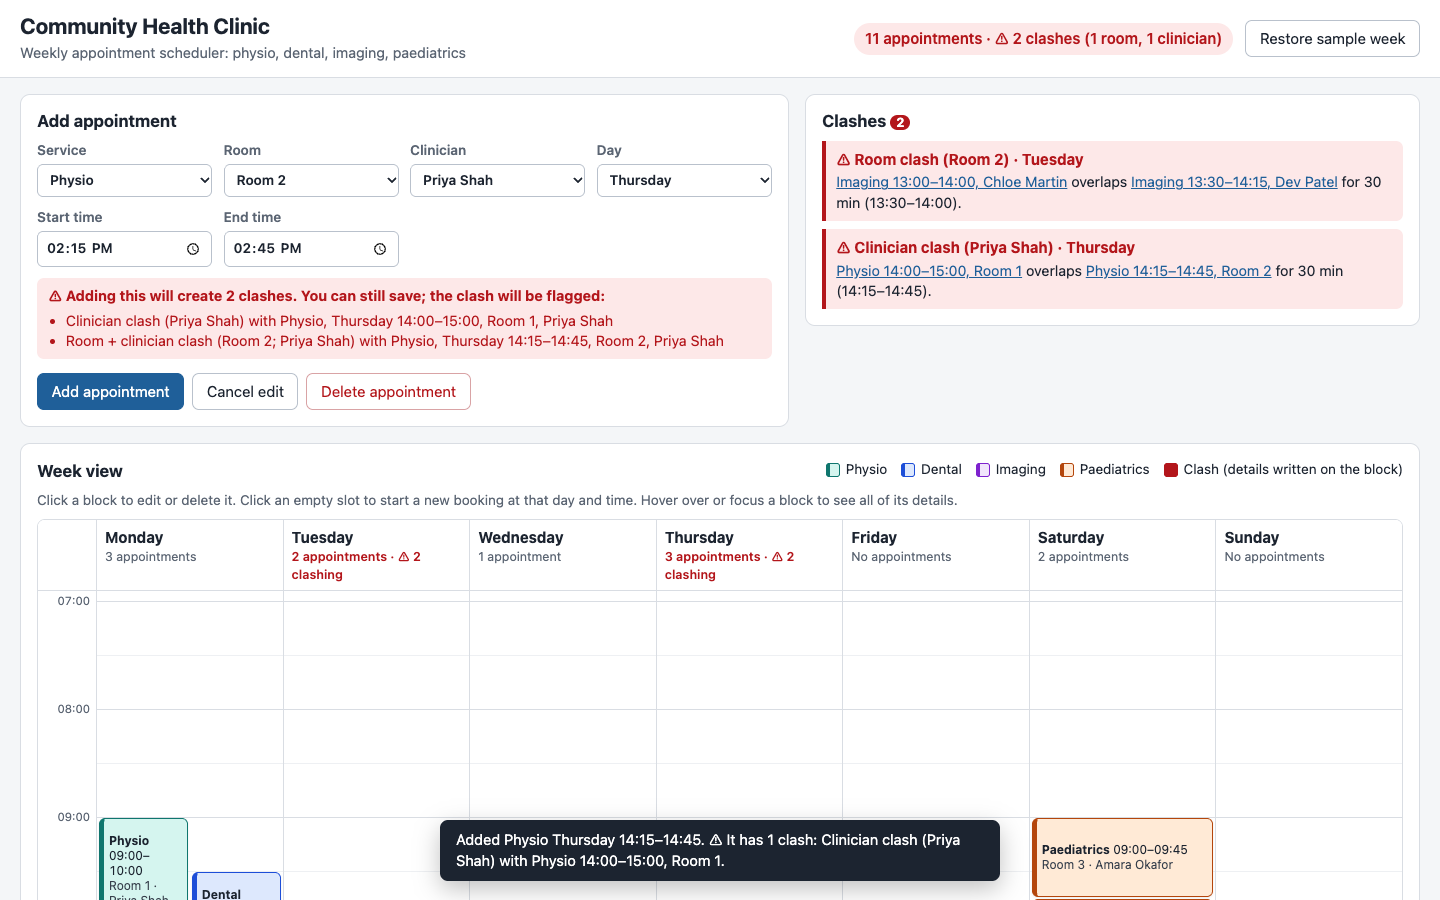
Dan berikut milik Opus 5.5 setelah langkah yang sama, dengan panel bentrok yang mencantumkan setiap pasangan tersisa dan durasi tumpang tindihnya:
Temuan utama:
- Pada logika konflik, tidak ada yang unggul. Kedua halaman dibuka dengan tepat dua bentrok ruangan dan satu bentrok klinisi ditandai, masing-masing menyebutkan janji lain dan alasannya, dan keduanya tidak menandai pemesanan berurutan.
- Edit, hapus, dan muat ulang juga tidak menjatuhkan keduanya. Memindahkan pemesanan ke ruangan kosong menghapus kedua sisi bentrok, menghapus satu sisi bentrok klinisi menghapus sisi satunya, pemesanan baru yang membuat klinisi double-booked ditandai dengan benar, dan semuanya bertahan setelah muat ulang.
- Perbedaannya semua pada penyajian. GPT-6.1 Sol membangun halaman yang lebih rapi, dengan kartu ringkasan, filter layanan, dan toggle "Hanya konflik", tetapi ia mencantumkan pemesanan harian berurutan waktu alih-alih pada kisi waktu. Opus 5.5 menambahkan panel bentrok yang menunjukkan durasi tumpang tindih dan memperingatkan Anda tentang bentrok sebelum menyimpan, tetapi kisi minggunya perlu digulir.
- Opus 5.5 menulis minggu contoh yang lebih sulit. Seed-nya mencakup tumpang tindih di ruangan berbeda dengan klinisi berbeda.
Saya memberi nilai 5 dari 5 untuk keduanya pada kepatuhan spesifikasi dan logika konflik. GPT-6.1 Sol mendapat 5 untuk kegunaan dan tata letak, dan Opus 5.5 mendapat 4 karena tampilan minggunya tidak muat dalam satu layar.
Biaya yang membedakan keduanya. Opus 5.5 menghabiskan lebih dari dua kali lipat token output, sebagian besar untuk pemikiran:
- GPT-6.1 Sol: $0,27
- Claude Opus 5.5: $1,11
Jadi siapa yang menang? Pada tugas ini, GPT-6.1 Sol, dan terutama karena harga. Keduanya menghasilkan penjadwal yang benar dan berfungsi, dan GPT-6.1 Sol melakukannya dengan sekitar seperempat biaya.
Kapan Memilih GPT-6.1 Sol vs Claude Opus 5.5
Bagi sebagian besar tim, titik beloknya adalah biaya per tugas: GPT-6.1 Sol mencapai skor yang dilaporkan OpenAI dengan sekitar seperlima hingga setengah dari pengeluaran Opus 5.5. Pengecualiannya adalah prompt panjang, poin-poin terakhir keberhasilan pada run yang sulit, dan tempat Anda melakukan deployment.
Pilih GPT-6.1 Sol jika...
- Anda menjalankan agen dalam volume besar. Pada otomasi alur kerja bisnis, ia mengalahkan Opus 5.5 pada upaya medium dengan sekitar sepertiga biaya per tugas, yang terakumulasi di ribuan run.
- Pekerjaan Anda berupa pertanyaan atas dokumen padat. Ia memimpin Opus 5.5 pada benchmark PDF OpenAI di setiap tingkat upaya, dengan biaya kurang dari setengahnya.
- Tim Anda sudah bekerja di ChatGPT Work atau Codex. Inilah model yang direkomendasikan OpenAI di sana untuk pengodean kompleks dan pekerjaan agentik.
- Anda memakai ulang prompt sistem atau konteks panjang. Input cache seharga $0,10 per sejuta token membuat loop agen yang banyak pengulangan jadi murah, selama setiap prompt tetap di bawah 272K token.
Pilih Claude Opus 5.5 jika...
- Prompt Anda secara rutin melebihi 272K token. Biaya tambahan GPT-6.1 Sol menghapus sebagian besar keunggulan harganya di sana, dan Opus 5.5 tidak memiliki biaya tambahan konteks panjang.
- Run yang gagal biayanya lebih besar daripada token. Pada upaya maksimum, Opus 5.5 mencatat skor AutomationBench tertinggi di grafik OpenAI sendiri, termasuk GPT-6 Astra.
- Anda melakukan deployment melalui Cursor, Amazon Bedrock, atau Google Vertex AI. Opus 5.5 terdaftar di ketiganya; GPT-6.1 Sol belum tercantum di dokumentasi Cursor atau Vertex AI.
- Anda menginginkan default konservatif Anthropic untuk agen tanpa pengawasan. Pengamanannya merutekan pekerjaan keamanan dan biologi berisiko ke model lain alih-alih mencobanya.
Cara Memulai dengan GPT-6.1 Sol dan Claude Opus 5.5
| Permukaan | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| Aplikasi konsumen | ChatGPT Work dan Codex (Plus, Pro, Business, Enterprise, Edu); belum ada di Chat | Aplikasi Claude (Pro, Max, Team, Enterprise) |
| API pihak pertama | OpenAI API (pemanggilan alat melalui Responses API) | Claude API |
| Platform cloud | Azure AI Foundry; belum tercantum di dokumentasi Vertex AI per 30 September 2026 | Amazon Bedrock, Google Vertex AI, Azure AI Foundry |
| Agen pengodean | Codex, GitHub Copilot; belum tercantum di dokumentasi Cursor per 30 September 2026 | Claude Code, Cursor, GitHub Copilot |
| Router pihak ketiga | OpenRouter (openai/gpt-6.1-sol) | OpenRouter (anthropic/claude-opus-5.5) |
| ID model API | gpt-6.1-sol |
claude-opus-5-5 |
Perbedaan terbesar adalah jangkauan: Opus 5.5 ada di ketiga cloud besar dan di Cursor, sementara GPT-6.1 Sol terpusat pada produk OpenAI sendiri, Azure, dan Copilot.
Membuat panggilan API pertama Anda
Kedua model menggunakan SDK berbeda, jadi beralih berarti mengganti klien sekaligus string model:
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6.1-sol",
    reasoning={"effort": "medium"},
    input="Summarize the payment terms in this contract: ...",
)
print(response.output_text)
from anthropic import Anthropic
client = Anthropic()
response = client.messages.create(
model="claude-opus-5-5",
max_tokens=2048,
messages=[{"role": "user", "content": "Summarize the payment terms in this contract: ..."}],
)
print(next(b.text for b in response.content if b.type == "text"))Untuk build lengkap, lihat tutorial API GPT-6 Sol dan tutorial API Opus 5.5 kami, yang juga saya sebutkan sebelumnya.
Pemikiran Akhir
Jika biaya per tugas menjadi kendala Anda, gunakan GPT-6.1 Sol. Jika Anda membutuhkan tingkat keberhasilan tertinggi pada run agen yang sulit, mengirim prompt panjang, atau melakukan deployment melalui Cursor atau Bedrock, gunakan Opus 5.5.
Yang paling menunjukkan bagi saya adalah grafik OpenAI sendiri yang membuat kasus untuk keduanya. Mereka memilih titik upaya medium untuk judulnya, tetapi grafik yang sama menunjukkan Opus 5.5 berada di puncak pada upaya maksimum. OpenAI bertaruh bahwa sebagian besar pembeli peduli pada titik yang lebih murah di kurva, dan untuk agen sehari-hari, saya pikir itu benar.
Karena Sol adalah model tingkat menengah, GPT-6.1 Sol vs Claude Sonnet 5.5 juga layak diuji.
Dan jika Anda membangun di atas salah satu model, saya merekomendasikan jalur keahlian OpenAI Fundamentals atau kursus Introduction to Claude Models kami.