OpenAI nutzte den DevDay am 29. September, um GPT-6.1 Sol zu veröffentlichen – ein Upgrade des Mid-Tier-Modells, das laut OpenAI nahe an GPT-6 Astra heranreicht, bei einem Fünftel der Astra-Tokenpreise. Eine Woche zuvor brachte Anthropic Claude Opus 5.5 heraus – beworben als Leistung auf Fable 5.1-Niveau, 40% günstiger.
Beide Launches zielen auf Effizienz. OpenAI nennt Opus 5.5 im Launch-Post explizit und beansprucht Vorteile bei Business-Workflows und Dokumentenarbeit – zu einem Bruchteil der Kosten pro Aufgabe. Die eigenen Charts von OpenAI erzählen aber eine spannendere Geschichte als die Überschrift, denn der Vergleich hängt stark von der gewählten Aufwandstufe ab.
In diesem Artikel vergleichen wir GPT-6.1 Sol vor allem deshalb direkt mit Opus 5.5, weil OpenAI diese Gegenüberstellung selbst wählt. Eine ebenso faire Alternative ist Claude Sonnet 5.5, die wir im Beitrag GPT-6.1 Sol vs Claude Sonnet 5.5 abdecken.
TL;DR
- GPT-6.1 Sol führt bei den Kosten pro Aufgabe: Auf allen gemeinsamen Benchmarks liefert es die Ergebnisse für einen Bruchteil der Ausgaben von Opus 5.5.
- Der Preisvorteil schrumpft jedoch stark bei Prompts über 272K Tokens, wo der Aufschlag von GPT-6.1 Sol greift.
- Opus 5.5 hat bei Business-Automatisierung und wissenschaftlicher Terminal-Arbeit mit maximalem Aufwand die höhere Obergrenze.
Was ist GPT-6.1 Sol?
GPT-6.1 Sol ist OpenAIs Mid-Tier-Reasoning-Modell aus der GPT-6-Familie, veröffentlicht am 29. September 2026 als Upgrade zu GPT-6 Sol.
Das Versprechen: Ergebnisse nahe Astra bei Coding, Computersteuerung und professionellen Aufgaben zu deutlich niedrigeren Preisen – plus günstigeres Caching für Inputs, damit Agenten wiederverwendeten Kontext effizient nutzen.
Unser GPT-6.1 Sol Guide beleuchtet den Launch; im GPT-6 Sol API Tutorial bauen wir einen Agenten zur Codebase-Migration auf Basis der Vorgängerversion.
Was ist Claude Opus 5.5?
Claude Opus 5.5 ist Anthropics Flaggschiff der Opus-Reihe und das erste Modell der Claude-5.5-Familie.
Anthropic positioniert es für langlaufendes, agentisches Coding und Wissensarbeit – mit Leistung auf dem Niveau von Claude Fable 5.1 zu geringeren Kosten, bei dauerhaft aktivem adaptivem Denken.
Unser Claude Opus 5.5 Guide deckt den Launch ab; im Opus 5.5 API Tutorial bauen wir einen KI-Incident-Investigator.
GPT-6.1 Sol vs Claude Opus 5.5: Direktvergleich
GPT-6.1 Sol und Opus 5.5 überschneiden sich nur auf drei veröffentlichten Benchmarks, alle aus OpenAIs Launch-Charts. Opus 5.5 erzielt auf zweien die höhere Bestleistung, während GPT-6.1 Sol auf allen drei Benchmarks mit zwei- bis fünffach geringeren Kosten pro Aufgabe punktet.
| Feature | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| AutomationBench (Bestscore, Kosten pro Aufgabe) | 36,1% bei max, $0,30 | 42,5% bei max, $1,44 |
| GDP.pdf (Bestscore, Kosten pro Aufgabe) | 32,0% bei high, $0,35 | 28,8% bei high, $0,83 |
| Terminal-Bench Science 0.1 (maximaler Aufwand) | 57,0%, $5,47 | 63,3%, $23,21 |
| DeepSWE v1.1 | 75,2% bei high | Nicht veröffentlicht |
| Terminal-Bench 4.0 | Nicht veröffentlicht | 66,4% bei max |
| Computersteuerung | 71,4% auf OSWorld 2.0 offline (max) | 81,8% auf OSWorld 2.1 |
| Kontextfenster / max. Ausgabe | 1,05M / 128K | 1M / 128K |
| Wissensstand | April 2026 | Juni 2026 |
| Aufwandsstufen | low, medium (Standard), high, xhigh, max | low, medium (Standard), high, xhigh, max |
Die ersten drei Zeilen stammen aus OpenAIs Charts, die die Claude-Ergebnisse als "Opus 5.5 w/ fallbacks" kennzeichnen. Alles Weitere sind Eigenangaben der Anbieter zu ihren Modellen.
Business-Workflows und Dokumente
Hier hat OpenAI den Vergleich gesucht – und die Aufwandseinstellung entscheidet über den Sieger.
OpenAIs Headline sagt, GPT-6.1 Sol liege auf der AutomationBench 2,2 Punkte vor Opus 5.5. Gemessen wird hier Zapiers Test von Agenten, die mehrstufige Workflows über Dutzende Business-Tools ausführen. Das stimmt bei medium: GPT-6.1 Sol erzielt 31,7% für $0,19 pro Aufgabe, gegenüber 29,5% für $0,65 bei Opus 5.5.
Drehst du beide auf max, kehrt sich die Reihenfolge um. Opus 5.5 steigt auf 42,5% – sogar über GPT-6 Astra – während GPT-6.1 Sol bei 36,1% deckelt. Opus 5.5 bezahlt das mit fast dem Fünffachen an Kosten pro Aufgabe. Die Frage ist also, ob dir sechs Prozentpunkte mehr Workflow-Erfolg das wert sind. Für einen Support-Bot mit Tausenden Tickets: eher nicht. Für einen Finanz-Workflow, bei dem ein Fehllauf menschliches Nacharbeiten bedeutet: vielleicht schon.
Für Dokumentenarbeit und alltägliche Automatisierung ist GPT-6.1 Sol der bessere Deal. Opus 5.5 wählst du, wenn die härtesten Runs sitzen müssen.
Coding und wissenschaftliche Arbeit
Es gibt keinen geteilten Coding-Benchmark, daher stehen die Zahlen der Anbieter isoliert in der Tabelle. OpenAI sagt, GPT-6.1 Sol erreiche auf DeepSWE v1.1 – einem Test langfristiger Engineering-Aufgaben in realen Codebasen – das Niveau von GPT-6 Astra. Anthropic meldet Opus 5.5 vorn auf Terminal-Bench 4.0 und FrontierCode gegenüber GPT-6 Astra.
In unserem früheren Hands-on schlug GPT-6 Sol, die Vorgängerversion, Opus 5.5 beim Bau eines Tetris-Klons – bei weniger als einem Drittel der Laufkosten (siehe GPT-6 Sol vs Claude Opus 5.5). Wir vermuten daher, dass GPT-6.1 Sol hier die Nase vorn hat.
Computersteuerung
Noch nicht direkt vergleichbar. OpenAI berichtet GPT-6.1 Sol auf dem Offline-Set von OSWorld 2.0, nur 2,1 Punkte hinter GPT-6 Astra. Anthropic berichtet Opus 5.5 auf OSWorld 2.1 – einer neueren Version mit anderen Aufgaben. Keiner hat die Version des anderen veröffentlicht, die Zahlen in der Tabelle sind also kein echtes Head-to-Head. Bis beide auf demselben Set laufen, bleibt das Feld offen.
Guardrails und API-Einschränkungen
Opus 5.5 ist in der Praxis stärker reglementiert. Anthropic leitet die meisten Cybersecurity-Aufgaben auf Opus 4.8 um, sofern du nicht im Cyber Verification Program bist; Ähnliches gilt für Biologie. Daher kennzeichnet OpenAI seine Claude-Ergebnisse als "with fallbacks".
Bei GPT-6.1 Sol betreffen die Einschränkungen eher die API. Es gibt keine Aufwandsstufen none oder minimal, und Tool-Aufrufe funktionieren nur über die Responses API, nicht über Chat Completions. Opus 5.5 hält adaptives Denken immer aktiv und verweigert erzwungene Tool-Nutzung. Für Security-Teams ist die Routing-Logik von Opus 5.5 der größere praktische Unterschied; für Developer, die Code migrieren, sind es die API-Änderungen bei GPT-6.1 Sol.
Preise: Was du wirklich zahlst
GPT-6.1 Sol kostet auf allen Standardtarifen exakt die Hälfte von Opus 5.5 – bis ein Prompt 272K Input-Tokens überschreitet.
Token-Tarife im Überblick
| Tarif | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| Input, pro 1M Tokens | $2,00 | $4,00 |
| Output, pro 1M Tokens | $10,00 | $20,00 |
| Gelesener Cache-Input, pro 1M Tokens | $0,10 | $0,20 |
| Cache-Schreiben, pro 1M Tokens | $2,50 | $5,00 (5 Minuten), $8,00 (1 Stunde) |
| Aufschlag für langen Kontext | Über 272K Input-Tokens: 2x Input und Cache, 1,5x Output für die gesamte Anfrage | Keiner |
| Batch-Rabatt | 50% | 50% |
| Fast Mode | 2x Standardtarife | $8 / $40 pro 1M Tokens |
Der konstante 0,5x-Faktor gilt für Input, Output und Cache-Reads. Für normal große Prompts lässt sich der Vergleich also auf "GPT-6.1 Sol kostet die Hälfte" verkürzen. Beide Modelle rechnen Reasoning-Tokens als Output ab – was bei Opus 5.5 stärker ins Gewicht fällt, da sich sein Denken nicht abschalten lässt.
Was ein echter Workload kostet
| Workload | GPT-6.1 Sol | Claude Opus 5.5 | Unterschied |
|---|---|---|---|
| Ausgewogener Assistent: 1M in / 250K out | $4,50 | $9,00 | $4,50 (50% weniger) |
| Retrieval, jede Anfrage unter 272K: 10M in / 1M out | $30 | $60 | $30 (50% weniger) |
| Retrieval, jede Anfrage über 272K: 10M in / 1M out | $55 | $60 | $5 (8% weniger) |
Jede Summe ist (Volumen ÷ 1M) × Tarif, aufsummiert über Input und Output, zu Standardpreisen.
- Ausgewogener Assistent: der simple Halbpreis-Fall – und so sehen die meisten Chat- und Agent-Workloads aus.
- Retrieval unter der Schwelle: weiterhin halb so teuer. RAG-Setups, die jeden Prompt klein halten, nutzen die volle Ersparnis.
- Retrieval über der Schwelle: Der Aufschlag verdoppelt bei GPT-6.1 Sol den Input-Tarif auf das Niveau von Opus 5.5, die Ersparnis schrumpft auf Rundungsgröße. Wenn deine Prompts regelmäßig komplette Codebasen tragen, kalkuliere, als würden beide etwa gleich viel kosten.
Die beiden Anbieter verwenden unterschiedliche Tokenizer und keiner hat Token-Zahlen für einen identischen Workload veröffentlicht. Sieh diese Summen daher als Tarifvergleich, nicht als Rechnung.
So performten GPT-6.1 Sol und Claude Opus 5.5
Die Benchmarks oben stammen von den Anbietern selbst. Daher habe ich eine Build-Aufgabe mit identischem Prompt und identischem Tooling gegen GPT-6.1 Sol und Claude Opus 5.5 gefahren.
Die Aufgabe: Ein einseitiger HTML-Terminplaner für eine Community-Gesundheitsklinik, mit Wochenansicht Montag–Sonntag für Physio-, Zahn-, Imaging- und Pädiatrie-Termine, Formular zum Anlegen, Bearbeiten und Löschen, localStorage-Persistenz und einer vorbefüllten Beispielwoche mit rund zehn Terminen. Kein Build-Step, keine Dependencies, kein Netzwerk.
Die harte Nuss ist die Konfliktlogik, die mehrere Regeln gleichzeitig einhalten muss:
- Zwei Termine kollidieren, wenn sie sich im selben Raum überschneiden, oder wenn sie sich mit derselben behandelnden Person überschneiden
- Back-to-back-Buchungen, bei denen ein Termin genau endet, wenn der nächste beginnt, dürfen nicht kollidieren
- Jede Markierung muss den anderen Termin und den Grund nennen, nicht nur rot färben
- Markierungen müssen nach jedem Edit und Delete aktualisieren und einen Reload überstehen
- Die Seed-Woche muss genau zwei Raumkonflikte und einen Konflikt auf Behandlerseite enthalten
Ich mag diesen Test, weil er OpenAIs Claim prüft, dass GPT-6.1 Sol bei Engineering in realen Codebasen mit GPT-6 Astra mithält, und Anthropics Positionierung von Opus 5.5 als langlaufendem Coding-Agenten.
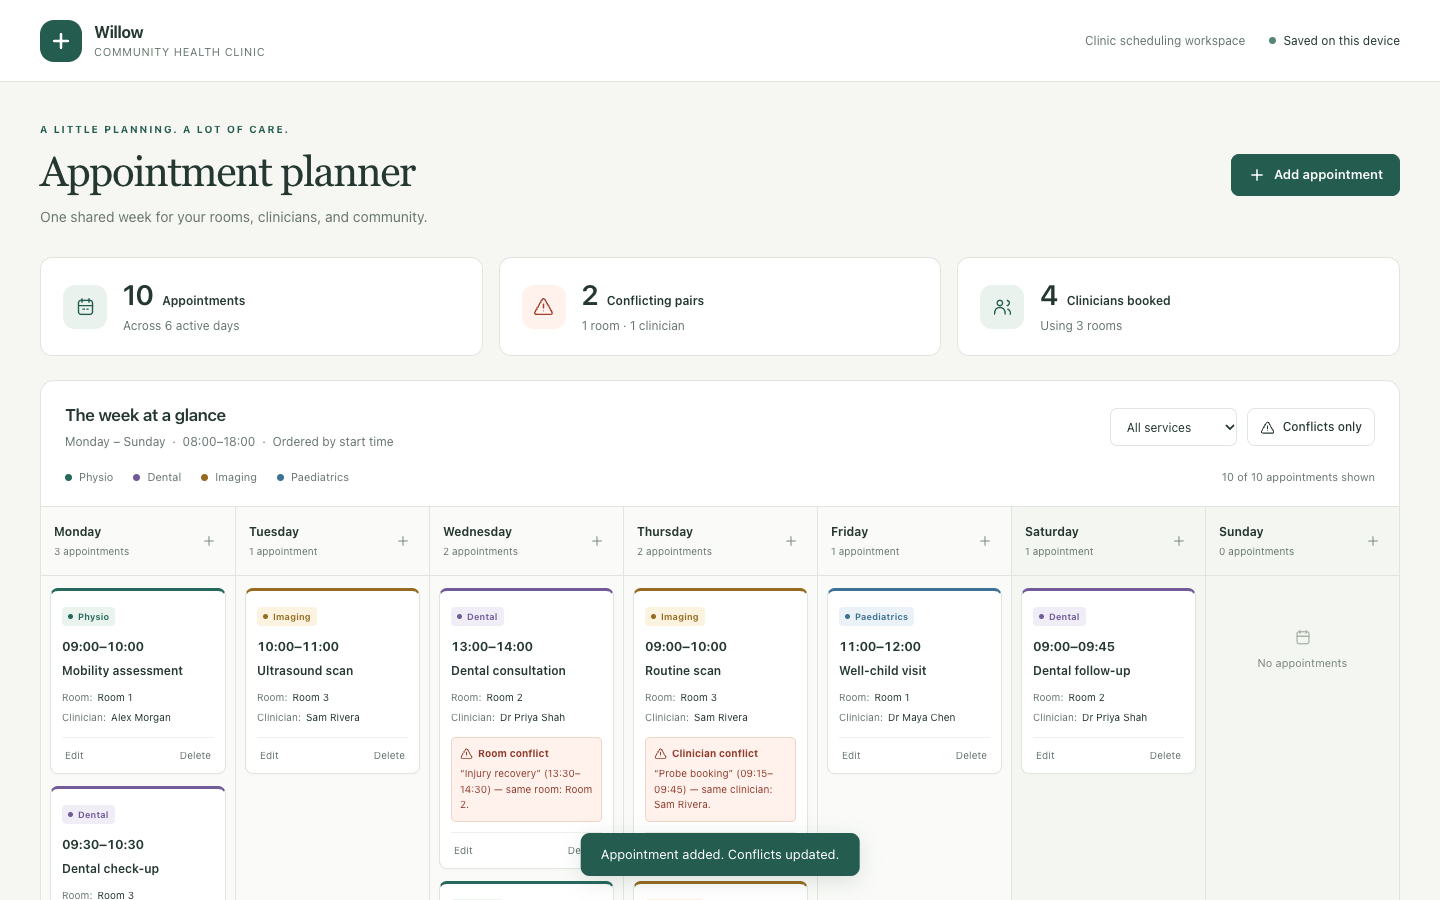
Hier ist der Scheduler von GPT-6.1 Sol, nachdem ich einen Termin verschoben, einen gelöscht und einen neuen hinzugefügt habe, der eine behandelnde Person doppelt belegt. Die neue Buchung am Donnerstag ist markiert und nennt den Termin, mit dem sie kollidiert:
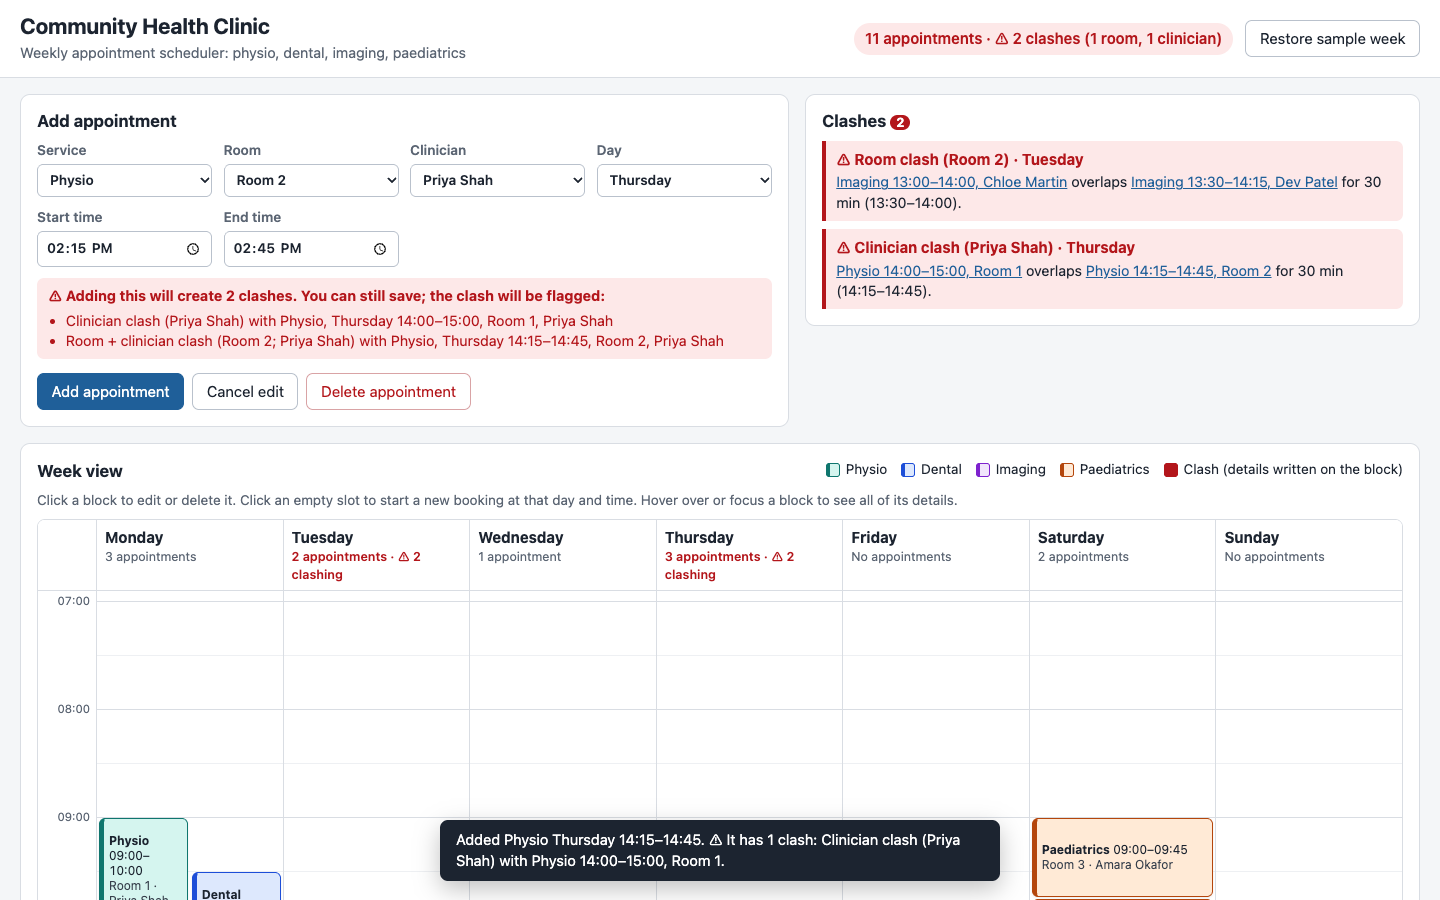
Und hier ist Opus 5.5 nach denselben Schritten, mit einem Konflikt-Panel, das jedes verbleibende Paar und die Dauer der Überlappung aufführt:
Die wichtigsten Erkenntnisse:
- Bei der Konfliktlogik trennte sich niemand. Beide Seiten starteten mit exakt zwei Raumkonflikten und einem Behandlerkonflikt, jeweils mit Benennung des anderen Termins und des Grundes, und beide ließen Back-to-back-Buchungen unberührt.
- Edits, Deletes und Reloads waren für beide kein Problem. Das Verschieben eines Termins in einen freien Raum löschte beide Hälften seines Konflikts, das Löschen einer Hälfte des Behandlerkonflikts klärte die andere, eine neue doppelte Belegung wurde korrekt markiert, und alles überstand einen Reload.
- Die Unterschiede lagen in der Präsentation. GPT-6.1 Sol baute die polishedere Seite mit Summary-Karten, Service-Filter und "Nur Konflikte"-Toggle, listet aber die Tagesbuchungen zeitlich statt auf einem Raster. Opus 5.5 ergänzte ein Konflikt-Panel mit Überlappungsdauern und warnt vor dem Speichern, doch das Wochenraster erfordert Scrollen.
- Opus 5.5 schrieb die kniffligere Seed-Woche. Sein Seed enthielt eine Überlappung in unterschiedlichen Räumen mit unterschiedlichen Behandlern.
Ich gab beiden 5 von 5 für Spez-Erfüllung und Konfliktlogik. GPT-6.1 Sol bekam 5 für Usability und Layout, Opus 5.5 erhielt 4, weil die Wochenansicht nicht auf einen Bildschirm passt.
Bei den Kosten trennten sie sich dann. Opus 5.5 verbrauchte mehr als doppelt so viele Output-Tokens – überwiegend fürs Denken:
- GPT-6.1 Sol: $0,27
- Claude Opus 5.5: $1,11
Wer gewinnt also? Auf diese Aufgabe bezogen: GPT-6.1 Sol – und zwar vor allem beim Preis. Beide lieferten einen korrekten, funktionsfähigen Scheduler, GPT-6.1 Sol tat das für rund ein Viertel der Kosten.
Wann du GPT-6.1 Sol vs. Claude Opus 5.5 wählst
Für die meisten Teams entscheidet der Preis pro Aufgabe: GPT-6.1 Sol erreicht die von OpenAI gemeldeten Scores für etwa ein Fünftel bis die Hälfte dessen, was Opus 5.5 ausgibt. Ausnahmen sind sehr lange Prompts, die letzten Prozente Erfolgsrate bei harten Runs und die Frage, wo du deployest.
Wähle GPT-6.1 Sol, wenn ...
- du Agenten in großer Stückzahl laufen lässt. Bei Business-Workflow-Automatisierung schlägt es Opus 5.5 bei medium Aufwand – zu rund einem Drittel der Kosten pro Aufgabe. Das summiert sich über Tausende Runs.
- deine Arbeit aus Fragen über dichten Dokumenten besteht. Es liegt auf OpenAIs PDF-Benchmark in jeder Aufwandstufe vor Opus 5.5 – bei weniger als der Hälfte der Kosten.
- dein Team bereits in ChatGPT Work oder Codex arbeitet. Es ist das von OpenAI empfohlene Modell für komplexes Coding und agentische Arbeit.
- ihr lange System-Prompts oder Kontext wiederverwendet. Gecachter Input für $0,10 pro Million Tokens macht wiederholungsintensive Agent-Loops günstig – solange jeder Prompt unter 272K Tokens bleibt.
Wähle Claude Opus 5.5, wenn ...
- deine Prompts regelmäßig 272K Tokens überschreiten. Der Aufschlag von GPT-6.1 Sol frisst den Preisvorteil weitgehend auf, während Opus 5.5 keinen Long-Context-Aufschlag hat.
- ein Fehllauf teurer ist als die Tokens. Bei maximalem Aufwand erzielt Opus 5.5 in OpenAIs eigener Grafik den höchsten AutomationBench-Score – inklusive GPT-6 Astra.
- du über Cursor, Amazon Bedrock oder Google Vertex AI deployest. Opus 5.5 ist auf allen drei gelistet; GPT-6.1 Sol ist in den Cursor- und Vertex-AI-Dokumenten noch nicht aufgeführt.
- du Anthropics konservative Defaults für unbeaufsichtigte Agenten willst. Die Safeguards routen riskante Security- und Biologie-Arbeit auf andere Modelle, statt sie zu versuchen.
So startest du mit GPT-6.1 Sol und Claude Opus 5.5
| Oberfläche | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| Consumer-App | ChatGPT Work und Codex (Plus, Pro, Business, Enterprise, Edu); noch nicht in Chat | Claude-Apps (Pro, Max, Team, Enterprise) |
| First-Party-API | OpenAI API (Tool-Calling über die Responses API) | Claude API |
| Cloud-Plattformen | Azure AI Foundry; in den Vertex-AI-Dokus Stand 30. September 2026 nicht gelistet | Amazon Bedrock, Google Vertex AI, Azure AI Foundry |
| Coding-Agenten | Codex, GitHub Copilot; in den Cursor-Dokus Stand 30. September 2026 nicht gelistet | Claude Code, Cursor, GitHub Copilot |
| Drittanbieter-Router | OpenRouter (openai/gpt-6.1-sol) | OpenRouter (anthropic/claude-opus-5.5) |
| API-Model-ID | gpt-6.1-sol |
claude-opus-5-5 |
Der größte Unterschied ist die Reichweite: Opus 5.5 ist auf allen drei großen Clouds und in Cursor vertreten, während GPT-6.1 Sol sich auf OpenAIs eigene Produkte, Azure und Copilot konzentriert.
Die erste API-Request
Die Modelle nutzen unterschiedliche SDKs – ein Wechsel erfordert also sowohl einen anderen Client als auch den Model-String:
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6.1-sol",
    reasoning={"effort": "medium"},
    input="Summarize the payment terms in this contract: ...",
)
print(response.output_text)
from anthropic import Anthropic
client = Anthropic()
response = client.messages.create(
model="claude-opus-5-5",
max_tokens=2048,
messages=[{"role": "user", "content": "Summarize the payment terms in this contract: ..."}],
)
print(next(b.text for b in response.content if b.type == "text"))Für vollständige Builds sieh dir unser GPT-6 Sol API Tutorial und das Opus 5.5 API Tutorial an, die ich oben bereits verlinkt habe.
Fazit
Ist der Preis pro Aufgabe dein Engpass, nutze GPT-6.1 Sol. Brauchst du die höchste Erfolgsquote bei harten Agent-Runs, arbeitest mit langen Prompts oder deployest über Cursor oder Bedrock, nimm Opus 5.5.
Aufschlussreich ist, dass OpenAIs eigene Charts für beide Seiten sprechen. Für die Headline wurde die Medium-Stufe gewählt, dieselbe Grafik zeigt aber Opus 5.5 bei maximalem Aufwand an der Spitze. OpenAI wettet darauf, dass den meisten Käufern der günstigere Punkt auf der Kurve wichtiger ist – und für Alltagsagenten halte ich das für richtig.
Weil Sol ein Mid-Tier-Modell ist, lohnt sich auch der Test GPT-6.1 Sol vs. Claude Sonnet 5.5.
Wenn du auf einem der beiden Modelle baust, empfehle ich dir unseren Lernpfad OpenAI Fundamentals oder den Kurs Introduction to Claude Models.