OpenAI aprovechó el DevDay del 29 de septiembre para lanzar GPT-6.1 Sol, una mejora de su modelo de gama media que, según afirma, se acerca al buque insignia GPT-6 Astra a una quinta parte del precio por token de Astra. Una semana antes, Anthropic presentó Claude Opus 5.5, posicionado como rendimiento de nivel Fable 5.1 con un 40% menos de coste.
Ambos son movimientos de eficiencia, y la nota de lanzamiento de OpenAI menciona directamente a Opus 5.5, reivindicando victorias en flujos de trabajo empresariales y trabajo con documentos a una fracción del coste por tarea. Aun así, los propios gráficos de OpenAI cuentan algo más matizado que el titular, porque la comparación cambia según el nivel de esfuerzo que elijas.
En este artículo comparamos GPT-6.1 Sol con Opus 5.5 sobre todo porque la nota de OpenAI plantea ese cara a cara, pero Claude Sonnet 5.5 también es una comparación razonable, que cubrimos en nuestro artículo GPT-6.1 Sol vs Claude Sonnet 5.5.
Resumen
- GPT-6.1 Sol lidera en coste por tarea: en todos los benchmarks que comparten, logra el resultado por una fracción del gasto de Opus 5.5.
- Sin embargo, la diferencia de precio casi desaparece en prompts de más de 272K tokens, donde entra en juego el recargo de GPT-6.1 Sol.
- Opus 5.5 mantiene el techo más alto en automatización de negocio y trabajo científico en terminal cuando lo ejecutas al máximo esfuerzo.
¿Qué es GPT-6.1 Sol?
GPT-6.1 Sol es el modelo de razonamiento de gama media de OpenAI dentro de la familia GPT-6, lanzado el 29 de septiembre de 2026 como actualización de GPT-6 Sol.
Su propuesta de valor son resultados cercanos a Astra en programación, uso del ordenador y trabajo profesional a un precio mucho menor, con lectura en caché más barata pensada para agentes que reutilizan contexto entre solicitudes.
Nuestra guía de GPT-6.1 Sol cubre el lanzamiento; nuestro tutorial del API de GPT-6 Sol construye un agente de migración de bases de código sobre la versión anterior.
¿Qué es Claude Opus 5.5?
Claude Opus 5.5 es el modelo Opus insignia de Anthropic, el primero de la familia Claude 5.5.
Anthropic lo posiciona para codificación agentiva de larga duración y trabajo de conocimiento, igualando a Claude Fable 5.1 en la mayoría de tareas a menor coste, con pensamiento adaptativo siempre activo.
Nuestra guía de Claude Opus 5.5 cubre el lanzamiento; nuestro tutorial del API de Opus 5.5 construye un investigador de incidentes de IA.
GPT-6.1 Sol vs Claude Opus 5.5: comparativa cara a cara
GPT-6.1 Sol y Opus 5.5 se solapan en solo tres benchmarks publicados, todos de los gráficos del lanzamiento de OpenAI. Opus 5.5 marca la mejor puntuación máxima en dos de ellos, y GPT-6.1 Sol alcanza sus resultados con entre 2 y 5 veces menos coste por tarea en los tres.
| Función | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| AutomationBench (mejor puntuación, coste por tarea) | 36,1% al máximo, 0,30 $ | 42,5% al máximo, 1,44 $ |
| GDP.pdf (mejor puntuación, coste por tarea) | 32,0% en alto, 0,35 $ | 28,8% en alto, 0,83 $ |
| Terminal-Bench Science 0.1 (esfuerzo máximo) | 57,0%, 5,47 $ | 63,3%, 23,21 $ |
| DeepSWE v1.1 | 75,2% en alto | No publicado |
| Terminal-Bench 4.0 | No publicado | 66,4% al máximo |
| Uso del ordenador | 71,4% en OSWorld 2.0 offline (máx.) | 81,8% en OSWorld 2.1 |
| Ventana de contexto / salida máxima | 1,05 M / 128K | 1 M / 128K |
| Fecha de corte de conocimiento | Abril de 2026 | Junio de 2026 |
| Niveles de esfuerzo | low, medium (predeterminado), high, xhigh, max | low, medium (predeterminado), high, xhigh, max |
Las tres primeras filas vienen de los gráficos de OpenAI, que etiquetan los resultados de Claude como «Opus 5.5 con fallbacks». El resto son cifras que cada proveedor reporta sobre su propio modelo.
Flujos de trabajo empresariales y documentos
Aquí es donde OpenAI planteó el pulso, y donde el nivel de esfuerzo decide el ganador.
El titular de OpenAI dice que GPT-6.1 Sol supera a Opus 5.5 por 2,2 puntos en AutomationBench, la prueba de Zapier sobre agentes que completan flujos multiherramienta. Es cierto a esfuerzo medio, donde GPT-6.1 Sol marca 31,7% a 0,19 $ por tarea frente al 29,5% de Opus 5.5 a 0,65 $.
Si subes ambos al máximo, el orden se invierte. Opus 5.5 escala hasta el 42,5%, por encima incluso de GPT-6 Astra, mientras GPT-6.1 Sol se queda en 36,1%. Opus 5.5 paga ese plus con casi 5 veces más coste por tarea, así que la cuestión es si seis puntos extra de éxito compensan para tu agente. Para un bot de soporte que gestiona miles de tickets, probablemente no. Para un flujo financiero donde un fallo implica rehacerlo a mano, quizá sí.
GPT-6.1 Sol ofrece mejor valor en trabajo con documentos y automatización del día a día. Opus 5.5 es la elección cuando las ejecuciones más difíciles tienen que salir bien.
Programación y trabajo científico
No hay un benchmark de código compartido, así que cada cifra va por separado. OpenAI afirma que GPT-6.1 Sol iguala a GPT-6 Astra en DeepSWE v1.1, que evalúa ingeniería de largo alcance en bases de código reales, mientras Anthropic reporta a Opus 5.5 por delante de GPT-6 Astra en Terminal-Bench 4.0 y FrontierCode.
En nuestra prueba práctica anterior, GPT-6 Sol, la versión previa, superó a Opus 5.5 en una construcción de Tetris con menos de un tercio del coste de ejecución (consulta nuestra comparativa GPT-6 Sol vs Claude Opus 5.5), así que sospechamos que GPT-6.1 Sol se impone.
Uso del ordenador
Aún no se pueden comparar directamente. OpenAI reporta GPT-6.1 Sol en el conjunto offline de OSWorld 2.0, a 2,1 puntos de GPT-6 Astra, mientras Anthropic reporta Opus 5.5 en OSWorld 2.1, una versión más reciente con tareas distintas. Ninguno publicó la versión del otro, así que los números de la tabla no son un cara a cara. Considera el uso del ordenador como «pendiente» hasta que alguien ejecute ambos en el mismo set.
Guardarraíles y restricciones de API
En la práctica, Opus 5.5 es el modelo más restringido. Anthropic deriva la mayoría de tareas de ciberseguridad a Opus 4.8 salvo que estés en su Cyber Verification Program, y el trabajo de biología pasa por mecanismos similares. Por eso los gráficos de OpenAI etiquetan sus resultados de Claude como «con fallbacks».
Las limitaciones de GPT-6.1 Sol están más en la API. No tiene ajustes de esfuerzo none o minimal, y las herramientas solo se invocan vía Responses API, no Chat Completions. Opus 5.5 mantiene el pensamiento adaptativo siempre activo y rechaza el uso forzado de herramientas. Para equipos de seguridad, el enrutado de Opus 5.5 es la diferencia práctica más grande; para desarrolladores que migran código, lo son los cambios de API de GPT-6.1 Sol.
Precios: lo que realmente vas a pagar
GPT-6.1 Sol cuesta exactamente la mitad que Opus 5.5 en todas las tarifas estándar, hasta que un prompt supera los 272K tokens de entrada.
Tarifas por token, lado a lado
| Tarifa | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| Entrada, por 1M de tokens | 2,00 $ | 4,00 $ |
| Salida, por 1M de tokens | 10,00 $ | 20,00 $ |
| Lectura de caché, por 1M de tokens | 0,10 $ | 0,20 $ |
| Escritura en caché, por 1M de tokens | 2,50 $ | 5,00 $ (5 minutos), 8,00 $ (1 hora) |
| Recargo por contexto largo | Más de 272K tokens de entrada: 2x en entrada y caché, 1,5x en salida para toda la solicitud | Ninguno |
| Descuento por batch | 50% | 50% |
| Modo rápido | 2x las tarifas estándar | 8 $ / 40 $ por 1M de tokens |
El multiplicador fijo 0,5x se mantiene en entrada, salida y lecturas de caché, así que para prompts de tamaño normal la comparación se reduce a «GPT-6.1 Sol cuesta la mitad». Ambos facturan los tokens de razonamiento como salida, lo que pesa más en Opus 5.5 porque su «pensamiento» no se puede desactivar.
Lo que cuesta una carga de trabajo real
| Caso | GPT-6.1 Sol | Claude Opus 5.5 | Diferencia |
|---|---|---|---|
| Asistente equilibrado: 1M in / 250K out | 4,50 $ | 9,00 $ | 4,50 $ (50% menos) |
| Retrieval, cada request por debajo de 272K: 10M in / 1M out | 30 $ | 60 $ | 30 $ (50% menos) |
| Retrieval, cada request por encima de 272K: 10M in / 1M out | 55 $ | 60 $ | 5 $ (8% menos) |
Cada total es (volumen ÷ 1M) × tarifa, sumado entre entrada y salida, a tarifas estándar.
- Asistente equilibrado: el caso de mitad de precio puro, y el que más se parece a la mayoría de chats y agentes.
- Retrieval por debajo del umbral: sigue siendo la mitad, así que los montajes de RAG que mantienen cada prompt pequeño capturan todo el ahorro.
- Retrieval por encima del umbral: el recargo duplica la tarifa de entrada de GPT-6.1 Sol hasta el nivel de Opus 5.5, y el ahorro se queda en casi nada. Si tus prompts arrastran repos completos, presupón que cuestan parecido.
Ambos usan tokenizadores distintos y ninguno ha publicado conteos para una carga compartida, así que trata estos totales como una comparación de tarifas, no como una factura.
Cómo rindieron GPT-6.1 Sol y Claude Opus 5.5
Los benchmarks de arriba son de los propios proveedores, así que ejecuté una tarea de construcción contra GPT-6.1 Sol y Claude Opus 5.5 con el mismo prompt y las mismas herramientas.
La tarea: un planificador de citas en HTML de un solo archivo para una clínica comunitaria, con vista semanal de lunes a domingo para fisio, odontología, imagen y pediatría; formulario para añadir, editar y borrar citas; persistencia en localStorage; y una semana de ejemplo con unas diez citas. Sin build, sin dependencias, sin red.
La parte complicada es la lógica de conflictos, que debe cumplir varias reglas a la vez:
- Dos citas chocan si se solapan en la misma sala o si se solapan con el mismo profesional
- Las seguidas, donde una termina justo cuando empieza la siguiente, no deben chocar
- Cada aviso debe nombrar la otra cita y el motivo, no solo ponerse en rojo
- Los avisos deben actualizarse tras cada edición y borrado, y sobrevivir a un recarga
- La semana inicial debe incluir exactamente dos choques de sala y uno de profesional
Me gusta esta prueba porque pone a prueba la afirmación de OpenAI de que GPT-6.1 Sol iguala a GPT-6 Astra en ingeniería de bases de código reales y el planteamiento de Anthropic para Opus 5.5 como agente de codificación de larga duración.
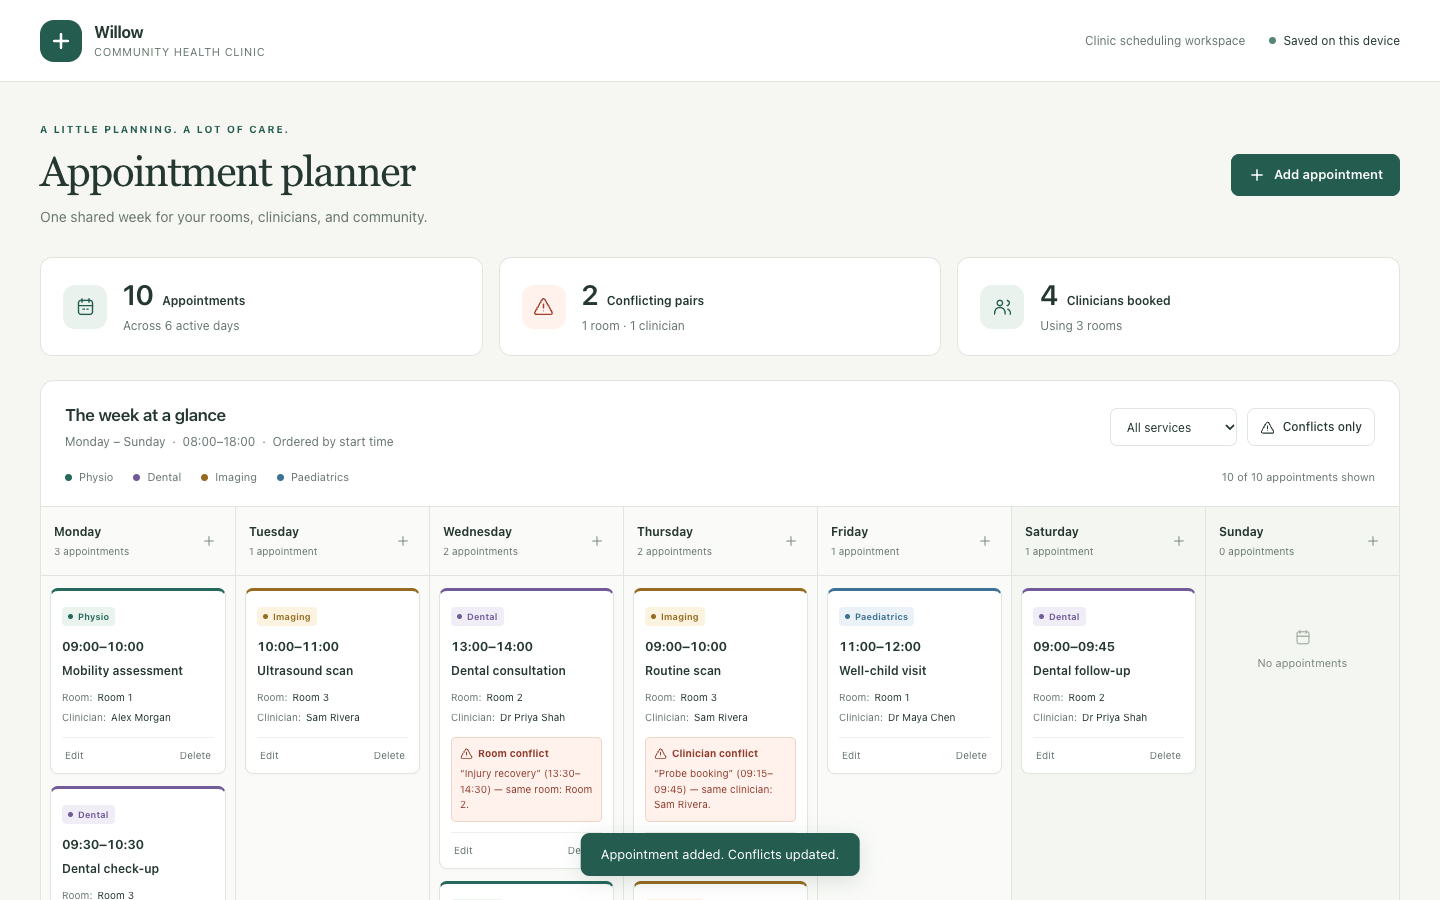
Aquí tienes el planificador de GPT-6.1 Sol después de mover una cita, borrar otra y añadir una nueva que duplica a un profesional. La nueva cita del jueves aparece marcada, con el nombre de la cita con la que choca:
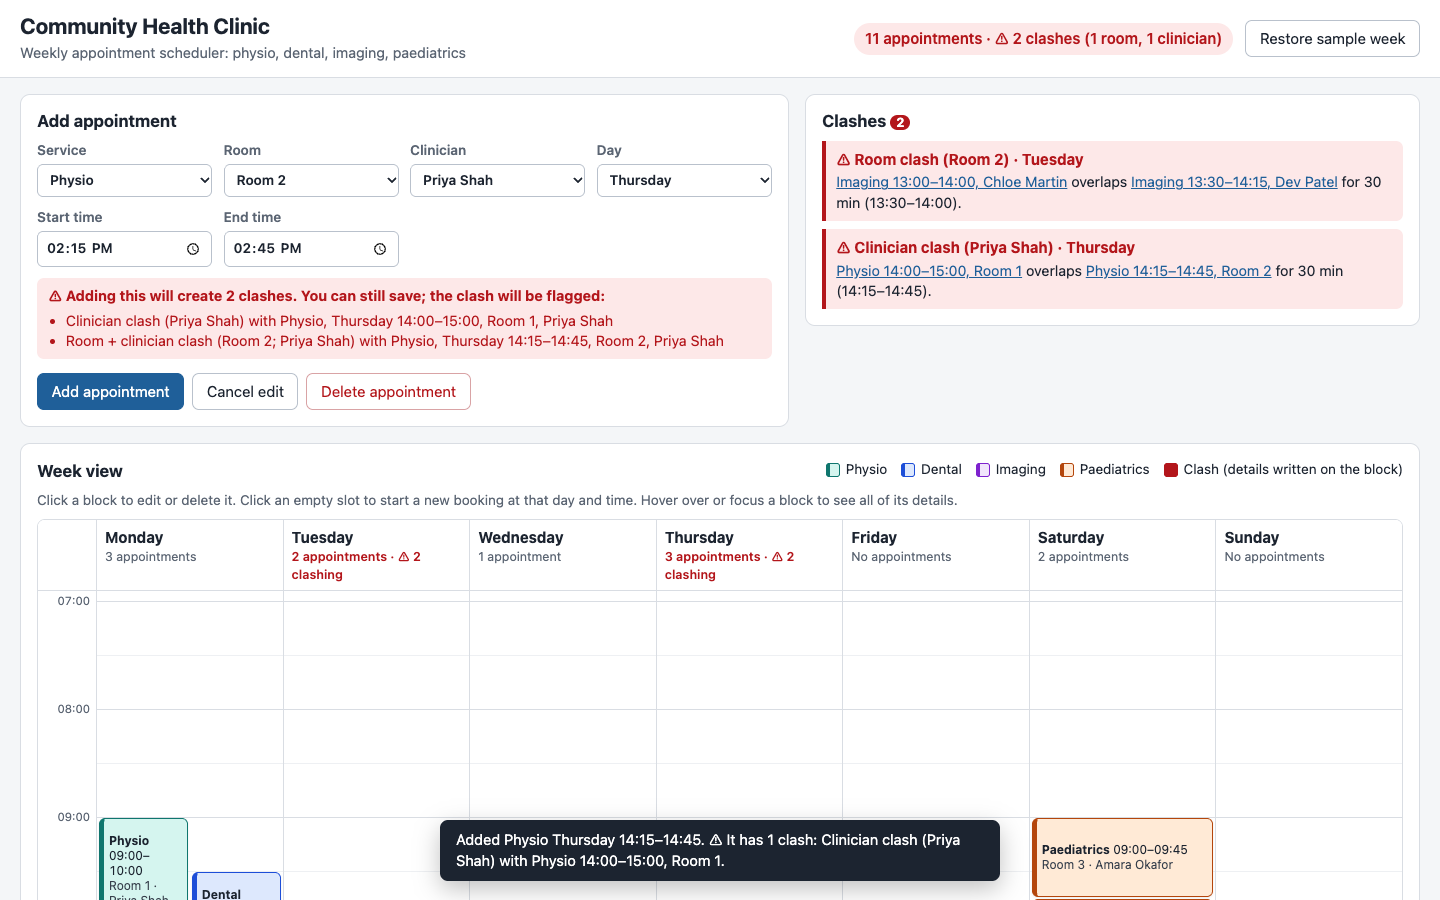
Y aquí el de Opus 5.5 tras los mismos pasos, con un panel de choques que lista cada par restante y cuánto dura el solapamiento:
Conclusiones principales:
- En la lógica de conflictos, no hubo diferencias. Ambas páginas abrieron con exactamente dos choques de sala y uno de profesional marcados, nombrando la otra cita y el motivo, y ambas respetaron las citas consecutivas.
- Ediciones, borrados y recargas tampoco fallaron. Mover una cita a una sala libre limpió ambas mitades del choque, borrar una mitad del choque de profesional limpió la otra, una nueva cita que duplicaba a un profesional se marcó correctamente y todo sobrevivió a una recarga.
- Las diferencias fueron de presentación. GPT-6.1 Sol creó una página más pulida, con tarjetas de resumen, filtro por servicio y un conmutador «Solo conflictos», pero lista las citas del día en orden temporal en lugar de una rejilla horaria. Opus 5.5 añadió un panel de choques que muestra la duración de cada solapamiento y avisa antes de guardar, pero su vista semanal requiere scroll.
- Opus 5.5 escribió la semana de ejemplo más retadora. Incluyó un solapamiento en salas distintas con profesionales distintos.
Puntué a ambos con 5 sobre 5 en adherencia a especificaciones y lógica de conflictos. GPT-6.1 Sol obtuvo 5 en usabilidad y diseño, y Opus 5.5 un 4 porque su vista semanal no cabe en una sola pantalla.
La diferencia llegó en el coste. Opus 5.5 gastó más del doble de tokens de salida, la mayoría en «pensar»:
- GPT-6.1 Sol: 0,27 $
- Claude Opus 5.5: 1,11 $
¿Quién gana entonces? En esta tarea, GPT-6.1 Sol, y casi solo por precio. Ambos entregaron un planificador correcto y funcional, y GPT-6.1 Sol lo hizo por alrededor de una cuarta parte del coste.
Cuándo elegir GPT-6.1 Sol vs Claude Opus 5.5
Para la mayoría de equipos, la clave es el coste por tarea: GPT-6.1 Sol alcanza las puntuaciones que reporta OpenAI por aproximadamente entre una quinta parte y la mitad de lo que gasta Opus 5.5. Las excepciones son los prompts largos, exprimir los últimos puntos de éxito en ejecuciones difíciles y dónde despliegas.
Elige GPT-6.1 Sol si…
- Ejecutas agentes a gran escala. En automatización de flujos de negocio, supera a Opus 5.5 a esfuerzo medio por alrededor de un tercio del coste por tarea, lo que se multiplica en miles de ejecuciones.
- Tu trabajo son preguntas sobre documentos densos. Lidera a Opus 5.5 en el benchmark de PDF de OpenAI en todos los niveles de esfuerzo, a menos de la mitad del coste.
- Tu equipo ya usa ChatGPT Work o Codex. Es el modelo que OpenAI recomienda allí para codificación compleja y trabajo agentivo.
- Reutilizas prompts de sistema o contexto largos. La entrada en caché a 0,10 $ por millón de tokens abarata los bucles de agentes con mucho contexto repetido, siempre que cada prompt quede por debajo de 272K tokens.
Elige Claude Opus 5.5 si…
- Tus prompts superan a menudo los 272K tokens. El recargo de GPT-6.1 Sol borra gran parte de su ventaja de precio ahí, y Opus 5.5 no tiene recargo por contexto largo.
- Una ejecución fallida cuesta más que los tokens. Al máximo esfuerzo, Opus 5.5 marca la mayor puntuación en AutomationBench en el propio gráfico de OpenAI, por encima de GPT-6 Astra.
- Despliegas en Cursor, Amazon Bedrock o Google Vertex AI. Opus 5.5 está listado en los tres; GPT-6.1 Sol aún no aparece en la documentación de Cursor ni de Vertex AI.
- Prefieres los valores conservadores de Anthropic para agentes desatendidos. Sus salvaguardas desvían trabajo de seguridad y biología arriesgado a otros modelos en lugar de intentarlo.
Cómo empezar con GPT-6.1 Sol y Claude Opus 5.5
| Superficie | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| App para consumidor | ChatGPT Work y Codex (Plus, Pro, Business, Enterprise, Edu); aún no en Chat | Apps de Claude (Pro, Max, Team, Enterprise) |
| API de primera parte | OpenAI API (llamadas a herramientas vía Responses API) | Claude API |
| Plataformas cloud | Azure AI Foundry; no listado en la documentación de Vertex AI a 30 de septiembre de 2026 | Amazon Bedrock, Google Vertex AI, Azure AI Foundry |
| Agentes de código | Codex, GitHub Copilot; no listado en la documentación de Cursor a 30 de septiembre de 2026 | Claude Code, Cursor, GitHub Copilot |
| Routers de terceros | OpenRouter (openai/gpt-6.1-sol) | OpenRouter (anthropic/claude-opus-5.5) |
| ID de modelo en API | gpt-6.1-sol |
claude-opus-5-5 |
La mayor diferencia es el alcance: Opus 5.5 está en las tres nubes principales y en Cursor, mientras que GPT-6.1 Sol se centra en los productos de OpenAI, Azure y Copilot.
Hacer tu primera llamada al API
Los dos modelos usan SDK diferentes, así que cambiar implica modificar el cliente además del nombre del modelo:
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6.1-sol",
    reasoning={"effort": "medium"},
    input="Summarize the payment terms in this contract: ...",
)
print(response.output_text)
from anthropic import Anthropic
client = Anthropic()
response = client.messages.create(
model="claude-opus-5-5",
max_tokens=2048,
messages=[{"role": "user", "content": "Summarize the payment terms in this contract: ..."}],
)
print(next(b.text for b in response.content if b.type == "text"))Para implementaciones completas, consulta nuestro tutorial del API de GPT-6 Sol y nuestro tutorial del API de Opus 5.5, que ya compartimos arriba.
Conclusión
Si tu restricción es el coste por tarea, usa GPT-6.1 Sol. Si necesitas la mayor tasa de éxito en ejecuciones difíciles, envías prompts largos o despliegas vía Cursor o Bedrock, usa Opus 5.5.
Lo más revelador es que los propios gráficos de OpenAI apoyan a ambos. Eligió el punto de esfuerzo medio para el titular, pero el mismo gráfico muestra a Opus 5.5 arriba al máximo esfuerzo. OpenAI apuesta a que la mayoría valora el punto barato de la curva y, para agentes del día a día, creo que acierta.
Como Sol es un modelo de gama media, también merece la pena probar GPT-6.1 Sol vs Claude Sonnet 5.5.
Y si vas a construir con cualquiera de los dos, te recomiendo nuestro itinerario de habilidades OpenAI Fundamentals o el curso Introduction to Claude Models.