OpenAI は 9 月 29 日の DevDay で、中位モデルのアップグレード版である GPT-6.1 Sol を発表しました。フラグシップの GPT-6 Astra に肉薄しつつ、トークン単価は Astra の 5 分の 1だとしています。その 1 週間前、Anthropic は Claude Opus 5.5 をリリースし、Fable 5.1 相当の性能を 40% 安く提供すると打ち出しました。
いずれも「効率」を掲げる発表で、OpenAI のローンチ記事は Opus 5.5 を名指しし、ビジネスワークフローとドキュメント作業でタスク当たりコストのごく一部で勝ると主張しています。ただし、OpenAI 自身のチャートは見出し以上に示唆的で、どの「effort(思考強度)」設定を見るかで比較結果が変わります。
本記事では OpenAI のローンチ記事が直接引き合いに出した GPT-6.1 Sol と Opus 5.5 を主に比較しますが、Claude Sonnet 5.5 との比較も妥当です。詳しくは GPT-6.1 Sol と Claude Sonnet 5.5 の比較をご覧ください。
TL;DR
- GPT-6.1 Sol はタスク当たりコストで優位:両モデルが共通で提示するすべてのベンチマークで、Opus 5.5 の一部の費用で到達。
- ただし、272K トークン超のプロンプトでは GPT-6.1 Sol のサーチャージが発動し、価格差の大半は消えます。
- 最大努力で回すと、ビジネス自動化と科学系ターミナル作業における上限値は依然として Opus 5.5 のほうが高い。
GPT-6.1 Sol とは?
GPT-6.1 Sol は GPT-6 ファミリーにおける OpenAI の中位推論モデルで、2026 年 9 月 29 日に GPT-6 Sol のアップグレードとしてリリースされました。
コーディング、PC 操作、プロフェッショナルワークで Astra に近い結果をより安価に提供することが売りで、リクエスト間でコンテキストを再利用するエージェント向けに、キャッシュ読み込みの入力が安価です。
GPT-6.1 Sol ガイドでローンチの概要を、前バージョンを用いたコードベース移行エージェントの構築は GPT-6 Sol API チュートリアルで解説しています。
Claude Opus 5.5 とは?
Claude Opus 5.5 は Anthropic のフラグシップ Opus モデルで、Claude 5.5 ファミリーの最初のモデルとして登場しました。
Anthropic はこれを、長時間走るエージェント型のコーディングやナレッジワーク向けに位置づけ、ほとんどのタスクで Claude Fable 5.1 並みの性能をより低コストで、常時有効のアダプティブ思考とともに提供するとしています。
Claude Opus 5.5 ガイドでローンチの詳細を、AI インシデント調査員の構築は Opus 5.5 API チュートリアルで紹介しています。
GPT-6.1 Sol と Claude Opus 5.5:項目別の比較
GPT-6.1 Sol と Opus 5.5 が重なる公開ベンチマークは、OpenAI のローンチチャートにある 3 本のみです。うち 2 本では Opus 5.5 が最高スコアを更新し、3 本すべてで GPT-6.1 Sol はタスク当たり 2~5 倍安く同等の結果に到達しています。
| 項目 | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| AutomationBench(最高スコア、タスク当たりコスト) | 最大で 36.1%、$0.30 | 最大で 42.5%、$1.44 |
| GDP.pdf(最高スコア、タスク当たりコスト) | 高で 32.0%、$0.35 | 高で 28.8%、$0.83 |
| Terminal-Bench Science 0.1(最大努力) | 57.0%、$5.47 | 63.3%、$23.21 |
| DeepSWE v1.1 | 高で 75.2% | 非公開 |
| Terminal-Bench 4.0 | 非公開 | 最大で 66.4% |
| PC 操作 | OSWorld 2.0 オフライン(最大)で 71.4% | OSWorld 2.1 で 81.8% |
| コンテキスト窓 / 最大出力 | 1.05M / 128K | 1M / 128K |
| ナレッジカットオフ | 2026 年 4 月 | 2026 年 6 月 |
| Effort レベル | low、medium(既定)、high、xhigh、max | low、medium(既定)、high、xhigh、max |
最初の 3 行は OpenAI のチャートに基づき、Claude の結果は「Opus 5.5 w/ fallbacks」と明記されています。その他は各ベンダーが自社モデルについて報告した数値です。
ビジネスワークフローとドキュメント
OpenAI が争点に据えた領域で、勝敗は effort 設定で決まります。
OpenAI の見出しは、Zapier のマルチステップ業務ツール横断エージェントテストである AutomationBench で、GPT-6.1 Sol が Opus 5.5 を 2.2 ポイント上回るとしています。これは medium(中)で真で、GPT-6.1 Sol が 31.7%(タスク当たり $0.19)、Opus 5.5 が 29.5%(タスク当たり $0.65)です。
両者を max(最大)に上げると順序は逆転します。Opus 5.5 は 42.5% に達し、GPT-6 Astra さえ上回る一方、GPT-6.1 Sol は 36.1% で頭打ち。代償はタスク当たりコストがほぼ 5 倍になる点で、6 ポイントの成功率差に費用対効果があるかはユースケース次第です。数千件を捌くサポートボットなら、おそらく不要。失敗すると人手でやり直すファイナンス業務なら、あり得ます。
日常的なドキュメント作業と自動化では GPT-6.1 Sol が高コスパ。最難関のワークフローを確実に通したいなら Opus 5.5 を選びます。
コーディングと科学系の作業
共通のコーディング系ベンチマークはなく、表の数値は各社の自己申告です。OpenAI は、実コードベースでの長期工程を測る DeepSWE v1.1 で GPT-6.1 Sol が GPT-6 Astra に並ぶとし、Anthropic は Opus 5.5 が Terminal-Bench 4.0 と FrontierCode で GPT-6 Astra を上回ると報告しています。
以前の実地テストでは前バージョンの GPT-6 Sol が、テトリス構築で Opus 5.5 をコスト 3 分の 1 未満で上回りました(GPT-6 Sol と Claude Opus 5.5 の比較参照)。そのため、GPT-6.1 Sol が優位と推測します。
PC 操作
ここはまだ直接比較できません。OpenAI は GPT-6.1 Sol を OSWorld 2.0 のオフラインセットで評価し、GPT-6 Astra に 2.1 ポイント差まで迫ったと報告。一方、Anthropic は異なる課題を含む新バージョンの OSWorld 2.1 で Opus 5.5 を報告。互いのバージョンでの数値は未公開のため、表の数値は正面比較ではありません。同一セットでの結果が出るまで保留と見るべきです。
ガードレールと API 制約
実運用では Opus 5.5 のほうが制約が強めです。Anthropic は多くのサイバーセキュリティタスクを、Opus 4.8 にフォールバックさせます(Cyber Verification Program 参加者を除く)。生物学関連も同様のフォールバック経路があります。OpenAI のチャートに Claude の結果が「fallbacks あり」とあるのはそのためです。
GPT-6.1 Sol の制約は API 側にあります。none や minimal の effort 設定がなく、ツール呼び出しは Chat Completions ではなく Responses API 経由のみ。Opus 5.5 はアダプティブ思考が常時有効で、ツールの強制使用は拒否します。セキュリティチームにとって実務上の違いは Opus 5.5 のルーティング、コード移行の開発者にとっては GPT-6.1 Sol の API 変更がポイントです。
価格:実際に払う金額
標準レートでは、272K 入力トークンを超えるまでは、GPT-6.1 Sol はあらゆる単価でちょうど Opus 5.5 の半額です。
トークン単価の並列表
| レート | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| 入力(100 万トークン当たり) | $2.00 | $4.00 |
| 出力(100 万トークン当たり) | $10.00 | $20.00 |
| キャッシュ読み取り(100 万トークン当たり) | $0.10 | $0.20 |
| キャッシュ書き込み(100 万トークン当たり) | $2.50 | $5.00(5 分)、$8.00(1 時間) |
| 長文コンテキストのサーチャージ | 入力 272K トークン超:リクエスト全体に入力・キャッシュ 2 倍、出力 1.5 倍 | なし |
| バッチ割引 | 50% | 50% |
| 高速モード | 標準レートの 2 倍 | 100 万トークン当たり $8 / $40 |
入力・出力・キャッシュ読み取りのすべてで一律に 0.5 倍なので、通常サイズのプロンプトでは「GPT-6.1 Sol は半額」に集約されます。両モデルとも推論トークンは出力として課金されます。思考をオフにできない Opus 5.5 では、この影響がより大きくなります。
実運用ワークロードにかかる費用
| ワークロード | GPT-6.1 Sol | Claude Opus 5.5 | 差分 |
|---|---|---|---|
| バランス型アシスタント:入力 100 万 / 出力 25 万 | $4.50 | $9.00 | $4.50(50% 安) |
| リトリーバル、各リクエストが 272K 未満:入力 1000 万 / 出力 100 万 | $30 | $60 | $30(50% 安) |
| リトリーバル、各リクエストが 272K 超:入力 1000 万 / 出力 100 万 | $55 | $60 | $5(8% 安) |
各合計は(ボリューム ÷ 100 万)× 単価を入力・出力で合算した標準レートでの計算です。
- バランス型アシスタント: 典型的な半額ケース。多くのチャットやエージェントの実態に近い。
- しきい値未満のリトリーバル: 依然として半額。各プロンプトを小さく保つ RAG 構成ではフルに節約できます。
- しきい値超のリトリーバル: サーチャージで GPT-6.1 Sol の入力単価が Opus 5.5 と同水準に倍増し、差はごく小さく。プロンプトが常にコードベース丸ごと級なら、両者同等のコストで予算化してください。
両ベンダーでトークナイザーが異なり、共通ワークロードのトークン数は未公開のため、ここでの合計は請求額というより単価比較として扱ってください。
GPT-6.1 Sol と Claude Opus 5.5 の実測
上記ベンチマークはベンダー提供なので、同一プロンプト・同一ツールでビルドタスクを 1 本、GPT-6.1 Sol と Claude Opus 5.5 に実施しました。
タスク:地域医療クリニック向けの単一 HTML ファイルの予約スケジューラー。理学療法・歯科・画像診断・小児科の月曜~日曜週表示、追加/編集/削除フォーム、localStorage 永続化、約 10 件のサンプル週をシード。ビルド不要、依存なし、ネットワークなし。
難所は競合ロジックで、同時に複数の規則を満たす必要があります。
- 同じ部屋で重なる、または同じ担当者で重なる予約は競合とみなす
- 終了時刻と開始時刻がちょうど接する背中合わせ予約は競合にしない
- フラグは赤くするだけでなく、相手の予約と理由を必ず明示する
- 編集・削除のたびにフラグが更新され、リロード後も維持される
- シード週には部屋の競合をちょうど 2 件、担当者の競合を 1 件含める
このテストは、実コードベースのエンジニアリングで GPT-6.1 Sol が GPT-6 Astra に並ぶという OpenAI の主張と、Opus 5.5 を長時間走るコーディングエージェントとして位置づける Anthropic の訴求を検証できます。
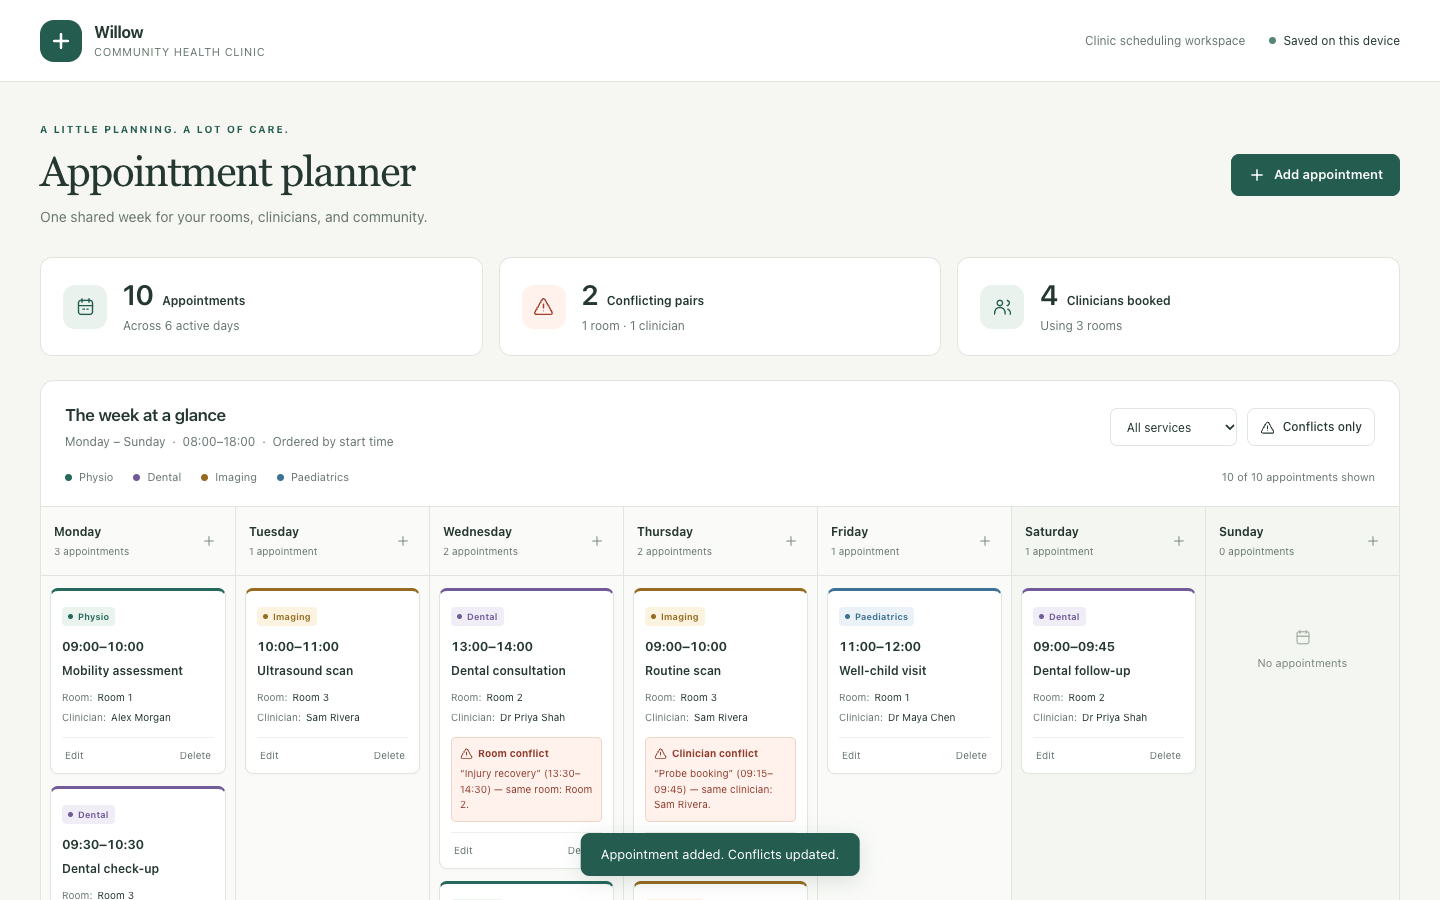
以下は、予約を移動・1 件削除・担当者を二重予約する新規追加を行った後の GPT-6.1 Sol のスケジューラーです。木曜の新規予約にフラグが立ち、競合相手が明示されています。
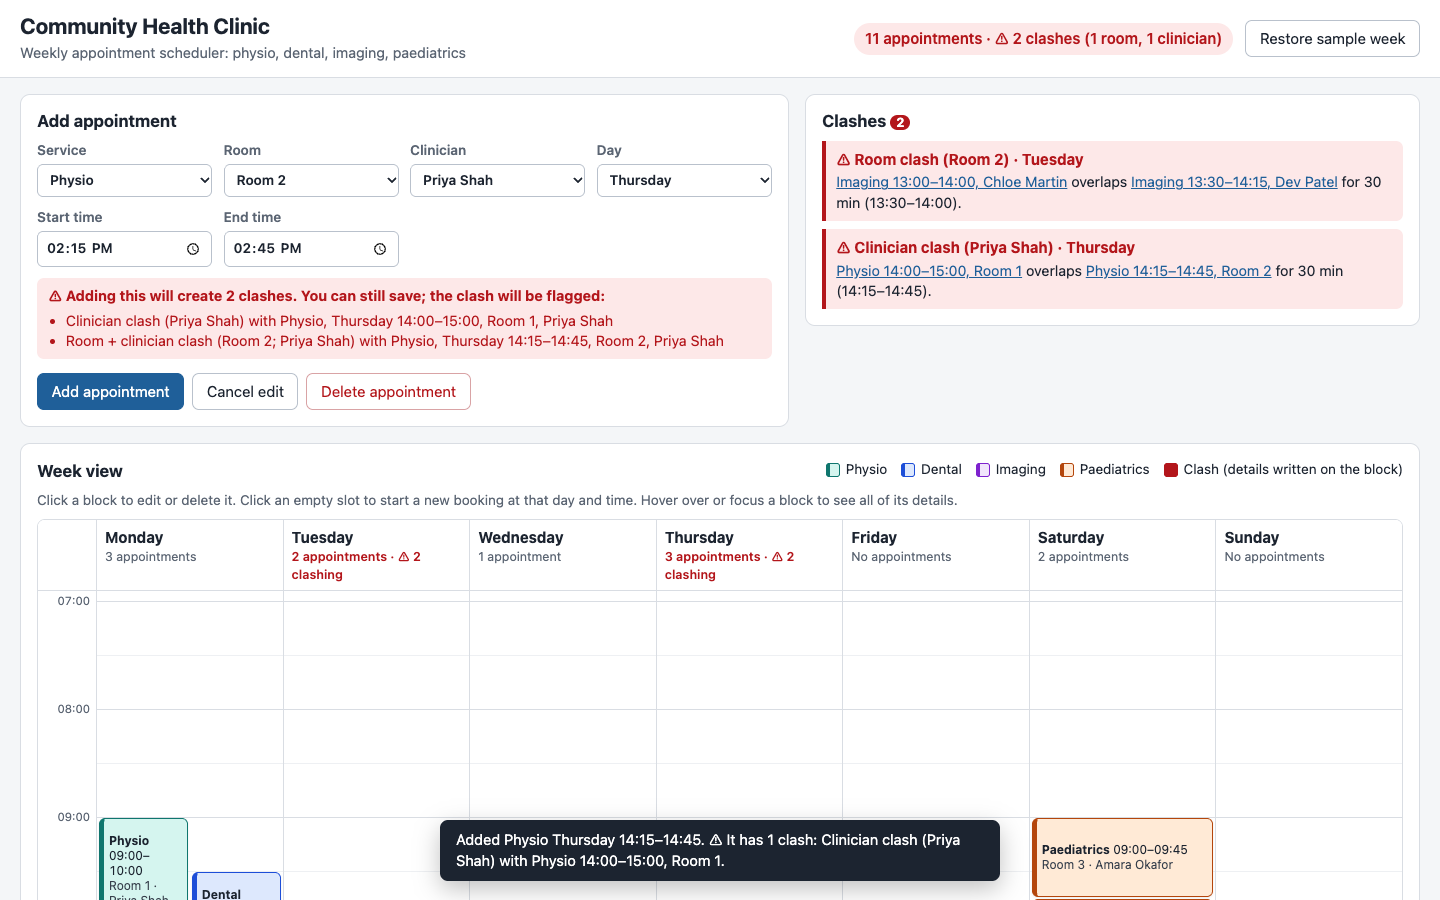
同じ手順後の Opus 5.5 は、競合パネルに残る各ペアと重複時間を表示します。
主な所見:
- 競合ロジックでの優劣はなし。 両ページとも初期状態で部屋 2 件・担当者 1 件の競合に正しくフラグが立ち、相手予約名と理由を表示。背中合わせ予約は両者とも問題なし。
- 編集・削除・リロードも問題なし。 予約を空き部屋に動かすと両方の競合が解消、担当者競合の一方を削除すると相手側も解消、新規の担当者二重予約は正しくフラグ、すべてリロード後も維持。
- 差はプレゼンテーションのみ。 GPT-6.1 Sol は要約カード、サービス絞り込み、「競合のみ」トグルを備え仕上がりが洗練。一方で日別リストが時間グリッドではなく時刻順。Opus 5.5 は重複時間を示す競合パネルと保存前警告を追加したが、週表示はスクロールが必要。
- サンプル週は Opus 5.5 のほうが手強い構成。 異なる部屋・異なる担当者での重複を含めていました。
仕様順守と競合ロジックは両者 5/5。使い勝手とレイアウトは GPT-6.1 Sol が 5、Opus 5.5 は週表示が一画面に収まらないため 4 と評価。
分かれたのはコストです。Opus 5.5 は出力トークンが 2 倍超で、その多くが思考に費やされました。
- GPT-6.1 Sol:$0.27
- Claude Opus 5.5:$1.11
では勝者は? このタスクでは GPT-6.1 Sol。主に価格面です。両者とも正しく動くスケジューラーを納品し、GPT-6.1 Sol はおよそ 4 分の 1 のコストでした。
GPT-6.1 Sol と Claude Opus 5.5 の使い分け
多くのチームにとって分岐はタスク当たりコストです。OpenAI の報告値への到達に、GPT-6.1 Sol は Opus 5.5 のおよそ 5 分の 1~半分で済みます。例外は長大プロンプト、難案件で最後の数ポイントを取りに行く場合、そしてデプロイ先です。
次のような場合は GPT-6.1 Sol を
- 大量のエージェント運用を行う。 ビジネスワークフロー自動化で medium 設定なら、Opus 5.5 を上回る性能をタスク当たり約 3 分の 1 の費用で達成し、積み上げ効果が大きい。
- 高密度ドキュメントへの質問が中心。 PDF ベンチマークで全設定にわたり Opus 5.5 を上回り、コストは半額未満。
- 既に ChatGPT Work や Codex を使っている。 複雑なコーディングやエージェント作業向けに OpenAI が推奨するモデルです。
- 長いシステムプロンプトやコンテキストを再利用する。 100 万トークン当たり $0.10 のキャッシュ読み取りで、繰り返しが多いエージェントループが安価に。ただし各プロンプトが 272K トークン未満であること。
次のような場合は Claude Opus 5.5 を
- プロンプトが常時 272K トークンを超える。 GPT-6.1 Sol のサーチャージで価格優位がほぼ消え、Opus 5.5 には長文サーチャージがありません。
- 失敗 1 回の損失がトークン費用を上回る。 最大努力では、OpenAI 自身のチャートで Opus 5.5 が AutomationBench の最高スコア(GPT-6 Astra を含む)を記録。
- Cursor、Amazon Bedrock、Google Vertex AI で運用する。 Opus 5.5 は 3 プラットフォームすべてに掲載。GPT-6.1 Sol は Cursor と Vertex AI のドキュメントにはまだ未掲載です。
- 無人エージェントに Anthropic の保守的デフォルトを求める。 リスキーなセキュリティ/生物系タスクは他モデルへルーティングし、試みない設計です。
GPT-6.1 Sol と Claude Opus 5.5 の始め方
| サーフェス | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| コンシューマーアプリ | ChatGPT Work と Codex(Plus、Pro、Business、Enterprise、Edu);Chat には未搭載 | Claude アプリ(Pro、Max、Team、Enterprise) |
| ファーストパーティ API | OpenAI API(ツール呼び出しは Responses API 経由) | Claude API |
| クラウドプラットフォーム | Azure AI Foundry;2026 年 9 月 30 日時点で Vertex AI のドキュメント未掲載 | Amazon Bedrock、Google Vertex AI、Azure AI Foundry |
| コーディングエージェント | Codex、GitHub Copilot;2026 年 9 月 30 日時点で Cursor のドキュメント未掲載 | Claude Code、Cursor、GitHub Copilot |
| サードパーティルーター | OpenRouter(openai/gpt-6.1-sol) | OpenRouter(anthropic/claude-opus-5.5) |
| API モデル ID | gpt-6.1-sol |
claude-opus-5-5 |
最大の違いはリーチです。Opus 5.5 は 3 大クラウドすべてと Cursor に展開され、GPT-6.1 Sol は OpenAI 自社製品と Azure、Copilot を中心に展開されています。
最初の API コール
2 つのモデルは SDK が異なるため、モデル文字列だけでなくクライアントも切り替える必要があります。
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6.1-sol",
    reasoning={"effort": "medium"},
    input="Summarize the payment terms in this contract: ...",
)
print(response.output_text)
from anthropic import Anthropic
client = Anthropic()
response = client.messages.create(
model="claude-opus-5-5",
max_tokens=2048,
messages=[{"role": "user", "content": "Summarize the payment terms in this contract: ..."}],
)
print(next(b.text for b in response.content if b.type == "text"))フル構築の参考には、前述の GPT-6 Sol API チュートリアル と Opus 5.5 API チュートリアルをご覧ください。
まとめ
制約がタスク当たりコストなら GPT-6.1 Sol。難案件で最高の成功率が必要、長大プロンプトを送る、あるいは Cursor や Bedrock で展開するなら Opus 5.5。
示唆的なのは、OpenAI 自身のチャートが両者の言い分を裏づけていることです。見出しは medium を選びましたが、同じチャートで max では Opus 5.5 がトップ。OpenAI は、多くの購買者が曲線の安価な点を重視すると読んでおり、日常のエージェント用途ではその通りだと思います。
Sol は中位モデルなので、GPT-6.1 Sol 対 Claude Sonnet 5.5 も試す価値があります。
どちらかで開発するなら、OpenAI Fundamentals スキルトラックや、Introduction to Claude Models コースをおすすめします。