OpenAI använde DevDay den 29 september för att lansera GPT-6.1 Sol, en uppgradering av deras mellanklassmodell som enligt dem närmar sig flaggskeppet GPT-6 Astra till en femtedel av Astras tokenpriser. En vecka tidigare lanserade Anthropic Claude Opus 5.5, presenterad som prestanda i klass med Fable 5.1 för 40% mindre.
Det här är effektivitetssatsningar, och OpenAIs lanseringsinlägg nämner Opus 5.5 direkt, med påståenden om vinster i affärsarbetsflöden och dokumentarbete till en bråkdel av kostnaden per uppgift. OpenAIs egna diagram berättar dock en mer intressant historia än rubriken, eftersom jämförelsen skiftar beroende på vilken ansträngningsnivå du tittar på.
I den här artikeln jämför vi GPT-6.1 Sol med Opus 5.5 främst för att OpenAIs lanseringsinlägg gör den kopplingen direkt, men Claude Sonnet 5.5 är en annan rättvis jämförelse som vi går igenom i vår artikel GPT-6.1 Sol vs Claude Sonnet 5.5.
Snabbversion
- GPT-6.1 Sol leder på kostnad per uppgift: på varje benchmark de båda delar når den dit för en bråkdel av Opus 5.5:s utlägg.
- Prisskillnaden försvinner dock till stor del vid promptar över 272 K token, där GPT-6.1 Sols påslag slår till.
- Opus 5.5 har fortfarande högre tak för affärsautomatisering och vetenskapligt terminalarbete när du kör på maxansträngning.
Vad är GPT-6.1 Sol?
GPT-6.1 Sol är OpenAIs mellanklassade resonemangsmodell i GPT-6-familjen, släppt den 29 september 2026 som en uppgradering av GPT-6 Sol.
Försäljningsargumentet är resultat nära Astra på kodning, datoranvändning och professionellt arbete till ett mycket lägre pris, med billigare cachad indata riktad mot agenter som återanvänder kontext mellan förfrågningar.
Vår guide till GPT-6.1 Sol täcker lanseringen; vår GPT-6 Sol API-handledning bygger en agent för kodbasmigrering på den tidigare versionen.
Vad är Claude Opus 5.5?
Claude Opus 5.5 är Anthropics flaggskeppsmodell i Opus-serien, släppt som den första modellen i Claude 5.5-familjen.
Anthropic positionerar den för långvarigt agentiskt kod- och kunskapsarbete, med matchande prestanda mot Claude Fable 5.1 på de flesta uppgifter till en lägre kostnad, och med adaptivt tänkande som alltid är påslaget.
Vår guide till Claude Opus 5.5 går igenom lanseringen; vår Opus 5.5 API-handledning bygger en AI-incidentutredare.
GPT-6.1 Sol vs Claude Opus 5.5: Direkt jämförelse
GPT-6.1 Sol och Opus 5.5 överlappar bara på tre publicerade benchmark, alla från OpenAIs lanseringsdiagram. Opus 5.5 har högre bästa resultat på två av dem, och GPT-6.1 Sol når sina resultat för 2–5 gånger lägre kostnad per uppgift på alla tre.
| Egenskap | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| AutomationBench (bästa resultat, kostnad per uppgift) | 36,1% på max, $0,30 | 42,5% på max, $1,44 |
| GDP.pdf (bästa resultat, kostnad per uppgift) | 32,0% på hög, $0,35 | 28,8% på hög, $0,83 |
| Terminal-Bench Science 0.1 (max ansträngning) | 57,0%, $5,47 | 63,3%, $23,21 |
| DeepSWE v1.1 | 75,2% på hög | Inte publicerat |
| Terminal-Bench 4.0 | Inte publicerat | 66,4% på max |
| Datoranvändning | 71,4% på OSWorld 2.0 offline (max) | 81,8% på OSWorld 2.1 |
| Kontextfönster / maxutdata | 1,05 M / 128 K | 1 M / 128 K |
| Kunskapsstopp | April 2026 | Juni 2026 |
| Ansträngningsnivåer | low, medium (standard), high, xhigh, max | low, medium (standard), high, xhigh, max |
De första tre raderna kommer från OpenAIs diagram, som märker Claude-resultaten "Opus 5.5 w/ fallbacks". Allt annat är respektive leverantör som rapporterar om sin egen modell.
Affärsarbetsflöden och dokument
Det här är där OpenAI valde att utmana, och där ansträngningsläget avgör vinnaren.
OpenAIs rubrik säger att GPT-6.1 Sol ligger 2,2 poäng över Opus 5.5 på AutomationBench, Zapiers test av agenter som slutför flerstegsarbetsflöden över dussintals affärsverktyg. Det stämmer på medium ansträngning, där GPT-6.1 Sol får 31,7% till $0,19 per uppgift mot Opus 5.5:s 29,5% till $0,65.
Skruva upp båda till max, och ordningen vänds. Opus 5.5 klättrar till 42,5%, över till och med GPT-6 Astra, medan GPT-6.1 Sol toppar på 36,1%. Opus 5.5 betalar för det med nära 5× så hög kostnad per uppgift, så frågan är om sex poängs högre lyckandefrekvens i arbetsflöden är värt det för din agent. För en supportbot som hanterar tusentals ärenden, troligen inte. För ett finansarbetsflöde där ett misslyckat körning innebär att en människa får göra om det, kanske.
GPT-6.1 Sol är bättre värde för dokumentarbete och vardagsautomatisering. Opus 5.5 är valet när de svåraste körningarna måste lyckas.
Kodning och vetenskapligt arbete
Det finns ingen gemensam kodningsbenchmark, så varje leverantörs siffra står ensam i tabellen. OpenAI säger att GPT-6.1 Sol matchar GPT-6 Astra på DeepSWE v1.1, som testar långsiktigt ingenjörsarbete i verkliga kodbaser, medan Anthropic rapporterar att Opus 5.5 leder GPT-6 Astra på Terminal-Bench 4.0 och FrontierCode.
I vårt tidigare praktiska test slog GPT-6 Sol, den föregående versionen, Opus 5.5 på ett Tetris-bygge till under en tredjedel av körkostnaden (se vår jämförelse GPT-6 Sol vs Claude Opus 5.5), så vi misstänker att GPT-6.1 Sol drar det längsta strået.
Datoranvändning
De två modellerna går inte att jämföra här än. OpenAI rapporterar GPT-6.1 Sol på den offline-uppsättningen av OSWorld 2.0, inom 2,1 poäng från GPT-6 Astra, medan Anthropic rapporterar Opus 5.5 på OSWorld 2.1, en nyare version med andra uppgifter. Ingen av leverantörerna publicerade den andras version, så siffrorna i sammanställningen är inte en direkt jämförelse. Betrakta datoranvändning som öppet tills någon kör båda på samma uppsättning.
Skyddsräcken och API-begränsningar
Opus 5.5 är den mer begränsade modellen i praktiken. Anthropic dirigerar de flesta cybersäkerhetsuppgifter till Opus 4.8 om du inte är med i deras Cyber Verification Program, och biologiarbete går genom liknande återfall. Det är också därför OpenAIs diagram märker Claude-resultaten som "med fallbacks".
GPT-6.1 Sols begränsningar handlar istället om API:et. Den har ingen ansträngningsnivå none eller minimal, och verktygsanrop fungerar bara via Responses API, inte Chat Completions. Opus 5.5 behåller adaptivt tänkande alltid på och nekar tvingad verktygsanvändning. För säkerhetsteam är Opus 5.5:s dirigeringsbeteende den större praktiska skillnaden; för utvecklare som migrerar kod är det GPT-6.1 Sols API-ändringar.
Prissättning: vad du faktiskt betalar
GPT-6.1 Sol kostar exakt hälften av Opus 5.5 på varje standardpris, tills en prompt passerar 272 K indatatoken.
Tokenpriser sida vid sida
| Pris | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| Indata, per 1 M token | $2,00 | $4,00 |
| Utdata, per 1 M token | $10,00 | $20,00 |
| Cache-läsning av indata, per 1 M token | $0,10 | $0,20 |
| Cache-skrivning, per 1 M token | $2,50 | $5,00 (5 minuter), $8,00 (1 timme) |
| Påslag för lång kontext | Över 272 K indatatoken: 2× indata och cache, 1,5× utdata för hela förfrågan | Inget |
| Batchrabatt | 50% | 50% |
| Snabbläge | 2× standardpriser | $8 / $40 per 1 M token |
Den jämna 0,5×-faktorn gäller över indata, utdata och cacheläsningar, så för normalstora promptar kokar jämförelsen ned till att "GPT-6.1 Sol kostar hälften". Båda modellerna debiterar resonemangstoken som utdata, vilket spelar större roll för Opus 5.5 eftersom dess tänkande inte går att stänga av.
Vad en verklig arbetslast kostar
| Arbetslast | GPT-6.1 Sol | Claude Opus 5.5 | Skillnad |
|---|---|---|---|
| Balanserad assistent: 1 M in / 250 K ut | $4,50 | $9,00 | $4,50 (50% mindre) |
| Återhämtning, varje förfrågan under 272 K: 10 M in / 1 M ut | $30 | $60 | $30 (50% mindre) |
| Återhämtning, varje förfrågan över 272 K: 10 M in / 1 M ut | $55 | $60 | $5 (8% mindre) |
Varje totalsumma är (volym ÷ 1 M) × pris, summerat över indata och utdata, till standardpriser.
- Balanserad assistent: det rena halva-priset-fallet, och det som de flesta chatt- och agentarbetslaster liknar.
- Återhämtning under tröskeln: fortfarande halva priset, så RAG-upplägg som håller varje prompt liten får hela besparingen.
- Återhämtning över tröskeln: påslaget fördubblar GPT-6.1 Sols indatapriser till Opus 5.5:s nivå, och besparingen krymper till en avrundningsfråga. Om dina promptar rutinmässigt bär hela kodbaser, budgetera som om de två kostar detsamma.
Leverantörerna använder olika tokenizers, och ingen har publicerat tokenantal för en delad arbetslast, så betrakta dessa totalsummor som en prisjämförelse snarare än en faktura.
Hur GPT-6.1 Sol och Claude Opus 5.5 presterade
Benchmarken ovan är leverantörernas egna, så jag körde en bygguppgift mot GPT-6.1 Sol och Claude Opus 5.5 med en identisk prompt och identiska verktyg.
Uppgiften: en enkel HTML-baserad bokningskalender i en fil för en vårdcentral, med veckovy måndag–söndag för tider hos sjukgymnastik, tandvård, bilddiagnostik och pediatrik, ett formulär för att lägga till, redigera och ta bort bokningar, localStorage-beständighet samt en seedad provvecka med cirka tio tider. Inget byggsteg, inga beroenden, inget nätverk.
Det svåra är konfliktlogiken, som måste hålla flera regler samtidigt:
- Två tider krockar om de överlappar i samma rum, eller om de överlappar med samma vårdgivare
- Rygg mot rygg-bokningar, där en slutar exakt när nästa börjar, får inte krocka
- Varje flagga måste namnge den andra tiden och orsaken, inte bara bli röd
- Flaggor måste uppdateras efter varje redigering och borttagning, och överleva en omladdning
- Den seedade veckan måste innehålla exakt två rumskrockar och en krock på vårdgivarnivå
Jag gillar detta test eftersom det prövar OpenAIs påstående att GPT-6.1 Sol matchar GPT-6 Astra på ingenjörsarbete i riktiga kodbaser och Anthropics pitch för Opus 5.5 som en långkörande kodagent.
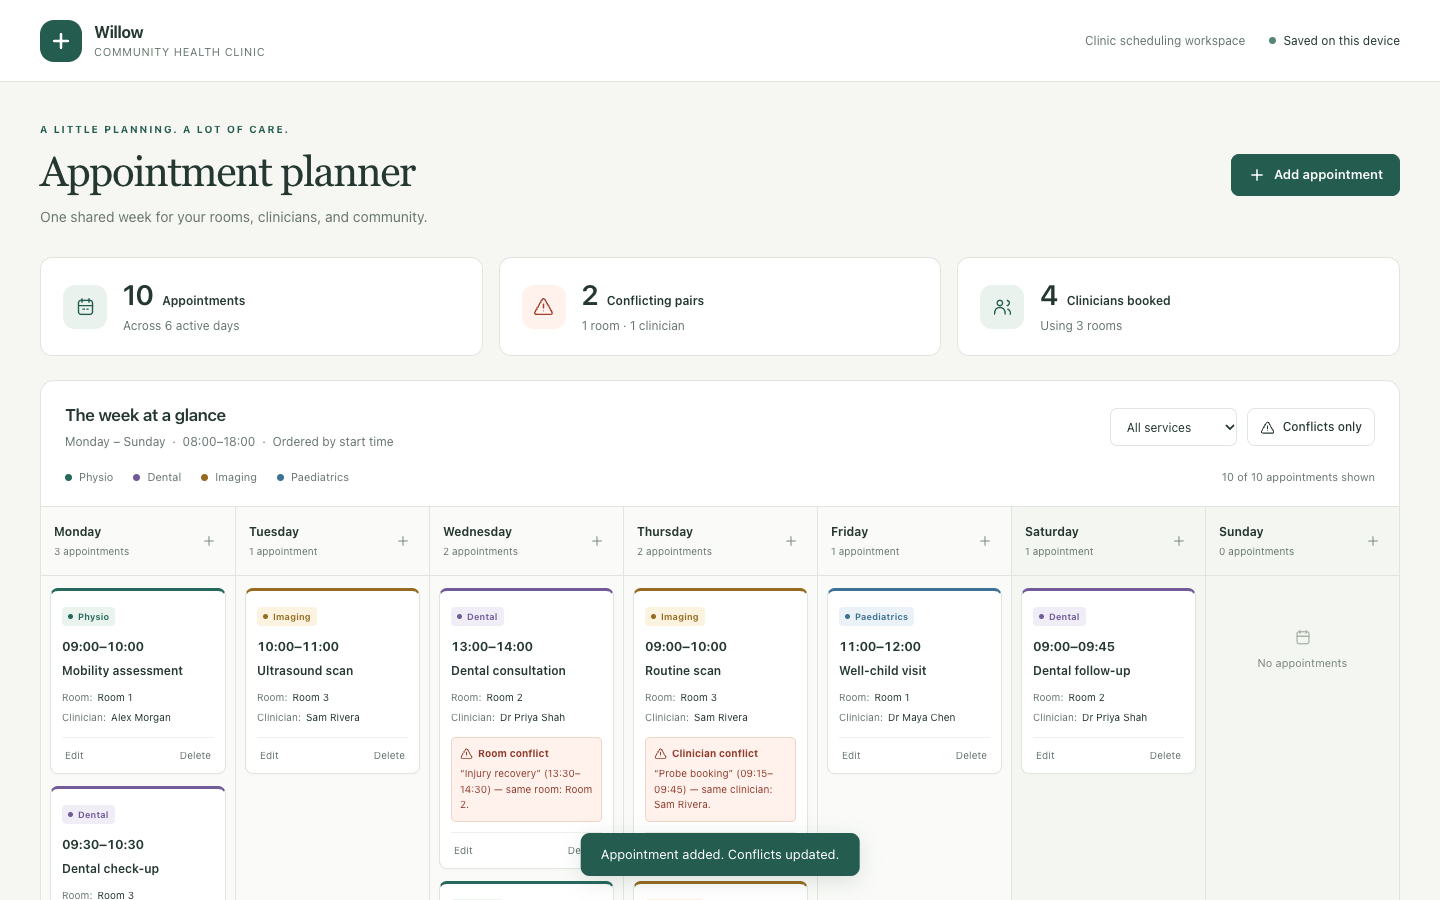
Här är GPT-6.1 Sols kalender efter att jag flyttat en tid, tagit bort en och lagt till en ny som dubbelbokar en vårdgivare. Den nya torsdagsbokningen är flaggad och namnger tiden den krockar med:
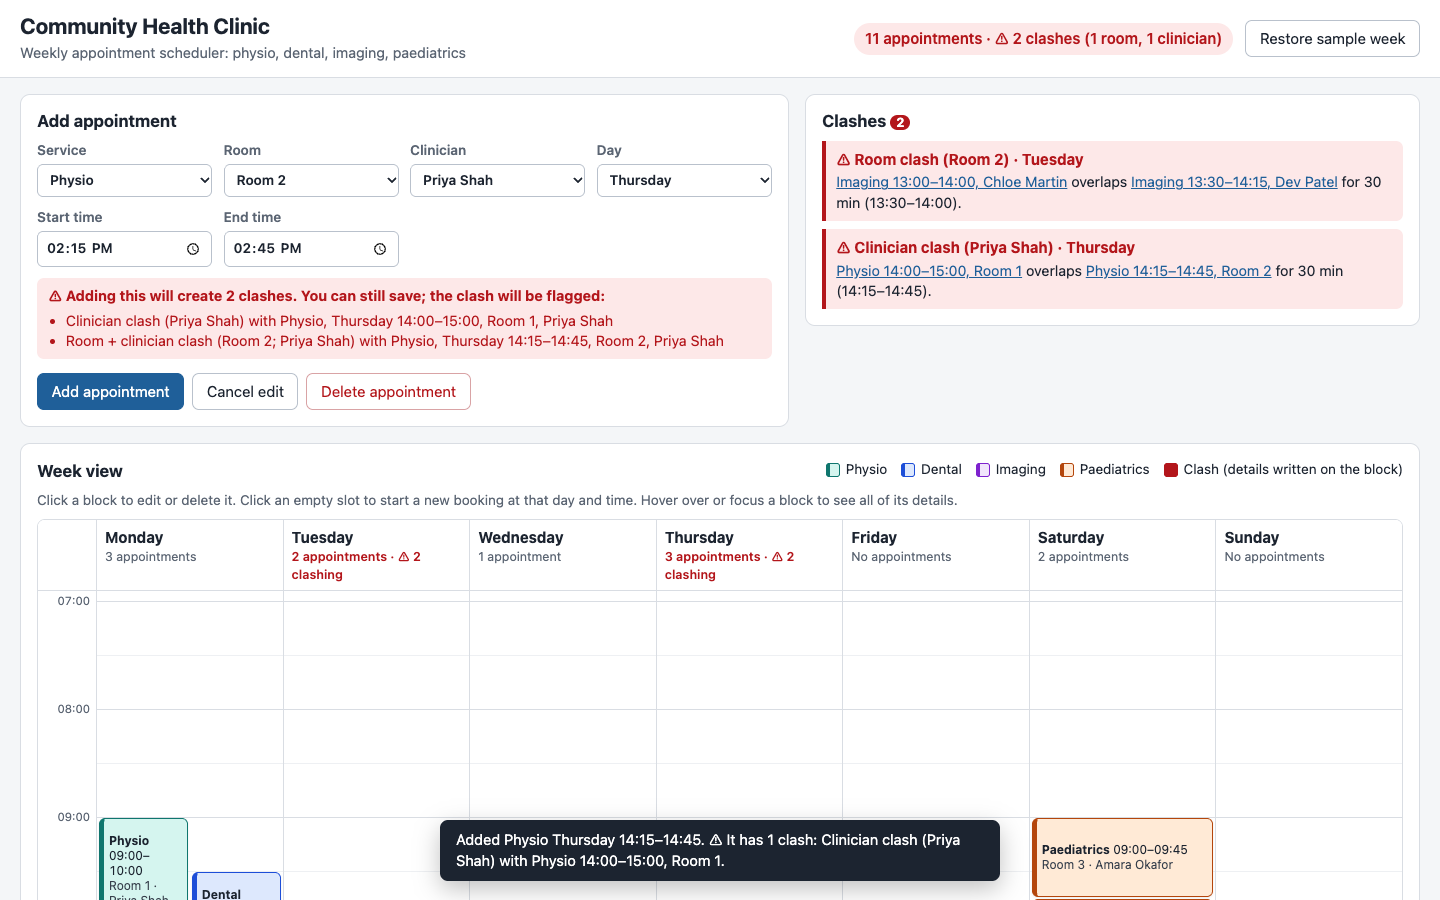
Och här är Opus 5.5:s efter samma steg, med dess konfliktpanel som listar varje återstående par och hur länge överlappet varar:
De viktigaste iakttagelserna:
- På konfliktlogiken skilde sig ingen åt. Båda sidorna öppnade med exakt två rumskrockar och en vårdgivarkrock flaggade, var och en med namn på den andra tiden och orsaken, och båda lät rygg mot rygg-bokningar vara i fred.
- Ändringar, borttagningar och omladdningar fällde inte heller någon. Att flytta en tid till ett ledigt rum rensade båda halvorna av dess krock, att ta bort ena halvan av vårdgivarkrocken rensade den andra, en ny tid som dubbelbokade en vårdgivare flaggades korrekt, och allt överlevde en omladdning.
- Skillnaderna var alla i presentationen. GPT-6.1 Sol byggde en mer polerad sida, med sammanfattningskort, tjänstefilter och en "Endast konflikter"-växel, men listar varje dags tider i tidsordning snarare än i ett tidsschema. Opus 5.5 lade till en konfliktpanel som visar hur länge varje överlapp varar och varnar för krockar innan du sparar, men dess veckovy kräver rullning.
- Opus 5.5 skrev den knepigare provveckan. Dess seed inkluderade en överlapp i olika rum med olika vårdgivare.
Jag gav båda 5 av 5 för att följa specifikationen och för konfliktlogiken. GPT-6.1 Sol fick 5 för användbarhet och layout, och Opus 5.5 fick 4 eftersom dess veckovy inte ryms på en skärm.
Kostnaden är där de skiljer sig. Opus 5.5 spenderade mer än dubbelt så många utdatatoken, de flesta på tänkande:
- GPT-6.1 Sol: $0,27
- Claude Opus 5.5: $1,11
Så vem vinner? På den här uppgiften, GPT-6.1 Sol, och mestadels på pris. Båda levererade en korrekt, fungerande kalender, och GPT-6.1 Sol gjorde det för runt en fjärdedel av kostnaden.
När ska du välja GPT-6.1 Sol vs Claude Opus 5.5
För de flesta team är skiljelinjen kostnad per uppgift: GPT-6.1 Sol når OpenAIs rapporterade poäng för ungefär en femtedel till hälften av vad Opus 5.5 spenderar. Undantagen är långa promptar, de sista procentenheterna i svåra körningar och var du distribuerar.
Välj GPT-6.1 Sol om...
- Du kör agenter i volym. På automatisering av affärsarbetsflöden slår den Opus 5.5 på medium ansträngning till ungefär en tredjedel av kostnaden per uppgift, vilket växer med tusentals körningar.
- Ditt arbete är frågor över täta dokument. Den leder Opus 5.5 på OpenAIs PDF-benchmark på varje ansträngningsnivå till mindre än halva kostnaden.
- Ditt team redan arbetar i ChatGPT Work eller Codex. Det är modellen OpenAI rekommenderar där för komplex kodning och agentiskt arbete.
- Du återanvänder långa systempromptar eller kontext. Cachad inläsning till $0,10 per miljon token gör loopar med många upprepningar billiga, så länge varje prompt håller sig under 272 K token.
Välj Claude Opus 5.5 om...
- Dina promptar överskrider regelbundet 272 K token. GPT-6.1 Sols påslag raderar det mesta av dess prisfördel där, och Opus 5.5 har inget påslag för lång kontext.
- En misslyckad körning kostar mer än tokenkostnaden. På maxansträngning noterar Opus 5.5 det högsta AutomationBench-resultatet i OpenAIs egna diagram, inklusive GPT-6 Astra.
- Du distribuerar via Cursor, Amazon Bedrock eller Google Vertex AI. Opus 5.5 finns listad på alla tre; GPT-6.1 Sol är ännu inte listad i Cursor- eller Vertex AI-dokumentationen.
- Du vill ha Anthropics konservativa standarder för obevakade agenter. Deras skyddsräcken dirigerar riskfyllt säkerhets- och biologiarbete till andra modeller istället för att försöka genomföra det.
Så kommer du igång med GPT-6.1 Sol och Claude Opus 5.5
| Yta | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| Konsumentapp | ChatGPT Work och Codex (Plus, Pro, Business, Enterprise, Edu); ännu inte i Chat | Claude-appar (Pro, Max, Team, Enterprise) |
| Förstaparts-API | OpenAI API (verktygsanrop via Responses API) | Claude API |
| Molnplattformar | Azure AI Foundry; ej listad i Vertex AI-dokumentationen per 30 september 2026 | Amazon Bedrock, Google Vertex AI, Azure AI Foundry |
| Kodningsagenter | Codex, GitHub Copilot; ej listad i Cursor-dokumentationen per 30 september 2026 | Claude Code, Cursor, GitHub Copilot |
| Tredjepartsroutrar | OpenRouter (openai/gpt-6.1-sol) | OpenRouter (anthropic/claude-opus-5.5) |
| API-modell-ID | gpt-6.1-sol |
claude-opus-5-5 |
Den största skillnaden är räckvidd: Opus 5.5 finns på alla tre stora moln och i Cursor, medan GPT-6.1 Sol är centrerad kring OpenAIs egna produkter, Azure och Copilot.
Göra ditt första API-anrop
De två modellerna använder olika SDK:er, så att byta innebär att byta klient såväl som modellsträng:
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6.1-sol",
    reasoning={"effort": "medium"},
    input="Summarize the payment terms in this contract: ...",
)
print(response.output_text)
from anthropic import Anthropic
client = Anthropic()
response = client.messages.create(
model="claude-opus-5-5",
max_tokens=2048,
messages=[{"role": "user", "content": "Summarize the payment terms in this contract: ..."}],
)
print(next(b.text for b in response.content if b.type == "text"))För fullständiga byggen, se vår GPT-6 Sol API-handledning och vår Opus 5.5 API-handledning, som jag också nämnde tidigare.
Slutsatser
Om kostnad per uppgift är din begränsning, använd GPT-6.1 Sol. Om du behöver högsta lyckandefrekvens på svåra agentkörningar, skickar långa promptar eller distribuerar via Cursor eller Bedrock, använd Opus 5.5.
Det mest talande tycker jag är att OpenAIs egna diagram argumenterar för båda. De valde medium-ansträngning för rubriken, men samma diagram visar Opus 5.5 överst på maxansträngning. OpenAI satsar på att de flesta köpare bryr sig om den billigare punkten på kurvan, och för vardagliga agenter tror jag att det stämmer.
Eftersom Sol är en mellanklassmodell är GPT-6.1 Sol vs. Claude Sonnet 5.5 också värd att testa.
Och om du bygger på någon av modellerna rekommenderar jag vår kompetensväg OpenAI Fundamentals eller vår kurs Introduction to Claude Models.