
Last chance! 50% off DataCamp Premium
Sale ends in
OpenAI, 29 Eylül’deki DevDay etkinliğinde orta seviye modelini yükselten GPT-6.1 Sol’u yayımladı; şirket, bu modelin amiral gemisi GPT-6 Astra’ya, Astra’nın token fiyatının beşte birine yakınlaştığını söylüyor. Bundan bir hafta önceyse Anthropic, Claude Opus 5.5’i piyasaya sürdü; bu model, Fable 5.1 seviyesinde performansı %40 daha ucuza vadeder.
Bunlar verimlilik odaklı hamleler ve OpenAI’nin lansman yazısı, görev başına maliyetin küçük bir kısmıyla iş akışları ve belge işlerinde kazandığını iddia ederek Opus 5.5’i doğrudan anıyor. Ancak OpenAI’nin kendi grafikleri, manşetten daha ilginç bir tablo çiziyor; çünkü karşılaştırma, hangi efor ayarına baktığınıza göre değişiyor.
Bu yazıda ağırlıklı olarak OpenAI’nin lansman yazısında doğrudan eşleştirme yaptığı için GPT-6.1 Sol ile Opus 5.5’i karşılaştırıyoruz; ancak adil bir diğer kıyaslama da Claude Sonnet 5.5; bunu da GPT-6.1 Sol ve Claude Sonnet 5.5 yazımızda ele aldık.
GPT-6.1 Sol, GPT-6 ailesindeki OpenAI’nin orta seviye akıl yürütme modeli olup, 29 Eylül 2026’da GPT-6 Sol’un bir yükseltmesi olarak yayımlandı.
Öne çıkan yanı; kodlama, bilgisayar kullanımı ve profesyonel işlerde Astra’ya yakın sonuçları çok daha düşük fiyata sunması; ayrıca, istekler arasında bağlamı yeniden kullanan ajanlara yönelik daha ucuz önbelleğe alınmış girdi okuması.
GPT-6.1 Sol rehberimiz lansmanı ele alıyor; GPT-6 Sol API eğitimi ise önceki sürüm üzerinde bir kod tabanı taşıma ajanı inşa ediyor.
Claude Opus 5.5, Claude 5.5 ailesinin ilk modeli olarak yayımlanan Anthropic’in amiral gemisi Opus modeli.
Anthropic, modeli uzun süreli ajansal kodlama ve bilgi çalışmaları için konumlandırıyor; çoğu görevde Claude Fable 5.1’i daha düşük maliyetle yakalarken, her zaman açık uyarlanabilir düşünme yeteneği sunuyor.
Claude Opus 5.5 rehberimiz lansmanı kapsıyor; Opus 5.5 API eğitimi bir yapay zekâ olay araştırmacısı oluşturuyor.
GPT-6.1 Sol ve Opus 5.5 yalnızca OpenAI’nin lansman grafiklerinden üç yayımlanmış kıyaslamada çakışıyor. Opus 5.5 bunların ikisinde en yüksek en iyi skoru alıyor; GPT-6.1 Sol ise üçünde de görevi 2 ila 5 kat daha ucuza tamamlıyor.
| Özellik | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| AutomationBench (en iyi skor, görev başına maliyet) | En yüksek eforda %36,1, $0,30 | En yüksek eforda %42,5, $1,44 |
| GDP.pdf (en iyi skor, görev başına maliyet) | Yüksek eforda %32,0, $0,35 | Yüksek eforda %28,8, $0,83 |
| Terminal-Bench Science 0.1 (maksimum efor) | %57,0, $5,47 | %63,3, $23,21 |
| DeepSWE v1.1 | Yüksek eforda %75,2 | Yayımlanmadı |
| Terminal-Bench 4.0 | Yayımlanmadı | En yüksek eforda %66,4 |
| Bilgisayar kullanımı | OSWorld 2.0 offline’da %71,4 (en yüksek) | OSWorld 2.1’de %81,8 |
| Bağlam penceresi / maks. çıktı | 1,05M / 128K | 1M / 128K |
| Bilgi kesim tarihi | Nisan 2026 | Haziran 2026 |
| Efor seviyeleri | düşük, orta (varsayılan), yüksek, çok yüksek, maks | düşük, orta (varsayılan), yüksek, çok yüksek, maks |
İlk üç satır OpenAI’nin grafiklerinden geliyor; burada Claude sonuçları “Opus 5.5 w/ fallbacks” olarak etiketlenmiş. Diğer her şey, her satıcının kendi modeline ilişkin raporları.
OpenAI’nin iddiasını ortaya koyduğu yer burası ve kazananı efor ayarı belirliyor.
OpenAI’nin manşeti, GPT-6.1 Sol’un, onlarca iş aracında çok adımlı iş akışlarını tamamlayan ajanları test eden AutomationBench’te, Opus 5.5’in 2,2 puan üzerinde skor aldığını söylüyor. Bu, orta eforda doğru; GPT-6.1 Sol %31,7’ye $0,19 görev başına maliyetle ulaşırken, Opus 5.5 %29,5’e $0,65 ile ulaşıyor.
İkisini de maksimuma çektiğinizde sıralama tersine dönüyor. Opus 5.5 %42,5’e çıkıyor ve GPT-6 Astra’yı dahi aşıyor; GPT-6.1 Sol ise %36,1’de tavan yapıyor. Opus 5.5 bunun bedelini görev başına neredeyse 5 kat maliyetle ödüyor; mesele, iş akışındaki altı puanlık başarı artışının sizin ajanınız için değip değmeyeceği. Binlerce bileti ele alan bir destek botu için muhtemelen hayır. Bir çalıştırmanın başarısız olmasının insan müdahalesi gerektirdiği bir finans akışı için belki.
Belge işleri ve günlük otomasyon için GPT-6.1 Sol daha iyi bir değer. En zorlu akışların başarılı olması gerektiğinde tercih Opus 5.5.
Ortak bir kodlama kıyaslaması yok; bu nedenle tablodaki rakamlar, her satıcının kendi verisi. OpenAI, gerçek kod tabanlarında uzun ufuklu mühendisliği test eden DeepSWE v1.1’de GPT-6.1 Sol’un GPT-6 Astra’yla başa baş gittiğini söylerken, Anthropic Opus 5.5’in Terminal-Bench 4.0 ve FrontierCode’da GPT-6 Astra’nın önünde olduğunu bildiriyor.
Daha önce yaptığımız pratik testte, önceki sürüm GPT-6 Sol, bir Tetris derlemesinde Opus 5.5’i çalıştırma maliyetinin üçte birinden azıyla geride bırakmıştı (bkz. GPT-6 Sol ve Claude Opus 5.5 karşılaştırmamız); bu yüzden GPT-6.1 Sol’un öne çıktığını tahmin ediyoruz.
Burada iki modeli henüz karşılaştıramıyoruz. OpenAI, GPT-6.1 Sol’u OSWorld 2.0’ın çevrimdışı setinde ve GPT-6 Astra’ya 2,1 puan mesafede raporlarken; Anthropic, Opus 5.5’i farklı görevler içeren daha yeni sürüm OSWorld 2.1’de raporluyor. Hiçbiri diğerinin sürümü için sonuç yayımlamadığından, özet tablodaki rakamlar bire bir kıyas değil. İki model aynı sette çalıştırılana kadar bilgisayar kullanımını açık bir konu olarak değerlendirin.
Uygulamada daha kısıtlı olan model Opus 5.5. Anthropic, çoğu siber güvenlik görevini Opus 4.8’e yönlendiriyor; Cyber Verification Program’ında olmadıkça, biyoloji çalışmaları da benzer geri dönüş yollarından geçiyor. OpenAI’nin grafiklerinde Claude sonuçlarının “fallbacks ile” etiketlenmesinin nedeni de bu.
GPT-6.1 Sol’un kısıtları ise API ile ilgili. none veya minimal efor ayarı yok ve araç çağırma Chat Completions üzerinden değil, yalnızca Responses API ile çalışıyor. Opus 5.5 uyarlanabilir düşünmeyi sürekli açık tutuyor ve zorunlu araç kullanımını reddediyor. Güvenlik ekipleri için pratikte daha büyük fark Opus 5.5’in yönlendirmesi; kod taşıyan geliştiriciler içinse GPT-6.1 Sol’un API değişiklikleri.
GPT-6.1 Sol, 272K girdi token’ını aşana kadar tüm standart oranlarda tam olarak Opus 5.5’in yarısına mal oluyor.
| Oran | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| Girdi, 1M token başına | $2,00 | $4,00 |
| Çıktı, 1M token başına | $10,00 | $20,00 |
| Önbellekten okuma, 1M token başına | $0,10 | $0,20 |
| Önbelleğe yazma, 1M token başına | $2,50 | $5,00 (5 dakika), $8,00 (1 saat) |
| Uzun bağlam ek ücreti | 272K girdi token’ı üzeri: tüm istek için girdi ve önbellekte 2x, çıktı için 1,5x | Yok |
| Toplu indirim | %50 | %50 |
| Hızlı mod | Standart oranların 2x’i | 1M token başına $8 / $40 |
Düz %50 çarpanı girdi, çıktı ve önbellekten okumada geçerli olduğundan, normal boyuttaki istemlerde karşılaştırma “GPT-6.1 Sol yarı fiyatına”ya indirgeniyor. Her iki model de akıl yürütme token’larını çıktı olarak faturalandırıyor; bu, düşünme modu kapatılamayan Opus 5.5 için daha kritik.
| İş yükü | GPT-6.1 Sol | Claude Opus 5.5 | Fark |
|---|---|---|---|
| Dengeli asistan: 1M girdi / 250K çıktı | $4,50 | $9,00 | $4,50 (%50 daha az) |
| Getirme, her istek 272K altı: 10M girdi / 1M çıktı | $30 | $60 | $30 (%50 daha az) |
| Getirme, her istek 272K üstü: 10M girdi / 1M çıktı | $55 | $60 | $5 (%8 daha az) |
Her toplam, standart oranlarda (hacim ÷ 1M) × oran formülüyle, girdi ve çıktı toplamı olarak hesaplanmıştır.
İki satıcı farklı tokenleştiriciler kullanıyor ve hiçbiri ortak bir iş yükü için token sayısı yayımlamadı; bu yüzden bu toplamları fatura değil, oran karşılaştırması olarak ele alın.
Yukarıdaki kıyaslamalar satıcıların kendi verileri; bu yüzden aynı istem ve aynı araçlarla GPT-6.1 Sol ve Claude Opus 5.5’e karşı tek bir derleme görevi koştum.
Görev: bir toplum sağlığı kliniği için tek dosyalık HTML randevu planlayıcı; fizyoterapi, diş, görüntüleme ve pediatri randevularının Pazartesi-Pazar hafta görünümü; ekleme, düzenleme ve silme formları; localStorage kalıcılığı; yaklaşık on randevuluk örnek bir tohum hafta. Derleme adımı yok, bağımlılık yok, ağ yok.
Zor kısım, aynı anda birkaç kuralı sağlaması gereken çakışma mantığı:
Bu testi seviyorum; çünkü GPT-6.1 Sol’un gerçek kod tabanlarında GPT-6 Astra’yı yakaladığı iddiasını ve Opus 5.5’in uzun süreli kodlama ajanı olduğu yönündeki Anthropic söylemini yokluyor.
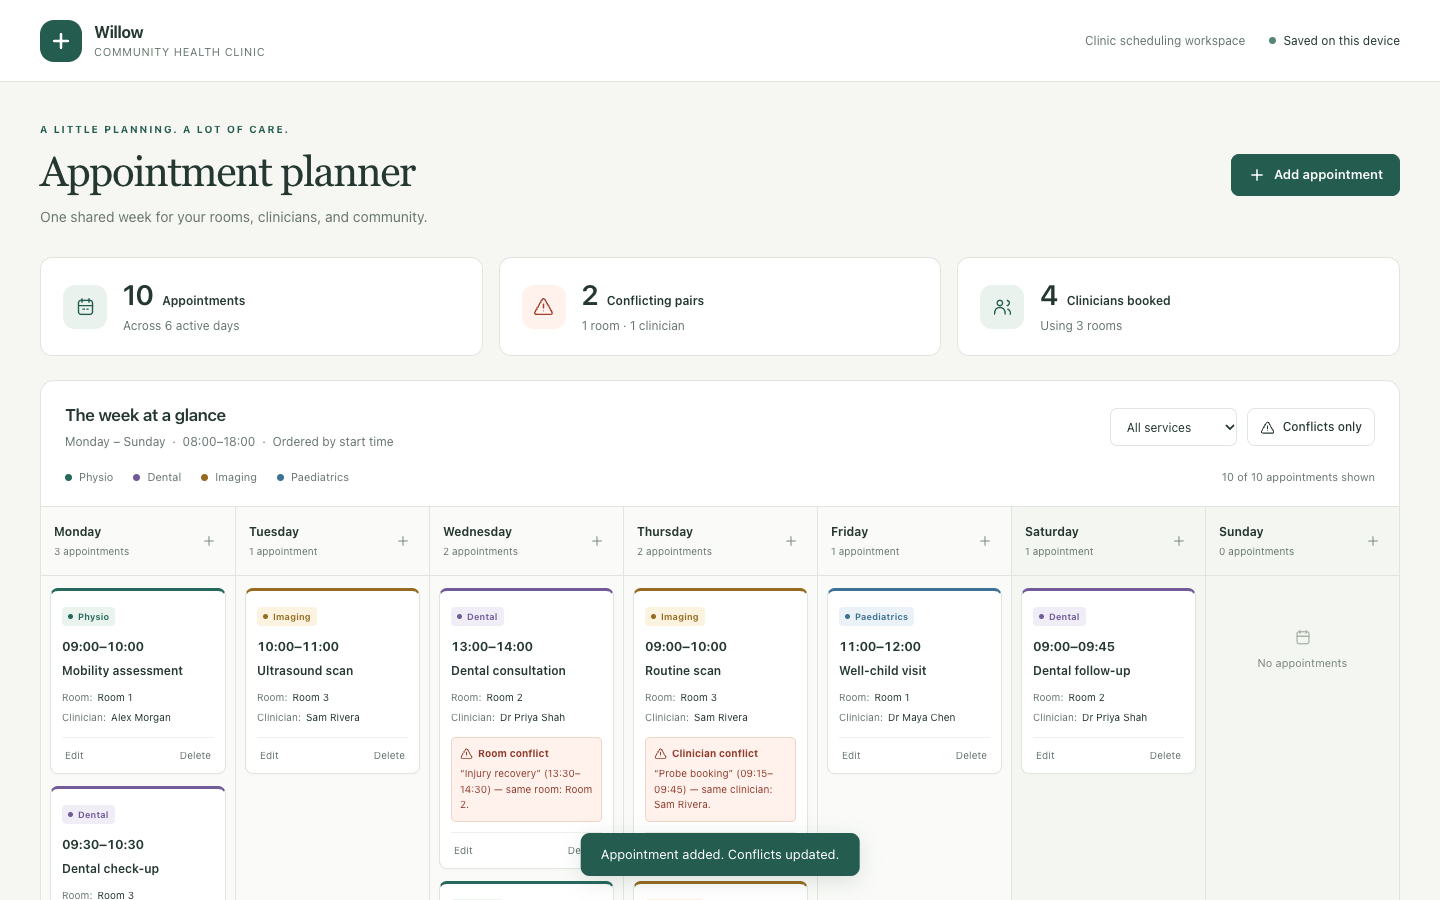
İşte bir rezervasyonu taşıyıp birini silip, bir hekimin çifte rezervasyonu olacak şekilde yeni bir tane ekledikten sonra GPT-6.1 Sol’un planlayıcısı. Yeni Perşembe randevusu, çakıştığı randevuyu ad vererek bayraklanmış:
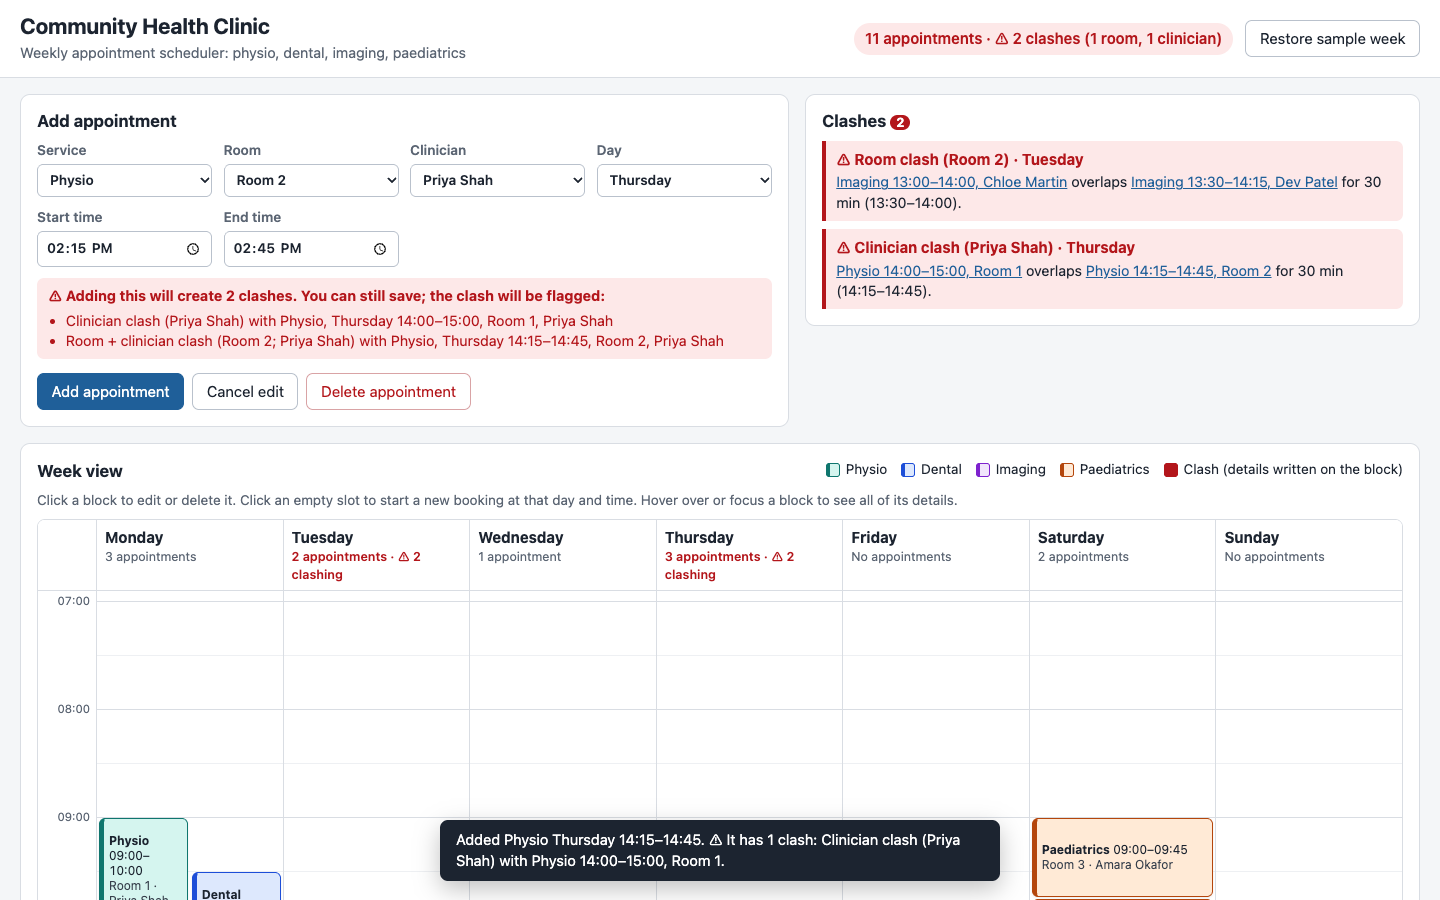
Aynı adımlardan sonra Opus 5.5’inki; çakışma paneli kalan her çifti ve örtüşmenin süresini listeliyor:
Başlıca bulgular:
Şartnameye uyum ve çakışma mantığı için ikisine de 5 üzerinden 5 verdim. Kullanılabilirlik ve yerleşim için GPT-6.1 Sol 5 aldı; Opus 5.5 ise hafta görünümü tek ekrana sığmadığı için 4 aldı.
Ayrıştıkları yer maliyet. Opus 5.5, çıktı token’larının iki kattan fazlasını harcadı; çoğu düşünmeye gitti:
Peki hangisi kazanıyor? Bu görevde GPT-6.1 Sol ve bunun da çoğunlukla fiyat nedeniyle. İkisi de doğru ve çalışan bir planlayıcı teslim etti; GPT-6.1 Sol bunu maliyetin yaklaşık dörtte biriyle yaptı.
Çoğu ekip için ayrım, görev başına maliyet: GPT-6.1 Sol, OpenAI’nin raporladığı skorlara Opus 5.5’in harcadığının yaklaşık beşte biri ile yarısı arasında ulaşıyor. İstisnalar; uzun istemler, zorlu çalıştırmalarda son birkaç puanlık başarı ve dağıtım yüzeyi.
| Yüzey | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| Tüketici uygulaması | ChatGPT Work ve Codex (Plus, Pro, Business, Enterprise, Edu); Chat’te henüz yok | Claude uygulamaları (Pro, Max, Team, Enterprise) |
| Birinci taraf API | OpenAI API (araç çağırma Responses API üzerinden) | Claude API |
| Bulut platformları | Azure AI Foundry; 30 Eylül 2026 itibarıyla Vertex AI dokümanlarında listeli değil | Amazon Bedrock, Google Vertex AI, Azure AI Foundry |
| Kodlama ajanları | Codex, GitHub Copilot; 30 Eylül 2026 itibarıyla Cursor dokümanlarında listeli değil | Claude Code, Cursor, GitHub Copilot |
| Üçüncü taraf yönlendiriciler | OpenRouter (openai/gpt-6.1-sol) | OpenRouter (anthropic/claude-opus-5.5) |
| API model kimliği | gpt-6.1-sol |
claude-opus-5-5 |
En büyük fark erişim alanı: Opus 5.5 üç büyük bulutta ve Cursor’da var; GPT-6.1 Sol ise OpenAI’nin kendi ürünleri, Azure ve Copilot etrafında konumlanmış.
İki model farklı SDK’lar kullanıyor; bu yüzden geçiş, yalnızca model dizgesini değil, istemciyi de değiştirmeyi gerektiriyor:
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6.1-sol",
    reasoning={"effort": "medium"},
    input="Summarize the payment terms in this contract: ...",
)
print(response.output_text)
from anthropic import Anthropic
client = Anthropic()
response = client.messages.create(
model="claude-opus-5-5",
max_tokens=2048,
messages=[{"role": "user", "content": "Summarize the payment terms in this contract: ..."}],
)
print(next(b.text for b in response.content if b.type == "text"))Tam yapılar için, daha önce de paylaştığım GPT-6 Sol API eğitimi ve Opus 5.5 API eğitimimize bakın.
Kısıtınız görev başına maliyetse GPT-6.1 Sol’u kullanın. Zor ajan çalıştırmalarında en yüksek başarı oranına ihtiyaç duyuyor, uzun istemler gönderiyor veya Cursor ya da Bedrock üzerinden dağıtıyorsanız Opus 5.5’i kullanın.
En çarpıcı bulduğum nokta, OpenAI’nin kendi grafiklerinin her ikisi için de argüman sunması. Manşet için orta efor noktasını seçtiler; ancak aynı grafik, maksimum eforda Opus 5.5’in zirvede olduğunu gösteriyor. OpenAI, çoğu alıcının eğrinin daha ucuz noktasını önemseyeceğine oynuyor ve günlük ajanlar için bence haklı.
Sol orta seviye bir model olduğu için, GPT-6.1 Sol ve Claude Sonnet 5.5 karşılaştırmasını da denemeye değer.
Ve her iki model üzerinde geliştirme yapıyorsanız, OpenAI Fundamentals yetkinlik yolumuzu veya Introduction to Claude Models kursumuzu öneririm.