OpenAI a profité de DevDay le 29 septembre pour lancer GPT-6.1 Sol, une mise à jour de son modèle intermédiaire, annoncée comme proche du fleuron GPT-6 Astra pour un cinquième du prix des tokens d'Astra. Une semaine plus tôt, Anthropic dévoilait Claude Opus 5.5, présenté comme offrant des performances de niveau Fable 5.1 pour 40 % de moins.
Ces lancements misent sur l'efficacité, et le billet d'OpenAI cite directement Opus 5.5, revendiquant des gains sur les workflows métier et le travail sur documents à une fraction du coût par tâche. Les graphiques d'OpenAI racontent toutefois une histoire plus nuancée que le titre, car la comparaison change selon le niveau d'effort retenu.
Dans cet article, nous comparons GPT-6.1 Sol à Opus 5.5 surtout parce que le billet d'OpenAI les met face à face. Mais Claude Sonnet 5.5 est aussi une comparaison légitime, que nous traitons dans notre article GPT-6.1 Sol vs Claude Sonnet 5.5.
En bref
- GPT-6.1 Sol est le champion du coût par tâche : sur chaque benchmark partagé, il atteint les résultats pour une fraction de la dépense d'Opus 5.5.
- Cependant, l'écart de prix s'estompe sur les invites de plus de 272 K tokens, où s'applique le surcoût de GPT-6.1 Sol.
- Opus 5.5 conserve un plafond plus élevé en automatisation métier et en travail scientifique sur terminal à effort maximal.
Qu'est-ce que GPT-6.1 Sol ?
GPT-6.1 Sol est le modèle de raisonnement intermédiaire d'OpenAI dans la famille GPT-6, publié le 29 septembre 2026 en mise à niveau de GPT-6 Sol.
Sa promesse : des résultats proches d'Astra en code, usage de l'ordinateur et travail professionnel, à un tarif bien plus bas, avec un input mis en cache moins cher pour les agents qui réutilisent le contexte entre les requêtes.
Notre guide GPT-6.1 Sol couvre le lancement ; notre tutoriel API GPT-6 Sol construit un agent de migration de code sur la version précédente.
Qu'est-ce que Claude Opus 5.5 ?
Claude Opus 5.5 est le modèle Opus phare d'Anthropic, premier de la famille Claude 5.5.
Anthropic le positionne pour du codage agentique longue durée et du travail de connaissance, à un coût réduit, avec une pensée adaptative toujours active, et des performances alignées sur Claude Fable 5.1 pour la plupart des tâches.
Notre guide Claude Opus 5.5 présente le lancement ; notre tutoriel API Opus 5.5 construit un investigateur d'incidents IA.
GPT-6.1 Sol vs Claude Opus 5.5 : comparatif point par point
GPT-6.1 Sol et Opus 5.5 ne se recoupent que sur trois benchmarks publiés, tous issus des graphiques d'OpenAI. Opus 5.5 affiche le meilleur score maximal sur deux d'entre eux, et GPT-6.1 Sol atteint ses résultats pour 2 à 5 fois moins cher par tâche sur les trois.
| Critère | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| AutomationBench (meilleur score, coût par tâche) | 36,1 % au max, 0,30 $ | 42,5 % au max, 1,44 $ |
| GDP.pdf (meilleur score, coût par tâche) | 32,0 % en "high", 0,35 $ | 28,8 % en "high", 0,83 $ |
| Terminal-Bench Science 0.1 (effort maximal) | 57,0 %, 5,47 $ | 63,3 %, 23,21 $ |
| DeepSWE v1.1 | 75,2 % en "high" | Non publié |
| Terminal-Bench 4.0 | Non publié | 66,4 % au max |
| Utilisation de l'ordinateur | 71,4 % sur OSWorld 2.0 offline (max) | 81,8 % sur OSWorld 2.1 |
| Fenêtre de contexte / sortie max | 1,05 M / 128 K | 1 M / 128 K |
| Knowledge cutoff | Avril 2026 | Juin 2026 |
| Niveaux d'effort | low, medium (par défaut), high, xhigh, max | low, medium (par défaut), high, xhigh, max |
Les trois premières lignes proviennent des graphiques d'OpenAI, qui libellent les résultats Claude "Opus 5.5 w/ fallbacks". Le reste est déclaré par chaque éditeur pour son propre modèle.
Workflows métier et documents
C'est là qu'OpenAI a choisi d'attaquer, et où le réglage d'effort désigne le gagnant.
Le titre d'OpenAI annonce que GPT-6.1 Sol devance Opus 5.5 de 2,2 points sur AutomationBench, le test de Zapier pour des agents exécutant des workflows multi-étapes sur des dizaines d'outils métier. C'est vrai en effort moyen, où GPT-6.1 Sol marque 31,7 % pour 0,19 $ par tâche contre 29,5 % et 0,65 $ pour Opus 5.5.
Montez les deux au maximum et l'ordre s'inverse. Opus 5.5 grimpe à 42,5 %, devant même GPT-6 Astra, tandis que GPT-6.1 Sol plafonne à 36,1 %. Opus 5.5 paie cela avec près de 5 fois le coût par tâche, donc la question est de savoir si six points de succès de workflow valent la différence pour votre agent. Pour un bot de support gérant des milliers de tickets, probablement pas. Pour un flux financier où un échec implique une reprise humaine, peut-être.
Pour le travail documentaire et l'automatisation courante, GPT-6.1 Sol offre le meilleur rapport qualité-prix. Opus 5.5 s'impose lorsque les exécutions les plus difficiles doivent réussir.
Code et travail scientifique
Il n'y a pas de benchmark commun en code, donc chaque chiffre dans le tableau reste isolé. OpenAI indique que GPT-6.1 Sol égale GPT-6 Astra sur DeepSWE v1.1, qui évalue l'ingénierie à long terme dans de vrais codebases, tandis qu'Anthropic annonce Opus 5.5 devant GPT-6 Astra sur Terminal-Bench 4.0 et FrontierCode.
Lors d'un test pratique précédent, GPT-6 Sol, la version antérieure, a battu Opus 5.5 sur une construction Tetris pour moins d'un tiers du coût d'exécution (voir notre comparaison GPT-6 Sol vs Claude Opus 5.5), nous pensons donc que GPT-6.1 Sol l'emporte.
Utilisation de l'ordinateur
Comparaison impossible à ce stade. OpenAI publie GPT-6.1 Sol sur l'ensemble offline d'OSWorld 2.0, à 2,1 points de GPT-6 Astra, tandis qu'Anthropic publie Opus 5.5 sur OSWorld 2.1, une version plus récente avec des tâches différentes. Aucun éditeur n'a publié la version de l'autre, donc les chiffres du récapitulatif ne sont pas un face-à-face. Considérez l'usage PC comme ouvert jusqu'à ce que quelqu'un exécute les deux sur le même set.
Garde-fous et contraintes API
Dans la pratique, Opus 5.5 est le plus restrictif. Anthropic redirige la plupart des tâches cybersécurité vers Opus 4.8 sauf si vous êtes dans son Cyber Verification Program, et la biologie suit des fallback similaires. C'est aussi pourquoi les graphiques d'OpenAI mentionnent des résultats Claude "with fallbacks".
Les contraintes de GPT-6.1 Sol tiennent plutôt à l'API. Il n'a pas de réglage d'effort none ou minimal, et l'appel d'outils ne fonctionne que via la Responses API, pas Chat Completions. Opus 5.5 garde la pensée adaptative toujours activée et refuse l'usage forcé d'outils. Pour les équipes sécurité, le routage d'Opus 5.5 est la différence la plus concrète ; pour les développeurs qui migrent du code, ce sont les changements d'API de GPT-6.1 Sol.
Tarifs : ce que vous payez vraiment
GPT-6.1 Sol coûte exactement la moitié d'Opus 5.5 sur chaque grille standard, jusqu'à ce qu'une invite dépasse 272 K tokens en input.
Tarifs tokens côte à côte
| Tarif | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| Input, par 1 M de tokens | 2,00 $ | 4,00 $ |
| Output, par 1 M de tokens | 10,00 $ | 20,00 $ |
| Lecture de cache (input), par 1 M de tokens | 0,10 $ | 0,20 $ |
| Écriture de cache, par 1 M de tokens | 2,50 $ | 5,00 $ (5 min), 8,00 $ (1 h) |
| Surcoût long contexte | Au-delà de 272 K tokens en input : x2 sur input et cache, x1,5 sur output pour toute la requête | Aucun |
| Remise batch | 50 % | 50 % |
| Mode rapide | 2x les tarifs standard | 8 $ / 40 $ par 1 M de tokens |
Le coefficient fixe 0,5 s'applique à l'input, l'output et la lecture de cache, donc pour des invites de taille normale la comparaison se résume à : "GPT-6.1 Sol coûte la moitié". Les deux modèles facturent les tokens de raisonnement en output, ce qui pèse davantage pour Opus 5.5 puisque sa pensée ne peut pas être désactivée.
Ce que coûte une charge réelle
| Charge | GPT-6.1 Sol | Claude Opus 5.5 | Différence |
|---|---|---|---|
| Assistant équilibré : 1 M in / 250 K out | 4,50 $ | 9,00 $ | 4,50 $ (50 % de moins) |
| Retrieval, chaque requête sous 272 K : 10 M in / 1 M out | 30 $ | 60 $ | 30 $ (50 % de moins) |
| Retrieval, chaque requête au-delà de 272 K : 10 M in / 1 M out | 55 $ | 60 $ | 5 $ (8 % de moins) |
Chaque total vaut (volume ÷ 1 M) × tarif, additionné sur l'input et l'output, aux tarifs standard.
- Assistant équilibré : le cas simple à moitié prix, qui reflète la plupart des workloads de chat et d'agents.
- Retrieval sous le seuil : toujours à moitié prix, donc les montages RAG qui gardent chaque invite compacte captent l'économie totale.
- Retrieval au-delà du seuil : le surcoût double le tarif input de GPT-6.1 Sol au niveau d'Opus 5.5, et l'économie se réduit à la marge. Si vos invites embarquent régulièrement des codebases entiers, budgétez comme si les deux coûtaient pareil.
Les éditeurs utilisent des tokenizers différents, et aucun n'a publié de comptages sur une charge commune ; considérez donc ces totaux comme une comparaison de grilles, pas une facture.
Performances de GPT-6.1 Sol et Claude Opus 5.5
Les benchmarks ci-dessus sont ceux des éditeurs, donc j'ai exécuté une tâche de build contre GPT-6.1 Sol et Claude Opus 5.5 avec une invite et un outillage identiques.
La tâche : un agenda de rendez-vous en HTML fichier unique pour une clinique de santé, vue hebdomadaire lundi→dimanche des rendez-vous de kiné, dentaire, imagerie et pédiatrie, formulaire pour ajouter, modifier, supprimer, persistance via localStorage, et une semaine d'exemple d'une dizaine de rendez-vous. Pas d'étape de build, pas de dépendances, pas de réseau.
La difficulté réside dans la logique de conflit, qui doit respecter plusieurs règles simultanément :
- Deux rendez-vous sont en conflit s'ils se superposent dans la même salle, ou s'ils se superposent avec le même praticien
- Les enchaînements dos à dos, où l'un finit exactement quand l'autre commence, ne doivent pas être signalés
- Chaque signalement doit nommer l'autre rendez-vous et la raison, pas seulement passer au rouge
- Les drapeaux doivent se mettre à jour après chaque édition et suppression, et survivre à un rechargement
- La semaine pré-remplie doit comporter exactement deux conflits de salle et un conflit de praticien
Ce test me plaît car il éprouve à la fois l'affirmation d'OpenAI selon laquelle GPT-6.1 Sol égale GPT-6 Astra sur de vrais codebases, et le positionnement d'Anthropic d'Opus 5.5 comme agent de codage longue durée.
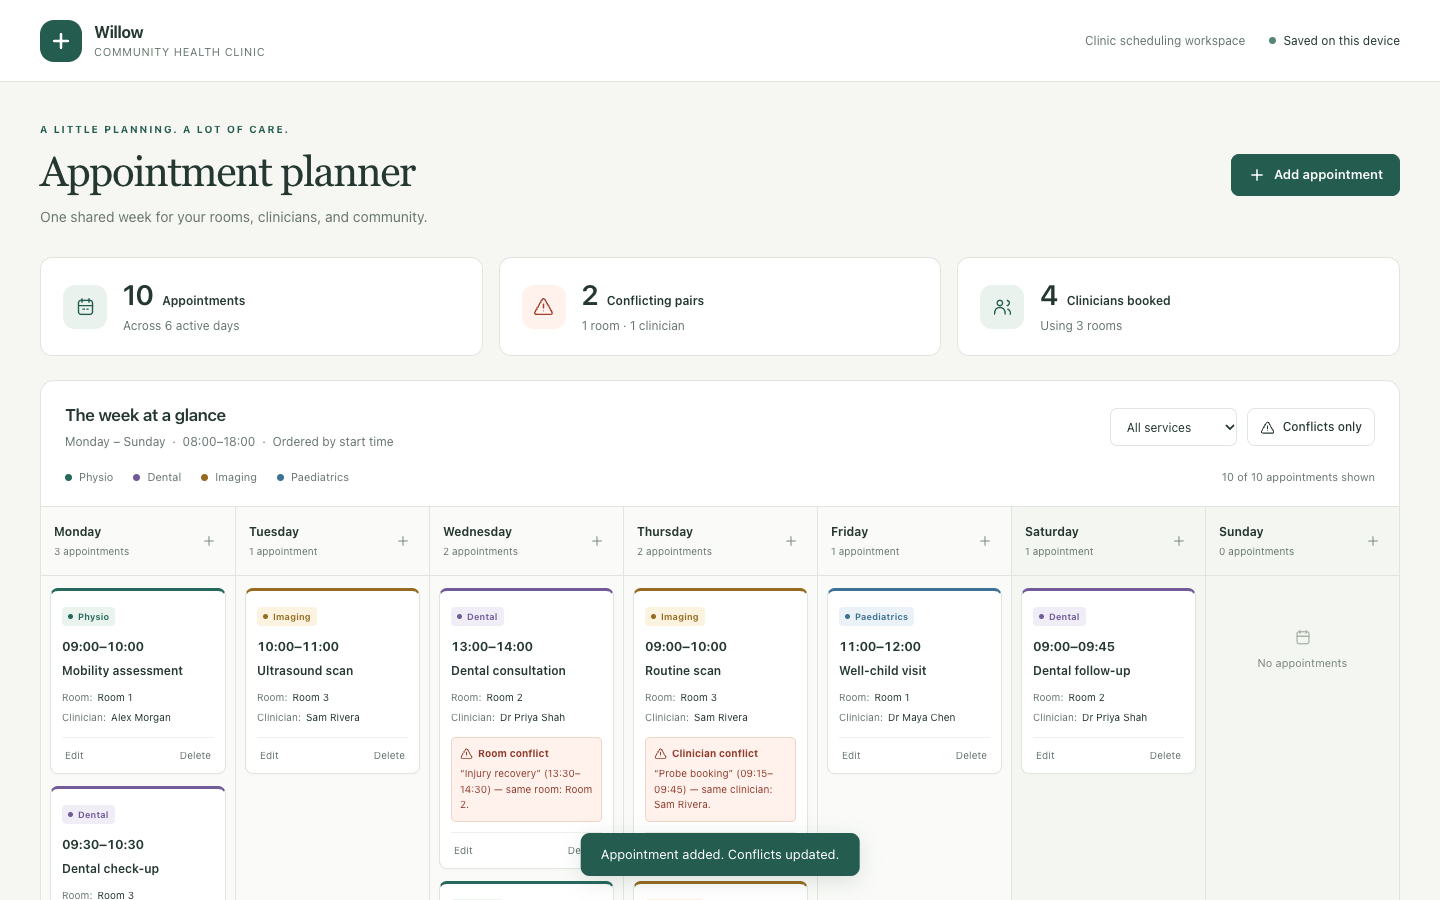
Voici le planificateur de GPT-6.1 Sol après déplacement, suppression et ajout d'un rendez-vous en double réservation d'un praticien. La nouvelle réservation du jeudi est signalée en nommant le rendez-vous en conflit :
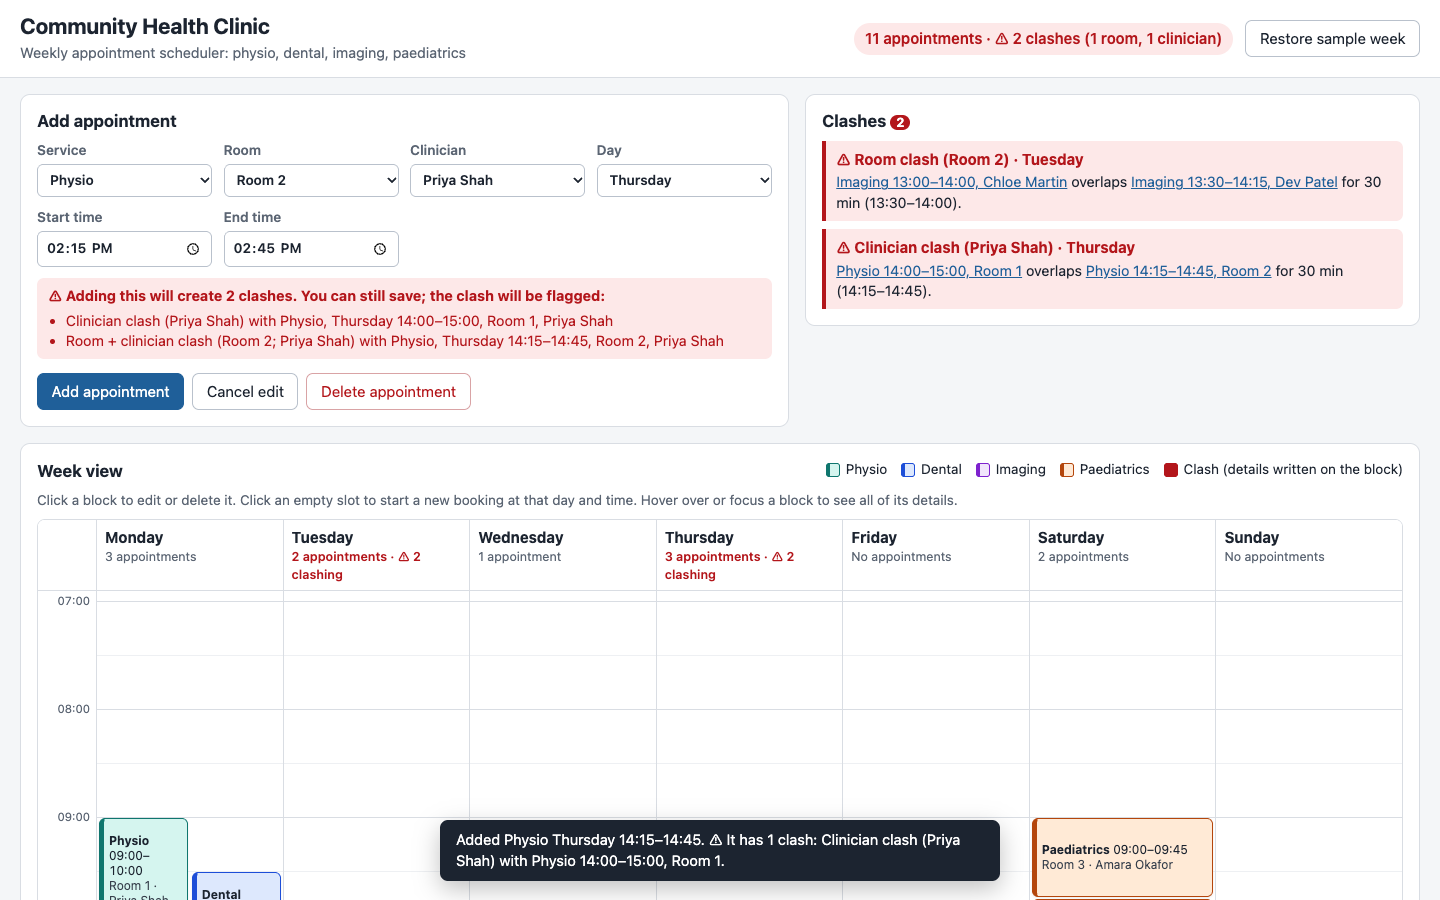
Et voici celui d'Opus 5.5 après les mêmes actions, avec un panneau de conflits listant chaque paire restante et la durée du chevauchement :
Principaux constats :
- Sur la logique de conflit, aucun ne s'est détaché. Les deux pages s'ouvrent avec exactement deux conflits de salle et un de praticien, chacun nommant l'autre rendez-vous et la raison, et laissent les rendez-vous enchaînés tranquilles.
- Ni les éditions, ni les suppressions, ni les rechargements n'ont piégé les modèles. Déplacer un rendez-vous vers une salle libre supprime les deux moitiés de son conflit, supprimer une moitié du conflit de praticien supprime l'autre, un nouvel ajout en double réservation de praticien est correctement signalé, et tout persiste après rechargement.
- Les différences tiennent à la présentation. GPT-6.1 Sol a produit une page plus soignée, avec cartes récap, filtre par service et un interrupteur "Conflits uniquement", mais il liste les rendez-vous du jour par heure plutôt que sur une grille horaire. Opus 5.5 ajoute un panneau de conflits indiquant la durée de chaque chevauchement et prévient avant l'enregistrement, mais sa grille hebdo n'entre pas sans défilement.
- Opus 5.5 a écrit la semaine d'exemple la plus piègeuse. Sa graine incluait un chevauchement dans des salles différentes avec des praticiens différents.
J'ai noté les deux à 5/5 sur l'adhérence au cahier des charges et la logique de conflit. GPT-6.1 Sol a eu 5 en ergonomie et mise en page, Opus 5.5 a eu 4 car sa vue semaine ne tient pas sur un écran.
La différence se joue sur le coût. Opus 5.5 a généré plus du double de tokens de sortie, majoritairement en raisonnement :
- GPT-6.1 Sol : 0,27 $
- Claude Opus 5.5 : 1,11 $
Qui gagne alors ? Sur cette tâche, GPT-6.1 Sol, principalement sur le prix. Les deux ont livré un agenda correct et fonctionnel, et GPT-6.1 Sol l'a fait pour environ un quart du coût.
Quand choisir GPT-6.1 Sol vs Claude Opus 5.5
Pour la plupart des équipes, l'arbitrage se fait au coût par tâche : GPT-6.1 Sol atteint les scores rapportés par OpenAI pour environ un cinquième à la moitié de la dépense d'Opus 5.5. Les exceptions : les invites très longues, les derniers points de succès sur des runs exigeants, et la plateforme de déploiement.
Choisissez GPT-6.1 Sol si ...
- Vous exécutez des agents à grande échelle. En automatisation de workflows métier, il devance Opus 5.5 en effort moyen pour environ un tiers du coût par tâche, ce qui se cumule sur des milliers d'exécutions.
- Votre travail consiste à interroger des documents denses. Il devance Opus 5.5 sur le benchmark PDF d'OpenAI à tous les niveaux d'effort, pour moins de la moitié du coût.
- Votre équipe utilise déjà ChatGPT Work ou Codex. C'est le modèle recommandé là-bas par OpenAI pour le code complexe et le travail agentique.
- Vous réutilisez de longues invites système ou du contexte. La lecture de cache à 0,10 $ par million de tokens rend les boucles d'agents répétitives très économiques, tant que chaque invite reste sous 272 K tokens.
Choisissez Claude Opus 5.5 si ...
- Vos invites dépassent régulièrement 272 K tokens. Le surcoût de GPT-6.1 Sol efface l'essentiel de son avantage prix, et Opus 5.5 n'applique aucun surcoût long contexte.
- Un échec coûte plus cher que les tokens. À effort maximal, Opus 5.5 signe le meilleur score AutomationBench sur le graphique d'OpenAI, devant même GPT-6 Astra.
- Vous déployez via Cursor, Amazon Bedrock ou Google Vertex AI. Opus 5.5 est listé sur les trois ; GPT-6.1 Sol n'apparaît pas encore dans la doc Cursor ou Vertex AI.
- Vous préférez les garde-fous conservateurs d'Anthropic pour des agents autonomes. Ses protections redirigent les tâches risquées en sécurité et biologie vers d'autres modèles plutôt que d'essayer.
Comment démarrer avec GPT-6.1 Sol et Claude Opus 5.5
| Surface | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| App grand public | ChatGPT Work et Codex (Plus, Pro, Business, Enterprise, Edu) ; pas encore dans Chat | Apps Claude (Pro, Max, Team, Enterprise) |
| API first-party | OpenAI API (appel d'outils via la Responses API) | Claude API |
| Plateformes cloud | Azure AI Foundry ; non listé dans la doc Vertex AI au 30 septembre 2026 | Amazon Bedrock, Google Vertex AI, Azure AI Foundry |
| Agents de code | Codex, GitHub Copilot ; non listé dans la doc Cursor au 30 septembre 2026 | Claude Code, Cursor, GitHub Copilot |
| Routeurs tiers | OpenRouter (openai/gpt-6.1-sol) | OpenRouter (anthropic/claude-opus-5.5) |
| ID de modèle API | gpt-6.1-sol |
claude-opus-5-5 |
La plus grande différence concerne la portée : Opus 5.5 est présent sur les trois grands clouds et dans Cursor, tandis que GPT-6.1 Sol est recentré sur les produits OpenAI, Azure et Copilot.
Premiers appels API
Les deux modèles utilisent des SDK différents ; changer de modèle implique donc aussi de changer de client :
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6.1-sol",
    reasoning={"effort": "medium"},
    input="Summarize the payment terms in this contract: ...",
)
print(response.output_text)
from anthropic import Anthropic
client = Anthropic()
response = client.messages.create(
model="claude-opus-5-5",
max_tokens=2048,
messages=[{"role": "user", "content": "Summarize the payment terms in this contract: ..."}],
)
print(next(b.text for b in response.content if b.type == "text"))Pour des mises en œuvre complètes, consultez notre tutoriel API GPT-6 Sol et notre tutoriel API Opus 5.5, également cités plus haut.
Conclusion
Si votre contrainte est le coût par tâche, choisissez GPT-6.1 Sol. Si vous visez le meilleur taux de réussite sur des runs d'agents difficiles, envoyez de très longues invites, ou déployez via Cursor ou Bedrock, optez pour Opus 5.5.
Ce qui me frappe le plus, c'est que les graphiques d'OpenAI plaident pour les deux. Le titre retient l'effort moyen, mais le même graphique montre Opus 5.5 en tête à effort maximal. OpenAI parie que la plupart des acheteurs se soucient du point le moins cher de la courbe, et pour des agents du quotidien, je pense qu'il a raison.
Parce que Sol est un modèle intermédiaire, GPT-6.1 Sol vs Claude Sonnet 5.5 mérite aussi un test.
Et si vous construisez sur l'un ou l'autre, nous vous recommandons notre parcours de compétences OpenAI Fundamentals ou notre cours Introduction to Claude Models.