
Last chance! 50% off DataCamp Premium
Sale ends in
OpenAI đã tận dụng DevDay ngày 29 tháng 9 để ra mắt GPT-6.1 Sol, bản nâng cấp cho mô hình tầm trung của hãng, được cho là tiệm cận GPT-6 Astra chủ lực với mức giá token bằng một phần năm Astra. Trước đó một tuần, Anthropic ra mắt Claude Opus 5.5, được quảng bá có hiệu năng mức Fable 5.1 với chi phí thấp hơn 40%.
Đây đều là những bước đi về hiệu suất, và bài ra mắt của OpenAI nêu đích danh Opus 5.5, khẳng định thắng thế trong quy trình công việc doanh nghiệp và xử lý tài liệu với chi phí mỗi tác vụ chỉ bằng một phần nhỏ. Tuy nhiên, ngay chính biểu đồ của OpenAI kể câu chuyện thú vị hơn tiêu đề, vì kết quả so sánh thay đổi tùy theo mức nỗ lực bạn chọn.
Trong bài viết này, chúng tôi so sánh GPT-6.1 Sol với Opus 5.5 chủ yếu vì bài ra mắt của OpenAI đặt hai mô hình này đối đầu trực diện, nhưng Claude Sonnet 5.5 cũng là phép so sánh công bằng khác, đã được chúng tôi đề cập trong bài GPT-6.1 Sol vs Claude Sonnet 5.5.
GPT-6.1 Sol là mô hình lập luận tầm trung của OpenAI trong họ GPT-6, phát hành ngày 29 tháng 9, 2026 như bản nâng cấp của GPT-6 Sol.
Điểm bán của nó là kết quả gần như Astra trong mã hóa, sử dụng máy tính và công việc chuyên môn với mức giá thấp hơn nhiều, cùng chi phí đọc bộ nhớ đệm đầu vào rẻ hơn hướng đến các agent tái sử dụng ngữ cảnh qua nhiều yêu cầu.
Hướng dẫn GPT-6.1 Sol của chúng tôi bao quát bản phát hành; hướng dẫn API GPT-6 Sol của chúng tôi xây dựng một agent di trú codebase trên phiên bản trước.
Claude Opus 5.5 là mô hình Opus chủ lực của Anthropic, phát hành như mô hình đầu tiên trong họ Claude 5.5.
Anthropic định vị nó cho công việc mã hóa tác vụ dài hơi và tri thức, đạt mức tương đương Claude Fable 5.1 ở hầu hết nhiệm vụ với chi phí thấp hơn, cùng khả năng tư duy thích ứng luôn bật.
Hướng dẫn Claude Opus 5.5 của chúng tôi bao quát bản phát hành; hướng dẫn API Opus 5.5 của chúng tôi xây dựng một công cụ điều tra sự cố AI.
GPT-6.1 Sol và Opus 5.5 chỉ trùng nhau trên ba benchmark đã công bố, đều từ biểu đồ ra mắt của OpenAI. Opus 5.5 đạt điểm cao nhất trên hai trong số đó, và GPT-6.1 Sol đạt kết quả của mình với chi phí mỗi tác vụ thấp hơn 2x đến 5x trên cả ba.
| Tính năng | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| AutomationBench (điểm tốt nhất, chi phí mỗi tác vụ) | 36,1% ở mức tối đa, $0,30 | 42,5% ở mức tối đa, $1,44 |
| GDP.pdf (điểm tốt nhất, chi phí mỗi tác vụ) | 32,0% ở mức cao, $0,35 | 28,8% ở mức cao, $0,83 |
| Terminal-Bench Science 0.1 (nỗ lực tối đa) | 57,0%, $5,47 | 63,3%, $23,21 |
| DeepSWE v1.1 | 75,2% ở mức cao | Không công bố |
| Terminal-Bench 4.0 | Không công bố | 66,4% ở mức tối đa |
| Sử dụng máy tính | 71,4% trên OSWorld 2.0 offline (tối đa) | 81,8% trên OSWorld 2.1 |
| Cửa sổ ngữ cảnh / đầu ra tối đa | 1,05M / 128K | 1M / 128K |
| Mốc kiến thức | Tháng 4/2026 | Tháng 6/2026 |
| Các mức nỗ lực | low, medium (mặc định), high, xhigh, max | low, medium (mặc định), high, xhigh, max |
Ba hàng đầu tiên đến từ biểu đồ của OpenAI, trong đó kết quả Claude được dán nhãn "Opus 5.5 w/ fallbacks". Mọi mục khác là do mỗi nhà cung cấp báo cáo về mô hình của mình.
Đây là nơi OpenAI chọn “trận địa”, và nơi mức nỗ lực quyết định kẻ thắng người thua.
Tiêu đề của OpenAI nói GPT-6.1 Sol cao hơn Opus 5.5 là 2,2 điểm trên AutomationBench, bài kiểm tra agent của Zapier về việc hoàn thành quy trình nhiều bước trên hàng chục công cụ doanh nghiệp. Điều đó đúng ở mức nỗ lực trung bình, khi GPT-6.1 Sol đạt 31,7% với $0,19 mỗi tác vụ, so với 29,5% với $0,65 của Opus 5.5.
Khi đều đẩy lên mức tối đa, thứ hạng đảo ngược. Opus 5.5 leo lên 42,5%, vượt cả GPT-6 Astra, trong khi GPT-6.1 Sol dừng ở 36,1%. Opus 5.5 trả giá cho điều đó với chi phí mỗi tác vụ gần gấp 5 lần, nên câu hỏi là sáu điểm thành công quy trình có đáng với agent của bạn không. Với bot hỗ trợ xử lý hàng nghìn vé, có lẽ không. Với quy trình tài chính nơi một lần chạy lỗi đồng nghĩa con người phải làm lại, có thể có.
GPT-6.1 Sol có giá trị tốt hơn cho công việc tài liệu và tự động hóa thường nhật. Opus 5.5 là lựa chọn khi những lượt chạy khó nhất buộc phải thành công.
Không có benchmark mã hóa chung, nên số liệu của mỗi bên đứng độc lập trong bảng. OpenAI nói GPT-6.1 Sol ngang GPT-6 Astra trên DeepSWE v1.1, bài kiểm tra kỹ thuật dài hạn trên codebase thực, trong khi Anthropic báo cáo Opus 5.5 dẫn trước GPT-6 Astra trên Terminal-Bench 4.0 và FrontierCode.
Trong bài thử thực tế trước đây, GPT-6 Sol, phiên bản trước, đánh bại Opus 5.5 ở bài dựng Tetris với chi phí vận hành chưa tới một phần ba (xem so sánh GPT-6 Sol vs Claude Opus 5.5), nên chúng tôi nghiêng về việc GPT-6.1 Sol sẽ thắng.
Hiện chưa thể so sánh hai mô hình ở hạng mục này. OpenAI báo cáo GPT-6.1 Sol trên bộ offline của OSWorld 2.0, kém GPT-6 Astra chỉ 2,1 điểm, trong khi Anthropic báo cáo Opus 5.5 trên OSWorld 2.1, phiên bản mới hơn với tác vụ khác. Không bên nào công bố kết quả trên phiên bản của bên kia, nên các con số trong bảng tổng hợp không phải đối đầu trực diện. Hãy coi hạng mục sử dụng máy tính là còn bỏ ngỏ đến khi ai đó chạy cả hai trên cùng một bộ.
Opus 5.5 thực tế là mô hình bị hạn chế hơn. Anthropic định tuyến hầu hết tác vụ an ninh mạng sang Opus 4.8 trừ khi bạn nằm trong Chương trình Xác minh An ninh mạng của họ, và công việc sinh học cũng có các cơ chế dự phòng tương tự. Đó cũng là lý do biểu đồ của OpenAI gắn nhãn kết quả của Claude là "with fallbacks".
Ràng buộc của GPT-6.1 Sol lại nằm ở API. Nó không có mức nỗ lực none hay minimal, và gọi công cụ chỉ hoạt động qua Responses API, không phải Chat Completions. Opus 5.5 giữ tư duy thích ứng luôn bật và từ chối ép buộc dùng công cụ. Với đội an ninh, cơ chế định tuyến của Opus 5.5 là khác biệt thực tế lớn hơn; với nhà phát triển di trú mã, đó là thay đổi API của GPT-6.1 Sol.
GPT-6.1 Sol có chi phí đúng bằng một nửa Opus 5.5 trên mọi mức giá chuẩn, cho đến khi một prompt vượt 272K token đầu vào.
| Mức | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| Đầu vào, mỗi 1M token | $2,00 | $4,00 |
| Đầu ra, mỗi 1M token | $10,00 | $20,00 |
| Đọc bộ nhớ đệm đầu vào, mỗi 1M token | $0,10 | $0,20 |
| Ghi bộ nhớ đệm, mỗi 1M token | $2,50 | $5,00 (5 phút), $8,00 (1 giờ) |
| Phụ phí ngữ cảnh dài | Trên 272K token đầu vào: gấp đôi đầu vào và bộ nhớ đệm, gấp 1,5 lần đầu ra cho toàn bộ yêu cầu | Không có |
| Giảm giá theo lô | 50% | 50% |
| Chế độ nhanh | Gấp 2 lần mức chuẩn | $8 / $40 mỗi 1M token |
Hệ số cố định 0,5x áp dụng cho cả đầu vào, đầu ra và đọc bộ nhớ đệm, nên với các prompt cỡ bình thường, so sánh có thể tóm gọn thành "GPT-6.1 Sol tốn bằng một nửa". Cả hai mô hình tính token lập luận như đầu ra, điều này quan trọng hơn với Opus 5.5 vì chế độ tư duy của nó không thể tắt.
| Khối lượng công việc | GPT-6.1 Sol | Claude Opus 5.5 | Khác biệt |
|---|---|---|---|
| Trợ lý cân bằng: 1M vào / 250K ra | $4,50 | $9,00 | $4,50 (giảm 50%) |
| Truy xuất, mỗi yêu cầu dưới 272K: 10M vào / 1M ra | $30 | $60 | $30 (giảm 50%) |
| Truy xuất, mỗi yêu cầu trên 272K: 10M vào / 1M ra | $55 | $60 | $5 (giảm 8%) |
Mỗi tổng chi phí là (khối lượng ÷ 1M) × mức giá, cộng gộp giữa đầu vào và đầu ra, theo mức chuẩn.
Hai bên dùng bộ tách token khác nhau, và không bên nào công bố số token cho cùng một khối lượng công việc, nên hãy coi các tổng này là so sánh mức giá chứ không phải hóa đơn.
Các benchmark trên là do nhà cung cấp tự công bố, nên tôi đã chạy một tác vụ build với cùng prompt và cùng công cụ, lần lượt trên GPT-6.1 Sol và Claude Opus 5.5.
Tác vụ: một bộ lập lịch hẹn HTML một tệp cho phòng khám sức khỏe cộng đồng, với chế độ xem tuần từ Thứ Hai đến Chủ Nhật cho lịch hẹn vật lý trị liệu, nha khoa, chẩn đoán hình ảnh và nhi khoa; biểu mẫu để thêm, sửa, xóa đặt chỗ; lưu trữ qua localStorage; và một tuần mẫu gồm khoảng mười lịch hẹn. Không có bước build, không phụ thuộc, không mạng.
Phần khó là logic xung đột, phải giữ đồng thời nhiều quy tắc:
Tôi thích bài test này vì nó kiểm chứng tuyên bố của OpenAI rằng GPT-6.1 Sol ngang GPT-6 Astra về kỹ thuật trên codebase thực, và thông điệp của Anthropic về Opus 5.5 như một agent mã hóa chạy dài hơi.
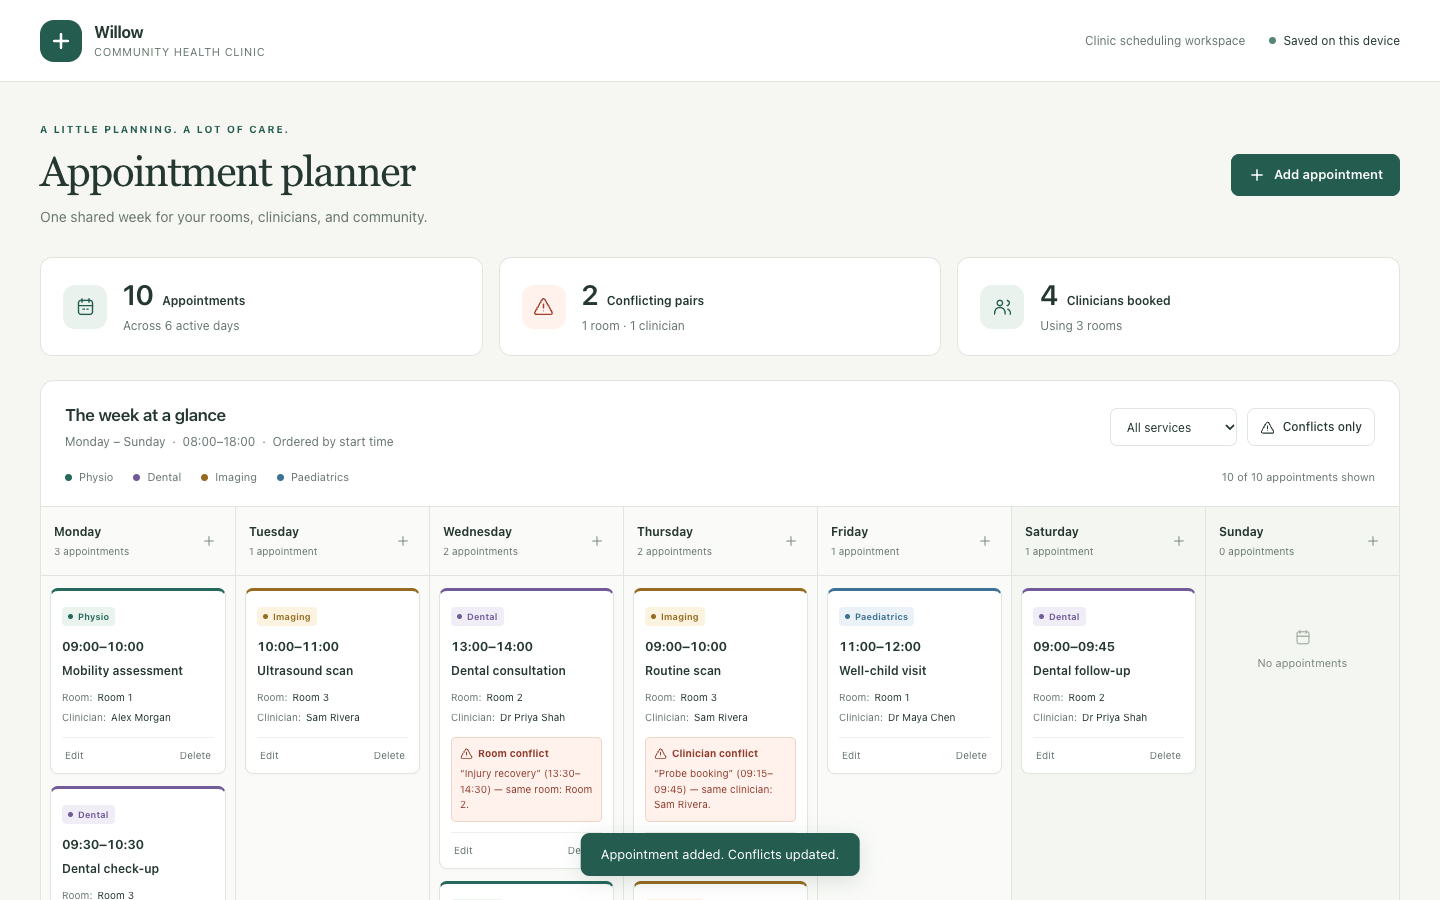
Dưới đây là bộ lập lịch của GPT-6.1 Sol sau khi tôi di chuyển một đặt chỗ, xóa một chỗ, và thêm một chỗ mới trùng bác sĩ. Lịch mới ngày Thứ Năm được gắn cờ, nêu tên lịch hẹn bị trùng:
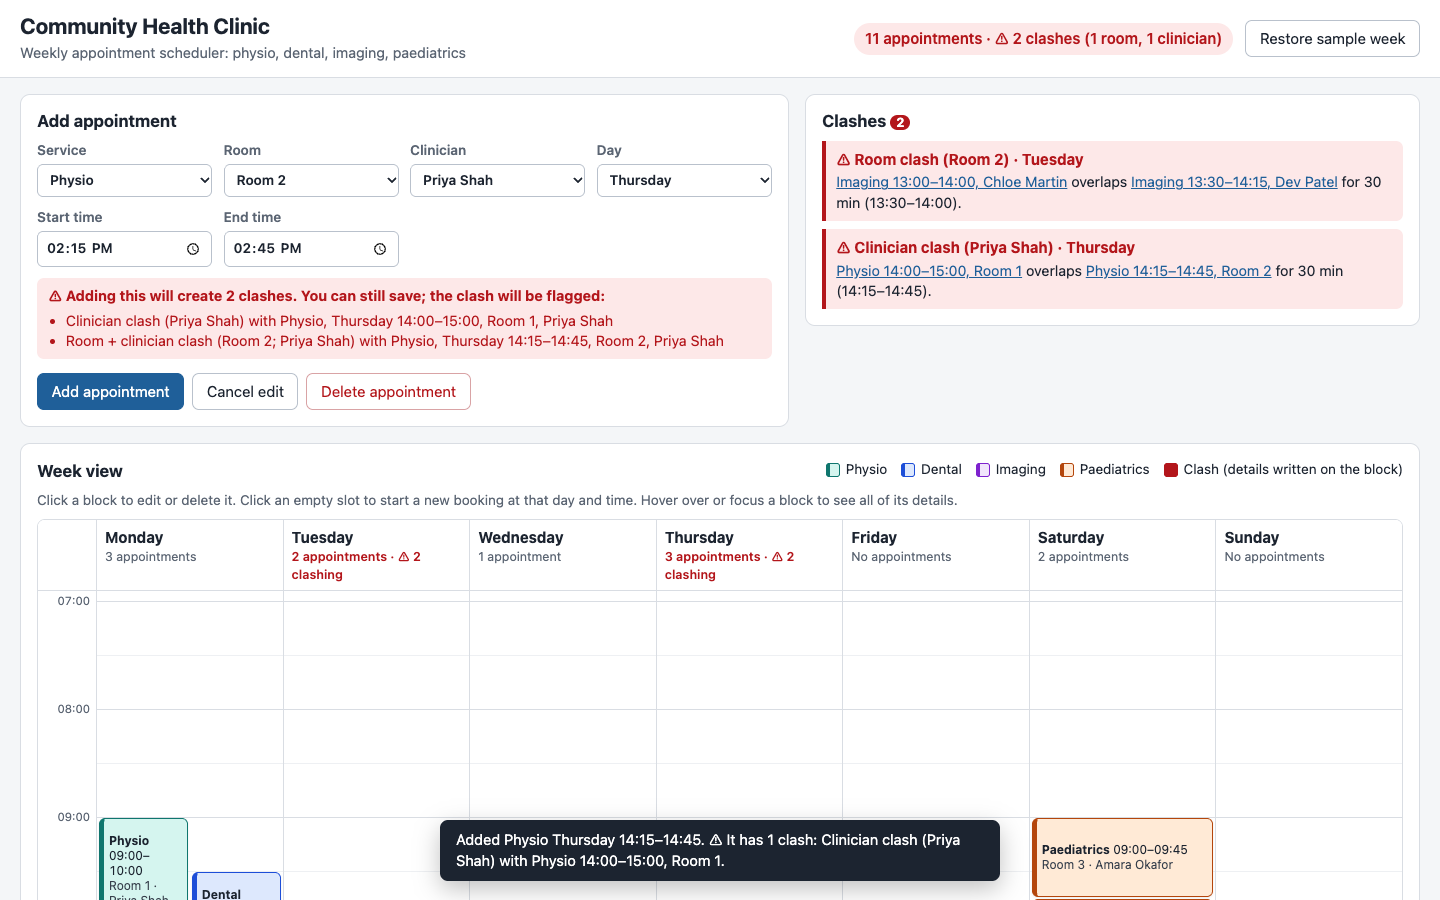
Còn đây là của Opus 5.5 sau các bước tương tự, với bảng xung đột liệt kê từng cặp còn lại và thời lượng trùng lặp:
Kết luận chính:
Tôi chấm cả hai 5/5 về tuân thủ yêu cầu và logic xung đột. GPT-6.1 Sol được 5 điểm về khả năng sử dụng và bố cục, còn Opus 5.5 được 4 vì chế độ xem tuần không vừa một màn hình.
Chi phí là nơi chúng tách nhau. Opus 5.5 dùng nhiều token đầu ra hơn gấp đôi, chủ yếu cho phần tư duy:
Vậy ai thắng? Với tác vụ này, GPT-6.1 Sol, chủ yếu nhờ giá. Cả hai đều tạo ra bộ lập lịch đúng và hoạt động tốt, và GPT-6.1 Sol làm điều đó với chi phí khoảng một phần tư.
Với hầu hết đội ngũ, ngã rẽ nằm ở chi phí mỗi tác vụ: GPT-6.1 Sol đạt các điểm số do OpenAI báo cáo với chi phí xấp xỉ một phần năm đến một nửa so với Opus 5.5. Ngoại lệ là prompt dài, vài điểm cuối cùng của thành công trên các lượt chạy khó, và môi trường bạn triển khai.
| Nền tảng | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| Ứng dụng cho người dùng | ChatGPT Work và Codex (Plus, Pro, Business, Enterprise, Edu); chưa có trong Chat | Ứng dụng Claude (Pro, Max, Team, Enterprise) |
| API chính chủ | OpenAI API (gọi công cụ qua Responses API) | Claude API |
| Nền tảng đám mây | Azure AI Foundry; chưa được liệt kê trong tài liệu Vertex AI tính đến 30/09/2026 | Amazon Bedrock, Google Vertex AI, Azure AI Foundry |
| Agent mã hóa | Codex, GitHub Copilot; chưa được liệt kê trong tài liệu Cursor tính đến 30/09/2026 | Claude Code, Cursor, GitHub Copilot |
| Bộ định tuyến bên thứ ba | OpenRouter (openai/gpt-6.1-sol) | OpenRouter (anthropic/claude-opus-5.5) |
| ID mô hình API | gpt-6.1-sol |
claude-opus-5-5 |
Khác biệt lớn nhất là độ phủ: Opus 5.5 có trên cả ba đám mây lớn và trong Cursor, còn GPT-6.1 Sol tập trung ở sản phẩm của OpenAI, Azure và Copilot.
Hai mô hình dùng SDK khác nhau, nên khi chuyển đổi bạn cần thay client cũng như chuỗi mô hình:
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6.1-sol",
    reasoning={"effort": "medium"},
    input="Summarize the payment terms in this contract: ...",
)
print(response.output_text)
from anthropic import Anthropic
client = Anthropic()
response = client.messages.create(
model="claude-opus-5-5",
max_tokens=2048,
messages=[{"role": "user", "content": "Summarize the payment terms in this contract: ..."}],
)
print(next(b.text for b in response.content if b.type == "text"))Để xây dựng đầy đủ, xem hướng dẫn API GPT-6 Sol và hướng dẫn API Opus 5.5 của chúng tôi, mà tôi cũng đã chia sẻ ở trên.
Nếu chi phí mỗi tác vụ là ràng buộc của bạn, hãy dùng GPT-6.1 Sol. Nếu bạn cần tỷ lệ thành công cao nhất trên các lượt chạy agent khó, gửi prompt dài, hoặc triển khai qua Cursor hay Bedrock, hãy dùng Opus 5.5.
Điều tôi thấy đáng chú ý là ngay chính biểu đồ của OpenAI ủng hộ cả hai bên. Họ chọn mức nỗ lực trung bình cho tiêu đề, nhưng cùng biểu đồ đó cho thấy Opus 5.5 đứng đầu ở mức tối đa. OpenAI đặt cược rằng đa số người mua quan tâm đến điểm rẻ hơn trên đường cong, và với các agent thường nhật, tôi cho rằng họ đúng.
Vì Sol là mô hình tầm trung, GPT-6.1 Sol vs. Claude Sonnet 5.5 cũng đáng để thử nghiệm.
Nếu bạn xây dựng trên một trong hai mô hình, tôi khuyến nghị lộ trình kỹ năng OpenAI Fundamentals hoặc khóa học Introduction to Claude Models của chúng tôi.