На DevDay 29 сентября OpenAI выпустила GPT-6.1 Sol — обновление своего среднего сегмента, которое, по утверждению компании, подбирается к флагману GPT-6 Astra при цене на токены в пять раз ниже. Неделей ранее Anthropic представила Claude Opus 5.5, заявленный как производительность уровня Fable 5.1 на 40% дешевле.
Обе модели делают ставку на эффективность, и в посте OpenAI Opus 5.5 упоминается напрямую — заявлены преимущества в бизнес-процессах и работе с документами при доле стоимости за задачу. Однако собственные графики OpenAI рассказывают интереснее заголовка: результат сравнения меняется в зависимости от выбранного уровня усилия.
В этой статье мы сравниваем GPT-6.1 Sol и Opus 5.5 главным образом потому, что OpenAI сделала именно такое сопоставление в анонсе. Но Claude Sonnet 5.5 — тоже корректная точка сравнения; см. нашу статью GPT-6.1 Sol vs Claude Sonnet 5.5.
Если кратко
- GPT-6.1 Sol — лидер по стоимости задачи: на каждом общем для обеих моделей бенчмарке он достигает результата за долю расходов Opus 5.5.
- Однако разница в цене почти исчезает на промптах свыше 272K токенов, где у GPT-6.1 Sol включается надбавка.
- Opus 5.5 сохраняет более высокий потолок в автоматизации бизнеса и научной терминальной работе при максимальном усилии.
Что такое GPT-6.1 Sol?
GPT-6.1 Sol — модель среднего уровня рассуждений в семействе GPT-6, выпущенная 29 сентября 2026 года как апгрейд GPT-6 Sol.
Её ключевое преимущество — результаты, близкие к Astra, в кодинге, использовании компьютера и профессиональной работе по гораздо более низкой цене, плюс дешёвое чтение кэша для агентов, которые переиспользуют контекст между запросами.
В нашем гайде по GPT-6.1 Sol разбираем запуск; в туториале по API GPT-6 Sol создаём агента для миграции кодовой базы на предыдущей версии.
Что такое Claude Opus 5.5?
Claude Opus 5.5 — флагманская модель Opus от Anthropic, первая в семействе Claude 5.5.
Anthropic позиционирует её для длительных агентных сценариев программирования и работы с знаниями: соответствие Claude Fable 5.1 в большинстве задач при меньшей цене, с постоянно включённым адаптивным мышлением.
Наш гайд по Claude Opus 5.5 освещает релиз; в туториале по API Opus 5.5 мы строим расследователь инцидентов ИИ.
GPT-6.1 Sol и Claude Opus 5.5: сравнение лоб в лоб
GPT-6.1 Sol и Opus 5.5 пересекаются всего на трёх опубликованных бенчмарках — все взяты с графиков запуска OpenAI. Opus 5.5 показывает более высокий лучший счёт на двух из них, а GPT-6.1 Sol достигает своих результатов за 2–5 раз меньшую стоимость задачи на всех трёх.
| Характеристика | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| AutomationBench (лучший счёт, стоимость задачи) | 36,1% при max, $0,30 | 42,5% при max, $1,44 |
| GDP.pdf (лучший счёт, стоимость задачи) | 32,0% при high, $0,35 | 28,8% при high, $0,83 |
| Terminal-Bench Science 0.1 (макс. усилие) | 57,0%, $5,47 | 63,3%, $23,21 |
| DeepSWE v1.1 | 75,2% при high | Не опубликовано |
| Terminal-Bench 4.0 | Не опубликовано | 66,4% при max |
| Использование компьютера | 71,4% на OSWorld 2.0 offline (max) | 81,8% на OSWorld 2.1 |
| Окно контекста / макс. вывод | 1,05M / 128K | 1M / 128K |
| Граница знаний | Апрель 2026 | Июнь 2026 |
| Уровни усилия | low, medium (по умолчанию), high, xhigh, max | low, medium (по умолчанию), high, xhigh, max |
Первые три строки взяты из графиков OpenAI, где результаты Claude помечены как «Opus 5.5 w/ fallbacks». Остальное — отчёты каждого вендора по своей модели.
Бизнес-процессы и документы
Именно здесь OpenAI выбрала поле боя — и именно здесь уровень усилия решает исход.
В заголовке OpenAI говорится, что GPT-6.1 Sol набирает на 2,2 пункта больше Opus 5.5 на AutomationBench — тесте Zapier по выполнению агентами многошаговых сценариев в десятках бизнес-инструментов. Это верно при среднем усилии: GPT-6.1 Sol — 31,7% за $0,19 за задачу против 29,5% у Opus 5.5 за $0,65.
Включите обе модели на max — и порядок меняется. Opus 5.5 поднимается до 42,5%, обгоняя даже GPT-6 Astra, тогда как GPT-6.1 Sol упирается в 36,1%. За это Opus 5.5 платит почти пятикратной стоимостью задачи, так что вопрос в том, стоят ли шесть пунктов успеха вашего агента этих денег. Для бота поддержки с тысячами тикетов — скорее нет. Для финансового процесса, где неудачный прогон придётся переделывать человеку, — возможно.
Для документов и повседневной автоматизации GPT-6.1 Sol — выгоднее. Opus 5.5 — выбор там, где самые сложные прогоны должны проходить.
Код и научная работа
Общего бенчмарка по программированию нет, поэтому в таблице — цифры вендоров. OpenAI заявляет, что GPT-6.1 Sol сопоставим с GPT-6 Astra на DeepSWE v1.1, который тестирует долгосрочную инженерную работу в реальных кодовых базах, тогда как Anthropic сообщает, что Opus 5.5 лидирует над GPT-6 Astra на Terminal-Bench 4.0 и FrontierCode.
В нашем прежнем практическом тесте GPT-6 Sol (предыдущая версия) обошёл Opus 5.5 при сборке «Тетриса» менее чем за треть стоимости запуска (см. сравнение GPT-6 Sol vs Claude Opus 5.5), так что есть основания полагать, что GPT-6.1 Sol выигрывает.
Использование компьютера
Сравнивать пока нельзя. OpenAI приводит GPT-6.1 Sol на офлайн-наборе OSWorld 2.0 — отстаёт от GPT-6 Astra всего на 2,1 пункта, а Anthropic — Opus 5.5 на OSWorld 2.1, более новой версии с другими задачами. Ни один вендор не опубликовал результаты на версии другого, поэтому цифры в сводной таблице — не лоб в лоб. Считайте «использование компьютера» открытым вопросом, пока обе модели не пройдут один и тот же набор.
Ограничения и условия API
На практике Opus 5.5 — более ограниченная модель. Anthropic маршрутизирует большинство задач по кибербезопасности в Opus 4.8, если вы не в программе Cyber Verification; по биологии — похожие откаты. Поэтому на графиках OpenAI результаты Claude помечены как «with fallbacks».
Ограничения GPT-6.1 Sol — скорее про API. Нет уровней усилия none или minimal, а вызов инструментов работает только через Responses API, а не Chat Completions. В Opus 5.5 адаптивное мышление всегда включено, и он отклоняет принудительное использование инструментов. Для команд безопасности маршрутизация Opus 5.5 — более существенное отличие; для разработчиков, мигрирующих код, — изменения API у GPT-6.1 Sol.
Цены: что вы реально платите
GPT-6.1 Sol стоит ровно вдвое дешевле Opus 5.5 по каждому стандартному тарифу — пока промпт не превысит 272K входных токенов.
Ставки на токены рядом
| Ставка | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| Вход, за 1M токенов | $2,00 | $4,00 |
| Выход, за 1M токенов | $10,00 | $20,00 |
| Чтение из кэша, за 1M токенов | $0,10 | $0,20 |
| Запись в кэш, за 1M токенов | $2,50 | $5,00 (5 минут), $8,00 (1 час) |
| Надбавка за длинный контекст | Свыше 272K входных токенов: 2x для входа и кэша, 1,5x для выхода на весь запрос | Нет |
| Скидка на batch | 50% | 50% |
| Быстрый режим | 2x стандартных ставок | $8 / $40 за 1M токенов |
Плоский множитель 0,5 работает для входа, выхода и чтения кэша, поэтому для нормальных промптов сравнение сводится к «GPT-6.1 Sol стоит вдвое дешевле». Обе модели считают токены рассуждений как выход — это сильнее влияет на Opus 5.5, так как его «мышление» нельзя выключить.
Сколько стоит реальная нагрузка
| Нагрузка | GPT-6.1 Sol | Claude Opus 5.5 | Разница |
|---|---|---|---|
| Сбалансированный ассистент: 1M вход / 250K выход | $4,50 | $9,00 | $4,50 (на 50% меньше) |
| Поиск, каждый запрос до 272K: 10M вход / 1M выход | $30 | $60 | $30 (на 50% меньше) |
| Поиск, каждый запрос свыше 272K: 10M вход / 1M выход | $55 | $60 | $5 (на 8% меньше) |
Каждая сумма — это (объём ÷ 1M) × ставка, сложенная по входу и выходу, по стандартным тарифам.
- Сбалансированный ассистент: классический случай «вдвое дешевле», характерный для большинства чатов и агентных нагрузок.
- Поиск до порога: всё ещё вдвое дешевле, так что RAG-конфигурации, где каждый промпт маленький, получают полную экономию.
- Поиск сверх порога: надбавка удваивает входную ставку GPT-6.1 Sol до уровня Opus 5.5, и экономия сходит на нет. Если ваши промпты регулярно несут целые кодовые базы, бюджетируйте так, будто модели стоят одинаково.
Вендоры используют разные токенизаторы, и ни один не публиковал подсчёт токенов для общего ворклоада, поэтому воспринимайте суммы как сравнение ставок, а не счёт к оплате.
Как показали себя GPT-6.1 Sol и Claude Opus 5.5
Бенчмарки выше — от самих вендоров, поэтому я прогнал одну сборочную задачу на GPT-6.1 Sol и Claude Opus 5.5 с идентичным промптом и инструментами.
Задача: одностраничный HTML-планировщик записей для районной клиники, с недельным видом (понедельник–воскресенье) для приёмов по физиотерапии, стоматологии, диагностике и педиатрии; форма для добавления, редактирования и удаления записей; сохранение в localStorage; и сэмпловая неделя примерно из десяти записей. Без сборки, зависимостей и сети.
Сложность — в логике конфликтов, где нужно одновременно соблюдать несколько правил:
- Два приёма конфликтуют, если они пересекаются в одной и той же комнате или с одним и тем же врачом
- Записи «встык», где одна заканчивается ровно в момент начала следующей, не должны конфликтовать
- Каждый флаг должен указывать вторую запись и причину, а не просто краснеть
- Флаги должны обновляться после каждого редактирования и удаления и переживать перезагрузку
- В сэмпловой неделе должно быть ровно два конфликта по комнатам и один — по врачу
Тест хорош тем, что проверяет тезис OpenAI о сопоставимости GPT-6.1 Sol с GPT-6 Astra в инженерии на реальных кодовых базах и позиционирование Anthropic для Opus 5.5 как долговременного кодового агента.
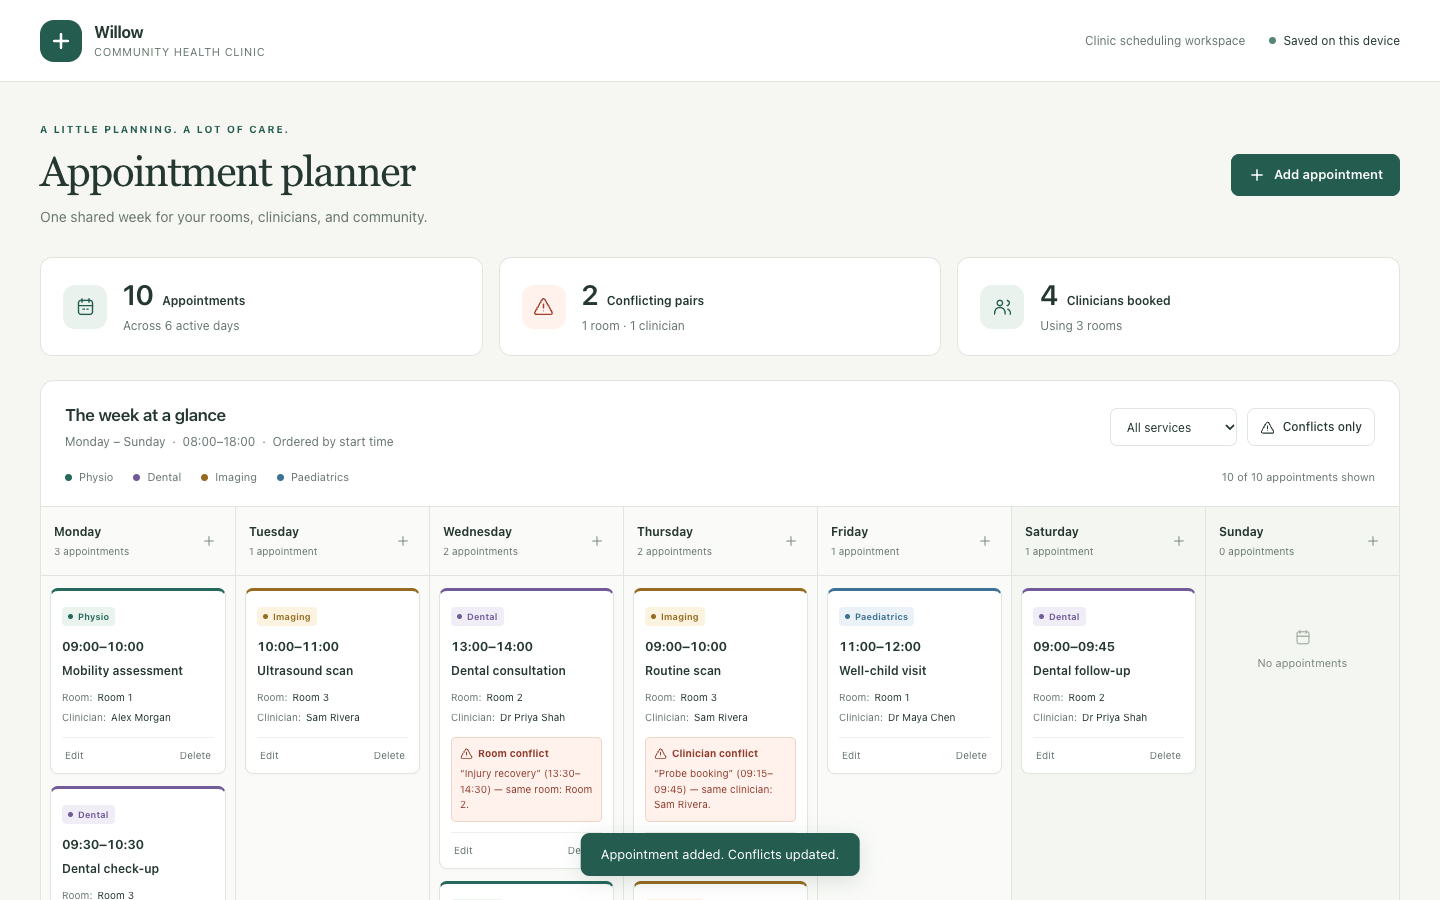
Вот планировщик GPT-6.1 Sol после того, как я перенёс запись, удалил одну и добавил новую, которая двойным бронированием заняла врача. Новая запись в четверг помечена с указанием записи, с которой она конфликтует:
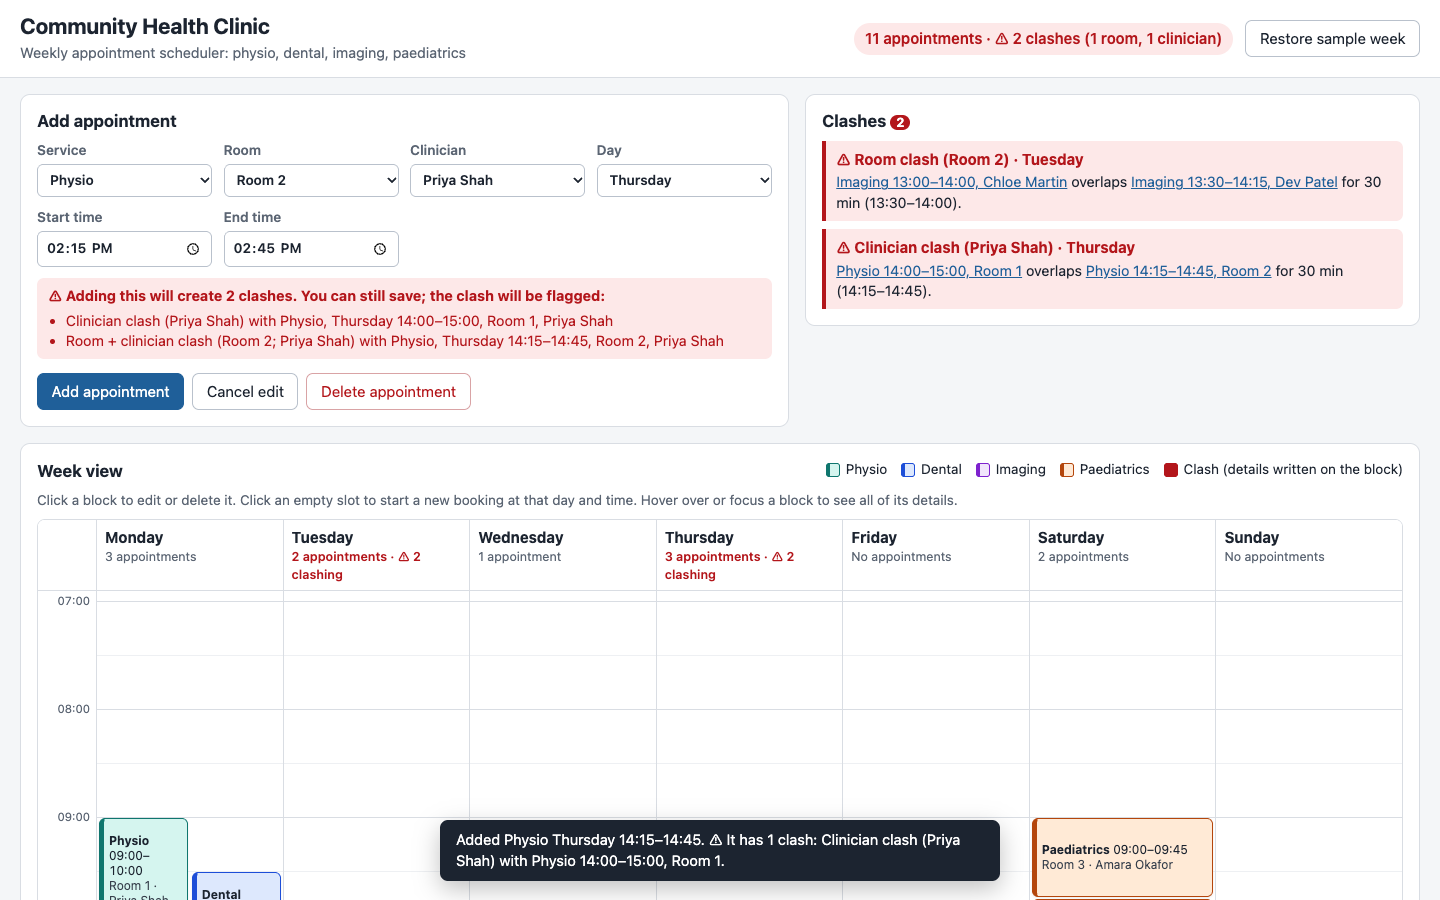
А вот результат Opus 5.5 после тех же шагов: панель конфликтов перечисляет каждую оставшуюся пару и длительность пересечения:
Главные выводы:
- По логике конфликтов никто не оторвался. Обе страницы открылись ровно с двумя конфликтами по комнатам и одним — по врачу, в каждом случае указаны другая запись и причина; записи «встык» обе модели оставили в покое.
- Редактирование, удаление и перезагрузка тоже никого не подвели. Перенос записи в свободную комнату снял обе половины конфликта, удаление одной половины конфликта по врачу сняло вторую, новая запись с двойным бронированием врача была корректно помечена, и всё пережило перезагрузку.
- Различия — в презентации. GPT-6.1 Sol сделал более отполированную страницу с карточками-резюме, фильтром по услугам и переключателем «Только конфликты», но выводит записи дня в порядке времени, а не по временной сетке. Opus 5.5 добавил панель конфликтов с длительностью пересечений и предупреждает о конфликтах до сохранения, но его недельная сетка требует скролла.
- Opus 5.5 составил более хитрый сэмпл-неделю. В начальных данных было пересечение в разных комнатах с разными врачами.
Обеим моделям — 5 из 5 за соответствие спецификации и логику конфликтов. GPT-6.1 Sol получил 5 за удобство и компоновку; Opus 5.5 — 4, потому что недельный вид не умещается на один экран.
Разошлись по стоимости. Opus 5.5 израсходовал более чем вдвое больше выходных токенов — в основном на «мышление»:
- GPT-6.1 Sol: $0,27
- Claude Opus 5.5: $1,11
Кто победил? В этой задаче — GPT-6.1 Sol, и в основном за счёт цены. Обе модели выдали корректный, рабочий планировщик, а GPT-6.1 Sol сделал это примерно за четверть стоимости.
Когда выбирать GPT-6.1 Sol, а когда — Claude Opus 5.5
Для большинства команд развилка — стоимость одной задачи: GPT-6.1 Sol достигает заявленных OpenAI результатов за примерно пятую–половину расходов Opus 5.5. Исключения — длинные промпты, последние проценты успеха на сложных прогонах и место деплоя.
Выберите GPT-6.1 Sol, если…
- Вы запускаете агентов в больших объёмах. В автоматизации бизнес-процессов он обходит Opus 5.5 при среднем усилии примерно за треть стоимости задачи — это критично при тысячах прогонов.
- Ваша работа — вопросы по насыщенным документам. Он опережает Opus 5.5 на PDF-бенчмарке OpenAI на всех уровнях усилия при менее чем половине стоимости.
- Ваша команда уже работает в ChatGPT Work или Codex. Это рекомендованная OpenAI модель для сложного кодинга и агентной работы.
- Вы переиспользуете длинные системные промпты или контекст. Чтение кэша по $0,10 за миллион токенов делает частые циклы агента дешёвыми, пока каждый промпт остаётся ниже 272K токенов.
Выберите Claude Opus 5.5, если…
- Ваши промпты регулярно превышают 272K токенов. Надбавка у GPT-6.1 Sol съедает почти всё ценовое преимущество; у Opus 5.5 такой надбавки нет.
- Неудачный прогон дороже токенов. При max усилии Opus 5.5 показывает самый высокий счёт на AutomationBench в графике OpenAI — выше GPT-6 Astra.
- Вы деплоите через Cursor, Amazon Bedrock или Google Vertex AI. Opus 5.5 доступен на всех трёх; GPT-6.1 Sol ещё не указан в документации Cursor и Vertex AI.
- Вам нужны консервативные настройки Anthropic для автономных агентов. Защиты маршрутизируют рискованные задачи по безопасности и биологии в другие модели вместо попыток выполнить их.
Как начать работу с GPT-6.1 Sol и Claude Opus 5.5
| Среда | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| Пользовательское приложение | ChatGPT Work и Codex (Plus, Pro, Business, Enterprise, Edu); пока нет в Chat | Приложения Claude (Pro, Max, Team, Enterprise) |
| Нативный API | OpenAI API (вызов инструментов через Responses API) | Claude API |
| Облака | Azure AI Foundry; не указан в документации Vertex AI на 30 сентября 2026 | Amazon Bedrock, Google Vertex AI, Azure AI Foundry |
| Кодовые агенты | Codex, GitHub Copilot; не указан в документации Cursor на 30 сентября 2026 | Claude Code, Cursor, GitHub Copilot |
| Маршрутизаторы | OpenRouter (openai/gpt-6.1-sol) | OpenRouter (anthropic/claude-opus-5.5) |
| ID модели в API | gpt-6.1-sol |
claude-opus-5-5 |
Главное различие — охват: Opus 5.5 есть во всех трёх крупных облаках и в Cursor, тогда как GPT-6.1 Sol сосредоточен на продуктах OpenAI, Azure и Copilot.
Первый вызов API
Модели используют разные SDK, поэтому при переключении меняются и клиент, и строка модели:
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6.1-sol",
    reasoning={"effort": "medium"},
    input="Summarize the payment terms in this contract: ...",
)
print(response.output_text)
from anthropic import Anthropic
client = Anthropic()
response = client.messages.create(
model="claude-opus-5-5",
max_tokens=2048,
messages=[{"role": "user", "content": "Summarize the payment terms in this contract: ..."}],
)
print(next(b.text for b in response.content if b.type == "text"))Полные примеры — в нашем туториале по API GPT-6 Sol и туториале по API Opus 5.5, о которых мы уже упоминали.
Итог
Если для вас критична стоимость задачи — используйте GPT-6.1 Sol. Если важнее максимальная успешность сложных агентных прогонов, вы отправляете длинные промпты или деплоите через Cursor или Bedrock — используйте Opus 5.5.
Показательно, что графики самой OpenAI подтверждают оба вывода. В заголовок вынесена точка на среднем усилии, но на том же графике Opus 5.5 лидирует при максимальном. Ставка OpenAI — что большинству покупателей важнее дешевая точка на кривой, и для повседневных агентов это, по всей видимости, верно.
Поскольку Sol — модель среднего уровня, стоит протестировать и GPT-6.1 Sol vs. Claude Sonnet 5.5.
Если вы строите решения на любой из моделей, рекомендуем наш трек навыков OpenAI Fundamentals или курс Introduction to Claude Models.