OpenAI wykorzystało DevDay 29 września do premiery GPT-6.1 Sol, ulepszenia swojego modelu ze średniej półki, który – jak twierdzi firma – zbliża się do flagowego GPT-6 Astra przy jednej piątej ceny tokenów Astry. Tydzień wcześniej Anthropic wprowadził Claude Opus 5.5, reklamowany jako wydajność na poziomie Fable 5.1 za 40% mniej.
To zagrania na efektywność i post OpenAI wprost przywołuje Opus 5.5, deklarując przewagi w biznesowych przepływach pracy i pracy z dokumentami za ułamek kosztu na zadanie. Wykresy OpenAI opowiadają jednak ciekawszą historię niż nagłówek, bo porównanie zmienia się zależnie od ustawienia wysiłku.
W tym artykule zestawiamy GPT-6.1 Sol z Opus 5.5 głównie dlatego, że post premierowy OpenAI robi to bezpośrednio, ale Claude Sonnet 5.5 to również sensowny punkt odniesienia, który omawiamy w tekście GPT-6.1 Sol vs Claude Sonnet 5.5.
TL;DR
- GPT-6.1 Sol prowadzi w koszcie na zadanie: we wszystkich wspólnych benchmarkach osiąga wynik za ułamek wydatku Opus 5.5.
- Jednak różnica cenowa w dużej mierze znika przy promptach powyżej 272 tys. tokenów, gdzie wchodzi dopłata GPT-6.1 Sol.
- Opus 5.5 nadal ma wyższy sufit w automatyzacji biznesu i pracy w terminalu naukowym, gdy uruchomisz go na maksymalnym wysiłku.
Czym jest GPT-6.1 Sol?
GPT-6.1 Sol to model rozumowania ze średniej półki w rodzinie GPT-6, wydany 29 września 2026 jako ulepszenie GPT-6 Sol.
Jego atutem są wyniki zbliżone do Astry w programowaniu, obsłudze komputera i pracy profesjonalnej przy znacznie niższej cenie, z tańszym odczytem z cache dla agentów, którzy wielokrotnie używają tego samego kontekstu.
Nasz przewodnik po GPT-6.1 Sol omawia premierę; nasz samouczek API GPT-6 Sol buduje agenta do migracji kodu na poprzedniej wersji.
Czym jest Claude Opus 5.5?
Claude Opus 5.5 to flagowy model Opus Anthropic, wydany jako pierwszy model z rodziny Claude 5.5.
Anthropic pozycjonuje go do długotrwałego, agentowego programowania i pracy wiedzoznawczej, dorównującego Claude Fable 5.1 w większości zadań przy niższym koszcie, z zawsze włączonym adaptacyjnym rozumowaniem.
Nasz przewodnik po Claude Opus 5.5 omawia premierę; nasz samouczek API Opus 5.5 buduje inspektora incydentów AI.
GPT-6.1 Sol vs Claude Opus 5.5: porównanie bezpośrednie
GPT-6.1 Sol i Opus 5.5 pokrywają się tylko na trzech opublikowanych benchmarkach, wszystkich z wykresów premiery OpenAI. Opus 5.5 ma wyższy najlepszy wynik na dwóch z nich, a GPT-6.1 Sol osiąga swoje rezultaty za 2–5 razy mniejszy koszt na zadanie na wszystkich trzech.
| Funkcja | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| AutomationBench (najlepszy wynik, koszt na zadanie) | 36,1% na max, 0,30 $ | 42,5% na max, 1,44 $ |
| GDP.pdf (najlepszy wynik, koszt na zadanie) | 32,0% na high, 0,35 $ | 28,8% na high, 0,83 $ |
| Terminal-Bench Science 0.1 (max effort) | 57,0%, 5,47 $ | 63,3%, 23,21 $ |
| DeepSWE v1.1 | 75,2% na high | Brak publikacji |
| Terminal-Bench 4.0 | Brak publikacji | 66,4% na max |
| Obsługa komputera | 71,4% na OSWorld 2.0 offline (max) | 81,8% na OSWorld 2.1 |
| Okno kontekstu / maks. wyjście | 1,05 mln / 128 tys. | 1 mln / 128 tys. |
| Granica wiedzy | Kwiecień 2026 | Czerwiec 2026 |
| Poziomy wysiłku | low, medium (domyślny), high, xhigh, max | low, medium (domyślny), high, xhigh, max |
Pierwsze trzy wiersze pochodzą z wykresów OpenAI, które podpisują wyniki Claude jako „Opus 5.5 z fallbackami”. Reszta to dane od każdego dostawcy o własnym modelu.
Przepływy biznesowe i dokumenty
Tu OpenAI wybrało pole bitwy i tu ustawienie wysiłku decyduje o zwycięzcy.
Nagłówek OpenAI mówi, że GPT-6.1 Sol ma o 2,2 punktu więcej niż Opus 5.5 w AutomationBench, teście Zapiera sprawdzającym agentów wykonujących wieloetapowe przepływy przez dziesiątki narzędzi biznesowych. To prawda przy średnim wysiłku: GPT-6.1 Sol zdobywa 31,7% za 0,19 $ na zadanie wobec 29,5% i 0,65 $ u Opus 5.5.
Podkręć oba do max i kolejność się odwraca. Opus 5.5 rośnie do 42,5%, powyżej nawet GPT-6 Astra, podczas gdy GPT-6.1 Sol kończy na 36,1%. Opus 5.5 płaci za to prawie 5× większym kosztem na zadanie, więc pytanie brzmi, czy sześć punktów skuteczności przepływu jest warte dopłaty dla twojego agenta. Dla bota wsparcia obsługującego tysiące zgłoszeń – raczej nie. Dla procesu finansowego, gdzie nieudane uruchomienie oznacza, że człowiek robi to od nowa – być może.
GPT-6.1 Sol daje lepszą wartość w pracy z dokumentami i codziennej automatyzacji. Opus 5.5 wygrywa, gdy najtrudniejsze przebiegi muszą się udać.
Kodowanie i prace naukowe
Nie ma wspólnego benchmarku programistycznego, więc liczby każdego dostawcy w tabeli stoją osobno. OpenAI podaje, że GPT-6.1 Sol dorównuje GPT-6 Astra na DeepSWE v1.1, który testuje długohoryzontalne inżynierowanie w prawdziwych kodach, podczas gdy Anthropic raportuje prowadzenie Opus 5.5 nad GPT-6 Astra w Terminal-Bench 4.0 i FrontierCode.
We wcześniejszym teście praktycznym GPT-6 Sol, poprzednia wersja, pokonał Opus 5.5 w budowie Tetrisa przy koszcie poniżej jednej trzeciej przebiegu (zobacz nasze porównanie GPT-6 Sol vs Claude Opus 5.5), więc podejrzewamy, że GPT-6.1 Sol również wygrywa.
Obsługa komputera
Tych modeli na razie nie da się tu porównać. OpenAI raportuje GPT-6.1 Sol na offline’owym zbiorze OSWorld 2.0, w odległości 2,1 punktu od GPT-6 Astra, podczas gdy Anthropic raportuje Opus 5.5 na OSWorld 2.1, nowszej wersji z innymi zadaniami. Żaden dostawca nie opublikował wyniku na wersji drugiego, więc liczby w tabeli nie są bezpośrednim starciem. Traktuj „obsługę komputera” jako otwartą, dopóki ktoś nie uruchomi obu na tym samym zestawie.
Bezpieczeństwo i ograniczenia API
W praktyce bardziej restrykcyjny jest Opus 5.5. Anthropic kieruje większość zadań cyberbezpieczeństwa do Opus 4.8, chyba że jesteś w ich Cyber Verification Program, a prace z biologii trafiają na podobne fallbacki. Dlatego wykresy OpenAI podpisują wyniki Claude jako „z fallbackami”.
Ograniczenia GPT-6.1 Sol dotyczą za to API. Nie ma ustawienia wysiłku none ani minimal, a wywołania narzędzi działają tylko przez Responses API, nie Chat Completions. Opus 5.5 utrzymuje adaptacyjne myślenie zawsze włączone i odrzuca wymuszone użycie narzędzi. Dla zespołów bezpieczeństwa większą praktyczną różnicą jest routing w Opus 5.5; dla deweloperów migrujących kod – zmiany w API GPT-6.1 Sol.
Ceny: ile faktycznie zapłacisz
GPT-6.1 Sol kosztuje dokładnie połowę Opus 5.5 na każdej standardowej stawce, dopóki prompt nie przekroczy 272 tys. tokenów wejściowych.
Stawki za tokeny obok siebie
| Stawka | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| Wejście, za 1 mln tokenów | 2,00 $ | 4,00 $ |
| Wyjście, za 1 mln tokenów | 10,00 $ | 20,00 $ |
| Odczyt z cache, za 1 mln tokenów | 0,10 $ | 0,20 $ |
| Zapis do cache, za 1 mln tokenów | 2,50 $ | 5,00 $ (5 min), 8,00 $ (1 godz.) |
| Dopłata za długi kontekst | Powyżej 272 tys. tokenów wejściowych: 2× wejście i cache, 1,5× wyjście dla całego żądania | Brak |
| Zniżka za batch | 50% | 50% |
| Tryb szybki | 2× stawki standardowe | 8 $ / 40 $ za 1 mln tokenów |
Sztywne 0,5× dotyczy wejścia, wyjścia i odczytów cache, więc dla normalnych promptów porównanie sprowadza się do „GPT-6.1 Sol kosztuje połowę”. Oba modele rozliczają tokeny rozumowania jako wyjście, co bardziej liczy się przy Opus 5.5, bo jego myślenia nie da się wyłączyć.
Ile kosztuje realne obciążenie
| Obciążenie | GPT-6.1 Sol | Claude Opus 5.5 | Różnica |
|---|---|---|---|
| Asystent zbalansowany: 1 mln in / 250 tys. out | 4,50 $ | 9,00 $ | 4,50 $ (50% mniej) |
| Retrieval, każde żądanie poniżej 272 tys.: 10 mln in / 1 mln out | 30 $ | 60 $ | 30 $ (50% mniej) |
| Retrieval, każde żądanie powyżej 272 tys.: 10 mln in / 1 mln out | 55 $ | 60 $ | 5 $ (8% mniej) |
Każdy total to (wolumen ÷ 1 mln) × stawka, zsumowane dla wejścia i wyjścia, w stawkach standardowych.
- Asystent zbalansowany: czysty przypadek „połowa ceny” i najbliższy większości obciążeń czatu i agentów.
- Retrieval poniżej progu: nadal połowa ceny, więc konfiguracje RAG utrzymujące każdy prompt małym zyskują pełną oszczędność.
- Retrieval powyżej progu: dopłata podwaja stawkę wejścia GPT-6.1 Sol do poziomu Opus 5.5, a oszczędność topnieje do zaokrąglenia. Jeśli twoje prompty rutynowo niosą całe codebase’y, planuj budżet tak, jakby oba kosztowały tyle samo.
Dostawcy używają różnych tokenizerów i żaden nie opublikował liczby tokenów dla wspólnego obciążenia, więc traktuj te sumy jako porównanie stawek, a nie rachunek.
Jak wypadły GPT-6.1 Sol i Claude Opus 5.5
Powyższe benchmarki pochodzą od dostawców, więc uruchomiłem jedno zadanie budowy przeciwko GPT-6.1 Sol i Claude Opus 5.5 z identycznym promptem i identycznymi narzędziami.
Zadanie: jednoplikowy html-owy terminarz wizyt dla przychodni, z widokiem tygodnia od poniedziałku do niedzieli dla fizjo, stomatologii, diagnostyki obrazowej i pediatrii, formularzem dodawania, edycji i usuwania rezerwacji, trwałością w localStorage oraz zasianym przykładowym tygodniem ok. dziesięciu wizyt. Bez kroków builda, bez zależności, bez sieci.
Trudna część to logika konfliktów, która musi jednocześnie utrzymać kilka reguł:
- Dwie wizyty kolidują, jeśli nachodzą na siebie w tym samym pokoju lub jeśli nachodzą z tym samym lekarzem
- Rezerwacje stykowe, gdzie jedna kończy się dokładnie, gdy zaczyna się następna, nie mogą kolidować
- Każda flaga musi wskazać drugą wizytę i powód, nie tylko zmienić kolor na czerwony
- Flagi muszą się aktualizować po każdej edycji i usunięciu oraz przetrwać reload
- Zasiany tydzień musi zawierać dokładnie dwie kolizje pokojów i jedną kolizję lekarza
Lubię ten test, bo sprawdza tezę OpenAI, że GPT-6.1 Sol dorównuje GPT-6 Astra w inżynierii na prawdziwych kodach, oraz obietnicę Anthropic o Opus 5.5 jako długodziałającym agencie programistycznym.
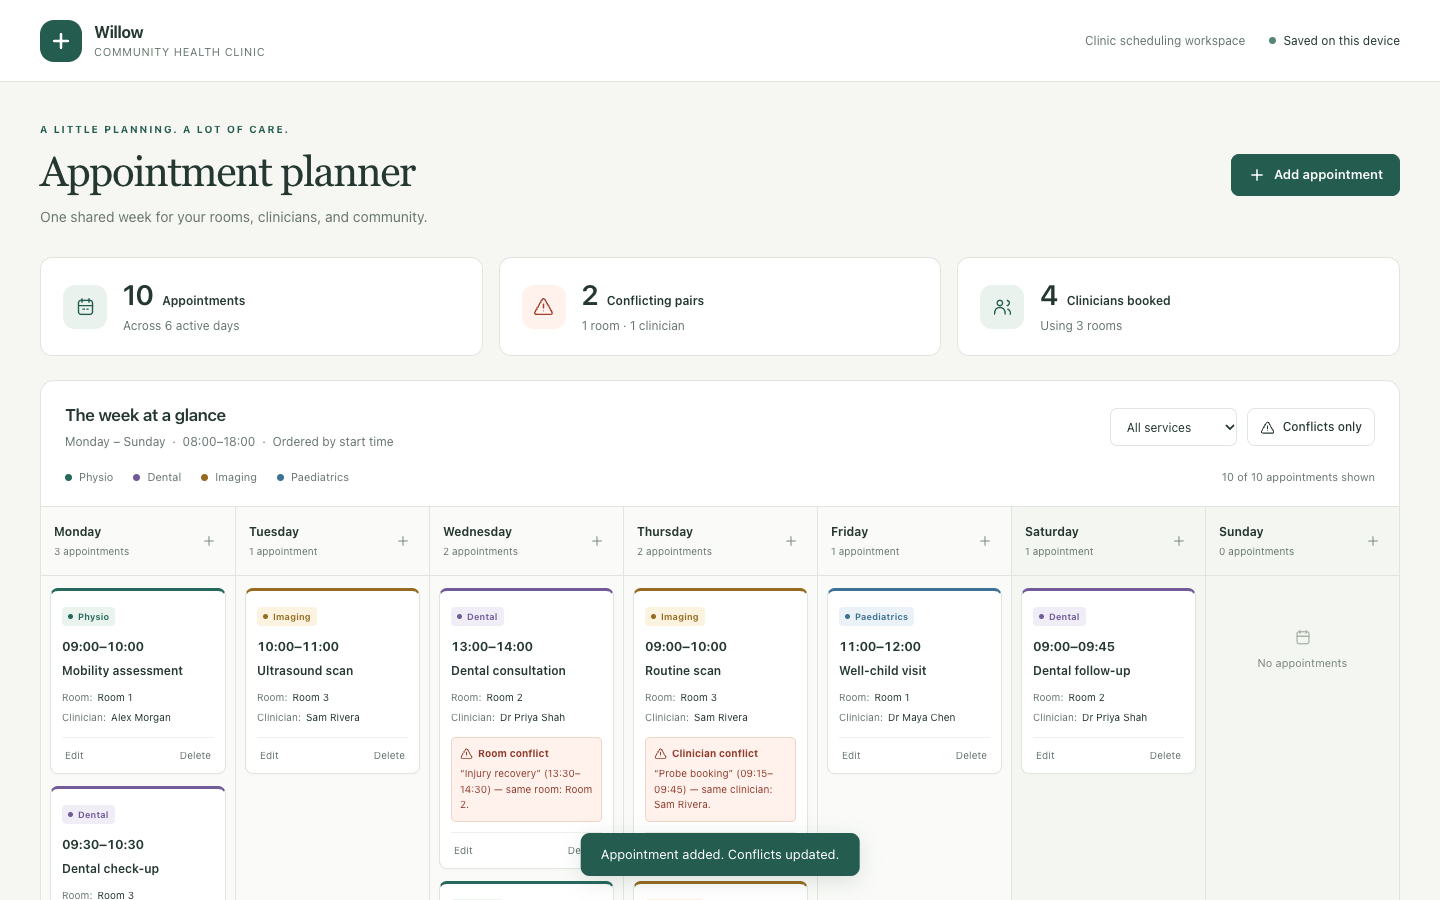
Oto terminarz GPT-6.1 Sol po przeniesieniu jednej wizyty, usunięciu innej i dodaniu nowej, która podwójnie rezerwuje lekarza. Nowa wizyta w czwartek jest oflagowana z nazwaniem kolidującej rezerwacji:
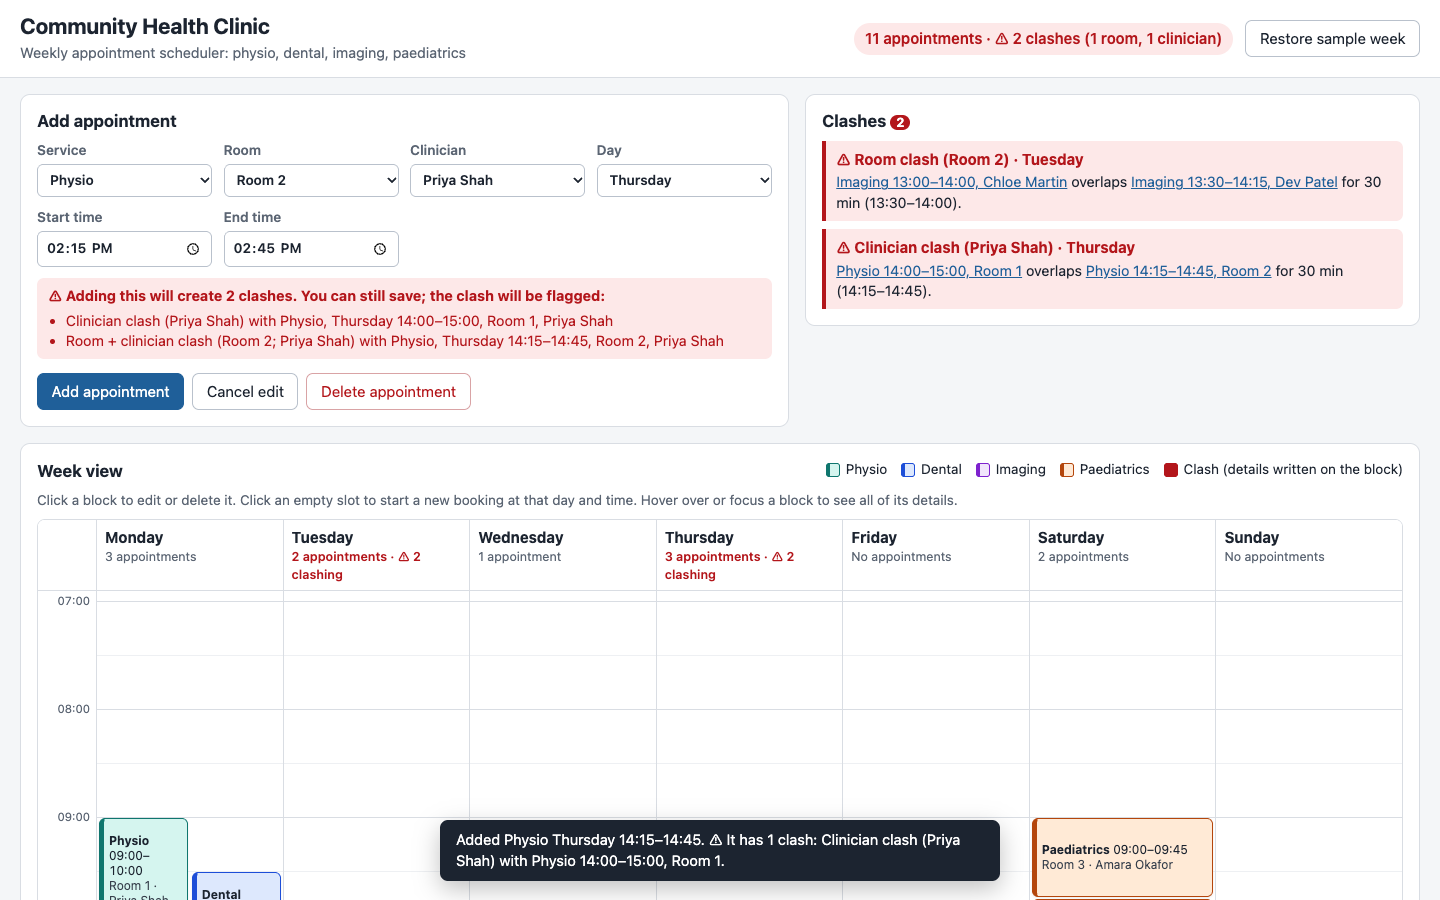
A tak wygląda wynik Opus 5.5 po tych samych krokach, z panelem konfliktów wymieniającym każdą pozostałą parę i czas nakładania:
Najważniejsze wnioski:
- W logice konfliktów nikt nie odskoczył. Obie strony otworzyły się z dokładnie dwiema kolizjami pokojów i jedną kolizją lekarza, każda z nazwaniem drugiej wizyty i powodu, i obie zostawiły rezerwacje stykowe w spokoju.
- Edycje, usunięcia i przeładowania też nie sprawiły kłopotów. Przeniesienie wizyty do wolnego pokoju wyczyściło obie strony konfliktu, usunięcie jednej połowy kolizji lekarza wyczyściło drugą, nowa wizyta podwójnie rezerwująca lekarza została poprawnie oflagowana, a wszystko przetrwało reload.
- Różnice były wyłącznie prezentacyjne. GPT-6.1 Sol zbudował bardziej dopracowaną stronę z kartami podsumowań, filtrem usług i przełącznikiem „Tylko konflikty”, ale listuje rezerwacje danego dnia w kolejności czasowej zamiast na siatce czasu. Opus 5.5 dodał panel konfliktów pokazujący czas nakładania i ostrzega przed konfliktami przed zapisem, ale jego widok tygodnia wymaga przewijania.
- Opus 5.5 napisał trudniejszy przykładowy tydzień. Jego ziarno zawierało nakładanie w różnych pokojach z różnymi lekarzami.
Obu przyznałem 5/5 za zgodność ze specyfikacją i logikę konfliktów. GPT-6.1 Sol dostał 5 za użyteczność i układ, a Opus 5.5 – 4, bo widok tygodnia nie mieści się na jednym ekranie.
Koszt to miejsce, gdzie się rozjechały. Opus 5.5 zużył ponad dwa razy więcej tokenów wyjściowych, głównie na myślenie:
- GPT-6.1 Sol: 0,27 $
- Claude Opus 5.5: 1,11 $
Więc który wygrywa? W tym zadaniu – GPT-6.1 Sol, i to głównie ceną. Oba dostarczyły poprawny, działający terminarz, a GPT-6.1 Sol zrobił to za około jedną czwartą kosztu.
Kiedy wybrać GPT-6.1 Sol vs Claude Opus 5.5
Dla większości zespołów rozstrzyga koszt na zadanie: GPT-6.1 Sol osiąga raportowane przez OpenAI wyniki za około jedną piątą do połowy wydatków Opus 5.5. Wyjątki to długie prompty, ostatnie punkty skuteczności w trudnych przebiegach i miejsce wdrożenia.
Wybierz GPT-6.1 Sol, jeśli...
- Uruchamiasz agentów w dużej skali. W automatyzacji przepływów biznesowych bije Opus 5.5 przy średnim wysiłku za około jedną trzecią kosztu na zadanie, co się kumuluje przy tysiącach przebiegów.
- Twoja praca to pytania nad gęstymi dokumentami. Prowadzi nad Opus 5.5 w PDF-owym benchmarku OpenAI przy każdym poziomie wysiłku, za mniej niż połowę kosztu.
- Twój zespół już pracuje w ChatGPT Work lub Codex. To model, który OpenAI poleca tam do złożonego kodowania i pracy agentowej.
- Wielokrotnie używasz długich promptów systemowych lub kontekstu. Odczyt z cache za 0,10 $ za milion tokenów czyni pętle agentów z powtórkami tanimi, o ile każdy prompt zostaje poniżej 272 tys. tokenów.
Wybierz Claude Opus 5.5, jeśli...
- Twoje prompty regularnie przekraczają 272 tys. tokenów. Dopłata GPT-6.1 Sol kasuje większość przewagi cenowej, a Opus 5.5 nie ma dopłaty za długi kontekst.
- Nieudany przebieg kosztuje więcej niż tokeny. Przy maksymalnym wysiłku Opus 5.5 notuje najwyższy wynik AutomationBench na wykresie OpenAI, wyżej niż GPT-6 Astra.
- Wdrażasz przez Cursor, Amazon Bedrock lub Google Vertex AI. Opus 5.5 jest dostępny we wszystkich trzech; GPT-6.1 Sol nie widnieje jeszcze w dokumentacji Cursor ani Vertex AI.
- Chcesz konserwatywnych domyślnych ustawień Anthropic dla niepilnowanych agentów. Jego zabezpieczenia kierują ryzykowne prace z bezpieczeństwa i biologii do innych modeli zamiast je podejmować.
Jak zacząć z GPT-6.1 Sol i Claude Opus 5.5
| Powierzchnia | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| Aplikacja konsumencka | ChatGPT Work i Codex (Plus, Pro, Business, Enterprise, Edu); jeszcze nie w Chat | Aplikacje Claude (Pro, Max, Team, Enterprise) |
| API pierwszej strony | OpenAI API (wywołania narzędzi przez Responses API) | Claude API |
| Platformy chmurowe | Azure AI Foundry; nie wymieniony w dokumentacji Vertex AI na 30 września 2026 | Amazon Bedrock, Google Vertex AI, Azure AI Foundry |
| Agenci do kodowania | Codex, GitHub Copilot; nie wymieniony w dokumentacji Cursor na 30 września 2026 | Claude Code, Cursor, GitHub Copilot |
| Routery zewnętrzne | OpenRouter (openai/gpt-6.1-sol) | OpenRouter (anthropic/claude-opus-5.5) |
| ID modelu API | gpt-6.1-sol |
claude-opus-5-5 |
Największa różnica to zasięg: Opus 5.5 jest na wszystkich trzech głównych chmurach i w Cursorze, podczas gdy GPT-6.1 Sol koncentruje się na produktach OpenAI, Azure i Copilocie.
Pierwsze wywołanie API
Modele korzystają z różnych SDK, więc przełączenie wymaga zmiany klienta oraz nazwy modelu:
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6.1-sol",
    reasoning={"effort": "medium"},
    input="Summarize the payment terms in this contract: ...",
)
print(response.output_text)
from anthropic import Anthropic
client = Anthropic()
response = client.messages.create(
model="claude-opus-5-5",
max_tokens=2048,
messages=[{"role": "user", "content": "Summarize the payment terms in this contract: ..."}],
)
print(next(b.text for b in response.content if b.type == "text"))Pełne projekty znajdziesz w naszym samouczku API GPT-6 Sol i samouczku API Opus 5.5, które już wcześniej podlinkowałem.
Na koniec
Jeśli ogranicza cię koszt na zadanie, użyj GPT-6.1 Sol. Jeśli potrzebujesz najwyższej skuteczności w trudnych przebiegach agentów, wysyłasz długie prompty lub wdrażasz przez Cursor czy Bedrock, użyj Opus 5.5.
Najbardziej wymowne jest dla mnie to, że wykresy OpenAI same robią case dla obu. Firma wybrała punkt ze średnim wysiłkiem do nagłówka, ale ten sam wykres pokazuje Opus 5.5 na szczycie przy maksymalnym wysiłku. OpenAI zakłada, że większości kupujących zależy na tańszym punkcie na krzywej, i w przypadku codziennych agentów myślę, że ma rację.
Ponieważ Sol to model ze średniej półki, warto też przetestować GPT-6.1 Sol vs Claude Sonnet 5.5.
A jeśli budujesz na którymkolwiek modelu, polecam naszą ścieżkę OpenAI Fundamentals lub kurs Introduction to Claude Models.