OpenAI ใช้งาน DevDay เมื่อวันที่ 29 กันยายน เปิดตัว GPT-6.1 Sol อัปเกรดของโมเดลระดับกลางที่ถูกอ้างว่าเข้าใกล้เรือธง GPT-6 Astra ด้วยราคาโทเค็นเพียงหนึ่งในห้า หนึ่งสัปดาห์ก่อนหน้า Anthropic เปิดตัว Claude Opus 5.5 โดยชูจุดเด่นว่ามีประสิทธิภาพระดับ Fable 5.1 ในราคาถูกลง 40%.
ทั้งสองเป็นเกมรุกด้านประสิทธิภาพ และโพสต์เปิดตัวของ OpenAI เอ่ยถึง Opus 5.5 โดยตรง อ้างชัยชนะในงานเวิร์กโฟลว์ธุรกิจและงานเอกสารด้วยต้นทุนต่อภารกิจเพียงเสี้ยวเดียว อย่างไรก็ตาม แผนภูมิของ OpenAI เองเล่าเรื่องที่น่าสนใจกว่าพาดหัว เพราะผลเทียบจะแตกต่างกันไปตามระดับความพยายามที่ใช้ดู
บทความนี้จะเทียบ GPT-6.1 Sol กับ Opus 5.5 เป็นหลัก เพราะโพสต์เปิดตัวของ OpenAI จับคู่กันไว้โดยตรง แต่ Claude Sonnet 5.5 ก็เป็นอีกคู่เทียบที่ยุติธรรม ครอบคลุมไว้ในบทความ GPT-6.1 Sol เทียบกับ Claude Sonnet 5.5.
สรุปสั้นๆ
- GPT-6.1 Sol นำเรื่องต้นทุนต่อภารกิจ: ในทุกผลทดสอบที่ทั้งสองรุ่นใช้ร่วมกัน ทำได้ด้วยค่าใช้จ่ายเพียงเสี้ยวของ Opus 5.5
- อย่างไรก็ตาม ช่องว่างราคาจะหายไปส่วนใหญ่เมื่อพรอมป์ตเกิน 272K โทเค็น ซึ่งเป็นจุดที่มีค่าบวกเพิ่มของ GPT-6.1 Sol
- Opus 5.5 ยังมีเพดานสูงกว่าในงานอัตโนมัติธุรกิจและงานวิทยาศาสตร์บนเทอร์มินัลเมื่อรันที่ความพยายามสูงสุด
GPT-6.1 Sol คืออะไร?
GPT-6.1 Sol คือโมเดลให้เหตุผลระดับกลางของ OpenAI ในตระกูล GPT-6 เปิดตัวเมื่อวันที่ 29 กันยายน 2026 เป็นอัปเกรดของ GPT-6 Sol
จุดขายคือผลลัพธ์ที่เข้าใกล้ Astra ในงานเขียนโค้ด การใช้งานคอมพิวเตอร์ และงานมืออาชีพในราคาที่ต่ำกว่ามาก โดยมีค่าอ่านแคชอินพุตที่ถูกกว่า เหมาะกับเอเจนต์ที่ใช้คอนเท็กซ์ซ้ำระหว่างคำขอ
คู่มือ GPT-6.1 Sol ของเราครอบคลุมรายละเอียดการเปิดตัว และ บทเรียน API ของ GPT-6 Sol สร้างเอเจนต์ย้ายฐานโค้ดบนเวอร์ชันก่อนหน้า
Claude Opus 5.5 คืออะไร?
Claude Opus 5.5 คือโมเดล Opus เรือธงของ Anthropic เปิดเป็นรุ่นแรกในตระกูล Claude 5.5
Anthropic วางตำแหน่งสำหรับงานโค้ดแบบเอเจนต์ที่รันยาวและงานความรู้ โดยทำผลงานเทียบ Claude Fable 5.1 ได้ในงานส่วนใหญ่ที่ต้นทุนต่ำกว่า พร้อมโหมดคิดแบบปรับตัวที่เปิดตลอดเวลา
คู่มือ Claude Opus 5.5 ของเราครอบคลุมการเปิดตัว และ บทเรียน API Opus 5.5 สร้างตัวสืบสวนเหตุการณ์ AI
GPT-6.1 Sol เทียบกับ Claude Opus 5.5: เปรียบเทียบกันตรงๆ
GPT-6.1 Sol และ Opus 5.5 ทับซ้อนกันบนบันทึกชี้วัดที่เผยแพร่เพียงสามรายการ ทั้งหมดมาจากแผนภูมิเปิดตัวของ OpenAI Opus 5.5 ทำคะแนนสูงสุดได้ดีกว่าในสองรายการ และ GPT-6.1 Sol ทำได้ด้วยต้นทุนต่อภารกิจต่ำกว่าราว 2–5 เท่าในทั้งสามรายการ
| คุณสมบัติ | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| AutomationBench (คะแนนสูงสุด, ต้นทุนต่อภารกิจ) | 36.1% ที่ max, $0.30 | 42.5% ที่ max, $1.44 |
| GDP.pdf (คะแนนสูงสุด, ต้นทุนต่อภารกิจ) | 32.0% ที่ high, $0.35 | 28.8% ที่ high, $0.83 |
| Terminal-Bench Science 0.1 (ความพยายามสูงสุด) | 57.0%, $5.47 | 63.3%, $23.21 |
| DeepSWE v1.1 | 75.2% ที่ high | ไม่ได้เผยแพร่ |
| Terminal-Bench 4.0 | ไม่ได้เผยแพร่ | 66.4% ที่ max |
| การใช้งานคอมพิวเตอร์ | 71.4% บน OSWorld 2.0 ออฟไลน์ (max) | 81.8% บน OSWorld 2.1 |
| หน้าต่างคอนเท็กซ์ / เอาต์พุตสูงสุด | 1.05M / 128K | 1M / 128K |
| ขอบเขตความรู้ | เมษายน 2026 | มิถุนายน 2026 |
| ระดับความพยายาม | low, medium (ค่าปริยาย), high, xhigh, max | low, medium (ค่าปริยาย), high, xhigh, max |
สามแถวแรกมาจากแผนภูมิของ OpenAI ซึ่งระบุผลของ Claude ว่า "Opus 5.5 w/ fallbacks" ส่วนอื่นๆ เป็นรายงานของแต่ละผู้ให้บริการเกี่ยวกับโมเดลของตนเอง
เวิร์กโฟลว์ธุรกิจและเอกสาร
นี่คือสนามที่ OpenAI เลือก และระดับความพยายามเป็นตัวชี้ขาดผู้ชนะ
พาดหัวของ OpenAI ระบุว่า GPT-6.1 Sol ทำคะแนนเหนือ Opus 5.5 อยู่ 2.2 คะแนนบน AutomationBench ซึ่งเป็นการทดสอบเอเจนต์ให้ทำเวิร์กโฟลว์หลายขั้นตอนบนเครื่องมือธุรกิจหลายสิบรายการของ Zapier ข้อนี้ถูกต้องที่ความพยายามระดับ medium ซึ่ง GPT-6.1 Sol ทำได้ 31.7% ที่ $0.19 ต่อภารกิจ เทียบกับ Opus 5.5 ที่ 29.5% ที่ $0.65
ปรับทั้งคู่ขึ้นเป็น max แล้วลำดับจะสลับ Opus 5.5 ไต่ขึ้นไปที่ 42.5% สูงกว่าแม้แต่ GPT-6 Astra ขณะที่ GPT-6.1 Sol สูงสุดที่ 36.1% Opus 5.5 จ่ายในราคาเกือบ 5 เท่าต่อภารกิจ ดังนั้นคำถามคือส่วนต่างหกแต้มของความสำเร็จเวิร์กโฟลว์นั้นคุ้มกับเอเจนต์ของคุณหรือไม่ สำหรับบ็อตซัพพอร์ตที่ดูแลทิกเก็ตนับพัน อาจไม่คุ้ม สำหรับเวิร์กโฟลว์การเงินที่การรันล้มเหลวหมายถึงต้องให้มนุษย์ทำใหม่ อาจคุ้ม
GPT-6.1 Sol คุ้มค่ากว่าสำหรับงานเอกสารและอัตโนมัติในชีวิตประจำวัน Opus 5.5 เหมาะเมื่อการรันที่ยากที่สุดต้องสำเร็จ
งานโค้ดและงานวิทยาศาสตร์
ยังไม่มีบันทึกชี้วัดร่วมสำหรับงานโค้ด ดังนั้นตัวเลขของแต่ละค่ายจึงยืนบนตารางตามลำพัง OpenAI ระบุว่า GPT-6.1 Sol เทียบชั้น GPT-6 Astra บน DeepSWE v1.1 ซึ่งทดสอบวิศวกรรมระยะยาวในฐานโค้ดจริง ขณะที่ Anthropic รายงานว่า Opus 5.5 นำ GPT-6 Astra บน Terminal-Bench 4.0 และ FrontierCode
ในการทดสอบใช้งานก่อนหน้านี้ GPT-6 Sol ซึ่งเป็นเวอร์ชันก่อนหน้า เอาชนะ Opus 5.5 ในการสร้าง Tetris ด้วยต้นทุนรันไม่ถึงหนึ่งในสาม (ดูการเปรียบเทียบ GPT-6 Sol เทียบกับ Claude Opus 5.5) จึงคาดว่า GPT-6.1 Sol น่าจะชนะ
การใช้งานคอมพิวเตอร์
ยังเทียบตรงๆ ไม่ได้ OpenAI รายงาน GPT-6.1 Sol บนชุดออฟไลน์ของ OSWorld 2.0 โดยห่าง GPT-6 Astra เพียง 2.1 แต้ม ขณะที่ Anthropic รายงาน Opus 5.5 บน OSWorld 2.1 ซึ่งเป็นเวอร์ชันใหม่กว่าพร้อมภารกิจต่างกัน ไม่มีค่ายใดเผยผลของเวอร์ชันอีกฝ่าย ดังนั้นตัวเลขในตารางสรุปจึงไม่ใช่การเทียบกันตรงๆ ให้ถือว่าหัวข้อการใช้งานคอมพิวเตอร์ยังเปิดอยู่จนกว่าจะมีการทดสอบทั้งคู่บนชุดเดียวกัน
รั้วกันภัยและข้อจำกัด API
ในทางปฏิบัติ Opus 5.5 ถูกจำกัดมากกว่า Anthropic จะส่งงานไซเบอร์ซีเคียวริตี้ส่วนใหญ่ไปที่ Opus 4.8 เว้นแต่จะอยู่ในโครงการ Cyber Verification และงานชีววิทยาก็มีเส้นทางสำรองที่คล้ายกัน นั่นจึงเป็นเหตุผลที่แผนภูมิของ OpenAI ระบุผลของ Claude ว่า "มี fallbacks"
ข้อจำกัดของ GPT-6.1 Sol อยู่ที่ API แทน ไม่มีระดับความพยายาม none หรือ minimal และการเรียกใช้เครื่องมือทำได้เฉพาะผ่าน Responses API ไม่ใช่ Chat Completions ขณะที่ Opus 5.5 เปิดโหมดคิดแบบปรับตัวตลอดเวลาและปฏิเสธการบังคับใช้เครื่องมือ สำหรับทีมความปลอดภัย การจัดเส้นทางของ Opus 5.5 คือความแตกต่างที่สำคัญกว่า ในมุมมองนักพัฒนาที่กำลังย้ายโค้ด คือการเปลี่ยนแปลง API ของ GPT-6.1 Sol
ราคา: สิ่งที่ต้องจ่ายจริง
GPT-6.1 Sol มีราคาเท่ากับครึ่งหนึ่งของ Opus 5.5 ในทุกราคามาตรฐาน จนกว่าพรอมป์ตจะเกิน 272K โทเค็นอินพุต
อัตราโทเค็นแบบเทียบข้างกัน
| อัตรา | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| อินพุต ต่อ 1M โทเค็น | $2.00 | $4.00 |
| เอาต์พุต ต่อ 1M โทเค็น | $10.00 | $20.00 |
| อ่านแคชอินพุต ต่อ 1M โทเค็น | $0.10 | $0.20 |
| เขียนแคช ต่อ 1M โทเค็น | $2.50 | $5.00 (5 นาที), $8.00 (1 ชั่วโมง) |
| ค่าบวกเพิ่มบริบทยาว | เกิน 272K โทเค็นอินพุต: อินพุตและแคช 2 เท่า เอาต์พุต 1.5 เท่า ทั้งคำขอ | ไม่มี |
| ส่วนลดแบบแบตช์ | 50% | 50% |
| โหมดเร็ว | 2 เท่าของอัตรามาตรฐาน | $8 / $40 ต่อ 1M โทเค็น |
ตัวคูณคงที่ 0.5x ครอบคลุมทั้งอินพุต เอาต์พุต และการอ่านแคช ดังนั้นสำหรับพรอมป์ตขนาดปกติ การเทียบจะสรุปได้ว่า "GPT-6.1 Sol ราคาเพียงครึ่ง" ทั้งสองรุ่นคิดโทเค็นการให้เหตุผลเป็นเอาต์พุต ซึ่งมีผลกับ Opus 5.5 มากกว่าเพราะไม่สามารถปิดโหมดคิดได้
ต้นทุนงานจริง
| งาน | GPT-6.1 Sol | Claude Opus 5.5 | ส่วนต่าง |
|---|---|---|---|
| ผู้ช่วยสมดุล: อิน 1M / เอาต์ 250K | $4.50 | $9.00 | $4.50 (ถูกกว่า 50%) |
| การสืบค้น แต่ละคำขอไม่เกิน 272K: อิน 10M / เอาต์ 1M | $30 | $60 | $30 (ถูกกว่า 50%) |
| การสืบค้น แต่ละคำขอเกิน 272K: อิน 10M / เอาต์ 1M | $55 | $60 | $5 (ถูกกว่า 8%) |
ผลรวมคำนวณจาก (ปริมาณ ÷ 1M) × อัตรา รวมอินพุตและเอาต์พุตที่อัตรามาตรฐาน
- ผู้ช่วยสมดุล: กรณีครึ่งราคาอย่างตรงไปตรงมา และเป็นรูปแบบที่งานแชทและเอเจนต์ส่วนใหญ่มักเป็น
- การสืบค้นต่ำกว่าเกณฑ์: ยังครึ่งราคา ดังนั้นระบบ RAG ที่คุมพรอมป์ตแต่ละครั้งให้เล็กจะได้ส่วนลดเต็มที่
- การสืบค้นเกินเกณฑ์: ค่าบวกเพิ่มทำให้อัตราอินพุตของ GPT-6.1 Sol เพิ่มเป็นระดับเดียวกับ Opus 5.5 และส่วนต่างราคาหดเหลือน้อยมาก หากพรอมป์ตบรรทุกฐานโค้ดทั้งชุดเป็นประจำ ให้ตั้งงบเสมือนทั้งคู่ราคาเท่ากัน
ทั้งสองค่ายใช้ตัวตัดโทเค็นต่างกัน และยังไม่มีการเผยนับโทเค็นบนงานร่วม จึงให้มองผลรวมนี้เป็นการเทียบอัตรามากกว่าบิลจริง
ผลการทำงานของ GPT-6.1 Sol และ Claude Opus 5.5
บันทึกชี้วัดด้านบนเป็นของผู้ขายเอง ดังนั้นจึงรันทดลองสร้างหนึ่งงานกับ GPT-6.1 Sol และ Claude Opus 5.5 โดยใช้พรอมป์ตและเครื่องมือชุดเดียวกันทั้งหมด
โจทย์: ตัวจัดตารางนัดหมาย HTML ไฟล์เดียวสำหรับคลินิกสุขภาพชุมชน มุมมองสัปดาห์จันทร์ถึงอาทิตย์สำหรับนัดกายภาพฟื้นฟู ทันตกรรม เอ็กซเรย์ และกุมาร เวิร์กโฟลว์เพิ่ม แก้ไข ลบการจอง การคงอยู่ด้วย localStorage และสัปดาห์ตัวอย่างประมาณสิบการนัดหมาย ไม่มีขั้นตอนบิลด์ ไม่มีไลบรารีภายนอก ไม่ใช้เน็ตเวิร์ก
ส่วนที่ยากคือกฎชนกันของนัดหมาย ซึ่งต้องถือหลายกฎพร้อมกัน:
- นัดสองรายการชนกันหากทับซ้อนกันในห้องเดียวกัน หรือทับซ้อนกันกับแพทย์คนเดียวกัน
- การจองต่อเนื่องแบบพอดีเวลา ที่รายการหนึ่งจบตรงเวลาที่อีกรายการเริ่ม ต้องไม่ถือว่าชน
- ทุกธงต้องระบุชื่อนัดอีกฝั่งและเหตุผล ไม่ใช่แค่เปลี่ยนเป็นสีแดง
- ต้องอัปเดตธงหลังทุกการแก้ไขและลบ และคงอยู่หลังรีโหลด
- สัปดาห์ตัวอย่างต้องมีชนกันของห้องสองกรณีและชนกันของแพทย์หนึ่งกรณีพอดี
ชอบการทดสอบนี้เพราะทดสอบคำกล่าวของ OpenAI ว่า GPT-6.1 Sol เทียบชั้น GPT-6 Astra ในวิศวกรรมฐานโค้ดจริง และแนวทางของ Anthropic ที่ชู Opus 5.5 เป็นเอเจนต์โค้ดที่รันยาว
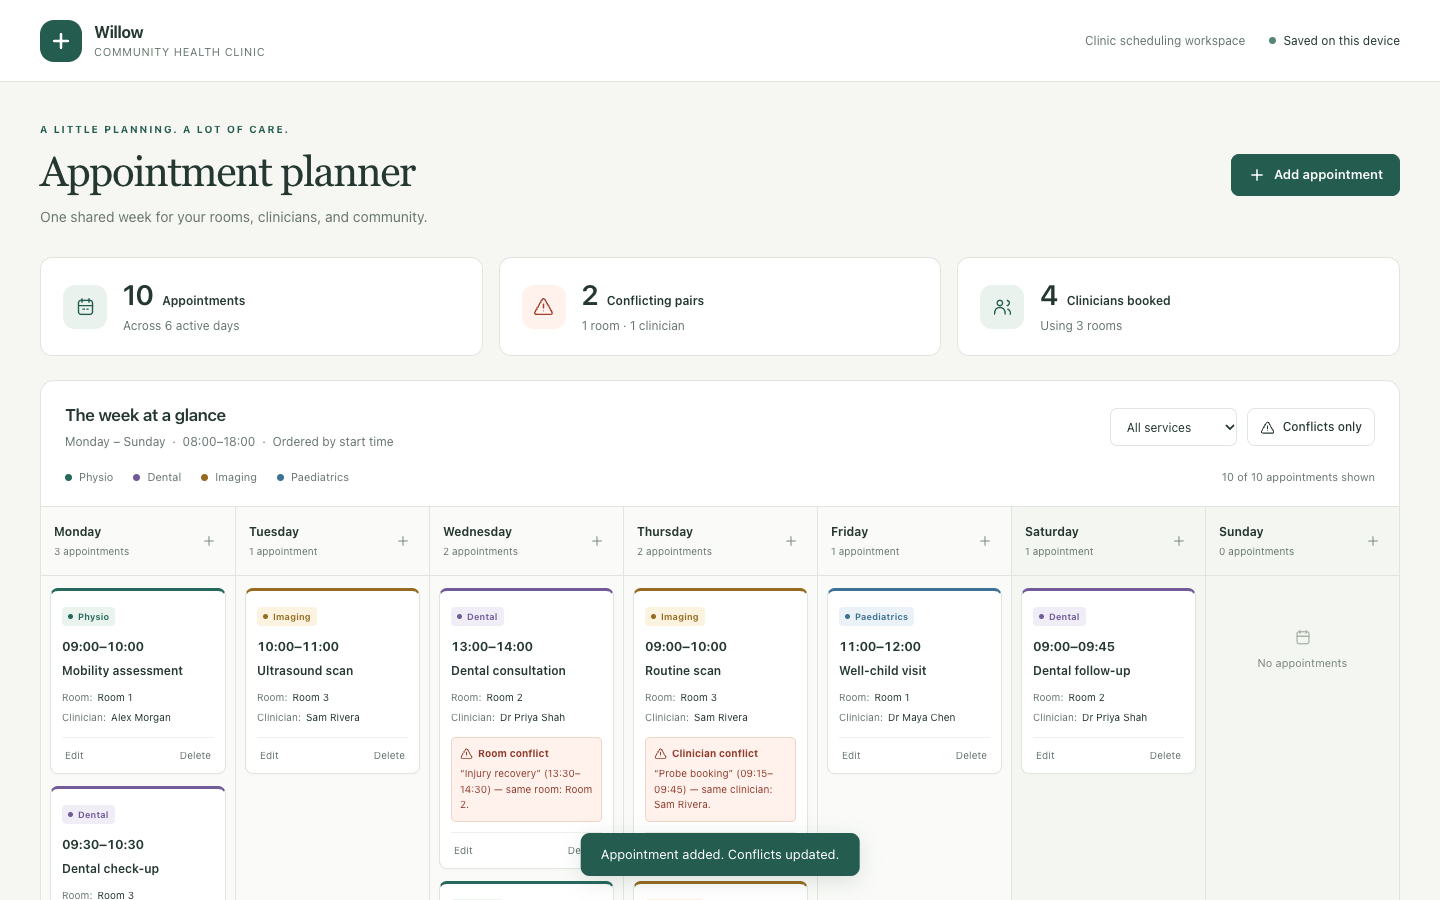
นี่คือหน้าจัดตารางของ GPT-6.1 Sol หลังจากย้ายการจอง ลบหนึ่งรายการ และเพิ่มรายการใหม่ที่จองแพทย์ซ้ำ การจองวันพฤหัสบดีรายการใหม่ถูกติดธง พร้อมระบุนัดที่ชนกัน:
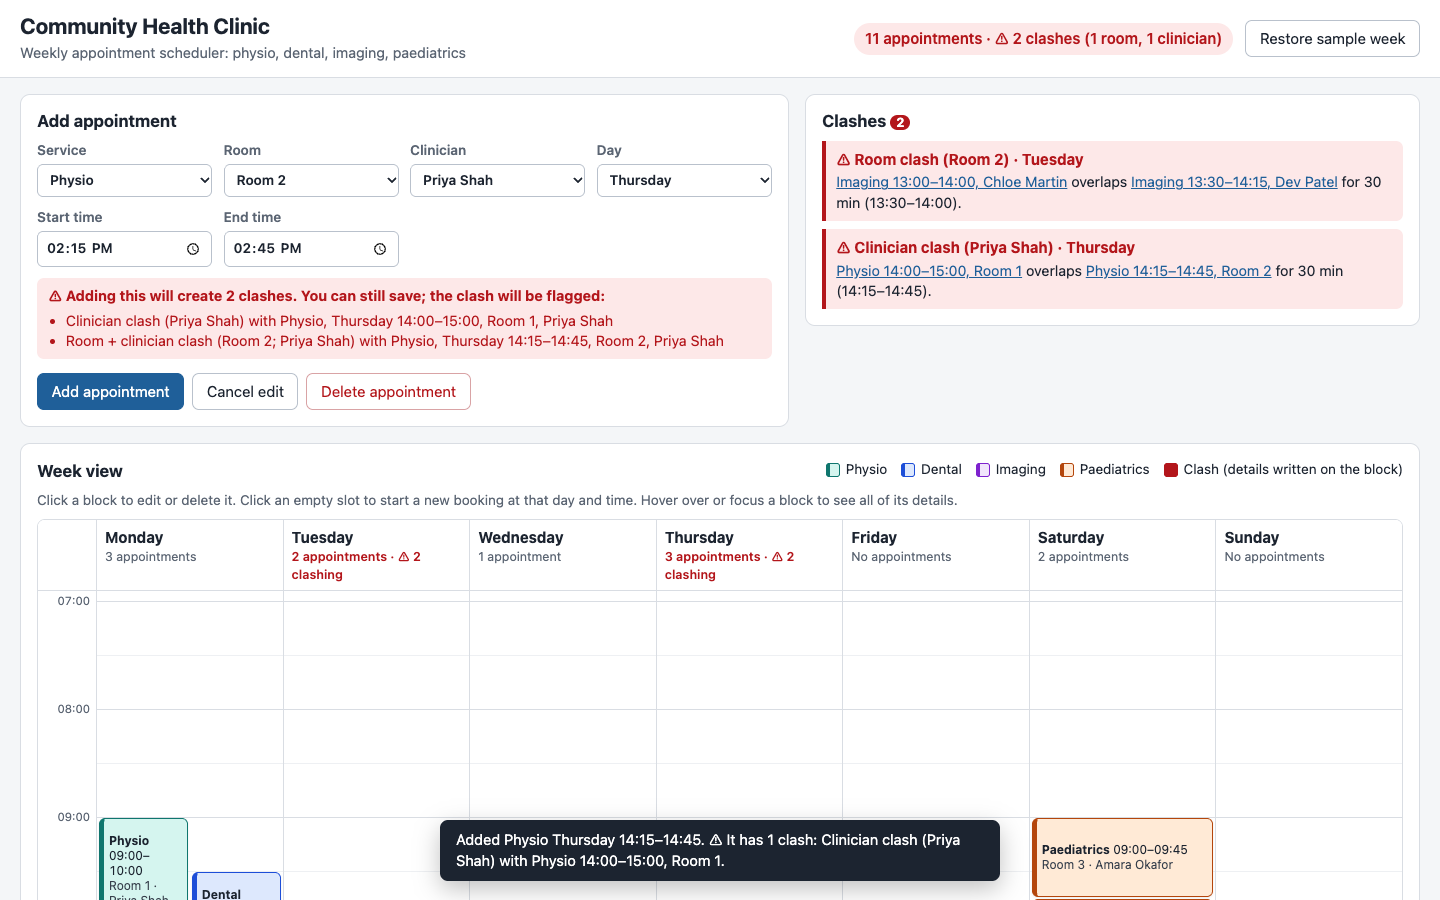
และนี่คือของ Opus 5.5 หลังทำขั้นตอนเดียวกัน โดยมีแผงแจ้งชนกันที่แสดงแต่ละคู่ที่ยังชนกันและระยะเวลาทับซ้อน:
ข้อค้นพบหลัก:
- เรื่องตรรกะชนกัน ไม่มีใครทิ้งห่างกัน ทั้งสองหน้าเปิดมาพร้อมชนกันของห้องสองกรณีและชนกันของแพทย์หนึ่งกรณีพอดี แต่ละธงระบุนัดอีกฝั่งและเหตุผล และทั้งคู่ไม่แตะการจองต่อเนื่องที่พอดีเวลา
- การแก้ไข ลบ และรีโหลด ก็ไม่พลาด ย้ายการจองไปห้องว่างล้างธงชนทั้งสองฝั่ง ลบหนึ่งฝั่งของชนกันของแพทย์ทำให้ฝั่งอีกด้านถูกล้าง การจองใหม่ที่จองแพทย์ซ้ำถูกติดธงถูกต้อง และทุกอย่างคงอยู่หลังรีโหลด
- ความต่างอยู่ที่การนำเสนอ GPT-6.1 Sol สร้างหน้าที่เนี้ยบกว่า มีการ์ดสรุป ตัวกรองบริการ และปุ่ม "แสดงเฉพาะชนกัน" แต่แสดงรายการนัดแต่ละวันตามเวลาแทนที่จะใช้กริดเวลา Opus 5.5 เพิ่มแผงชนกันที่แสดงระยะเวลาทับซ้อนของแต่ละคู่และเตือนก่อนบันทึก แต่กริดสัปดาห์ต้องเลื่อนจอ
- Opus 5.5 เขียนสัปดาห์ตัวอย่างที่ท้าทายกว่า มีกรณีทับซ้อนกันคนละห้องและคนละแพทย์
ให้คะแนนทั้งคู่ 5 เต็ม 5 สำหรับการยึดสเปกและตรรกะชนกัน GPT-6.1 Sol ได้ 5 สำหรับการใช้งานและเลย์เอาต์ ส่วน Opus 5.5 ได้ 4 เพราะมุมมองสัปดาห์ไม่พอดีจอเดียว
ต้นทุนคือจุดที่แยกกัน Opus 5.5 ใช้โทเค็นเอาต์พุตมากกว่าสองเท่า ส่วนใหญ่เป็นโทเค็นคิด:
- GPT-6.1 Sol: $0.27
- Claude Opus 5.5: $1.11
ดังนั้นใครชนะ? สำหรับงานนี้ GPT-6.1 Sol และแทบจะชนะที่ราคา ทั้งสองสร้างตัวจัดตารางที่ถูกต้องและใช้งานได้ และ GPT-6.1 Sol ทำได้ด้วยต้นทุนราวหนึ่งในสี่
ควรเลือก GPT-6.1 Sol หรือ Claude Opus 5.5 เมื่อใด
สำหรับทีมส่วนใหญ่ จุดตัดสินคือค่าต่อภารกิจ: GPT-6.1 Sol ทำคะแนนตามที่ OpenAI รายงานได้ในต้นทุนราวหนึ่งในห้าถึงครึ่งหนึ่งของที่ Opus 5.5 ใช้ ข้อยกเว้นคือพรอมป์ตยาว คะแนนส่วนท้ายบนรันที่ยาก และช่องทางที่ใช้งาน
เลือก GPT-6.1 Sol ถ้า...
- รันเอเจนต์จำนวนมาก บนงานอัตโนมัติเวิร์กโฟลว์ธุรกิจ ชนะ Opus 5.5 ที่ความพยายามระดับ medium ด้วยต้นทุนต่อภารกิจราวหนึ่งในสาม ซึ่งทบต้นเมื่อรันนับพันครั้ง
- งานคือการตั้งคำถามเหนือเอกสารหนาแน่น นำหน้า Opus 5.5 บนบันทึกชี้วัด PDF ของ OpenAI ในทุกระดับความพยายาม ด้วยต้นทุนต่ำกว่าครึ่ง
- ทีมใช้งานใน ChatGPT Work หรือ Codex อยู่แล้ว เป็นโมเดลที่ OpenAI แนะนำสำหรับงานโค้ดซับซ้อนและงานแบบเอเจนต์
- ใช้พรอมป์ตระบบหรือคอนเท็กซ์ยาวซ้ำๆ การอ่านแคชอินพุตที่ $0.10 ต่อหนึ่งล้านโทเค็นทำให้ลูปเอเจนต์ที่ซ้ำบ่อยมีต้นทุนต่ำ ตราบใดที่พรอมป์ตแต่ละครั้งไม่เกิน 272K โทเค็น
เลือก Claude Opus 5.5 ถ้า...
- พรอมป์ตเกิน 272K โทเค็นเป็นประจำ ค่าบวกเพิ่มของ GPT-6.1 Sol ลบข้อได้เปรียบด้านราคาไปเกือบหมด และ Opus 5.5 ไม่มีค่าบวกเพิ่มบริบทยาว
- การรันล้มเหลวมีต้นทุนสูงกว่าโทเค็น ที่ความพยายาม max Opus 5.5 ทำคะแนนสูงสุดบน AutomationBench ในแผนภูมิของ OpenAI เอง รวมถึงเหนือ GPT-6 Astra
- ใช้งานผ่าน Cursor, Amazon Bedrock หรือ Google Vertex AI Opus 5.5 มีรายชื่อบนทั้งสามแพลตฟอร์ม ส่วน GPT-6.1 Sol ยังไม่ปรากฏในเอกสาร Cursor หรือ Vertex AI
- ต้องการค่าปริยายเชิงอนุรักษนิยมของ Anthropic สำหรับเอเจนต์ไร้คนดูแล กลไกป้องกันจะส่งงานความเสี่ยงด้านความปลอดภัยและชีววิทยาไปยังโมเดลอื่น แทนการพยายามทำเอง
เริ่มต้นใช้งาน GPT-6.1 Sol และ Claude Opus 5.5 อย่างไร
| ช่องทาง | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| แอปสำหรับผู้ใช้ทั่วไป | ChatGPT Work และ Codex (Plus, Pro, Business, Enterprise, Edu); ยังไม่อยู่ใน Chat | แอป Claude (Pro, Max, Team, Enterprise) |
| API ของผู้พัฒนา | OpenAI API (เรียกใช้เครื่องมือผ่าน Responses API) | Claude API |
| แพลตฟอร์มคลาวด์ | Azure AI Foundry; ยังไม่ปรากฏในเอกสาร Vertex AI ณ 30 กันยายน 2026 | Amazon Bedrock, Google Vertex AI, Azure AI Foundry |
| เอเจนต์สำหรับโค้ด | Codex, GitHub Copilot; ยังไม่ปรากฏในเอกสาร Cursor ณ 30 กันยายน 2026 | Claude Code, Cursor, GitHub Copilot |
| ตัวจัดเส้นทางภายนอก | OpenRouter (openai/gpt-6.1-sol) | OpenRouter (anthropic/claude-opus-5.5) |
| รหัสโมเดล API | gpt-6.1-sol |
claude-opus-5-5 |
ความต่างใหญ่คือการเข้าถึง: Opus 5.5 อยู่บนคลาวด์หลักทั้งสามและใน Cursor ขณะที่ GPT-6.1 Sol เน้นอยู่ในผลิตภัณฑ์ของ OpenAI เอง Azure และ Copilot
การเรียก API ครั้งแรก
สองโมเดลใช้ SDK ต่างกัน ดังนั้นการสลับหมายถึงต้องเปลี่ยนทั้งไคลเอนต์และสตริงโมเดล:
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6.1-sol",
    reasoning={"effort": "medium"},
    input="Summarize the payment terms in this contract: ...",
)
print(response.output_text)
from anthropic import Anthropic
client = Anthropic()
response = client.messages.create(
model="claude-opus-5-5",
max_tokens=2048,
messages=[{"role": "user", "content": "Summarize the payment terms in this contract: ..."}],
)
print(next(b.text for b in response.content if b.type == "text"))สำหรับงานสร้างเต็มรูปแบบ ดู บทเรียน API ของ GPT-6 Sol และ บทเรียน API ของ Opus 5.5 ที่กล่าวถึงก่อนหน้านี้
ข้อคิดส่งท้าย
หากข้อจำกัดคือค่าต่อภารกิจ ให้ใช้ GPT-6.1 Sol หากต้องการอัตราความสำเร็จสูงสุดบนการรันเอเจนต์ที่ยาก ส่งพรอมป์ตยาว หรือดีพลอยผ่าน Cursor หรือ Bedrock ให้ใช้ Opus 5.5
สิ่งที่ชี้ขาดคือแผนภูมิของ OpenAI เองสนับสนุนทั้งสองมุม OpenAI เลือกจุดความพยายามระดับ medium เป็นพาดหัว แต่แผนภูมิเดียวกันแสดงว่า Opus 5.5 อยู่บนสุดที่ความพยายาม max OpenAI กำลังเดิมพันว่าผู้ซื้อส่วนใหญ่สนใจจุดที่ถูกกว่า และสำหรับเอเจนต์ในชีวิตประจำวัน ก็มีแนวโน้มถูกต้อง
เพราะ Sol เป็นโมเดลระดับกลาง การทดสอบ GPT-6.1 Sol เทียบ Claude Sonnet 5.5 ก็ควรทำเช่นกัน
และหากกำลังพัฒนาบนโมเดลใดโมเดลหนึ่ง แนะนำ เส้นทางทักษะ OpenAI Fundamentals หรือคอร์ส Introduction to Claude Models ของเรา