OpenAI 于 9 月 29 日的 DevDay 发布了 GPT-6.1 Sol,这是其中端模型的升级版,称其在令牌价格仅为旗舰 GPT-6 Astra 五分之一的情况下接近 Astra 的表现。前一周,Anthropic 上线了 Claude Opus 5.5,主打以 Fable 5.1 级表现、成本降低 40%。
两者都在打效率牌。OpenAI 的发布文直接点名 Opus 5.5,宣称在业务流程与文档处理上以更低的单任务成本取胜。不过,OpenAI 自己的图表比标题更有意思,因为胜负取决于您选择的努力等级。
在本文中,我们之所以将 GPT-6.1 Sol 与 Opus 5.5 对比,主要是因为 OpenAI 发布文直接把它们放在一起。但把 Claude Sonnet 5.5 拿来比也很合理,我们在另一篇 GPT-6.1 Sol 与 Claude Sonnet 5.5 的文章中有覆盖。
要点速览
- GPT-6.1 Sol 是单任务成本的领先者:在两者都参与的每项基准上,它都以远低于 Opus 5.5 的花费达到目标。
- 不过,在超过 272K 令牌的提示上,GPT-6.1 Sol 的附加费生效,价格差距大多会消失。
- 在将努力开到最大时,Opus 5.5 在业务自动化与科学终端工作上的上限仍更高。
什么是 GPT-6.1 Sol?
GPT-6.1 Sol 是 OpenAI 的 GPT-6 家族中端推理模型,于 2026 年 9 月 29 日发布,用于升级 GPT-6 Sol。
其卖点是在编码、电脑操作与专业工作上接近 Astra 的效果,但价格低很多,并提供更便宜的缓存输入,面向在多次请求间复用上下文的代理。
我们的 GPT-6.1 Sol 指南涵盖发布细节;我们的 GPT-6 Sol API 教程基于上一版本构建了一个代码库迁移代理。
什么是 Claude Opus 5.5?
Claude Opus 5.5 是 Anthropic 的旗舰 Opus 模型,也是 Claude 5.5 家族的首发模型。
Anthropic 将其定位于长时运行的代理式编码与知识工作,以更低成本在大多数任务上匹配 Claude Fable 5.1,并且自适应思考始终开启。
我们的 Claude Opus 5.5 指南涵盖发布;我们的 Opus 5.5 API 教程构建了一个 AI 事故调查员。
GPT-6.1 Sol 与 Claude Opus 5.5:正面对比
GPT-6.1 Sol 与 Opus 5.5 仅在 OpenAI 发布图表中的三项基准上有交集。Opus 5.5 在其中两项拿到更高的最好分数,而 GPT-6.1 Sol 在这三项中的单任务成本均低 2 到 5 倍。
| 功能 | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| AutomationBench(最好分数,单任务成本) | 最高 36.1%,$0.30 | 最高 42.5%,$1.44 |
| GDP.pdf(最好分数,单任务成本) | 高 32.0%,$0.35 | 高 28.8%,$0.83 |
| Terminal-Bench Science 0.1(最大努力) | 57.0%,$5.47 | 63.3%,$23.21 |
| DeepSWE v1.1 | 高 75.2% | 未发布 |
| Terminal-Bench 4.0 | 未发布 | 最高 66.4% |
| 电脑使用 | OSWorld 2.0 离线集 71.4%(最高) | OSWorld 2.1 为 81.8% |
| 上下文窗口 / 最大输出 | 1.05M / 128K | 1M / 128K |
| 知识截断 | 2026 年 4 月 | 2026 年 6 月 |
| 努力等级 | low、medium(默认)、high、xhigh、max | low、medium(默认)、high、xhigh、max |
前三行来自 OpenAI 的图表,图中将 Claude 的结果标为“Opus 5.5 w/ fallbacks(带回退)”。其余为各家对自家模型的报告。
业务流程与文档
这是 OpenAI 主攻的方向,胜负取决于努力等级。
OpenAI 的标题写着 GPT-6.1 Sol 在 AutomationBench(Zapier 对跨数十种业务工具、完成多步流程的代理测试)上高出 Opus 5.5 2.2 分。此结论在中等努力下成立:GPT-6.1 Sol 以每任务 $0.19 拿到 31.7%,而 Opus 5.5 以 $0.65 拿到 29.5%。
将两者都调至最大努力,顺序就会反转。Opus 5.5 提升至 42.5%,甚至超过 GPT-6 Astra,而 GPT-6.1 Sol 封顶在 36.1%。代价是 Opus 5.5 的单任务成本几乎高出 5 倍,因此问题在于:为多出 6 个百分点的流程成功率是否值得?如果是处理成千上万工单的支持机器人,大概不值;如果是财务流程,失败一次就需要人工重做,或许值得。
做文档与日常自动化,GPT-6.1 Sol 更划算;而最难的流程必须跑通时,选 Opus 5.5。
编码与科学工作
两者没有共享的编码基准,因此表中的数字各自为政。OpenAI 称 GPT-6.1 Sol 在 DeepSWE v1.1(在真实代码库中测试长视程工程)上匹配 GPT-6 Astra;而 Anthropic 报告 Opus 5.5 在 Terminal-Bench 4.0 与 FrontierCode 上领先 GPT-6 Astra。
在我们更早的动手测试中,上一代 GPT-6 Sol 在俄罗斯方块构建上以不到三分之一的运行成本击败 Opus 5.5(见 GPT-6 Sol 与 Claude Opus 5.5 对比),因此我们倾向认为 GPT-6.1 Sol 会胜出。
电脑使用
目前两者尚不能直接对比。OpenAI 报告了 GPT-6.1 Sol 在 OSWorld 2.0 的离线集上,成绩与 GPT-6 Astra 仅差 2.1 个点;而 Anthropic 报告的是 Opus 5.5 在 OSWorld 2.1(任务不同的更新版本)上的结果。双方都未发布对方所用版本的成绩,因此表中的数字并非正面对比。在有人用同一数据集测试之前,将电脑使用视为未定。
安全护栏与 API 约束
实际使用中,Opus 5.5 的限制更多。除非加入其网络安全验证计划,Anthropic 会将大多数网络安全相关任务路由至 Opus 4.8,生物学相关工作也有类似回退。这也是为何 OpenAI 图表将 Claude 的结果标为“带回退”。
GPT-6.1 Sol 的限制更多来自 API。本身没有 none 或 minimal 努力等级,且工具调用只能通过 Responses API,不能用 Chat Completions。Opus 5.5 则保持自适应思考常开并拒绝强制工具使用。对安全团队而言,Opus 5.5 的路由差异更实际;对迁移代码的开发者,则更多关注 GPT-6.1 Sol 的 API 变化。
定价:您实际会花多少钱
在所有标准费率上,GPT-6.1 Sol 的价格都正好是 Opus 5.5 的一半,直到提示超过 272K 输入令牌。
令牌费率并排对比
| 费率 | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| 输入,每 100 万令牌 | $2.00 | $4.00 |
| 输出,每 100 万令牌 | $10.00 | $20.00 |
| 缓存读取,每 100 万令牌 | $0.10 | $0.20 |
| 缓存写入,每 100 万令牌 | $2.50 | $5.00(5 分钟)、$8.00(1 小时) |
| 长上下文附加费 | 超过 272K 输入令牌:整次请求的输入与缓存按 2x、输出按 1.5x | 无 |
| 批量折扣 | 50% | 50% |
| 快速模式 | 标准费率的 2 倍 | 每 100 万令牌 $8 / $40 |
这一“0.5 倍”的比例在输入、输出与缓存读取上都成立,因此对常规大小的提示,结论基本就是“GPT-6.1 Sol 价格减半”。两者都将推理令牌计为输出,这对 Opus 5.5 影响更大,因为它的思考无法关闭。
真实工作负载需要多少成本
| 工作负载 | GPT-6.1 Sol | Claude Opus 5.5 | 差异 |
|---|---|---|---|
| 均衡助手:入 100 万 / 出 25 万 | $4.50 | $9.00 | $4.50(便宜 50%) |
| 检索,每次请求低于 272K:入 1000 万 / 出 100 万 | $30 | $60 | $30(便宜 50%) |
| 检索,每次请求高于 272K:入 1000 万 / 出 100 万 | $55 | $60 | $5(便宜 8%) |
总价为(体量 ÷ 100 万)× 费率,在标准费率下累加输入与输出。
- 均衡助手:最直接的“半价”情形,也是大多数聊天与代理工作负载的样貌。
- 阈值内检索:仍是半价,因此各轮提示保持较小的 RAG 架构可以获得完整降幅。
- 阈值外检索:附加费会把 GPT-6.1 Sol 的输入费率翻倍到与 Opus 5.5 相同,节省缩水到近似四舍五入误差。如果您的提示常常携带整个代码库,请按两者同价预算。
两家使用不同的分词器,且都未公布在同一工作负载上的令牌统计,因此将上述总价视为费率对比,而非账单。
GPT-6.1 Sol 与 Claude Opus 5.5 的实测表现
以上基准来自厂商自报,因此我用相同提示与相同工具,对 GPT-6.1 Sol 与 Claude Opus 5.5 各跑了一次构建任务。
任务:为一家社区诊所做一个单文件 HTML 的预约排班器,周视图从周一到周日,科室包括理疗、牙科、影像与儿科,具备新增、编辑、删除预约的表单,localStorage 持久化,并预置约 10 个预约的样例周。不允许构建步骤、无依赖、无网络。
难点是冲突逻辑,需要同时满足多条规则:
- 同一房间时间重叠,或同一医生时间重叠,均视为冲突
- 紧邻预订(一个结束时间恰好等于下一个开始时间)不得视为冲突
- 每个冲突标记必须指出对方预约及原因,而非仅仅变红
- 每次编辑与删除后必须更新标记,并在刷新后仍然存在
- 预置样例周必须恰好包含两个房间冲突与一个医生冲突
我喜欢这个测试,因为它既能验证 OpenAI 关于 GPT-6.1 Sol 在真实代码库工程上可匹敌 GPT-6 Astra 的说法,也能检验 Anthropic 将 Opus 5.5 定位为长时运行编码代理的主张。
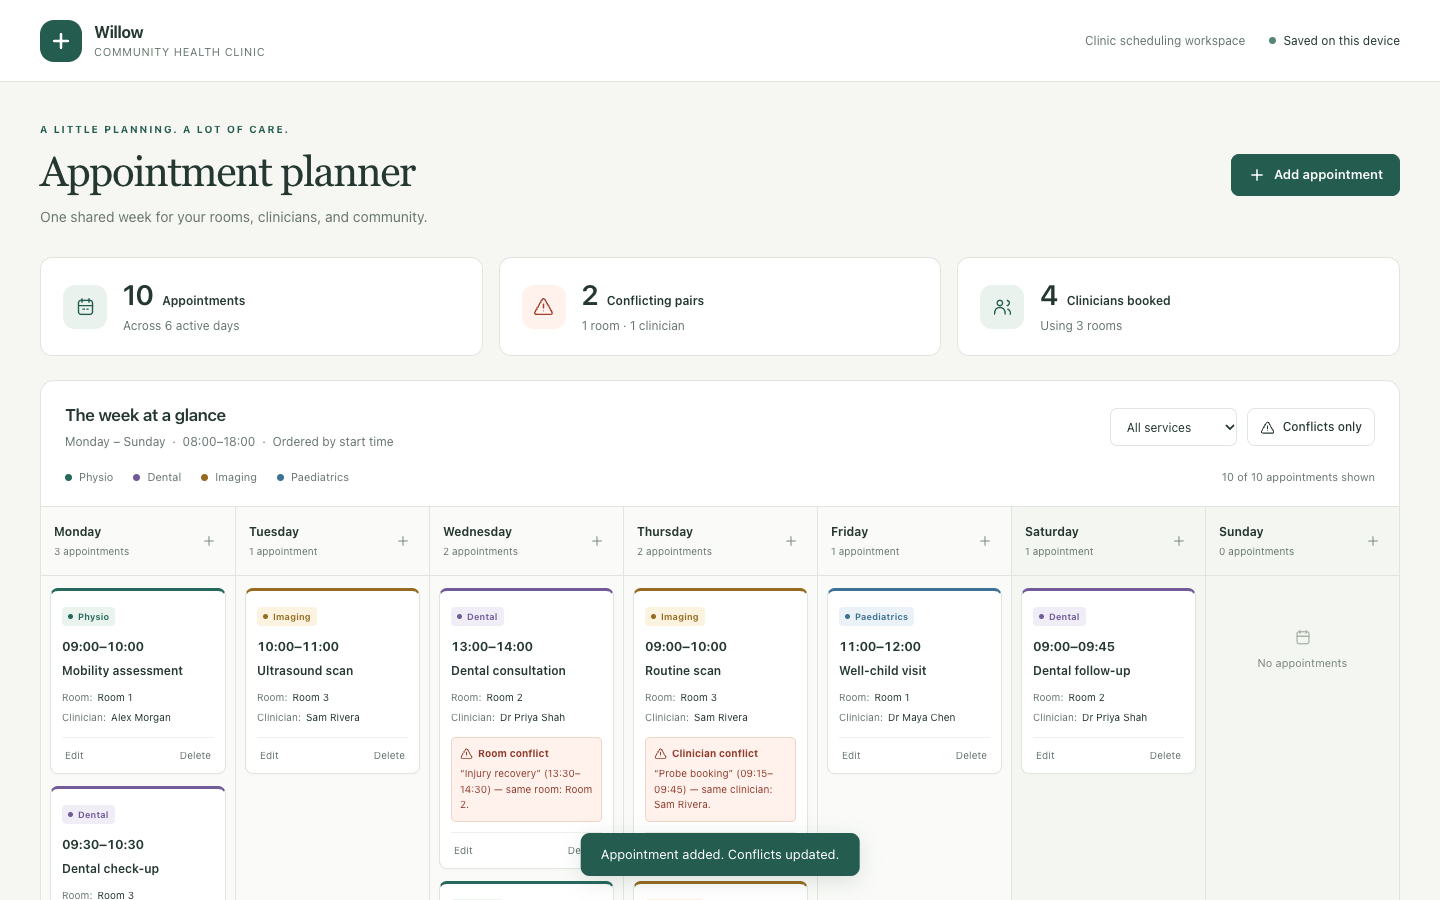
以下是我移动一次预约、删除一次、并新增一次导致医生重复预约后,GPT-6.1 Sol 的排班器。新的周四预约被标记且点名与其冲突的那条预约:
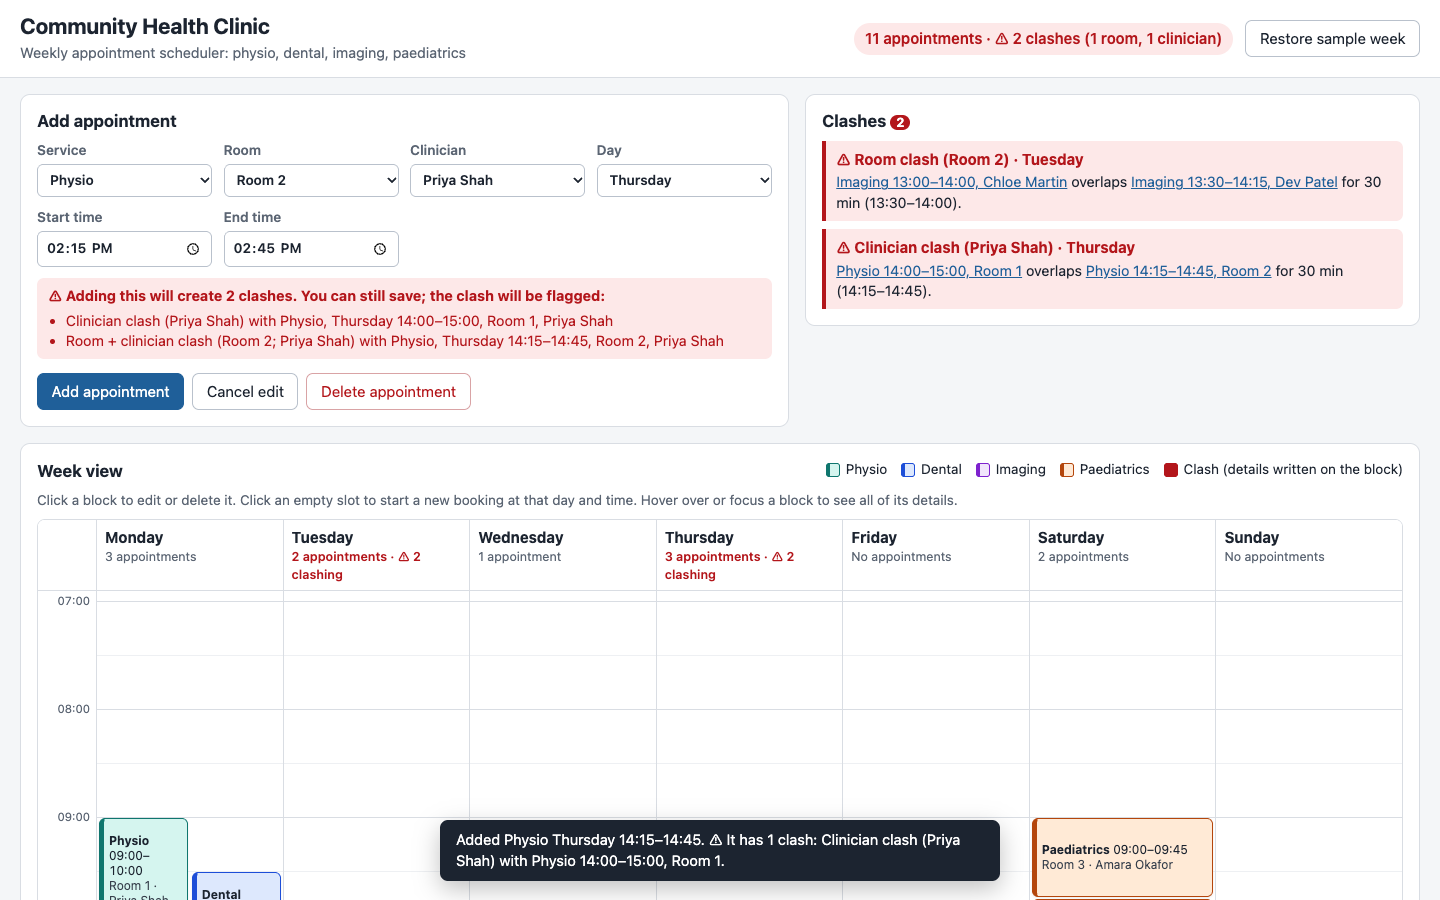
以下是 Opus 5.5 在相同步骤后的结果,冲突面板列出了每对剩余冲突及其重叠时长:
主要结论:
- 在冲突逻辑上,双方不分伯仲。两者初始页面均正确标记出两个房间冲突与一个医生冲突,并点名对方预约与原因,同时都未将紧邻预订视为冲突。
- 编辑、删除与刷新同样无误。将预约移到空闲房间能清除冲突双方;删除医生冲突的一方会清除另一方;新增一次医生重复预约能被正确标记;刷新后标记仍在。
- 差异主要在呈现。GPT-6.1 Sol 页面更精致,有摘要卡片、服务筛选与“仅显示冲突”开关,但按时间顺序列出每日预约而非时间网格。Opus 5.5 增加了显示重叠时长的冲突面板,并在保存前警示冲突,但其周视图需要滚动。
- Opus 5.5 写的样例周更刁钻。它包含一次不同房间、不同医生的重叠。
我在规范符合度与冲突逻辑上都打了 5 分(满分 5 分)。可用性与布局方面,GPT-6.1 Sol 得 5 分;Opus 5.5 因为周视图无法一屏展示,得 4 分。
成本是分野所在。Opus 5.5 的输出令牌多出一倍以上,其中大多是思考:
- GPT-6.1 Sol:$0.27
- Claude Opus 5.5:$1.11
那么谁赢?在这项任务上,是 GPT-6.1 Sol,主要体现在价格。两者都交付了正确可用的排班器,而 GPT-6.1 Sol 的成本约为后者的四分之一。
何时选择 GPT-6.1 Sol,何时选择 Claude Opus 5.5
对大多数团队而言,分水岭在单任务成本:GPT-6.1 Sol 达到 OpenAI 报告的分数,所花费用约为 Opus 5.5 的五分之一到二分之一。例外是长提示、在困难任务上追求最后几个百分点的成功率,以及您的部署渠道。
在以下情况下选择 GPT-6.1 Sol…
- 您需要大规模运行代理。在业务流程自动化上,它在中等努力下以约三分之一的单任务成本胜过 Opus 5.5,规模化后效应显著。
- 您的工作是围绕高密度文档提问。在 OpenAI 的 PDF 基准上,它在各努力等级都领先 Opus 5.5,且成本不到一半。
- 您的团队已在 ChatGPT Work 或 Codex 中工作。这是 OpenAI 在这些产品中推荐用于复杂编码与代理工作的模型。
- 您会复用较长的系统提示或上下文。每百万令牌 $0.10 的缓存读取,让高复用的代理循环很便宜,只要每次提示不超过 272K 令牌。
在以下情况下选择 Claude Opus 5.5…
- 您的提示经常超过 272K 令牌。GPT-6.1 Sol 的附加费会抹平大部分价格优势,而 Opus 5.5 没有长上下文附加费。
- 一次失败的运行代价高于令牌成本。在最大努力下,Opus 5.5 在 OpenAI 自己的图表中拿到最高的 AutomationBench 分数,超过 GPT-6 Astra。
- 您要通过 Cursor、Amazon Bedrock 或 Google Vertex AI 部署。Opus 5.5 已上这三家;GPT-6.1 Sol 目前尚未出现在 Cursor 或 Vertex AI 文档中。
- 您偏好 Anthropic 面向无人值守代理的保守默认设置。其安全防护会将风险较高的安全与生物学工作路由到其他模型,而非尝试直接处理。
如何开始使用 GPT-6.1 Sol 与 Claude Opus 5.5
| 使用界面 | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| 消费级应用 | ChatGPT Work 与 Codex(Plus、Pro、Business、Enterprise、Edu);Chat 暂未上 | Claude 应用(Pro、Max、Team、Enterprise) |
| 一方 API | OpenAI API(通过 Responses API 调用工具) | Claude API |
| 云平台 | Azure AI Foundry;截至 2026 年 9 月 30 日未在 Vertex AI 文档中列出 | Amazon Bedrock、Google Vertex AI、Azure AI Foundry |
| 编码代理 | Codex、GitHub Copilot;截至 2026 年 9 月 30 日未在 Cursor 文档中列出 | Claude Code、Cursor、GitHub Copilot |
| 第三方路由 | OpenRouter(openai/gpt-6.1-sol) | OpenRouter(anthropic/claude-opus-5.5) |
| API 模型 ID | gpt-6.1-sol |
claude-opus-5-5 |
最大差异在覆盖面:Opus 5.5 同时上了三大公有云与 Cursor,而 GPT-6.1 Sol 主要集中在 OpenAI 自家产品、Azure 与 Copilot。
发起您的第一个 API 调用
两款模型使用不同 SDK,因此切换时需要更换客户端与模型字符串:
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6.1-sol",
    reasoning={"effort": "medium"},
    input="Summarize the payment terms in this contract: ...",
)
print(response.output_text)
from anthropic import Anthropic
client = Anthropic()
response = client.messages.create(
model="claude-opus-5-5",
max_tokens=2048,
messages=[{"role": "user", "content": "Summarize the payment terms in this contract: ..."}],
)
print(next(b.text for b in response.content if b.type == "text"))完整构建可参考我们的 GPT-6 Sol API 教程 与 Opus 5.5 API 教程,上文也有提到。
结语
如果您的约束是单任务成本,就用 GPT-6.1 Sol。如果需要在困难代理任务上拿到最高成功率、经常发送长提示,或需通过 Cursor 或 Bedrock 部署,就用 Opus 5.5。
最耐人寻味的是,OpenAI 自己的图表为两者都做了背书。它选了中等努力的点作为标题,但同一张图在最大努力下显示 Opus 5.5 领先。OpenAI 押注大多数买家更在意曲线中更便宜的那一点;对日常代理而言,我认为这是对的。
由于 Sol 是中端模型,GPT-6.1 Sol vs. Claude Sonnet 5.5 也值得一试。
如果您要基于任一模型构建,我推荐我们的 OpenAI Fundamentals 技能路径或 Introduction to Claude Models 课程。