
Last chance! 50% off DataCamp Premium
Sale ends in
OpenAI gebruikte DevDay op 29 september om GPT-6.1 Sol te lanceren, een upgrade van het model uit het middensegment dat volgens hen dicht in de buurt komt van vlaggenschip GPT-6 Astra voor een vijfde van Astra's tokenprijzen. Een week eerder bracht Anthropic Claude Opus 5.5 uit, gepositioneerd als Fable 5.1-niveau prestaties voor 40% minder.
Dit zijn efficiëntieslagen, en OpenAI noemt Opus 5.5 expliciet in de lanceringspost, met claims van winst op zakelijke workflows en documentwerk tegen een fractie van de kosten per taak. OpenAI's eigen grafieken vertellen echter een interessanter verhaal dan de kop, omdat de vergelijking verandert afhankelijk van welke inspanningsstand je bekijkt.
In dit artikel vergelijken we GPT-6.1 Sol met Opus 5.5 vooral omdat OpenAI die match-up rechtstreeks maakt in de lancering, maar Claude Sonnet 5.5 is ook een eerlijke vergelijking, die we behandelen in ons artikel GPT-6.1 Sol vs Claude Sonnet 5.5.
GPT-6.1 Sol is OpenAI's redeneermodel uit het middensegment in de GPT-6-familie, uitgebracht op 29 september 2026 als upgrade van GPT-6 Sol.
Het verkooppunt is near-Astra resultaten op coderen, computergebruik en professioneel werk tegen een veel lagere prijs, met goedkopere gecachte input gericht op agents die context hergebruiken tussen requests.
Onze GPT-6.1 Sol-gids behandelt de lancering; onze GPT-6 Sol API-tutorial bouwt een migratie-agent voor codebases op de vorige versie.
Claude Opus 5.5 is Anthropics vlaggenschip Opus-model, uitgebracht als het eerste model in de Claude 5.5-familie.
Anthropic positioneert het voor langdurig agentisch coderen en kenniswerk, met prestaties die grotendeels overeenkomen met Claude Fable 5.1 tegen lagere kosten, met adaptief denken dat altijd aan staat.
Onze Claude Opus 5.5-gids behandelt de lancering; onze Opus 5.5 API-tutorial bouwt een AI-incidentonderzoeker.
GPT-6.1 Sol en Opus 5.5 overlappen op slechts drie gepubliceerde benchmarks, allemaal uit OpenAI's lanceringsgrafieken. Opus 5.5 noteert de hogere bestscore op twee daarvan, en GPT-6.1 Sol behaalt zijn resultaten voor 2x tot 5x minder per taak op alle drie.
| Feature | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| AutomationBench (bestscore, kosten per taak) | 36,1% op max, $0,30 | 42,5% op max, $1,44 |
| GDP.pdf (bestscore, kosten per taak) | 32,0% op high, $0,35 | 28,8% op high, $0,83 |
| Terminal-Bench Science 0.1 (maximale inspanning) | 57,0%, $5,47 | 63,3%, $23,21 |
| DeepSWE v1.1 | 75,2% op high | Niet gepubliceerd |
| Terminal-Bench 4.0 | Niet gepubliceerd | 66,4% op max |
| Computergebruik | 71,4% op OSWorld 2.0 offline (max) | 81,8% op OSWorld 2.1 |
| Contextvenster / max output | 1,05M / 128K | 1M / 128K |
| Kennisafkapdatum | april 2026 | juni 2026 |
| Inspanningsniveaus | low, medium (standaard), high, xhigh, max | low, medium (standaard), high, xhigh, max |
De eerste drie rijen komen uit OpenAI's grafieken, die de Claude-resultaten labelen als "Opus 5.5 w/ fallbacks". Alles daarbuiten is door elke leverancier zelf gerapporteerd.
Hier koos OpenAI zijn strijd, en hier bepaalt de inspanningsstand de winnaar.
OpenAI's kop zegt dat GPT-6.1 Sol 2,2 punten boven Opus 5.5 scoort op AutomationBench, Zapier's test voor agents die meerstapsworkflows in tientallen zakelijke tools afronden. Dat klopt op medium inspanning, waar GPT-6.1 Sol 31,7% haalt voor $0,19 per taak tegenover Opus 5.5's 29,5% voor $0,65.
Zet ze allebei op max, en de volgorde draait om. Opus 5.5 stijgt naar 42,5%, zelfs boven GPT-6 Astra, terwijl GPT-6.1 Sol piekt op 36,1%. Opus 5.5 betaalt daarvoor met bijna 5x de kosten per taak, dus de vraag is of zes punten meer workflowsucces het waard zijn voor jouw agent. Voor een supportbot die duizenden tickets afhandelt waarschijnlijk niet. Voor een financiële workflow waar een mislukte run betekent dat een mens het overdoet, misschien wel.
GPT-6.1 Sol is de betere waarde voor documentwerk en alledaagse automatisering. Opus 5.5 kies je wanneer de moeilijkste workflowruns móéten slagen.
Er is geen gedeelde codeerbenchmark, dus het cijfer van elke leverancier staat op zichzelf in de tabel. OpenAI zegt dat GPT-6.1 Sol overeenkomt met GPT-6 Astra op DeepSWE v1.1, dat lange-horizon engineering in echte codebases test, terwijl Anthropic meldt dat Opus 5.5 voorloopt op GPT-6 Astra op Terminal-Bench 4.0 en FrontierCode.
In onze eerdere praktijktest versloeg GPT-6 Sol, de vorige versie, Opus 5.5 op een Tetris-build voor minder dan een derde van de runtijdkosten (zie onze vergelijking GPT-6 Sol vs Claude Opus 5.5), dus we vermoeden dat GPT-6.1 Sol hier de overhand heeft.
De twee modellen zijn hier nog niet te vergelijken. OpenAI rapporteert GPT-6.1 Sol op de offline set van OSWorld 2.0, binnen 2,1 punten van GPT-6 Astra, terwijl Anthropic Opus 5.5 rapporteert op OSWorld 2.1, een nieuwere versie met andere taken. Geen van beide publiceerde de versie van de ander, dus de cijfers in de samenvattingstabel zijn geen directe vergelijking. Beschouw computergebruik als open tot iemand beide op dezelfde set draait.
Opus 5.5 is in de praktijk het meer beperkte model. Anthropic routeert de meeste cybersecuritytaken naar Opus 4.8 tenzij je in het Cyber Verification Program zit, en biologiewerk gaat via vergelijkbare fallbacks. Daarom labelt OpenAI in de grafieken de Claude-resultaten ook als "met fallbacks".
GPT-6.1 Sol's beperkingen zitten eerder in de API. Het heeft geen none- of minimal-inspanning, en tool-calling werkt alleen via de Responses API, niet via Chat Completions. Opus 5.5 houdt adaptief denken altijd aan en weigert geforceerd toolgebruik. Voor securityteams is de routing van Opus 5.5 het grootste praktische verschil; voor developers die code migreren zijn het de API-wijzigingen van GPT-6.1 Sol.
GPT-6.1 Sol kost precies de helft van Opus 5.5 op elk standaardtarief, totdat een prompt de 272K inputtokens passeert.
| Tarief | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| Input, per 1M tokens | $2,00 | $4,00 |
| Output, per 1M tokens | $10,00 | $20,00 |
| Gecachte input lezen, per 1M tokens | $0,10 | $0,20 |
| Cache schrijven, per 1M tokens | $2,50 | $5,00 (5 minuten), $8,00 (1 uur) |
| Toeslag voor lange context | Boven 272K inputtokens: 2x input en cache, 1,5x output voor de hele request | Geen |
| Batchkorting | 50% | 50% |
| Snelle modus | 2x standaardtarieven | $8 / $40 per 1M tokens |
De vaste factor 0,5x geldt voor input, output en cachereads, dus bij prompts van normale grootte komt de vergelijking neer op "GPT-6.1 Sol kost de helft". Beide modellen rekenen redeneertokens als output, wat meer uitmaakt voor Opus 5.5 omdat het denken niet uitgezet kan worden.
| Workload | GPT-6.1 Sol | Claude Opus 5.5 | Verschil |
|---|---|---|---|
| Gebalanceerde assistent: 1M in / 250K uit | $4,50 | $9,00 | $4,50 (50% minder) |
| Retrieval, elke request onder 272K: 10M in / 1M uit | $30 | $60 | $30 (50% minder) |
| Retrieval, elke request boven 272K: 10M in / 1M uit | $55 | $60 | $5 (8% minder) |
Elke totaalprijs is (volume ÷ 1M) × tarief, opgeteld over input en output, tegen standaardtarieven.
De twee leveranciers gebruiken verschillende tokenizers, en geen van beiden heeft tokenaantallen voor een gedeelde workload gepubliceerd, dus beschouw deze totalen als een tariefvergelijking in plaats van een factuur.
De benchmarks hierboven zijn die van de leveranciers zelf, dus ik draaide één bouwtaak tegen GPT-6.1 Sol en Claude Opus 5.5 met een identieke prompt en identieke tooling.
De taak: een single-file HTML-afsprakenscheduler voor een wijkgezondheidskliniek, met een weekoverzicht van maandag tot en met zondag van fysio-, tandarts-, beeldvorming- en kindergeneeskunde-afspraken, een formulier om boekingen toe te voegen, te bewerken en te verwijderen, localStorage-persistentie, en een voorgevulde voorbeeldweek van zo'n tien afspraken. Geen buildstap, geen dependencies, geen netwerk.
Het lastigste deel is de conflictenlogica, die meerdere regels tegelijk moet vasthouden:
Ik houd van deze test omdat hij OpenAI's claim prikt dat GPT-6.1 Sol overeenkomt met GPT-6 Astra op engineering in echte codebases, en Anthropics pitch voor Opus 5.5 als langdurige codeeragent.
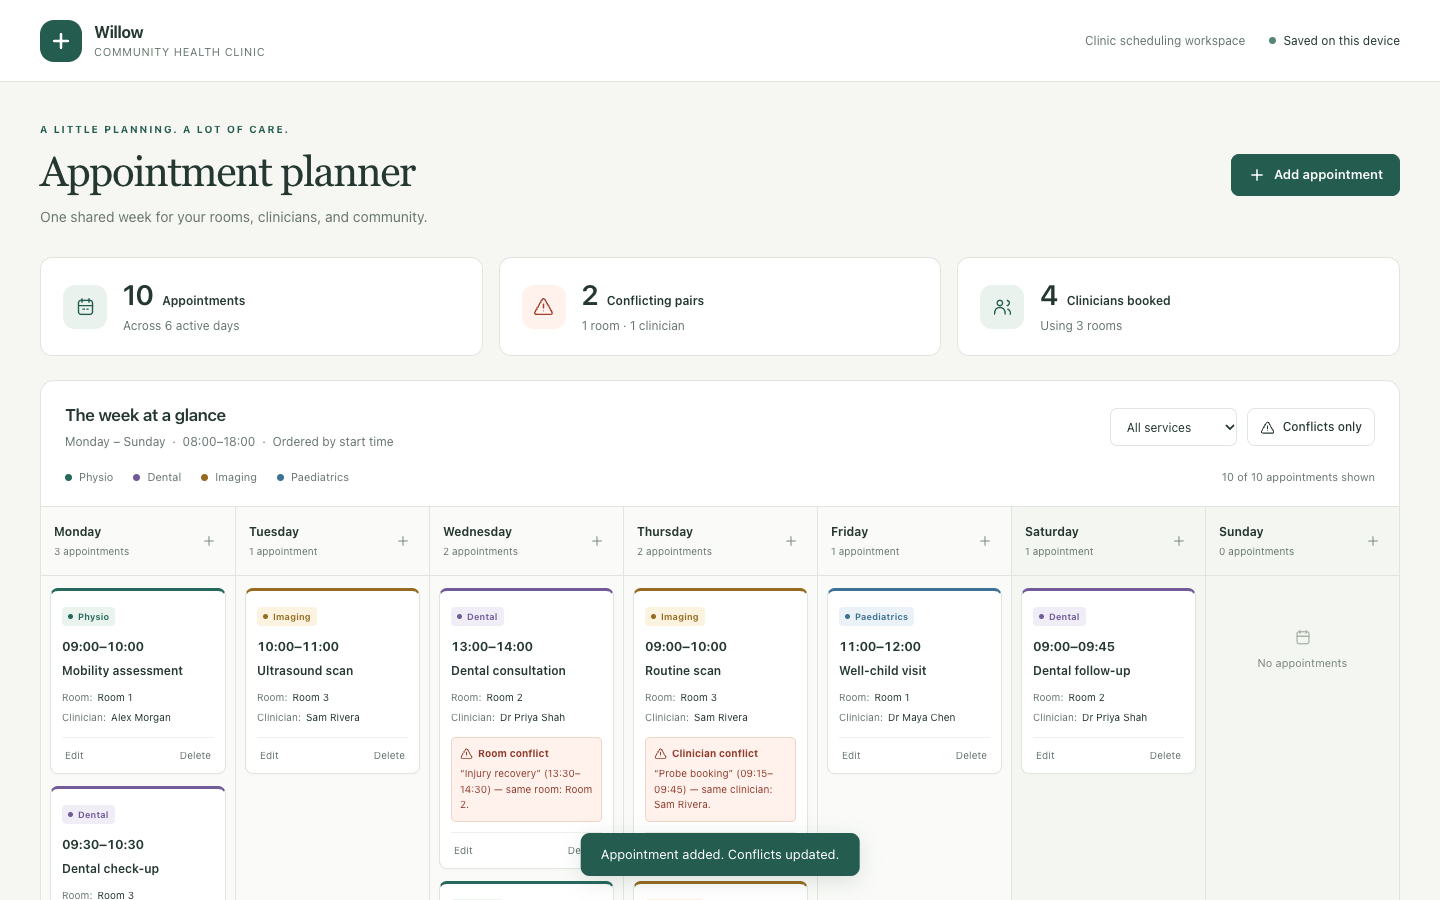
Hier is de scheduler van GPT-6.1 Sol nadat ik een boeking verplaatste, er één verwijderde en een nieuwe toevoegde die een behandelaar dubbel boekt. De nieuwe boeking op donderdag is gevlagd, met naamgeving van de afspraak waarmee hij botst:
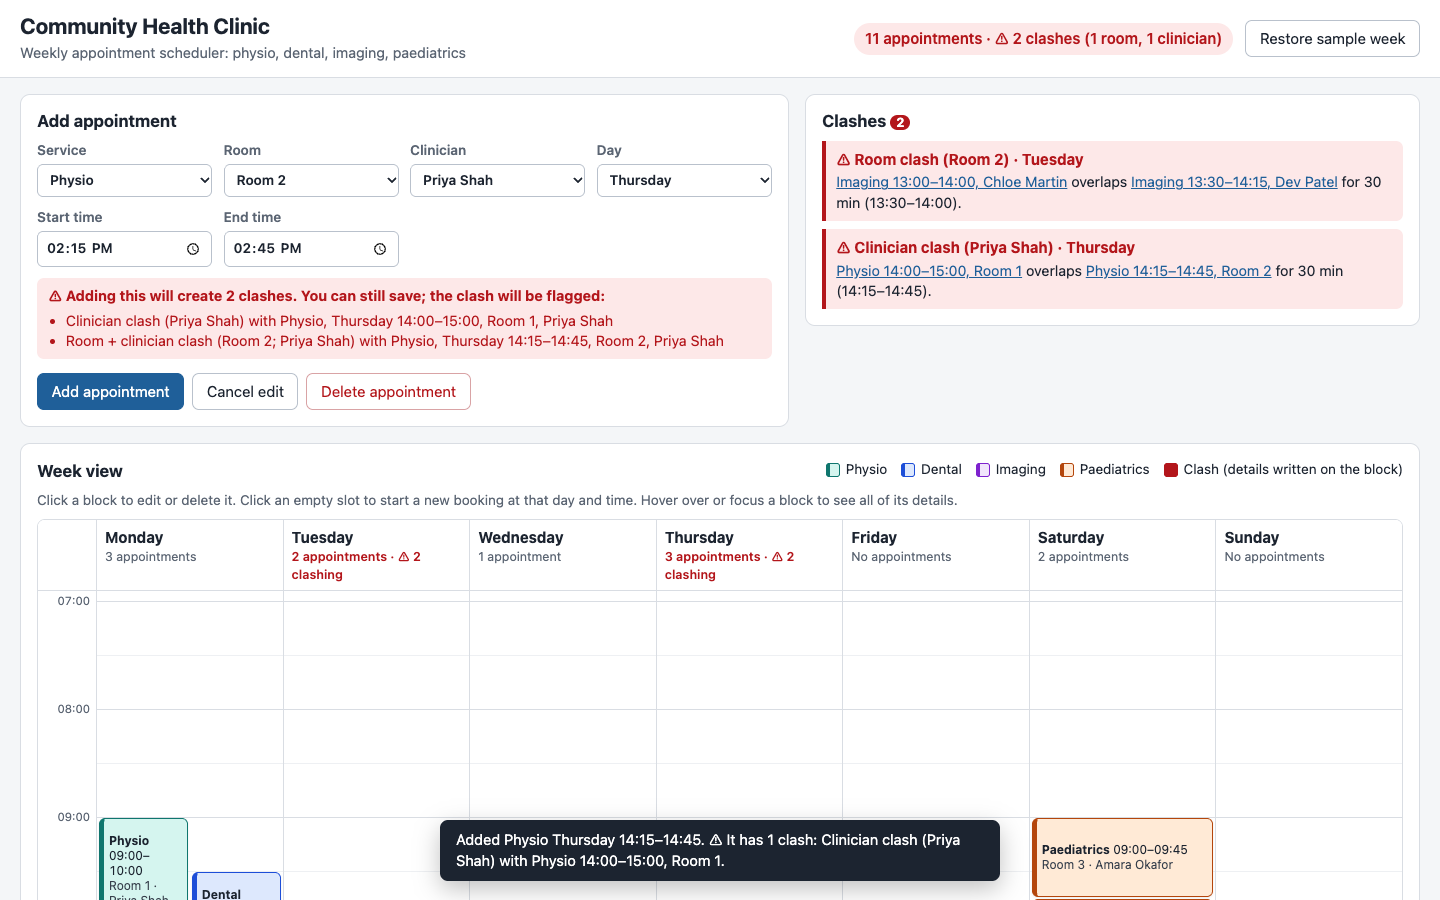
En hier is die van Opus 5.5 na dezelfde stappen, met een conflictpaneel dat elk overgebleven paar en de duur van de overlap toont:
De belangrijkste bevindingen:
Ik gaf beide een 5 uit 5 voor het volgen van de specificatie en de conflictenlogica. GPT-6.1 Sol kreeg 5 voor bruikbaarheid en layout, en Opus 5.5 kreeg 4 omdat zijn weekweergave niet op één scherm past.
Bij de kosten scheiden ze. Opus 5.5 verbruikte meer dan twee keer zoveel outputtokens, grotendeels aan denken:
Wie wint er dan? Bij deze taak: GPT-6.1 Sol, en vooral op prijs. Beide leverden een correcte, werkende scheduler op, en GPT-6.1 Sol deed dat voor ongeveer een kwart van de kosten.
Voor de meeste teams is de splitsing kosten per taak: GPT-6.1 Sol haalt OpenAI's gerapporteerde scores voor grofweg een vijfde tot de helft van wat Opus 5.5 uitgeeft. Uitzonderingen zijn lange prompts, de laatste paar succespunten op moeilijke runs, en waar je uitrolt.
| Surface | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| Consumentenapp | ChatGPT Work en Codex (Plus, Pro, Business, Enterprise, Edu); nog niet in Chat | Claude-apps (Pro, Max, Team, Enterprise) |
| Eerste-partij API | OpenAI API (tool-calling via de Responses API) | Claude API |
| Cloudplatformen | Azure AI Foundry; niet vermeld in de Vertex AI-docs per 30 september 2026 | Amazon Bedrock, Google Vertex AI, Azure AI Foundry |
| Codeeragents | Codex, GitHub Copilot; niet vermeld in de Cursor-docs per 30 september 2026 | Claude Code, Cursor, GitHub Copilot |
| Routers van derden | OpenRouter (openai/gpt-6.1-sol) | OpenRouter (anthropic/claude-opus-5.5) |
| API-model-ID | gpt-6.1-sol |
claude-opus-5-5 |
Het grootste verschil is bereik: Opus 5.5 staat op alle drie de grote clouds en in Cursor, terwijl GPT-6.1 Sol gecentreerd is rond OpenAI's eigen producten, Azure en Copilot.
De twee modellen gebruiken verschillende SDK's, dus overstappen betekent de client én de modelstring wijzigen:
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6.1-sol",
    reasoning={"effort": "medium"},
    input="Summarize the payment terms in this contract: ...",
)
print(response.output_text)
from anthropic import Anthropic
client = Anthropic()
response = client.messages.create(
model="claude-opus-5-5",
max_tokens=2048,
messages=[{"role": "user", "content": "Summarize the payment terms in this contract: ..."}],
)
print(next(b.text for b in response.content if b.type == "text"))Voor volledige builds, zie onze GPT-6 Sol API-tutorial en onze Opus 5.5 API-tutorial, die ik hierboven ook deelde.
Als kosten per taak je beperking zijn, gebruik GPT-6.1 Sol. Als je de hoogste slagingskans nodig hebt op moeilijke agentruns, lange prompts verstuurt of uitrolt via Cursor of Bedrock, gebruik Opus 5.5.
Wat ik het meest veelzeggend vind, is dat OpenAI's eigen grafieken voor beide pleiten. Ze kozen de medium-inspanningspunt voor de kop, maar dezelfde grafiek toont Opus 5.5 bovenaan bij maximale inspanning. OpenAI gokt dat de meeste kopers het goedkopere punt op de curve belangrijker vinden, en voor alledaagse agents denk ik dat dat klopt.
Omdat Sol een model uit het middensegment is, is GPT-6.1 Sol vs. Claude Sonnet 5.5 ook het testen waard.
En als je op een van beide modellen bouwt, raad ik onze skill track OpenAI Fundamentals of onze cursus Introduction to Claude Models aan.