Traseu de învățare
Dezvoltarea modelelor lingvistice mari
16 ore
Imaginează-ți doi studenți care dau același examen. Primul petrece trei săptămâni studiind doar un modul, în timp ce al doilea a exersat deja pe milioane de examene diferite și, în ziua examenului, primește doar o fișă cu exemple rezolvate.
Pentru mare parte din istoria învățării automate, modelele pentru tabele au fost primul student. Fiecare set de date nou însemna curățarea coloanelor, inginerie de caracteristici, antrenarea XGBoost sau LightGBM și reglarea hiperparametrilor ore întregi.
Modelele fundamentale pentru tabele, însă, sunt al doilea student: le dai rândurile etichetate ca exemple și ele prezic restul fără niciun fel de antrenare.
În 2026, această idee a trecut de la lucrări de cercetare la produse reale, cu SAP angajând peste 1 miliard € pentru Prior Labs și Google lansând propriul model. Așadar, în acest articol vom vedea:
Nu te îngrijora dacă nu ai multă experiență cu deep learning. Codul din acest articol folosește interfața familiară scikit-learn, iar dacă vrei mai întâi o recapitulare rapidă, 8 modele de Machine Learning explicate în 20 de minute acoperă elementele de bază.
pip install tabicl.Un model fundamental pentru tabele este o rețea neuronală preantrenată pe milioane de seturi de date tabelare sintetice, care învață o strategie generală de prezicere a unei coloane-țintă, apoi aplică acea strategie unui tabel nou prin învățare în context, fără vreo antrenare pe setul respectiv.
Marea schimbare aici este când are loc învățarea.
Cu XGBoost, învățarea are loc pe datele tale de fiecare dată când antrenezi un model nou. Cu un model fundamental pentru tabele, învățarea a avut loc cu luni în urmă în timpul preantrenării, iar datele tale sunt pur și simplu intrarea. Vei mai vedea câțiva termeni, așa că îi explic pe scurt, pe înțelesul tuturor:
Acum, să vedem cum se compară modelele fundamentale pentru tabele cu metodele de boosting și cu AutoML:
| Modele fundamentale pentru tabele | Arbori boosting (XGBoost, LightGBM) | AutoML (AutoGluon, H2O AutoML) | |
|---|---|---|---|
| Timp de antrenare pe date noi | Inexistent | Secunde până la minute, plus reglare | Minute până la ore |
| Interpretabilitate | Limitată (SHAP e posibil, dar lent) | Bună (importanța caracteristicilor, SHAP rapid) | Variază, adesea ansambluri greu de interpretat |
| Mărimea optimă a setului de date | Sute până la ~100K rânduri | Mii până la multe milioane de rânduri | Mii până la milioane de rânduri |
| E nevoie de GPU? | Recomandat peste câteva mii de rânduri | Nu | De obicei nu |
| Seturi mici, împărțite aleator | Cele mai bune pe benchmark-urile actuale | Puternice când sunt reglate | Puternice, dar lente |
Înainte să vedem cum funcționează, vreau să le compar rapid cu cele mai celebre și folosite modele: modelele mari de limbaj.
Modelele mari de limbaj (LLM) și modelele fundamentale pentru tabele folosesc ambele transformere și învață din exemplele din intrare.
Diferența este ce sunt construite să citească. Un LLM citește un tabel ca pe un șir lung de text, ceea ce înseamnă că trebuie să deducă din virgule și spații ce numere aparțin aceleiași coloane.
Mai este și o problemă de sens.
Valoarea 42 ar putea fi vârsta cuiva sau o sumă de venit, dar numărul în sine nu îți spune care e cazul. Un model fundamental pentru tabele este antrenat să trateze fiecare coloană ca pe propria variabilă și fiecare rând ca pe un exemplu, astfel încât se concentrează pe relațiile dintre coloane.
Îmi place să o privesc așa: un LLM e excelent la a vorbi despre datele tale, iar un model fundamental pentru tabele e construit să facă matematica pe ele.
Cele două pot lucra și împreună, exact cum poziționează H2O.ai modelul tabH2O: ca instrumentul de predicție pe care îl apelează un agent AI când are nevoie de un număr dintr-un spreadsheet.
Datele tabelare au fost dificile pentru deep learning deoarece tabelele nu au o structură comună pe care o rețea neuronală să o învețe o dată și să o refolosească. Un pixel e un pixel în orice fotografie. O coloană numită score într-un set financiar și una numită score într-un set din fotbal nu au nimic în comun.
O lucrare cunoscută din 2022 de Léo Grinsztajn, Edouard Oyallon și Gaël Varoquaux, Why do tree-based models still outperform deep learning on tabular data?, a testat asta pe 45 de seturi de date și a găsit că modelele pe arbori, în special gradient boosting, bat în continuare deep learning pe tabele medii de aproximativ 10.000 de rânduri. Motivele identificate sunt:
Două probleme practice agravează situația. Un singur tabel poate amesteca numere, categorii, clasamente și valori lipsă, iar majoritatea tabelelor de business au doar sute sau mii de rânduri, mult prea puține pentru o rețea antrenată de la zero.
Aș susține că seturile mici sunt problema cea mai importantă. O rețea neuronală antrenată de la zero pe 800 de rânduri nu are pe ce se sprijini, în timp ce un arbore nu are nevoie de cunoștințe anterioare ca să funcționeze.
Exact asta a rezolvat preantrenarea. Un model fundamental pentru tabele a exersat deja pe milioane de tabele mici, dezordonate, inventate, înainte să-l vadă pe al tău, deci nu pornește de la zero.
Un model fundamental pentru tabele ia rândurile tale de antrenare etichetate și rândurile de test neetichetate împreună ca o singură intrare și prezice etichetele lipsă într-un singur forward pass. Greutățile nu se schimbă niciodată, la fel ca un LLM care răspunde la o întrebare după ce îi dai câteva exemple în prompt.
Asta schimbă și ce înseamnă metodele familiare din scikit-learn.
Când apelezi .fit() pe TabICL, documentația TabICL explică faptul că încarcă checkpoint-ul preantrenat, îți preprocesează datele și le stochează. Munca reală are loc în timpul .predict().
Numele .fit() rămâne ca modelul să se potrivească cu codul tău existent din scikit-learn.
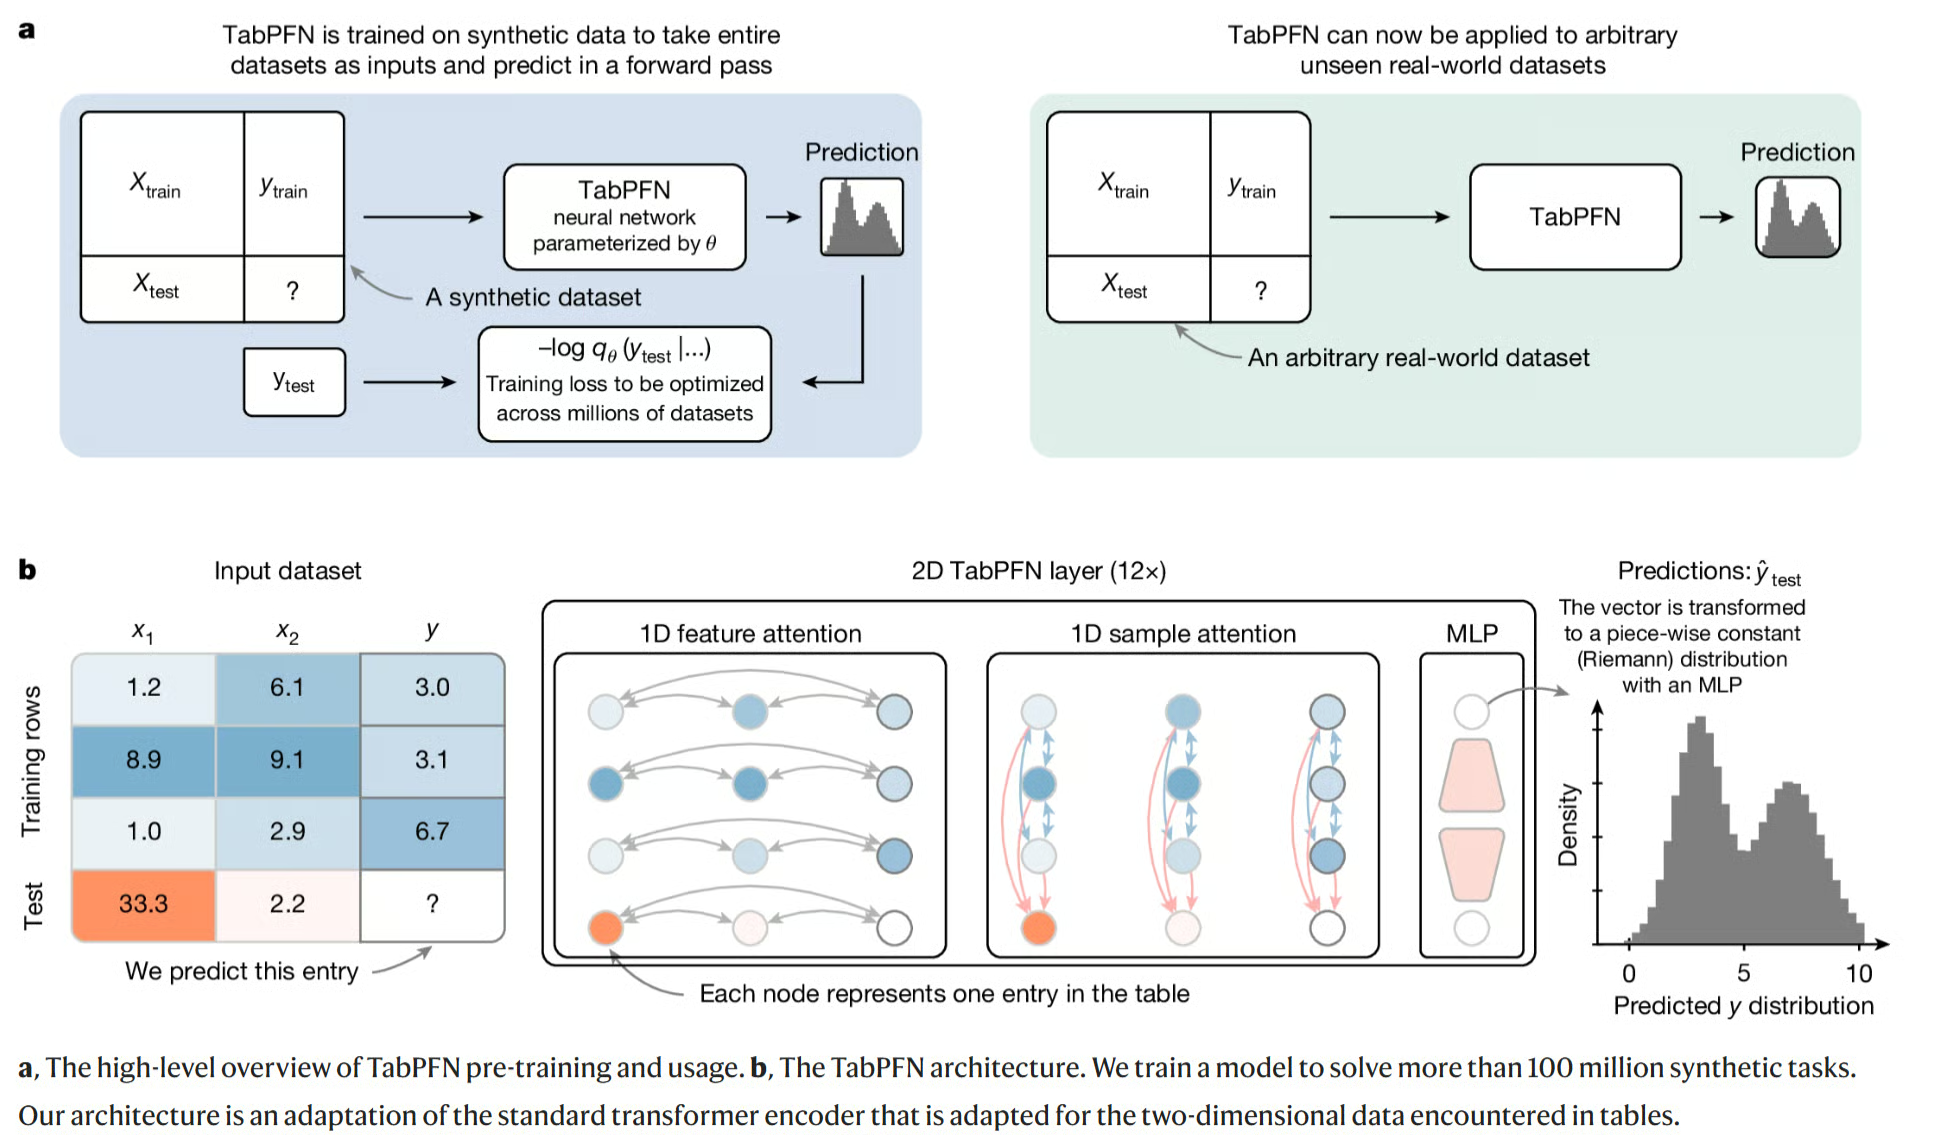
Figura 1: TabPFN este preantrenat pe milioane de seturi de date sintetice, apoi prezice pe un tabel real într-un singur forward pass. Panoul de jos arată cum acordă atenție pe caracteristici și pe eșantioane. Sursa: Hollmann et al., „Accurate predictions on small data with a tabular foundation model”, Nature (2025).
Preantrenarea sintetică înseamnă antrenarea modelului pe tabele inventate în loc de unele reale, produse de un generator de date care funcționează ca un model generativ.
Gândește-te la un pilot care se antrenează într-un simulator de zbor. Pilotul exersează mii de zboruri false cu vreme, aeroporturi și defecțiuni diferite, astfel încât primul zbor real să nu pară nou.
TabPFN funcționează într-un mod similar.
Creatorii lui au scris un generator care inventează reguli aleatorii de „cauză și efect” între coloane (de exemplu, coloana A o influențează pe B, care influențează ținta), apoi produce rânduri din acele reguli.
În timpul preantrenării, coloana-țintă este ascunsă, modelul încearcă să o prezică, iar acest lucru se repetă de milioane de ori cu reguli, niveluri de zgomot și dimensiuni de tabele diferite.
Important este că modelul nu învață niciodată fapte despre vreun subiect real. El învață abilități generale precum depistarea coloanelor relevante, gestionarea valorilor extreme și recunoașterea incertitudinii.
De fapt, lucrarea TabICLv2 creditează noul său generator de date sintetice drept un motiv-cheie pentru performanța mai bună.
Nu trebuie să înțelegi fiecare detaliu al arhitecturilor, dar ajută să știi că există două abordări principale:
Reține că ambele familii sunt antrenate pe date sintetice, deci „rețea ajustată pe prior” descrie cum sunt antrenate, nu un tip separat de model.
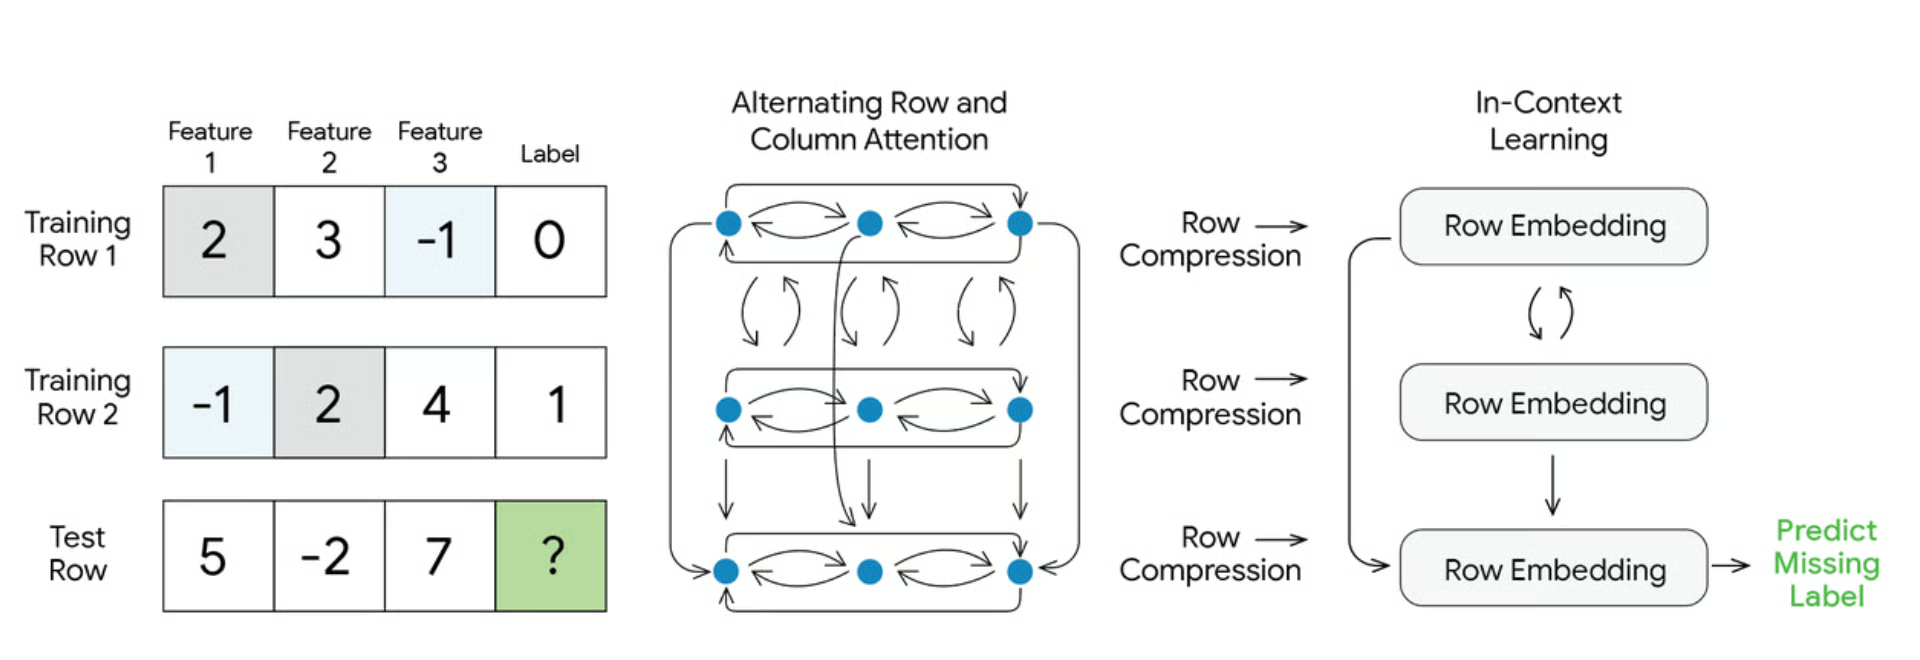
Figura 2: TabFM îmbină ambele designuri: atenție în stil TabPFN pe rânduri și coloane, apoi compresie pe rând în stil TabICL, apoi învățare în context pentru eticheta lipsă. Sursa: Google Research, „Introducing TabFM: A zero-shot foundation model for tabular data” (2026).
Există un compromis care îi prinde pe mulți pe picior greșit.
XGBoost petrece timp o dată la antrenare, apoi prezice aproape instantaneu.
Un model fundamental pentru tabele sare peste antrenare, dar trebuie să citească toate rândurile tale de antrenare de fiecare dată când prezice.
Gândește-te la un bucătar care nu face nicio pregătire înainte de serviciu, dar trebuie să recitească toată cartea de rețete pentru fiecare comandă.
Pentru o carte mică, e în regulă, dar pe măsură ce setul tău de date crește, predicțiile se încetinesc. Atât TabICL, cât și TabPFN pot memora în cache „citirea” datelor de antrenare pentru a accelera predicțiile repetate, dar primul pas tot costă timp.
Modelele-cheie în 2026 sunt TabPFN, TabICLv2, TabFM de la Google, NEXUS de la Fundamental și tabH2O de la H2O.ai. Ce mi se pare interesant este cât de repede s-a mișcat partea de business: cinci luni au dus domeniul de la lucrări academice la acorduri majore. Iată o scurtă cronologie:
Acum să le parcurgem pe rând, începând cu modelul care a pornit totul.
TabPFN este modelul care a creat această categorie. TabPFN-2 a fost publicat în Nature în ianuarie 2025 și a depășit modelele pe arbori reglate pe seturi de până la 10.000 de rânduri.
De atunci, Prior Labs a lansat rapid versiuni noi. TabPFN-3 a apărut în mai 2026 și gestionează până la 1 milion de rânduri (și până la 200 de caracteristici). A adăugat și un mod Thinking (prin API-ul cu plată) care petrece timp suplimentar la etapa de fitting pentru predicții mai bune.
Cea mai recentă versiune, TabPFN-3.5, a apărut în septembrie 2026, iar raportul tehnic revendică primul loc pe mai multe benchmark-uri majore, inclusiv pe date ordonate în timp și grupate. Aș trata acele rezultate ca cifrele companiei până la confirmări independente.
Încă un aspect este licența. TabPFN-2 poate fi folosit comercial atâta timp cât menționezi Prior Labs, dar versiunile 2.5–3.5 sunt necomerciale. Asta înseamnă că poți experimenta gratuit, dar folosirea într-un produs real necesită o licență plătită.
TabICLv2 este cel mai bun model fundamental complet deschis pentru tabele în acest moment. A fost construit la Inria, lansat în februarie 2026 și acceptat la ICML 2026.
Rezultatul principal din lucrarea TabICLv2 este că, fără nicio reglare, a depășit RealTabPFN-2.5, modelul anterior de top, deși acela fusese reglat, ansamblat și fine-tuned pe date reale.
Conform repository-ului de pe GitHub, bate și XGBoost, CatBoost și LightGBM intens reglate pe aproximativ 80% dintre seturile de date din benchmark-ul TabArena.
Este și rapid, gestionând 50.000 de rânduri cu 100 de caracteristici în sub 10 secunde pe un GPU H100, cam de 10 ori mai rapid decât TabPFN-2.5.
Funcționează cel mai bine între 300 și 100.000 de rânduri și poate urca până la aproximativ 500.000 de rânduri cu o oarecare pierdere de acuratețe.
Din punctul meu de vedere, acesta este cel cu care ar trebui să înceapă majoritatea cititorilor.
Îl instalezi cu pip install tabicl, funcționează ca orice model scikit-learn, iar licența permisivă îți permite utilizare comercială fără înscrieri. Totuși, clasamentele se mișcă rapid, iar raportul TabPFN-3.5 se clasează acum înaintea TabICLv2.
TabFM este modelul pentru tabele al Google Research, lansat pe 30 iunie 2026. Diferența este unde îl poți folosi: este integrat în BigQuery, depozitul de date în cloud al Google, astfel încât poți obține predicții cu SQL obișnuit.
-- Use past customers (with known churn) to predict churn for new customers
-- AI.PREDICT is in preview, so check the BigQuery docs for the latest syntax
SELECT *
FROM AI.PREDICT(
  TABLE my_dataset.customers_history,
  TABLE my_dataset.customers_new,
  label_col => 'churned'
);
Acest lucru este excelent pentru cei care știu SQL, dar nu Python.
Totuși, documentația BigQuery te limitează în prezent la 20 de coloane de caracteristici și 10 clase, iar Google plănuiește să introducă prețuri pe bază de token, pe lângă tarifele standard BigQuery, din 30 octombrie 2026. Greutățile modelului de pe Hugging Face sunt necomerciale, deci utilizarea comercială trece prin BigQuery.
NEXUS este un model închis, destinat companiilor, de la Fundamental, un startup din San Francisco fondat de foști cercetători DeepMind. A fost lansat în februarie 2026 cu 255 milioane $ finanțare, iar compania îl numește un Large Tabular Model (LTM).
Companiile cumpără și rulează NEXUS prin AWS, iar Fundamental susține că firme din Fortune 100 îl folosesc deja pentru prognoză a cererii, stabilirea prețurilor și churn. Totuși, nu există greutăți publice sau benchmark-uri pe care să le poți verifica, așa că l-aș trata ca pe o opțiune enterprise.
tabH2O este modelul H2O.ai, iar ideea lui este simplă: trimiți datele, primești predicții înapoi.
Îți rezolvă valorile lipsă și categoriile și poate rula pe serverele proprii ale unei companii, lucru important pentru bănci și spitale care nu pot trimite date în cloud.
Ce îmi place este că lucrarea tabH2O nu îl supraevaluează. A depășit CatBoost și LightGBM reglate pe benchmark-ul TALENT, dar tot s-a clasat în urma TabICLv2.
| Model | Creator | Greutăți deschise? | Scală maximă | Licență | Cel mai potrivit pentru |
|---|---|---|---|---|---|
| TabPFN-2 | Prior Labs | Da | 10K rânduri | Comercial cu atribuire | Utilizare comercială a unui model mai vechi, dovedit |
| TabPFN-3 / 3.5 | Prior Labs (SAP) | Da, după acceptarea unei licențe | Până la 1M rânduri | Necomercial, API plătit pentru business | Acuratețe de top și cercetare |
| TabICLv2 | Inria | Da | Optim până la 100K rânduri | Open source permisiv | Punctul tău de pornire implicit |
| TabFM | Google Research | Da | 20 caracteristici în BigQuery | Greutăți necomerciale | Utilizatori de SQL pe BigQuery |
| NEXUS | Fundamental | Nu | Nedezvăluit | Proprietar | Companii mari pe AWS |
| tabH2O | H2O.ai | Nu | Nedezvăluit | API comercial | Echipe fără setup ML, agenți AI |
Folosesti un model fundamental pentru tabele în Python exact ca pe orice alt model scikit-learn.
Cel mai bun mod de a vedea ce oferă este să-l pui față în față cu XGBoost, așa că să facem asta pe setul de date despre cancerul mamar din scikit-learn.
Mai întâi, instalăm pachetele:
pip install tabicl xgboost scikit-learnApoi rulăm ambele modele pe aceeași împărțire:
from sklearn.datasets import load_breast_cancer
from sklearn.metrics import accuracy_score
from sklearn.model_selection import train_test_split
from tabicl import TabICLClassifier
from xgboost import XGBClassifier

# Load a small tabular dataset as a pandas DataFrame
X, y = load_breast_cancer(return_X_y=True, as_frame=True)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, stratify=y, random_state=42
)

# Tabular foundation model: fit() just stores the training rows
tfm = TabICLClassifier()
tfm.fit(X_train, y_train)
tfm_preds = tfm.predict(X_test)

# XGBoost baseline with reasonable, untuned settings
xgb = XGBClassifier(n_estimators=300, learning_rate=0.05, max_depth=4)
xgb.fit(X_train, y_train)
xgb_preds = xgb.predict(X_test)

print(f"TabICL accuracy:  {accuracy_score(y_test, tfm_preds):.3f}")
print(f"XGBoost accuracy: {accuracy_score(y_test, xgb_preds):.3f}")
Acest set mic rulează bine pe un CPU obișnuit de laptop.
Ambele modele vor obține scoruri foarte mari pe ceva atât de curat, deci te rog să nu le judeci după o singură împărțire. Testul real va fi pe datele tale dezordonate.
Dacă vrei să încerci TabPFN, rulează pip install tabpfn, iar apoi sunt doar două linii de schimbat:
from tabpfn import TabPFNClassifier

tfm = TabPFNClassifier()  # The first run asks you to accept the license
tfm.fit(X_train, y_train)
tfm_preds = tfm.predict(X_test)
Un lucru important înainte să compari modele pe date reale.
Dacă datele tale au date calendaristice, împarte-le în funcție de timp, nu aleator. Altfel, modelul aruncă un ochi în viitor și, după cum vei vedea în secțiunea următoare, exact acolo modelele fundamentale pentru tabele arată mai bine decât sunt în realitate.
Modelele fundamentale pentru tabele funcționează bine când setul tău de date este mic spre mediu și rândurile de test seamănă cu rândurile de antrenare. Se chinuie cu date ordonate în timp, date grupate, tabele foarte mari și cerințe stricte de explicabilitate.
Această idee, „rândurile de test seamănă cu rândurile de antrenare”, are un nume: IID (independente și identic distribuite) și este cel mai important lucru de verificat despre datele tale.
Să începem cu unde funcționează bine:
Acum limitările, care cred că contează mai mult dacă vrei să folosești aceste modele într-un proiect real.
Benchmark-ul BeyondArena, lansat în iunie 2026, a testat 11 modele pe 142 de seturi, inclusiv unele împărțite în timp (prezicerea viitorului din trecut) și pe grupuri (prezicerea pentru un spital sau o țară nouă).
A constatat că modelele fundamentale pentru tabele sunt cele mai bune pe date IID mici și medii, în timp ce modelele pe arbori și alte modele deep learning conduc încă pe date ordonate în timp, grupate, mari și foarte late. Cum majoritatea datelor de business (vânzări, fraudă, churn) sunt ordonate în timp, această limitare apare în multe proiecte reale.
TabPFN-3.5, lansat după BeyondArena, susține în mod specific că închide acest decalaj pe date ordonate în timp și grupate. E promițător, dar nu a fost încă testat independent.
Poți obține valori SHAP atât din TabICL, cât și din TabPFN, dar durează mult mai mult decât SHAP pe un model pe arbori, și nu există tăieturi de arbore de inspectat. În domenii precum scorarea de credit, unde regulatorii trebuie să înțeleagă modelul, aceasta e o problemă reală.
Orice peste câteva mii de rânduri chiar cere un GPU, iar predicțiile încetinesc pe măsură ce datele de antrenare cresc. Un model XGBoost antrenat pe CPU va câștiga mereu la viteză.
TabPFN-2 e comercial cu atribuire, versiunile mai noi TabPFN sunt necomerciale, greutățile TabFM sunt necomerciale, iar TabICLv2 e permisiv.
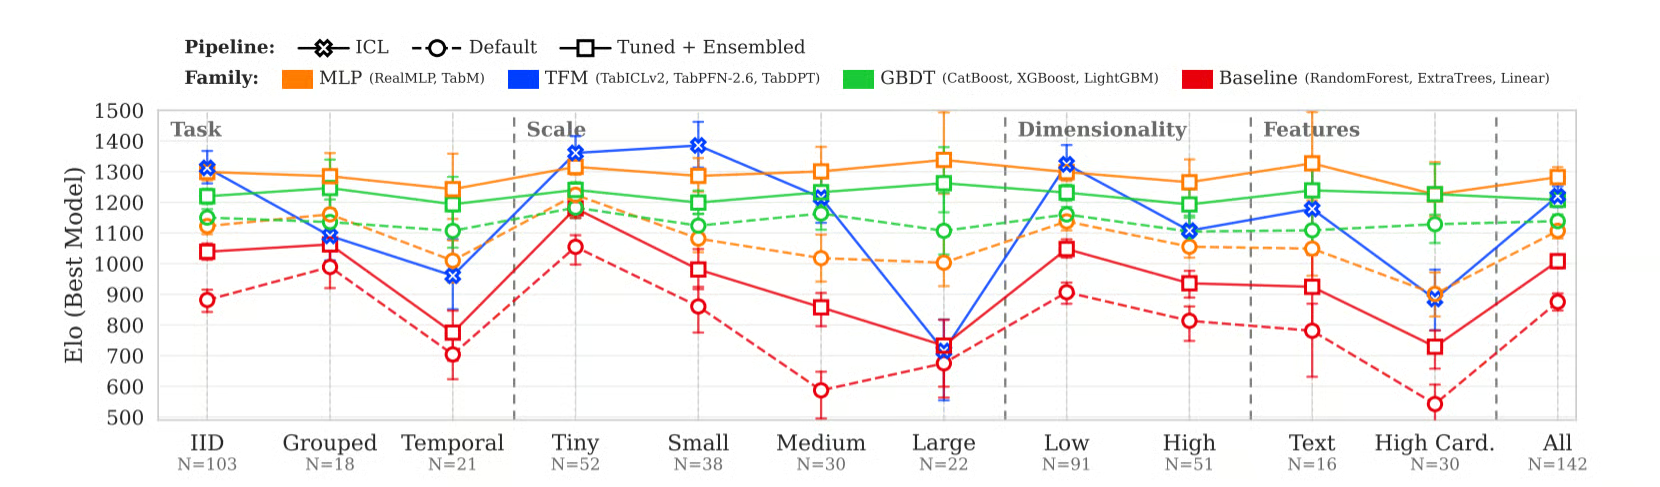
Figura 3: Elo pe familie de modele (mai mare e mai bine). Modelele fundamentale pentru tabele conduc pe date IID mici, dar scad pe seturi temporale și mari, unde arborii și MLP-urile rezistă mai bine. Albastru reprezintă cel mai bun dintre TabICLv2, TabPFN-2.6 și TabDPT, nu cele mai noi versiuni TabPFN. Sursa: Purucker et al., „Beyond IID: How General Are Tabular Foundation Models, Really?” (2026), CC BY 4.0.
Sper că ești de acord că modelele fundamentale pentru tabele au ridicat ștacheta pentru cât de bun poate fi un baseline rapid, fără efort, dar modelele pe arbori rămân alegerea mai bună în multe situații reale.
Ar trebui să folosești un model fundamental pentru tabele când setul tău de date este mic spre mediu și IID și nu ai nevoie de un model complet explicabil sau de predicții foarte rapide pe CPU. Iată tabelul de decizie pe care l-aș folosi:
| Scenariu | Abordare recomandată |
|---|---|
| Sub 10K rânduri, IID, fără nevoi de explicabilitate | Începe cu TabICLv2 sau TabPFN |
| 10K până la 100K rânduri, IID | Testează TabICLv2 și XGBoost, păstrează câștigătorul |
| 100K până la 1M rânduri | Începe cu XGBoost sau LightGBM, încearcă TabPFN-3 ca pretendent |
| Date împărțite pe timp sau pe grup | Începe cu modele pe arbori |
| Ai nevoie de SHAP, importanța caracteristicilor sau audit | Model pe arbori cu SHAP |
| Predicții rapide fără GPU | Model pe arbori |
| Proof of concept rapid, fără setup ML | TabICLv2 sau BigQuery AI.PREDICT dacă datele sunt deja acolo |
| Agent AI care are nevoie de predicții din tabele | Un API precum tabH2O sau NEXUS |
Înainte de a alege un model, ți-aș recomanda să pui aceste trei întrebări:
Și ultimul punct pe care aș vrea să-l subliniez e acesta. Rulează mai întâi un model fundamental pentru tabele, pentru că te costă doar câteva minute. Dacă nu poate bate XGBoost pe datele tale, știi acum că merită să investești timp în inginerie de caracteristici și reglarea XGBoost.
Îți amintești cei doi studenți de la început? În 2026, al doilea student, cel care a exersat pe milioane de examene, îl poate în sfârșit întrece pe cel care a studiat săptămâni întregi, cel puțin pe tabele mici și medii.
Modelele fundamentale pentru tabele înlocuiesc antrenarea per set de date cu preantrenare și înlocuiesc fit() cu învățarea din exemple.
Ceea ce mă surprinde cel mai mult este cât de repede a evoluat acest domeniu. TabPFN-2 a arătat în 2025 pentru prima dată că o rețea neuronală poate bate arbori reglați pe tabele mici, iar TabICLv2 și TabPFN-3 au extins de atunci asta la unele mult mai mari.
Problemele deschise acum sunt datele ordonate în timp, datele care se schimbă, explicabilitatea și licențierea, exact lucrurile care decid dacă un model ajunge într-un produs real.
Așa că sfatul meu este să tratezi aceste modele ca pe noul tău punct de plecare și să alegi instrumentul final în funcție de datele tale, constrângerile tale și unde va rula modelul.
Iar dacă vrei să stăpânești modelele pe arbori care încă înving în multe situații reale, aruncă o privire la cursul nostru Machine Learning cu modele pe arbori în Python și la track-ul Supervised Machine Learning in Python. Dacă lucrezi în R, Machine Learning cu modele pe arbori în R acoperă același conținut.
Top cursuri DataCamp
Traseu de învățare
Curs
Traseu de învățare