Lärstig
Utveckla stora språkmodeller
16 tim
Föreställ dig två studenter som skriver samma prov. Den första studenten pluggar i tre veckor men bara på en kursmodul, medan den andra redan har övat på miljontals olika prov och bara får ett blad med genomgångna exempel på provdagen.
Under större delen av maskininlärningens historia har tabulära modeller varit den första studenten. Varje nytt dataset innebar att rensa kolumner, konstruera features, träna XGBoost eller LightGBM och finjustera hyperparametrar i timmar.
Tabulära grundmodeller är däremot den andra studenten: du ger dem dina märkta rader som exempel, och de förutspår resten med ingen träning alls.
År 2026 gick den här idén från forskningsartiklar till riktiga produkter, med SAP som satsade mer än €1 miljard på Prior Labs och Google som släppte sin egen modell. I den här artikeln tittar vi därför på:
Oroa dig inte om du inte har mycket erfarenhet av deep learning. Koden i den här artikeln använder det bekanta scikit-learn-gränssnittet, och om du vill ha en snabb uppfräschning först täcker 8 Machine Learning Models Explained in 20 Minutes grunderna.
pip install tabicl.En tabulär grundmodell är ett neuralt nätverk som förtränats på miljontals syntetiska tabulära dataset och lär sig en allmän strategi för att förutsäga en målkolumn, och sedan tillämpar den strategin på en ny tabell genom in-context learning, utan någon träning per dataset.
Den stora förändringen här är när inlärningen sker.
Med XGBoost sker inlärningen på din data varje gång du tränar en ny modell. Med en tabulär grundmodell skedde inlärningen för månader sedan under förträningen, och din data är helt enkelt indatan. Det finns också några termer du kommer att se ofta, så låt mig förklara dem på enkel svenska:
Låt oss nu prata om hur tabulära grundmodeller jämförs med boosting-metoder och automatiserad maskininlärning (AutoML):
| Tabulära grundmodeller | Gradientboostade träd (XGBoost, LightGBM) | AutoML (AutoGluon, H2O AutoML) | |
|---|---|---|---|
| Träningstid på ny data | Ingen | Sekunder till minuter, plus tuning | Minuter till timmar |
| Tolkbarhet | Begränsad (SHAP är möjligt men långsamt) | God (feature importance, snabb SHAP) | Varierar, ofta svårtolkade ensembler |
| Bästa datasetstorlek | Hundratals till cirka 100K rader | Tusentals till många miljoner rader | Tusentals till miljoner rader |
| Behövs GPU? | Rekommenderas över några tusen rader | Nej | Vanligtvis nej |
| Små, slumpmässigt splitade dataset | Bäst på nuvarande benchmarktester | Starka när de är tunade | Starka men långsamma |
Innan vi tittar på hur de fungerar vill jag snabbt jämföra dem med de mest kända, mest använda modellerna: stora språkmodeller.
Stora språkmodeller (LLM) och tabulära grundmodeller använder båda transformers, och båda lär sig av exempel i sin indata.
Skillnaden är vad de är byggda för att läsa. En LLM läser en tabell som en lång textsträng, vilket betyder att den måste lista ut från kommatecken och blanksteg vilka siffror som hör till samma kolumn.
Det finns också ett betydelseproblem.
Värdet 42 kan vara någons ålder eller en intäktspost, men inget i talet i sig berättar vilket. En tabulär grundmodell tränas att behandla varje kolumn som sin egen variabel och varje rad som ett exempel, så den fokuserar på hur kolumnerna förhåller sig till varandra.
Jag tänker så här: en LLM är bra på att prata om din data, medan en tabulär grundmodell är byggd för att göra matematiken på den.
De kan också arbeta tillsammans, vilket är precis hur H2O.ai positionerar sin tabH2O-modell: som prediktionsverktyget en AI-agent anropar när den behöver ett tal från ett kalkylblad.
Tabulär data var svårt för deep learning eftersom tabeller saknar den gemensamma struktur som ett neuralt nätverk kan lära sig en gång och återanvända. En pixel är en pixel i varje foto. En kolumn som heter score i ett finansdataset och en kolumn som heter score i ett fotbollsdataset har inget gemensamt.
En välkänd artikel från 2022 av Léo Grinsztajn, Edouard Oyallon och Gaël Varoquaux, Why do tree-based models still outperform deep learning on tabular data?, testade detta på 45 dataset och fann att trädmodeller, särskilt gradient boosting, fortfarande slog deep learning på medelstora tabeller runt 10 000 rader. Skälen de fann är:
Två mer praktiska problem förvärrar detta. En enda tabell kan blanda tal, kategorier, rangordningar och saknade värden, och de flesta affärstabeller har bara hundra- eller tusentals rader, vilket är alldeles för lite för ett neuralt nätverk tränat från grunden.
Jag skulle säga att små dataset är det viktigaste problemet. Ett neuralt nätverk som tränas från noll på 800 rader har inget att falla tillbaka på, medan ett träd inte behöver någon förkunskap för att fungera.
Det var precis detta som förträningen löste. En tabulär grundmodell har redan övat på miljontals små, röriga, påhittade tabeller innan den någonsin ser din, så den börjar inte från noll.
En tabulär grundmodell tar dina märkta träningsrader och dina omärkta testrader tillsammans som en indata och förutspår de saknade etiketterna i ett enda forward-pass. Vikterna ändras aldrig, precis som när en LLM svarar på en fråga efter att du gett några exempel i prompten.
Detta förändrar också vad de bekanta scikit-learn-metoderna betyder.
När du anropar .fit() på TabICL förklarar TabICL-dokumentationen att den laddar den förtränade checkpointen, förbehandlar din data och lagrar den. Det verkliga arbetet sker under .predict().
Namnet .fit() finns kvar så att modellen passar in i din befintliga scikit-learn-kod.
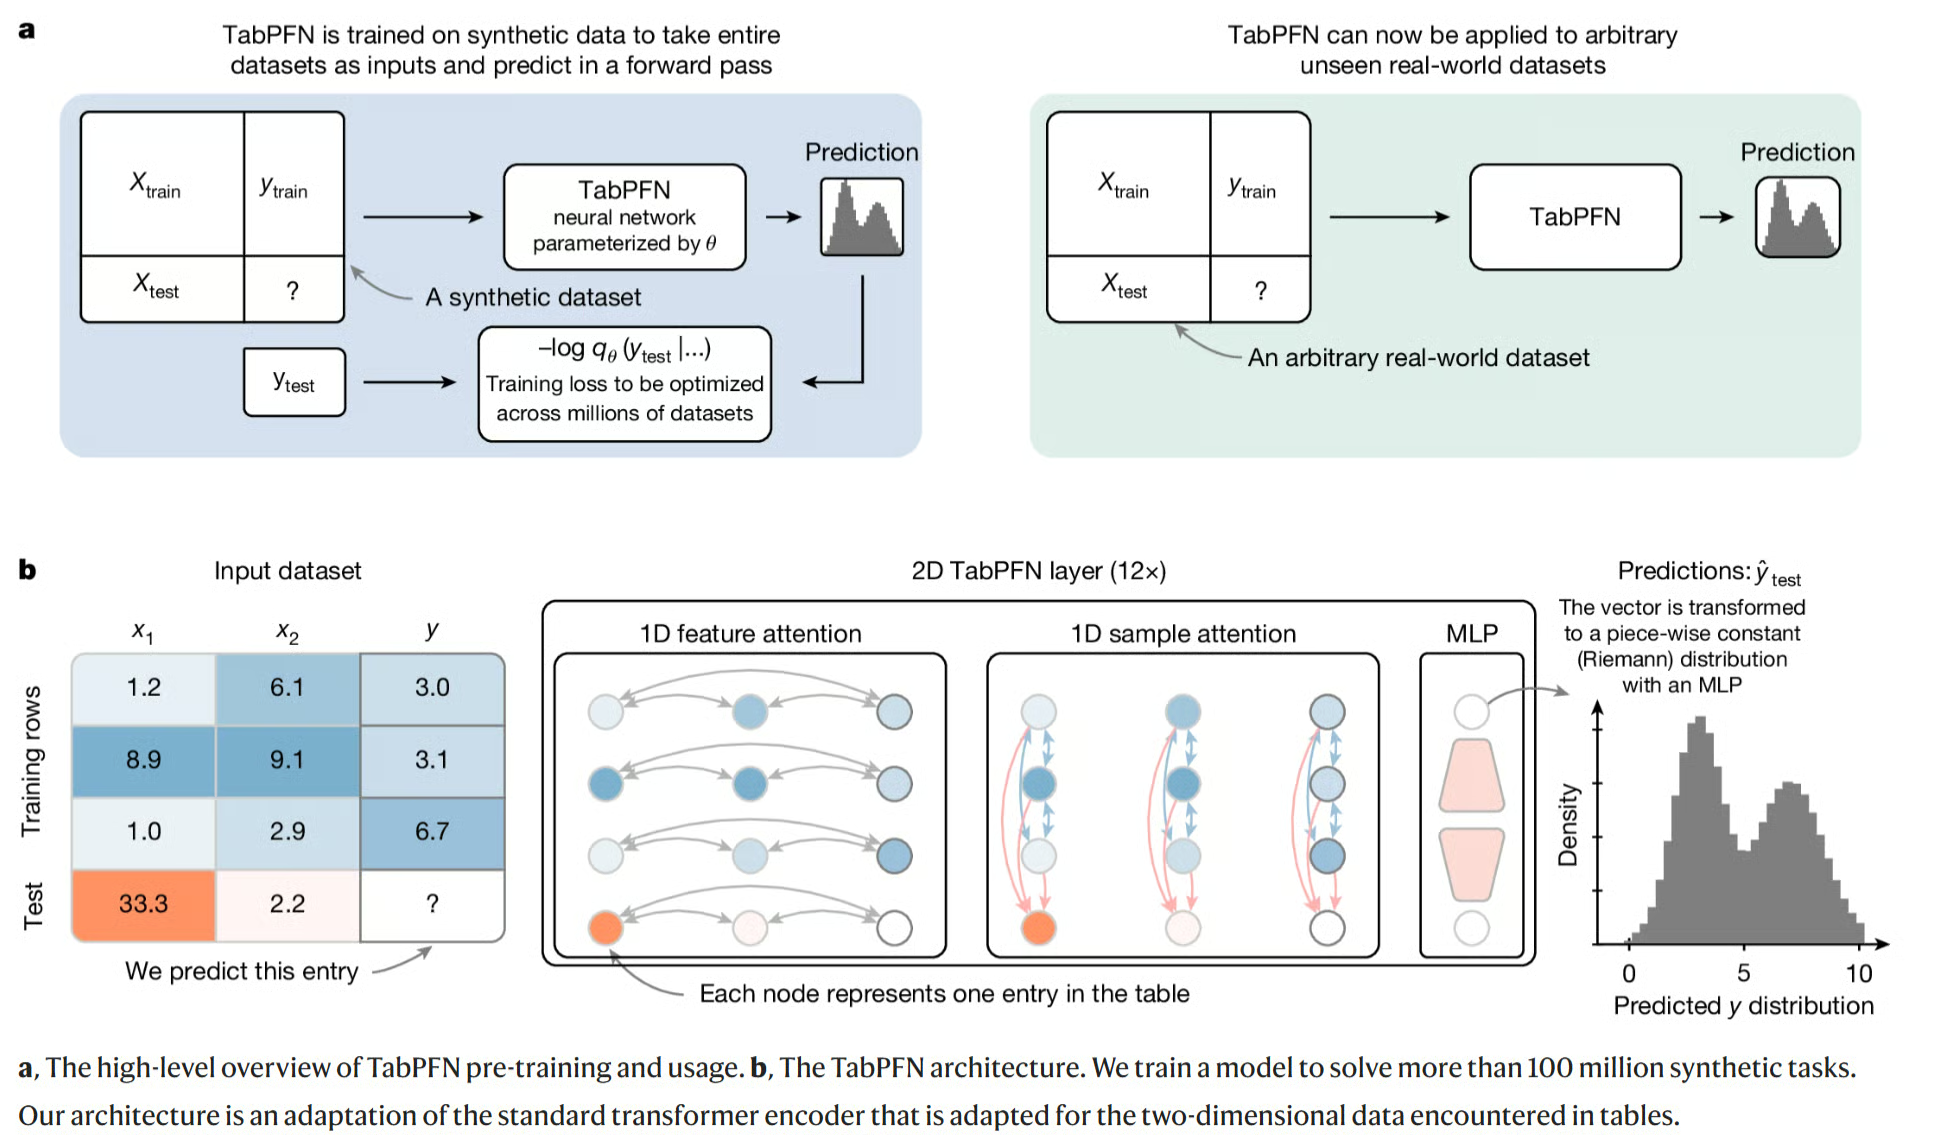
Figur 1: TabPFN förtränas på miljontals syntetiska dataset och förutspår sedan på en riktig tabell i ett forward-pass. Den undre panelen visar hur den uppmärksammar över features och exempel. Källa: Hollmann m.fl., ”Accurate predictions on small data with a tabular foundation model”, Nature (2025).
Syntetisk förträning innebär att träna modellen på påhittade tabeller i stället för riktiga, framtagna av en datagenerator som fungerar som en generativ modell.
Tänk på en pilot som tränar i en flygsimulator. Piloten övar tusentals fejkade flygningar med olika väder, flygplatser och fel, så att den första riktiga flygningen inte känns ny.
TabPFN fungerar på liknande sätt.
Skaparna skrev en generator som hittar på slumpmässiga ”orsak och verkan”-regler mellan kolumner (till exempel påverkar kolumn A kolumn B, som påverkar målet), och producerar sedan rader utifrån dessa regler.
Under förträningen döljs målkolumnen, modellen försöker förutsäga den, och detta upprepas miljontals gånger med olika regler, brusnivåer och tabellstorlekar.
Det viktiga är att modellen aldrig lär sig fakta om något verkligt ämne. Den lär sig allmänna färdigheter som att upptäcka vilka kolumner som spelar roll, hantera avvikare och veta när den ska vara osäker.
Faktum är att TabICLv2-artikeln anger sin nya syntetiska datagenerator som en nyckelorsak till den bättre prestandan.
Du behöver inte förstå varje detalj i arkitekturerna, men det hjälper att veta att det finns två huvudupplägg:
Observera att båda familjerna tränas på syntetisk data, så ”prior-fitted network” beskriver hur de tränas snarare än en separat typ av modell.
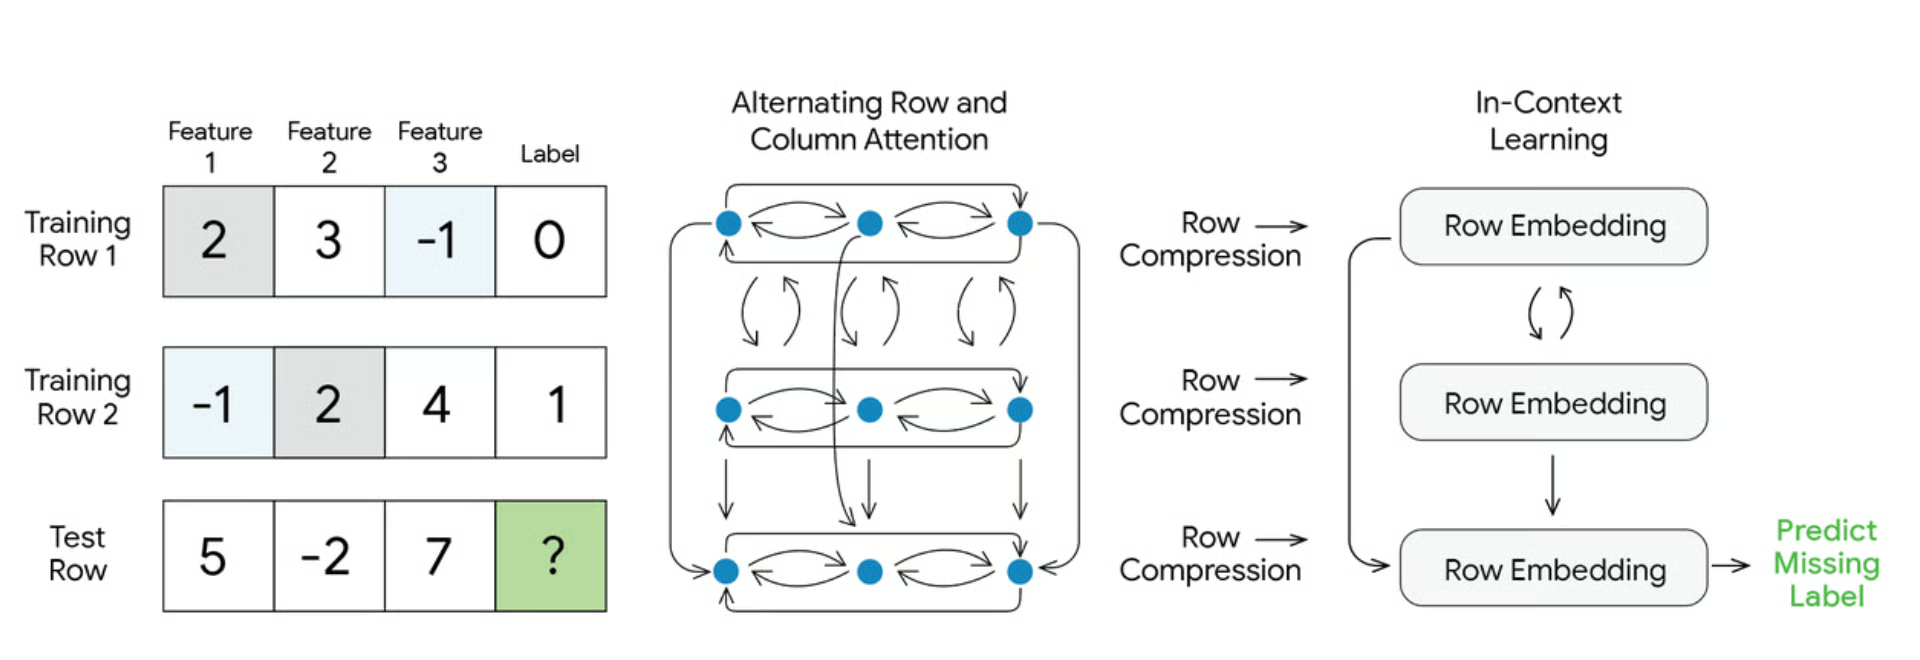
Figur 2: TabFM blandar båda designerna: TabPFN-lik attention över rader och kolumner, sedan TabICL-lik radsummering, och därefter in-context learning för den saknade etiketten. Källa: Google Research, ”Introducing TabFM: A zero-shot foundation model for tabular data” (2026).
Det finns en trade-off här som överraskar många.
XGBoost lägger tid på att träna en gång och förutspår sedan nästan omedelbart.
En tabulär grundmodell hoppar över träningen, men måste läsa alla dina träningsrader varje gång den förutspår.
Tänk på en kock som inte gör något förarbete före service men måste läsa om hela receptboken för varje beställning.
För en liten bok är det okej, men när ditt dataset växer blir förutsägelserna långsammare. Både TabICL och TabPFN kan cacha sin ”läsning” av träningsdatan för att snabba upp upprepade förutsägelser, men första passet kostar ändå tid.
De viktigaste tabulära grundmodellerna 2026 är TabPFN, TabICLv2, Googles TabFM, Fundamentals NEXUS och H2O.ai:s tabH2O. Det jag tycker är intressant är hur snabbt affärssidan rörde sig: fem månader tog det här området från akademiska artiklar till stora affärer. Här är en kort tidslinje:
Låt oss nu gå igenom var och en, med start i modellen som startade allt.
TabPFN är modellen som skapade den här kategorin. TabPFN-2 publicerades i Nature i januari 2025 och slog tunade trädmodeller på dataset upp till 10 000 rader.
Sedan dess har Prior Labs släppt nya versioner snabbt. TabPFN-3 kom i maj 2026 och hanterar upp till 1 miljon rader (och upp till 200 features). Den lade också till ett Thinking-läge (via sitt betalda API) som lägger extra tid i fit-steget för att ge bättre förutsägelser.
Den senaste versionen, TabPFN-3.5, kom i september 2026, och dess tekniska rapport gör anspråk på förstaplatsen på flera större benchmarktester, inklusive på tidsordnad och grupperad data. Jag skulle behandla dessa som företagets egna siffror tills andra bekräftar dem.
En sak till är licensen. TabPFN-2 kan användas kommersiellt så länge du krediterar Prior Labs, men versionerna 2.5 till 3.5 är icke-kommersiella. Det betyder att du kan experimentera med dem gratis, men att använda dem i en riktig produkt kräver en betald licens.
TabICLv2 är den bästa helt öppna tabulära grundmodellen just nu. Den byggdes på Inria, släpptes i februari 2026 och accepterades på ICML 2026.
Huvudresultatet från TabICLv2-artikeln är att den, utan någon tuning, slog RealTabPFN-2.5, den tidigare bästa modellen, trots att den modellen hade tunats, ensembles och finjusterats på riktig data.
Enligt dess GitHub-repo slår den också hårt tunade XGBoost, CatBoost och LightGBM på omkring 80% av datamängderna i TabArena-benchmarken.
Den är också snabb och hanterar 50 000 rader med 100 features på under 10 sekunder på ett H100-GPU, vilket är cirka 10 gånger snabbare än TabPFN-2.5.
Den fungerar bäst mellan 300 och 100 000 rader och kan sträckas till runt 500 000 rader med viss förlust i noggrannhet.
Enligt min mening är detta den de flesta läsare bör börja med.
Du installerar den med pip install tabicl, den fungerar som vilken scikit-learn-modell som helst, och dess tillåtande licens låter dig använda den kommersiellt utan att registrera dig för något. Topplistan ändras snabbt, och TabPFN-3.5:s rapport rankar nu sig själv före TabICLv2.
TabFM är Google Researchs tabulära grundmodell, släppt den 30 juni 2026. Det som gör den annorlunda är var du kan använda den: den är inbyggd i BigQuery, Googles molndatalager, så du kan få förutsägelser med vanlig SQL.
-- Use past customers (with known churn) to predict churn for new customers
-- AI.PREDICT is in preview, so check the BigQuery docs for the latest syntax
SELECT *
FROM AI.PREDICT(
  TABLE my_dataset.customers_history,
  TABLE my_dataset.customers_new,
  label_col => 'churned'
);
Detta är perfekt för dig som kan SQL men inte Python.
Dock begränsar BigQuery-dokumentationen dig för närvarande till 20 feature-kolumner och 10 klasser, och Google planerar att lägga till token-baserad prissättning ovanpå standardavgifter för BigQuery från den 30 oktober 2026. Modellvikterna på Hugging Face är icke-kommersiella, så kommersiell användning går via BigQuery.
NEXUS är en sluten, företagsinriktad modell från Fundamental, ett San Francisco-bolag grundat av tidigare DeepMind-forskare. Den lanserades i februari 2026 med 255 miljoner dollar i finansiering, och företaget kallar den en Large Tabular Model (LTM).
Företag köper och kör NEXUS via AWS, och Fundamental säger att Fortune 100-bolag redan använder den för efterfrågeprognoser, prissättning och kundbortfall. Det finns dock inga offentliga vikter eller benchmarkresultat du kan kontrollera själv, så jag skulle betrakta den som ett alternativ för enterprise.
tabH2O är H2O.ai:s modell, och hela idén är enkel: skicka din data, få förutsägelser tillbaka.
Den städar upp saknade värden och kategorier åt dig och kan köras på ett företags egna servrar, vilket är viktigt för banker och sjukhus som inte kan skicka data till molnet.
Det jag gillar är att tabH2O-artikeln inte översäljer den. Den slog tunade CatBoost och LightGBM på TALENT-benchmarken, men låg fortfarande bakom TabICLv2.
| Modell | Skapare | Öppna vikter? | Max skala | Licens | Bäst för |
|---|---|---|---|---|---|
| TabPFN-2 | Prior Labs | Ja | 10K rader | Kommersiell med attribuering | Kommersiell användning av en beprövad äldre modell |
| TabPFN-3 / 3.5 | Prior Labs (SAP) | Ja, efter att ha accepterat en licens | Upp till 1M rader | Icke-kommersiell, betalt API för företag | Högsta noggrannhet och forskning |
| TabICLv2 | Inria | Ja | Bäst upp till 100K rader | Tillåtande öppen källkod | Din standardstartpunkt |
| TabFM | Google Research | Ja | 20 features i BigQuery | Icke-kommersiella vikter | SQL-användare på BigQuery |
| NEXUS | Fundamental | Nej | Ej offentliggjort | Proprietär | Stora företag på AWS |
| tabH2O | H2O.ai | Nej | Ej offentliggjort | Kommersiellt API | Team utan ML-setup, AI-agenter |
Du använder en tabulär grundmodell i Python precis som vilken annan scikit-learn-modell som helst.
Det bästa sättet att se vad den erbjuder är att ställa den mot XGBoost, så låt oss göra det på scikit-learns inbyggda bröstcancerdataset.
Först installerar vi paketen:
pip install tabicl xgboost scikit-learnSedan kör vi båda modellerna på samma split:
from sklearn.datasets import load_breast_cancer
from sklearn.metrics import accuracy_score
from sklearn.model_selection import train_test_split
from tabicl import TabICLClassifier
from xgboost import XGBClassifier

# Load a small tabular dataset as a pandas DataFrame
X, y = load_breast_cancer(return_X_y=True, as_frame=True)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, stratify=y, random_state=42
)

# Tabular foundation model: fit() just stores the training rows
tfm = TabICLClassifier()
tfm.fit(X_train, y_train)
tfm_preds = tfm.predict(X_test)

# XGBoost baseline with reasonable, untuned settings
xgb = XGBClassifier(n_estimators=300, learning_rate=0.05, max_depth=4)
xgb.fit(X_train, y_train)
xgb_preds = xgb.predict(X_test)

print(f"TabICL accuracy:  {accuracy_score(y_test, tfm_preds):.3f}")
print(f"XGBoost accuracy: {accuracy_score(y_test, xgb_preds):.3f}")
Detta lilla dataset körs fint på en vanlig laptop-CPU.
Båda modellerna kommer att få mycket höga poäng på något så här rent, så döm dem inte på en enda split. Det riktiga testet blir din egen röriga data.
Om du vill prova TabPFN i stället, kör pip install tabpfn, och sedan är det bara två rader som ändras:
from tabpfn import TabPFNClassifier

tfm = TabPFNClassifier()  # The first run asks you to accept the license
tfm.fit(X_train, y_train)
tfm_preds = tfm.predict(X_test)
En viktig sak innan du jämför modeller på riktig data.
Om din data har datum, splitta den över tid i stället för slumpmässigt. Annars får modellen tjuvkika på framtiden, och som du kommer att se i nästa avsnitt är det precis där tabulära grundmodeller ser bättre ut än de egentligen är.
Tabulära grundmodeller fungerar bra när ditt dataset är litet till medelstort och testraderna liknar träningsraderna. De har det svårt med tidsordnad data, grupperad data, mycket stora tabeller och strikta förklaringskrav.
Att ”testraderna liknar träningsraderna” har ett namn, IID (oberoende och identiskt fördelade), och det är den enskilt viktigaste saken att kontrollera i din data.
Låt oss börja med var de fungerar bra:
Nu till begränsningarna, som jag tycker är viktigare om du planerar att använda dessa i ett riktigt projekt.
BeyondArena-benchmarken, släppt i juni 2026, testade 11 modeller på 142 dataset, inklusive sådana som delades upp över tid (förutsäga framtiden från det förflutna) och per grupp (förutsäga för ett nytt sjukhus eller land).
Den fann att tabulära grundmodeller presterar bäst på små och medelstora IID-data, medan träd- och andra deep learning-modeller fortfarande leder på tidsordnad, grupperad, stor och mycket bred data. Eftersom de flesta affärsdata (försäljning, bedrägeri, churn) är tidsordnade syns den här begränsningen i de flesta verkliga projekt.
TabPFN-3.5, släppt efter BeyondArena, hävdar specifikt att den stänger gapet på tidsordnad och grupperad data. Det är lovande, men har ännu inte testats oberoende.
Du kan få SHAP-värden från både TabICL och TabPFN, men det tar mycket längre tid än SHAP på en trädmodell, och det finns inga träddelningar att inspektera. Inom områden som kreditbedömning, där tillsynsmyndigheter måste förstå modellen, är detta ett reellt problem.
Allt över några tusen rader vill egentligen ha en GPU, och förutsägelser blir långsammare ju mer din träningsdata växer. En tränad XGBoost-modell på en CPU vinner alltid på hastighet.
TabPFN-2 är kommersiell med kreditering, nyare TabPFN-versioner är icke-kommersiella, TabFM-vikter är icke-kommersiella och TabICLv2 är tillåtande.
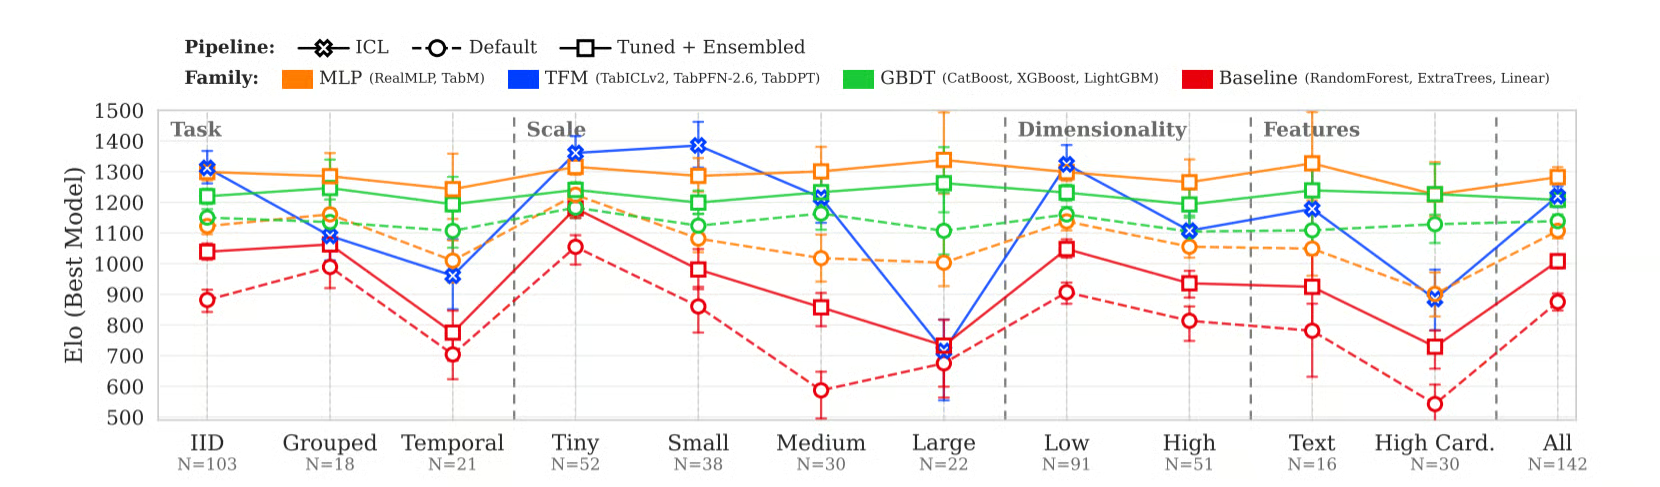
Figur 3: Elo per modellfamilj (högre är bättre). Tabulära grundmodeller leder på små IID-data men tappar på temporala och stora dataset, där träd och MLP:er står sig bättre. Blått är det bästa av TabICLv2, TabPFN-2.6 och TabDPT, inte de nyaste TabPFN-versionerna. Källa: Purucker m.fl., ”Beyond IID: How General Are Tabular Foundation Models, Really?” (2026), CC BY 4.0.
Förhoppningsvis håller du med om att tabulära grundmodeller har höjt ribban för hur bra en snabb, ansträngningsfri baslinje kan vara, men trädmodeller är fortfarande det bättre valet i många verkliga situationer.
Du bör använda en tabulär grundmodell när ditt dataset är litet till medelstort och IID, och du inte behöver en fullt förklarbar modell eller mycket snabba förutsägelser på en CPU. Här är beslutstabellen jag skulle använda:
| Scenario | Rekommenderat tillvägagångssätt |
|---|---|
| Under 10K rader, IID, inga förklaringskrav | Börja med TabICLv2 eller TabPFN |
| 10K till 100K rader, IID | Testa TabICLv2 och XGBoost, behåll vinnaren |
| 100K till 1M rader | Börja med XGBoost eller LightGBM, prova TabPFN-3 som utmanare |
| Data splittad över tid eller per grupp | Börja med trädmodeller |
| Behöver SHAP, feature-importance eller granskning | Trädmodell med SHAP |
| Snabba förutsägelser utan GPU | Trädmodell |
| Snabbt proof of concept, ingen ML-setup | TabICLv2, eller BigQuery AI.PREDICT om din data redan finns där |
| AI-agent som behöver förutsägelser från tabeller | Ett API som tabH2O eller NEXUS |
Innan du väljer modell skulle jag rekommendera att ställa dessa tre frågor:
Och den sista poängen jag vill göra är denna. Kör en tabulär grundmodell först, eftersom det bara kostar dig några minuter. Om den inte kan slå XGBoost på din data vet du nu att det är värt att lägga tid på feature engineering och tuning av XGBoost.
Kommer du ihåg de två studenterna från början av artikeln? År 2026 kan den andra studenten, den som övade på miljontals prov, äntligen slå den som pluggade i veckor, åtminstone på små och medelstora tabeller.
Tabulära grundmodeller ersätter träning per dataset med förträning och ersätter fit() med att lära av exempel.
Det som förvånar mig mest är hur snabbt detta område har förbättrats. TabPFN-2 visade först 2025 att ett neuralt nätverk kunde slå tunade träd på små tabeller, och TabICLv2 och TabPFN-3 har sedan dess tryckt det till mycket större.
De öppna problemen nu är tidsordnad data, föränderliga data, förklarbarhet och licensiering, vilket är precis de saker som avgör om en modell tar sig in i en riktig produkt.
Så mitt råd är att behandla dessa modeller som din nya startpunkt och välja det slutliga verktyget baserat på din data, dina begränsningar och var modellen ska köras.
Och om du vill bemästra trädmodellerna som fortfarande vinner i många verkliga situationer, kolla in vår kurs Machine Learning with Tree-Based Models in Python och utbildningsspåret Supervised Machine Learning in Python. Om du arbetar i R täcker Machine Learning with Tree-Based Models in R samma område.
Toppkurser på DataCamp
Lärstig
Kurs
Lärstig