Program
Pengembangan Model Bahasa Besar
16 jam
Bayangkan dua siswa mengerjakan ujian yang sama. Siswa pertama menghabiskan tiga minggu belajar hanya satu modul, sementara siswa kedua sudah berlatih pada jutaan ujian berbeda dan pada hari-H hanya mendapatkan lembar contoh soal yang sudah dikerjakan.
Selama sebagian besar masa machine learning, model tabular seperti siswa pertama. Setiap dataset baru berarti membersihkan kolom, merekayasa fitur, melatih XGBoost atau LightGBM, dan menyetel hiperparameter selama berjam-jam.
Model fondasi tabular adalah siswa kedua: Anda memberikan baris berlabel sebagai contoh, dan mereka memprediksi sisanya dengan tanpa pelatihan sama sekali.
Pada 2026, gagasan ini beralih dari makalah riset ke produk nyata, dengan SAP mengalokasikan lebih dari €1 miliar ke Prior Labs dan Google merilis modelnya sendiri. Jadi dalam artikel ini, kita akan melihat:
Jangan khawatir jika Anda belum banyak berpengalaman dengan deep learning. Kode dalam artikel ini menggunakan antarmuka scikit-learn yang familier, dan jika Anda ingin penyegaran singkat terlebih dahulu, 8 Model Machine Learning Dijelaskan dalam 20 Menit membahas dasar-dasarnya.
pip install tabicl.Model fondasi tabular adalah jaringan saraf yang dipra-latih pada jutaan dataset tabular sintetis untuk mempelajari strategi umum dalam memprediksi kolom target, lalu menerapkan strategi itu pada tabel baru melalui in-context learning, tanpa pelatihan per dataset.
Perubahan besar di sini adalah kapan pembelajaran terjadi.
Dengan XGBoost, pembelajaran terjadi pada data Anda setiap kali Anda melatih model baru. Dengan model fondasi tabular, pembelajaran terjadi berbulan-bulan lalu saat pra-pelatihan, dan data Anda hanyalah input. Anda juga akan sering menemui beberapa istilah berikut, jadi mari saya jelaskan dengan bahasa sederhana:
Sekarang, mari bandingkan bagaimana model fondasi tabular dengan metode boosting dan automated machine learning (AutoML):
| Model fondasi tabular | Pohon boosted gradien (XGBoost, LightGBM) | AutoML (AutoGluon, H2O AutoML) | |
|---|---|---|---|
| Waktu pelatihan pada data baru | Tidak ada | Detik hingga menit, plus penyetelan | Menit hingga jam |
| Keterjelasan | Terbatas (SHAP memungkinkan tapi lambat) | Baik (feature importance, SHAP cepat) | Bervariasi, sering berupa ensemble yang sulit dibaca |
| Ukuran dataset terbaik | Ratusan hingga sekitar 100K baris | Ribuan hingga banyak jutaan baris | Ribuan hingga jutaan baris |
| Perlu GPU? | Direkomendasikan di atas beberapa ribu baris | Tidak | Biasanya tidak |
| Dataset kecil dengan pembagian acak | Terbaik pada tolok ukur saat ini | Kuat saat disetel | Kuat namun lambat |
Sebelum kita membahas cara kerjanya, saya ingin membandingkannya cepat dengan model paling terkenal dan banyak digunakan: large language model.
Large language model (LLM) dan model fondasi tabular sama-sama menggunakan transformer, dan keduanya belajar dari contoh di inputnya.
Perbedaannya adalah apa yang mereka dirancang untuk dibaca. LLM membaca tabel sebagai string teks panjang, yang berarti ia harus menebak dari koma dan spasi angka mana yang termasuk ke kolom yang sama.
Ada juga masalah pemaknaan.
Nilai 42 bisa berarti usia seseorang atau angka pendapatan, tetapi tidak ada yang melekat pada angka itu sendiri yang memberi tahu Anda mana yang benar. Model fondasi tabular dilatih untuk memperlakukan setiap kolom sebagai variabel tersendiri dan setiap baris sebagai satu contoh, sehingga fokus pada bagaimana kolom-kolom saling berhubungan.
Saya suka memikirkannya begini: LLM sangat andal untuk “membicarakan” data Anda, sedangkan model fondasi tabular dibangun untuk “menghitungnya”.
Keduanya juga bisa bekerja bersama, persis seperti posisi model tabH2O dari H2O.ai: sebagai alat prediksi yang dipanggil agen AI saat membutuhkan angka dari spreadsheet.
Data tabular sulit bagi deep learning karena tabel tidak memiliki struktur bersama yang bisa dipelajari jaringan saraf sekali dan digunakan ulang. Sebuah piksel adalah piksel di setiap foto. Kolom bernama score dalam dataset finansial dan kolom bernama score dalam dataset sepak bola tidak memiliki kesamaan.
Makalah 2022 yang terkenal oleh Léo Grinsztajn, Edouard Oyallon, dan Gaël Varoquaux, Why do tree-based models still outperform deep learning on tabular data?, menguji ini pada 45 dataset dan menemukan bahwa model berbasis pohon, khususnya gradient boosting, masih mengungguli deep learning pada tabel berukuran menengah sekitar 10.000 baris. Alasan yang mereka temukan adalah:
Dua masalah praktis lain memperburuk keadaan. Satu tabel dapat mencampur angka, kategori, peringkat, dan nilai hilang, dan sebagian besar tabel bisnis hanya memiliki ratusan atau ribuan baris, yang terlalu sedikit untuk jaringan saraf yang dilatih dari nol.
Menurut saya, dataset kecil adalah masalah terpenting. Jaringan saraf yang dilatih dari nol pada 800 baris tidak punya pijakan, sedangkan pohon tidak memerlukan pengetahuan awal untuk bekerja.
Inilah yang diperbaiki oleh pra-pelatihan. Model fondasi tabular telah berlatih pada jutaan tabel kecil, berantakan, dan buatan sebelum melihat data Anda, jadi ia tidak mulai dari nol.
Model fondasi tabular mengambil baris pelatihan berlabel dan baris uji tidak berlabel Anda sebagai satu input dan memprediksi label yang hilang dalam satu forward pass. Bobotnya tidak pernah berubah, sama seperti LLM yang menjawab pertanyaan setelah Anda memberinya beberapa contoh di prompt.
Ini juga mengubah makna metode scikit-learn yang familier.
Saat Anda memanggil .fit() pada TabICL, dokumentasi TabICL menjelaskan bahwa ia memuat checkpoint pra-latih, melakukan praproses data Anda, dan menyimpannya. Pekerjaan sebenarnya terjadi saat .predict().
Nama .fit() dipertahankan agar model mudah dipasang ke dalam kode scikit-learn Anda yang sudah ada.
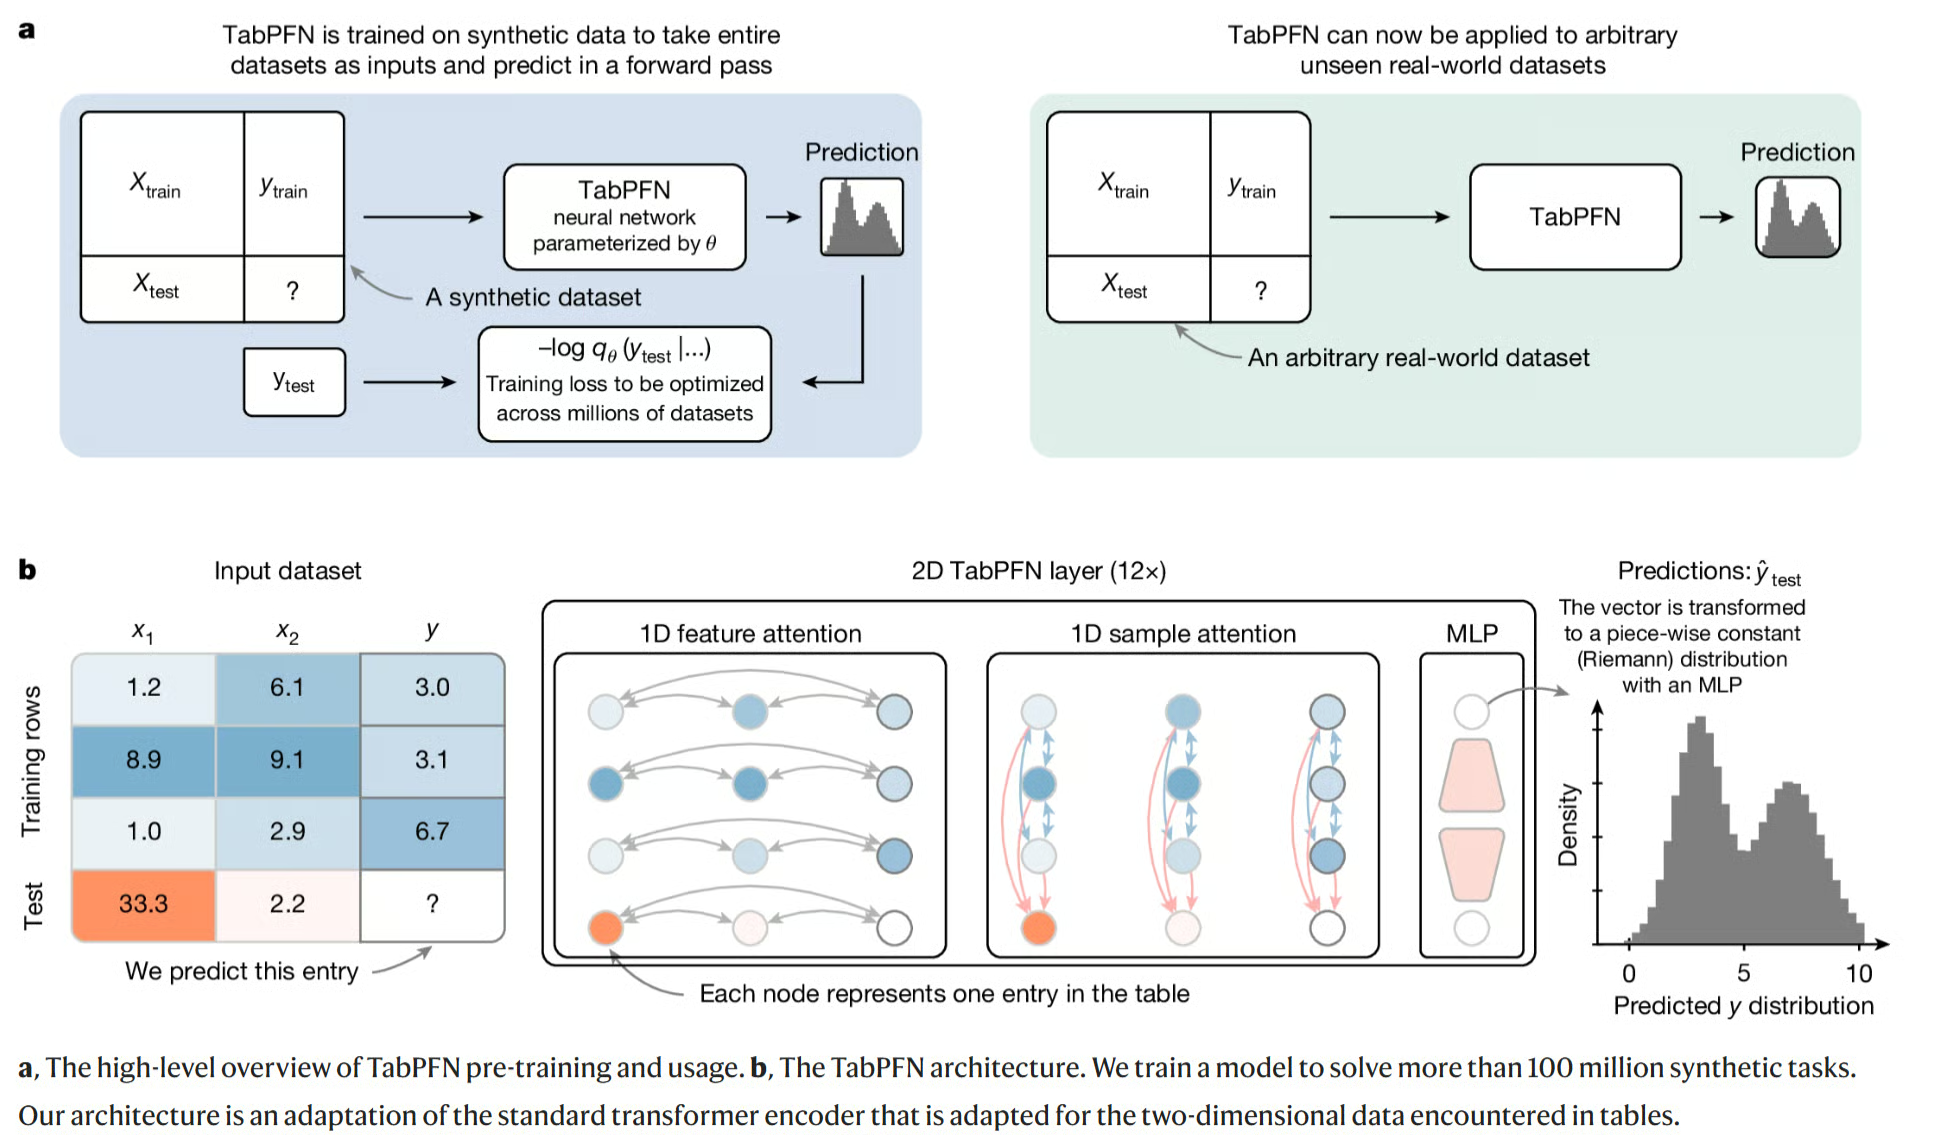
Gambar 1: TabPFN dipra-latih pada jutaan dataset sintetis, lalu memprediksi pada tabel nyata dalam satu forward pass. Panel bawah menunjukkan bagaimana ia melakukan atensi lintas fitur dan sampel. Sumber: Hollmann dkk., “Accurate predictions on small data with a tabular foundation model”, Nature (2025).
Pra-pelatihan sintetis berarti melatih model pada tabel buatan, yang dihasilkan oleh generator data yang bekerja seperti model generatif.
Pikirkan seorang pilot yang berlatih di simulator penerbangan. Pilot itu berlatih ribuan penerbangan palsu dengan cuaca, bandara, dan gangguan yang berbeda, sehingga penerbangan nyata pertamanya tidak terasa asing.
TabPFN bekerja dengan cara serupa.
Penciptanya menulis generator yang menciptakan aturan “sebab-akibat” acak antar kolom (misalnya, kolom A memengaruhi kolom B, yang memengaruhi target), lalu menghasilkan baris dari aturan tersebut.
Selama pra-pelatihan, kolom target disembunyikan, model mencoba memprediksinya, dan ini berulang jutaan kali dengan aturan, tingkat kebisingan, dan ukuran tabel yang berbeda.
Hal pentingnya adalah model tidak pernah mempelajari fakta tentang topik nyata apa pun. Ia mempelajari keterampilan umum seperti mengenali kolom mana yang penting, menangani outlier, dan tahu kapan harus ragu.
Faktanya, makalah TabICLv2 menyebut generator data sintetis barunya sebagai alasan kunci kinerja yang lebih baik.
Anda tidak perlu memahami setiap detail arsitektur, namun membantu untuk mengetahui ada dua desain utama:
Perlu dicatat bahwa keduanya dilatih pada data sintetis, jadi “prior-fitted network” menggambarkan bagaimana mereka dilatih, bukan tipe model yang terpisah.
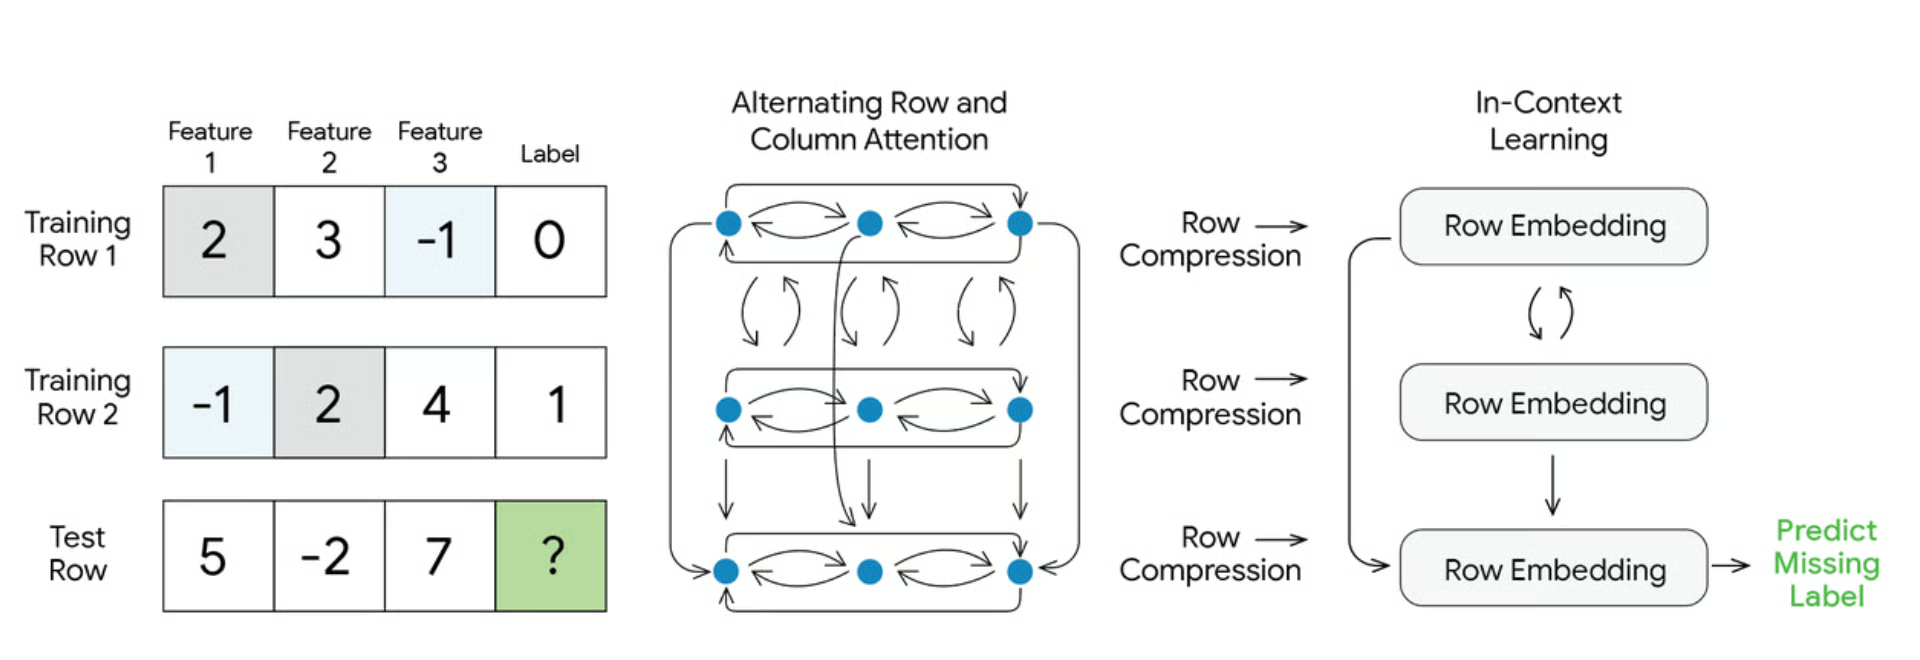
Gambar 2: TabFM memadukan kedua desain: atensi gaya TabPFN pada baris dan kolom, lalu kompresi baris ala TabICL, lalu in-context learning untuk label yang hilang. Sumber: Google Research, “Introducing TabFM: A zero-shot foundation model for tabular data” (2026).
Ada trade-off yang sering menjebak banyak orang.
XGBoost menghabiskan waktu untuk pelatihan sekali, lalu memprediksi hampir seketika.
Model fondasi tabular melewati pelatihan, tetapi harus membaca seluruh baris pelatihan Anda setiap kali melakukan prediksi.
Pikirkan seorang koki yang tidak melakukan persiapan sebelum layanan, tetapi harus membaca ulang seluruh buku resep untuk setiap pesanan.
Untuk buku yang tipis, itu tidak masalah, tetapi saat dataset Anda tumbuh, prediksi menjadi lebih lambat. Baik TabICL maupun TabPFN dapat melakukan cache “pembacaan” data pelatihan untuk mempercepat prediksi berulang, namun lintasan pertama tetap memakan waktu.
Model fondasi tabular kunci pada 2026 adalah TabPFN, TabICLv2, TabFM dari Google, NEXUS dari Fundamental, dan tabH2O dari H2O.ai. Yang menarik bagi saya adalah betapa cepat sisi bisnis bergerak: lima bulan membawa bidang ini dari makalah akademik ke kesepakatan besar. Berikut linimasa singkat:
Sekarang mari kita bahas masing-masing, dimulai dari model yang memulai semuanya.
TabPFN adalah model yang menciptakan kategori ini. TabPFN-2 diterbitkan di Nature pada Januari 2025 dan mengungguli model berbasis pohon yang disetel pada dataset hingga 10.000 baris.
Sejak saat itu, Prior Labs merilis versi baru dengan cepat. TabPFN-3 hadir pada Mei 2026 dan menangani hingga 1 juta baris (dan hingga 200 fitur). Ia juga menambahkan mode Thinking (melalui API berbayar) yang menghabiskan waktu ekstra pada tahap fitting untuk membuat prediksi yang lebih baik.
Versi terbaru, TabPFN-3.5, keluar pada September 2026, dan laporan teknisnya mengklaim posisi pertama pada beberapa tolok ukur besar, termasuk pada data berurutan waktu dan berkelompok. Saya akan memperlakukan itu sebagai angka dari perusahaan sendiri sampai ada konfirmasi independen.
Satu hal lagi adalah lisensi. TabPFN-2 dapat digunakan secara komersial selama Anda mencantumkan kredit untuk Prior Labs, tetapi versi 2.5 hingga 3.5 bersifat non-komersial. Artinya Anda bisa bereksperimen secara gratis, tetapi menggunakannya dalam produk nyata memerlukan lisensi berbayar.
TabICLv2 adalah model fondasi tabular sepenuhnya terbuka terbaik saat ini. Dibangun di Inria, dirilis pada Februari 2026, dan diterima di ICML 2026.
Hasil utama dari makalah TabICLv2 adalah, tanpa penyetelan apa pun, ia mengungguli RealTabPFN-2.5, model terbaik sebelumnya, meski model itu telah disetel, diensemble, dan di-fine-tune pada data nyata.
Menurut repositori GitHub-nya, ia juga mengungguli XGBoost, CatBoost, dan LightGBM yang disetel berat pada sekitar 80% dataset dalam tolok ukur TabArena.
Ia juga cepat, menangani 50.000 baris dengan 100 fitur dalam waktu kurang dari 10 detik pada GPU H100, sekitar 10 kali lebih cepat daripada TabPFN-2.5.
Ia bekerja paling baik antara 300 hingga 100.000 baris dan bisa diperluas hingga sekitar 500.000 baris dengan sedikit penurunan akurasi.
Menurut saya, inilah yang paling cocok untuk sebagian besar pembaca.
Anda memasangnya dengan pip install tabicl, ia bekerja seperti model scikit-learn mana pun, dan lisensinya yang permisif memungkinkan penggunaan komersial tanpa pendaftaran. Namun papan peringkat berubah cepat, dan laporan TabPFN-3.5 kini menempatkan dirinya di atas TabICLv2.
TabFM adalah model fondasi tabular dari Google Research, dirilis pada 30 Juni 2026. Yang membuatnya berbeda adalah tempat Anda bisa menggunakannya: model ini terintegrasi ke BigQuery, gudang data cloud milik Google, sehingga Anda bisa mendapatkan prediksi dengan SQL biasa.
-- Gunakan pelanggan lama (dengan churn yang sudah diketahui) untuk memprediksi churn pelanggan baru
-- AI.PREDICT masih pratinjau, periksa dokumentasi BigQuery untuk sintaks terbaru
SELECT *
FROM AI.PREDICT(
  TABLE my_dataset.customers_history,
  TABLE my_dataset.customers_new,
  label_col => 'churned'
);
Ini sangat membantu bagi mereka yang menguasai SQL tetapi tidak Python.
Namun, dokumentasi BigQuery saat ini membatasi Anda pada 20 kolom fitur dan 10 kelas, dan Google berencana menambahkan penetapan harga berbasis token di atas biaya standar BigQuery mulai 30 Oktober 2026. Bobot model di Hugging Face bersifat non-komersial, jadi penggunaan komersial melalui BigQuery.
NEXUS adalah model tertutup khusus bisnis dari Fundamental, startup San Francisco yang didirikan mantan peneliti DeepMind. Diluncurkan pada Februari 2026 dengan pendanaan $255M, dan perusahaan menyebutnya Large Tabular Model (LTM).
Bisnis membeli dan menjalankan NEXUS melalui AWS, dan Fundamental mengatakan perusahaan Fortune 100 sudah menggunakannya untuk peramalan permintaan, penetapan harga, dan churn pelanggan. Namun, tidak ada bobot atau hasil tolok ukur publik yang bisa Anda periksa sendiri, jadi saya akan memperlakukannya sebagai opsi enterprise.
tabH2O adalah model dari H2O.ai, dan gagasan utamanya sederhana: kirim data Anda, dapatkan prediksi kembali.
Ia membersihkan nilai hilang dan kolom kategori untuk Anda dan bisa berjalan pada server milik perusahaan sendiri, yang penting bagi bank dan rumah sakit yang tidak dapat mengirim data ke cloud.
Yang saya suka adalah makalah tabH2O tidak melebih-lebihkan. Ia mengungguli CatBoost dan LightGBM yang disetel pada tolok ukur TALENT, tetapi tetap berada di belakang TabICLv2.
| Model | Pembuat | Bobot terbuka? | Skala maks | Lisensi | Terbaik untuk |
|---|---|---|---|---|---|
| TabPFN-2 | Prior Labs | Ya | 10K baris | Komersial dengan atribusi | Penggunaan komersial model lama yang terbukti |
| TabPFN-3 / 3.5 | Prior Labs (SAP) | Ya, setelah menerima lisensi | Hingga 1M baris | Non-komersial, API berbayar untuk bisnis | Akurasi teratas dan riset |
| TabICLv2 | Inria | Ya | Terbaik hingga 100K baris | Open source permisif | Titik awal default Anda |
| TabFM | Google Research | Ya | 20 fitur di BigQuery | Bobot non-komersial | Pengguna SQL di BigQuery |
| NEXUS | Fundamental | Tidak | Tidak diungkap | Proprietary | Perusahaan besar di AWS |
| tabH2O | H2O.ai | Tidak | Tidak diungkap | API komersial | Tim tanpa setup ML, agen AI |
Anda menggunakan model fondasi tabular di Python persis seperti model scikit-learn lainnya.
Cara terbaik melihat apa yang ditawarkannya adalah menandingkannya langsung dengan XGBoost, jadi mari kita lakukan pada dataset kanker payudara bawaan scikit-learn.
Pertama, kita memasang paketnya:
pip install tabicl xgboost scikit-learnKemudian kita jalankan kedua model pada pembagian yang sama:
from sklearn.datasets import load_breast_cancer
from sklearn.metrics import accuracy_score
from sklearn.model_selection import train_test_split
from tabicl import TabICLClassifier
from xgboost import XGBClassifier

# Load a small tabular dataset as a pandas DataFrame
X, y = load_breast_cancer(return_X_y=True, as_frame=True)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, stratify=y, random_state=42
)

# Tabular foundation model: fit() just stores the training rows
tfm = TabICLClassifier()
tfm.fit(X_train, y_train)
tfm_preds = tfm.predict(X_test)

# XGBoost baseline with reasonable, untuned settings
xgb = XGBClassifier(n_estimators=300, learning_rate=0.05, max_depth=4)
xgb.fit(X_train, y_train)
xgb_preds = xgb.predict(X_test)

print(f"TabICL accuracy:  {accuracy_score(y_test, tfm_preds):.3f}")
print(f"XGBoost accuracy: {accuracy_score(y_test, xgb_preds):.3f}")
Dataset kecil ini berjalan baik di CPU laptop biasa.
Kedua model akan mencetak skor sangat tinggi pada data sebersih ini, jadi jangan menilainya dari satu pembagian saja. Ujian sebenarnya adalah data berantakan Anda sendiri.
Jika Anda ingin mencoba TabPFN sebagai gantinya, jalankan pip install tabpfn, lalu hanya perlu dua baris perubahan:
from tabpfn import TabPFNClassifier

tfm = TabPFNClassifier()  # The first run asks you to accept the license
tfm.fit(X_train, y_train)
tfm_preds = tfm.predict(X_test)
Satu hal penting sebelum Anda membandingkan model pada data nyata.
Jika data Anda memiliki tanggal, bagi berdasarkan waktu alih-alih secara acak. Jika tidak, model dapat mengintip masa depan, dan seperti yang akan Anda lihat di bagian berikutnya, di situlah model fondasi tabular tampak lebih baik dari yang sebenarnya.
Model fondasi tabular bekerja baik saat dataset Anda kecil hingga menengah dan baris uji mirip dengan baris pelatihan. Mereka kesulitan dengan data berurutan waktu, data berkelompok, tabel yang sangat besar, dan kebutuhan penjelasan yang ketat.
Gagasan “baris uji mirip dengan baris pelatihan” itu memiliki nama, IID (independent and identically distributed), dan itu adalah hal paling penting untuk diperiksa pada data Anda.
Mari mulai dari di mana mereka bekerja baik:
Sekarang keterbatasannya, yang menurut saya lebih penting jika Anda berencana menggunakannya dalam proyek nyata.
Tolok ukur BeyondArena, dirilis pada Juni 2026, menguji 11 model pada 142 dataset, termasuk yang dibagi berdasarkan waktu (memprediksi masa depan dari masa lalu) dan berdasarkan grup (memprediksi untuk rumah sakit atau negara baru).
Hasilnya menunjukkan model fondasi tabular terbaik pada data IID kecil dan menengah, sementara model berbasis pohon dan deep learning lainnya masih unggul pada data berurutan waktu, berkelompok, besar, dan sangat lebar. Karena sebagian besar data bisnis (penjualan, penipuan, churn) berurutan waktu, keterbatasan ini muncul di banyak proyek nyata.
TabPFN-3.5, yang dirilis setelah BeyondArena, secara khusus mengklaim menutup kesenjangan ini pada data berurutan waktu dan berkelompok. Itu menjanjikan, namun belum diuji secara independen.
Anda bisa mendapatkan nilai SHAP dari TabICL dan TabPFN, tetapi jauh lebih lama dibandingkan SHAP pada model pohon, dan tidak ada split pohon untuk diperiksa. Di bidang seperti penilaian kredit, di mana regulator perlu memahami model, ini adalah masalah nyata.
Apapun di atas beberapa ribu baris pada dasarnya menginginkan GPU, dan prediksi melambat seiring pertumbuhan data pelatihan. Model XGBoost yang sudah dilatih pada CPU akan selalu menang dalam hal kecepatan.
TabPFN-2 komersial dengan kredit, versi TabPFN yang lebih baru bersifat non-komersial, bobot TabFM non-komersial, dan TabICLv2 permisif.
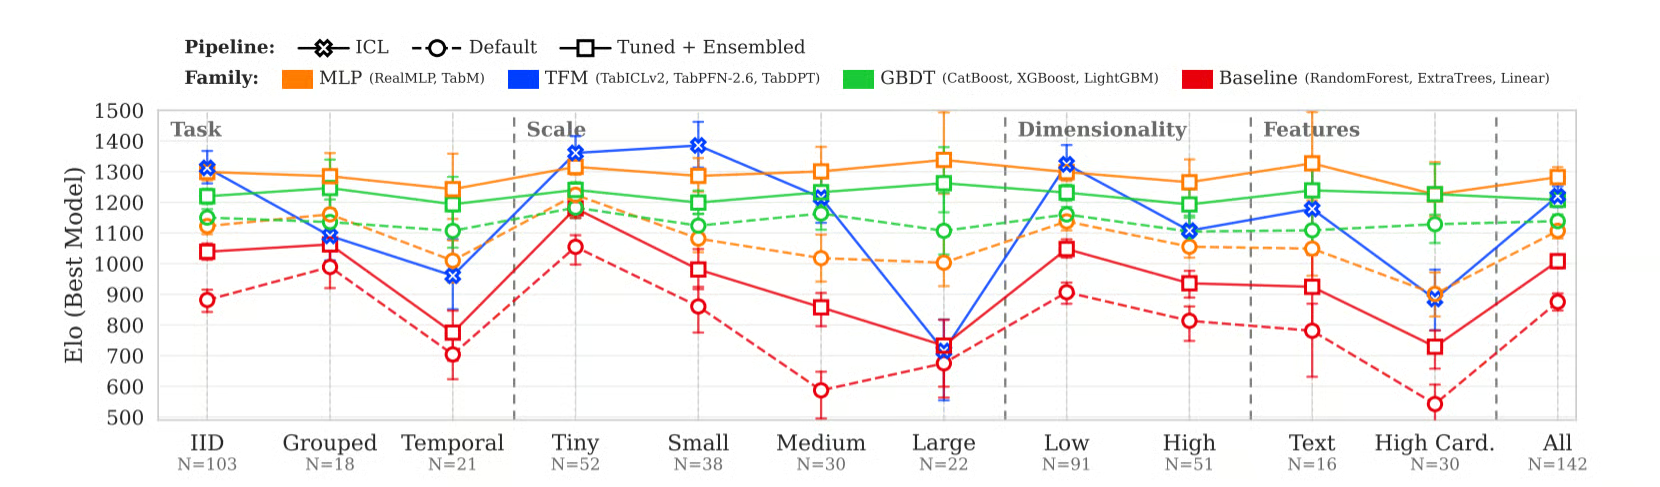
Gambar 3: Elo menurut keluarga model (lebih tinggi lebih baik). Model fondasi tabular memimpin pada data IID kecil namun turun pada dataset temporal dan besar, di mana pohon dan MLP lebih stabil. Biru adalah yang terbaik dari TabICLv2, TabPFN-2.6, dan TabDPT, bukan versi TabPFN terbaru. Sumber: Purucker dkk., “Beyond IID: How General Are Tabular Foundation Models, Really?” (2026), CC BY 4.0.
Semoga Anda sependapat bahwa model fondasi tabular telah menaikkan standar untuk baseline cepat tanpa usaha, namun model berbasis pohon masih menjadi pilihan lebih baik dalam banyak situasi nyata.
Anda sebaiknya menggunakan model fondasi tabular saat dataset Anda kecil hingga menengah dan IID, dan Anda tidak memerlukan model yang sepenuhnya dapat dijelaskan atau prediksi yang sangat cepat di CPU. Berikut tabel keputusan yang akan saya gunakan:
| Skenario | Pendekatan yang direkomendasikan |
|---|---|
| Di bawah 10K baris, IID, tanpa kebutuhan penjelasan | Mulai dengan TabICLv2 atau TabPFN |
| 10K hingga 100K baris, IID | Uji TabICLv2 dan XGBoost, pertahankan pemenang |
| 100K hingga 1M baris | Mulai dengan XGBoost atau LightGBM, coba TabPFN-3 sebagai penantang |
| Data dibagi berdasarkan waktu atau grup | Mulai dengan model berbasis pohon |
| Butuh SHAP, feature importance, atau audit | Model berbasis pohon dengan SHAP |
| Prediksi cepat tanpa GPU | Model berbasis pohon |
| Proof of concept cepat, tanpa setup ML | TabICLv2, atau BigQuery AI.PREDICT jika data Anda sudah di sana |
| Agen AI yang butuh prediksi dari tabel | API seperti tabH2O atau NEXUS |
Sebelum memilih model, saya merekomendasikan tiga pertanyaan ini:
Dan poin terakhir yang ingin saya sampaikan adalah ini. Jalankan model fondasi tabular terlebih dahulu, karena hanya butuh beberapa menit. Jika ia tidak bisa mengalahkan XGBoost pada data Anda, kini Anda tahu bahwa menghabiskan waktu untuk rekayasa fitur dan menyetel XGBoost memang sepadan.
Ingat dua siswa di awal artikel ini? Pada 2026, siswa kedua, yang berlatih pada jutaan ujian, akhirnya bisa mengalahkan yang belajar berminggu-minggu, setidaknya pada tabel kecil dan menengah.
Model fondasi tabular menggantikan pelatihan per dataset dengan pra-pelatihan, dan menggantikan fit() dengan belajar dari contoh.
Yang paling mengejutkan saya adalah betapa cepatnya domain ini berkembang. TabPFN-2 pertama kali menunjukkan pada 2025 bahwa jaringan saraf bisa mengalahkan pohon yang disetel pada tabel kecil, dan TabICLv2 serta TabPFN-3 sejak itu mendorongnya ke tabel yang jauh lebih besar.
Masalah terbuka sekarang adalah data berurutan waktu, data yang berubah, keterjelasan, dan perizinan, yang merupakan hal-hal yang menentukan apakah sebuah model masuk ke produk nyata.
Jadi saran saya adalah perlakukan model-model ini sebagai titik awal baru Anda dan pilih alat final berdasarkan data Anda, batasan Anda, dan di mana model akan dijalankan.
Dan jika Anda ingin menguasai model berbasis pohon yang masih menang dalam banyak situasi nyata, lihat kursus Machine Learning with Tree-Based Models in Python kami dan track Supervised Machine Learning in Python. Jika Anda bekerja di R, Machine Learning with Tree-Based Models in R membahas topik yang sama.
Kursus Teratas DataCamp
Program
Kursus
Program
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt
blogs
Javier Canales Luna
14 mnt