
Programa
Desarrollar grandes modelos lingüísticos
16 h
Imagina a dos estudiantes haciendo el mismo examen. El primero pasa tres semanas estudiando solo un tema. El segundo ya ha practicado con millones de exámenes distintos y, el día de la prueba, recibe una hoja con ejercicios resueltos.
Durante la mayor parte de la historia del machine learning, los modelos tabulares han sido el primer estudiante. Cada nuevo conjunto de datos implicaba limpiar columnas, crear variables, entrenar XGBoost o LightGBM y ajustar hiperparámetros durante horas.
Los modelos fundacionales tabulares, en cambio, son el segundo estudiante: les das tus filas etiquetadas como ejemplos y predicen el resto sin ningún entrenamiento.
En 2026, esta idea pasó de los papers a los productos reales, con SAP comprometiendo más de 1.000 millones de euros con Prior Labs y Google lanzando su propio modelo. Así que, en este artículo, veremos:
No te preocupes si no tienes mucha experiencia en deep learning. El código de este artículo usa la interfaz familiar de scikit-learn y, si quieres un repaso rápido antes, 8 modelos de machine learning explicados en 20 minutos cubre lo básico.
pip install tabicl.Un modelo fundacional tabular es una red neuronal preentrenada en millones de datasets tabulares sintéticos que aprende una estrategia general para predecir una columna objetivo y luego aplica esa estrategia a una tabla nueva mediante aprendizaje en contexto, sin entrenamiento por dataset.
El gran cambio aquí es cuándo ocurre el aprendizaje.
Con XGBoost, el aprendizaje sucede sobre tus datos cada vez que entrenas un modelo nuevo. Con un modelo fundacional tabular, el aprendizaje ocurrió meses atrás durante el preentrenamiento, y tus datos son simplemente la entrada. También verás algunos términos recurrentes, así que los explico en lenguaje llano:
Ahora, veamos cómo se comparan los modelos fundacionales tabulares con los métodos de boosting y con el machine learning automatizado (AutoML):
| Modelos fundacionales tabulares | Árboles potenciados (XGBoost, LightGBM) | AutoML (AutoGluon, H2O AutoML) | |
|---|---|---|---|
| Tiempo de entrenamiento en datos nuevos | Ninguno | De segundos a minutos, más el ajuste | De minutos a horas |
| Interpretabilidad | Limitada (SHAP es posible pero lento) | Buena (importancia de variables, SHAP rápido) | Variable, a menudo ensembles difíciles de leer |
| Tamaño de dataset ideal | Centenares hasta ~100K filas | De miles a muchos millones de filas | De miles a millones de filas |
| ¿Necesita GPU? | Recomendable a partir de unas pocas miles de filas | No | Normalmente no |
| Datasets pequeños con partición aleatoria | Mejores en los benchmarks actuales | Fuertes cuando se ajustan | Fuertes pero lentos |
Antes de ver cómo funcionan, quiero compararlos rápidamente con los modelos más famosos y usados: los grandes modelos de lenguaje.
Los grandes modelos de lenguaje (LLM) y los modelos fundacionales tabulares usan transformers y ambos aprenden de ejemplos en su entrada.
La diferencia está en lo que están diseñados para leer. Un LLM lee una tabla como una larga cadena de texto, por lo que debe deducir a partir de comas y espacios qué números pertenecen a la misma columna.
También hay un problema de significado.
El valor 42 puede ser una edad o una cifra de ingresos, pero nada en el número lo indica. Un modelo fundacional tabular se entrena para tratar cada columna como su propia variable y cada fila como un ejemplo, de modo que se centra en cómo se relacionan las columnas entre sí.
Me gusta pensarlo así: un LLM es excelente para hablar sobre tus datos, y un modelo fundacional tabular está hecho para hacer las cuentas con ellos.
Además, pueden trabajar juntos, que es exactamente como H2O.ai posiciona su modelo tabH2O: como la herramienta de predicción a la que llama un agente de IA cuando necesita un número de una hoja de cálculo.
Fueron difíciles porque las tablas no comparten una estructura común que una red neuronal pueda aprender una vez y reutilizar. Un píxel es un píxel en cada foto. Una columna llamada score en un dataset financiero y otra llamada score en un dataset de fútbol no tienen nada en común.
Un paper conocido de 2022 de Léo Grinsztajn, Edouard Oyallon y Gaël Varoquaux, Why do tree-based models still outperform deep learning on tabular data?, lo probó en 45 datasets y encontró que los modelos basados en árboles, especialmente el gradient boosting, seguían superando al deep learning en tablas de tamaño medio (~10.000 filas). Las razones:
Dos problemas prácticos lo agravan. Una tabla puede mezclar números, categorías, rankings y valores faltantes, y la mayoría de tablas de negocio solo tienen cientos o miles de filas, demasiado pocas para entrenar una red desde cero.
Yo diría que los datasets pequeños son el mayor problema. Una red neuronal entrenada desde cero con 800 filas no tiene de qué tirar, mientras que un árbol no necesita conocimiento previo para funcionar.
Esto es justo lo que soluciona el preentrenamiento. Un modelo fundacional tabular ya ha practicado con millones de tablas pequeñas, desordenadas y sintéticas antes de ver la tuya, así que no parte de cero.
Un modelo fundacional tabular toma tus filas etiquetadas de entrenamiento y tus filas sin etiqueta de test juntas como una única entrada y predice las etiquetas que faltan en un solo forward pass. Sus pesos no cambian, igual que un LLM respondiendo a una pregunta tras darle unos ejemplos en el prompt.
Esto también cambia el significado de los métodos conocidos de scikit-learn.
Cuando llamas a .fit() en TabICL, la documentación de TabICL explica que carga el checkpoint preentrenado, preprocesa tus datos y los almacena. El trabajo real ocurre en .predict().
El nombre .fit() se mantiene para que el modelo encaje en tu código actual de scikit-learn.
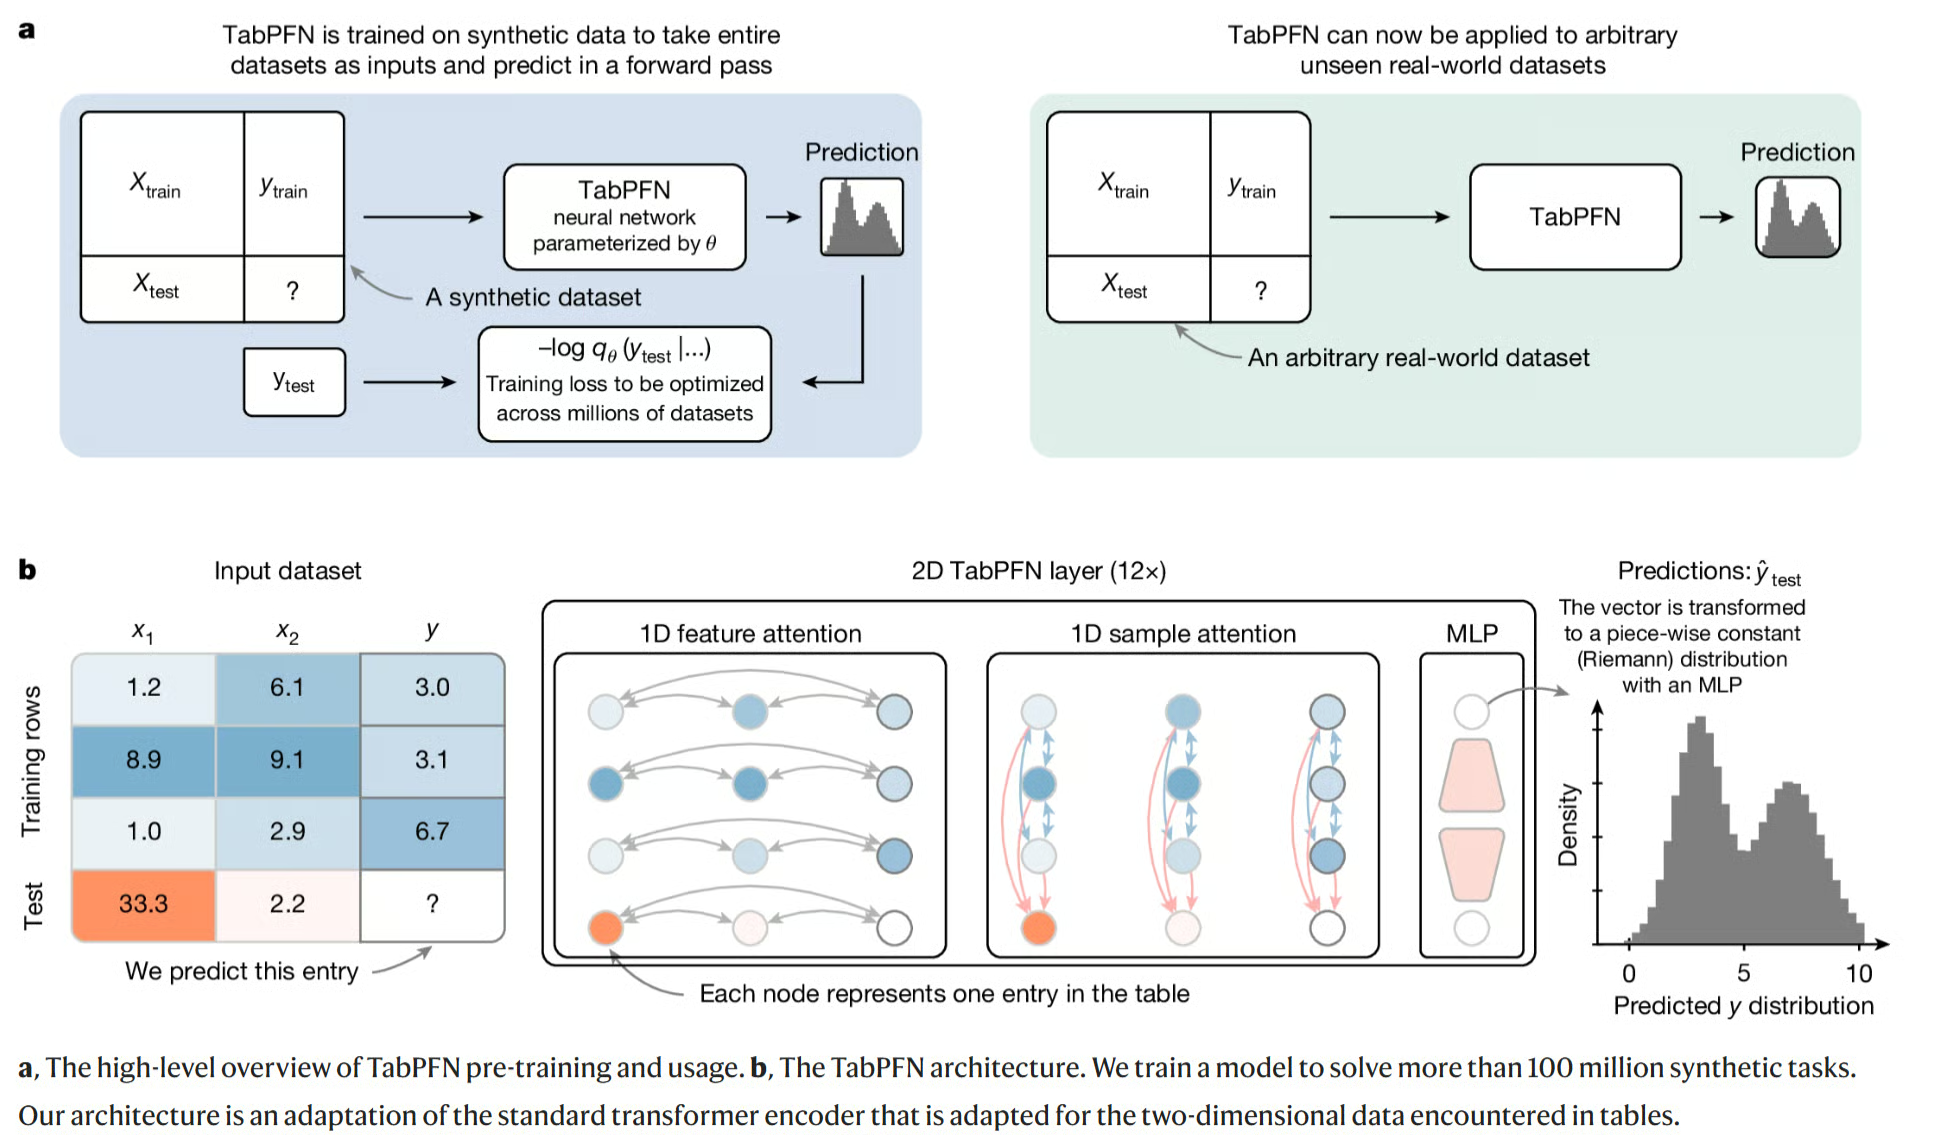
Figura 1: TabPFN se preentrena en millones de datasets sintéticos y luego predice sobre una tabla real en un forward pass. El panel inferior muestra cómo atiende a través de características y muestras. Fuente: Hollmann et al., “Accurate predictions on small data with a tabular foundation model”, Nature (2025).
El preentrenamiento sintético significa entrenar el modelo con tablas inventadas en lugar de reales, generadas por un motor de datos que funciona como un modelo generativo.
Piénsalo como un piloto entrenando en un simulador. Practica miles de vuelos ficticios con climas, aeropuertos y fallos distintos, para que el primer vuelo real no le pille de nuevas.
TabPFN funciona de forma similar.
Sus creadores escribieron un generador que inventa reglas aleatorias de “causa y efecto” entre columnas (por ejemplo, la columna A afecta a la B, que afecta al objetivo) y luego produce filas a partir de esas reglas.
Durante el preentrenamiento, se oculta la columna objetivo, el modelo intenta predecirla y esto se repite millones de veces con reglas, niveles de ruido y tamaños de tabla distintos.
Lo importante es que el modelo nunca aprende hechos de ningún tema real. Aprende habilidades generales como detectar qué columnas importan, tratar con outliers y saber cuándo dudar.
De hecho, el paper de TabICLv2 atribuye a su nuevo generador sintético una mejora clave de rendimiento.
No necesitas entender cada detalle de las arquitecturas, pero ayuda saber que hay dos diseños principales:
Ojo: ambas familias se entrenan con datos sintéticos, así que “prior-fitted network” describe cómo se entrenan, no un tipo de modelo distinto.
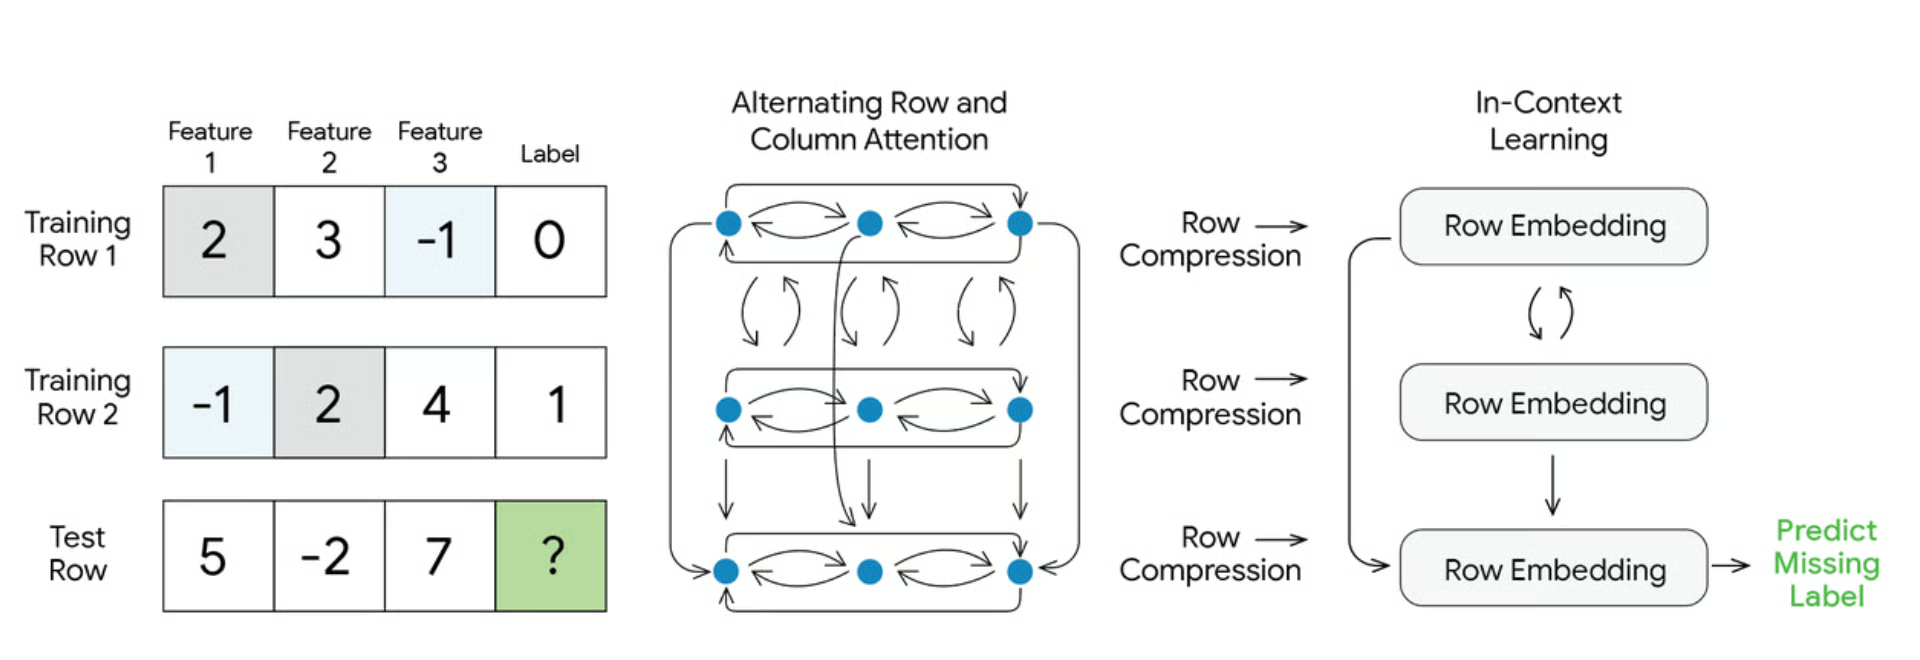
Figura 2: TabFM combina ambos enfoques: atención tipo TabPFN sobre filas y columnas, luego compresión de filas estilo TabICL y, después, aprendizaje en contexto para la etiqueta faltante. Fuente: Google Research, “Introducing TabFM: A zero-shot foundation model for tabular data” (2026).
Hay un trade-off que pilla a mucha gente.
XGBoost invierte tiempo en entrenar una vez y luego predice casi al instante.
Un modelo fundacional tabular se salta el entrenamiento, pero tiene que leer todas tus filas de entrenamiento cada vez que predice.
Piénsalo como un chef que no hace mise en place y debe releer el recetario para cada pedido.
Con un recetario pequeño, bien; a medida que crece el dataset, las predicciones se ralentizan. Tanto TabICL como TabPFN pueden cachear su “lectura” de los datos de entrenamiento para acelerar predicciones repetidas, pero la primera pasada sigue costando tiempo.
Los modelos clave en 2026 son TabPFN, TabICLv2, TabFM de Google, NEXUS de Fundamental y tabH2O de H2O.ai. Lo interesante es lo rápido que se movió el negocio: en cinco meses pasamos de papers académicos a acuerdos importantes. Cronología breve:
Ahora veamos cada uno, empezando por el modelo que lo inició todo.
TabPFN es el modelo que creó esta categoría. TabPFN-2 se publicó en Nature en enero de 2025 y superó a modelos de árboles ajustados en datasets de hasta 10.000 filas.
Desde entonces, Prior Labs ha sacado versiones nuevas con rapidez. TabPFN-3 llegó en mayo de 2026 y maneja hasta 1 millón de filas (y hasta 200 variables). También añadió un modo Thinking (a través de su API de pago) que invierte más tiempo en la fase de fit para mejorar las predicciones.
La última versión, TabPFN-3.5, salió en septiembre de 2026 y su informe técnico reclama el primer puesto en varios benchmarks importantes, incluidos datos ordenados en el tiempo y por grupos. Yo trataría esas cifras como números de la empresa hasta que otros las confirmen.
Un punto más: la licencia. TabPFN-2 puede usarse comercialmente siempre que cites a Prior Labs, pero las versiones 2.5 a 3.5 son no comerciales. Eso significa que puedes experimentar gratis, pero usarlo en un producto real requiere licencia de pago.
TabICLv2 es, a día de hoy, el mejor modelo fundacional tabular completamente abierto. Lo desarrolló Inria, se publicó en febrero de 2026 y fue aceptado en ICML 2026.
El resultado destacado del paper de TabICLv2 es que, sin ningún ajuste, superó a RealTabPFN-2.5, el anterior mejor modelo, pese a que éste sí estaba ajustado, ensamblado y afinado con datos reales.
Según su repositorio en GitHub, también supera a XGBoost, CatBoost y LightGBM fuertemente ajustados en alrededor del 80% de los datasets del benchmark TabArena.
Además es rápido: maneja 50.000 filas con 100 variables en menos de 10 segundos en una GPU H100, unas 10 veces más veloz que TabPFN-2.5.
Funciona mejor entre 300 y 100.000 filas y puede estirarse hasta ~500.000 con algo de pérdida de precisión.
En mi opinión, es con el que debería empezar la mayoría.
Se instala con pip install tabicl, funciona como cualquier modelo de scikit-learn y su licencia permisiva te permite usarlo comercialmente sin registrarte. El ranking cambia rápido, eso sí, y el informe de TabPFN-3.5 ahora se sitúa por delante de TabICLv2.
TabFM es el modelo fundacional tabular de Google Research, lanzado el 30 de junio de 2026. Lo que lo diferencia es dónde puedes usarlo: está integrado en BigQuery, el data warehouse en la nube de Google, así que puedes obtener predicciones con SQL puro.
-- Usa clientes históricos (con churn conocido) para predecir el churn de nuevos clientes
-- AI.PREDICT está en vista previa; consulta la documentación de BigQuery para la sintaxis más reciente
SELECT *
FROM AI.PREDICT(
  TABLE my_dataset.customers_history,
  TABLE my_dataset.customers_new,
  label_col => 'churned'
);
Ideal para quien sabe SQL pero no Python.
Sin embargo, la documentación de BigQuery actualmente te limita a 20 columnas de características y 10 clases, y Google planea añadir precios por tokens además de los cargos estándar de BigQuery a partir del 30 de octubre de 2026. Los pesos del modelo en Hugging Face son no comerciales, así que el uso comercial pasa por BigQuery.
NEXUS es un modelo cerrado, solo para empresas, de Fundamental, una startup de San Francisco fundada por ex investigadores de DeepMind. Se lanzó en febrero de 2026 con 255 millones de dólares y la empresa lo denomina Large Tabular Model (LTM).
Las empresas compran y ejecutan NEXUS en AWS, y Fundamental afirma que compañías de la Fortune 100 ya lo usan para previsión de demanda, precios y churn. No hay pesos públicos ni benchmarks verificables, así que lo trataría como una opción empresarial.
tabH2O es el modelo de H2O.ai y su propuesta es simple: envía tus datos y recibe predicciones.
Limpia valores faltantes y categorías por ti y puede ejecutarse en servidores propios, algo clave para bancos y hospitales que no pueden enviar datos a la nube.
Me gusta que el paper de tabH2O no lo sobredimensiona. Superó a CatBoost y LightGBM ajustados en el benchmark TALENT, pero quedó por detrás de TabICLv2.
| Modelo | Creador | ¿Pesos abiertos? | Escala máx. | Licencia | Mejor para |
|---|---|---|---|---|---|
| TabPFN-2 | Prior Labs | Sí | 10K filas | Comercial con atribución | Uso comercial de un modelo maduro |
| TabPFN-3 / 3.5 | Prior Labs (SAP) | Sí, aceptando una licencia | Hasta 1M de filas | No comercial, API de pago para empresas | Máxima precisión e I+D |
| TabICLv2 | Inria | Sí | Óptimo hasta 100K filas | Open source permisiva | Tu punto de partida por defecto |
| TabFM | Google Research | Sí | 20 variables en BigQuery | Pesos no comerciales | Usuarios de SQL en BigQuery |
| NEXUS | Fundamental | No | No divulgado | Propietaria | Grandes empresas en AWS |
| tabH2O | H2O.ai | No | No divulgado | API comercial | Equipos sin infraestructura de ML, agentes de IA |
Usas un modelo fundacional tabular en Python exactamente igual que cualquier modelo de scikit-learn.
La mejor forma de ver qué aporta es enfrentarlo a XGBoost, así que hagámoslo con el dataset de cáncer de mama incluido en scikit-learn.
Primero, instalamos los paquetes:
pip install tabicl xgboost scikit-learnLuego ejecutamos ambos modelos sobre la misma partición:
from sklearn.datasets import load_breast_cancer
from sklearn.metrics import accuracy_score
from sklearn.model_selection import train_test_split
from tabicl import TabICLClassifier
from xgboost import XGBClassifier

# Carga un dataset tabular pequeño como DataFrame de pandas
X, y = load_breast_cancer(return_X_y=True, as_frame=True)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, stratify=y, random_state=42
)

# Modelo fundacional tabular: fit() solo guarda las filas de entrenamiento
tfm = TabICLClassifier()
tfm.fit(X_train, y_train)
tfm_preds = tfm.predict(X_test)

# Línea base con XGBoost y ajustes razonables sin tunear
xgb = XGBClassifier(n_estimators=300, learning_rate=0.05, max_depth=4)
xgb.fit(X_train, y_train)
xgb_preds = xgb.predict(X_test)

print(f"TabICL accuracy:  {accuracy_score(y_test, tfm_preds):.3f}")
print(f"XGBoost accuracy: {accuracy_score(y_test, xgb_preds):.3f}")
Este dataset pequeño funciona bien en la CPU de un portátil normal.
Ambos modelos obtendrán puntuaciones muy altas en algo tan limpio, así que no los juzgues por una sola partición. La prueba real serán tus propios datos desordenados.
Si quieres probar TabPFN en su lugar, ejecuta pip install tabpfn y solo hay que cambiar dos líneas:
from tabpfn import TabPFNClassifier

tfm = TabPFNClassifier()  # En la primera ejecución te pedirá aceptar la licencia
tfm.fit(X_train, y_train)
tfm_preds = tfm.predict(X_test)
Un punto importante antes de comparar modelos en datos reales.
Si tus datos tienen fechas, divide por tiempo en lugar de aleatoriamente. Si no, el modelo mira al futuro, y como verás en la siguiente sección, ese es justo el contexto donde los modelos fundacionales tabulares se ven mejor de lo que son en realidad.
Funcionan bien cuando tu dataset es pequeño o mediano y las filas de test se parecen a las de entrenamiento. Sufren con datos ordenados en el tiempo, por grupos, tablas muy grandes y exigencias estrictas de explicabilidad.
Esa idea de “las filas de test se parecen a las de entrenamiento” se llama IID (independientes e idénticamente distribuidas) y es lo más importante que debes comprobar de tus datos.
Empecemos por donde funcionan bien:
Ahora, las limitaciones, que creo que importan más si planeas usarlos en un proyecto real.
El benchmark BeyondArena, publicado en junio de 2026, probó 11 modelos en 142 datasets, incluidos los divididos por tiempo (predecir el futuro desde el pasado) y por grupo (predecir para un hospital o país nuevos).
Encontró que los modelos fundacionales tabulares rinden mejor en datos IID pequeños y medianos, mientras que los modelos basados en árboles y otros de deep learning siguen liderando en datos temporales, por grupos, grandes y muy anchos. Como la mayoría de datos de negocio (ventas, fraude, churn) están ordenados en el tiempo, esta limitación aparece en muchos proyectos reales.
TabPFN-3.5, lanzado después de BeyondArena, afirma específicamente cerrar esta brecha en datos temporales y por grupos. Es prometedor, pero aún no ha sido validado externamente.
Puedes obtener valores SHAP tanto de TabICL como de TabPFN, pero tardan bastante más que el SHAP en un modelo de árboles, y no hay splits de árbol que inspeccionar. En ámbitos como el credit scoring, donde los reguladores necesitan entender el modelo, esto es un problema real.
Más allá de unas pocas miles de filas, realmente conviene una GPU, y las predicciones se vuelven más lentas a medida que crecen los datos de entrenamiento. Un XGBoost entrenado en CPU ganará siempre en velocidad.
TabPFN-2 es comercial con atribución; las versiones nuevas de TabPFN son no comerciales; los pesos de TabFM son no comerciales; TabICLv2 es permisivo.
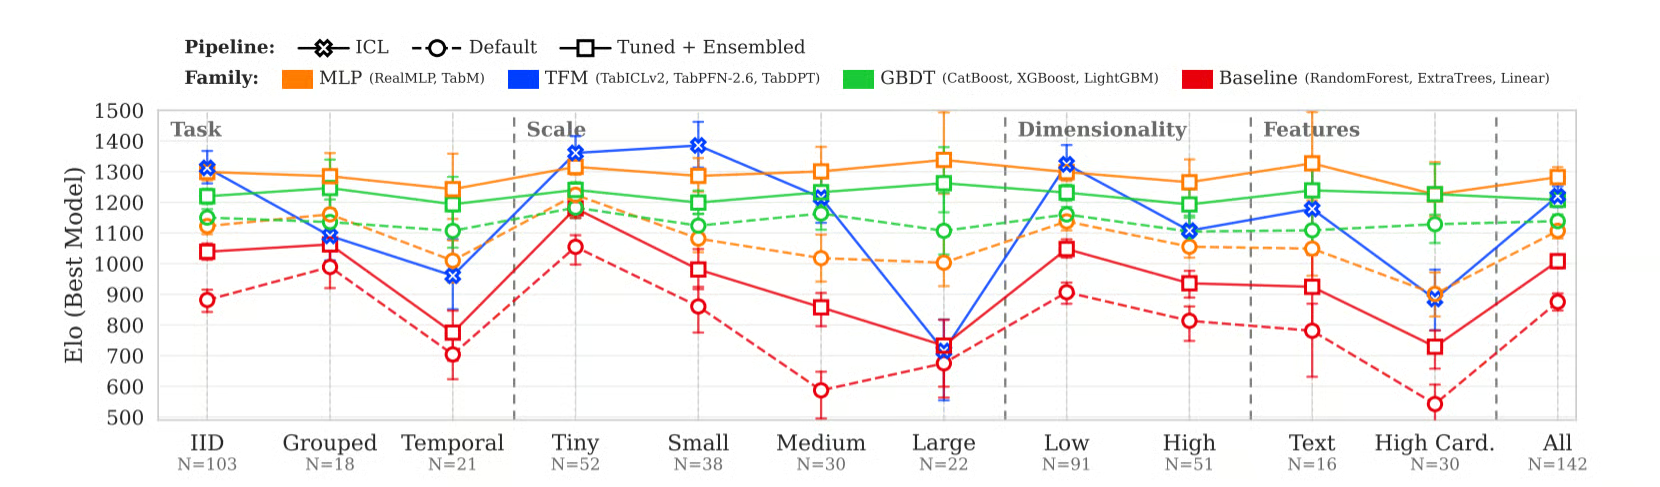
Figura 3: Elo por familia de modelos (más alto es mejor). Los modelos fundacionales tabulares lideran en datos IID pequeños pero caen en datasets temporales y grandes, donde árboles y MLPs aguantan mejor. En azul, lo mejor de TabICLv2, TabPFN-2.6 y TabDPT, no las versiones más nuevas de TabPFN. Fuente: Purucker et al., “Beyond IID: How General Are Tabular Foundation Models, Really?” (2026), CC BY 4.0.
Con suerte coincidirás conmigo en que estos modelos han elevado el listón de lo que puede ser un baseline rápido y sin esfuerzo, pero los modelos basados en árboles siguen siendo la mejor opción en muchos casos reales.
Úsalo cuando tu dataset sea pequeño o mediano y IID, y no necesites un modelo totalmente explicable ni predicciones muy rápidas en CPU. Esta es la tabla de decisiones que usaría:
| Escenario | Enfoque recomendado |
|---|---|
| Menos de 10K filas, IID, sin necesidad de explicabilidad | Empieza con TabICLv2 o TabPFN |
| De 10K a 100K filas, IID | Prueba TabICLv2 y XGBoost, quédate con el ganador |
| De 100K a 1M de filas | Empieza con XGBoost o LightGBM, prueba TabPFN-3 como retador |
| Datos divididos por tiempo o por grupo | Empieza con modelos de árboles |
| Necesitas SHAP, importancia de variables o auditoría | Modelo de árboles con SHAP |
| Predicciones rápidas sin GPU | Modelo de árboles |
| Prueba de concepto rápida, sin infraestructura de ML | TabICLv2, o BigQuery AI.PREDICT si tus datos ya están allí |
| Un agente de IA que necesita predicciones desde tablas | Una API como tabH2O o NEXUS |
Antes de elegir modelo, te recomiendo hacerte estas tres preguntas:
Y un último consejo. Ejecuta primero un modelo fundacional tabular, porque solo te costará unos minutos. Si no supera a XGBoost en tus datos, sabrás que merece la pena invertir tiempo en feature engineering y ajustar XGBoost.
¿Recuerdas a los dos estudiantes del principio? En 2026, el segundo, el que practicó con millones de exámenes, por fin puede superar al que estudió durante semanas, al menos en tablas pequeñas y medianas.
Los modelos fundacionales tabulares sustituyen el entrenamiento por dataset por el preentrenamiento y cambian fit() por aprender a partir de ejemplos.
Lo que más me sorprende es lo rápido que ha mejorado este campo. TabPFN-2 demostró en 2025 que una red neuronal podía superar a árboles ajustados en tablas pequeñas, y TabICLv2 y TabPFN-3 han ampliado eso a tablas mucho mayores.
Los problemas abiertos ahora son datos temporales, datos cambiantes, explicabilidad y licencias, justo las cuestiones que determinan si un modelo llega a un producto real.
Así que mi consejo es tratar estos modelos como tu nuevo punto de partida y elegir la herramienta final según tus datos, tus limitaciones y dónde vaya a ejecutarse el modelo.
Y si quieres dominar los modelos basados en árboles, que siguen ganando en muchas situaciones reales, echa un vistazo a nuestro curso Machine Learning with Tree-Based Models in Python y al itinerario Supervised Machine Learning in Python. Si trabajas en R, Machine Learning with Tree-Based Models in R cubre lo mismo.
Los mejores cursos de DataCamp
Programa
Curso
Programa