Programma
Sviluppare modelli linguistici di grandi dimensioni
16 ore
Immagina due studenti che sostengono lo stesso esame. Il primo passa tre settimane a studiare un solo modulo, mentre il secondo ha già fatto pratica su milioni di esami diversi e il giorno della prova riceve semplicemente un foglio con esercizi svolti.
Per gran parte del passato del machine learning, i modelli per dati tabellari sono stati come il primo studente. Ogni nuovo dataset significava pulire le colonne, fare feature engineering, addestrare XGBoost o LightGBM e ottimizzare gli iperparametri per ore.
I modelli foundation per dati tabellari, invece, sono come il secondo studente: consegni loro le tue righe etichettate come esempi e loro predicono il resto senza alcun addestramento.
Nel 2026, questa idea è passata dagli articoli di ricerca a prodotti reali, con SAP che ha impegnato oltre €1 miliardo in Prior Labs e Google che ha rilasciato il proprio modello. In questo articolo vedremo quindi:
Non preoccuparti se non hai molta esperienza con il deep learning. Il codice in questo articolo usa la familiare interfaccia di scikit-learn e, se vuoi un rapido ripasso, 8 modelli di Machine Learning spiegati in 20 minuti copre le basi.
pip install tabicl.Un modello foundation per dati tabellari è una rete neurale preaddestrata su milioni di dataset tabellari sintetici che apprende una strategia generale per prevedere una colonna target, quindi applica quella strategia a una nuova tabella tramite in-context learning, senza alcun addestramento specifico per dataset.
Il grande cambiamento qui riguarda quando avviene l’apprendimento.
Con XGBoost, l’apprendimento avviene sui tuoi dati ogni volta che addestri un nuovo modello. Con un modello foundation per tabellari, l’apprendimento è avvenuto mesi prima durante il pretraining e i tuoi dati sono semplicemente l’input. Ci sono anche alcuni termini che incontrerai spesso, quindi te li spiego in modo semplice:
Ora vediamo come i modelli foundation per tabellari si confrontano con i metodi di boosting e con l’AutoML:
| Modelli foundation per tabellari | Alberi gradient-boosted (XGBoost, LightGBM) | AutoML (AutoGluon, H2O AutoML) | |
|---|---|---|---|
| Tempo di training su nuovi dati | Nessuno | Secondi-minuti, più tuning | Minuti-ore |
| Interpretabilità | Limitata (SHAP è possibile ma lento) | Buona (feature importance, SHAP veloce) | Variabile, spesso ensemble difficili da leggere |
| Dimensione dataset ideale | Centinaia fino a ~100K righe | Migliaia fino a molti milioni di righe | Migliaia fino a milioni di righe |
| Serve la GPU? | Consigliata oltre poche migliaia di righe | No | Di solito no |
| Dataset piccoli con split casuale | Migliori negli attuali benchmark | Forti se ottimizzati | Forti ma lenti |
Prima di vedere come funzionano, però, voglio confrontarli rapidamente con i modelli più famosi e diffusi: i large language model.
I large language model (LLM) e i modelli foundation per tabellari usano entrambi i transformer e apprendono dagli esempi presenti nel loro input.
La differenza sta in cosa sono costruiti per leggere. Un LLM legge una tabella come una lunga stringa di testo, il che significa che deve ricavare da virgole e spazi quali numeri appartengono alla stessa colonna.
C’è anche un problema di significato.
Il valore 42 potrebbe essere l’età di qualcuno o un ricavo, ma il numero in sé non ti dice quale. Un modello foundation per tabellari è addestrato a trattare ogni colonna come una variabile a sé e ogni riga come un esempio, così si concentra su come le colonne si relazionano tra loro.
Mi piace pensarla così: un LLM è ottimo per parlare dei tuoi dati, mentre un modello foundation per tabellari è costruito per farci i conti.
I due possono anche lavorare insieme, ed è esattamente così che H2O.ai posiziona il suo modello tabH2O: come lo strumento di previsione che un agente AI chiama quando gli serve un numero da un foglio di calcolo.
I dati tabellari erano difficili per il deep learning perché le tabelle non hanno una struttura condivisa che una rete neurale possa imparare una volta e riutilizzare. Un pixel è un pixel in ogni foto. Una colonna chiamata score in un dataset finanziario e una colonna chiamata score in un dataset calcistico non hanno niente in comune.
Un noto articolo del 2022 di Léo Grinsztajn, Edouard Oyallon e Gaël Varoquaux, Why do tree-based models still outperform deep learning on tabular data?, lo ha testato su 45 dataset e ha rilevato che i modelli ad alberi, soprattutto il gradient boosting, battono ancora il deep learning su tabelle di medie dimensioni, attorno alle 10.000 righe. Le ragioni individuate sono:
Altri due problemi pratici peggiorano la situazione. Una singola tabella può mescolare numeri, categorie, ordinamenti e valori mancanti, e la maggior parte delle tabelle aziendali ha solo centinaia o migliaia di righe, troppo poche per una rete neurale addestrata da zero.
Direi che i dataset piccoli sono il problema più importante. Una rete neurale addestrata da zero su 800 righe non ha nulla su cui fare affidamento, mentre un albero non ha bisogno di conoscenze pregresse per funzionare.
È proprio questo che il pretraining ha risolto. Un modello foundation per tabellari ha già fatto pratica su milioni di tabelle piccole, disordinate e inventate prima di vedere la tua, quindi non parte da zero.
Un modello foundation per tabellari prende insieme le tue righe di training etichettate e le righe di test non etichettate come un unico input e predice le etichette mancanti in un singolo forward pass. I suoi pesi non cambiano mai, proprio come un LLM che risponde a una domanda dopo che gli hai fornito alcuni esempi nel prompt.
Questo cambia anche il significato dei metodi familiari di scikit-learn.
Quando chiami .fit() su TabICL, la documentazione di TabICL spiega che carica il checkpoint preaddestrato, preelabora i tuoi dati e li salva. Il lavoro vero avviene durante .predict().
Il nome .fit() resta per permettere al modello di integrarsi nel tuo codice scikit-learn esistente.
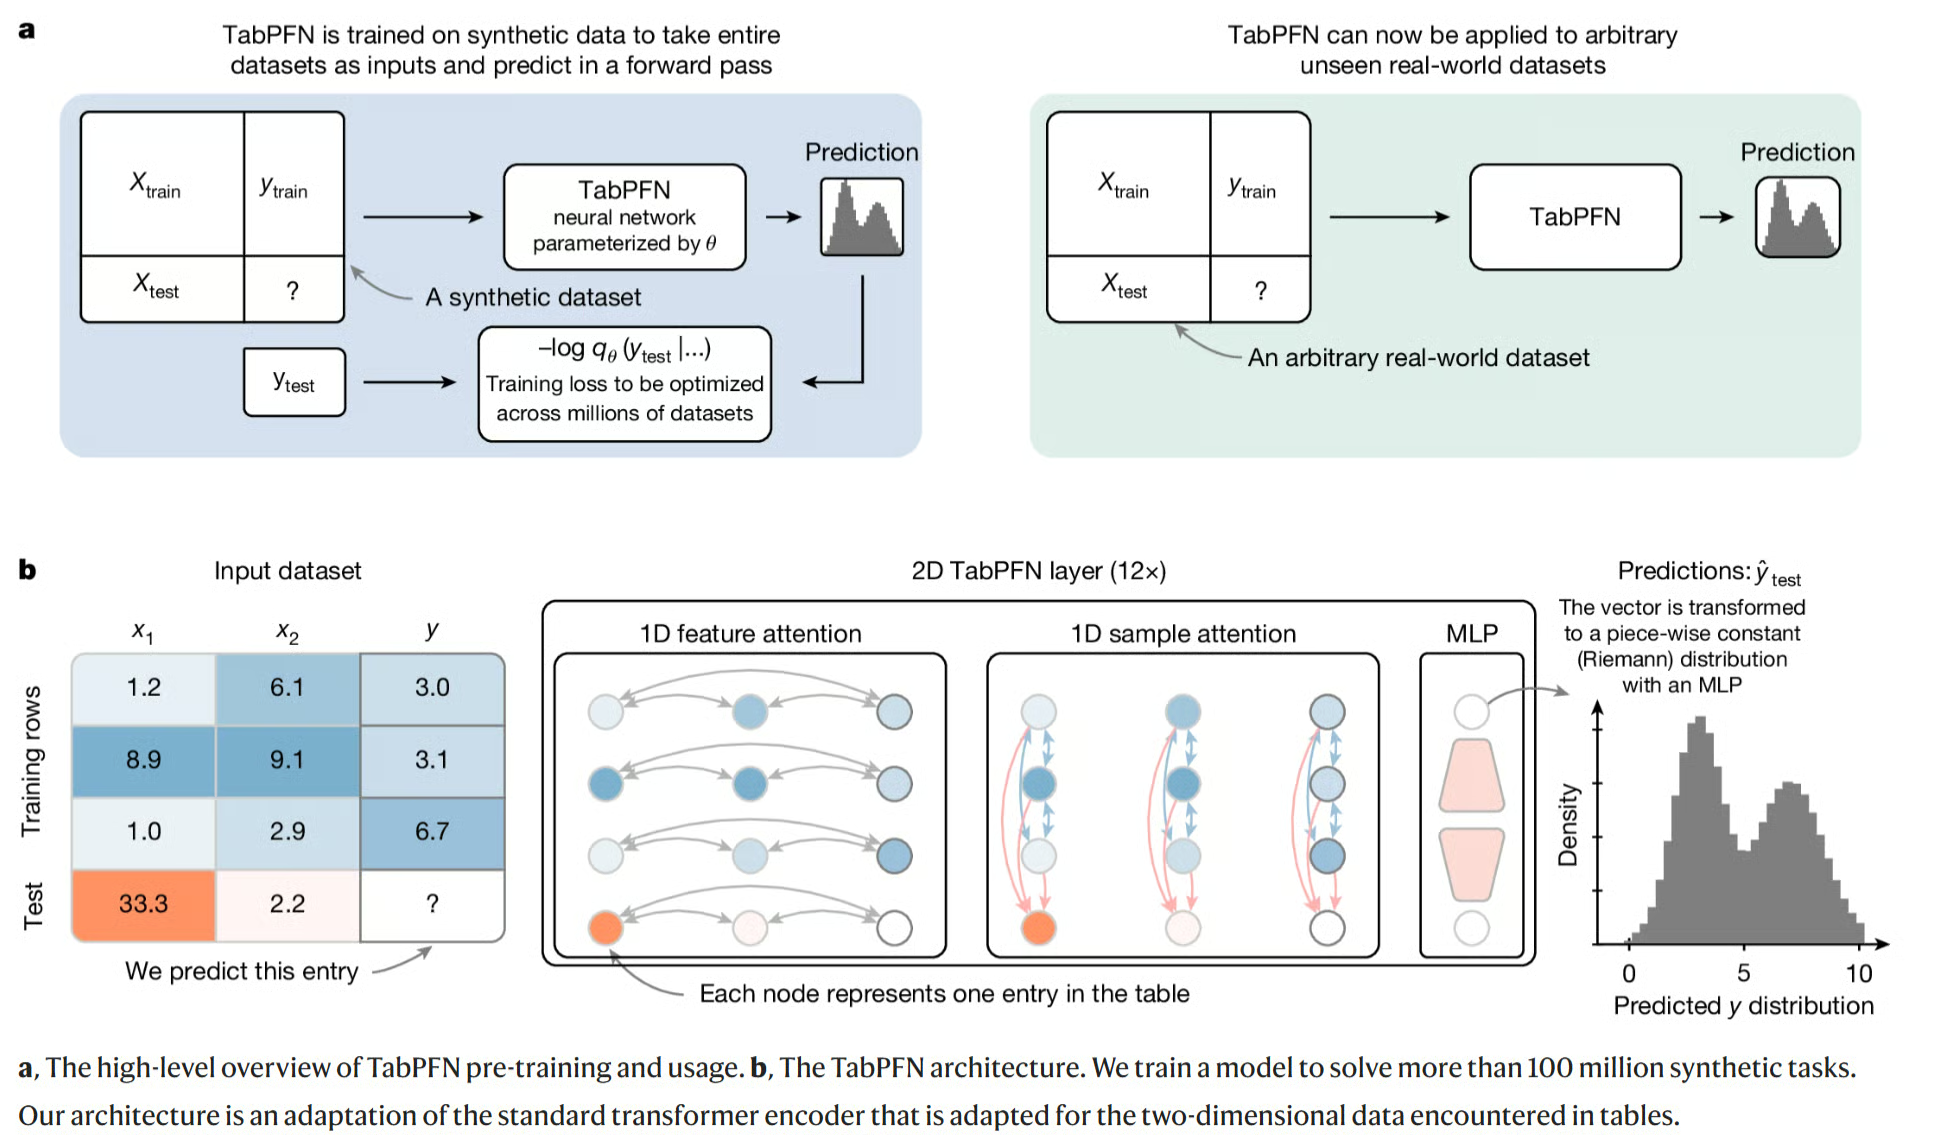
Figura 1: TabPFN è preaddestrato su milioni di dataset sintetici, poi predice su una tabella reale in un solo forward pass. Il pannello in basso mostra come esegue l’attenzione su feature e campioni. Fonte: Hollmann et al., “Accurate predictions on small data with a tabular foundation model”, Nature (2025).
Pretraining sintetico significa addestrare il modello su tabelle inventate, prodotte da un generatore di dati che funziona come un modello generativo.
Pensa a un pilota che si allena in un simulatore di volo. Il pilota prova migliaia di voli fittizi con meteo, aeroporti e guasti diversi, così che il primo volo reale non sembri nuovo.
TabPFN funziona in modo simile.
I suoi creatori hanno scritto un generatore che inventa regole causali casuali tra colonne (per esempio, la colonna A influenza la colonna B, che influenza il target), poi produce righe a partire da quelle regole.
Durante il pretraining, la colonna target è nascosta, il modello prova a prevederla e questo si ripete milioni di volte con regole, livelli di rumore e dimensioni della tabella diversi.
La cosa importante è che il modello non apprende mai fatti su argomenti reali. Impara abilità generali come individuare quali colonne contano, gestire gli outlier e sapere quando essere incerto.
Infatti, l’articolo su TabICLv2 attribuisce al suo nuovo generatore di dati sintetici una delle ragioni chiave delle migliori prestazioni.
Non serve capire ogni dettaglio delle architetture, ma aiuta sapere che esistono due principali approcci progettuali:
Nota che entrambe le famiglie sono addestrate su dati sintetici, quindi “prior-fitted network” descrive come sono addestrate più che un tipo di modello separato.
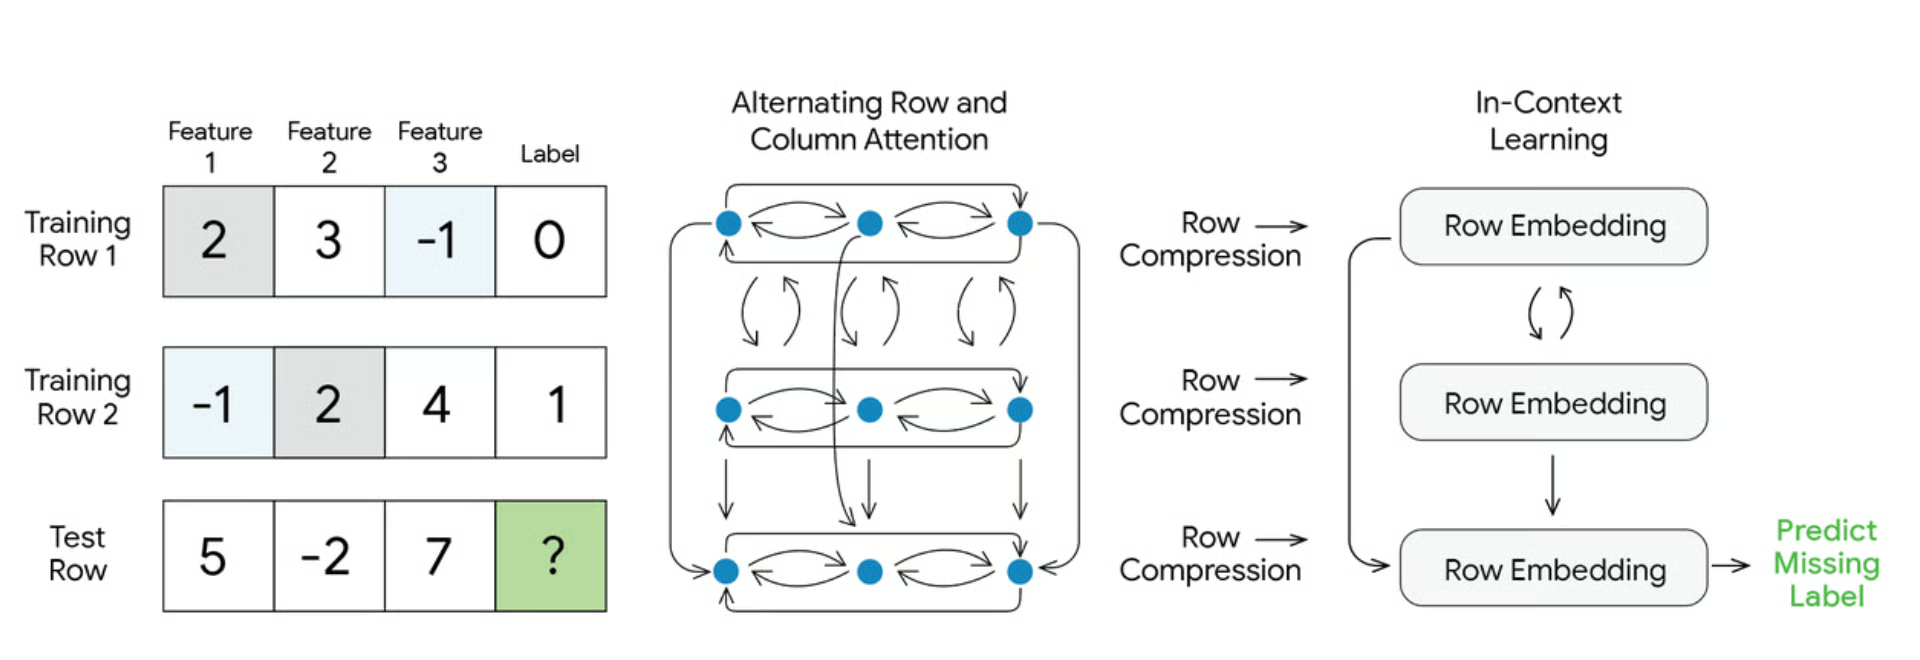
Figura 2: TabFM mescola entrambi i design: attenzione in stile TabPFN su righe e colonne, poi compressione delle righe in stile TabICL, quindi in-context learning per l’etichetta mancante. Fonte: Google Research, “Introducing TabFM: A zero-shot foundation model for tabular data” (2026).
C’è un compromesso che coglie di sorpresa molti.
XGBoost impiega tempo ad addestrarsi una volta, poi predice quasi istantaneamente.
Un modello foundation per tabellari salta l’addestramento, ma deve leggere tutte le tue righe di training ogni volta che predice.
Pensa a uno chef che non fa preparazioni prima del servizio ma deve rileggere tutto il ricettario per ogni ordine.
Con un ricettario piccolo va bene, ma man mano che il dataset cresce, le predizioni rallentano. Sia TabICL sia TabPFN possono mettere in cache la loro “lettura” dei dati di training per accelerare predizioni ripetute, ma il primo passaggio ha comunque un costo in tempo.
I modelli chiave nel 2026 sono TabPFN, TabICLv2, TabFM di Google, NEXUS di Fundamental e tabH2O di H2O.ai. Trovo interessante la rapidità con cui si è mosso il lato business: cinque mesi hanno portato quest’area dagli articoli accademici ad accordi importanti. Ecco una breve timeline:
Ora vediamoli uno per uno, partendo dal modello che ha dato il via a tutto.
TabPFN è il modello che ha creato questa categoria. TabPFN-2 è stato pubblicato su Nature a gennaio 2025 e ha superato i modelli ad alberi ottimizzati su dataset fino a 10.000 righe.
Da allora, Prior Labs ha rilasciato nuove versioni rapidamente. TabPFN-3 è arrivato a maggio 2026 e gestisce fino a 1 milione di righe (e fino a 200 feature). Ha anche aggiunto una Thinking mode (tramite la sua API a pagamento) che dedica più tempo alla fase di fitting per migliorare le previsioni.
L’ultima versione, TabPFN-3.5, è uscita a settembre 2026 e il suo rapporto tecnico rivendica il primo posto in diversi benchmark importanti, anche su dati ordinati nel tempo e raggruppati. Tratterei quei numeri come valori dell’azienda finché non verranno confermati da altri.
Un altro aspetto è la licenza. TabPFN-2 può essere usato commercialmente purché si citi Prior Labs, ma le versioni dalla 2.5 alla 3.5 sono non commerciali. Significa che puoi sperimentarci gratuitamente, ma per usarle in un prodotto reale serve una licenza a pagamento.
TabICLv2 è il miglior modello totalmente open per dati tabellari al momento. È stato sviluppato a Inria, rilasciato a febbraio 2026 e accettato a ICML 2026.
Il risultato principale dell’articolo su TabICLv2 è che, senza alcun tuning, ha superato RealTabPFN-2.5, il precedente miglior modello, benché quest’ultimo fosse stato ottimizzato, messo in ensemble e fine-tunato su dati reali.
Secondo il suo repository su GitHub, supera anche XGBoost, CatBoost e LightGBM pesantemente ottimizzati su circa l’80% dei dataset nel benchmark TabArena.
È anche veloce: gestisce 50.000 righe con 100 feature in meno di 10 secondi su una GPU H100, circa 10 volte più rapido di TabPFN-2.5.
Rende al meglio tra 300 e 100.000 righe e può spingersi fino a circa 500.000 righe con una certa perdita di accuratezza.
A mio avviso, è quello da cui la maggior parte dei lettori dovrebbe partire.
Si installa con pip install tabicl, funziona come un qualunque modello scikit-learn e la sua licenza permissiva ti consente l’uso commerciale senza registrazioni. La classifica però cambia in fretta e il report di TabPFN-3.5 ora si colloca davanti a TabICLv2.
TabFM è il modello foundation per tabellari di Google Research, rilasciato il 30 giugno 2026. La sua particolarità è dove puoi usarlo: è integrato in BigQuery, il data warehouse cloud di Google, così puoi ottenere previsioni con semplice SQL.
-- Use past customers (with known churn) to predict churn for new customers
-- AI.PREDICT is in preview, so check the BigQuery docs for the latest syntax
SELECT *
FROM AI.PREDICT(
  TABLE my_dataset.customers_history,
  TABLE my_dataset.customers_new,
  label_col => 'churned'
);
È ottimo per chi conosce SQL ma non Python.
Tuttavia, la documentazione di BigQuery al momento ti limita a 20 colonne di feature e 10 classi, e Google prevede di aggiungere un pricing a token oltre alle tariffe standard di BigQuery dal 30 ottobre 2026. I pesi del modello su Hugging Face sono non commerciali, quindi l’uso commerciale passa da BigQuery.
NEXUS è un modello chiuso, solo per aziende, di Fundamental, startup di San Francisco fondata da ex ricercatori di DeepMind. È stato lanciato a febbraio 2026 con 255 milioni di dollari di finanziamento, e l’azienda lo definisce un Large Tabular Model (LTM).
Le aziende acquistano ed eseguono NEXUS tramite AWS, e Fundamental afferma che aziende Fortune 100 lo usano già per previsioni di domanda, pricing e churn dei clienti. Tuttavia, non ci sono pesi pubblici o benchmark verificabili in autonomia, quindi lo tratterei come un’opzione enterprise.
tabH2O è il modello di H2O.ai e la sua idea è semplice: invia i tuoi dati, ricevi le previsioni.
Gestisce per te valori mancanti e categorie e può girare sui server interni di un’azienda, cosa importante per banche e ospedali che non possono inviare dati nel cloud.
Apprezzo che l’articolo su tabH2O non lo sopravvaluti. Ha superato CatBoost e LightGBM ottimizzati nel benchmark TALENT, ma è comunque rimasto dietro TabICLv2.
| Modello | Creatore | Pesi aperti? | Scala massima | Licenza | Ideale per |
|---|---|---|---|---|---|
| TabPFN-2 | Prior Labs | Sì | 10K righe | Commerciale con attribuzione | Uso commerciale di un modello collaudato più vecchio |
| TabPFN-3 / 3.5 | Prior Labs (SAP) | Sì, previa accettazione di una licenza | Fino a 1M di righe | Non commerciale, API a pagamento per il business | Massima accuratezza e ricerca |
| TabICLv2 | Inria | Sì | Ottimale fino a 100K righe | Open source permissiva | Il tuo punto di partenza predefinito |
| TabFM | Google Research | Sì | 20 feature in BigQuery | Pesi non commerciali | Utenti SQL su BigQuery |
| NEXUS | Fundamental | No | Non divulgato | Proprietaria | Grandi aziende su AWS |
| tabH2O | H2O.ai | No | Non divulgato | API commerciale | Team senza setup ML, agenti AI |
Si usa esattamente come qualunque altro modello scikit-learn.
Il modo migliore per capire cosa offre è metterlo testa a testa con XGBoost, quindi facciamolo sul dataset sul cancro al seno integrato in scikit-learn.
Per prima cosa, installiamo i pacchetti:
pip install tabicl xgboost scikit-learnPoi eseguiamo entrambi i modelli sullo stesso split:
from sklearn.datasets import load_breast_cancer
from sklearn.metrics import accuracy_score
from sklearn.model_selection import train_test_split
from tabicl import TabICLClassifier
from xgboost import XGBClassifier

# Load a small tabular dataset as a pandas DataFrame
X, y = load_breast_cancer(return_X_y=True, as_frame=True)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, stratify=y, random_state=42
)

# Tabular foundation model: fit() just stores the training rows
tfm = TabICLClassifier()
tfm.fit(X_train, y_train)
tfm_preds = tfm.predict(X_test)

# XGBoost baseline with reasonable, untuned settings
xgb = XGBClassifier(n_estimators=300, learning_rate=0.05, max_depth=4)
xgb.fit(X_train, y_train)
xgb_preds = xgb.predict(X_test)

print(f"TabICL accuracy:  {accuracy_score(y_test, tfm_preds):.3f}")
print(f"XGBoost accuracy: {accuracy_score(y_test, xgb_preds):.3f}")
Questo piccolo dataset gira senza problemi su una normale CPU da laptop.
Entrambi i modelli otterranno punteggi molto alti su un dataset così pulito, quindi per favore non giudicarli da uno solo split. Il vero test saranno i tuoi dati disordinati.
Se vuoi provare invece TabPFN, esegui pip install tabpfn, poi basta cambiare due righe:
from tabpfn import TabPFNClassifier

tfm = TabPFNClassifier()  # The first run asks you to accept the license
tfm.fit(X_train, y_train)
tfm_preds = tfm.predict(X_test)
Un punto importante prima di confrontare i modelli su dati reali.
Se i tuoi dati hanno date, dividili nel tempo invece che a caso. Altrimenti, il modello sbircia nel futuro e, come vedrai nella prossima sezione, è proprio lì che i modelli foundation per tabellari sembrano migliori di quanto siano davvero.
I modelli foundation per tabellari funzionano bene quando il tuo dataset è piccolo o medio e le righe di test assomigliano a quelle di training. Faticano con dati ordinati nel tempo, dati raggruppati, tabelle molto grandi e requisiti stringenti di spiegabilità.
Questa idea che “le righe di test assomigliano a quelle di training” ha un nome, IID (indipendenti e identicamente distribuite), ed è la singola cosa più importante da verificare sui tuoi dati.
Partiamo da dove funzionano bene:
Ora i limiti, che a mio avviso contano di più se pensi di usarli in un progetto reale.
Il benchmark BeyondArena, rilasciato a giugno 2026, ha testato 11 modelli su 142 dataset, inclusi quelli divisi nel tempo (predire il futuro dal passato) e per gruppo (predire per un nuovo ospedale o paese).
Ha rilevato che i modelli foundation per tabellari rendono al meglio su dati IID piccoli e medi, mentre modelli ad alberi e altri modelli di deep learning sono ancora in testa su dati ordinati nel tempo, raggruppati, grandi e molto larghi. Poiché la maggior parte dei dati aziendali (vendite, frodi, churn) è ordinata nel tempo, questo limite emerge in molti progetti reali.
TabPFN-3.5, rilasciato dopo BeyondArena, sostiene specificamente di colmare questo gap su dati ordinati nel tempo e raggruppati. È promettente, ma non è ancora stato testato in modo indipendente.
Puoi ottenere valori SHAP sia da TabICL sia da TabPFN, ma serve molto più tempo rispetto a SHAP su un modello ad alberi, e non ci sono split di alberi da ispezionare. In ambiti come il credit scoring, dove i regolatori devono comprendere il modello, questo è un problema concreto.
Oltre poche migliaia di righe serve davvero una GPU e le predizioni rallentano man mano che i dati di training crescono. Un modello XGBoost addestrato su CPU vincerà sempre in velocità.
TabPFN-2 è commerciale con attribuzione, le versioni più recenti di TabPFN sono non commerciali, i pesi di TabFM sono non commerciali e TabICLv2 è permissivo.
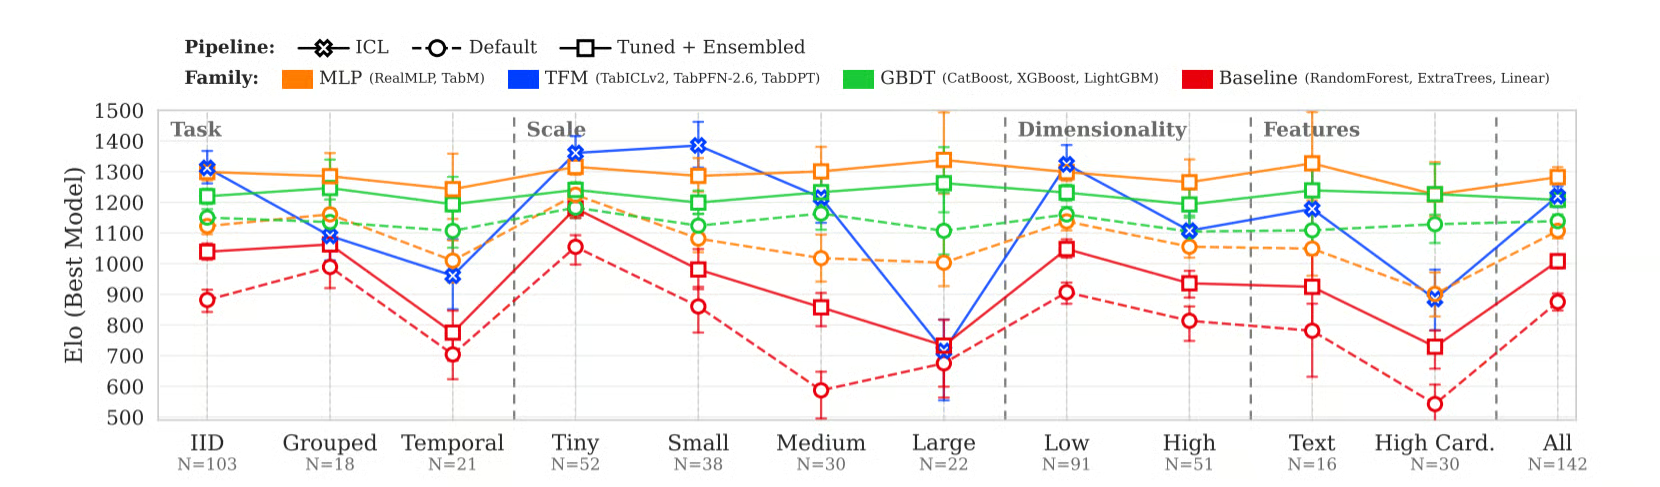
Figura 3: Elo per famiglia di modelli (più alto è meglio). I modelli foundation per tabellari guidano su dati IID piccoli ma calano su dataset temporali e grandi, dove alberi e MLP reggono meglio. Il blu indica il migliore tra TabICLv2, TabPFN-2.6 e TabDPT, non le versioni più recenti di TabPFN. Fonte: Purucker et al., “Beyond IID: How General Are Tabular Foundation Models, Really?” (2026), CC BY 4.0.
Spero converrai che i modelli foundation per tabellari hanno alzato l’asticella di quanto possa essere buono un baseline rapido e senza sforzo, ma i modelli ad alberi restano spesso la scelta migliore in molte situazioni reali.
Dovresti usarlo quando il tuo dataset è piccolo o medio e IID, e non ti serve un modello pienamente spiegabile o predizioni molto veloci su CPU. Ecco la tabella decisionale che userei:
| Scenario | Approccio consigliato |
|---|---|
| Meno di 10K righe, IID, nessun requisito di spiegabilità | Inizia con TabICLv2 o TabPFN |
| Da 10K a 100K righe, IID | Prova TabICLv2 e XGBoost, tieni il vincitore |
| Da 100K a 1M di righe | Parti con XGBoost o LightGBM, prova TabPFN-3 come challenger |
| Dati divisi nel tempo o per gruppo | Punta prima sui modelli ad alberi |
| Servono SHAP, feature importance o audit | Modello ad alberi con SHAP |
| Predizioni veloci senza GPU | Modello ad alberi |
| Proof of concept rapida, nessun setup ML | TabICLv2, o BigQuery AI.PREDICT se i tuoi dati sono già lì |
| Agente AI che deve fare previsioni da tabelle | Un’API come tabH2O o NEXUS |
Prima di scegliere un modello, ti suggerisco di porti queste tre domande:
E l’ultimo punto che vorrei sottolineare è questo. Esegui prima un modello foundation per tabellari, perché ti costa solo pochi minuti. Se non riesce a battere XGBoost sui tuoi dati, sai che vale la pena investire tempo in feature engineering e tuning di XGBoost.
Ricordi i due studenti all’inizio dell’articolo? Nel 2026, il secondo, quello che ha fatto pratica su milioni di esami, può finalmente battere quello che ha studiato per settimane, almeno su tabelle piccole e medie.
I modelli foundation per tabellari sostituiscono l’addestramento per dataset con il pretraining e sostituiscono fit() con l’apprendimento dagli esempi.
Ciò che mi sorprende di più è la rapidità con cui questo dominio è migliorato. TabPFN-2 ha mostrato per primo nel 2025 che una rete neurale poteva superare alberi ottimizzati su tabelle piccole e TabICLv2 e TabPFN-3 hanno poi esteso il risultato a tabelle molto più grandi.
I problemi aperti ora sono dati ordinati nel tempo, dati che cambiano, spiegabilità e licenze, esattamente le cose che decidono se un modello arriva in un prodotto reale.
Il mio consiglio è quindi di considerare questi modelli come il tuo nuovo punto di partenza e scegliere lo strumento finale in base ai tuoi dati, ai tuoi vincoli e a dove il modello verrà eseguito.
E se vuoi padroneggiare i modelli ad alberi che vincono ancora in molte situazioni reali, dai un’occhiata al nostro corso Machine Learning with Tree-Based Models in Python e al percorso Supervised Machine Learning in Python. Se lavori in R, Machine Learning with Tree-Based Models in R copre gli stessi argomenti.
I migliori corsi DataCamp
Programma
Corso
Programma
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min