Programa
Desenvolvimento de modelos de idiomas grandes
16 h
Imagine dois alunos fazendo a mesma prova. O primeiro passa três semanas estudando só um módulo, enquanto o segundo já praticou em milhões de provas diferentes e, no dia, recebe uma folha com exemplos resolvidos.
Durante a maior parte da história do machine learning, os modelos para dados tabulares foram como o primeiro aluno. Cada novo dataset exigia limpar colunas, criar features, treinar XGBoost ou LightGBM e ajustar hiperparâmetros por horas.
Tabular foundation models, por outro lado, são como o segundo aluno: você fornece linhas rotuladas como exemplos e eles preveem o restante com zero de treinamento.
Em 2026, essa ideia saiu dos papers e virou produto de verdade, com a SAP comprometendo mais de €1 bilhão com a Prior Labs e o Google lançando seu próprio modelo. Neste artigo, vamos ver:
Não se preocupe se você não tem muita experiência com deep learning. O código aqui usa a interface familiar do scikit-learn e, se quiser um aquecimento rápido, 8 modelos de machine learning explicados em 20 minutos cobre o básico.
pip install tabicl.Um tabular foundation model é uma rede neural pré-treinada em milhões de datasets tabulares sintéticos que aprende uma estratégia geral para prever a coluna alvo e aplica essa estratégia a uma nova tabela por meio de in-context learning, sem treinamento específico por dataset.
A grande mudança aqui é quando o aprendizado acontece.
Com XGBoost, o aprendizado acontece nos seus dados toda vez que você treina um novo modelo. Com um foundation model tabular, o aprendizado ocorreu meses atrás, durante o pré-treinamento, e seus dados são apenas a entrada. Você também vai ver alguns termos recorrentes, então vamos explicá-los de forma simples:
Agora, vamos comparar esses modelos com os métodos de boosting e com AutoML:
| Tabular foundation models | Árvores com gradient boosting (XGBoost, LightGBM) | AutoML (AutoGluon, H2O AutoML) | |
|---|---|---|---|
| Tempo de treino em novos dados | Nenhum | Segundos a minutos, mais tuning | Minutos a horas |
| Interpretabilidade | Limitada (SHAP é possível, mas lento) | Boa (importância de features, SHAP rápido) | Varia; ensembles difíceis de ler |
| Tamanho ideal do dataset | Centenas até ~100K linhas | Milhares até muitos milhões de linhas | Milhares até milhões de linhas |
| Precisa de GPU? | Recomendado acima de poucas milhares de linhas | Não | Geralmente não |
| Datasets pequenos com split aleatório | Melhor nos benchmarks atuais | Forte quando ajustado | Forte, porém lento |
Antes de ver como eles funcionam, quero compará-los rapidamente aos modelos mais famosos e usados: os large language models.
Large language models (LLMs) e tabular foundation models usam transformers e ambos aprendem com exemplos na entrada.
A diferença está no que foram feitos para ler. Um LLM lê uma tabela como uma longa string de texto, então precisa deduzir por vírgulas e espaços quais números pertencem à mesma coluna.
Há também um problema de significado.
O valor 42 pode ser idade de alguém ou uma receita, mas o número em si não diz qual. Um tabular foundation model é treinado para tratar cada coluna como uma variável e cada linha como um exemplo, focando em como as colunas se relacionam.
Eu gosto de pensar assim: um LLM é ótimo para falar sobre seus dados, e um tabular foundation model é feito para fazer a conta neles.
Os dois também podem trabalhar juntos — exatamente como a H2O.ai posiciona o tabH2O: a ferramenta de previsão que um agente de IA chama quando precisa de um número de uma planilha.
Dados tabulares eram difíceis para deep learning porque tabelas não têm uma estrutura compartilhada que uma rede neural possa aprender uma vez e reutilizar. Um pixel é um pixel em toda foto. Uma coluna chamada score em finanças e uma coluna score em futebol não têm nada em comum.
Um paper conhecido de 2022, de Léo Grinsztajn, Edouard Oyallon e Gaël Varoquaux, Why do tree-based models still outperform deep learning on tabular data?, testou 45 datasets e concluiu que modelos baseados em árvores, especialmente gradient boosting, ainda venciam deep learning em tabelas médias de ~10.000 linhas. Os motivos:
Dois problemas práticos pioram isso. Uma única tabela pode misturar números, categorias, rankings e valores ausentes, e a maioria das tabelas de negócios tem só centenas ou milhares de linhas — muito pouco para treinar uma rede do zero.
Eu diria que datasets pequenos são o maior problema. Uma rede neural treinada do zero em 800 linhas não tem em que se apoiar, enquanto uma árvore não precisa de conhecimento prévio para funcionar.
É exatamente isso que o pré-treinamento resolveu. Um tabular foundation model já praticou em milhões de tabelas pequenas, bagunçadas e sintéticas antes de ver a sua, então ele não começa do zero.
Um tabular foundation model recebe suas linhas de treino rotuladas e suas linhas de teste sem rótulo juntas como uma única entrada e prevê os rótulos faltantes em um único forward pass. Seus pesos não mudam, como um LLM respondendo a uma pergunta após receber alguns exemplos no prompt.
Isso também muda o significado dos métodos familiares do scikit-learn.
Quando você chama .fit() no TabICL, a documentação do TabICL explica que ele carrega o checkpoint pré-treinado, pré-processa seus dados e os armazena. O trabalho pesado acontece no .predict().
O nome .fit() fica para encaixar no seu código atual do scikit-learn.
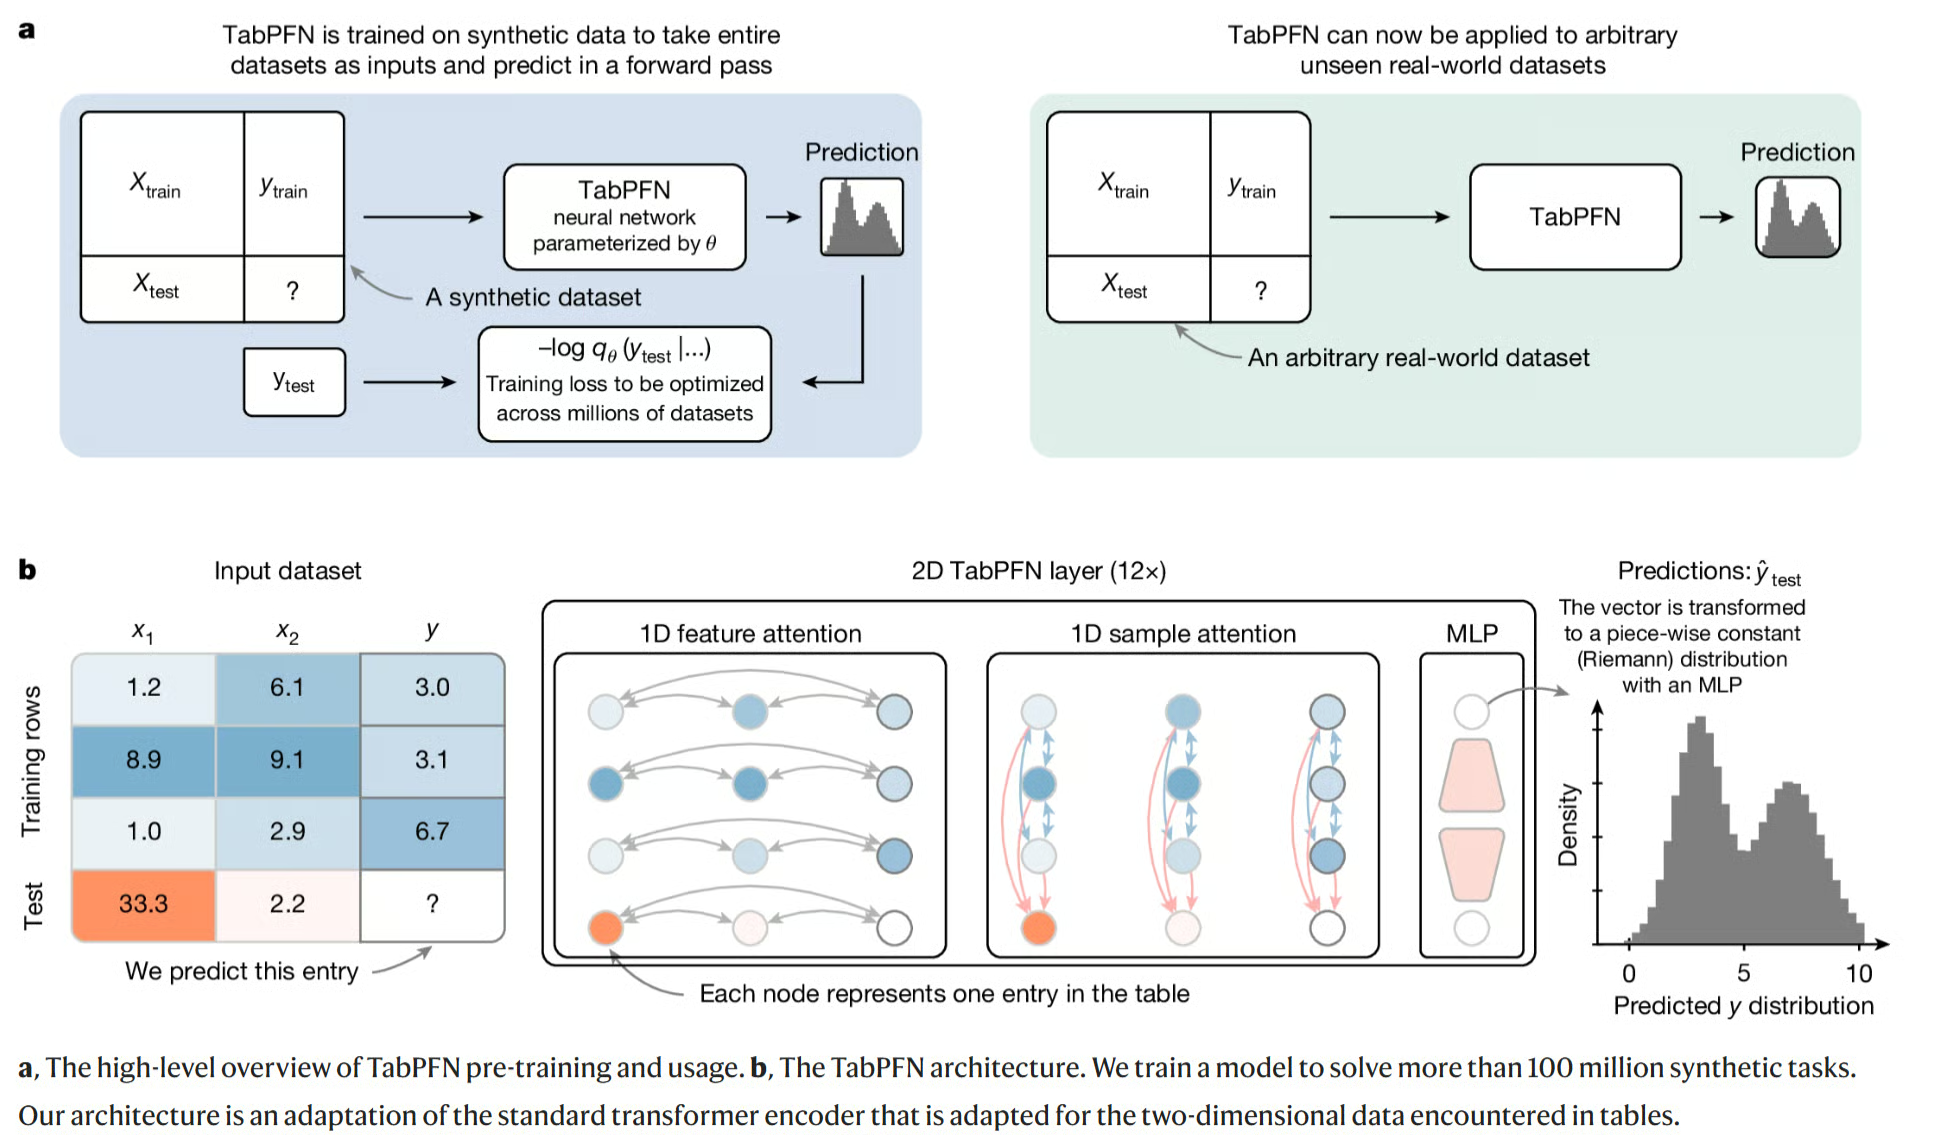
Figura 1: TabPFN é pré-treinado em milhões de datasets sintéticos e depois prevê em uma tabela real em um forward pass. O painel inferior mostra como ele atende a features e amostras. Fonte: Hollmann et al., “Accurate predictions on small data with a tabular foundation model”, Nature (2025).
Pré-treinamento sintético significa treinar o modelo em tabelas artificiais, produzidas por um gerador que funciona como um modelo generativo.
Pense em um piloto treinando em simulador. Ele pratica milhares de voos falsos com climas, aeroportos e falhas diferentes, para que o primeiro voo real não pareça novidade.
O TabPFN funciona de forma parecida.
Seus criadores escreveram um gerador que inventa regras aleatórias de “causa e efeito” entre colunas (por exemplo, a coluna A afeta a B, que afeta o alvo) e depois produz linhas a partir dessas regras.
Durante o pré-treinamento, a coluna alvo é escondida, o modelo tenta prevê-la e isso se repete milhões de vezes com regras, níveis de ruído e tamanhos de tabela diferentes.
O importante é que o modelo não aprende fatos sobre nenhum tema real. Ele aprende habilidades gerais como identificar quais colunas importam, lidar com outliers e saber quando estar inseguro.
Aliás, o artigo do TabICLv2 credita seu novo gerador sintético como um dos motivos do ganho de performance.
Você não precisa entender cada detalhe das arquiteturas, mas ajuda saber que há dois desenhos principais:
Note que ambas as famílias são treinadas em dados sintéticos, então “prior-fitted network” descreve o jeito de treinar, não um tipo de modelo separado.
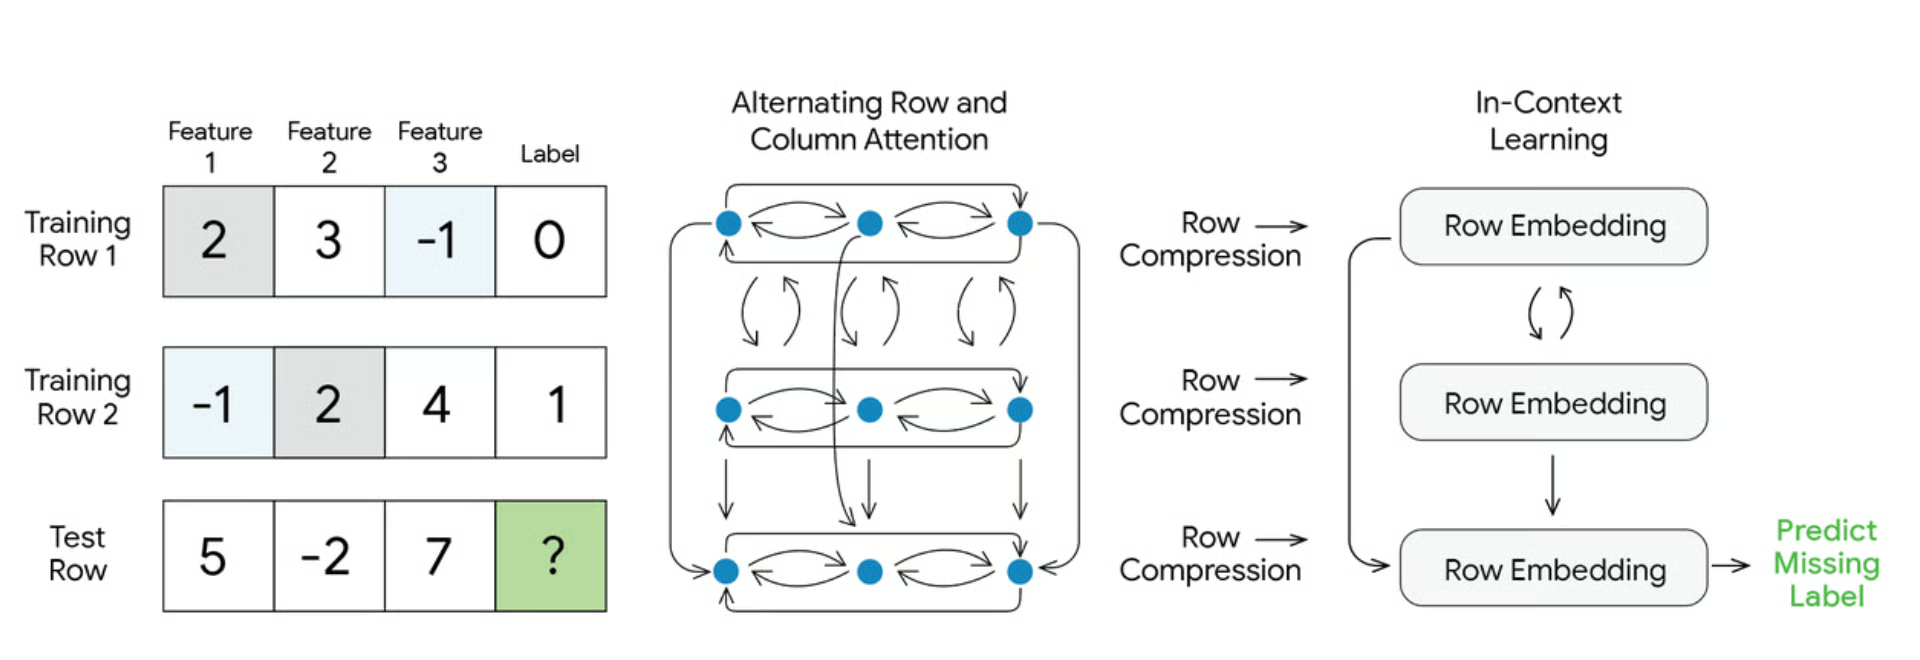
Figura 2: TabFM mistura os dois desenhos: atenção estilo TabPFN por linhas e colunas, depois compressão de linhas ao estilo TabICL e então in-context learning para o rótulo faltante. Fonte: Google Research, “Introducing TabFM: A zero-shot foundation model for tabular data” (2026).
Existe um trade-off que pega muita gente de surpresa.
O XGBoost gasta tempo treinando uma vez e depois prevê quase instantaneamente.
Um tabular foundation model pula o treino, mas precisa ler todas as suas linhas de treinamento a cada previsão.
Pense em um chef que não faz mise en place, mas precisa reler o livro de receitas inteiro a cada pedido.
Com um livro fino, tudo bem; conforme o dataset cresce, as previsões ficam mais lentas. Tanto TabICL quanto TabPFN podem fazer cache da “leitura” dos dados de treino para acelerar previsões repetidas, mas a primeira passada ainda custa tempo.
Os principais modelos em 2026 são TabPFN, TabICLv2, TabFM do Google, NEXUS da Fundamental e tabH2O da H2O.ai. O que me chama atenção é a velocidade do movimento de negócio: em cinco meses, essa área foi de papers acadêmicos a grandes acordos. Linha do tempo:
Agora vamos passar por cada um, começando pelo modelo que iniciou tudo.
O TabPFN criou essa categoria. O TabPFN-2 saiu na Nature em janeiro de 2025 e superou árvores ajustadas em datasets de até 10.000 linhas.
Desde então, a Prior Labs lançou novas versões rapidamente. O TabPFN-3 chegou em maio de 2026 e suporta até 1 milhão de linhas (e até 200 features). Também adicionou um Thinking mode (via API paga) que gasta mais tempo na etapa de fitting para melhorar as previsões.
A versão mais recente, TabPFN-3.5, saiu em setembro de 2026 e seu relatório técnico reivindica o primeiro lugar em vários benchmarks importantes, incluindo dados ordenados no tempo e agrupados. Eu trataria esses números como da própria empresa até haver confirmações independentes.
Mais um ponto é a licença. O TabPFN-2 pode ser usado comercialmente com atribuição à Prior Labs, mas as versões 2.5 a 3.5 são não comerciais. Ou seja, dá para experimentar de graça, mas uso em produto exige licença paga.
O TabICLv2 é hoje o melhor modelo tabular totalmente aberto. Foi desenvolvido no Inria, lançado em fevereiro de 2026 e aceito no ICML 2026.
O resultado principal do paper do TabICLv2 é que, sem qualquer tuning, ele superou o RealTabPFN-2.5, o modelo anterior de referência, mesmo este tendo sido ajustado, ensembled e fine-tunado em dados reais.
Segundo o repositório no GitHub, ele também supera XGBoost, CatBoost e LightGBM fortemente ajustados em cerca de 80% dos datasets no benchmark TabArena.
Ele também é rápido: lida com 50.000 linhas e 100 features em menos de 10 segundos em uma GPU H100, cerca de 10 vezes mais rápido que o TabPFN-2.5.
Funciona melhor entre 300 e 100.000 linhas e pode ir até ~500.000 com alguma perda de acurácia.
Na minha opinião, é por aqui que a maioria deveria começar.
Instala com pip install tabicl, funciona como qualquer modelo do scikit-learn e a licença permissiva permite uso comercial sem cadastro. O ranking muda rápido, porém, e o relatório do TabPFN-3.5 agora se coloca à frente do TabICLv2.
O TabFM é o modelo tabular do Google Research, lançado em 30 de junho de 2026. O diferencial é onde você pode usá-lo: ele está embutido no BigQuery, o data warehouse em nuvem do Google, então você obtém previsões com SQL puro.
-- Use clientes passados (com churn conhecido) para prever o churn de novos clientes
-- AI.PREDICT está em preview; consulte a documentação do BigQuery para a sintaxe mais recente
SELECT *
FROM AI.PREDICT(
  TABLE my_dataset.customers_history,
  TABLE my_dataset.customers_new,
  label_col => 'churned'
);
É ótimo para quem sabe SQL, mas não Python.
Porém, a documentação do BigQuery atualmente limita a 20 colunas de features e 10 classes, e o Google planeja cobrar por tokens além das taxas padrão do BigQuery a partir de 30 de outubro de 2026. Os pesos no Hugging Face são não comerciais, então uso comercial acontece via BigQuery.
O NEXUS é um modelo fechado, para empresas, da Fundamental, startup de São Francisco fundada por ex-pesquisadores da DeepMind. Lançado em fevereiro de 2026 com US$ 255 milhões, a empresa o chama de Large Tabular Model (LTM).
Empresas compram e rodam o NEXUS na AWS, e a Fundamental afirma que empresas da Fortune 100 já o usam para previsão de demanda, precificação e churn. Não há pesos públicos nem benchmarks verificáveis, então eu trataria como uma opção enterprise.
O tabH2O é o modelo da H2O.ai, com uma proposta direta: você envia os dados e recebe as previsões.
Ele trata valores ausentes e categorias para você e pode rodar nos servidores da própria empresa, algo importante para bancos e hospitais que não podem enviar dados para a nuvem.
Gosto do fato de que o paper do tabH2O não exagera. Ele superou CatBoost e LightGBM ajustados no benchmark TALENT, mas ainda ficou atrás do TabICLv2.
| Modelo | Criador | Pesos abertos? | Escala máxima | Licença | Melhor para |
|---|---|---|---|---|---|
| TabPFN-2 | Prior Labs | Sim | 10K linhas | Comercial com atribuição | Uso comercial de um modelo mais antigo e comprovado |
| TabPFN-3 / 3.5 | Prior Labs (SAP) | Sim, mediante aceite de licença | Até 1M de linhas | Não comercial, API paga para negócios | Melhor acurácia e pesquisa |
| TabICLv2 | Inria | Sim | Melhor até 100K linhas | Open source permissiva | Seu ponto de partida padrão |
| TabFM | Google Research | Sim | 20 features no BigQuery | Pesos não comerciais | Usuários de SQL no BigQuery |
| NEXUS | Fundamental | Não | Não divulgado | Proprietária | Grandes empresas na AWS |
| tabH2O | H2O.ai | Não | Não divulgado | API comercial | Times sem setup de ML, agentes de IA |
Você usa um tabular foundation model em Python exatamente como qualquer modelo do scikit-learn.
A melhor forma de enxergar seu valor é colocá-lo frente a frente com o XGBoost. Vamos fazer isso no dataset de câncer de mama do scikit-learn.
Primeiro, instale os pacotes:
pip install tabicl xgboost scikit-learnDepois, rode ambos os modelos no mesmo split:
from sklearn.datasets import load_breast_cancer
from sklearn.metrics import accuracy_score
from sklearn.model_selection import train_test_split
from tabicl import TabICLClassifier
from xgboost import XGBClassifier

# Carregue um dataset tabular pequeno como DataFrame do pandas
X, y = load_breast_cancer(return_X_y=True, as_frame=True)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, stratify=y, random_state=42
)

# Tabular foundation model: fit() só armazena as linhas de treino
tfm = TabICLClassifier()
tfm.fit(X_train, y_train)
tfm_preds = tfm.predict(X_test)

# Baseline XGBoost com configurações razoáveis, sem tuning
xgb = XGBClassifier(n_estimators=300, learning_rate=0.05, max_depth=4)
xgb.fit(X_train, y_train)
xgb_preds = xgb.predict(X_test)

print(f"TabICL accuracy:  {accuracy_score(y_test, tfm_preds):.3f}")
print(f"XGBoost accuracy: {accuracy_score(y_test, xgb_preds):.3f}")
Esse dataset pequeno roda bem em uma CPU de notebook comum.
Ambos os modelos terão pontuações altíssimas em algo tão limpo, então não julgue por um único split. O teste real serão os seus dados bagunçados.
Se quiser testar o TabPFN, rode pip install tabpfn e mude só duas linhas:
from tabpfn import TabPFNClassifier

tfm = TabPFNClassifier()  # Na primeira execução, você precisa aceitar a licença
tfm.fit(X_train, y_train)
tfm_preds = tfm.predict(X_test)
Um ponto importante antes de comparar modelos em dados reais.
Se seus dados têm datas, faça o split por tempo em vez de aleatório. Caso contrário, o modelo espia o futuro e, como você verá a seguir, é justamente aí que tabular foundation models parecem melhores do que realmente são.
Tabular foundation models vão bem quando o dataset é pequeno a médio e as linhas de teste se parecem com as de treino. Eles sofrem com dados ordenados no tempo, agrupados, tabelas muito grandes e exigências rígidas de explicabilidade.
Essa ideia de “linhas de teste se parecem com as de treino” tem nome: IID (independentes e identicamente distribuídas) e é o ponto mais importante para checar nos seus dados.
Começando pelo que funciona bem:
Agora, as limitações, que importam mais se você pretende usar em projeto real.
O benchmark BeyondArena, lançado em junho de 2026, testou 11 modelos em 142 datasets, incluindo splits por tempo (prever o futuro a partir do passado) e por grupo (prever para um novo hospital ou país).
O estudo concluiu que tabular foundation models vão melhor em dados IID pequenos e médios, enquanto modelos baseados em árvores e outros de deep learning ainda lideram em dados temporais, agrupados, grandes e muito largos. Como a maior parte dos dados de negócio (vendas, fraude, churn) é ordenada no tempo, essa limitação aparece em muitos projetos reais.
O TabPFN-3.5, lançado após o BeyondArena, afirma especificamente fechar essa lacuna em dados temporais e agrupados. É promissor, mas ainda não foi testado de forma independente.
Você pode obter valores SHAP tanto do TabICL quanto do TabPFN, mas leva bem mais tempo do que o SHAP em modelos de árvore, e não há splits de árvore para inspecionar. Em áreas como crédito, onde reguladores precisam entender o modelo, isso é um problema real.
Acima de algumas milhares de linhas, uma GPU ajuda bastante, e as previsões ficam mais lentas conforme os dados de treino crescem. Um XGBoost treinado em CPU vai ganhar em velocidade sempre.
TabPFN-2 é comercial com crédito, versões mais novas do TabPFN são não comerciais, os pesos do TabFM são não comerciais e o TabICLv2 é permissivo.
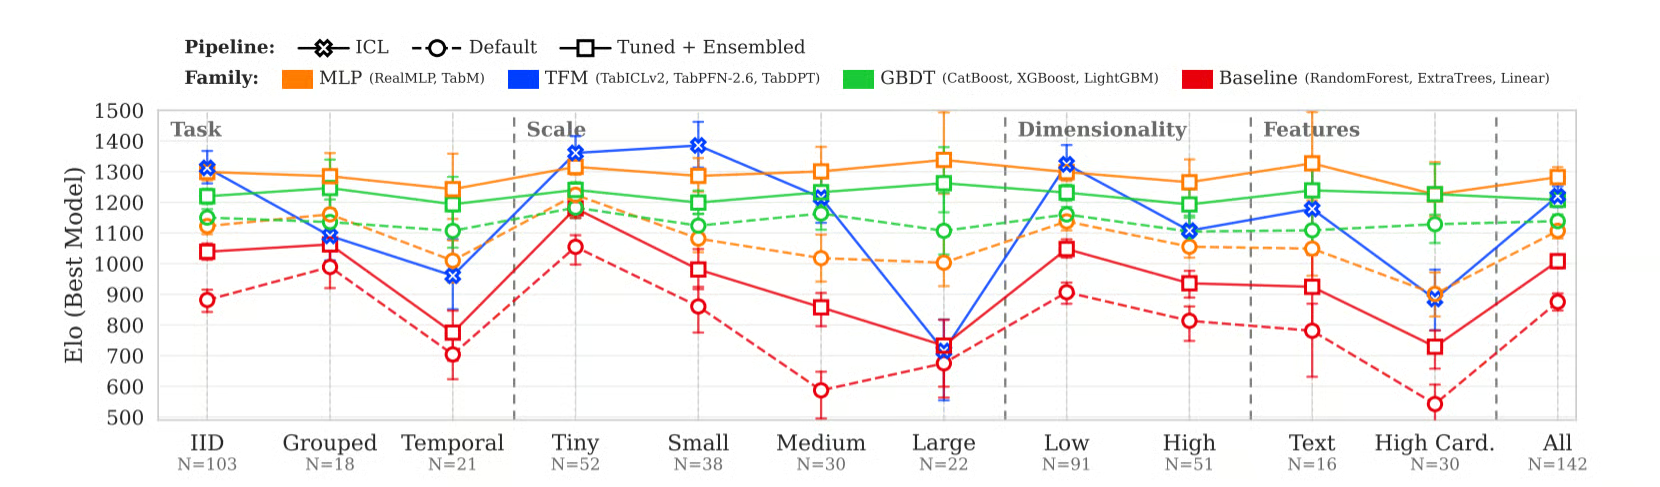
Figura 3: Elo por família de modelos (quanto maior, melhor). Tabular foundation models lideram em dados IID pequenos, mas caem em datasets temporais e grandes, onde árvores e MLPs se mantêm melhor. Azul representa o melhor entre TabICLv2, TabPFN-2.6 e TabDPT, não as versões mais novas do TabPFN. Fonte: Purucker et al., “Beyond IID: How General Are Tabular Foundation Models, Really?” (2026), CC BY 4.0.
Espero que você concorde: os tabular foundation models elevaram o nível do que um baseline rápido e sem esforço pode fazer, mas modelos baseados em árvores ainda são a melhor escolha em muitas situações reais.
Use um tabular foundation model quando seu dataset for pequeno a médio e IID, e você não precisar de um modelo totalmente explicável ou de previsões muito rápidas em CPU. Eis a tabela de decisão que eu usaria:
| Cenário | Abordagem recomendada |
|---|---|
| Menos de 10K linhas, IID, sem necessidade de explicabilidade | Comece com TabICLv2 ou TabPFN |
| 10K a 100K linhas, IID | Teste TabICLv2 e XGBoost e fique com o vencedor |
| 100K a 1M de linhas | Comece com XGBoost ou LightGBM e teste TabPFN-3 como desafiante |
| Dados com split por tempo ou por grupo | Comece com modelos baseados em árvores |
| Precisa de SHAP, importância de features ou auditoria | Modelo de árvores com SHAP |
| Previsões rápidas sem GPU | Modelo de árvores |
| Prova de conceito rápida, sem setup de ML | TabICLv2 ou BigQuery AI.PREDICT se seus dados já estiverem lá |
| Agente de IA que precisa prever a partir de tabelas | Uma API como tabH2O ou NEXUS |
Antes de escolher um modelo, eu faria três perguntas:
E um último ponto: rode um tabular foundation model primeiro, porque custa só alguns minutos. Se ele não superar o XGBoost nos seus dados, você sabe que vale a pena investir em feature engineering e tuning do XGBoost.
Lembra dos dois alunos do início? Em 2026, o segundo — o que praticou em milhões de provas — finalmente consegue vencer o que estudou por semanas, ao menos em tabelas pequenas e médias.
Tabular foundation models trocam o treinamento por dataset por pré-treinamento e trocam o fit() por aprendizado a partir de exemplos.
O que mais me surpreende é a velocidade do avanço. O TabPFN-2 mostrou em 2025 que uma rede podia superar árvores ajustadas em tabelas pequenas, e TabICLv2 e TabPFN-3 ampliaram isso para tabelas bem maiores.
Os problemas em aberto agora são dados ordenados no tempo, dados que mudam, explicabilidade e licenças — justamente o que define se um modelo chega a produto.
Então, trate esses modelos como seu novo ponto de partida e escolha a ferramenta final com base nos seus dados, nas suas restrições e em onde o modelo vai rodar.
E, se você quer dominar os modelos baseados em árvores que ainda vencem em muitas situações reais, confira nosso curso Machine Learning with Tree-Based Models in Python e a trilha Supervised Machine Learning in Python. Se você trabalha em R, o curso Machine Learning with Tree-Based Models in R cobre o mesmo conteúdo.
Principais cursos da DataCamp
Programa
Curso
Programa
blog
Javier Canales Luna
9 min
blog
Abid Ali Awan
11 min
blog
Joleen Bothma
7 min
Tutorial
Zoumana Keita
8 min
Tutorial
Zoumana Keita
12 min
Tutorial
Josep Ferrer
11 min