トラック
大規模言語モデル(LLM)の開発
16時間
同じ試験を受ける2人の受験生を想像してください。1人目は3週間かけて1つの科目だけを勉強し、2人目はすでに何百万もの異なる試験で練習を積み、当日は解答例が載ったシートを受け取るだけです。
機械学習のこれまでの大半では、表形式モデルは前者に当たりました。新しいデータセットが来るたびに、列を整え、特徴量を作り、XGBoostやLightGBMを学習し、ハイパーパラメータを何時間もチューニングするのが常でした。
しかし表形式ファウンデーションモデルは後者です。ラベル付きの行を例として渡すと、学習を一切行わずに残りを予測します。
このアイデアは2026年に研究段階から実製品へと一気に進み、SAPはPrior Labsに10億ユーロ超の投資を約束し、Googleも独自モデルを公開しました。そこで本記事では次の点を取り上げます。
ディープラーニングの経験があまりなくても心配はいりません。この記事のコードは馴染みのあるscikit-learnインターフェースを使います。必要なら、まず20分でわかる機械学習モデル8選で基礎をおさらいしてください。
pip install tabiclで導入できます。表形式ファウンデーションモデルとは、何百万もの合成の表形式データセットで事前学習され、目的列の予測に関する一般的な戦略を身につけ、それをインコンテキスト学習によって新しいテーブルに適用するニューラルネットです。データセットごとの学習は行いません。
ここでの大きな違いは、学習がいつ起きるかです。
XGBoostでは、新しいモデルを学習するたびに手元のデータで学習が行われます。表形式のファウンデーションモデルでは、学習は何カ月も前の事前学習時に終わっており、手元のデータは単なる入力にすぎません。今後も頻出する用語があるので、平易に説明します。
では、表形式ファウンデーションモデルをブースティング手法や自動機械学習(AutoML)と比べるとどうでしょうか。
| 表形式ファウンデーションモデル | 勾配ブースティング木(XGBoost、LightGBM) | AutoML(AutoGluon、H2O AutoML) | |
|---|---|---|---|
| 新規データでの学習時間 | 不要 | 数秒〜数分+チューニング | 数分〜数時間 |
| 解釈性 | 限定的(SHAPは可能だが遅い) | 良好(特徴量重要度、迅速なSHAP) | 様々。読みにくいアンサンブルも多い |
| 得意なデータサイズ | 数百〜約10万行 | 数千〜数百万行以上 | 数千〜数百万行 |
| GPUは必要? | 数千行を超えるなら推奨 | 不要 | 通常は不要 |
| 小規模・ランダム分割データ | 現行ベンチマークで最良 | チューニングすれば強力 | 強力だが遅い |
仕組みの詳細に入る前に、最も有名で広く使われているモデル、すなわち大規模言語モデルとの比較を簡単にしておきます。
大規模言語モデル(LLM)と表形式ファウンデーションモデルはいずれもトランスフォーマーを用い、入力中の例から学習します。
違いは、何を読むように作られているかです。LLMは表を長いテキストとして読み、カンマや空白から、どの数値が同じ列に属するかを推測しなければなりません。
意味づけの問題もあります。
数値の42は年齢かもしれないし、売上高かもしれませんが、数自体からは判別できません。表形式ファウンデーションモデルは各列を独立した変数、各行を1つの例として扱うよう訓練されているため、列間の関係に重点を置きます。
こう考えるとわかりやすいでしょう。LLMはデータについて「語る」ことに優れ、表形式ファウンデーションモデルはそのデータで「計算する」ために作られているのです。
両者は協調も可能で、H2O.aiがtabH2Oを位置づけているのもまさにそれです。AIエージェントがスプレッドシートから数値を得る必要があるときに呼び出す予測ツールとして機能します。
表形式データが難しかったのは、テーブルにはニューラルネットが一度学んで再利用できる共通構造がないからです。画像のピクセルはどの写真でもピクセルです。しかし金融データのscore列とサッカーデータのscore列は、名前が同じでも何の共通点もありません。
Léo Grinsztajn、Edouard Oyallon、Gaël Varoquauxによる2022年のよく知られた論文「なぜ表形式データでは木ベースのモデルが依然としてディープラーニングを上回るのか?」は45データセットで検証し、特に勾配ブースティングが、約1万行の中規模テーブルでディープラーニングを上回ると示しました。その理由は以下の通りです。
さらに実務的な問題が2つあります。1つのテーブルに数値、カテゴリ、順位、欠損値が混在しがちなこと、そして多くの業務データは数百〜数千行と小さく、ゼロからニューラルネットを学習するには少なすぎることです。
特に小規模データは最重要の課題だと言えるでしょう。800行でゼロから学習するニューラルネットには拠り所がありませんが、木は事前知識不要で機能します。
事前学習が解決したのはまさにこの点です。表形式ファウンデーションモデルは、手元のデータを見るよりはるか前に、小規模で雑多な作り物のテーブルを何百万回と「練習」しており、ゼロから始めてはいないのです。
表形式ファウンデーションモデルは、ラベル付きの学習行とラベルなしのテスト行を1つの入力としてまとめて受け取り、1回のフォワードパスで欠損ラベルを予測します。LLMがプロンプト中の例を基に質問に答えるのと同様に、重みは変化しません。
このため、見慣れたscikit-learnのメソッドの意味も変わります。
TabICLで.fit()を呼ぶと、TabICLのドキュメントが説明するように、事前学習済みチェックポイントを読み込み、データを前処理して保存します。実際の処理は.predict()のときに行われます。
モデル名に.fit()が残っているのは、既存のscikit-learnコードにそのまま組み込めるようにするためです。
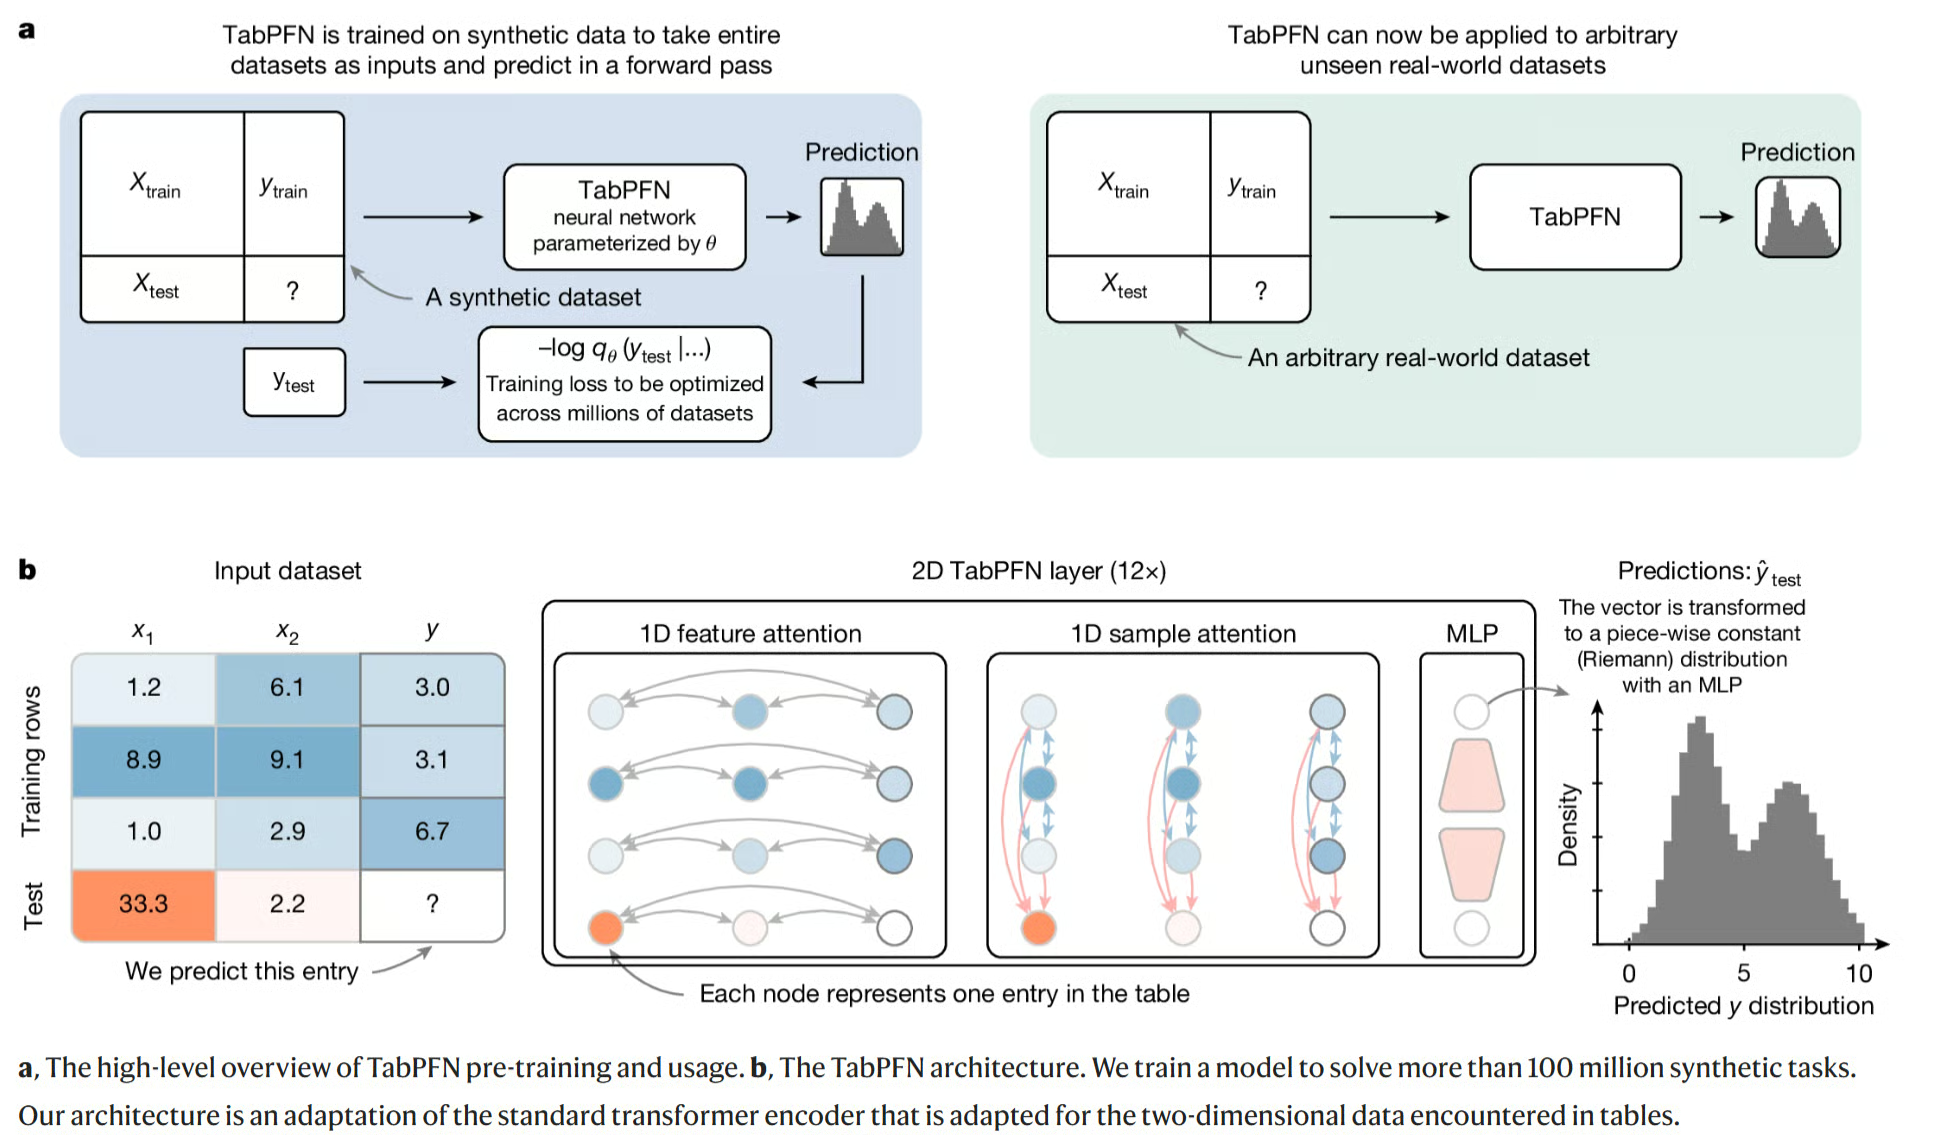
図1:TabPFNは何百万もの合成データセットで事前学習され、その後、実テーブルで1回のフォワードパスにより予測します。下段は特徴量とサンプルの両方向へのアテンションを示しています。出典:Hollmannほか「Accurate predictions on small data with a tabular foundation model」Nature(2025)。
合成事前学習とは、実データではなく、生成モデルのように動作するデータジェネレーターによって作られたテーブルでモデルを学習することです。
パイロットがフライトシミュレーターで訓練するのに似ています。さまざまな天候、空港、故障を想定した多数の模擬飛行を重ねることで、最初の実飛行でも新鮮味が薄れるのです。
TabPFNも同様に動作します。
開発者は、列間のランダムな「因果」関係(たとえば列Aが列Bに影響し、それが目的変数に影響する)を作り、それに従って行を生成するジェネレーターを作りました。
事前学習では目的列を隠し、モデルがそれを予測し、これをルール、ノイズレベル、表のサイズを変えながら何百万回と繰り返します。
重要なのは、モデルが実世界の特定分野の事実を学ぶわけではないことです。どの列が重要かの見極め、外れ値への対処、不確実性の判断など、汎用的な技能を学びます。
実際、TabICLv2の論文は、新しい合成データジェネレーターが性能向上の主要因だと述べています。
アーキテクチャの細部まで理解する必要はありませんが、主に2つの設計があることは知っておくと役立ちます。
いずれの系列も合成データで学習されます。したがって「prior-fitted network」は学習方法を指しており、別種のモデルという意味ではありません。
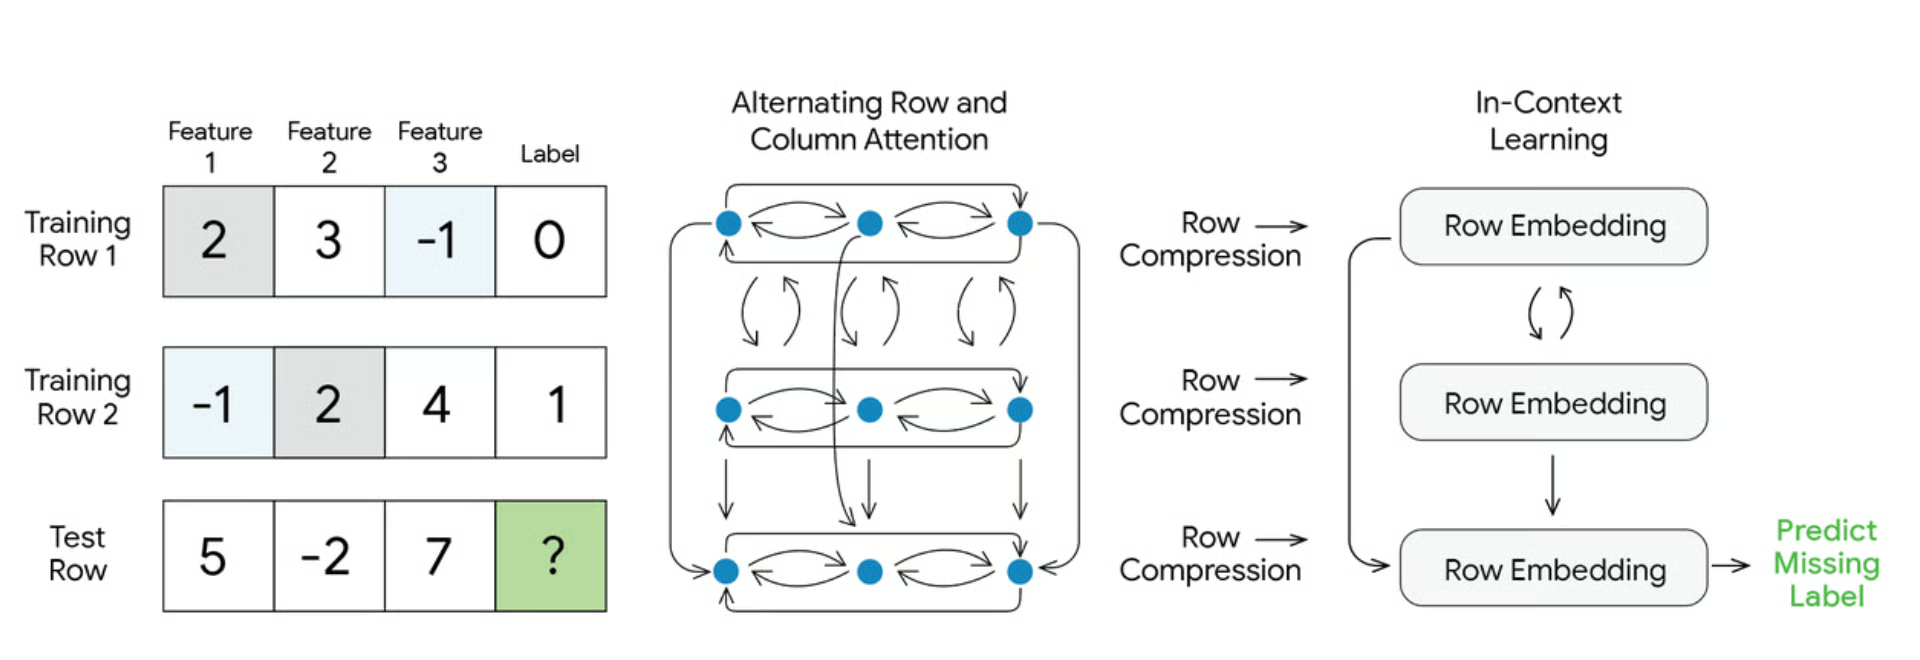
図2:TabFMは両設計を組み合わせています。TabPFN風の行・列アテンション、TabICL風の行圧縮、その後の欠損ラベルに対するインコンテキスト学習。出典:Google Research「Introducing TabFM: A zero-shot foundation model for tabular data」(2026)。
多くの人が見落とすトレードオフがあります。
XGBoostは一度学習に時間をかければ、その後の予測はほぼ瞬時です。
表形式ファウンデーションモデルは学習を省きますが、予測のたびに学習用の全行を読み直す必要があります。
あらかじめ仕込みをしない料理人が、注文のたびにレシピ本を最初から読み返すようなものです。
本が薄ければ問題ありませんが、データセットが大きくなるほど予測は遅くなります。TabICLもTabPFNも、学習データの「読み込み」をキャッシュして繰り返し予測を高速化できますが、初回は時間がかかります。
2026年の主要モデルは、TabPFN、TabICLv2、GoogleのTabFM、FundamentalのNEXUS、H2O.aiのtabH2Oです。注目すべきは、ビジネス面の展開が極めて速かったことです。わずか5カ月で学術論文から大型ディールへと進みました。簡単なタイムラインは次の通りです。
では、この分野を切り開いたモデルから順に見ていきます。
TabPFNはこのカテゴリを生み出したモデルです。TabPFN-2は2025年1月にNatureで発表され、最大1万行のデータセットでチューニング済みの木ベースモデルを上回りました。
その後、Prior Labsは矢継ぎ早に新バージョンを公開。TabPFN-3は2026年5月に登場し、最大100万行(特徴量は最大200)に対応。さらにThinkingモード(有料API)を追加し、フィット段階に追加時間をかけて予測精度を高められるようになりました。
最新のTabPFN-3.5は2026年9月に公開され、技術レポートでは、時系列順・グループ分割データを含む主要ベンチマークで首位を主張しています。これらは独自計測の可能性があるため、第三者検証を待つのがよいでしょう。
ライセンスにも注意が必要です。TabPFN-2は帰属表示つきで商用利用可能ですが、2.5〜3.5は非商用です。無料で試せますが、実製品に使うには有料ライセンスが必要です。
TabICLv2はいま最も優れた完全オープンの表形式ファウンデーションモデルです。Inriaで開発され、2026年2月に公開、ICML 2026に採択されました。
TabICLv2の論文のハイライトは、チューニングや実データでのアンサンブル・微調整が施された当時最強のRealTabPFN-2.5を、TabICLv2が無調整のまま上回った点です。
GitHubリポジトリによれば、TabArenaベンチマークでは重チューニングしたXGBoost、CatBoost、LightGBMにも約8割のデータセットで勝っています。
さらに高速で、H100 GPU上で5万行・100特徴量を10秒未満で処理。TabPFN-2.5の約10倍速いとされています。
最適なレンジは300〜10万行で、精度低下を許容すれば約50万行まで拡張可能です。
多くの読者にとって、まず試すべきはこれだと考えています。
pip install tabiclで導入でき、scikit-learnのモデル同様に扱え、商用利用も許す寛容なライセンスです。ただし情勢は急速に変わっており、TabPFN-3.5のレポートでは自らTabICLv2を上回ると主張しています。
TabFMはGoogle Researchの表形式ファウンデーションモデルで、2026年6月30日に公開されました。特徴的なのは使える場所です。GoogleのクラウドデータウェアハウスBigQueryに組み込まれており、SQLだけで予測が得られます。
-- Use past customers (with known churn) to predict churn for new customers
-- AI.PREDICT is in preview, so check the BigQuery docs for the latest syntax
SELECT *
FROM AI.PREDICT(
  TABLE my_dataset.customers_history,
  TABLE my_dataset.customers_new,
  label_col => 'churned'
);
PythonではなくSQLに馴染みがある方には最適です。
ただし、BigQueryのドキュメントでは現在、特徴量列は20、クラスは10までという制約があり、2026年10月30日からは通常のBigQuery課金に加えてトークンベースの課金が予定されています。Hugging Face上のモデル重みは非商用のため、商用利用はBigQuery経由になります。
NEXUSはサンフランシスコのスタートアップFundamentalによる、ビジネス専用のクローズドモデルです。元DeepMindの研究者が設立し、2026年2月に2億5500万ドルの資金とともに公開。企業はLarge Tabular Model(LTM)と称しています。
企業はAWS上でNEXUSを購入・運用し、すでにFortune 100企業が需要予測、価格設定、離反予測に用いていると述べられています。ただし公開重みや再現可能なベンチマークはなく、エンタープライズ向けの選択肢とみなすのが妥当でしょう。
tabH2OはH2O.aiのモデルで、コンセプトは明快です。データを送ると予測が返ってくるというものです。
欠損値やカテゴリの処理を自動で行い、企業のオンプレミスでも動かせます。クラウドにデータを送れない銀行や医療機関には重要です。
好感が持てるのは、tabH2Oの論文が誇張を避けている点です。TALENTベンチマークでチューニング済みCatBoostやLightGBMに勝った一方、TabICLv2には及ばないとしています。
| モデル | 開発元 | 重み公開? | 最大規模 | ライセンス | 最適な用途 |
|---|---|---|---|---|---|
| TabPFN-2 | Prior Labs | はい | 1万行 | 帰属表示つきで商用可 | 実績ある旧モデルの商用利用 |
| TabPFN-3 / 3.5 | Prior Labs(SAP) | ライセンス同意後に可 | 最大100万行 | 非商用、ビジネス向けは有料API | 最高精度と研究用途 |
| TabICLv2 | Inria | はい | 最適は10万行まで | 寛容なオープンソース | 標準の出発点 |
| TabFM | Google Research | はい | BigQueryで20特徴量 | 非商用重み | BigQueryのSQLユーザー |
| NEXUS | Fundamental | いいえ | 非公開 | 独自 | AWS上の大企業 |
| tabH2O | H2O.ai | いいえ | 非公開 | 商用API | ML環境がないチーム、AIエージェント |
Pythonでは、他のscikit-learnモデルとまったく同じように使います。
強みを確認する最良の方法はXGBoostとの直接対決です。scikit-learnの乳がんデータセットで試してみましょう。
まずはパッケージをインストールします。
pip install tabicl xgboost scikit-learn次に同じ分割で両モデルを回します。
from sklearn.datasets import load_breast_cancer
from sklearn.metrics import accuracy_score
from sklearn.model_selection import train_test_split
from tabicl import TabICLClassifier
from xgboost import XGBClassifier

# Load a small tabular dataset as a pandas DataFrame
X, y = load_breast_cancer(return_X_y=True, as_frame=True)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, stratify=y, random_state=42
)

# Tabular foundation model: fit() just stores the training rows
tfm = TabICLClassifier()
tfm.fit(X_train, y_train)
tfm_preds = tfm.predict(X_test)

# XGBoost baseline with reasonable, untuned settings
xgb = XGBClassifier(n_estimators=300, learning_rate=0.05, max_depth=4)
xgb.fit(X_train, y_train)
xgb_preds = xgb.predict(X_test)

print(f"TabICL accuracy:  {accuracy_score(y_test, tfm_preds):.3f}")
print(f"XGBoost accuracy: {accuracy_score(y_test, xgb_preds):.3f}")
この小さなデータセットなら一般的なノートPCのCPUで問題なく動きます。
ここまで綺麗なデータだと両者とも高得点になります。1回の分割結果で判断しないでください。本当の勝負は手元の雑多なデータです。
TabPFNを試したい場合は、pip install tabpfnを実行し、次の2行だけ変えればOKです。
from tabpfn import TabPFNClassifier

tfm = TabPFNClassifier()  # The first run asks you to accept the license
tfm.fit(X_train, y_train)
tfm_preds = tfm.predict(X_test)
実データでモデルを比較する前に、重要な注意点を1つ。
データに日付が含まれる場合は、ランダムではなく時間で分割してください。さもないとモデルが未来を覗き見することになり、次のセクションで述べる通り、まさにその状況で表形式ファウンデーションモデルは過大評価されがちです。
表形式ファウンデーションモデルは、小〜中規模で、テスト行が学習行と似ている(IID)データセットで力を発揮します。時系列順データ、グループ分割データ、超大規模テーブル、厳格な説明責任が必要な場面では苦戦します。
「テスト行が学習行と似ている」という条件はIID(独立同分布)と呼ばれ、データについて最も重要なチェックポイントです。
まずは得意な場面から:
次に制約です。実プロジェクトで使うなら、こちらの方が重要になるでしょう。
2026年6月公開のBeyondArenaベンチマークは、時系列分割(過去から未来を予測)やグループ分割(新しい病院や国を予測)を含む142データセットで11モデルを評価しました。
その結果、表形式ファウンデーションモデルは小〜中規模のIIDデータで最良だが、時系列・グループ分割・大規模・超高次元では木系や他の深層モデルが依然優勢と示されました。営業、不正検知、離反など多くの業務データは時間順であるため、この制約は実案件で頻出します。
BeyondArenaの後に公開されたTabPFN-3.5は、時系列・グループ分割データでのギャップを埋めたと主張しています。期待は持てますが、独立検証はこれからです。
TabICLやTabPFNでもSHAP値は算出できますが、木モデルでのSHAPに比べてはるかに時間がかかり、木の分割のような直観的な手がかりもありません。規制当局の理解が求められる信用スコアリングなどでは深刻な問題です。
数千行を超えるとGPUが欲しくなり、学習データが増えるほど予測は遅くなります。CPU上の学習済みXGBoostは速度で常に勝るでしょう。
TabPFN-2は帰属表示つき商用可、新しいTabPFNは非商用、TabFMの重みも非商用、TabICLv2は寛容です。
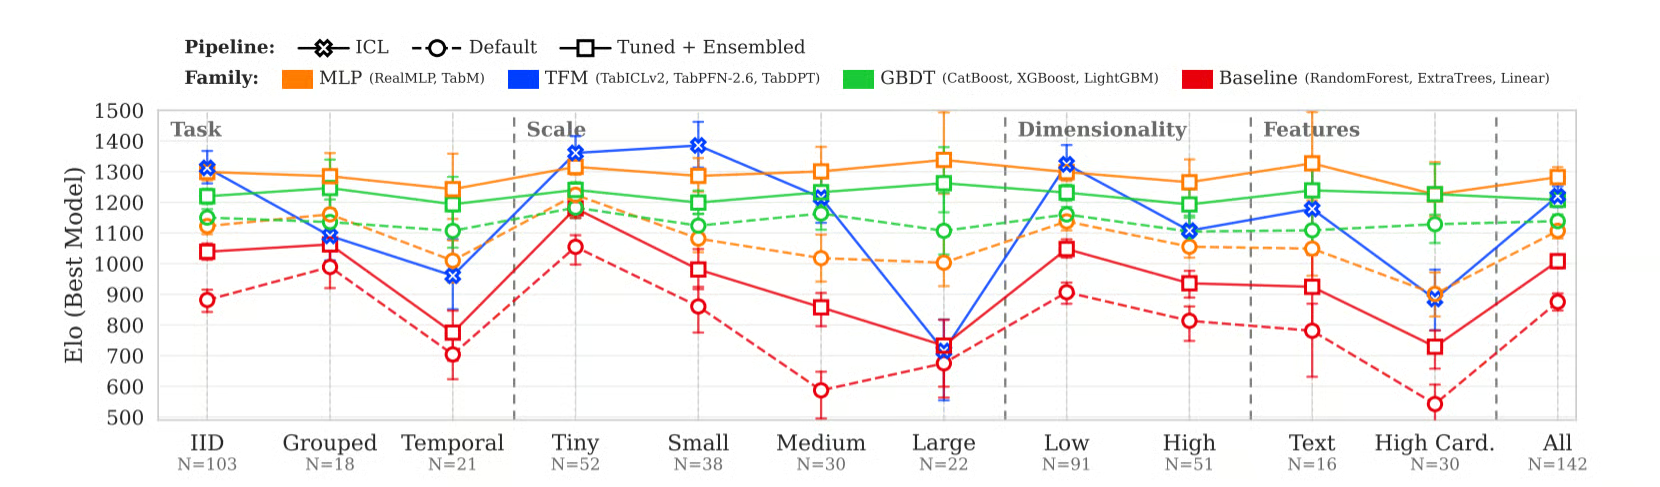
図3:モデル系列ごとのElo(高いほど良い)。表形式ファウンデーションモデルは小規模IIDでリードする一方、時系列や大規模では低下し、木やMLPが粘ります。青はTabICLv2、TabPFN-2.6、TabDPTの中での最良で、最新のTabPFNではありません。出典:Puruckerほか「Beyond IID: How General Are Tabular Foundation Models, Really?」(2026)、CC BY 4.0。
要するに、表形式ファウンデーションモデルは、手間いらずのクイックなベースライン水準を大きく引き上げましたが、実務の多くの状況では依然として木ベースのモデルに分があります。
データセットが小〜中規模でIID、かつ完全な説明性やCPUでの超高速推論が不要な場合に使うべきです。意思決定表は次の通りです。
| シナリオ | 推奨アプローチ |
|---|---|
| 1万行未満、IID、説明不要 | TabICLv2またはTabPFNから開始 |
| 1万〜10万行、IID | TabICLv2とXGBoostを比較し勝者を採用 |
| 10万〜100万行 | XGBoostまたはLightGBMを起点に、挑戦者としてTabPFN-3を試す |
| 時間またはグループで分割 | 木ベースモデルから開始 |
| SHAP・特徴量重要度・監査が必要 | SHAP対応の木ベースモデル |
| GPUなしで高速推論が必要 | 木ベースモデル |
| 迅速なPoC、ML環境なし | TabICLv2、またはデータがBigQueryにあるならAI.PREDICT |
| 表から予測が欲しいAIエージェント | tabH2OやNEXUSのようなAPI |
モデル選定の前に、次の3点を確認することをおすすめします。
最後に強調したい点があります。まず表形式ファウンデーションモデルを走らせてください。数分のコストしかかかりません。これでXGBoostに勝てないなら、特徴量エンジニアリングやXGBoostのチューニングに時間をかける価値があると判断できます。
記事の冒頭の2人の受験生を思い出してください。2026年、数百万の試験で練習を積んだ後者が、少なくとも小〜中規模のテーブルでは、数週間勉強した前者に勝てるようになりました。
表形式ファウンデーションモデルは、データセットごとの学習を事前学習に置き換え、fit()を例からの学習に置き換えます。
驚くべきは、この分野の進歩の速さです。2025年にTabPFN-2が小規模テーブルでチューニング済みの木を上回れることを示し、その後、TabICLv2とTabPFN-3が対象をはるかに大きなテーブルへと広げました。
未解決の課題は、時系列、データの変化、説明性、ライセンスです。いずれも、モデルが実製品に採用されるかどうかを左右する要素です。
したがって、これらのモデルを新たな出発点として扱い、最終的な選択はデータ、制約、運用環境に基づいて行ってください。
現実の多くの場面で今なお勝る木ベースモデルを極めたい方は、弊社のMachine Learning with Tree-Based Models in PythonコースやSupervised Machine Learning in Pythonトラックをご覧ください。Rでの学習には、Machine Learning with Tree-Based Models in Rが同等の内容を扱います。
Top DataCamp Courses
トラック
コース
トラック