Lernpfad
Entwicklung von großen Sprachmodellen
16 Std.
Stell dir zwei Studierende in derselben Prüfung vor. Die erste Person lernt drei Wochen lang nur ein einziges Modul. Die zweite hat bereits Millionen verschiedener Prüfungen geübt und bekommt am Tag selbst lediglich ein Blatt mit Musterlösungen.
Über weite Strecken der ML-Geschichte waren tabellarische Modelle wie die erste Person. Jedes neue Dataset bedeutete: Spalten bereinigen, Features bauen, XGBoost oder LightGBM trainieren und Hyperparameter stundenlang abstimmen.
Tabellarische Foundation-Modelle sind hingegen die zweite Person: Du gibst ihnen deine gelabelten Zeilen als Beispiele, und sie sagen den Rest mit Null Training vorher.
2026 ist diese Idee aus Forschungspapieren in echte Produkte übergegangen: SAP investierte über 1 Milliarde € in Prior Labs und Google veröffentlichte ein eigenes Modell. In diesem Artikel schauen wir uns an:
Keine Sorge, wenn du wenig Deep-Learning-Erfahrung hast. Der Code hier nutzt die vertraute scikit-learn-Schnittstelle. Wenn du erst kurz auffrischen möchtest, erklärt 8 Machine-Learning-Modelle in 20 Minuten die Basics.
pip install tabicl sofort einsatzbereit.Ein tabellarisches Foundation-Modell ist ein neuronales Netz, das auf Millionen synthetischer Tabellendatasets vortrainiert wurde. Es lernt eine allgemeine Strategie, um eine Zielspalte vorherzusagen, und wendet diese Strategie über In-Context-Learning auf eine neue Tabelle an – ganz ohne Training pro Dataset.
Der große Unterschied ist, wann gelernt wird.
Bei XGBoost findet das Lernen jedes Mal auf deinen Daten statt, wenn du ein neues Modell trainierst. Bei einem tabellarischen Foundation-Modell geschah das Lernen bereits vor Monaten während des Vortrainings, und deine Daten sind nur noch der Input. Es tauchen auch ein paar Begriffe immer wieder auf, daher kurz in einfachen Worten:
Jetzt vergleichen wir tabellarische Foundation-Modelle mit Boosting-Methoden und AutoML:
| Tabellarische Foundation-Modelle | Gradientengeboostete Bäume (XGBoost, LightGBM) | AutoML (AutoGluon, H2O AutoML) | |
|---|---|---|---|
| Trainingszeit auf neuen Daten | Keine | Sekunden bis Minuten, plus Tuning | Minuten bis Stunden |
| Interpretierbarkeit | Begrenzt (SHAP möglich, aber langsam) | Gut (Feature Importance, schnelles SHAP) | Unterschiedlich, oft schwer lesbare Ensembles |
| Optimale Dataset-Größe | Hunderte bis ca. 100 Tsd. Zeilen | Tausende bis viele Millionen Zeilen | Tausende bis Millionen Zeilen |
| GPU nötig? | Ab einigen Tausend Zeilen empfehlenswert | Nein | Meist nein |
| Kleine, zufällig gesplittete Datasets | Aktuell am besten | Stark bei Tuning | Stark, aber langsam |
Bevor wir ins Wie einsteigen, ein schneller Vergleich mit den bekanntesten, am weitesten verbreiteten Modellen: den großen Sprachmodellen.
Large Language Models (LLMs) und tabellarische Foundation-Modelle nutzen beide Transformer und lernen beide aus Beispielen im Input.
Der Unterschied liegt darin, was sie lesen sollen. Ein LLM liest eine Tabelle als langen Textstring und muss aus Kommas und Leerzeichen rekonstruieren, welche Zahlen zu derselben Spalte gehören.
Dazu kommt ein Bedeutungsproblem.
Der Wert 42 könnte ein Alter oder ein Umsatz sein, aber die Zahl selbst verrät es nicht. Ein tabellarisches Foundation-Modell ist so trainiert, dass jede Spalte als eigene Variable und jede Zeile als ein Beispiel behandelt wird – es fokussiert also die Beziehungen zwischen den Spalten.
Ich merke es mir so: Ein LLM ist großartig darin, über deine Daten zu sprechen, ein tabellarisches Foundation-Modell ist dafür gebaut, damit zu rechnen.
Beide können auch zusammenarbeiten – genau so positioniert H2O.ai sein tabH2O: als Vorhersagewerkzeug, das ein KI-Agent aufruft, wenn er eine Zahl aus einer Tabelle braucht.
Tabellarische Daten sind schwierig, weil Tabellen keine gemeinsame Struktur haben, die ein neuronales Netz einmal lernen und wiederverwenden kann. Ein Pixel ist in jedem Foto ein Pixel. Eine Spalte namens score in einem Finanz- und eine Spalte score in einem Fußballdatensatz haben nichts gemeinsam.
Ein bekanntes Paper von 2022 von Léo Grinsztajn, Edouard Oyallon und Gaël Varoquaux, Why do tree-based models still outperform deep learning on tabular data?, testete 45 Datasets und fand: Baumbasierte Modelle, insbesondere Gradient Boosting, schlagen Deep Learning weiterhin auf mittelgroßen Tabellen um 10.000 Zeilen. Gründe:
Zwei praktische Probleme verschärfen das: Eine Tabelle mischt Zahlen, Kategorien, Ränge und fehlende Werte, und die meisten Business-Tabellen haben nur Hunderte oder Tausende Zeilen – zu wenig für ein Netz von Null an.
Ich würde sagen: Kleine Datasets sind das größte Problem. Ein von Null auf 800 Zeilen trainiertes Netz hat keinen Rückhalt, während ein Baum keinerlei Vorwissen braucht.
Genau das behebt Vortraining. Ein tabellarisches Foundation-Modell hat bereits auf Millionen kleiner, unordentlicher, erfundener Tabellen „geübt“, bevor es deine sieht – es startet nicht bei Null.
Ein tabellarisches Foundation-Modell nimmt deine gelabelten Trainingszeilen und die unlabelten Testzeilen gemeinsam als Input und sagt die fehlenden Labels in einem einzigen Forward Pass voraus. Seine Gewichte ändern sich nie – genau wie ein LLM, das nach ein paar Beispielen in der Prompt antwortet.
Das ändert auch die Bedeutung der gewohnten scikit-learn-Methoden.
Wenn du .fit() auf TabICL aufrufst, erklärt die TabICL-Dokumentation, dass der vortrainierte Checkpoint geladen, deine Daten vorverarbeitet und gespeichert werden. Die eigentliche Arbeit passiert in .predict().
Der Name .fit() bleibt, damit das Modell nahtlos in deinen scikit-learn-Code passt.
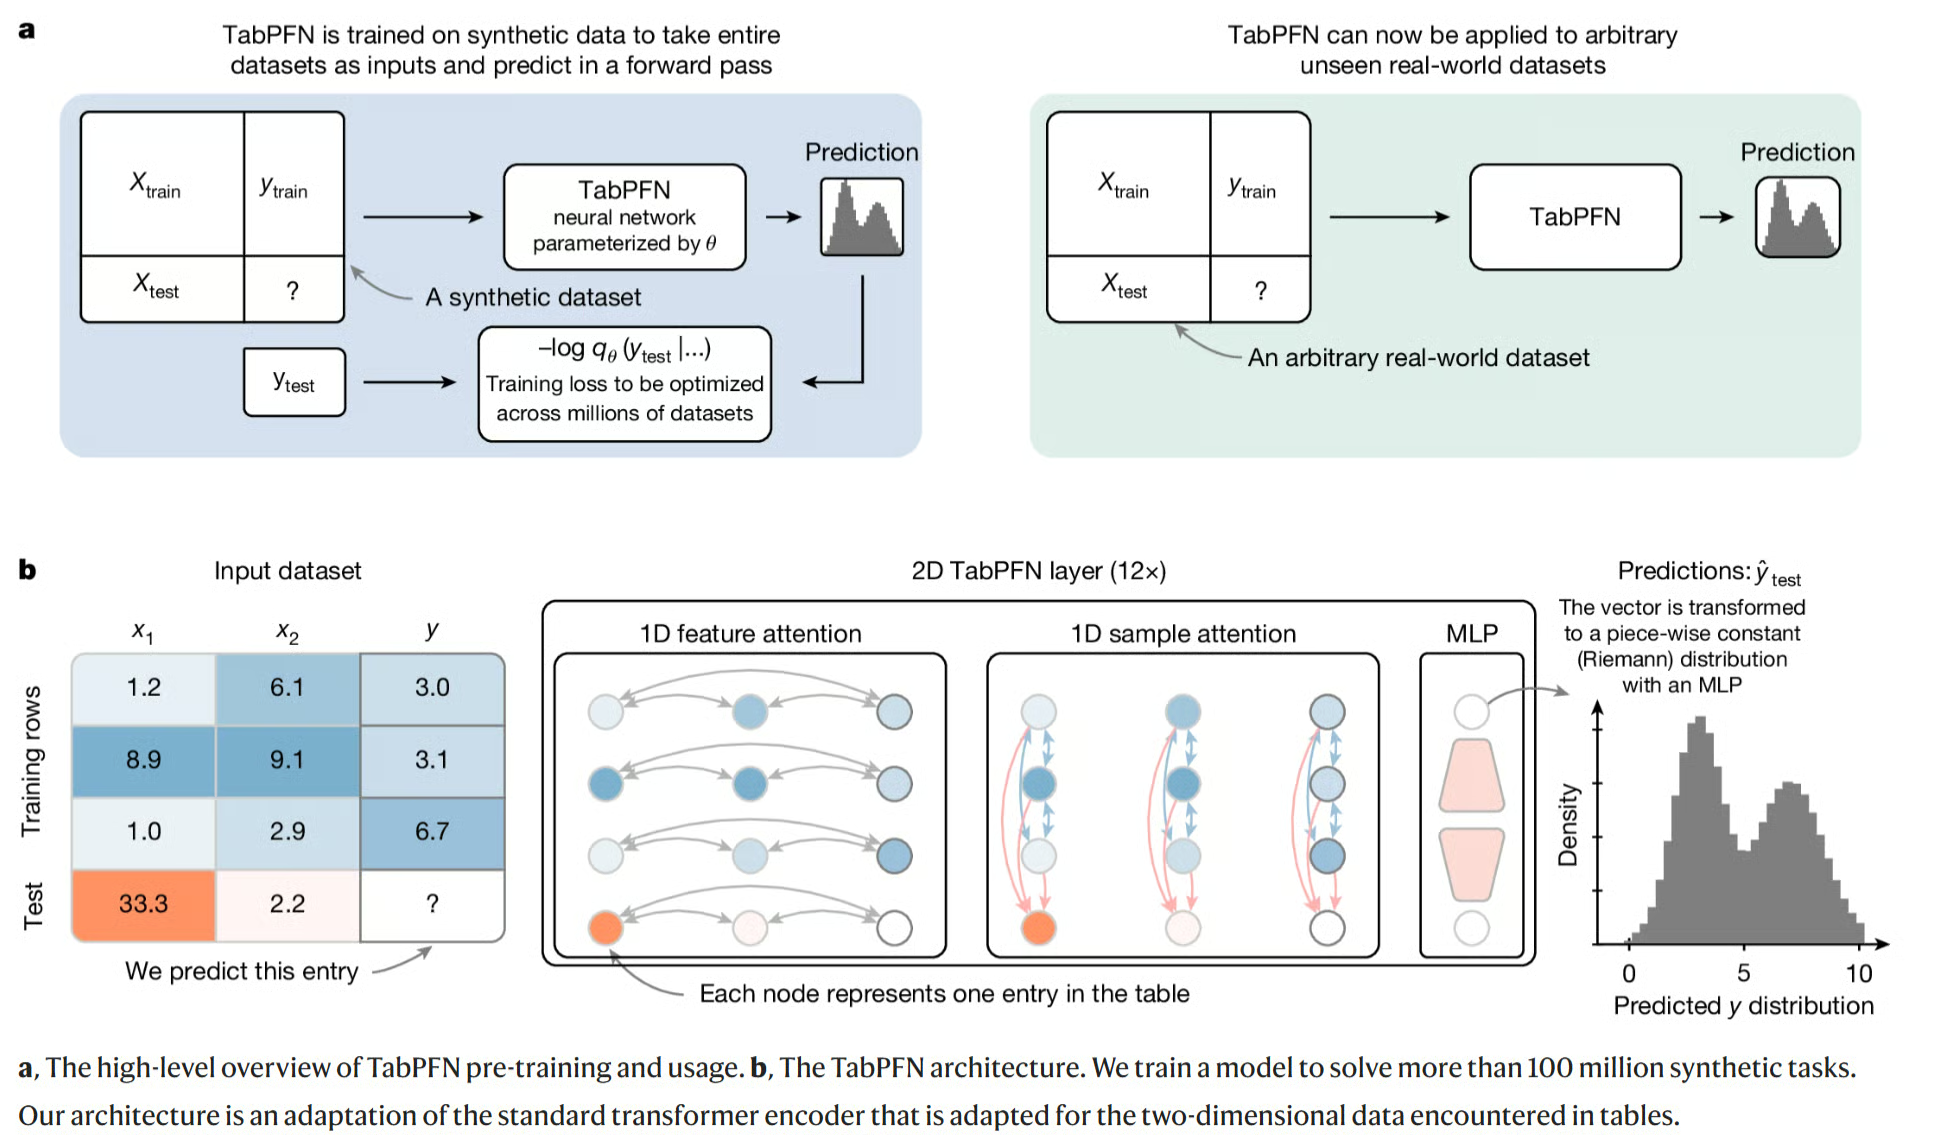
Abbildung 1: TabPFN wird auf Millionen synthetischer Datasets vortrainiert und sagt dann auf einer realen Tabelle in einem Forward Pass voraus. Unten ist zu sehen, wie über Features und Samples hinweg "attended" wird. Quelle: Hollmann et al., „Accurate predictions on small data with a tabular foundation model“, Nature (2025).
Synthetisches Vortraining bedeutet, dass das Modell auf erfundenen Tabellen trainiert wird, erzeugt von einem Datengenerator, der wie ein generatives Modell arbeitet.
Denk an Pilotentraining im Flugsimulator. Die Pilotin übt Tausende simulierte Flüge mit unterschiedlichem Wetter, Flughäfen und Defekten, damit sich der erste echte Flug nicht neu anfühlt.
TabPFN funktioniert ähnlich.
Die Entwickler schrieben einen Generator, der zufällige „Ursache-Wirkung“-Regeln zwischen Spalten erfindet (z. B. Spalte A beeinflusst B, die das Ziel beeinflusst) und daraus Zeilen erzeugt.
Im Vortraining wird die Zielspalte versteckt, das Modell versucht sie vorherzusagen, und das wiederholt sich millionenfach mit verschiedenen Regeln, Rauschgraden und Tabellengrößen.
Wichtig ist: Das Modell lernt keine Fakten zu realen Themen. Es lernt allgemeine Fähigkeiten wie relevante Spalten erkennen, Ausreißer handhaben und Unsicherheit einschätzen.
Tatsächlich führt das TabICLv2-Paper seinen Leistungszuwachs wesentlich auf den neuen synthetischen Datengenerator zurück.
Du musst nicht jedes Architekturdetail kennen, aber zwei Hauptansätze helfen beim Verständnis:
Beachte: Beide Familien werden auf synthetischen Daten trainiert, „Prior-fitted Network“ beschreibt also die Trainingsart, nicht einen separaten Modelltyp.
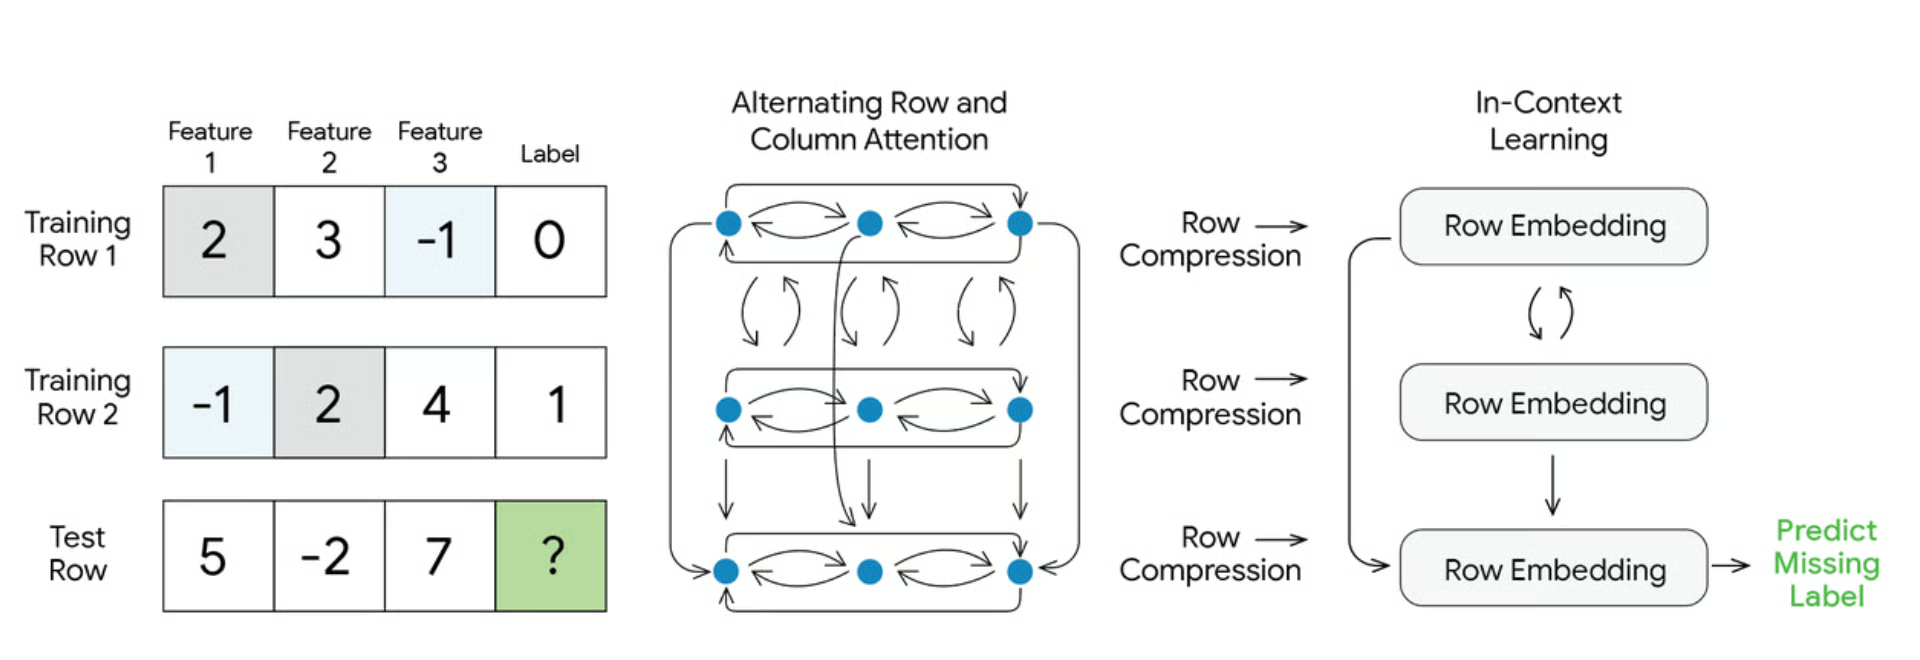
Abbildung 2: TabFM kombiniert beides: TabPFN-Style Attention über Zeilen und Spalten, dann TabICL-Style Zeilenkompression und anschließend In-Context-Learning für das fehlende Label. Quelle: Google Research, „Introducing TabFM: A zero-shot foundation model for tabular data“ (2026).
Hier gibt es einen Trade-off, der viele überrascht.
XGBoost investiert einmal Zeit ins Training und sagt dann fast sofort vorher.
Ein tabellarisches Foundation-Modell überspringt das Training, muss aber bei jeder Vorhersage alle deine Trainingszeilen erneut lesen.
Denk an eine Köchin, die vor dem Service nichts vorbereitet und für jede Bestellung das komplette Kochbuch neu liest.
Bei einem dünnen Buch geht das, aber je größer dein Dataset, desto langsamer die Vorhersagen. TabICL und TabPFN können das „Lesen“ der Trainingsdaten cachen und so Wiederholungen beschleunigen, aber der erste Durchlauf kostet Zeit.
Die zentralen Modelle 2026 sind TabPFN, TabICLv2, Googles TabFM, Fundamentals NEXUS und H2O.ai’s tabH2O. Spannend ist, wie schnell das Business nachgezogen hat: Fünf Monate von Papern bis zu großen Deals. Eine kurze Timeline:
Schauen wir uns die einzelnen Modelle an, beginnend mit dem, das alles ins Rollen brachte.
TabPFN ist das Modell, das diese Kategorie geprägt hat. TabPFN-2 erschien im Januar 2025 in Nature und schlug getunte Baummodelle auf Datasets bis 10.000 Zeilen.
Seitdem veröffentlichte Prior Labs schnell neue Versionen. TabPFN-3 kam im Mai 2026 und bewältigt bis zu 1 Million Zeilen (bis zu 200 Features). Zudem kam ein Thinking Mode (über die kostenpflichtige API), der in der Fit-Phase zusätzliche Zeit investiert, um bessere Vorhersagen zu erzielen.
Die neueste Version, TabPFN-3.5, erschien im September 2026. Der Technikbericht reklamiert Spitzenplätze auf mehreren großen Benchmarks, auch bei zeitlich geordneten und gruppierten Daten. Ich würde diese Zahlen als firmenintern einstufen, bis sie extern bestätigt sind.
Noch wichtig: die Lizenz. TabPFN-2 ist kommerziell nutzbar mit Nennung von Prior Labs, aber Versionen 2.5 bis 3.5 sind nicht-kommerziell. Du kannst damit frei experimentieren, für echte Produkte brauchst du jedoch eine kostenpflichtige Lizenz.
TabICLv2 ist derzeit das beste vollständig offene tabellarische Foundation-Modell. Es wurde bei Inria entwickelt, im Februar 2026 veröffentlicht und bei der ICML 2026 angenommen.
Das Kernergebnis des TabICLv2-Papers: Ohne jegliches Tuning schlug es RealTabPFN-2.5, das vorher beste Modell, obwohl dieses getunt, ensemmbled und auf realen Daten feinjustiert war.
Laut GitHub-Repository schlägt es zudem stark getunte XGBoost-, CatBoost- und LightGBM-Modelle auf rund 80 % der Datasets im TabArena-Benchmark.
Es ist auch schnell: 50.000 Zeilen mit 100 Features in unter 10 Sekunden auf einer H100-GPU – etwa zehnmal schneller als TabPFN-2.5.
Am besten funktioniert es zwischen 300 und 100.000 Zeilen und lässt sich mit etwas Genauigkeitsverlust bis etwa 500.000 Zeilen strecken.
Meiner Meinung nach ist das für die meisten der beste Startpunkt.
Installation per pip install tabicl, funktioniert wie jedes scikit-learn-Modell, und die freizügige Lizenz erlaubt kommerzielle Nutzung ohne Anmeldung. Das Leaderboard bewegt sich aber schnell, und TabPFN-3.5 sieht sich im eigenen Bericht inzwischen vor TabICLv2.
TabFM ist das tabellarische Foundation-Modell von Google Research, veröffentlicht am 30. Juni 2026. Besonders ist, wo du es nutzen kannst: Es ist in BigQuery, das Cloud-Datenlager von Google, integriert – Vorhersagen per SQL.
-- Nutze vergangene Kund:innen (mit bekanntem Churn), um Churn für neue zu prognostizieren
-- AI.PREDICT ist in der Vorschau, prüfe die BigQuery-Doku für die aktuellste Syntax
SELECT *
FROM AI.PREDICT(
  TABLE my_dataset.customers_history,
  TABLE my_dataset.customers_new,
  label_col => 'churned'
);
Ideal für alle, die SQL können, aber kein Python nutzen.
Allerdings beschränkt die BigQuery-Dokumentation aktuell auf 20 Feature-Spalten und 10 Klassen, und ab dem 30. Oktober 2026 plant Google tokenbasierte Preise zusätzlich zu den üblichen BigQuery-Gebühren. Die Modellgewichte auf Hugging Face sind nicht-kommerziell, kommerzielle Nutzung läuft über BigQuery.
NEXUS ist ein geschlossenes, rein geschäftliches Modell von Fundamental, einem Startup aus San Francisco, gegründet von ehemaligen DeepMind-Forschenden. Launch war im Februar 2026 mit 255 Mio. US-Dollar, das Unternehmen nennt es ein Large Tabular Model (LTM).
Unternehmen kaufen und betreiben NEXUS über AWS. Fundamental sagt, Fortune-100-Firmen nutzen es bereits für Nachfrageprognosen, Pricing und Churn. Es gibt jedoch keine öffentlichen Gewichte oder Benchmarks zum Nachprüfen – also eher eine Enterprise-Option.
tabH2O ist H2O.ai’s Modell, und die Idee ist simpel: Daten schicken, Vorhersagen zurückbekommen.
Fehlende Werte und Kategorien werden automatisch bereinigt, und es kann on-premise laufen – wichtig für Banken und Kliniken, die keine Cloud dürfen.
Positiv: Das tabH2O-Paper übertreibt nicht. Es schlug getuntes CatBoost und LightGBM im TALENT-Benchmark, lag aber hinter TabICLv2.
| Modell | Entwickler | Offene Gewichte? | Maximale Skalierung | Lizenz | Am besten geeignet für |
|---|---|---|---|---|---|
| TabPFN-2 | Prior Labs | Ja | 10 Tsd. Zeilen | Kommerziell mit Attribution | Kommerzielle Nutzung eines bewährten älteren Modells |
| TabPFN-3 / 3.5 | Prior Labs (SAP) | Ja, nach Lizenzannahme | Bis 1 Mio. Zeilen | Nicht-kommerziell, bezahlte API für Business | Top-Genauigkeit und Forschung |
| TabICLv2 | Inria | Ja | Am besten bis 100 Tsd. Zeilen | Freizügige Open-Source | Dein Standard-Startpunkt |
| TabFM | Google Research | Ja | 20 Features in BigQuery | Nicht-kommerzielle Gewichte | SQL-User in BigQuery |
| NEXUS | Fundamental | Nein | Nicht offengelegt | Proprietär | Großunternehmen auf AWS |
| tabH2O | H2O.ai | Nein | Nicht offengelegt | Kommerzielle API | Teams ohne ML-Setup, KI-Agenten |
Du nutzt es exakt wie jedes andere scikit-learn-Modell.
Am besten siehst du den Mehrwert im direkten Duell mit XGBoost. Nehmen wir den eingebauten Breast-Cancer-Datensatz aus scikit-learn.
Zuerst installieren wir die Pakete:
pip install tabicl xgboost scikit-learnDann lassen wir beide Modelle auf demselben Split laufen:
from sklearn.datasets import load_breast_cancer
from sklearn.metrics import accuracy_score
from sklearn.model_selection import train_test_split
from tabicl import TabICLClassifier
from xgboost import XGBClassifier

# Lade ein kleines tabellarisches Dataset als pandas DataFrame
X, y = load_breast_cancer(return_X_y=True, as_frame=True)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, stratify=y, random_state=42
)

# Tabellarisches Foundation-Modell: fit() speichert nur die Trainingszeilen
tfm = TabICLClassifier()
tfm.fit(X_train, y_train)
tfm_preds = tfm.predict(X_test)

# XGBoost-Baseline mit vernünftigen, ungetunten Einstellungen
xgb = XGBClassifier(n_estimators=300, learning_rate=0.05, max_depth=4)
xgb.fit(X_train, y_train)
xgb_preds = xgb.predict(X_test)

print(f"TabICL accuracy:  {accuracy_score(y_test, tfm_preds):.3f}")
print(f"XGBoost accuracy: {accuracy_score(y_test, xgb_preds):.3f}")
Dieses kleine Dataset läuft problemlos auf einer normalen Laptop-CPU.
Beide Modelle erreichen hier sehr hohe Scores, also bitte nicht anhand eines Splits urteilen. Der echte Test sind deine eigenen, unaufgeräumten Daten.
Wenn du stattdessen TabPFN probieren willst, installiere pip install tabpfn, danach sind nur zwei Zeilen anders:
from tabpfn import TabPFNClassifier

tfm = TabPFNClassifier()  # Beim ersten Lauf musst du die Lizenz akzeptieren
tfm.fit(X_train, y_train)
tfm_preds = tfm.predict(X_test)
Ein wichtiger Punkt, bevor du Modelle auf echten Daten vergleichst.
Wenn deine Daten Datumsangaben enthalten, splitte nach Zeit statt zufällig. Andernfalls blickt das Modell in die Zukunft – und genau dort wirken tabellarische Foundation-Modelle besser als sie wirklich sind, wie du im nächsten Abschnitt siehst.
Sie funktionieren gut, wenn dein Dataset klein bis mittel ist und die Testzeilen den Trainingszeilen ähnlich sind. Sie tun sich schwer mit zeitlich geordneten Daten, gruppierten Daten, sehr großen Tabellen und strengen Erklärbarkeitsanforderungen.
Dieses „Testzeilen sehen aus wie Trainingszeilen“ nennt man IID (unabhängig und identisch verteilt) und es ist der wichtigste Check für deine Daten.
Gut geeignet sind vor allem:
Jetzt zu den Limitierungen, die in realen Projekten oft schwerer wiegen.
Der BeyondArena-Benchmark (Juni 2026) testete 11 Modelle auf 142 Datasets, darunter zeitlich gesplittete (Zukunft aus Vergangenheit) und gruppierte (neues Krankenhaus oder Land).
Ergebnis: Tabellarische Foundation-Modelle sind am besten bei kleinen/mittleren IID-Daten, während baumbasierte und andere DL-Modelle bei zeitlich geordneten, gruppierten, großen und sehr breiten Daten führen. Da die meisten Business-Daten (Sales, Fraud, Churn) zeitlich geordnet sind, trifft diese Schwäche viele Praxisfälle.
TabPFN-3.5, nach BeyondArena erschienen, beansprucht speziell, diese Lücke bei zeitlich geordneten und gruppierten Daten zu schließen. Das ist vielversprechend, aber noch nicht unabhängig bestätigt.
SHAP-Werte bekommst du auch für TabICL und TabPFN, aber deutlich langsamer als SHAP bei Baumodellen, und es gibt keine Baumsplits zum Inspizieren. In regulierten Bereichen wie Kreditvergabe ist das ein echtes Problem.
Alles jenseits weniger Tausend Zeilen profitiert stark von einer GPU, und Vorhersagen werden mit wachsenden Trainingsdaten langsamer. Ein trainiertes XGBoost-Modell auf der CPU gewinnt beim Tempo praktisch immer.
TabPFN-2 ist kommerziell mit Nennung, neuere TabPFN-Versionen sind nicht-kommerziell, TabFM-Gewichte nicht-kommerziell, TabICLv2 freizügig.
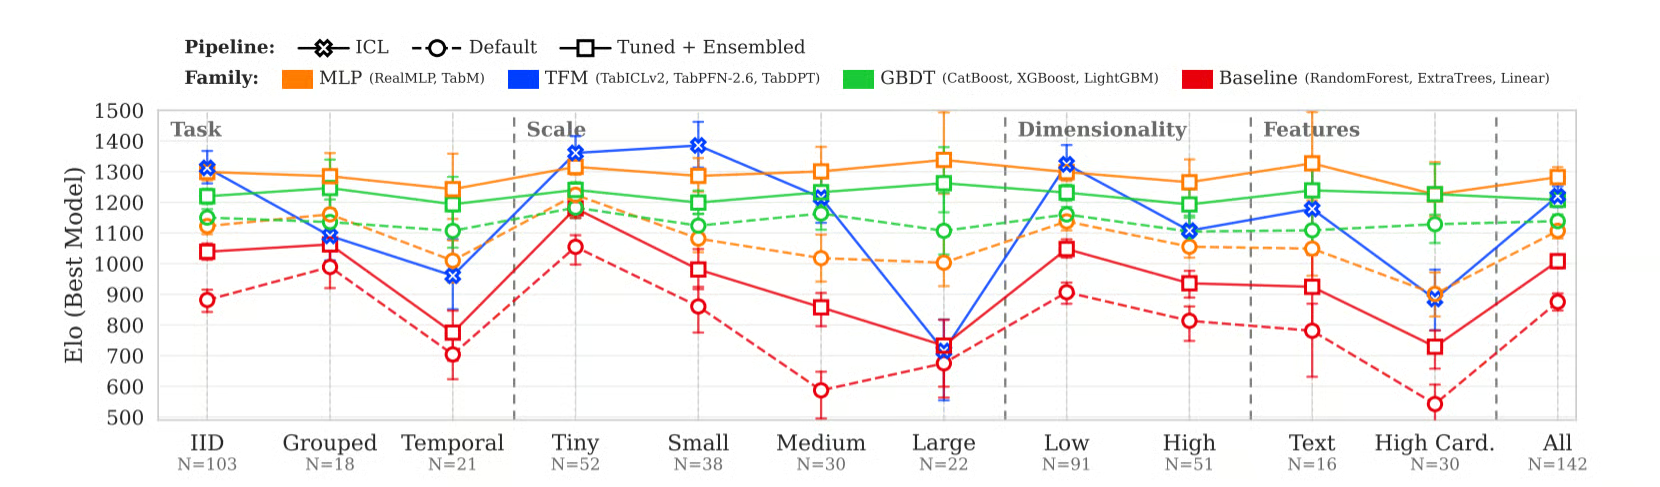
Abbildung 3: Elo nach Modellfamilie (höher ist besser). Tabellarische Foundation-Modelle führen bei kleinen IID-Daten, fallen aber bei temporalen und großen Datasets ab, wo Bäume und MLPs robuster sind. Blau steht für das beste aus TabICLv2, TabPFN-2.6 und TabDPT, nicht für die neuesten TabPFN-Versionen. Quelle: Purucker et al., „Beyond IID: How General Are Tabular Foundation Models, Really?“ (2026), CC BY 4.0.
Hoffentlich stimmst du zu: Tabellarische Foundation-Modelle heben die Messlatte für schnelle, aufwandsarme Baselines deutlich an, aber Baummodelle bleiben in vielen realen Situationen die bessere Wahl.
Setze es ein, wenn dein Dataset klein bis mittel und IID ist und du weder vollständige Erklärbarkeit noch extrem schnelle CPU-Vorhersagen brauchst. Hier ist meine Entscheidungshilfe:
| Szenario | Empfohlener Ansatz |
|---|---|
| Unter 10 Tsd. Zeilen, IID, keine Erklärbarkeitsanforderungen | Starte mit TabICLv2 oder TabPFN |
| 10 Tsd. bis 100 Tsd. Zeilen, IID | Teste TabICLv2 und XGBoost, behalte den Sieger |
| 100 Tsd. bis 1 Mio. Zeilen | Starte mit XGBoost oder LightGBM, probiere TabPFN-3 als Challenger |
| Daten nach Zeit oder Gruppe gesplittet | Starte mit baumbasierten Modellen |
| Brauchst SHAP, Feature Importance oder Audits | Baummodell mit SHAP |
| Schnelle Vorhersagen ohne GPU | Baummodell |
| Schneller Proof of Concept, kein ML-Setup | TabICLv2 oder BigQuery AI.PREDICT, wenn deine Daten schon dort sind |
| KI-Agent, der Vorhersagen aus Tabellen braucht | Eine API wie tabH2O oder NEXUS |
Bevor du ein Modell auswählst, würde ich drei Fragen stellen:
Zum Schluss mein Rat: Lass zuerst ein tabellarisches Foundation-Modell laufen, denn das kostet dich nur ein paar Minuten. Wenn es XGBoost auf deinen Daten nicht schlägt, weißt du, dass sich Feature Engineering und Tuning für XGBoost lohnen.
Erinnerst du dich an die zwei Studierenden vom Anfang? 2026 kann die zweite Person, die Millionen Prüfungen geübt hat, die andere endlich schlagen – zumindest auf kleinen und mittleren Tabellen.
Tabellarische Foundation-Modelle ersetzen das Training pro Dataset durch Vortraining und ersetzen fit() durch Lernen aus Beispielen.
Am meisten überrascht mich, wie rasant das Feld vorangekommen ist. TabPFN-2 zeigte 2025 erstmals, dass ein neuronales Netz getunte Bäume auf kleinen Tabellen schlagen kann. TabICLv2 und TabPFN-3 haben das seitdem auf deutlich größere erweitert.
Offen bleiben Zeitreihen, driftende Daten, Erklärbarkeit und Lizenzen – genau die Punkte, die entscheiden, ob ein Modell ins echte Produkt kommt.
Behandle diese Modelle also als neuen Startpunkt und wähle das Endwerkzeug nach deinen Daten, deinen Randbedingungen und der Zielumgebung aus.
Und wenn du die Baummodelle meistern willst, die in vielen realen Situationen weiterhin gewinnen, sieh dir unseren Kurs Machine Learning with Tree-Based Models in Python und den Supervised Machine Learning in Python-Lernpfad an. Arbeitest du in R, deckt Machine Learning with Tree-Based Models in R dasselbe ab.
Top-DataCamp-Kurse
Lernpfad
Kurs
Lernpfad
Blog
Blog
Hesam Sheikh Hassani
15 Min.
Tutorial
Josef Waples
8 Min.
Tutorial
Sejal Jaiswal
24 Min.
Tutorial
Laiba Siddiqui
6 Min.
Tutorial
Josef Waples
3 Min.